

ROC कर्व क्या है?
ROC कर्व विभिन्न थ्रेशहोल्ड्स पर true positive rate (TPR) और false positive rate (FPR) के बीच ट्रे़ड-ऑफ का दृश्य रूप देता है। यह बताता है कि अलग-अलग थ्रेशहोल्ड्स पर पॉजिटिव इंस्टैंसेज़ को पकड़ने और फॉल्स पॉजिटिव से बचने के बीच मॉडल कितना अच्छा संतुलन बना पाता है। AUC, यानी Area Under the Curve, 0 से 1 के बीच एक एकल स्केलर मान है, जो मॉडल के प्रदर्शन की एक झलक देता है। AUC की गणना हमेशा ROC कर्व बनाने के बाद ही होती है क्योंकि AUC इसी कर्व के नीचे के क्षेत्र का प्रतिनिधित्व करता है।
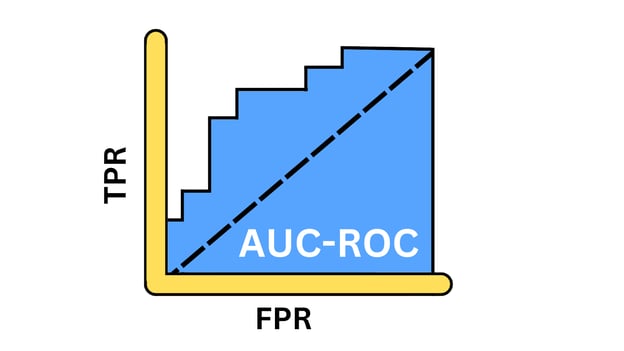
AUC-ROC कर्व का चित्रण। चित्र: लेखक
True positive rate
True positive rate, जिसे sensitivity या recall भी कहते हैं, पॉजिटिव इंस्टैंसेज़ को सही पहचानने की मॉडल की क्षमता को दर्शाता है। यह वास्तविक पॉजिटिव मामलों का वह अनुपात मापता है जिन्हें मॉडल सफलतापूर्वक पहचानता है। गणितीय रूप से, इसे निम्न समीकरण से व्यक्त किया जा सकता है:
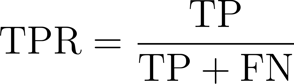
जहाँ:
- TP या true positives वे पॉजिटिव क्लास रिकॉर्ड हैं जिन्हें मॉडल ने सही रूप से पॉजिटिव भविष्यवाणी किया।
- FN या false negatives वे पॉजिटिव क्लास रिकॉर्ड हैं जिन्हें मॉडल ने गलत रूप से नेगेटिव भविष्यवाणी किया।
False positive rate
FPR यह दर्शाता है कि हमारा मॉडल नेगेटिव क्लास इंस्टैंसेज़ को कितनी बार गलत रूप से पॉजिटिव के रूप में वर्गीकृत करता है। यह वास्तविक नेगेटिव इंस्टैंसेज़ का वह अनुपात मापता है जिन्हें मॉडल गलत तरीके से पॉजिटिव पहचानता है, यानी फॉल्स अलार्म की दर। गणितीय रूप से इसे इस प्रकार व्यक्त किया जा सकता है।
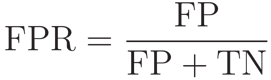
जहाँ:
- FP या false positives वे नेगेटिव क्लास रिकॉर्ड हैं जिन्हें गलत रूप से पॉजिटिव भविष्यवाणी किया गया।
- TN या true negatives वे नेगेटिव क्लास रिकॉर्ड हैं जिन्हें सही रूप से नेगेटिव भविष्यवाणी किया गया।
AUC-ROC कर्व का उपयोग क्यों करें?
आइए समझते हैं कि किन परिदृश्यों में AUC-ROC अधिक प्रासंगिक मेट्रिक है।
प्रदर्शन का मापन
AUC-ROC सभी संभावित क्लासिफिकेशन थ्रेशहोल्ड्स पर समग्र प्रदर्शन माप प्रदान करता है। एक्यूरेसी, प्रिसिजन या F1-स्कोर जैसे मेट्रिक्स किसी विशिष्ट थ्रेशहोल्ड पर निर्भर होते हैं, जबकि AUC-ROC अलग-अलग ऑपरेटिंग पॉइंट्स पर प्रदर्शन पर विचार करता है।
मॉडल तुलना
AUC-ROC एक एकल स्केलर मान देता है जो विभिन्न क्लासिफिकेशन थ्रेशहोल्ड्स की परवाह किए बिना कई मॉडलों की तुलना आसान बनाता है। इसकी थ्रेशहोल्ड-स्वतंत्र प्रकृति अलग-अलग सर्वोत्तम थ्रेशहोल्ड वाले मॉडलों की निष्पक्ष तुलना के लिए इसे बेहतर विकल्प बनाती है।
क्लास असंतुलन पर नज़र
अधिकांश वास्तविक जीवन के डेटासेट असंतुलित होते हैं जहाँ एक क्लास दूसरी की तुलना में अनुपातहीन रूप से अधिक होती है, जैसे sentiment analysis, fraud detection और कैंसर डिटेक्शन। ऐसे में एक्यूरेसी जैसे मेट्रिक्स बहुसंख्यक क्लास की ओर पक्षपाती होने के कारण प्रदर्शन का भ्रामक आकलन देते हैं। इन परिस्थितियों में AUC-ROC जैसे मेट्रिक्स अधिक विश्वसनीय होते हैं।
AUC-ROC कर्व की प्रमुख अवधारणाएँ
चलिए कुछ प्रमुख विचारों पर नज़र डालते हैं।
ROC कर्व बनाना
ROC कर्व को practically देखने के लिए, हम विभिन्न थ्रेशहोल्ड्स पर TPR और FPR की गणना करेंगे। इस डेमो के लिए आवश्यक लाइब्रेरीज़ इम्पोर्ट करने से शुरू करते हैं।
from sklearn.model_selection import train_test_split
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score, accuracy_score, precision_score, recall_score, f1_score, confusion_matrix, roc_curve, auc
import matplotlib.pyplot as pltइसके बाद हम make-classification() फ़ंक्शन का उपयोग करके 1000 सैम्पल और 20 फीचर्स वाला एक बाइनरी क्लासिफिकेशन डेटासेट जनरेट करेंगे।
# Generate a binary classification dataset
X, y = make_classification(n_samples=1000, n_features=20, n_classes=2, random_state=0)आइए डेटासेट को ट्रेनिंग और टेस्ट डेटा में बाँटते हैं—हम ट्रेनिंग सेट पर मॉडल को प्रशिक्षित करेंगे और अनदेखे टेस्ट डेटासेट पर इसका प्रदर्शन मापेंगे।
# Split the dataset into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)अब हम LogisticRegression() क्लास को कॉल करके मॉडल ऑब्जेक्ट परिभाषित करेंगे और फिर इसे ट्रेनिंग डेटा पर fit मेथड से ट्रेन करेंगे, जहाँ X_train फीचर्स हैं और y_train लेबल्स को दर्शाता है।
# Train a Logistic Regression model
model = LogisticRegression()
model.fit(X_train, y_train)अब मॉडल प्रशिक्षित हो चुका है और भविष्यवाणियाँ जनरेट करने के लिए तैयार है। हम predict_proba() फ़ंक्शन को कॉल करके पॉजिटिव क्लास की प्रायिकता निकालते हैं। हम predict() मेथड का उपयोग करके accuracy, precision, recall और F1-स्कोर जैसे मूल्यांकन मेट्रिक्स की गणना करते हैं।
# Predict the probabilities for the test set
y_probs = model.predict_proba(X_test)[:, 1]
# Predict the classes for the test set
y_pred = model.predict(X_test)इसके बाद, हम उनके संबंधित फ़ंक्शनों का उपयोग करके इन सभी मेट्रिक्स की गणना और प्रिंट करेंगे।
# Calculate the AUC - ROC score
roc_auc = roc_auc_score(y_test, y_probs)
# Calculate other metrics
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)
# Print the metrics
print(f"AUC - ROC Score: {roc_auc:.2f}")
print(f"Accuracy: {accuracy:.2f}")
print(f"Precision: {precision:.2f}")
print(f"Recall: {recall:.2f}")
print(f"F1 Score: {f1:.2f}")AUC-ROC Score: 0.93
Accuracy: 0.87
Precision: 0.87
Recall: 0.87
F1 Score: 0.87अब, आइए ROC कर्व को उस विकर्ण रेखा के साथ विज़ुअलाइज़ करें जो एक रैंडम-चांस मॉडल का प्रतिनिधित्व करती है। इसकी गणना के लिए हमें 0 और 1 के बीच हर डिस्क्रीट थ्रेशहोल्ड पर FPR और TPR की आवश्यकता होती है। नीचे दिए ग्राफ में, नारंगी कर्व ROC को दर्शाता है और इस कर्व के नीचे का क्षेत्रफल 0.93 है।
# Plotting the ROC Curve
fpr, tpr, thresholds = roc_curve(y_test, y_probs)
roc_auc = auc(fpr, tpr)
plt.figure()
plt.plot(fpr, tpr, color='darkorange', lw=2, label=f'ROC curve (area = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('Receiver Operating Characteristic')
plt.legend(loc="lower right")
plt.show()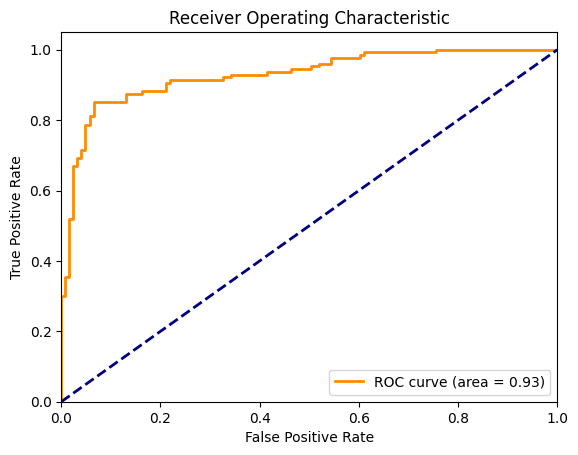
लॉजिस्टिक रिग्रेशन के लिए ROC कर्व। चित्र: लेखक
ROC कर्व का उपयोग करके सर्वश्रेष्ठ एल्गोरिदम चुनना
अब, हम उसी डेटासेट का उपयोग करके ROC के माध्यम से चार क्लासिफिकेशन एल्गोरिदम के प्रदर्शन की तुलना करेंगे। हम RandomForestClassifier, KNeighborsClassifier और SVC इम्पोर्ट करके इन्हें LogisticRegression से तुलना करेंगे।
from sklearn.ensemble import RandomForestClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC
# Define the models
models = {
"Logistic Regression": LogisticRegression(),
"Random Forest": RandomForestClassifier(),
"SVM": SVC(probability=True),
"K-Nearest Neighbors": KNeighborsClassifier()
}
# Initialize a dictionary to store AUC - ROC scores
roc_auc_scores = {}
# Plot the ROC curves
plt.figure(figsize=(10, 8))
for name, model in models.items():
# Train the model
model.fit(X_train, y_train)
# Predict the probabilities
y_probs = model.predict_proba(X_test)[:, 1]
# Calculate the AUC - ROC score
roc_auc = roc_auc_score(y_test, y_probs)
roc_auc_scores[name] = roc_auc
# Compute ROC curve
fpr, tpr, _ = roc_curve(y_test, y_probs)
# Plot ROC curve
plt.plot(fpr, tpr, lw=2, label=f'{name} (AUC = {roc_auc:.2f})')
# Plot the diagonal 50% line
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
# Customize the plot
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('ROC Curve Comparison')
plt.legend(loc="lower right")
plt.show()
# Print the AUC - ROC scores for each model
for name, score in roc_auc_scores.items():
print(f'{name}: AUC - ROC = {score:.2f}')हर मॉडल ऑब्जेक्ट के लिए हम fit() और predict_proba() दोहराते हैं, संबंधित FPR और TPR निकालते हैं, और फिर उनके कर्व्स प्लॉट करते हैं।
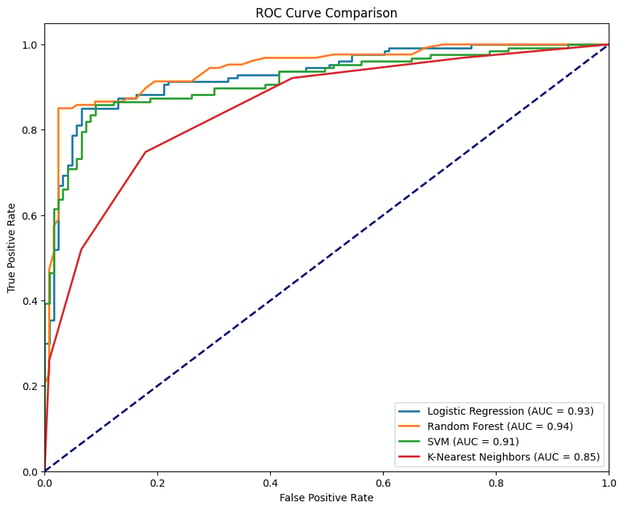
विभिन्न मॉडलों के लिए ROC कर्व। चित्र: लेखक
ऊपर दिए चित्र में चारों क्लासिफायर्स के अनुरूप चार कर्व दिखाए गए हैं, जहाँ RandomForestClassifier 0.94 के AUC-ROC के साथ सर्वश्रेष्ठ प्रदर्शन करता है, जबकि KNeighborsClassifier 0.85 के AUC-ROC के साथ सबसे कम प्रदर्शन करता है। आदर्श मॉडल प्लॉट के टॉप-लेफ्ट कोने से सटा हुआ होगा—जहाँ TPR अधिकतम और FPR न्यूनतम होता है। कर्व जितना इस बिंदु के निकट होगा, मॉडल का प्रदर्शन उतना बेहतर होगा।
AUC-ROC कर्व को कैसे पढ़ें और समझें
आइए AUC-ROC कर्व द्वारा दिए गए मेट्रिक्स को समझें और उनकी अहमियत जानें।
AUC मान की व्याख्या
AUC मान तेजी से यह समझने का तरीका देते हैं कि मॉडल कितना अच्छा प्रदर्शन कर रहा है। जब AUC 1 के करीब होता है, हमारा मॉडल सर्वश्रेष्ठ स्थिति में होता है—क्लासों में फर्क करने की क्षमता बहुत मजबूत होती है। AUC लगभग 0.5 होना चिंताजनक है, यह बताता है कि मॉडल रैंडम अनुमान से बेहतर नहीं कर रहा—भेदकारी शक्ति नहीं है। AUC 0 के पास होना अलार्मिंग है, यानी मॉडल पूरी तरह गलत कर रहा है—सिक्का उछालने से भी बदतर।
True positive rate: सफलता का माप
TPR, या sensitivity, एक अहम मेट्रिक है जो बताता है कि हमारा मॉडल पॉजिटिव इंस्टैंसेज़ को कितनी अच्छी तरह पकड़ रहा है। TPR वास्तविक पॉजिटिव्स के उस अनुपात के रूप में निकाला जाता है जिन्हें मॉडल सही पहचानता है। यह सच्चे संकेतों (पॉजिटिव्स) का पता लगाने में मॉडल की प्रभावशीलता का प्रमुख संकेतक है। उच्च TPR का मतलब है कि हमारा मॉडल महत्वपूर्ण चीज़ों को भली-भाँति पहचान रहा है।
False positive rate: शोर का आकलन
दूसरी ओर, FPR हमें शोर समझने में मदद करता है—हमारा मॉडल नेगेटिव्स को कितनी बार गलत तरीके से पॉजिटिव बताता है। FPR वास्तविक नेगेटिव्स का वह अनुपात है जिन्हें हमारा मॉडल गलत रूप से पॉजिटिव चिह्नित करता है। यह मॉडल के किए जा रहे ट्रे़ड-ऑफ्स का आकलन करने के लिए महत्वपूर्ण है। उच्च FPR फॉल्स अलार्म की प्रवृत्ति दर्शाता है, जो एप्लिकेशन के अनुसार महँगी साबित हो सकती है।
Sensitivity और specificity का संतुलन
बाइनरी क्लासिफिकेशन की खूबसूरती और चुनौती थ्रेशहोल्ड सेटिंग्स में निहित है और इसी कारण हम मॉडल की sensitivity (TPR) और specificity (1 - FPR) को फाइन-ट्यून करते हैं। थ्रेशहोल्ड ट्यून करके हम मॉडल को पॉजिटिव क्लास इंस्टैंसेज़ के प्रति कितना संवेदनशील बनाना है, और फॉल्स पॉजिटिव्स को कैसे घटाना है—इसे नियंत्रित कर सकते हैं। अधिकतर वास्तविक-world परिदृश्यों में फॉल्स नेगेटिव (पॉजिटिव छूट जाना) और फॉल्स पॉजिटिव (झूठा अलार्म) की लागत में काफी फर्क होता है।
AUC-ROC कर्व के वास्तविक उपयोग
AUC-ROC केवल सैद्धांतिक अवधारणा नहीं है; यह विभिन्न उद्योगों में अहम फैसले लेने के लिए व्यावहारिक रूप से ऐसे उपयोग में आता है:
मेडिकल डायग्नोस्टिक्स
AUC-ROC अलग-अलग डायग्नोस्टिक टेस्ट्स की तुलना में उपयोग होता है। यह तब खास उपयोगी है जब फॉल्स नेगेटिव (जैसे किसी बीमारी का छूट जाना) की लागत फॉल्स पॉजिटिव (जैसे अनावश्यक उपचार) से कहीं अधिक हो सकती है। एक उल्लेखनीय उदाहरण कैंसर स्क्रीनिंग है, जहाँ आगे की जाँच का थ्रेशहोल्ड जोखिम कारकों और संसाधन उपलब्धता के आधार पर समायोजित किया जा सकता है।
फ्रॉड डिटेक्शन
वित्तीय क्षेत्र में धोखाधड़ी गतिविधियों की पहचान के लिए मशीन लर्निंग मॉडलों का उपयोग तेजी से बढ़ रहा है। चूँकि फ्रॉड ट्रांज़ैक्शन्स काफी दुर्लभ होते हैं, ऐसे डेटासेट अत्यधिक असंतुलित होते हैं। इसलिए AUC-ROC एक प्रभावी मूल्यांकन मेट्रिक है जो थ्रेशहोल्ड को विभिन्न कारकों—जैसे लेनदेन के जोखिम की परिमाण, हर ट्रांज़ैक्शन की मैनुअल जाँच की लागत, और ग्राहक असुविधा की लागत—के आधार पर समायोजित करने की सुविधा भी देता है।
साइबर सुरक्षा
फ्रॉड डिटेक्शन की तरह, साइबर हमले भी अपेक्षाकृत दुर्लभ घटनाएँ हैं। इसलिए AUC-ROC साइबर सुरक्षा में भी उपयोगी है—खतरों का पता लगाने और फॉल्स पॉजिटिव्स से होने वाली अलर्ट थकान से बचने के बीच संतुलन बनाते हुए।
AUC-ROC कर्व के विकल्प
AUC-ROC बाइनरी क्लासिफिकेशन मॉडलों के लिए लोकप्रिय मेट्रिक है, लेकिन कुछ परिस्थितियों में वैकल्पिक मेट्रिक्स अधिक उपयुक्त हो सकते हैं। आइए कुछ विकल्पों और उनके उपयोग के समय को समझें:
प्रिसिजन-रिकॉल कर्व
प्रिसिजन-रिकॉल कर्व (PRC) असंतुलित डेटासेट्स के लिए उपयोगी मेट्रिक है, खासकर जब फॉल्स पॉजिटिव और फॉल्स नेगेटिव की लागतें अलग-अलग हों। AUC-ROC के विपरीत, जो असंतुलित डेटासेट्स में कभी-कभी जरूरत से ज्यादा आशावादी चित्र दे सकता है, PRC पॉजिटिव क्लास के सापेक्ष प्रदर्शन पर अधिक फोकस करता है।
F1 स्कोर
F1 स्कोर, प्रिसिजन और रिकॉल का हार्मोनिक मीन है, जो दोनों का संतुलित एकल मेट्रिक देता है। इसका उपयोग तब होता है जब हमें विशेषकर असंतुलित डेटासेट्स में प्रदर्शन का एक स्पष्ट, एक-नंबर सारांश चाहिए। AUC-ROC एक अधिक समग्र दृष्टि देता है, जबकि F1 PRC कर्व पर एक विशिष्ट बिंदु का प्रतिनिधित्व करता है।
निष्कर्ष
AUC-ROC बाइनरी क्लासिफिकेशन समस्याओं में स्वर्ण मानक जैसा है क्योंकि यह अलग-अलग थ्रेशहोल्ड्स पर मॉडल के प्रदर्शन का संतुलित दृश्य देता है—खासकर क्लास-असंतुलन की स्थितियों में।
हम मानते हैं कि सीखने को मजबूत करने का सबसे अच्छा तरीका हाथों-हाथ अभ्यास है। Python की बहुमुखी प्रतिभा हमें आवश्यक अवधारणाओं में महारत हासिल करने का उत्तम अवसर देती है। चाहे हम अपने मूल सिद्धांत दोहरा रहे हों या उन्नत विषयों की खोज कर रहे हों, यह गहराई में जाने का उपयुक्त समय है। आइए Python के बेसिक्स फिर से देखें और जटिल डेटासेट्स पर AUC-ROC के साथ काम करके खुद को चुनौती दें।

मैं एक एआई रणनीतिकार और नैतिकतावादी हूं, जो डेटा साइंस, प्रोडक्ट और इंजीनियरिंग के संगम पर स्केलेबल मशीन लर्निंग सिस्टम बनाने का काम करता/करती हूं। दुनिया के "टॉप 200 बिज़नेस और टेक्नोलॉजी इनोवेटर्स" में सूचीबद्ध, मेरा लक्ष्य मशीन लर्निंग को सबके लिए सुलभ बनाना और जटिल शब्दावली को सरल करना है, ताकि हर कोई इस परिवर्तन का हिस्सा बन सके।
अक्सर पूछे जाने वाले प्रश्न
AUC क्या है?
AUC-ROC कर्व क्या है?
AUC-ROC कर्व एक ग्राफ है जो विभिन्न थ्रेशहोल्ड्स पर बाइनरी क्लासिफिकेशन मॉडल के प्रदर्शन को दर्शाता है, जिसमें True Positive Rate को False Positive Rate के विरुद्ध प्लॉट किया जाता है।
मॉडल मूल्यांकन में AUC-ROC कर्व महत्वपूर्ण क्यों है?
AUC-ROC कर्व सभी थ्रेशहोल्ड्स पर एक व्यापक प्रदर्शन माप देता है, जिससे मॉडलों की तुलना करना और उनकी क्लासों में फर्क करने की क्षमता का आकलन करना विशेष रूप से उपयोगी हो जाता है।
AUC स्कोर की व्याख्या कैसे करें?
AUC स्कोर 0 से 1 तक होता है, जहाँ 1 के करीब स्कोर उत्कृष्ट प्रदर्शन दर्शाता है, 0.5 रैंडम अनुमान का संकेत देता है, और 0 के पास स्कोर कमजोर प्रदर्शन बताता है।
मुझे अन्य मेट्रिक्स के बजाय AUC-ROC कब इस्तेमाल करना चाहिए?
जब आपको थ्रेशहोल्ड-स्वतंत्र मेट्रिक चाहिए—खासकर असंतुलित डेटासेट्स में जहाँ एक्यूरेसी जैसे पारंपरिक मेट्रिक्स भ्रामक हो सकते हैं—तब AUC-ROC आदर्श होता है।
AUC-ROC कर्व के कुछ विकल्प क्या हैं?
विकल्पों में असंतुलित डेटासेट्स के लिए प्रिसिजन-रिकॉल कर्व और F1 स्कोर शामिल हैं, जो प्रिसिजन और रिकॉल का संतुलन देता है और समग्र प्रदर्शन के बजाय किसी विशेष बिंदु का आकलन करता है।
क्लासिफिकेशन मॉडल सबसे अधिक उपयोग किए जाने वाले प्रेडिक्टिव एल्गोरिदम में शामिल हैं। किसी प्रक्रिया को मॉडल करने के लिए कई एल्गोरिदम उपलब्ध हैं, पर आप कैसे तय करें कि कौन-सा मॉडल सबसे प्रभावी है?
मॉडल चयन में उनके प्रदर्शन मेट्रिक्स—जैसे प्रिसिजन, रिकॉल, F1-स्कोर, और AUC-ROC—के आधार पर विभिन्न मॉडलों का मूल्यांकन शामिल होता है। प्रिसिजन, रिकॉल और F1-स्कोर जैसे मेट्रिक्स बताते हैं कि कौन-सा मॉडल डेटा के लिए बेहतर है, लेकिन वे यह आकलन एक ही थ्रेशहोल्ड पर करते हैं। दूसरी ओर, AUC-ROC, यानी Receiver Operating Characteristic कर्व के नीचे का क्षेत्रफल, एक सशक्त मेट्रिक है जो पूरे थ्रेशहोल्ड स्पेक्ट्रम में मॉडल की गुणवत्ता का आकलन करता है।
इस पोस्ट में, हम समझेंगे कि AUC-ROC बाइनरी क्लासिफिकेशन मॉडलों के प्रदर्शन का मूल्यांकन करने के लिए पसंदीदा मेट्रिक क्यों है और इसे दो क्लासों के बीच अंतर करने में कैसे उपयोग किया जा सकता है। शुरुआत करते समय, हमारे Machine Learning Scientist with Python करियर ट्रैक में नामांकन करने पर भी विचार करें। यह आपको sklearn में निपुण बनाएगा, जिसका उपयोग हम इस ट्यूटोरियल में करते रहेंगे।