

Apa itu Kurva ROC?
Kurva ROC memberikan representasi visual tentang trade-off antara true positive rate (TPR) dan false positive rate (FPR) pada berbagai ambang. Kurva ini memberikan wawasan tentang seberapa baik model menyeimbangkan trade-off antara mendeteksi instance positif dan menghindari positif palsu di berbagai ambang. AUC, atau Area Under the Curve, adalah nilai skalar tunggal berkisar 0 hingga 1 yang memberikan gambaran kinerja model. Anda hanya menghitung AUC setelah menghasilkan kurva ROC karena AUC merepresentasikan luas area di bawah kurva.
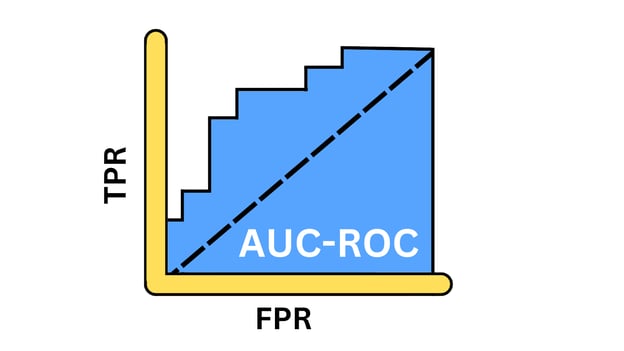
Ilustrasi Kurva AUC-ROC. Gambar oleh Penulis
True positive rate
True positive rate, juga dikenal sebagai sensitivitas atau recall, mencerminkan kemampuan model untuk mengidentifikasi instance positif dengan benar. Metrik ini mengukur proporsi kasus positif sebenarnya yang berhasil diidentifikasi model. Secara matematis, ini dapat dinyatakan dengan persamaan berikut:
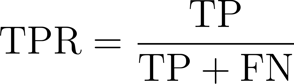
Di mana:
- TP atau true positives adalah jumlah record kelas positif yang diprediksi model sebagai positif dengan benar.
- FN atau false negatives adalah jumlah record kelas positif yang salah diprediksi model sebagai negatif.
False positive rate
FPR merepresentasikan seberapa sering model secara keliru mengklasifikasikan instance kelas negatif sebagai positif. Ini mengukur proporsi instance negatif sebenarnya yang salah diidentifikasi sebagai positif oleh model, yang menunjukkan tingkat alarm palsu. Secara matematis hal ini dapat dinyatakan sebagai berikut.
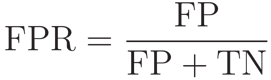
Di mana:
- FP atau false positives adalah jumlah record kelas negatif yang salah diprediksi sebagai positif.
- TN atau true negatives adalah jumlah record kelas negatif yang diprediksi sebagai negatif dengan benar.
Mengapa menggunakan kurva AUC-ROC?
Mari pahami skenario di mana AUC-ROC menjadi metrik yang lebih relevan.
Mengukur kinerja
AUC-ROC memberikan ukuran kinerja agregat di seluruh kemungkinan ambang klasifikasi. Tidak seperti akurasi, precision, atau F1-score yang bergantung pada ambang tertentu, AUC-ROC mempertimbangkan kinerja model pada berbagai titik operasi.
Perbandingan model
AUC-ROC adalah nilai skalar tunggal yang memudahkan perbandingan beberapa model, terlepas dari ambang klasifikasinya. Sifatnya yang independen dari ambang menjadikannya pilihan yang lebih baik untuk membandingkan model dengan ambang optimal yang berbeda.
Melihat ketidakseimbangan kelas
Sebagian besar dataset dunia nyata tidak seimbang, di mana satu kelas jauh lebih banyak daripada yang lain, misalnya analisis sentimen, deteksi penipuan, dan deteksi kanker. Dalam skenario seperti ini, metrik seperti akurasi memberikan penilaian yang menyesatkan karena bias terhadap kelas mayoritas. Pada kondisi tersebut, metrik seperti AUC-ROC lebih andal.
Konsep Kunci Kurva AUC-ROC
Mari kita lihat beberapa gagasan kuncinya.
Membuat kurva ROC
Untuk membangun kurva ROC, kita akan menghitung TPR dan FPR pada berbagai ambang. Mari mulai dengan mengimpor pustaka yang diperlukan untuk demo ini.
from sklearn.model_selection import train_test_split
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score, accuracy_score, precision_score, recall_score, f1_score, confusion_matrix, roc_curve, auc
import matplotlib.pyplot as pltSelanjutnya, kita akan menghasilkan dataset klasifikasi biner menggunakan fungsi make-classification(), dengan 1000 sampel dan 20 fitur.
# Generate a binary classification dataset
X, y = make_classification(n_samples=1000, n_features=20, n_classes=2, random_state=0)Mari bagi dataset menjadi data latih dan uji—kita akan melatih model pada set latih dan mengukur kinerjanya pada dataset uji yang belum pernah dilihat.
# Split the dataset into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)Berikutnya, kita mendefinisikan objek model dengan memanggil kelas LogisticRegression() lalu melatihnya menggunakan metode fit pada data latih, di mana X_train berisi fitur dan y_train merepresentasikan label.
# Train a Logistic Regression model
model = LogisticRegression()
model.fit(X_train, y_train)Kini model telah terlatih dan siap menghasilkan prediksi. Kita memanggil fungsi predict_proba() untuk menghasilkan probabilitas kelas positif. Kita menggunakan metode predict() untuk menghitung metrik evaluasi seperti akurasi, precision, recall, dan F1-score.
# Predict the probabilities for the test set
y_probs = model.predict_proba(X_test)[:, 1]
# Predict the classes for the test set
y_pred = model.predict(X_test)Selanjutnya, kita menghitung dan mencetak semua metrik ini menggunakan fungsinya masing-masing.
# Calculate the AUC - ROC score
roc_auc = roc_auc_score(y_test, y_probs)
# Calculate other metrics
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)
# Print the metrics
print(f"AUC - ROC Score: {roc_auc:.2f}")
print(f"Accuracy: {accuracy:.2f}")
print(f"Precision: {precision:.2f}")
print(f"Recall: {recall:.2f}")
print(f"F1 Score: {f1:.2f}")AUC-ROC Score: 0.93
Accuracy: 0.87
Precision: 0.87
Recall: 0.87
F1 Score: 0.87Sekarang, mari visualisasikan kurva ROC bersama garis diagonal yang merepresentasikan model acak. Untuk menghitung ini, kita memerlukan FPR dan TPR untuk setiap ambang diskret antara 0 dan 1. Pada grafik di bawah, kurva oranye merepresentasikan ROC dan luas area di bawah kurva ini adalah 0,93.
# Plotting the ROC Curve
fpr, tpr, thresholds = roc_curve(y_test, y_probs)
roc_auc = auc(fpr, tpr)
plt.figure()
plt.plot(fpr, tpr, color='darkorange', lw=2, label=f'ROC curve (area = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('Receiver Operating Characteristic')
plt.legend(loc="lower right")
plt.show()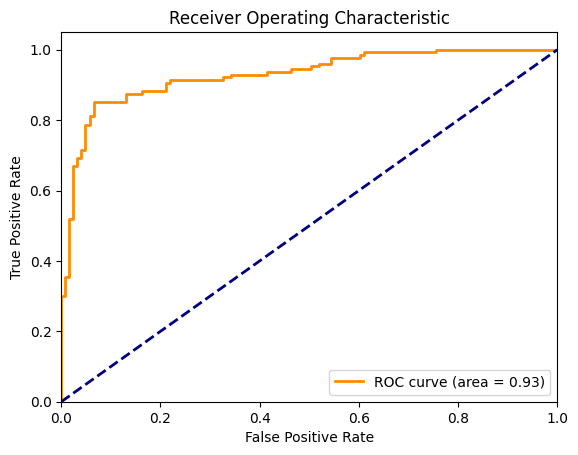
Kurva ROC untuk logistic regression. Gambar oleh Penulis
Memilih Algoritma Terbaik menggunakan Kurva ROC
Sekarang, mari gunakan dataset yang sama dan bandingkan kinerja empat algoritma klasifikasi menggunakan ROC. Kita akan mulai dengan mengimpor RandomForestClassifier, KNeighborsClassifier, dan SVC lalu membandingkannya dengan LogisticRegression.
from sklearn.ensemble import RandomForestClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC
# Define the models
models = {
"Logistic Regression": LogisticRegression(),
"Random Forest": RandomForestClassifier(),
"SVM": SVC(probability=True),
"K-Nearest Neighbors": KNeighborsClassifier()
}
# Initialize a dictionary to store AUC - ROC scores
roc_auc_scores = {}
# Plot the ROC curves
plt.figure(figsize=(10, 8))
for name, model in models.items():
# Train the model
model.fit(X_train, y_train)
# Predict the probabilities
y_probs = model.predict_proba(X_test)[:, 1]
# Calculate the AUC - ROC score
roc_auc = roc_auc_score(y_test, y_probs)
roc_auc_scores[name] = roc_auc
# Compute ROC curve
fpr, tpr, _ = roc_curve(y_test, y_probs)
# Plot ROC curve
plt.plot(fpr, tpr, lw=2, label=f'{name} (AUC = {roc_auc:.2f})')
# Plot the diagonal 50% line
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
# Customize the plot
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('ROC Curve Comparison')
plt.legend(loc="lower right")
plt.show()
# Print the AUC - ROC scores for each model
for name, score in roc_auc_scores.items():
print(f'{name}: AUC - ROC = {score:.2f}')Untuk setiap objek model, kita mengulangi fit() dan predict_proba(), menghitung FPR dan TPR yang sesuai, lalu memplot kurva masing-masing.
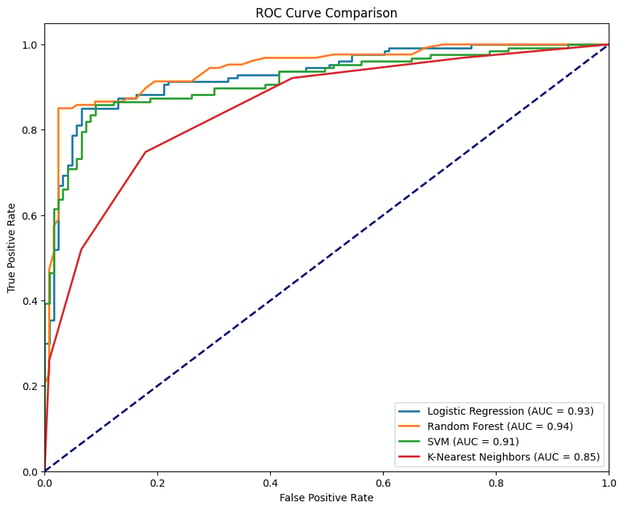
Kurva ROC untuk berbagai model. Gambar oleh Penulis
Gambar di atas menunjukkan keempat kurva yang sesuai dengan empat classifier, di mana RandomForestClassifier berkinerja terbaik dengan AUC-ROC sebesar 0,94 sementara KNeighborsClassifier berkinerja paling rendah dengan AUC-ROC sebesar 0,85. Model ideal akan merapat ke sudut kiri atas plot—di mana TPR dimaksimalkan dan FPR diminimalkan. Semakin dekat kurva ke titik ini, semakin baik kinerja model.
Cara Membaca dan Memahami Kurva AUC-ROC
Mari uraikan metrik yang disediakan kurva AUC-ROC dan pahami signifikansinya.
Menafsirkan nilai AUC
Nilai AUC memberikan rujukan cepat untuk memahami seberapa baik model bekerja. Ketika AUC mendekati 1, model kita berada pada performa puncak. Ini menunjukkan kinerja yang sangat baik dengan kemampuan kuat membedakan antar kelas. AUC sekitar 0,5 adalah kondisi yang mengkhawatirkan, karena menunjukkan bahwa model tidak lebih baik daripada menebak secara acak, menandakan tidak ada daya diskriminasi. Skor AUC yang mendekati 0 adalah situasi yang mengkhawatirkan. Ini mengindikasikan model benar-benar salah, bahkan lebih buruk daripada lempar koin.
True positive rate: mengukur keberhasilan
TPR, atau sensitivitas, adalah metrik penting yang menunjukkan seberapa baik model kita menangkap instance positif. TPR dihitung sebagai proporsi positif sebenarnya yang diidentifikasi dengan benar oleh model. Ini adalah indikator kunci efektivitas model dalam mendeteksi sinyal yang benar (positif). TPR yang tinggi berarti model kita sangat baik dalam mengenali hal yang paling penting.
False positive rate: mengukur derau
Sebaliknya, FPR membantu kita memahami derau—seberapa sering model secara keliru mengidentifikasi negatif sebagai positif. FPR adalah proporsi negatif sebenarnya yang secara keliru ditandai sebagai positif oleh model. Ini adalah metrik penting untuk menilai trade-off yang dibuat model. FPR yang tinggi menunjukkan kecenderungan menghasilkan alarm palsu, yang bisa mahal bergantung pada aplikasinya.
Menyeimbangkan sensitivitas dan spesifisitas
Keindahan dan tantangan klasifikasi biner terletak pada pengaturan ambang, sehingga kita menyetel sensitivitas (TPR) dan spesifisitas (1 - FPR) model. Kita dapat mengendalikan seberapa sensitif model dalam mendeteksi instance kelas positif dan mengurangi positif palsu dengan menyetel ambang. Dalam banyak skenario dunia nyata, biaya false negative (melewatkan positif) versus false positive (alarm palsu) dapat sangat berbeda.
Kasus Penggunaan Nyata Kurva AUC-ROC
AUC-ROC bukan sekadar konsep teoretis; berikut adalah cara metrik praktis ini digunakan di berbagai industri untuk mendorong pengambilan keputusan penting:
Diagnostik medis
AUC-ROC digunakan untuk membandingkan berbagai tes diagnostik. Metrik ini sangat berguna ketika biaya false negative (misalnya, melewatkan penyakit) jauh lebih besar daripada false positive (misalnya, perawatan yang tidak perlu). Contoh pentingnya adalah skrining kanker, di mana ambang untuk pemeriksaan lanjutan dapat disesuaikan berdasarkan faktor risiko dan ketersediaan sumber daya.
Deteksi penipuan
Model machine learning semakin banyak digunakan untuk mengidentifikasi aktivitas penipuan di sektor keuangan. Mengingat transaksi penipuan sangat jarang, dataset seperti ini sangat tidak seimbang. Oleh karena itu, AUC-ROC adalah metrik evaluasi yang efektif dan juga memungkinkan penyesuaian ambang berdasarkan berbagai faktor, seperti besarnya risiko pada transaksi, biaya verifikasi manual setiap transaksi, dan biaya ketidaknyamanan pelanggan.
Keamanan siber
Serupa dengan deteksi penipuan, serangan siber juga merupakan kejadian yang relatif jarang. Maka, AUC-ROC juga digunakan dalam keamanan siber, menyeimbangkan antara mendeteksi ancaman dan menghindari kelelahan akibat peringatan dari positif palsu.
Alternatif Kurva AUC-ROC
AUC-ROC adalah metrik populer untuk mengevaluasi model klasifikasi biner, tetapi ada skenario di mana metrik alternatif mungkin lebih sesuai. Mari jelajahi beberapa alternatif dan kapan menggunakannya:
Kurva precision-recall
Kurva precision-recall (PRC) adalah metrik untuk dataset tidak seimbang yang sangat memengaruhi nilai model machine learning ketika false positive dan false negative memiliki biaya yang berbeda. Tidak seperti AUC-ROC, yang dapat memberikan gambaran terlalu optimistis pada dataset tidak seimbang, PRC lebih berfokus pada kinerja terkait kelas positif.
Skor F1
F1-score adalah rata-rata harmonik dari precision dan recall, memberikan satu metrik yang menyeimbangkan keduanya. Metrik ini digunakan ketika kita membutuhkan ringkasan kinerja model dalam satu angka yang jelas, terutama pada dataset tidak seimbang. AUC-ROC memberikan pandangan yang lebih menyeluruh, sementara F1 adalah titik spesifik pada kurva PRC.
Kesimpulan
AUC-ROC adalah standar emas dalam masalah klasifikasi biner karena memberikan pandangan yang lebih seimbang tentang seberapa baik model berkinerja di berbagai ambang, terutama pada skenario ketidakseimbangan kelas.
Kami yakin cara terbaik memperkuat pembelajaran adalah melalui praktik langsung. Python yang serbaguna memberi kita kesempatan sempurna untuk menguasai konsep-konsep penting. Baik saat menyegarkan kembali fundamental maupun mengeksplorasi topik yang lebih lanjut, sekarang adalah waktu yang tepat untuk menyelam. Mari kita tinjau kembali dasar-dasar Python dan menantang diri dengan bekerja menggunakan AUC-ROC pada dataset yang kompleks.

Saya adalah Penasihat dan Etikus AI yang bekerja di persimpangan ilmu data, produk, dan rekayasa untuk membangun sistem pembelajaran mesin yang dapat diskalakan. Masuk dalam daftar "200 Inovator Bisnis dan Teknologi Teratas" di dunia, saya memiliki misi untuk mendemokratisasi pembelajaran mesin dan menyederhanakan jargon agar semua orang dapat menjadi bagian dari transformasi ini.
Pertanyaan yang Sering Diajukan
Apa itu AUC?
Apa itu kurva AUC-ROC?
Kurva AUC-ROC adalah grafik yang menggambarkan kinerja model klasifikasi biner di berbagai ambang dengan memplot True Positive Rate terhadap False Positive Rate.
Mengapa kurva AUC-ROC penting dalam evaluasi model?
Kurva AUC-ROC memberikan ukuran kinerja yang komprehensif di semua ambang, sehingga sangat berguna untuk membandingkan model dan mengevaluasi kemampuan mereka membedakan antar kelas.
Bagaimana cara menafsirkan skor AUC?
Skor AUC berkisar dari 0 hingga 1, di mana skor yang lebih dekat ke 1 menunjukkan kinerja model yang sangat baik, 0,5 menyiratkan tebak-tebakan acak, dan skor mendekati 0 berarti kinerja buruk.
Kapan saya harus menggunakan AUC-ROC dibanding metrik lain?
AUC-ROC ideal digunakan saat Anda memerlukan metrik yang tidak bergantung pada ambang, khususnya pada dataset tidak seimbang di mana metrik tradisional seperti akurasi dapat menyesatkan.
Apa saja alternatif kurva AUC-ROC?
Alternatifnya termasuk kurva precision-recall untuk dataset tidak seimbang dan Skor F1, yang menyeimbangkan precision dan recall, menawarkan evaluasi titik tertentu alih-alih pandangan kinerja menyeluruh.




Model klasifikasi adalah salah satu algoritma prediktif yang paling umum digunakan. Beragam algoritma dapat digunakan untuk memodelkan sebuah proses, tetapi bagaimana cara Anda menentukan model mana yang paling efektif?
Pemilihan model melibatkan evaluasi berbagai model berdasarkan metrik kinerja, seperti precision, recall, F1-score, dan AUC-ROC. Metrik seperti precision, recall, dan F1-score memberikan wawasan tentang model mana yang paling sesuai dengan data, tetapi hanya pada satu ambang tertentu. Di sisi lain, AUC-ROC, atau Area Under the Receiver Operating Characteristic Curve, adalah metrik yang tangguh untuk menilai kualitas model di seluruh rentang ambang.
Dalam tulisan ini, kita akan memahami mengapa AUC-ROC menjadi metrik andalan untuk mengevaluasi kinerja model klasifikasi biner dan bagaimana kita dapat menggunakannya untuk membedakan dua kelas. Saat memulai, pertimbangkan juga untuk mendaftar di jalur karier Machine Learning Scientist with Python. Jalur ini akan memantapkan keahlian Anda dalam sklearn, yang akan kita gunakan sepanjang tutorial ini.