
Corso
Introduzione alla statistica in Python
4 ore
200.6K
La curva ROC offre una rappresentazione visiva del trade-off tra true positive rate (TPR) e false positive rate (FPR) a vari threshold. Fornisce indicazioni su quanto bene il modello riesce a bilanciare il rilevamento delle istanze positive e l’evitare i falsi positivi ai diversi threshold. AUC, o Area Under the Curve, è un singolo valore scalare compreso tra 0 e 1 che fornisce un’istantanea delle prestazioni del modello. L’AUC si calcola solo dopo aver generato la curva ROC, perché rappresenta l’area sottesa alla curva.
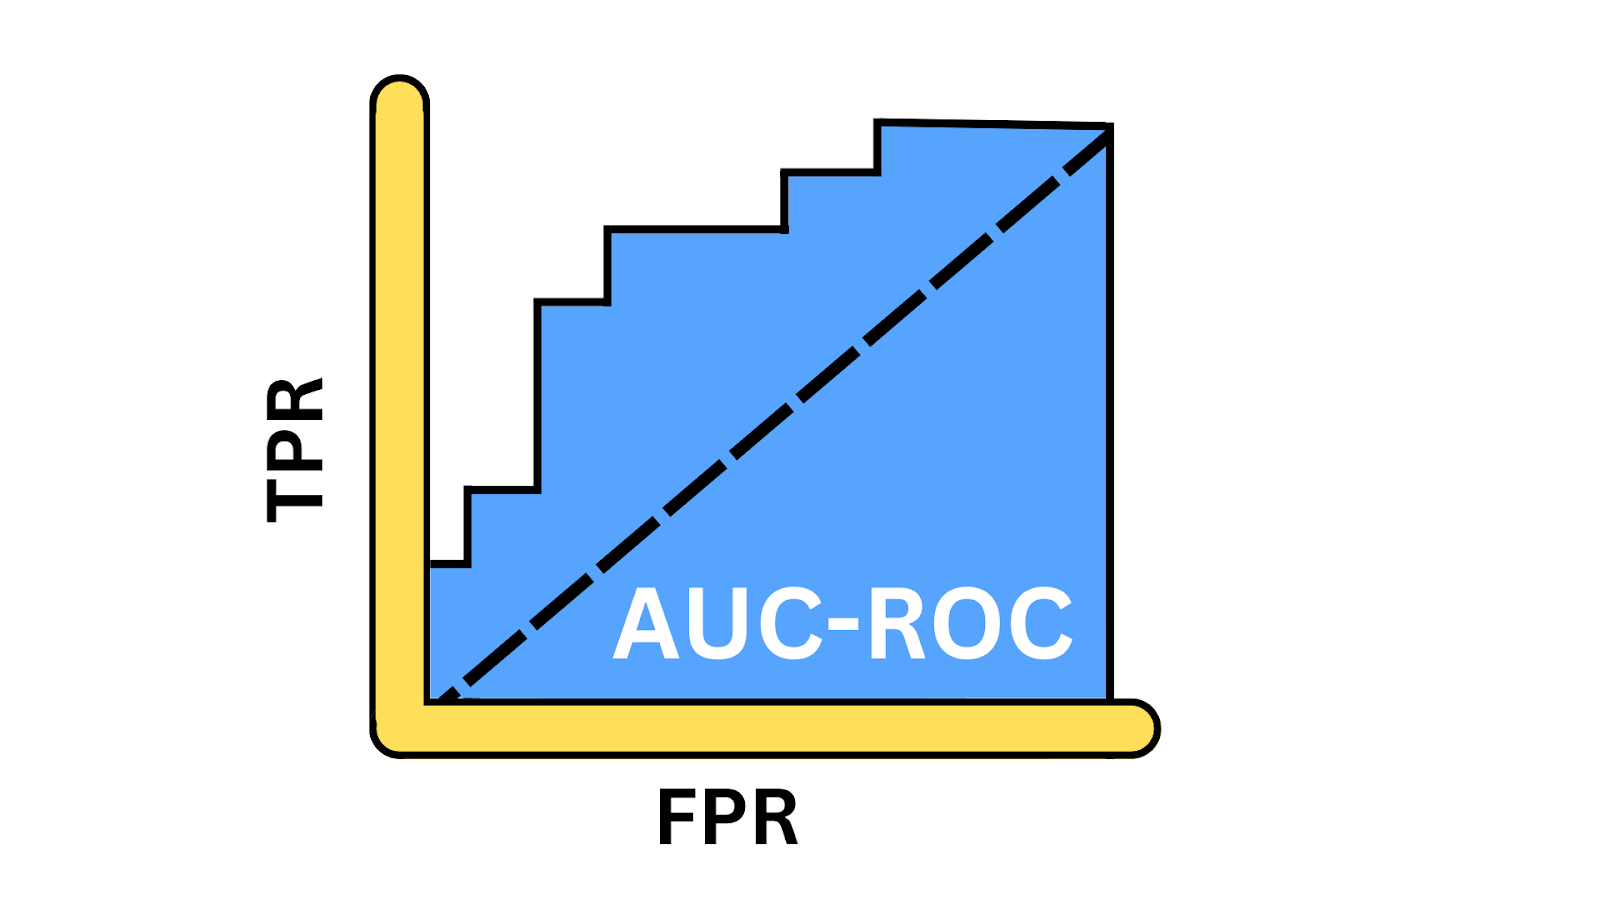
Illustrazione della curva AUC-ROC. Immagine dell’autore
Il true positive rate, noto anche come sensitivity o recall, riflette la capacità di un modello di identificare correttamente le istanze positive. Misura la proporzione dei casi realmente positivi che il modello identifica con successo. Matematicamente, si può esprimere con la seguente equazione:
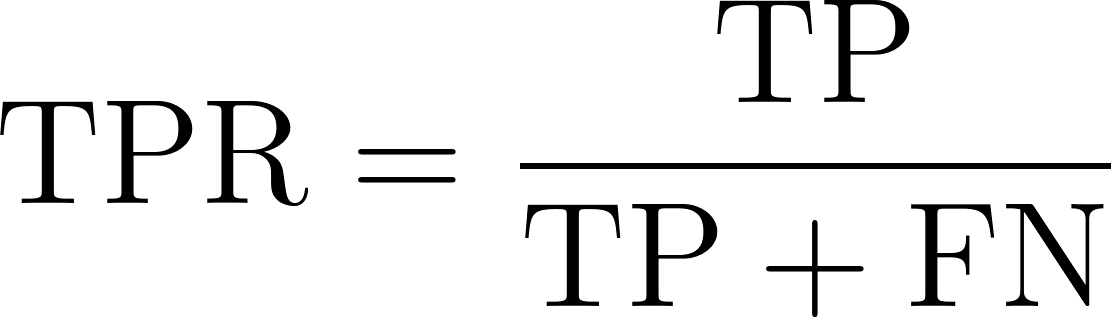
Dove:
L’FPR indica quanto spesso il nostro modello classifica erroneamente istanze della classe negativa come positive. Misura la proporzione di istanze realmente negative che vengono identificate in modo errato come positive dal modello, indicando il tasso di falsi allarmi. Matematicamente si può esprimere come segue.
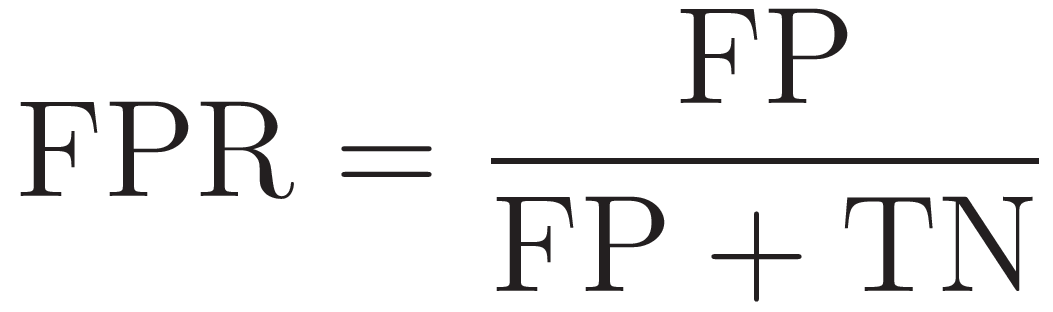
Dove:
Vediamo in quali scenari l’AUC-ROC è una metrica più pertinente.
L’AUC-ROC fornisce una misura aggregata delle prestazioni su tutti i possibili threshold di classificazione. A differenza di accuracy, precision o F1-score, che dipendono da un threshold specifico, considera le prestazioni del modello in diversi punti operativi.
L’AUC-ROC è un singolo valore scalare che rende più semplice confrontare più modelli, indipendentemente dai loro threshold di classificazione. La sua natura indipendente dal threshold la rende una scelta migliore per confronti equi tra modelli con threshold ottimali diversi.
La maggior parte dei dataset reali è sbilanciata, con una classe molto più rappresentata dell’altra, ad esempio nell’analisi del sentiment, nel rilevamento delle frodi e nella diagnosi del cancro. In questi casi, metriche come accuracy forniscono una valutazione fuorviante delle prestazioni del modello perché sono biasate verso la classe maggioritaria. In tali scenari, metriche come l’AUC-ROC sono più affidabili.
Diamo uno sguardo ad alcune idee fondamentali.
Per dare vita alla curva ROC, calcoleremo TPR e FPR a vari threshold. Iniziamo importando le librerie necessarie per questa demo.
from sklearn.model_selection import train_test_split
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score, accuracy_score, precision_score, recall_score, f1_score, confusion_matrix, roc_curve, auc
import matplotlib.pyplot as plt
Poi genereremo un dataset di classificazione binaria usando la funzione make-classification(), con 1000 campioni e 20 feature.
# Generate a binary classification dataset
X, y = make_classification(n_samples=1000, n_features=20, n_classes=2, random_state=0)
Dividiamo il dataset in train e test: alleneremo il modello sul train set e misureremo le sue prestazioni sul dataset di test mai visto.
# Split the dataset into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)
Quindi definiamo l’oggetto modello richiamando la classe LogisticRegression() e lo alleniamo con il metodo fit sui dati di training, dove X_train contiene le feature e y_train rappresenta le etichette.
# Train a Logistic Regression model
model = LogisticRegression()
model.fit(X_train, y_train)
Ora il modello è allenato e pronto a generare predizioni. Chiamiamo la funzione predict_proba() per ottenere la probabilità della classe positiva. Usiamo il metodo predict() per calcolare metriche di valutazione come accuracy, precision, recall e F1-score.
# Predict the probabilities for the test set
y_probs = model.predict_proba(X_test)[:, 1]

# Predict the classes for the test set
y_pred = model.predict(X_test)
Successivamente, calcoliamo e stampiamo tutte queste metriche usando le rispettive funzioni.
# Calculate the AUC - ROC score
roc_auc = roc_auc_score(y_test, y_probs)

# Calculate other metrics
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)

# Print the metrics
print(f"AUC - ROC Score: {roc_auc:.2f}")
print(f"Accuracy: {accuracy:.2f}")
print(f"Precision: {precision:.2f}")
print(f"Recall: {recall:.2f}")
print(f"F1 Score: {f1:.2f}")
AUC-ROC Score: 0.93
Accuracy: 0.87
Precision: 0.87
Recall: 0.87
F1 Score: 0.87Ora visualizziamo la curva ROC insieme alla diagonale che rappresenta un modello casuale. Per calcolarla, ci servono FPR e TPR per ogni threshold discreto tra 0 e 1. Nel grafico qui sotto, la curva arancione rappresenta la ROC e l’area sotto questa curva è 0,93.
# Plotting the ROC Curve
fpr, tpr, thresholds = roc_curve(y_test, y_probs)
roc_auc = auc(fpr, tpr)

plt.figure()
plt.plot(fpr, tpr, color='darkorange', lw=2, label=f'ROC curve (area = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('Receiver Operating Characteristic')
plt.legend(loc="lower right")
plt.show()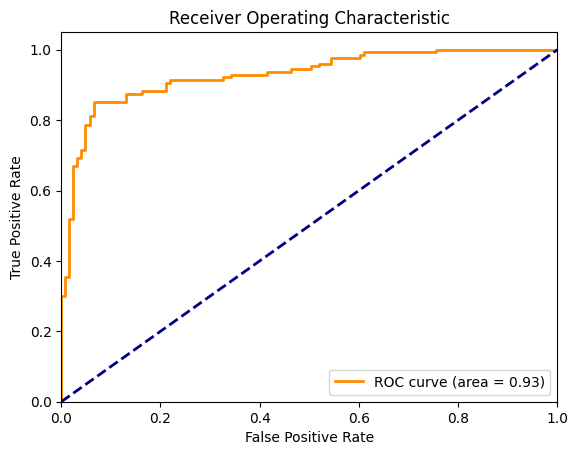
Curva ROC per la logistic regression. Immagine dell’autore
Ora useremo lo stesso dataset e confronteremo le prestazioni di quattro algoritmi di classificazione usando la ROC. Inizieremo importando RandomForestClassifier, KNeighborsClassifier e SVC e li confronteremo con la LogisticRegression.
from sklearn.ensemble import RandomForestClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC

# Define the models
models = {
    "Logistic Regression": LogisticRegression(),
    "Random Forest": RandomForestClassifier(),
    "SVM": SVC(probability=True),
    "K-Nearest Neighbors": KNeighborsClassifier()
}

# Initialize a dictionary to store AUC - ROC scores
roc_auc_scores = {}

# Plot the ROC curves
plt.figure(figsize=(10, 8))

for name, model in models.items():
    # Train the model
    model.fit(X_train, y_train)

    # Predict the probabilities
    y_probs = model.predict_proba(X_test)[:, 1]

    # Calculate the AUC - ROC score
    roc_auc = roc_auc_score(y_test, y_probs)
    roc_auc_scores[name] = roc_auc

    # Compute ROC curve
    fpr, tpr, _ = roc_curve(y_test, y_probs)

    # Plot ROC curve
    plt.plot(fpr, tpr, lw=2, label=f'{name} (AUC = {roc_auc:.2f})')

# Plot the diagonal 50% line
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')

# Customize the plot
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('ROC Curve Comparison')
plt.legend(loc="lower right")
plt.show()

# Print the AUC - ROC scores for each model
for name, score in roc_auc_scores.items():
    print(f'{name}: AUC - ROC = {score:.2f}')
Per ogni oggetto modello ripetiamo fit() e predict_proba(), calcoliamo i corrispondenti FPR e TPR e poi tracciamo le rispettive curve.
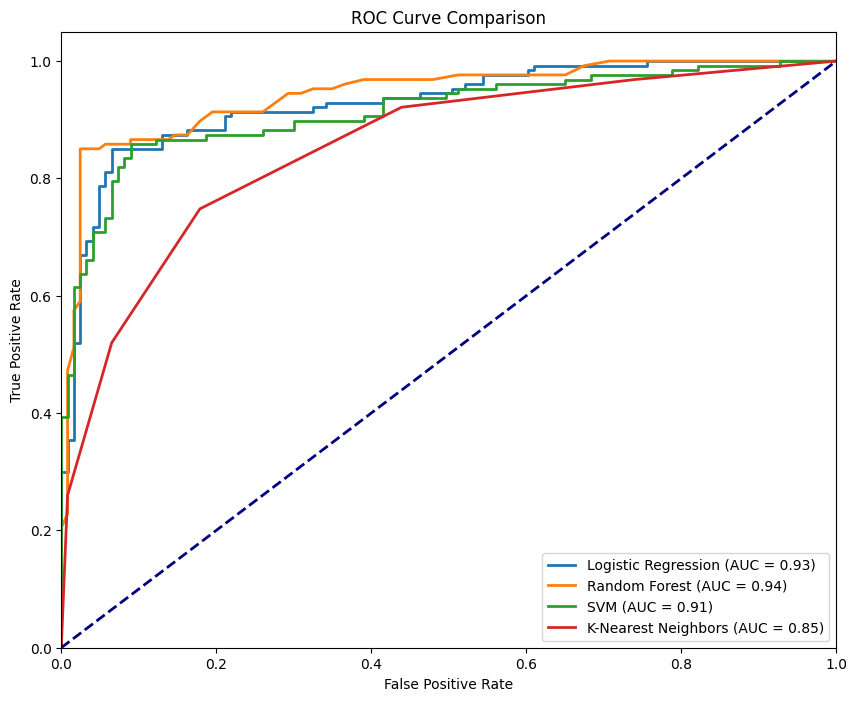
Curva ROC per modelli diversi. Immagine dell’autore
La figura sopra mostra le quattro curve corrispondenti ai quattro classificatori: il RandomForestClassifier è il migliore con un’AUC-ROC di 0,94, mentre il KNeighborsClassifier è il peggiore con un’AUC-ROC di 0,85. Un modello ideale “abbraccia” l’angolo in alto a sinistra del grafico—dove il TPR è massimizzato e l’FPR minimizzato. Più la curva si avvicina a questo punto, migliori sono le prestazioni del modello.
Scomponiamo le metriche fornite dalla curva AUC-ROC e capiamone il significato.
I valori AUC forniscono un riferimento rapido per capire quanto bene sta funzionando il modello. Quando l’AUC è vicina a 1, il modello è al top: mostra ottime prestazioni con una forte capacità di distinguere tra le classi. Un’AUC attorno a 0,5 è preoccupante, perché indica che il modello non fa meglio di un’ipotesi casuale, segnalando assenza di potere discriminante. Un punteggio AUC vicino a 0 è allarmante: indica che il modello sta sbagliando completamente, peggio di un lancio di moneta.
TPR, o sensitivity, è una metrica fondamentale che indica quanto bene il modello cattura le istanze positive. Il TPR è calcolato come la proporzione di positivi reali identificati correttamente dal modello. È un indicatore chiave dell’efficacia del modello nel rilevare i segnali veri (positivi). Un TPR alto significa che il modello sta facendo un ottimo lavoro nel riconoscere ciò che conta di più.
Sul lato opposto, l’FPR ci aiuta a capire il rumore—quanto spesso il modello identifica falsamente i negativi come positivi. L’FPR è la proporzione di negativi reali che il modello segnala erroneamente come positivi. È una metrica vitale per valutare i trade-off che il modello sta facendo. Un FPR alto indica una tendenza a generare falsi allarmi, che possono essere costosi a seconda dell’applicazione.
La bellezza e la sfida della classificazione binaria risiedono nelle impostazioni del threshold: così si rifiniscono sensibilità (TPR) e specificità (1 - FPR) del modello. Possiamo controllare quanto il modello è sensibile nel rilevare istanze della classe positiva e ridurre i falsi positivi regolando il threshold. Nella maggior parte degli scenari reali, il costo dei falsi negativi (mancare un positivo) rispetto ai falsi positivi (falsi allarmi) può variare significativamente.
L’AUC-ROC non è solo un concetto teorico; ecco come questa metrica pratica viene usata in vari settori per guidare decisioni critiche:
L’AUC-ROC è usata per confrontare test diagnostici diversi. È particolarmente utile quando il costo dei falsi negativi (per esempio, non rilevare una malattia) può essere molto più alto dei falsi positivi (per esempio, un trattamento non necessario). Un esempio rilevante è lo screening oncologico, dove la soglia per ulteriori esami può essere regolata in base ai fattori di rischio e alla disponibilità di risorse.
I modelli di machine learning sono sempre più usati per identificare attività fraudolente nel settore finanziario. Poiché le transazioni fraudolente sono relativamente rare, questi dataset sono altamente sbilanciati. Pertanto, l’AUC-ROC è una metrica di valutazione efficace che consente anche di regolare il threshold in base a vari fattori, come l’entità del rischio della transazione, il costo della verifica manuale di ogni transazione e il costo dell’inconveniente per il cliente.
Analogamente al rilevamento delle frodi, anche gli attacchi informatici sono eventi relativamente rari. Di conseguenza, l’AUC-ROC trova applicazione anche nella cybersecurity, bilanciando tra rilevare le minacce ed evitare la fatica da allerta dovuta ai falsi positivi.
L’AUC-ROC è una metrica popolare per valutare i modelli di classificazione binaria, ma esistono scenari in cui metriche alternative possono essere più adatte. Esploriamone alcune e quando usarle:
La precision-recall curve (PRC) è una metrica per dataset sbilanciati che incide notevolmente sul valore del modello di machine learning quando falsi positivi e falsi negativi hanno costi diversi. A differenza dell’AUC-ROC, che può dare una visione ottimistica fuorviante in dataset sbilanciati, la PRC si concentra maggiormente sulle prestazioni rispetto alla classe positiva.
L’F1 score è la media armonica di precision e recall e fornisce una singola metrica che bilancia entrambe. Si usa quando serve un riassunto chiaro e compatto delle prestazioni del modello, soprattutto con dataset sbilanciati. L’AUC-ROC offre una visione più globale, mentre l’F1 è un punto specifico sulla curva PRC.
L’AUC-ROC è uno standard di riferimento nei problemi di classificazione binaria perché offre una visione più equilibrata di come il modello si comporta ai diversi threshold, soprattutto in scenari di sbilanciamento delle classi.
Crediamo che il modo migliore per consolidare l’apprendimento sia la pratica. La versatilità di Python ci offre l’occasione perfetta per padroneggiare i concetti essenziali. Che si tratti di ripassare le basi o di esplorare argomenti più avanzati, questo è il momento ideale per immergersi. Rivediamo le basi di Python e mettiamoci alla prova lavorando con l’AUC-ROC su dataset complessi.
Impara Python e Statistica con DataCamp
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



