
Kurs
Python ile İstatistiğe Giriş
4 sa
200.6K
ROC eğrisi, çeşitli eşiklerde gerçek pozitif oranı (TPR) ile yanlış pozitif oranı (FPR) arasındaki ödünleşimleri görselleştirir. Farklı eşiklerde pozitif örnekleri tespit etme ile yanlış pozitiflerden kaçınma arasındaki dengeyi modelin ne kadar iyi kurabildiğine dair içgörüler sunar. AUC, yani Eğri Altındaki Alan, 0 ile 1 arasında tek bir skaler değerdir ve modelin performansına anlık bir bakış sunar. AUC, eğrinin altında kalan alanı temsil ettiğinden, ROC eğrisini oluşturduktan sonra hesaplanır.
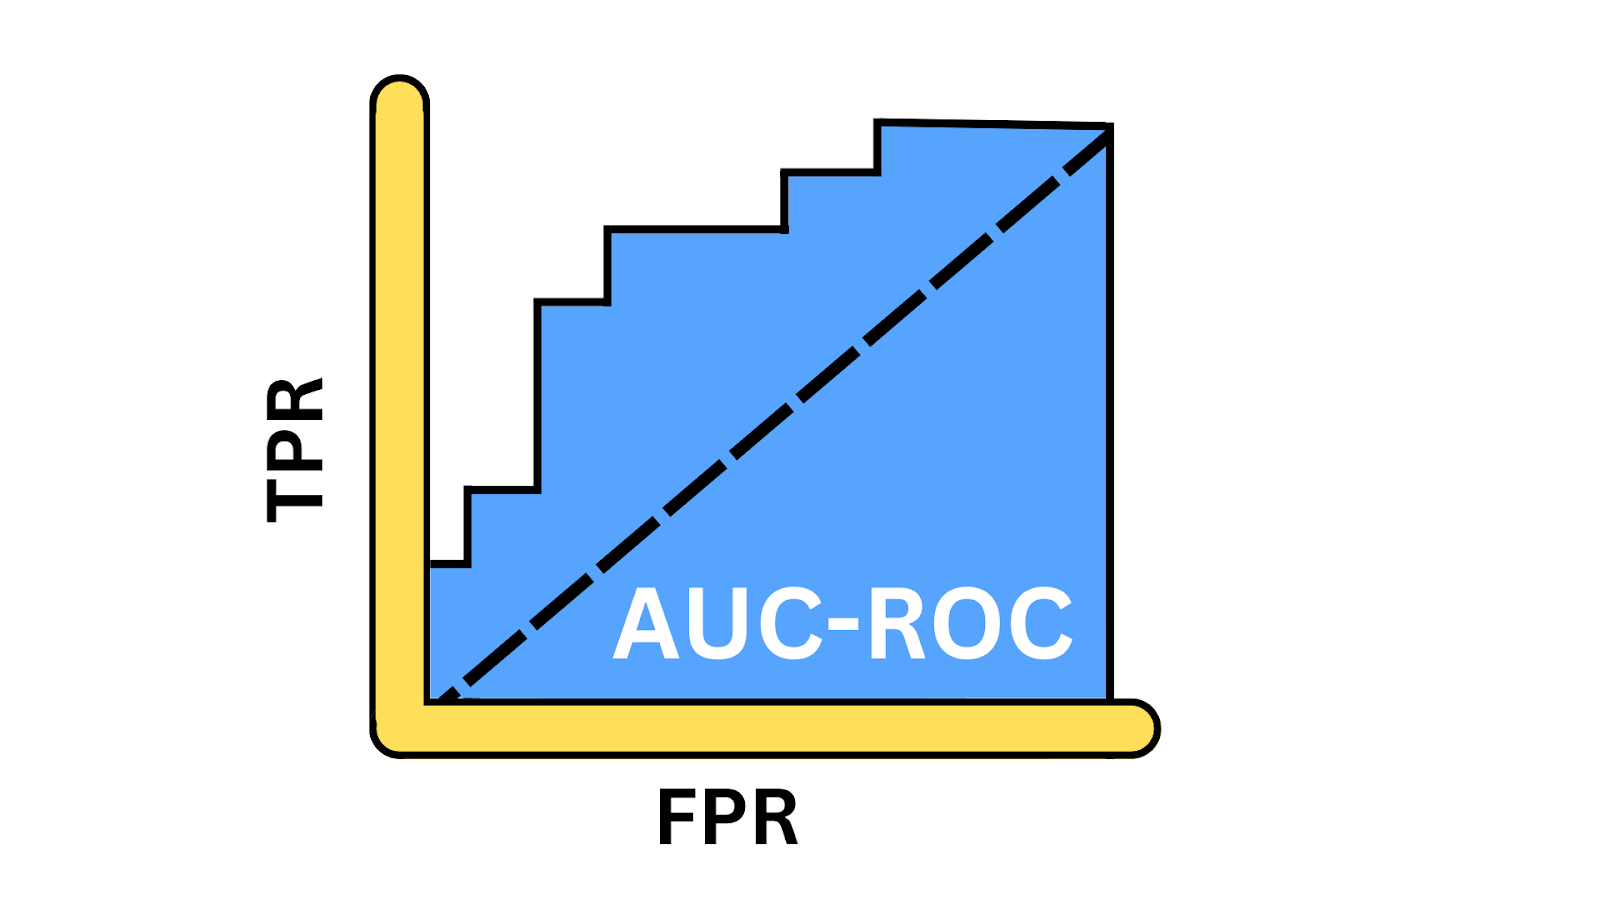
AUC-ROC Eğrisi görselleştirmesi. Görsel: Yazar
Duyarlılık ya da recall olarak da bilinen gerçek pozitif oranı, bir modelin pozitif örnekleri doğru şekilde tanımlama becerisini yansıtır. Modelin başarıyla belirlediği gerçek pozitif vakaların oranını ölçer. Matematiksel olarak bu, aşağıdaki denklemle ifade edilebilir:
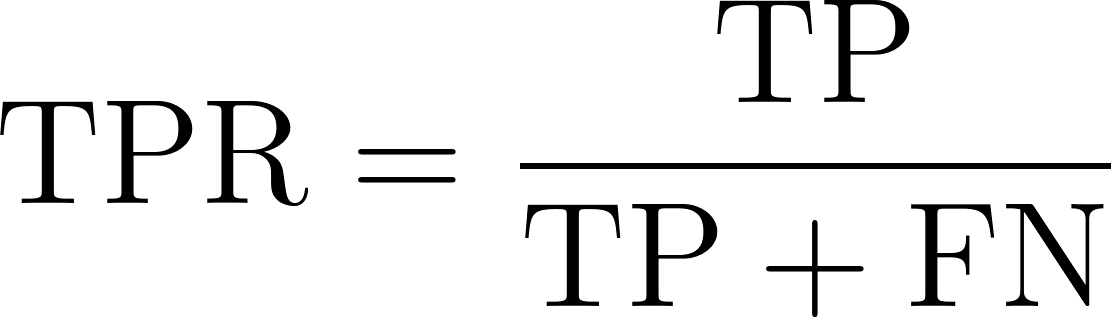
Burada:
FPR, modelimizin negatif sınıf örneklerini ne sıklıkla yanlışlıkla pozitif olarak sınıflandırdığını temsil eder. Model tarafından yanlış şekilde pozitif olarak tanımlanan gerçek negatif örneklerin oranını ölçer ve yanlış alarm oranını gösterir. Matematiksel olarak şu şekilde ifade edilir.
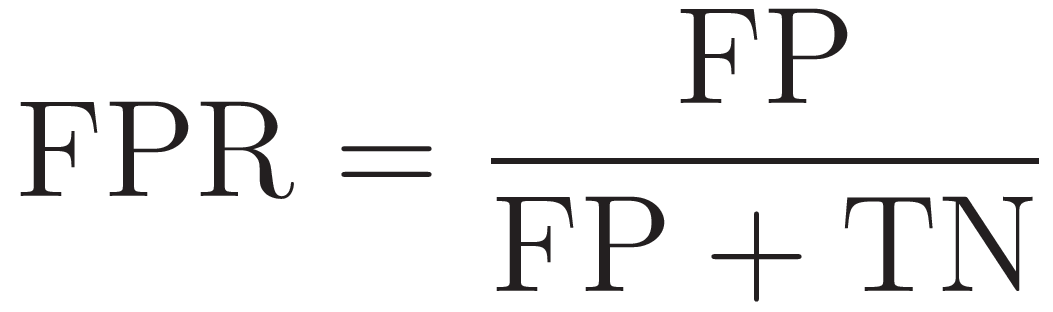
Burada:
AUC-ROC'un daha ilgili bir metrik olduğu senaryoları anlayalım.
AUC-ROC, tüm olası sınıflandırma eşikleri genelinde birleştirilmiş bir performans ölçüsü sunar. Belirli bir eşiğe bağlı olan doğruluk (accuracy), kesinlik veya F1 skordan farklı olarak, modelin farklı çalışma noktalarındaki performansını dikkate alır.
AUC-ROC, sınıflandırma eşiğinden bağımsız olarak birden çok modeli karşılaştırmayı kolaylaştıran tek bir skaler değerdir. Eşik bağımsız doğası, en iyi eşikleri farklı olan modeller arasında adil bir karşılaştırma yapmak için daha iyi bir seçimdir.
Gerçek hayattaki veri kümelerinin çoğu, bir sınıfın diğerine kıyasla orantısız şekilde fazla olduğu dengesiz yapılardır; örneğin duygu analizi, sahtecilik tespiti ve kanser tespiti. Bu gibi durumlarda, çoğunluk sınıfa yanlı oldukları için doğruluk gibi metrikler model performansına ilişkin yanıltıcı bir değerlendirme sunar. Böyle senaryolarda AUC-ROC gibi metrikler daha güvenilirdir.
Bazı kilit fikirlere göz atalım.
ROC eğrisini hayata geçirmek için farklı eşiklerde TPR ve FPR hesaplayacağız. Bu demo için gereken kütüphaneleri içe aktarmakla başlayalım.
from sklearn.model_selection import train_test_split
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score, accuracy_score, precision_score, recall_score, f1_score, confusion_matrix, roc_curve, auc
import matplotlib.pyplot as plt
Sonraki adımda, make-classification() fonksiyonunu kullanarak 1000 örnek ve 20 özellik içeren bir ikili sınıflandırma veri kümesi oluşturacağız.
# Generate a binary classification dataset
X, y = make_classification(n_samples=1000, n_features=20, n_classes=2, random_state=0)
Veri kümesini eğitim ve test verisine bölelim–modeli eğitim kümesi üzerinde eğitecek ve performansını görülmemiş test veri kümesinde ölçeceğiz.
# Split the dataset into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)
Ardından, LogisticRegression() sınıfını çağırarak model nesnesini tanımlar ve fit yöntemiyle eğitim verisi üzerinde eğitiriz; burada X_train özellikleri, y_train ise etiketleri temsil eder.
# Train a Logistic Regression model
model = LogisticRegression()
model.fit(X_train, y_train)
Artık model eğitildi ve tahmin üretmeye hazır. Pozitif sınıfın olasılığını üretmek için predict_proba() fonksiyonunu çağırıyoruz. Doğruluk, kesinlik, duyarlılık ve F1 skoru gibi değerlendirme metriklerini hesaplamak için predict() yöntemini kullanıyoruz.
# Predict the probabilities for the test set
y_probs = model.predict_proba(X_test)[:, 1]

# Predict the classes for the test set
y_pred = model.predict(X_test)
Sonraki adımda, bu metriklerin tümünü ilgili fonksiyonlarıyla hesaplayıp yazdırıyoruz.
# Calculate the AUC - ROC score
roc_auc = roc_auc_score(y_test, y_probs)

# Calculate other metrics
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)

# Print the metrics
print(f"AUC - ROC Score: {roc_auc:.2f}")
print(f"Accuracy: {accuracy:.2f}")
print(f"Precision: {precision:.2f}")
print(f"Recall: {recall:.2f}")
print(f"F1 Score: {f1:.2f}")
AUC-ROC Score: 0.93
Accuracy: 0.87
Precision: 0.87
Recall: 0.87
F1 Score: 0.87Şimdi, rastgele şans modelini temsil eden diyagonal çizgiyle birlikte ROC eğrisini görselleştirelim. Bunu hesaplamak için 0 ile 1 arasındaki her ayrık eşik için FPR ve TPR gerekir. Aşağıdaki grafikte turuncu eğri ROC’yi temsil eder ve bu eğrinin altındaki alan 0,93’tür.
# Plotting the ROC Curve
fpr, tpr, thresholds = roc_curve(y_test, y_probs)
roc_auc = auc(fpr, tpr)

plt.figure()
plt.plot(fpr, tpr, color='darkorange', lw=2, label=f'ROC curve (area = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('Receiver Operating Characteristic')
plt.legend(loc="lower right")
plt.show()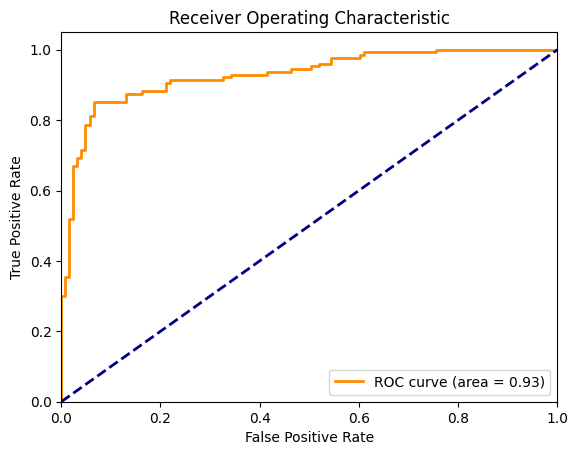
Lojistik regresyon için ROC eğrisi. Görsel: Yazar
Şimdi, aynı veri kümesini kullanarak dört sınıflandırma algoritmasının performansını ROC ile karşılaştıralım. RandomForestClassifier, KNeighborsClassifier ve SVC'yi içe aktararak başlayacak ve bunları LogisticRegression ile karşılaştıracağız.
from sklearn.ensemble import RandomForestClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC

# Define the models
models = {
    "Logistic Regression": LogisticRegression(),
    "Random Forest": RandomForestClassifier(),
    "SVM": SVC(probability=True),
    "K-Nearest Neighbors": KNeighborsClassifier()
}

# Initialize a dictionary to store AUC - ROC scores
roc_auc_scores = {}

# Plot the ROC curves
plt.figure(figsize=(10, 8))

for name, model in models.items():
    # Train the model
    model.fit(X_train, y_train)

    # Predict the probabilities
    y_probs = model.predict_proba(X_test)[:, 1]

    # Calculate the AUC - ROC score
    roc_auc = roc_auc_score(y_test, y_probs)
    roc_auc_scores[name] = roc_auc

    # Compute ROC curve
    fpr, tpr, _ = roc_curve(y_test, y_probs)

    # Plot ROC curve
    plt.plot(fpr, tpr, lw=2, label=f'{name} (AUC = {roc_auc:.2f})')

# Plot the diagonal 50% line
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')

# Customize the plot
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('ROC Curve Comparison')
plt.legend(loc="lower right")
plt.show()

# Print the AUC - ROC scores for each model
for name, score in roc_auc_scores.items():
    print(f'{name}: AUC - ROC = {score:.2f}')
Her model nesnesi için fit() ve predict_proba() adımlarını tekrarlar, karşılık gelen FPR ve TPR'yi hesaplar ve ardından kendi eğrilerini çizeriz.
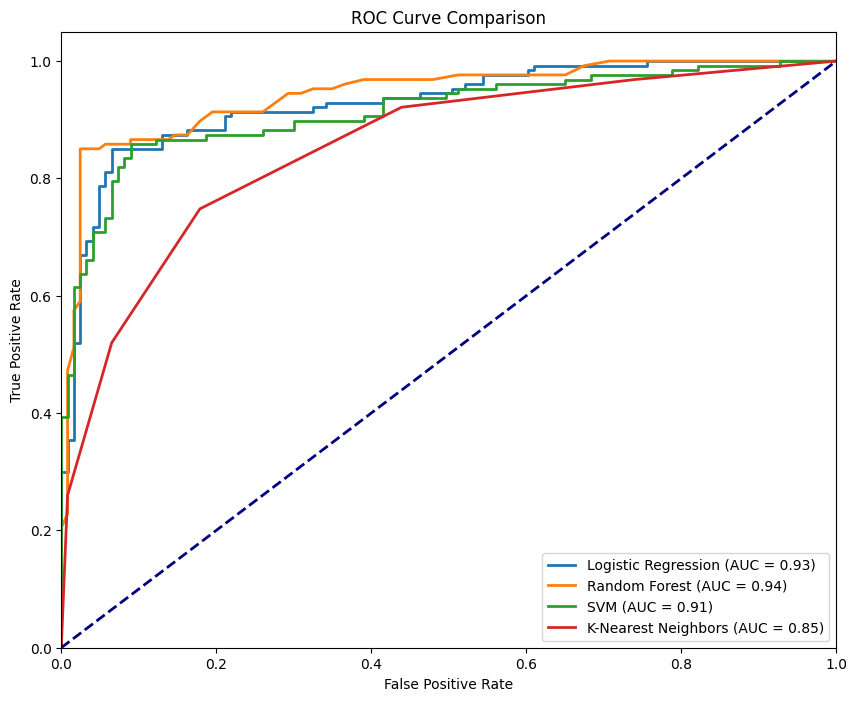
Farklı modeller için ROC eğrisi. Görsel: Yazar
Yukarıdaki şekil, dört sınıflandırıcıya karşılık gelen dört eğriyi göstermektedir; burada RandomForestClassifier 0,94 AUC-ROC ile en iyi performansı sergilerken KNeighborsClassifier 0,85 AUC-ROC ile en düşük performansı göstermektedir. İdeal bir model, grafiğin sol üst köşesine yaklaşır—TPR'nin en yüksek, FPR'nin en düşük olduğu yer. Eğri bu noktaya ne kadar yaklaşırsa modelin performansı o kadar iyidir.
AUC-ROC eğrisinin sunduğu metrikleri parçalara ayıralım ve önemlerini anlayalım.
AUC değerleri, modelin ne kadar iyi performans gösterdiğini hızlıca anlamak için başvurulacak bir referans sunar. AUC 1’e yaklaştığında modelimiz en iyi formundadır. Sınıfları ayırt etme konusunda güçlü bir yetkinlik ve mükemmele yakın performans gösterir. AUC'nin 0,5 civarında olması endişe vericidir; modelin rastgele tahminden daha iyi olmadığını ve ayrıştırma gücü bulunmadığını gösterir. AUC'nin 0’a yaklaşması ise alarm vericidir; modelin tamamen tersini yaptığına, yazı tura atmaktan bile kötü olduğuna işaret eder.
TPR, yani duyarlılık, modelimizin pozitif örnekleri ne kadar iyi yakaladığını söyleyen kritik bir metriktir. TPR, model tarafından doğru tanımlanan gerçek pozitiflerin oranı olarak hesaplanır. Gerçek sinyalleri (pozitifleri) tespit etmedeki etkinliğin kilit bir göstergesidir. Yüksek TPR, modelimizin en önemli olanı tanıma konusunda iyi iş çıkardığı anlamına gelir.
Diğer yandan FPR, modelimizin negatifleri ne sıklıkla pozitif olarak yanlış tanımladığını, yani gürültüyü anlamamıza yardımcı olur. FPR, modelimizin yanlış biçimde pozitif olarak işaretlediği gerçek negatiflerin oranıdır. Modelimizin yaptığı ödünleşimleri değerlendirmek için hayati bir metriktir. Yüksek FPR, yanlış alarmlara yatkınlığı gösterir; bu da uygulamaya bağlı olarak maliyetli olabilir.
İkili sınıflandırmanın güzelliği ve zorluğu eşik ayarlarında yatar; bu nedenle modelimizin duyarlılığını (TPR) ve özgüllüğünü (1 - FPR) ince ayarlarız. Eşiği ayarlayarak modelimizin pozitif sınıf örneklerini tespit etme hassasiyetini kontrol edebilir ve yanlış pozitifleri azaltabiliriz. Çoğu gerçek dünya senaryosunda, yanlış negatiflerin (pozitifi kaçırmak) ve yanlış pozitiflerin (yanlış alarm) maliyeti önemli ölçüde değişebilir.
AUC-ROC yalnızca teorik bir kavram değildir; bu pratik metrik, sektörler genelinde kritik kararları yönlendirmek için şu şekilde kullanılır:
AUC-ROC, farklı tanı testlerini karşılaştırmak için kullanılır. Yanlış negatiflerin (örneğin bir hastalığın gözden kaçması) maliyetinin, yanlış pozitiflerden (örneğin gereksiz tedavi) çok daha yüksek olabildiği durumlarda özellikle yararlıdır. Kayda değer bir örnek, risk faktörlerine ve kaynak mevcudiyetine göre ileri test eşiğinin ayarlanabildiği kanser taramalarıdır.
Makine öğrenimi modelleri finans sektöründe sahte işlemleri tespit etmek için giderek daha fazla kullanılıyor. Sahte işlemler oldukça nadir olduğundan bu tür veri kümeleri oldukça dengesizdir. Bu nedenle AUC-ROC, aynı zamanda eşiğin; işlemin içerdiği riskin büyüklüğü, her işlemin manuel doğrulama maliyeti ve müşteri rahatsızlığının maliyeti gibi faktörlere göre ayarlanmasına imkân veren etkili bir değerlendirme metriğidir.
Sahtecilik tespitine benzer şekilde, siber saldırılar da nispeten nadir olaylardır. Dolayısıyla AUC-ROC, tehditleri tespit etmek ile yanlış pozitiflerden kaynaklanan alarm yorgunluğundan kaçınmak arasındaki dengeyi kurarak siber güvenlikte de kullanım alanı bulur.
AUC-ROC, ikili sınıflandırma modellerini değerlendirmek için popüler bir metriktir; ancak bazı durumlarda alternatif metrikler daha uygun olabilir. Bazı alternatiflere ve ne zaman kullanılacaklarına bakalım:
Kesinlik-duyarlılık eğrisi (PRC), yanlış pozitif ve yanlış negatiflerin farklı maliyetlere sahip olduğu dengesiz veri kümeleri için uygun bir metriktir. Dengesiz veri kümelerinde yanıltıcı şekilde iyimser bir tablo çizebilen AUC-ROC’tan farklı olarak PRC, pozitif sınıfa ilişkin performansa daha fazla odaklanır.
F1 skoru, kesinlik ve duyarlılığın harmonik ortalamasıdır ve ikisini dengeleyen tek bir metrik sunar. Özellikle dengesiz veri kümelerinde, model performansına ilişkin net, tek sayılık bir özet gerektiğinde kullanılır. AUC-ROC daha küresel bir bakış sağlarken, F1 PRC eğrisi üzerindeki belirli bir noktadır.
AUC-ROC, özellikle sınıf dengesizliğinin söz konusu olduğu durumlarda, modelin farklı eşikler genelinde ne kadar iyi performans gösterdiğine daha dengeli bir bakış sunduğu için ikili sınıflandırma problemlerinde altın standarttır.
Öğrendiklerimizi pekiştirmenin en iyi yolunun uygulama olduğuna inanıyoruz. Python’un esnekliği bize temel kavramları ustalıkla öğrenmek için mükemmel bir fırsat sunar. temellerimizi tazeliyor ya da daha ileri konuları keşfediyor olalım, şimdi derine dalmak için ideal zaman. Python temel bilgilerimizi gözden geçirelim ve AUC-ROC ile karmaşık veri kümeleri üzerinde çalışarak kendimize meydan okuyalım.
DataCamp ile Python ve İstatistik Öğrenin
Kurs
Kurs
Program
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




