
Khóa học
Nhập môn Thống kê với Python
4 giờ
200.5K
Đường cong ROC cung cấp biểu diễn trực quan về sự đánh đổi giữa tỷ lệ dương tính thật (TPR) và tỷ lệ dương tính giả (FPR) tại các ngưỡng khác nhau. Nó cho biết mô hình cân bằng giữa việc phát hiện các điểm dương tính và tránh dương tính giả trên các ngưỡng khác nhau tốt đến đâu. AUC, hay Diện tích Dưới đường cong, là một giá trị vô hướng đơn lẻ trong khoảng từ 0 đến 1, cung cấp ảnh chụp nhanh về hiệu năng của mô hình. Bạn chỉ tính AUC sau khi vẽ đường cong ROC vì AUC chính là diện tích bên dưới đường cong đó.
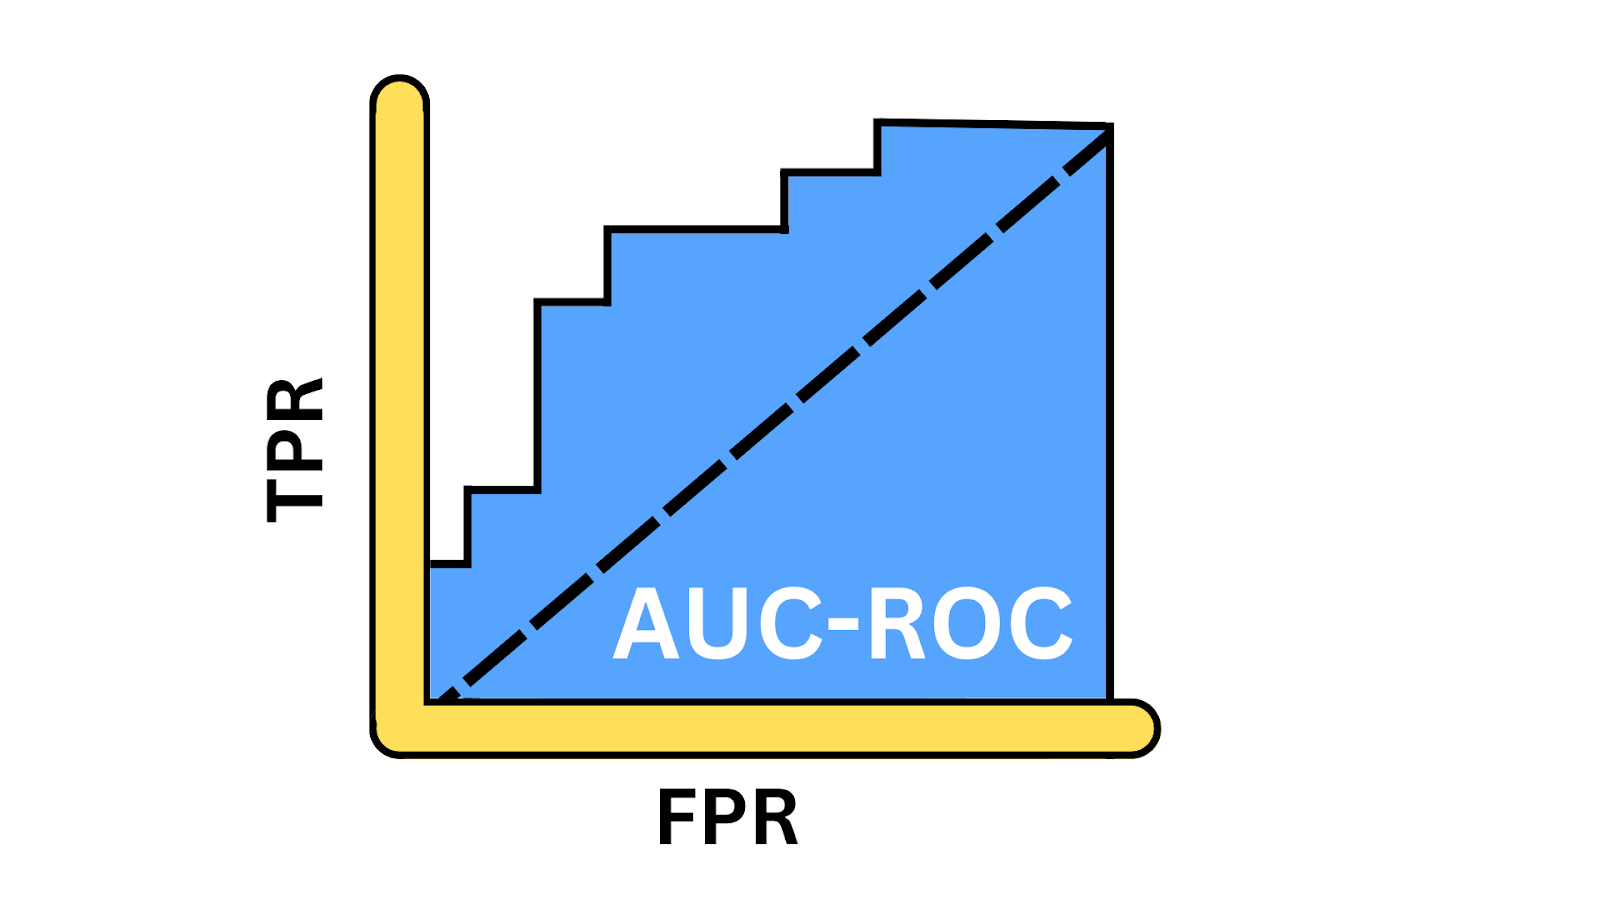
Minh họa đường cong AUC-ROC. Ảnh: Tác giả
Tỷ lệ dương tính thật, còn gọi là độ nhạy hoặc recall, phản ánh khả năng của mô hình trong việc nhận diện đúng các điểm dương tính. Nó đo lường tỷ lệ các trường hợp dương tính thực sự được mô hình nhận diện thành công. Về mặt toán học, có thể biểu diễn bằng phương trình sau:
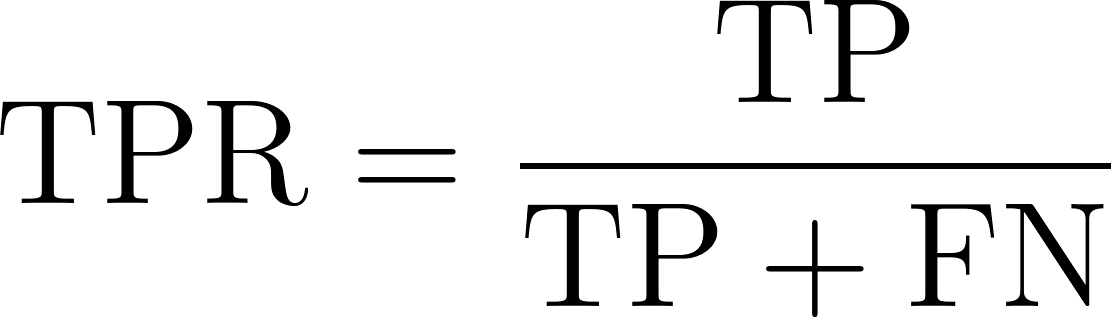
Trong đó:
FPR biểu thị tần suất mô hình phân loại sai các điểm thuộc lớp âm tính thành dương tính. Nó đo lường tỷ lệ các điểm âm tính thực sự bị mô hình nhận diện nhầm thành dương tính, cho thấy mức độ báo động giả. Về mặt toán học có thể biểu diễn như sau.
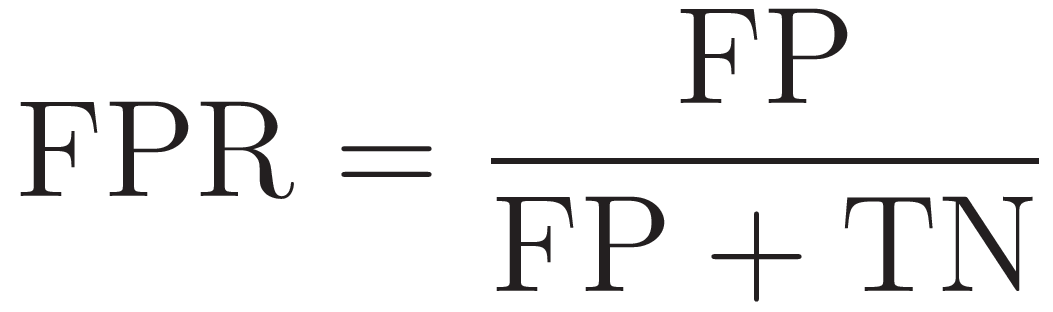
Trong đó:
Hãy cùng xem các tình huống AUC-ROC là chỉ số phù hợp hơn.
AUC-ROC cung cấp thước đo hiệu năng tổng hợp trên mọi ngưỡng phân loại có thể. Khác với accuracy, precision hay F1-score phụ thuộc vào một ngưỡng cụ thể, chỉ số này xem xét hiệu năng mô hình tại các điểm vận hành khác nhau.
AUC-ROC là một giá trị vô hướng duy nhất giúp việc so sánh nhiều mô hình dễ dàng hơn, bất kể ngưỡng phân loại của chúng. Tính độc lập với ngưỡng giúp nó là lựa chọn tốt hơn để so sánh công bằng giữa các mô hình có ngưỡng tối ưu khác nhau.
Hầu hết các tập dữ liệu thực tế đều mất cân bằng, khi một lớp chiếm ưu thế hơn hẳn lớp còn lại, ví dụ như phân tích cảm xúc, phát hiện gian lận và phát hiện ung thư. Trong các trường hợp như vậy, các chỉ số như accuracy đưa ra đánh giá sai lệch về hiệu năng mô hình do thiên lệch về lớp đa số. Khi đó, các chỉ số như AUC-ROC đáng tin cậy hơn.
Hãy cùng xem một số ý tưởng then chốt.
Để vẽ đường cong ROC, chúng ta sẽ tính TPR và FPR tại nhiều ngưỡng khác nhau. Bắt đầu bằng cách nhập các thư viện cần thiết cho ví dụ này.
from sklearn.model_selection import train_test_split
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score, accuracy_score, precision_score, recall_score, f1_score, confusion_matrix, roc_curve, auc
import matplotlib.pyplot as plt
Tiếp theo, chúng ta sẽ tạo một tập dữ liệu phân loại nhị phân bằng hàm make-classification(), với 1000 mẫu và 20 đặc trưng.
# Generate a binary classification dataset
X, y = make_classification(n_samples=1000, n_features=20, n_classes=2, random_state=0)
Hãy chia tập dữ liệu thành dữ liệu huấn luyện và kiểm tra–chúng ta sẽ huấn luyện mô hình trên tập huấn luyện và đo lường hiệu năng trên tập kiểm tra chưa thấy.
# Split the dataset into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)
Tiếp theo, chúng ta định nghĩa đối tượng mô hình bằng cách gọi lớp LogisticRegression() rồi huấn luyện nó bằng phương thức fit trên dữ liệu huấn luyện, trong đó X_train là các đặc trưng và y_train là nhãn.
# Train a Logistic Regression model
model = LogisticRegression()
model.fit(X_train, y_train)
Giờ đây mô hình đã được huấn luyện và sẵn sàng tạo dự đoán. Chúng ta gọi hàm predict_proba() để tạo xác suất thuộc lớp dương tính. Chúng ta dùng phương thức predict() để tính các chỉ số đánh giá như accuracy, precision, recall và F1-score.
# Predict the probabilities for the test set
y_probs = model.predict_proba(X_test)[:, 1]

# Predict the classes for the test set
y_pred = model.predict(X_test)
Tiếp theo, chúng ta tính và in tất cả các chỉ số này bằng những hàm tương ứng.
# Calculate the AUC - ROC score
roc_auc = roc_auc_score(y_test, y_probs)

# Calculate other metrics
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)

# Print the metrics
print(f"AUC - ROC Score: {roc_auc:.2f}")
print(f"Accuracy: {accuracy:.2f}")
print(f"Precision: {precision:.2f}")
print(f"Recall: {recall:.2f}")
print(f"F1 Score: {f1:.2f}")
AUC-ROC Score: 0.93
Accuracy: 0.87
Precision: 0.87
Recall: 0.87
F1 Score: 0.87Bây giờ, hãy trực quan hóa đường cong ROC cùng với đường chéo biểu thị mô hình đoán ngẫu nhiên. Để tính toán điều này, chúng ta cần FPR và TPR cho mỗi ngưỡng rời rạc giữa 0 và 1. Trên đồ thị dưới đây, đường cong màu cam là ROC và diện tích dưới đường cong này là 0.93.
# Plotting the ROC Curve
fpr, tpr, thresholds = roc_curve(y_test, y_probs)
roc_auc = auc(fpr, tpr)

plt.figure()
plt.plot(fpr, tpr, color='darkorange', lw=2, label=f'ROC curve (area = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('Receiver Operating Characteristic')
plt.legend(loc="lower right")
plt.show()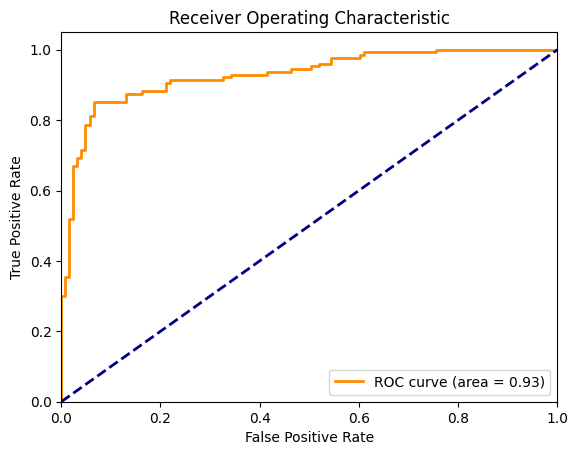
Đường cong ROC cho hồi quy logistic. Ảnh: Tác giả
Giờ hãy dùng cùng một tập dữ liệu và so sánh hiệu năng của bốn thuật toán phân loại bằng ROC. Chúng ta sẽ bắt đầu bằng cách nhập RandomForestClassifier, KNeighborsClassifier và SVC rồi so sánh chúng với LogisticRegression.
from sklearn.ensemble import RandomForestClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC

# Define the models
models = {
    "Logistic Regression": LogisticRegression(),
    "Random Forest": RandomForestClassifier(),
    "SVM": SVC(probability=True),
    "K-Nearest Neighbors": KNeighborsClassifier()
}

# Initialize a dictionary to store AUC - ROC scores
roc_auc_scores = {}

# Plot the ROC curves
plt.figure(figsize=(10, 8))

for name, model in models.items():
    # Train the model
    model.fit(X_train, y_train)

    # Predict the probabilities
    y_probs = model.predict_proba(X_test)[:, 1]

    # Calculate the AUC - ROC score
    roc_auc = roc_auc_score(y_test, y_probs)
    roc_auc_scores[name] = roc_auc

    # Compute ROC curve
    fpr, tpr, _ = roc_curve(y_test, y_probs)

    # Plot ROC curve
    plt.plot(fpr, tpr, lw=2, label=f'{name} (AUC = {roc_auc:.2f})')

# Plot the diagonal 50% line
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')

# Customize the plot
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('ROC Curve Comparison')
plt.legend(loc="lower right")
plt.show()

# Print the AUC - ROC scores for each model
for name, score in roc_auc_scores.items():
    print(f'{name}: AUC - ROC = {score:.2f}')
Với mỗi đối tượng mô hình, chúng ta lặp lại fit() và predict_proba(), tính FPR và TPR tương ứng, rồi vẽ các đường cong của chúng.
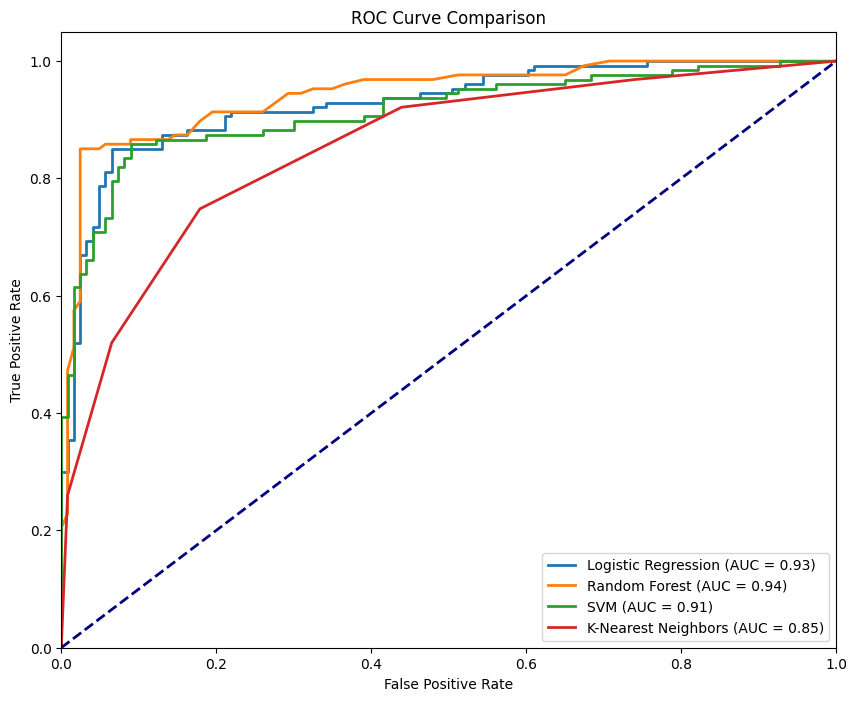
Đường cong ROC cho các mô hình khác nhau. Ảnh: Tác giả
Hình trên thể hiện bốn đường cong tương ứng với bốn bộ phân loại, trong đó RandomForestClassifier hoạt động tốt nhất với AUC-ROC là 0.94 còn KNeighborsClassifier kém nhất với AUC-ROC là 0.85. Một mô hình lý tưởng sẽ ôm sát góc trên bên trái của biểu đồ—nơi TPR được tối đa hóa và FPR được tối thiểu hóa. Đường cong càng tiến gần điểm này, hiệu năng mô hình càng tốt.
Hãy phân tích các chỉ số mà đường cong AUC-ROC cung cấp và hiểu ý nghĩa của chúng.
Giá trị AUC cho bạn tham chiếu nhanh để hiểu mô hình hoạt động tốt đến đâu. Khi AUC gần 1, mô hình của chúng ta đang ở phong độ cao: hiệu năng xuất sắc với khả năng phân biệt lớp mạnh. AUC quanh 0.5 là điều đáng lo, vì cho thấy mô hình không tốt hơn đoán ngẫu nhiên, tức không có năng lực phân biệt. Điểm AUC gần 0 là tình huống báo động: mô hình mắc sai hoàn toàn, thậm chí tệ hơn tung đồng xu.
TPR, hay độ nhạy, là chỉ số quan trọng cho biết mô hình bắt được các điểm dương tính tốt đến đâu. TPR được tính là tỷ lệ dương tính thực sự được mô hình nhận diện đúng. Đây là chỉ báo then chốt về mức độ hiệu quả của mô hình trong việc phát hiện tín hiệu thật (dương tính). TPR cao nghĩa là mô hình đang làm rất tốt trong việc nhận ra những gì quan trọng nhất.
Ngược lại, FPR giúp chúng ta hiểu về nhiễu—tần suất mô hình nhận diện nhầm các điểm âm tính thành dương tính. FPR là tỷ lệ các âm tính thực sự bị mô hình gắn nhầm là dương tính. Đây là chỉ số quan trọng để đánh giá sự đánh đổi mà mô hình đang thực hiện. FPR cao cho thấy xu hướng tạo ra báo động giả, có thể gây tốn kém tùy ứng dụng.
Vẻ đẹp và thách thức của phân loại nhị phân nằm ở thiết lập ngưỡng, do đó chúng ta tinh chỉnh độ nhạy (TPR) và độ đặc hiệu (1 - FPR) của mô hình. Ta có thể kiểm soát mức độ nhạy của mô hình với các điểm thuộc lớp dương tính và giảm dương tính giả bằng cách tinh chỉnh ngưỡng. Ở hầu hết các tình huống thực tế, chi phí của âm tính giả (bỏ sót dương tính) so với dương tính giả (báo động giả) có thể khác nhau đáng kể.
AUC-ROC không chỉ là khái niệm lý thuyết; đây là cách chỉ số thực tiễn này được dùng trong nhiều ngành để đưa ra các quyết định quan trọng:
AUC-ROC được dùng để so sánh các xét nghiệm chẩn đoán khác nhau. Nó đặc biệt hữu ích khi chi phí của âm tính giả (ví dụ, bỏ sót bệnh) có thể lớn hơn nhiều so với dương tính giả (ví dụ, điều trị không cần thiết). Một ví dụ đáng chú ý là sàng lọc ung thư, nơi ngưỡng để xét nghiệm thêm có thể điều chỉnh dựa trên yếu tố rủi ro và nguồn lực sẵn có.
Các mô hình machine learning ngày càng được dùng để xác định hoạt động gian lận trong lĩnh vực tài chính. Do các giao dịch gian lận khá hiếm, các tập dữ liệu như vậy rất mất cân bằng. Vì thế, AUC-ROC là chỉ số đánh giá hiệu quả, đồng thời cho phép điều chỉnh ngưỡng dựa trên nhiều yếu tố như mức độ rủi ro của giao dịch, chi phí xác minh thủ công từng giao dịch và chi phí gây bất tiện cho khách hàng.
Tương tự phát hiện gian lận, các cuộc tấn công mạng cũng là sự kiện tương đối hiếm. Do đó, AUC-ROC cũng có ứng dụng trong an ninh mạng, cân bằng giữa việc phát hiện mối đe dọa và tránh tình trạng mệt mỏi vì cảnh báo do dương tính giả.
AUC-ROC là chỉ số phổ biến để đánh giá mô hình phân loại nhị phân, nhưng có những tình huống các chỉ số khác phù hợp hơn. Hãy cùng khám phá một số lựa chọn thay thế và khi nào nên dùng chúng:
Đường cong precision-recall (PRC) là chỉ số phù hợp cho các tập dữ liệu mất cân bằng, nơi chi phí của dương tính giả và âm tính giả khác nhau đáng kể, tác động lớn đến giá trị của mô hình machine learning. Khác với AUC-ROC có thể tạo ấn tượng lạc quan trong tập dữ liệu mất cân bằng, PRC tập trung hơn vào hiệu năng đối với lớp dương tính.
F1 là trung bình điều hòa của precision và recall, cung cấp một chỉ số đơn lẻ cân bằng cả hai. Nó được dùng khi chúng ta cần một con số tóm tắt rõ ràng về hiệu năng mô hình, đặc biệt trong các tập dữ liệu mất cân bằng. AUC-ROC cho cái nhìn tổng quát hơn, trong khi F1 là một điểm cụ thể trên đường cong PRC.
AUC-ROC là tiêu chuẩn vàng trong các bài toán phân loại nhị phân vì nó cung cấp cái nhìn cân bằng hơn về mức độ mô hình hoạt động trên các ngưỡng khác nhau, đặc biệt trong các tình huống mất cân bằng lớp.
Chúng tôi tin rằng cách tốt nhất để củng cố kiến thức là thực hành. Sự linh hoạt của Python cho chúng ta cơ hội hoàn hảo để nắm vững các khái niệm cốt lõi. Dù bạn đang ôn lại kiến thức nền tảng hay khám phá các chủ đề nâng cao hơn, bây giờ là thời điểm lý tưởng để bắt đầu. Hãy cùng ôn lại Python căn bản và thử thách bản thân bằng cách làm việc với AUC-ROC trên các tập dữ liệu phức tạp.
Học Python và Thống kê với DataCamp
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
