

设置 AWS Bedrock
本节将引导您完成必要的权限配置、创建 AWS 账户,并开始上手 AWS Bedrock。
步骤 1:创建 AWS 账户(如尚未创建)
如果您还没有账户,请前往 AWS 注册页面创建账户。对于现有用户,请确保您的 IAM 用户具备管理员权限。
AWS 注册页面,展示新账户可探索的免费套餐产品。
如需详细步骤,请访问 AWS 官方指南。
步骤 2:进入 AWS Bedrock
可通过 AWS 管理控制台访问 Amazon Bedrock。按照以下步骤查找并开始使用:
- 登录 AWS 管理控制台:前往 AWS 控制台并输入您的登录凭证。
- 搜索 Bedrock:使用控制台顶部的搜索栏,输入“Bedrock”,并在下拉列表中选择。
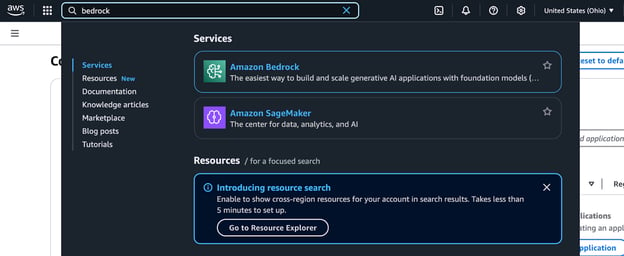
AWS 管理控制台关于 Bedrock 的搜索结果。
- 浏览 Bedrock 控制台:进入 Bedrock 控制台后,您将看到选择模型提供商与基础模型的选项。
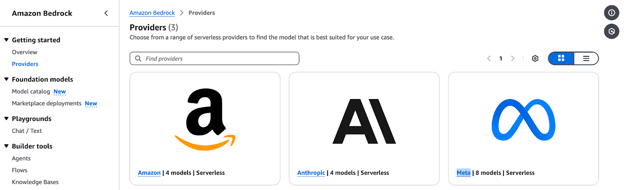
Amazon Bedrock Providers 页面展示来自 Amazon 的无服务器模型选项。
- 选择模型提供商与基础模型:
- 根据您的用例选择提供商(例如,文本生成可选 Amazon Titan,图像生成可选 Stability AI 等)。
- 查看模型特定选项,如输入类型、支持的功能以及输出参数。
- 运行测试推理:AWS Bedrock 允许您在控制台中直接运行示例推理。这是了解各模型工作方式的好方法,有助于在集成到应用前做出选择。
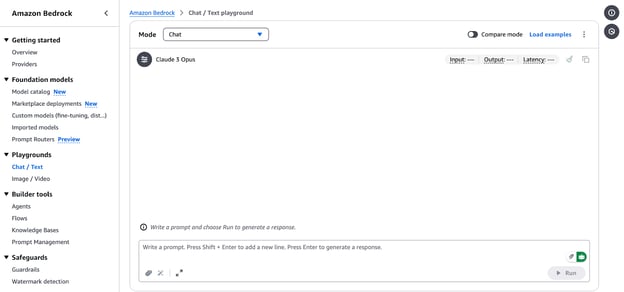
Amazon Bedrock 聊天/文本 Playground 界面。
步骤 3:配置 IAM 权限
AWS 身份与访问管理(IAM)对于安全访问 AWS Bedrock 至关重要。按照以下步骤配置权限:
- 在 AWS 管理控制台中,进入 IAM 服务。
- 在侧边栏点击 Roles,并选择 Create policy。
- 在 Specify permissions, 选择“JSON”。
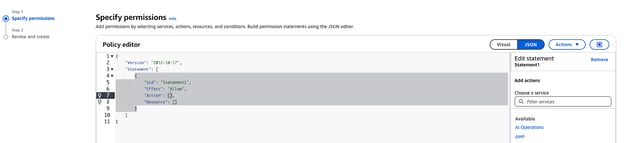
AWS IAM 策略编辑器(JSON 模式)
- 将以下策略粘贴到文本框:
{
"Version": "2012-10-17",
"Statement": [ {
"Sid": "BedrockFullAccess",
"Effect": "Allow",
"Action": ["bedrock:*"],
"Resource": "*"
}
]
}注意: 上述策略可附加到任何需要访问 Amazon Bedrock 服务的角色上。可以是 SageMaker 或用户。在使用 Amazon SageMaker 时,笔记本的执行角色通常不同于您登录 AWS 管理控制台所使用的用户或角色。若要通过 AWS 控制台体验 Amazon Bedrock 服务,请确保为您的控制台用户或角色授予权限。您可以在任何具备 AWS Bedrock 服务访问权限且拥有有效凭证的环境中运行笔记本。
将 Amazon Bedrock 用于生成式 AI 应用
生成式 AI 应用基于为特定任务(如文本生成、图像创建或数据转换)微调后的基础模型构建。以下是选择基础模型、使用基础推理作业以及调整模型响应以满足您需求的分步指南。
选择基础模型
挑选合适的基础模型至关重要,因为它取决于项目需求。您可以这样进行选择:
1. 明确您的用例:
- 文本生成:针对摘要、内容创作或聊天机器人开发等任务,可考虑以下模型:
- Amazon Titan Text G1:该模型具备良好的上下文理解能力,可生成高质量文本。
- Anthropic Claude 3:该模型擅长生成连贯且与语境相关的文本,适合对话式 AI 应用。
- 图像生成:如果您的项目涉及生成图像或其他形式的视觉内容,Stability AI 模型是不二之选:
- Stable Diffusion 3.5 Large:该模型擅长将文本描述转换为图像,无论是写实风格还是艺术风格。
- 多模态任务:对于同时需要文本与图像处理的应用,推荐使用 Amazon Nova 模型:
- Nova Lite:具成本优势的多模态模型,支持文本、图像与视频输入,并输出文本。
- Nova Pro:适用于更复杂任务的强大多模态模型。
2. 评估模型能力:
- 审视各模型的具体优势,确保与项目需求相匹配。有关受支持基础模型的详细信息(包括其能力与支持的区域)请参阅 AWS 文档。
启用模型访问
在使用这些模型之前,您需要在 AWS 账户中启用模型访问。配置步骤如下:
- 在 Bedrock 控制台中,导航到 Models access。
- 在控制台中点击 Modify model access.
- 浏览各提供商的可用模型并选择您喜欢的模型。本示例选择了 Titan Text G1—Express。
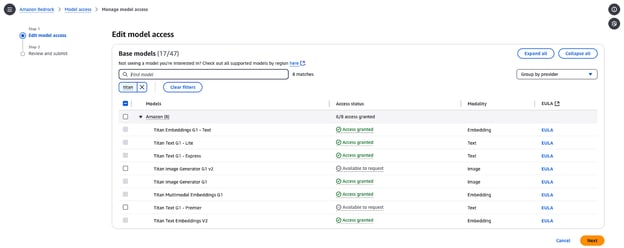
Amazon Bedrock 模型访问管理页面。
- 点击 Next,然后点击Review and submit。
运行基础推理
要使用 AWS Bedrock 中选定的基础模型执行推理,请按照以下步骤操作:
- 设置 AWS SDK for Python(boto3):
pip install boto3- 初始化 Bedrock 客户端: 在您选择的 AWS 区域中创建 Bedrock 运行时客户端:
import boto3
import json
from botocore.exceptions import ClientError
# 设置 AWS 区域
region = "us-east-1"
# 初始化 Bedrock Runtime 客户端
client = boto3.client("bedrock-runtime", region_name=region)- 调用模型: 定义模型 ID 和输入提示词:
# 定义 Amazon Titan Express v1 的模型 ID
model_id = "amazon.titan-text-express-v1"
# 定义输入提示词
prompt = """
Command: Compose an email from Tom, Customer Service Manager, to the customer "Nancy"
who provided negative feedback on the service provided by our customer support
Engineer"""- 构造请求载荷:
# 配置推理参数
inference_parameters = {
"inputText": prompt,
"textGenerationConfig": {
"maxTokenCount": 512, # 限制响应长度
"temperature": 0.5, # 控制输出的随机性
},
}
# 将请求载荷转换为 JSON
request_payload = json.dumps(inference_parameters)- 处理响应:
try:
# 调用模型
response = client.invoke_model(
modelId=model_id,
body=request_payload,
contentType="application/json",
accept="application/json"
)
# 解码响应主体
response_body = json.loads(response["body"].read())
# 提取并打印生成文本
generated_text = response_body["results"][0]["outputText"]
print("Generated Text:\n", generated_text)
except ClientError as e:
print(f"ClientError: {e.response['Error']['Message']}")
except Exception as e:
print(f"An error occurred: {e}")注意:您可以直接从GitHub Gist 访问并复制完整代码。
预期输出如下:
% python3 main.py
Generated Text:
Tom:
Nancy,
I am writing to express my sincere apologies for the negative experience you had with our customer support engineer. It is unacceptable that we did not meet your expectations, and I want to assure you that we are taking steps to prevent this from happening in the future.
Sincerely,
Tom
Customer Service Manager自定义模型输出
要微调模型输出行为,您可以调整 temperature 与 maxTokenCount 等参数:
temperature:控制输出的随机性。数值越低,输出越确定;数值越高,输出变化越大。MaxTokenCount:设置生成输出的最大长度。
例如:
inference_parameters = {
"inputText": prompt,
"textGenerationConfig": {
"maxTokenCount": 256, # 限制响应长度
"temperature": 0.7, # 控制输出的随机性
},
}通过调整这些参数,您可以更好地根据应用需求定制生成内容的创造性与长度。
Amazon Bedrock 高级功能
接下来我们将聚焦两个高级方法:利用检索增强生成(RAG)提升 AI,以及规模化管理与部署模型。
使用检索增强生成(RAG)自定义 AI 输出
RAG 需要具备一个知识库。在 Amazon Bedrock 中设置知识库之前,您需要创建一个 S3 存储桶并上传所需文件。具体步骤如下:
步骤 1:创建 S3 存储桶
- 登录 AWS 管理控制台:
- 进入 S3 服务。
- 创建新存储桶:
- 点击 Create bucket。
- 输入唯一的存储桶名称。
- 除非有特定安全或加密需求,否则保持默认设置。
- 配置存储桶设置:
- 确保启用阻止公共访问,除非确有需要。
- (可选)如需保留文件版本,可启用版本控制。
- 创建存储桶:
- 点击 Create bucket 完成设置。
步骤 2:将文件上传到 S3 存储桶
- 下载文件:
- 提供的 GitHub 链接包含一个带有 模拟数据的示例 PDF 文件: octank_financial_10K.pdf。您也可以使用其他文件。
- 将其保存到本地计算机。
- 将文件上传至 S3:
- 在 AWS 控制台中打开新建的 S3 存储桶。
- 点击 Upload 并选择文件
octank_financial_10K.pdf。 - 检查并设置权限(默认:私有)。
- 点击 Upload 将文件添加到存储桶。
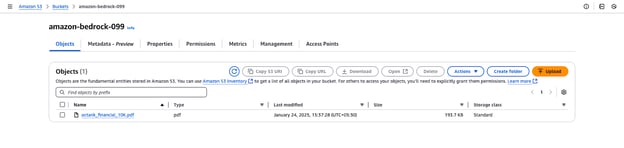
“amazon-bedrock-099” 的 Amazon S3 存储桶视图。
Amazon Bedrock 允许您基于向量数据库创建知识库。以下步骤将带您创建知识库、配置数据源,并选择嵌入模型与向量存储。
步骤 1:提供知识库详情
- 进入 Amazon Bedrock 控制台,在 Builder tools 部分选择 Knowledge Bases。
- 点击 Create Knowledge Base 并填写以下信息:
- 知识库名称:输入唯一名称(例如
knowledge-base-quick-start)。 - 知识库描述:(可选)简要描述知识库。
- 在 IAM permissions 部分:
- 选择“Create and use a new service role”或“Use an existing service role”。
- 确保该服务角色具备访问 Bedrock 的必要权限。
- 示例服务角色:
AmazonBedrockExecutionRoleForKnowledgeBase。 - 点击 Next 进入数据源配置。
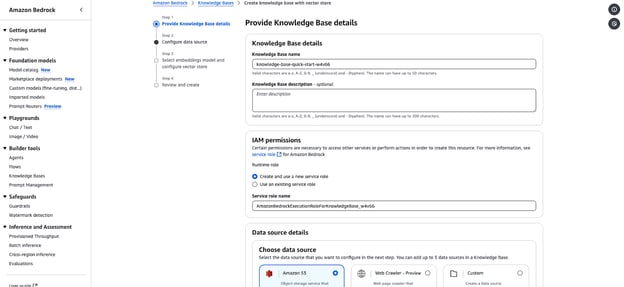
Amazon Bedrock 知识库创建向导。
步骤 2:配置数据源
- 在 Data source details 部分,选择您的数据源:
- Amazon S3:由于数据存储在 S3,请选择该选项。
- 指定以下内容:
- 数据源位置:在 “This AWS Account” 与 “Other AWS Account” 之间选择。
- S3 URI:提供包含数据的 S3 存储桶 URI,选择您在前一步创建的 S3 与文件。
- 加密密钥:(可选)如果数据已加密,请添加客户管理的 KMS 密钥。
- 配置解析策略:
- 默认解析器:处理纯文本数据。可以保持默认。
- 以基础模型为解析器:处理复杂文档或图像。可以保持默认。
- 分块策略:
- 默认设置会将文本拆分为约 300 个 token 的块以生成嵌入。可以保持默认。
- (可选)添加 Transformation functions 或高级设置以预处理数据。可以保持默认。
- 点击 Next 继续。
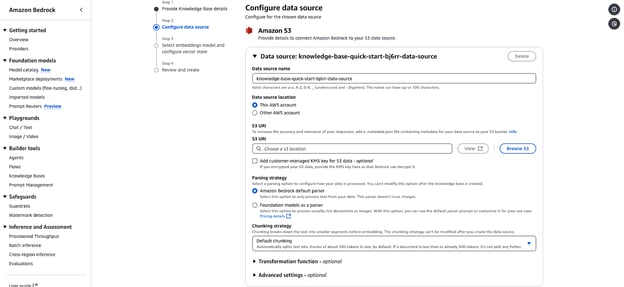
Amazon Bedrock 数据源配置页面,将 S3 作为知识库集成。
步骤 3:选择嵌入模型并配置向量存储
- 选择一个 嵌入模型(Embeddings model),将数据转换为向量表示:
- Titan Embeddings G1 - Text v1.2(本教程可选择该项)。
- Embed English v3
- Embed Multilingual v3
- 在 Vector database 部分:
- 选择 “Quick create a new vector store”(推荐),或选择已有存储。
- 可选项包括:
- Amazon OpenSearch Serverless:适合提供与上下文高度相关的响应。本教程可选择该项。
- Amazon Aurora PostgreSQL Serverless:针对快速相似性搜索进行了优化。
- Amazon Neptune Analytics:适用于基于图的分析与检索增强生成(RAG)。
- 点击 Next 以审阅并完成配置。
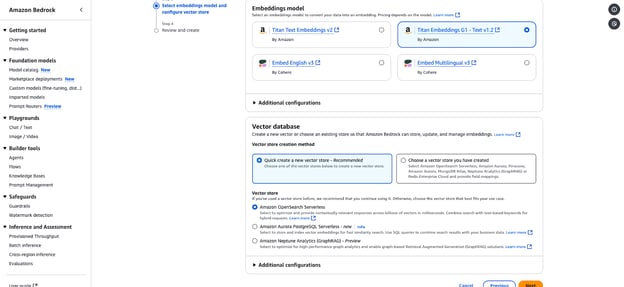
Amazon Bedrock 配置页面:选择嵌入模型与向量存储。
步骤 4:审阅与创建
- 审阅所有配置。
- 确认无误后,点击 Create 完成知识库创建。
- 创建完成后,您的知识库将显示在控制台的 Knowledge Bases 部分。
步骤 5:测试知识库
- 访问知识库概览:
- 前往 Amazon Bedrock 控制台中的 Knowledge Bases 部分。
- 选择您创建的知识库(例如
knowledge-base-quick-start)。 - 查看概览信息:
- 知识库名称与 ID
- 确保状态为 “Available”。
- 确认使用了正确的服务角色。
- 同步并添加数据源:
- 如果数据源尚未同步,点击 Sync 发起同步。
- 您也可以通过 Add documents from S3 添加更多文档或数据源。
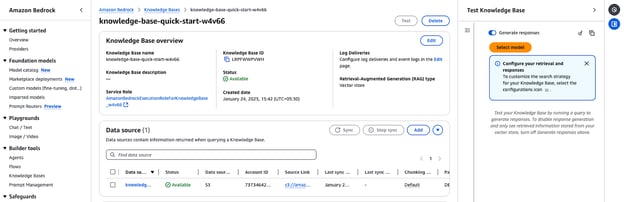
Amazon Bedrock 知识库概览展示配置详情与数据源状态。
步骤 6:选择用于测试的模型
- 选择基础模型:
- 在 Test Knowledge Base 面板点击 Select model。
- 浏览来自 Amazon、Anthropic、Cohere 等提供商的可用模型。
- 示例:选择 Claude Instant (v1.2) 进行文本查询。
- 推理类型:
- 若未设置预置吞吐量,选择 On-demand 推理。
- 应用模型:
- 点击 Apply 完成选择。
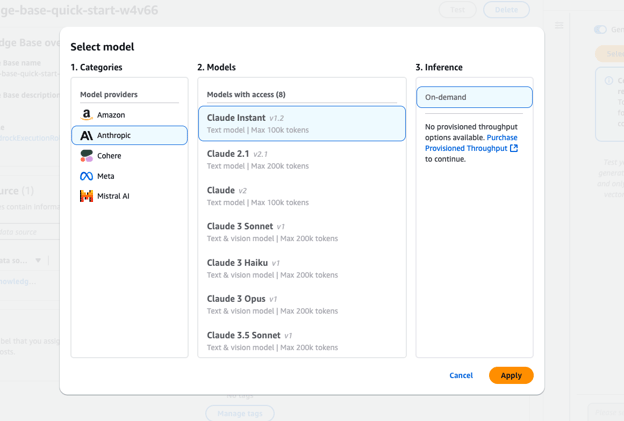
Amazon Bedrock 模型选择界面,展示多款 Anthropic 的 Claude 模型。
步骤 7:运行查询并生成响应
- 生成响应:
- 在输入框中输入查询(例如:“Help me with Financial Statement Schedules”)。
- 点击 Run 测试知识库。
- 查看来源详情:
- 响应将包含与查询相关的数据块。
- 展开 Source Details 查看元数据与检索信息来源。
- 审阅输出:
- 验证响应是否与知识库内容一致。
- 必要时微调检索配置。
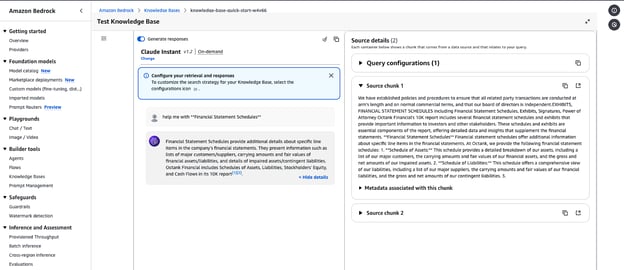
Amazon Bedrock 知识库测试界面展示针对查询的响应。
示例查询输出:
- 查询:“Help me with Financial Statement Schedules.”
- 响应:知识库将检索财务报表中各科目的详细信息,例如资产、负债明细及相关元数据。
规模化管理与部署 AI 模型
借助 AWS Lambda 等服务,Amazon Bedrock 可实现模型的规模化管理与部署。这种高性价比的方法确保高可用性,并可为 AI 应用自动扩缩容。
本节我们将使用 AWS Lambda 动态调用 Bedrock 模型,以便按需处理提示词。
步骤 1:创建 AWS Lambda 函数
- 登录 AWS 管理控制台。
- 进入 Lambda 服务并点击 Create function。
- 选择函数配置:
- 选择 “Author from Scratch”。
- 函数名称:bedrock。
- 运行时:Python 3.x。
- 权限:选择本教程前文创建的 IAM 角色。
- 点击 Create function 完成初始化。
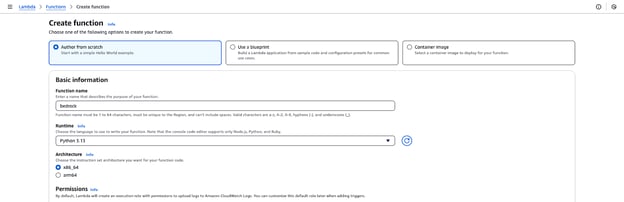
AWS Lambda 函数创建页面。
步骤 2:添加 Lambda 函数代码
- 在 Lambda 控制台的 Code 部分打开函数编辑器。
- 将默认代码替换为 Github Gist 中提供的代码。
- 点击 Deploy 保存变更。
步骤 3:测试 Lambda 函数
- 在 Lambda 控制台的 Test 选项卡中创建如下 JSON 的测试事件:
{
"prompt": "Write a formal apology letter for a late delivery."
}- 保存测试事件。
- 点击 Test 以调用 Lambda 函数。
- 在 Execution results 部分查看输出。生成文本应类似如下:
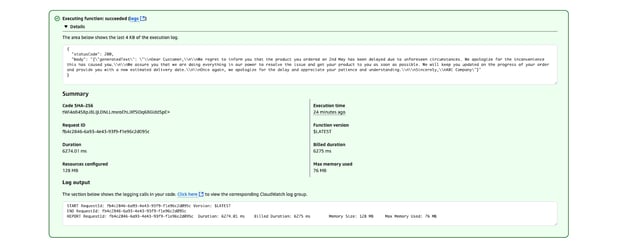
AWS Lambda 执行结果,显示函数成功运行。
AI 模型部署最佳实践
优化成本:
- 对于偶发用例,使用按需推理。
- 如预期请求频繁,考虑使用预置吞吐量。
保护 Lambda 函数安全:
- 将 IAM 角色权限限制在必要范围内。
- 使用环境变量,避免在代码中暴露敏感数据。
监控与日志:
- 使用 CloudWatch 日志追踪调用指标并排查问题。
- 为错误或高时延设置告警。
使用 AWS Bedrock 的最佳实践
本节分享使用 Amazon Bedrock 的一些最佳实践,从成本优化到保障安全与准确性。
成本优化
在 AWS Bedrock 中管理成本可能涉及借助 Amazon SageMaker 部署模型,并使用 Spot 实例以节省高达 90% 的费用。以下是我的一些最佳实践:
- 选择合适的基础模型:选择与需求匹配的模型。对于不太复杂的任务,优先选择更小、更省资源的模型以降低计算成本。例如,文本类任务可使用 Amazon Titan 模型,简单图像生成可使用 Stability AI。
- 批量推理:将多个推理请求合并为批次处理,而非逐个处理。这样可降低模型调用频率,从而减少成本。
- 利用 S3 生命周期策略:仅在 Amazon S3 中存储推理或微调所需的数据。通过生命周期策略自动将数据转移至更低成本的存储层(例如 S3 Glacier),或在设定时间后删除未使用数据。
- 监控与控制支出:使用 AWS Cost Explorer 分析支出模式并识别优化空间。设置 AWS Budgets,当接近预设阈值时接收告警。
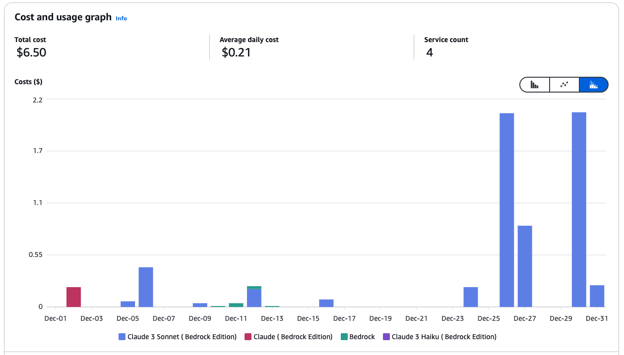
Amazon Bedrock 服务的成本与使用图。
- 结合 SageMaker 使用 Bedrock 提升成本效率: 在 SageMaker 中使用 Bedrock 基础模型,以利用托管的 Spot 实例来运行推理与训练作业。
- 在 SageMaker 中使用 Spot 实例:Spot 实例可将成本相较按需实例降低最高 90%。SageMaker 会代表您处理 Spot 中断,如 Spot 容量不可用将自动重试训练作业。示例:
from sagemaker.mxnet import MXNet
# 使用 Spot 实例以提高成本效率
use_spot_instances = True
# 训练作业的最⼤运⾏时间(秒)
max_run = 600
# Spot 实例可⽤性的最⼤等待时间(秒);仅在使⽤ Spot 实例时设置
max_wait = 1200 if use_spot_instances else None
# 定义训练作业的 MXNet 估计器
mnist_estimator = MXNet(
entry_point='source_dir/mnist.py', # 包含模型训练代码的脚本路径
role=role, # 访问 AWS 资源(如 S3、SageMaker)的 IAM 角色
output_path=model_artifacts_location, # 保存训练后模型制品的 S3 位置
code_location=custom_code_upload_location, # 上传训练脚本的 S3 位置
instance_count=1, # 训练实例数量
instance_type='ml.m4.xlarge', # 训练作业实例类型
framework_version='1.6.0', # 使用的 MXNet 框架版本
py_version='py3', # 环境的 Python 版本
distribution={'parameter_server': {'enabled': True}}, # 启用参数服务器的分布式训练
hyperparameters={ # 训练超参数
'learning-rate': 0.1, # 学习率
'epochs': 5 # 训练轮数
},
use_spot_instances=use_spot_instances, # 启用 Spot 实例以节省成本
max_run=max_run, # 训练作业的最⼤运⾏时间
max_wait=max_wait, # Spot 实例可⽤性的最⼤等待时间
checkpoint_s3_uri=checkpoint_s3_uri # 保存中间检查点的 S3 URI
)
# 启动训练作业,并指定训练与测试数据集的位置
mnist_estimator.fit({
'train': train_data_location, # 训练数据集的 S3 位置
'test': test_data_location # 测试/验证数据集的 S3 位置
})- 使用 CloudWatch 指标与日志: 训练指标与日志可在 Amazon CloudWatch 获取,为性能与资源使用提供洞察。
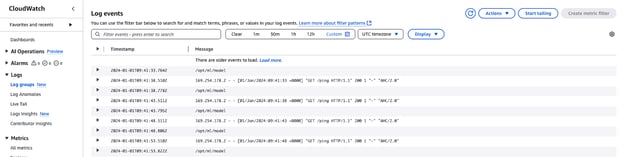
AWS CloudWatch 日志
安全性
为确保 Amazon Bedrock 的安全性、合规性与性能,遵循最佳实践至关重要。以下是我的建议:
- 最小权限原则:限制 IAM 权限与服务角色仅访问必要资源,防止未授权访问。
- 验证服务角色与安全组:确保 Bedrock 代理与模型定制作业正确配置有效的服务角色与安全设置。
- 在 VPC 中运行工作负载:在 虚拟私有云(VPC)中运行定制作业与数据处理可提升安全性。
- 加密关键数据:使用 Amazon KMS 客户管理密钥(CMKs)对代理会话、Bedrock Studio 工作区、自定义模型与临时知识库数据进行加密。
- 实施数据删除策略:仅在知识库数据源处于活动状态时保留向量化数据;在不再需要时设置自动删除。
- 强化 Bedrock 防护:将 Prompt Attack Strength 设为 HIGH,并启用敏感信息过滤,以防御对抗性攻击与数据泄露。
- 保护代理会话:使用防护措施阻止未授权访问并保护敏感交互。
- 启用日志提升可见性:在账号层面开启模型调用日志以追踪活动并检测异常。
- 防御跨服务攻击:使用服务角色策略,防止跨服务困惑副手攻击(Confused Deputy)。
模型监控与评估
通过监控与评估,确保模型准确、可靠并与业务目标一致。以下是一些最佳实践:
- 跟踪性能指标:使用 CloudWatch 监控时延、错误与调用趋势。
- 记录输入与输出:启用详细日志用于调试与趋势分析。
- 引入反馈回路:使用 Amazon A2I 等工具,对关键输出进行人工审阅。
- 定期评估输出:与验证数据集或真实标注进行对比。
- 持续改进模型:根据需要使用更新数据集或特定领域数据进行微调。
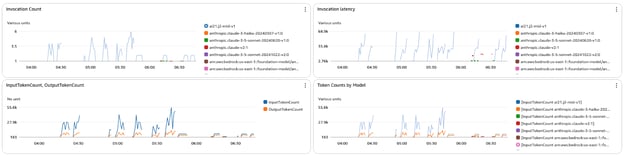
指标仪表板展示了 Amazon Bedrock 各模型的调用次数、时延与 token 计数。
结论
AWS Bedrock 正在重塑生成式 AI 应用的开发方式,它为使用基础模型提供了一个无需操心基础设施的集中平台。
从现在开始,本分步教程应能帮助您识别合适的模型,构建安全且可扩展的工作流,并集成检索增强生成(RAG)等功能以实现更高程度的定制化。借助在成本、安全与监控上的最佳实践,您已准备好开发与管理满足业务目标的 AI 解决方案。
若想进一步提升您的 AWS 专业能力,请探索以下课程:
- AWS Cloud Technology and Services – 了解 AWS 的核心服务以及如何构建云原生解决方案。
- AWS Security and Cost Management – 掌握保护 AWS 环境与高效优化成本的策略。
- Developing AI Applications – 深入学习 AI 开发,掌握构建、部署与扩展 AI 解决方案的方法。

Rahul Sharma 是一位 AWS 大使、DevOps 架构师与技术博主,专注于云计算、DevOps 实践与开源技术。凭借在 AWS、Kubernetes 与 Terraform 方面的专长,他通过生动易懂的文章与教程,为学习者与专业人士化繁为简。Rahul 热衷于解决 DevOps 难题,并分享洞见以赋能技术社区。
生成式 AI 已成为各行业的颠覆者,推动了自然语言处理、计算机视觉等诸多领域的进步。然而,释放其潜力往往伴随着成本高昂、基础设施复杂以及学习曲线陡峭等挑战。AWS Bedrock 正是在此背景下应运而生——它使您无需管理基础设施即可使用基础模型,从而破解这些难题。
本教程旨在为您全面介绍 Amazon Bedrock,包括它是什么、如何工作,以及如何使用它。阅读完本指南,您将具备开发自有生成式 AI 应用所需的信息与技能——这些应用可扩展、具备弹性,并与您的目标保持一致。
什么是 Amazon Bedrock?
Amazon Bedrock 是由 Amazon Web Services(AWS)提供的托管服务,用于访问和管理基础模型(FMs),它们是生成式 AI 的基本构件。Bedrock 将流程大幅简化,您无需为此操心 GPU 资源供给、模型流水线配置,或其他任何基础设施管理工作。
AWS Bedrock 是通往创新的门户。它是一个统一平台,使开发者能够探索、测试并部署来自 Anthropic、Stability AI 和 Amazon Titan 等领先提供商的前沿 AI 模型。
例如,设想您要开发一个客户支持聊天机器人。借助 AWS Bedrock,您可以选择先进的语言模型,针对应用需求进行调优,并将其嵌入到应用中,而无需编写任何服务器配置代码。
AWS Bedrock 的功能
AWS Bedrock 的功能旨在简化并加速从 AI 概念到生产落地的全过程。下面我们将详细拆解。
访问多种基础模型
AWS Bedrock 的一大优势在于其可用的基础模型种类丰富。无论您从事文本应用、视觉内容,还是强调安全可解释 AI 的项目,Bedrock 都能满足需求。以下是部分可用模型:
Amazon Bedrock 概览,突出其与各类模型的集成。
无需管理基础设施
AWS Bedrock 抽象了基础设施管理,这意味着:
可扩展性与灵活性
生成式 AI 应用的需求通常难以预测。高峰时段聊天机器人可能需响应数百位用户,而深夜只有少量请求。AWS Bedrock 通过内置的可扩展性解决了这一问题:
与 AWS 生态集成
AWS Bedrock 不仅提供强大的模型——它还与其他 AWS 服务集成,支持端到端的 AI 工作流。部分集成包括: