Khóa học
AI tạo sinh đã trở thành yếu tố làm thay đổi cuộc chơi trong mọi lĩnh vực, thúc đẩy tiến bộ trong xử lý ngôn ngữ tự nhiên, thị giác máy tính và nhiều mảng khác. Tuy nhiên, khai thác tiềm năng của nó thường đi kèm thách thức về chi phí, hạ tầng phức tạp và đường cong học tập dốc. Đây là lúc AWS Bedrock xuất hiện – giải pháp này giúp gỡ bỏ rào cản bằng cách cho phép bạn dùng các mô hình nền tảng mà không cần tự quản lý hạ tầng.
Hướng dẫn này là cẩm nang hoàn chỉnh về Amazon Bedrock, trình bày Bedrock là gì, hoạt động ra sao và cách bạn có thể sử dụng. Kết thúc bài viết, bạn sẽ có thông tin và kỹ năng cần thiết để phát triển ứng dụng AI tạo sinh của riêng mình — có khả năng mở rộng, linh hoạt và phù hợp với mục tiêu của bạn.
Amazon Bedrock là gì?
Amazon Bedrock là dịch vụ được quản lý của AWS để truy cập và quản lý các mô hình nền tảng (FM) – những khối xây dựng cơ bản của AI tạo sinh do Amazon Web Services (AWS) cung cấp. Bedrock đơn giản hóa mọi thứ đến mức bạn không cần bận tâm đến việc cấp phát GPU, cấu hình pipeline mô hình hay quản lý các thành phần hạ tầng khác.
AWS Bedrock là cánh cổng dẫn tới đổi mới. Đây là nền tảng hợp nhất cho phép nhà phát triển khám phá, thử nghiệm và triển khai các mô hình AI tiên tiến từ những nhà cung cấp hàng đầu như Anthropic, Stability AI và Titan của Amazon.
Ví dụ, hãy tưởng tượng bạn đang phát triển một chatbot hỗ trợ khách hàng. Với AWS Bedrock, bạn có thể chọn một mô hình ngôn ngữ tinh vi, tinh chỉnh cho nhu cầu ứng dụng của mình và nhúng vào ứng dụng mà không cần viết mã cấu hình máy chủ.
Các tính năng của AWS Bedrock
Các tính năng của AWS Bedrock được thiết kế để đơn giản hóa và tăng tốc hành trình từ ý tưởng AI đến sản phẩm. Hãy cùng phân tích chi tiết.
Truy cập nhiều mô hình nền tảng
Một trong những lợi ích đáng kể nhất của AWS Bedrock là sự đa dạng của các mô hình nền tảng. Dù bạn đang làm về ứng dụng văn bản, nội dung trực quan, hay AI an toàn và có thể diễn giải, Bedrock đều đáp ứng. Dưới đây là một số mô hình có sẵn:
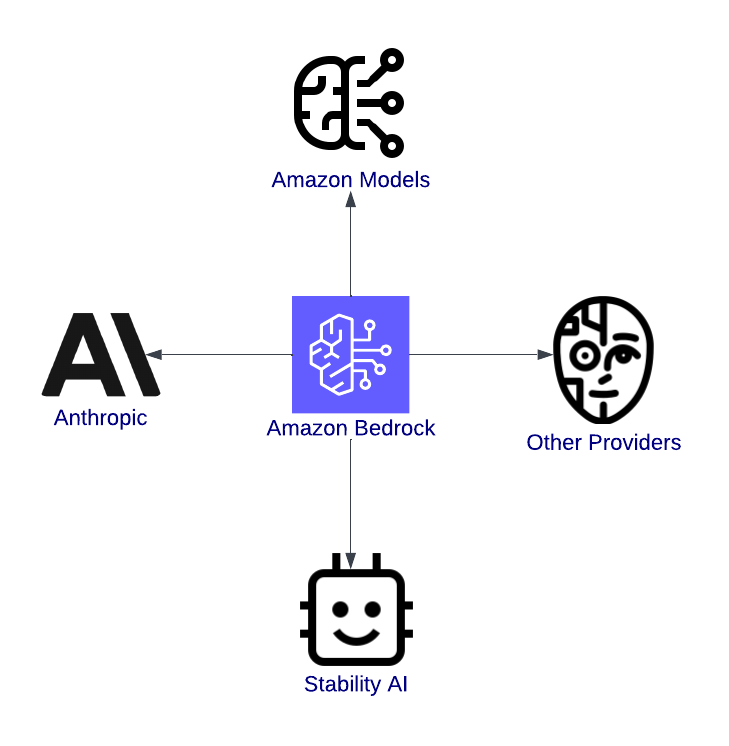
- Mô hình của Amazon: Các mô hình độc quyền này có thể dùng cho các tác vụ như tạo văn bản giống con người cho chatbot hoặc ứng dụng tạo nội dung, rút gọn tài liệu về cốt lõi, hoặc phân tích cảm xúc phản hồi của khách hàng.
- Mô hình Anthropic: Tập trung phát triển AI tốt và an toàn, phù hợp nhất cho các ngành đòi hỏi tuân thủ và độ tin cậy như ngân hàng hoặc y tế.
- Stability AI: Các mô hình Stability AI nổi tiếng về tạo ảnh. Chúng giúp biến ý tưởng thành hình ảnh cho marketing, tác phẩm nghệ thuật hoặc phát triển sản phẩm.

Tổng quan về Amazon Bedrock, làm nổi bật tích hợp với các mô hình.
Không cần quản lý hạ tầng
AWS Bedrock trừu tượng hóa việc quản lý hạ tầng, nghĩa là:
- Không cần cấp phát phiên bản GPU.
- Bạn có thể tập trung hoàn toàn vào xây dựng ứng dụng với kiến trúc không máy chủ (serverless).
- Tính dễ dùng giúp rút ngắn thời gian thiết lập đáng kể, thường từ vài tuần xuống vài giờ.
Khả năng mở rộng và linh hoạt
Các ứng dụng AI tạo sinh thường có nhu cầu không thể dự đoán. Một chatbot có thể trả lời hàng trăm người dùng vào giờ cao điểm và chỉ vài người vào ban đêm. AWS Bedrock giải quyết điều này với khả năng mở rộng tích hợp sẵn:
- Tự động mở rộng: Các mô hình có thể tự động điều chỉnh để xử lý đột biến tải công việc mà không cần bạn can thiệp thủ công.
- Khối lượng công việc song song: Bạn có thể chạy đồng thời nhiều mô hình cho các tình huống sử dụng khác nhau trong cùng một ứng dụng.
- Khả dụng toàn cầu: Với mạng lưới toàn cầu của AWS, bạn có thể triển khai ứng dụng gần người dùng hơn, giảm độ trễ và nâng cao trải nghiệm.
Tích hợp với hệ sinh thái AWS
AWS Bedrock không chỉ cung cấp các mô hình mạnh mẽ — nó còn tích hợp với các dịch vụ AWS khác để hỗ trợ quy trình AI đầu-cuối. Một số tích hợp gồm:
- Amazon SageMaker: Cho phép tinh chỉnh các mô hình nền tảng để đáp ứng yêu cầu cụ thể.
- AWS Lambda: Hỗ trợ ứng dụng AI theo sự kiện, như kích hoạt mô hình để tinh chỉnh dữ liệu mới hoặc rà soát kết quả suy luận.
- Amazon CloudWatch: Cung cấp khả năng giám sát và ghi log để phân tích hiệu năng mô hình và thu thập phản hồi người dùng.
- Amazon S3: Đóng vai trò lưu trữ tập dữ liệu, hỗ trợ theo dõi hiệu năng và phân tích chi phí.
Thiết lập AWS Bedrock
Phần này sẽ hướng dẫn bạn thiết lập quyền cần thiết, tạo tài khoản AWS và bắt đầu với AWS Bedrock.
Bước 1: Tạo tài khoản AWS (nếu bạn chưa có)
Nếu bạn chưa có, hãy truy cập trang đăng ký của AWS và tạo tài khoản. Với người dùng hiện có, đảm bảo người dùng IAM của bạn có quyền quản trị viên.
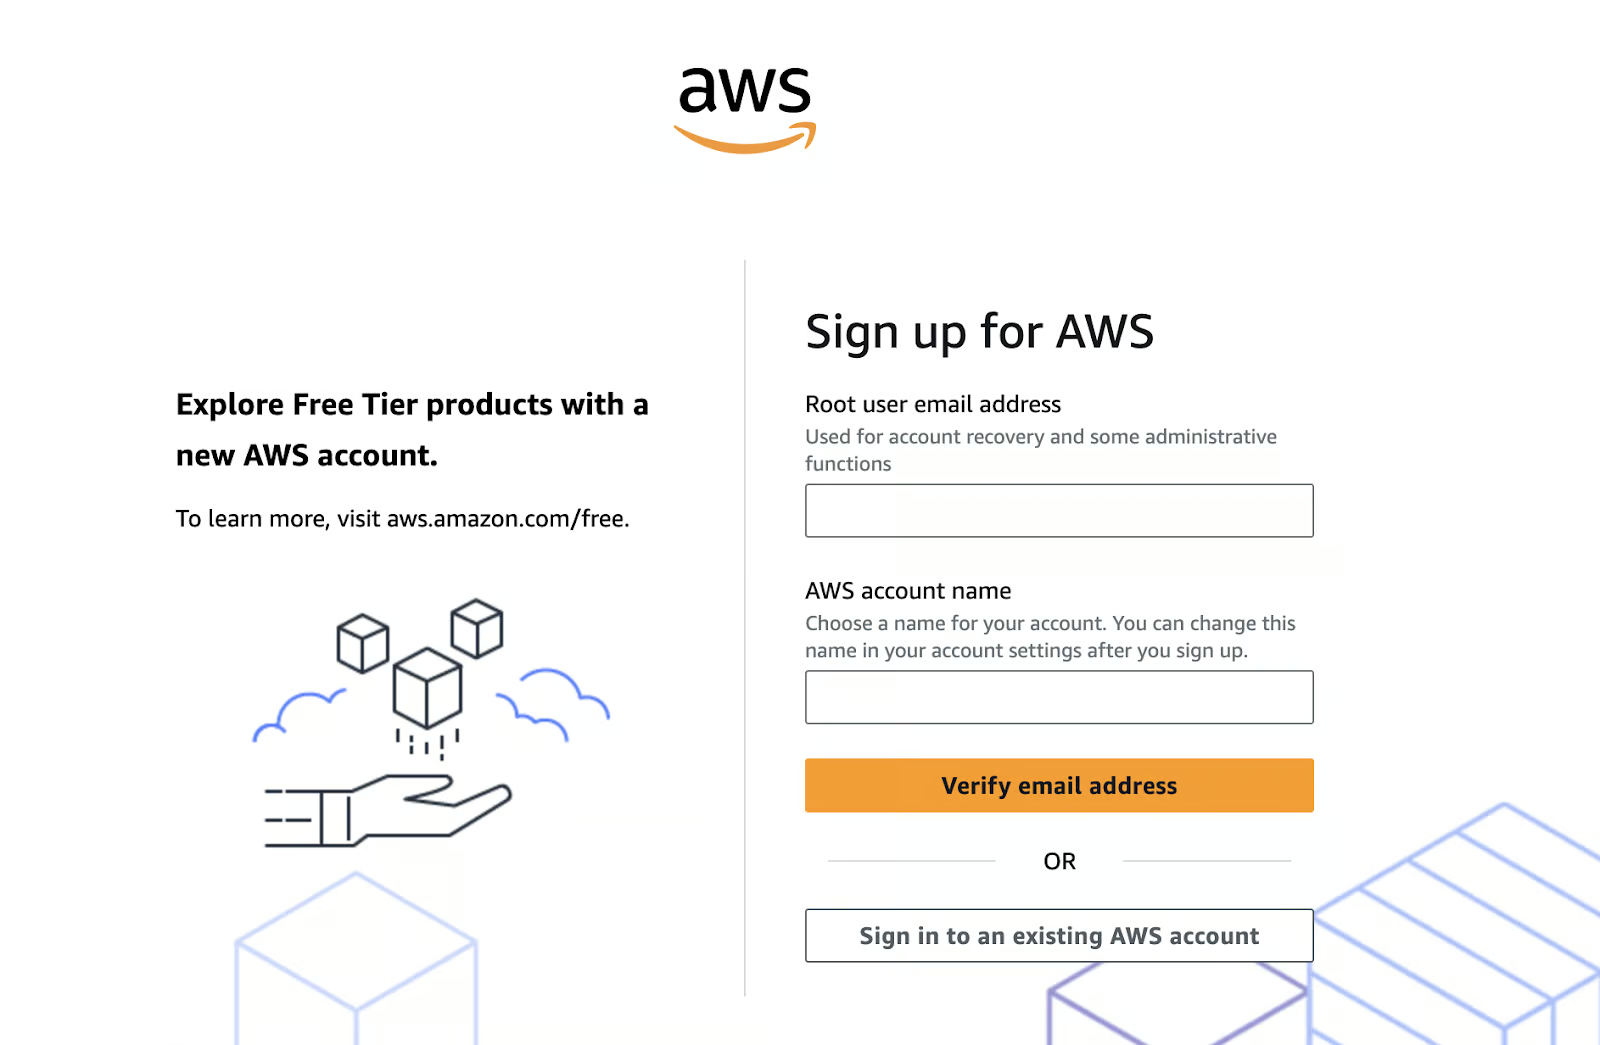
Trang đăng ký AWS, giới thiệu khám phá sản phẩm Free Tier cho tài khoản mới.
Nếu bạn cần các bước chi tiết, vui lòng truy cập hướng dẫn chính thức của AWS.
Bước 2: Điều hướng đến AWS Bedrock
Amazon Bedrock có thể truy cập qua AWS Management Console. Thực hiện các bước sau để tìm và bắt đầu sử dụng:
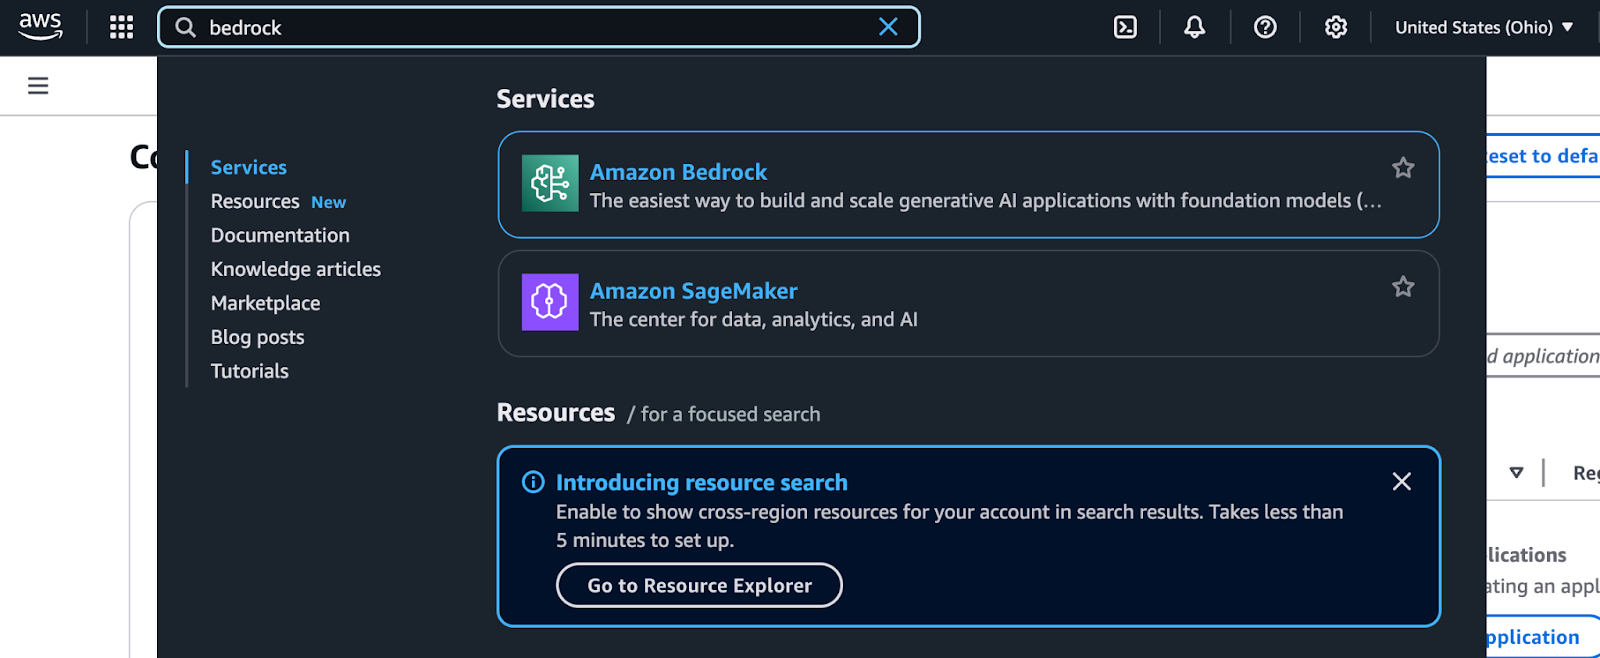
- Đăng nhập AWS Management Console: Đi tới AWS Console và nhập thông tin đăng nhập.
- Tìm Bedrock: Dùng thanh tìm kiếm ở đầu console. Gõ “Bedrock” và chọn từ danh sách thả xuống.

Kết quả tìm kiếm Bedrock trên AWS Management Console.
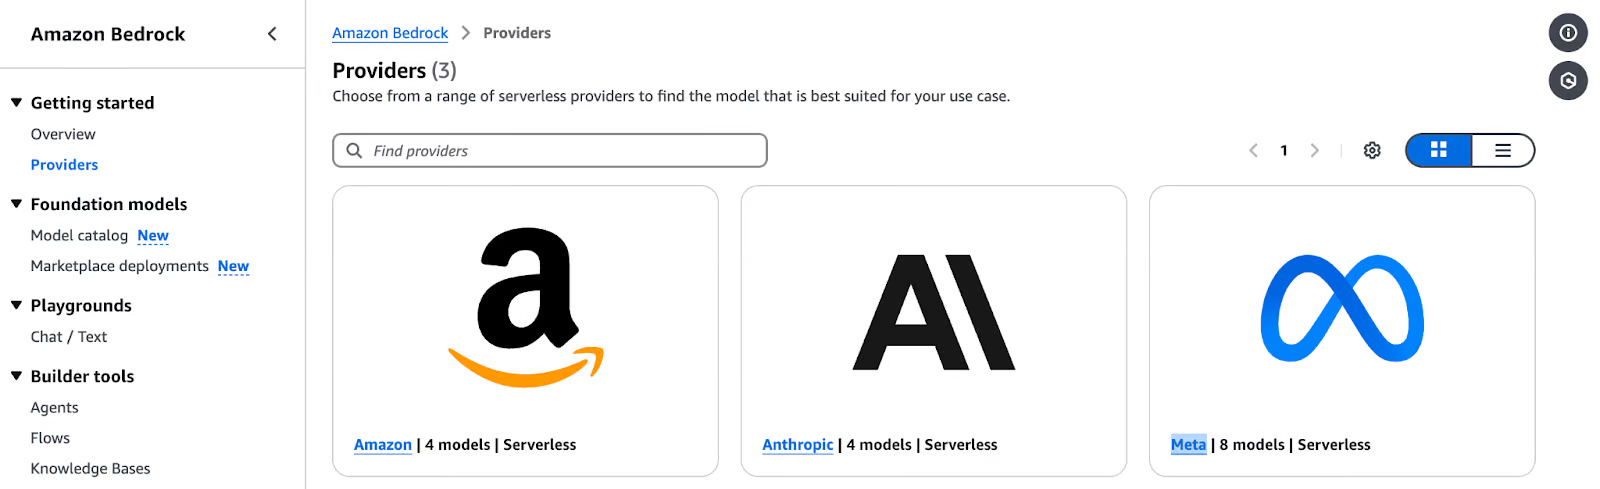
- Khám phá bảng điều khiển Bedrock: Trên bảng điều khiển Bedrock, bạn sẽ thấy tùy chọn chọn nhà cung cấp mô hình và các mô hình nền tảng.

Trang Amazon Bedrock Providers giới thiệu các tùy chọn mô hình serverless từ Amazon.
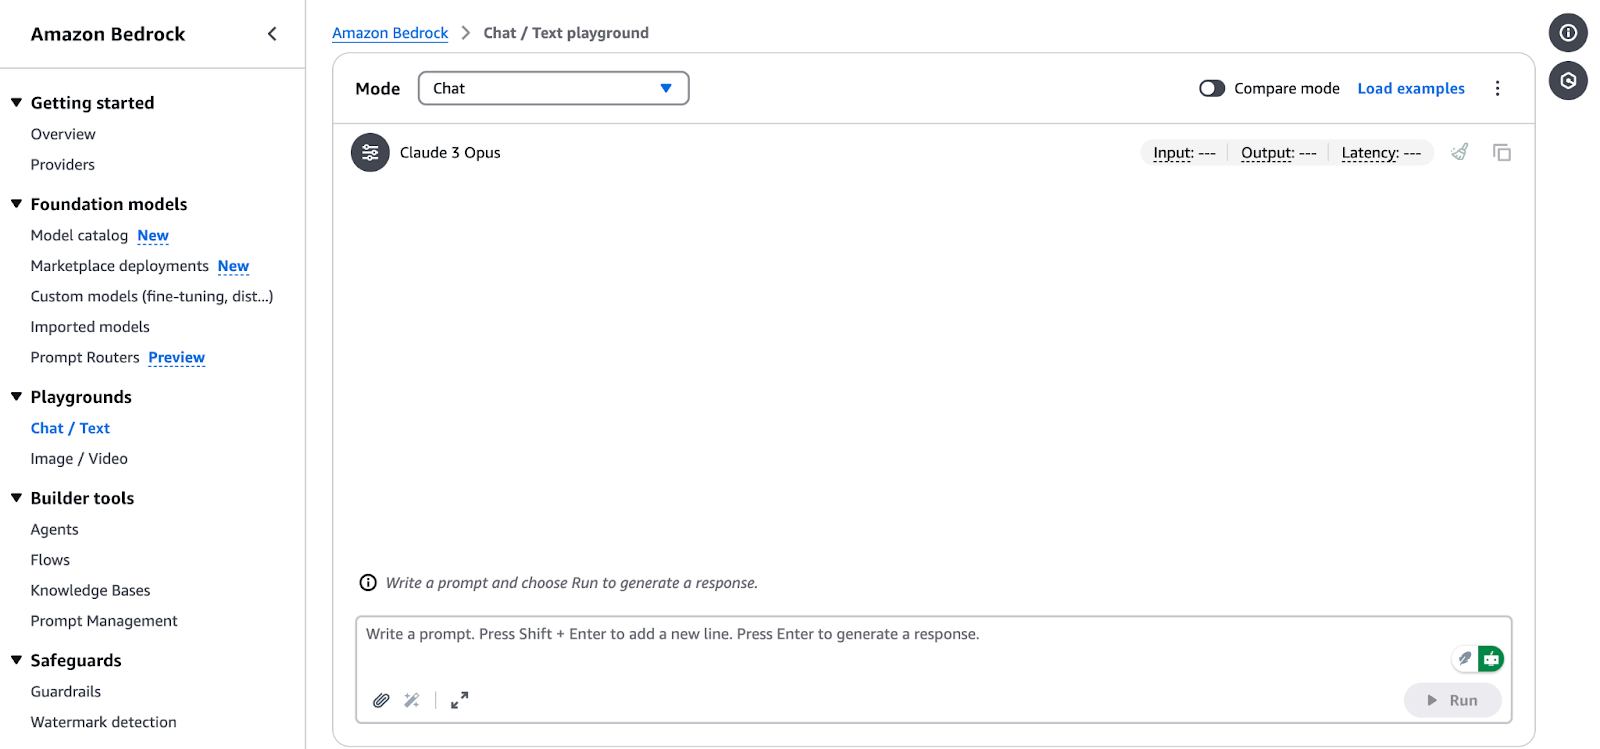
- Chọn nhà cung cấp và mô hình nền tảng:
- Chọn nhà cung cấp dựa trên trường hợp sử dụng (ví dụ, Amazon Titan cho tạo văn bản, Stability AI cho hình ảnh, v.v.).
- Khám phá các tùy chọn theo mô hình như loại đầu vào, tính năng hỗ trợ và tham số đầu ra.
- Chạy thử suy luận: AWS Bedrock cho phép bạn chạy các suy luận mẫu trực tiếp từ console. Đây là cách tuyệt vời để cảm nhận cách từng mô hình hoạt động trước khi tích hợp vào ứng dụng.

Giao diện Amazon Bedrock Chat/Text Playground.
Bước 3: Thiết lập quyền IAM
AWS Identity and Access Management (IAM) rất quan trọng để truy cập AWS Bedrock an toàn. Thực hiện các bước sau để cấu hình quyền:
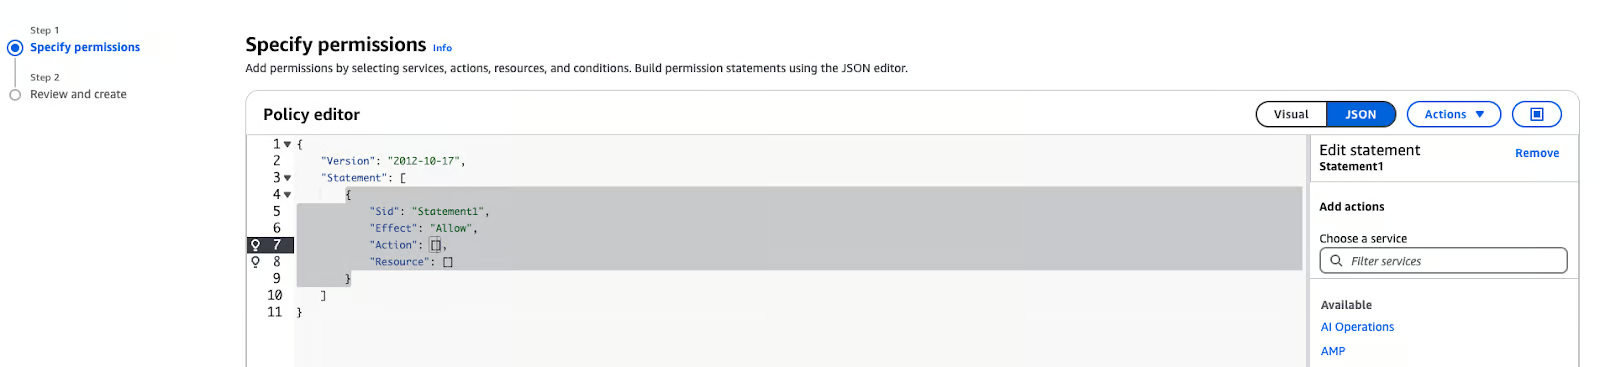
- Trong AWS Management Console, điều hướng đến dịch vụ IAM .
- Nhấp Roles ở thanh bên và chọn Create policy.
- Trong mục Specify permissions, chọn “JSON”.

Trình soạn thảo AWS IAM Policy ở chế độ JSON
- Dán policy dưới đây vào ô văn bản:
{
"Version": "2012-10-17",
"Statement": [ {
"Sid": "BedrockFullAccess",
"Effect": "Allow",
"Action": ["bedrock:*"],
"Resource": "*"
}
]
}
Lưu ý: Policy trên có thể được gắn vào bất kỳ vai trò nào cần truy cập dịch vụ Amazon Bedrock. Có thể là SageMaker hoặc người dùng. Khi dùng Amazon SageMaker, vai trò thực thi cho notebook của bạn thường là người dùng hoặc vai trò khác với tài khoản bạn dùng để đăng nhập AWS Management Console. Để tìm hiểu cách khám phá dịch vụ Amazon Bedrock bằng AWS Console, hãy đảm bảo bạn cấp quyền cho người dùng hoặc vai trò Console của mình. Bạn có thể chạy notebook từ bất kỳ môi trường nào có quyền truy cập dịch vụ AWS Bedrock và thông tin xác thực hợp lệ.
Sử dụng Amazon Bedrock cho ứng dụng AI tạo sinh
Các ứng dụng AI tạo sinh được xây dựng trên những mô hình nền tảng được tinh chỉnh cho tác vụ cụ thể như tạo văn bản, tạo hình ảnh hoặc chuyển đổi dữ liệu. Dưới đây là hướng dẫn từng bước về chọn mô hình nền tảng, chạy suy luận cơ bản và điều chỉnh phản hồi mô hình cho phù hợp nhu cầu.
Chọn mô hình nền tảng
Chọn đúng mô hình nền tảng rất quan trọng vì phụ thuộc vào nhu cầu dự án. Cách lựa chọn như sau:
1. Xác định trường hợp sử dụng:
- Tạo văn bản: Với các tác vụ như tóm tắt, tạo nội dung hoặc phát triển chatbot, hãy cân nhắc các mô hình sau:
- Amazon Titan Text G1: Mô hình này tạo văn bản chất lượng cao với khả năng hiểu ngữ cảnh tốt.
- Anthropic Claude 3: Mô hình này rất giỏi tạo văn bản mạch lạc và phù hợp ngữ cảnh, thích hợp cho ứng dụng hội thoại.
- Tạo hình ảnh: Nếu dự án của bạn tạo hình ảnh hoặc bất kỳ nội dung trực quan nào, các mô hình Stability AI là lựa chọn phù hợp:
- Stable Diffusion 3.5 Large: Mô hình rất tốt trong việc tạo ảnh từ mô tả văn bản, dù là phong cách ảnh thật hay nghệ thuật.
- Nhiệm vụ đa phương thức: Với ứng dụng cần xử lý cả văn bản và hình ảnh, khuyến nghị dùng các mô hình Amazon Nova:
- Nova Lite: Mô hình đa phương thức tiết kiệm chi phí, nhận đầu vào văn bản, hình ảnh và video, xuất ra văn bản.
- Nova Pro: Mô hình đa phương thức mạnh cho các tác vụ phức tạp hơn.
2. Đánh giá khả năng mô hình:
- Xem xét điểm mạnh cụ thể của từng mô hình để đảm bảo phù hợp với nhu cầu dự án. Thông tin chi tiết về các mô hình nền tảng được hỗ trợ, gồm khả năng và khu vực hỗ trợ, có tại tài liệu AWS.
Bật quyền truy cập mô hình
Trước khi dùng các mô hình, bạn cần bật quyền truy cập mô hình trong tài khoản AWS. Các bước thiết lập như sau:
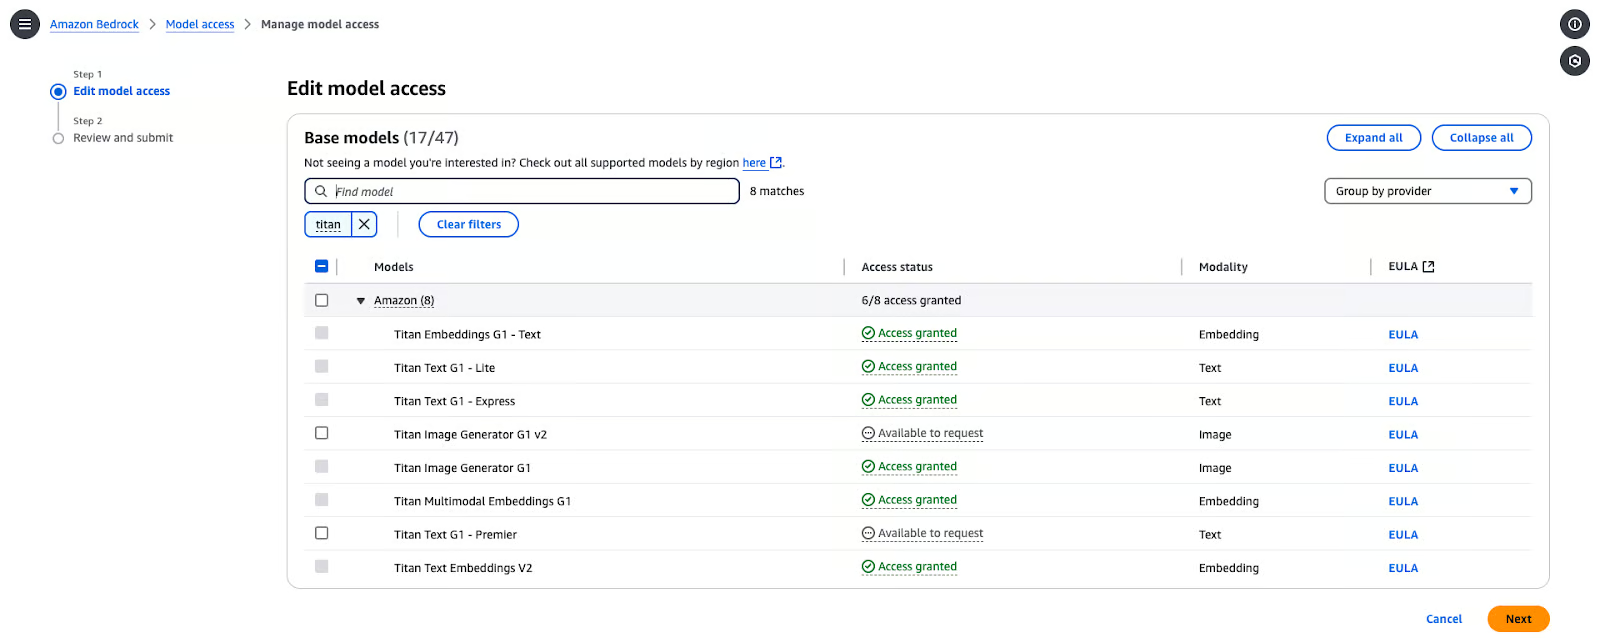
- Trong Bedrock Console, điều hướng tới Models access.
- Trong Console, nhấp Modify model access.
- Duyệt các mô hình có sẵn từ nhà cung cấp và chọn mô hình bạn muốn. Ở đây, tôi chọn Titan Text G1—Express.

Trang quản lý quyền truy cập mô hình Amazon Bedrock.
- Nhấp Next, sau đó nhấp Review and submit.
Chạy suy luận cơ bản
Để thực hiện suy luận bằng mô hình nền tảng đã chọn trong AWS Bedrock, hãy làm theo các bước sau:
- Thiết lập AWS SDK cho Python (boto3):
pip install boto3
- Khởi tạo client Bedrock: Tạo client runtime Bedrock ở vùng AWS bạn chọn:
import boto3
import json
from botocore.exceptions import ClientError
# Set the AWS Region
region = "us-east-1"
# Initialize the Bedrock Runtime client
client = boto3.client("bedrock-runtime", region_name=region)
- Gọi mô hình (invoke): Định nghĩa ID mô hình và prompt đầu vào:
# Define the model ID for Amazon Titan Express v1
model_id = "amazon.titan-text-express-v1"
# Define the input prompt
prompt = """
Command: Compose an email from Tom, Customer Service Manager, to the customer "Nancy"
who provided negative feedback on the service provided by our customer support
Engineer"""
- Định dạng payload yêu cầu:
# Configure inference parameters
inference_parameters = {
"inputText": prompt,
"textGenerationConfig": {
"maxTokenCount": 512, # Limit the response length
"temperature": 0.5, # Control the randomness of the output
},
}
# Convert the request payload to JSON
request_payload = json.dumps(inference_parameters)
- Xử lý phản hồi:
try:
# Invoke the model
response = client.invoke_model(
modelId=model_id,
body=request_payload,
contentType="application/json",
accept="application/json"
)
# Decode the response body
response_body = json.loads(response["body"].read())
# Extract and print the generated text
generated_text = response_body["results"][0]["outputText"]
print("Generated Text:\n", generated_text)
except ClientError as e:
print(f"ClientError: {e.response['Error']['Message']}")
except Exception as e:
print(f"An error occurred: {e}")
Lưu ý: Bạn có thể truy cập và sao chép toàn bộ mã trực tiếp từ GitHub Gist.
Bạn có thể kỳ vọng đầu ra như sau:
% python3 main.py
Generated Text:
Tom:
Nancy,
I am writing to express my sincere apologies for the negative experience you had with our customer support engineer. It is unacceptable that we did not meet your expectations, and I want to assure you that we are taking steps to prevent this from happening in the future.
Sincerely,
Tom
Customer Service Manager
Tùy chỉnh đầu ra mô hình
Để tinh chỉnh hành vi đầu ra của mô hình, bạn có thể điều chỉnh các tham số như temperature và maxTokenCount:
temperature: Tham số này điều khiển tính ngẫu nhiên của đầu ra. Giá trị thấp làm tăng tính quyết đoán, giá trị cao làm tăng độ biến thiên.MaxTokenCount: Thiết lập độ dài tối đa của đầu ra được tạo.
Ví dụ:
inference_parameters = {
"inputText": prompt,
"textGenerationConfig": {
"maxTokenCount": 256, # Limit the response length
"temperature": 0.7, # Control the randomness of the output
},
}
Bằng cách điều chỉnh các tham số này, bạn có thể điều tiết mức độ sáng tạo và độ dài nội dung tạo ra để phù hợp nhu cầu ứng dụng.
Tính năng nâng cao của Amazon Bedrock
Hãy chuyển sang hai phương pháp nâng cao: tăng cường AI bằng Retrieval-Augmented Generation (RAG) và quản lý, triển khai mô hình ở quy mô lớn.
Tùy chỉnh đầu ra AI với retrieval-augmented generation (RAG)
RAG yêu cầu chúng ta có một cơ sở tri thức. Trước khi thiết lập cơ sở tri thức trong Amazon Bedrock, bạn cần tạo một bucket S3 và tải lên các tệp cần thiết. Thực hiện theo các bước sau:
Bước 1: Tạo bucket S3
- Đăng nhập AWS Management Console:
- Đi tới dịch vụ S3 trong AWS Management Console.
- Tạo bucket mới:
- Nhấp Create bucket.
- Nhập tên bucket duy nhất.
- Giữ nguyên mặc định trừ khi bạn có yêu cầu cụ thể về bảo mật hoặc mã hóa.
- Cấu hình cài đặt bucket:
- Đảm bảo chặn truy cập công khai được bật trừ khi bạn thực sự cần.
- (Tùy chọn) Bật versioning nếu muốn lưu các phiên bản tệp.
- Tạo bucket:
- Nhấp Create bucket để hoàn tất thiết lập.
Bước 2: Tải tệp lên bucket S3
- Tải tệp:
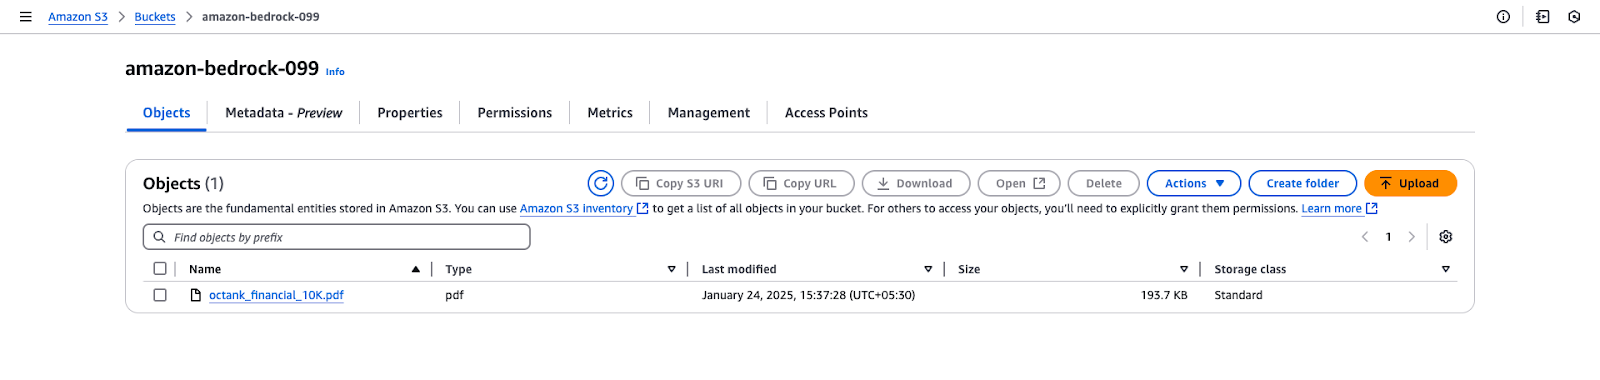
- Liên kết GitHub cung cấp tệp PDF mẫu với dữ liệu giả: octank_financial_10K.pdf. Bạn có thể dùng tệp khác nếu muốn.
- Lưu tệp vào máy tính của bạn.
- Tải tệp lên S3:
- Mở bucket S3 vừa tạo trong AWS Console.
- Nhấp Upload và chọn tệp
octank_financial_10K.pdf. - Rà soát và thiết lập quyền (mặc định: private).
- Nhấp Upload để thêm tệp vào bucket.

Giao diện bucket Amazon S3 cho "amazon-bedrock-099".
Amazon Bedrock cho phép bạn tạo cơ sở tri thức được hỗ trợ bởi các cơ sở dữ liệu vector. Các bước sau sẽ hướng dẫn bạn tạo cơ sở tri thức, cấu hình nguồn dữ liệu và chọn mô hình embedding cùng kho vector.
Bước 1: Cung cấp thông tin cơ sở tri thức
- Đi tới Amazon Bedrock Console và chọn Knowledge Bases trong phần Builder tools.
- Nhấp Create Knowledge Base và điền các thông tin sau:
- Tên Knowledge Base: Nhập tên duy nhất (ví dụ,
knowledge-base-quick-start). - Mô tả Knowledge Base: (Tùy chọn) Mô tả ngắn gọn về cơ sở tri thức.
- Trong phần IAM permissions:
- Chọn “Create and use a new service role” hoặc “Use an existing service role”.
- Đảm bảo vai trò dịch vụ có quyền cần thiết để truy cập Bedrock.
- Ví dụ vai trò dịch vụ:
AmazonBedrockExecutionRoleForKnowledgeBase. - Nhấp Next để tiếp tục cấu hình nguồn dữ liệu.
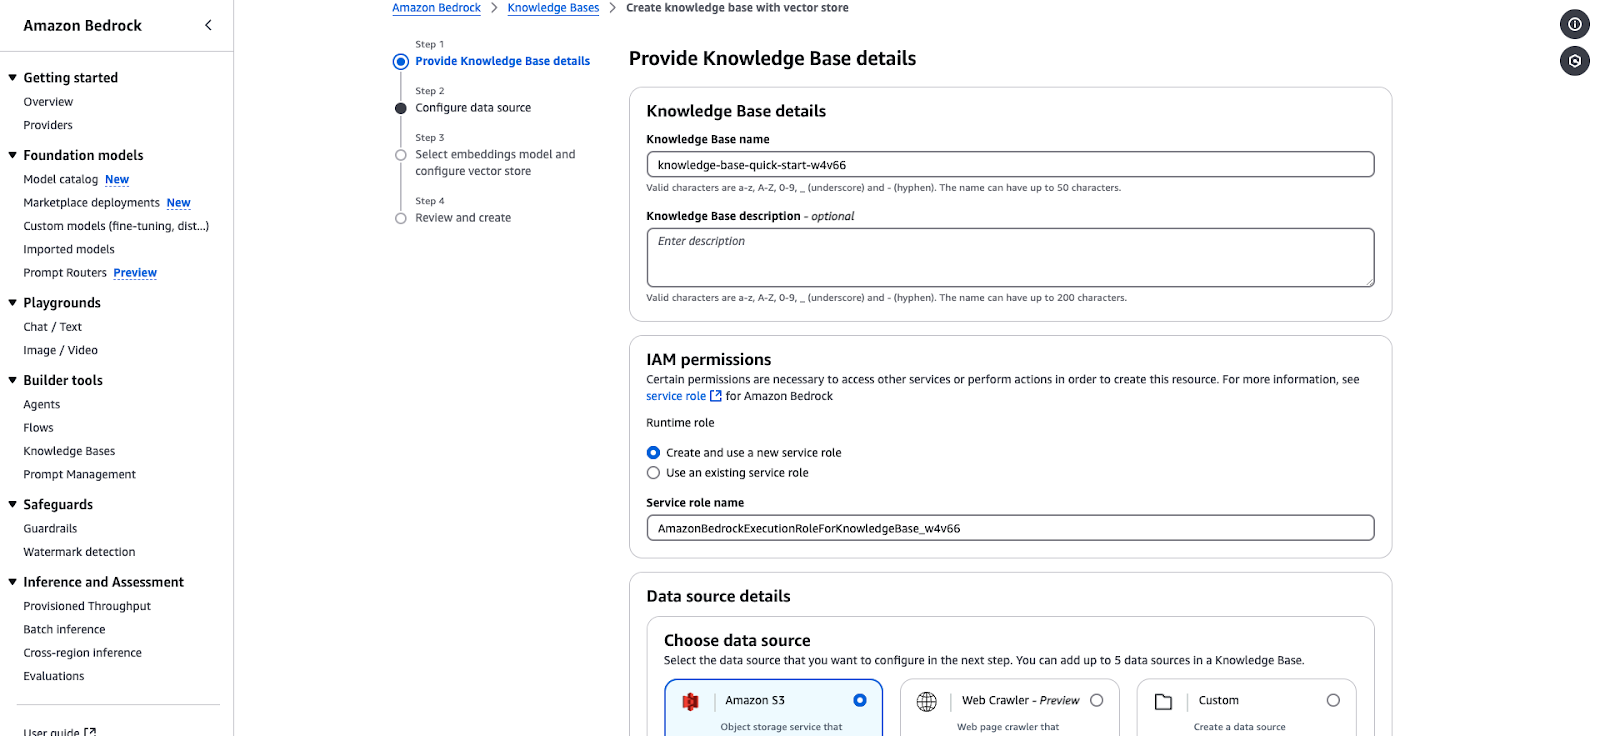
Trình hướng dẫn tạo Amazon Bedrock Knowledge Base.
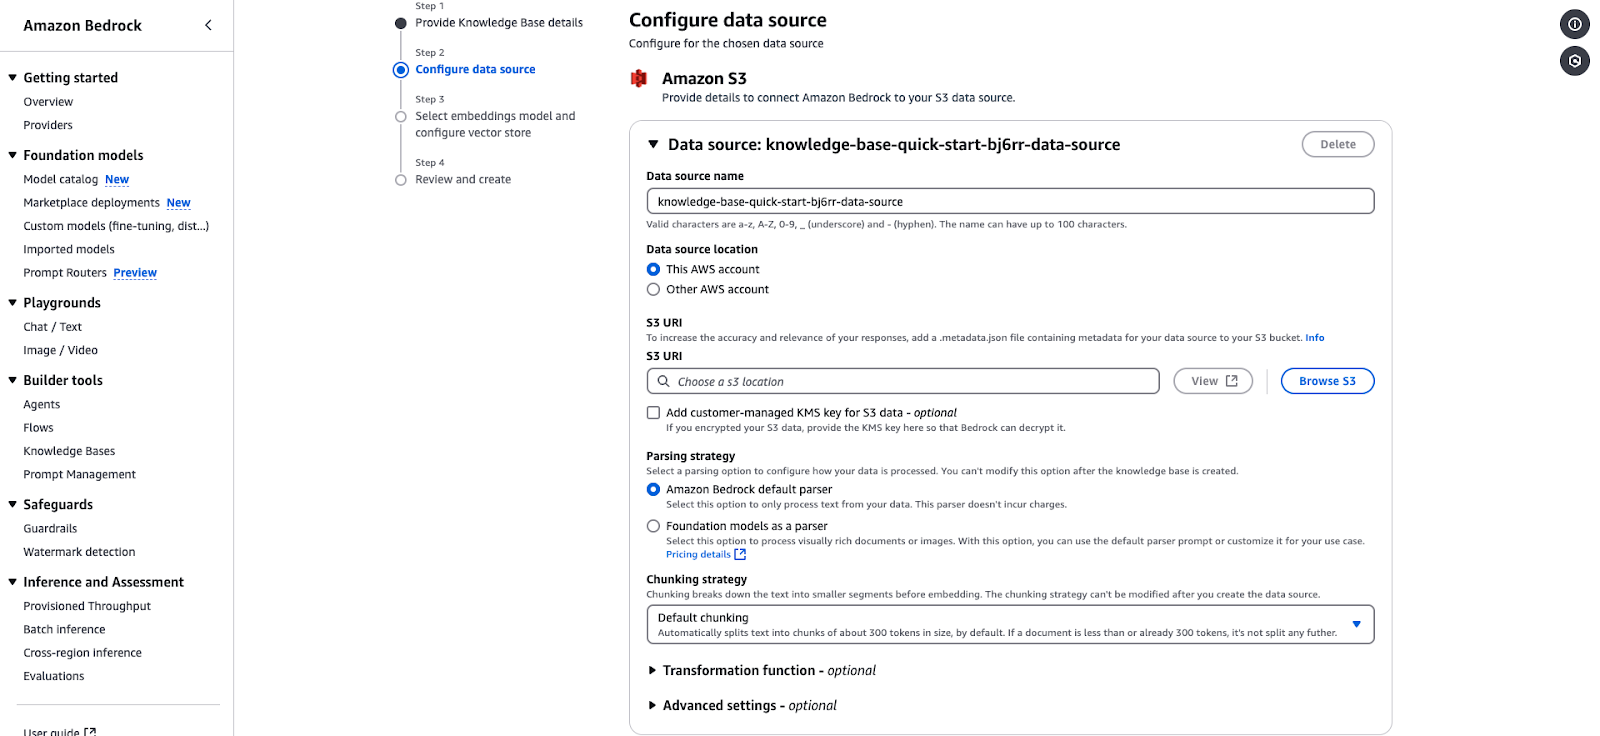
Bước 2: Cấu hình nguồn dữ liệu
- Trong phần Data source details, chọn nguồn dữ liệu của bạn:
- Amazon S3: Chọn tùy chọn này vì dữ liệu nằm trên S3.
- Chỉ định các nội dung sau:
- Vị trí nguồn dữ liệu: Chọn "This AWS Account" hoặc "Other AWS Account."
- S3 URI: Cung cấp URI bucket S3 chứa dữ liệu. Chọn S3 bạn đã tạo ở bước trước và tệp tương ứng.
- Khóa mã hóa: (Tùy chọn) Thêm khóa KMS do khách hàng quản lý nếu dữ liệu được mã hóa.
- Cấu hình chiến lược phân tách (parsing):
- Default parser: Xử lý dữ liệu văn bản thuần. Có thể giữ nguyên.
- Foundation models as parser: Xử lý tài liệu phức tạp hoặc hình ảnh. Có thể giữ nguyên.
- Chiến lược chia khối (chunking):
- Thiết lập mặc định chia văn bản thành các khối khoảng 300 token để embedding. Có thể giữ nguyên.
- (Tùy chọn) Thêm Transformation functions hoặc cài đặt nâng cao để tiền xử lý dữ liệu. Có thể giữ nguyên.
- Nhấp Next để tiếp tục.

Trang cấu hình nguồn dữ liệu Amazon Bedrock để tích hợp cơ sở tri thức dựa trên S3.
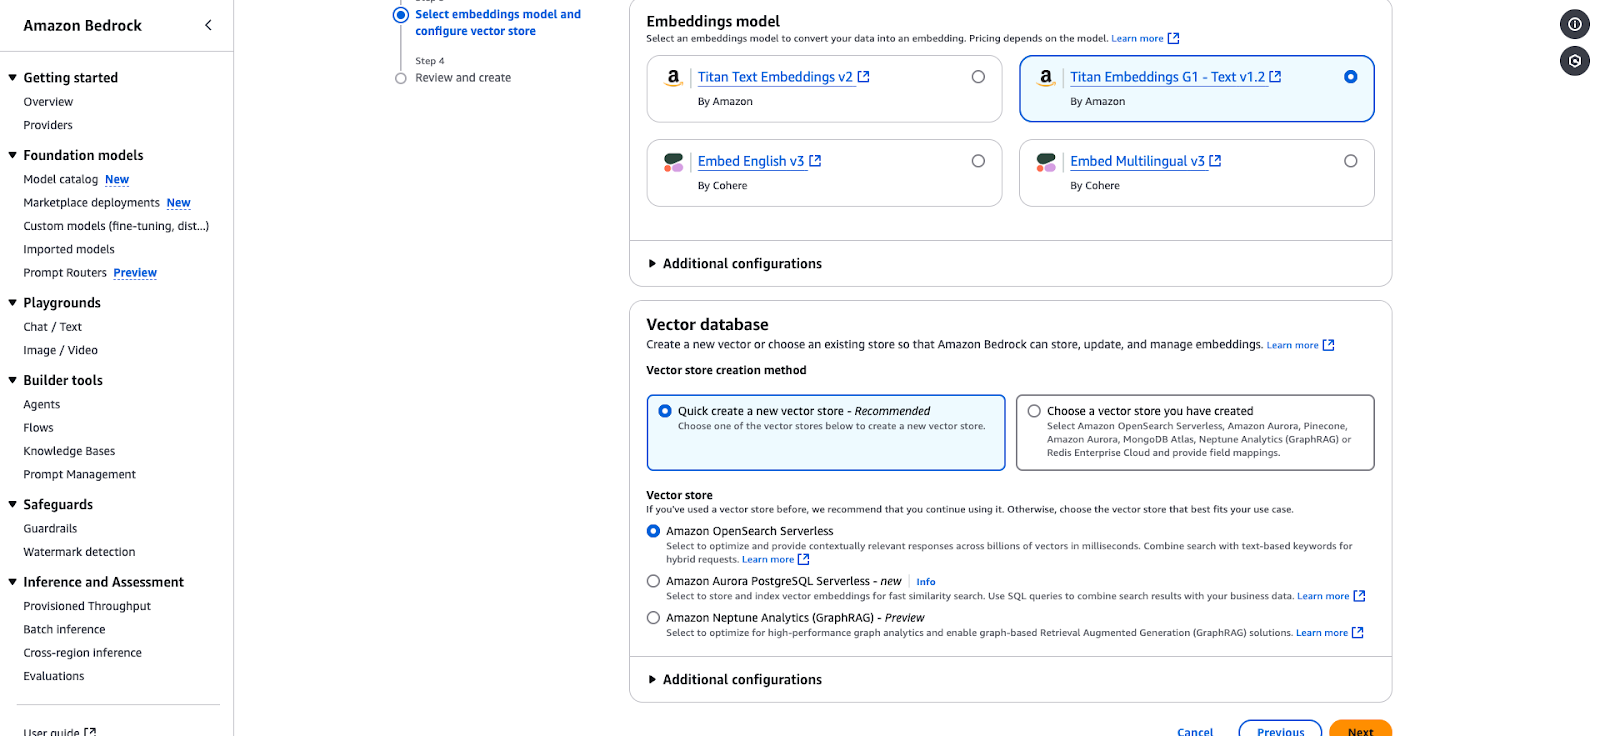
Bước 3: Chọn mô hình embedding và cấu hình kho vector
- Chọn mô hình Embeddings để chuyển dữ liệu thành biểu diễn vector:
- Titan Embeddings G1 - Text v1.2 (Bạn có thể chọn cho hướng dẫn này.)
- Embed English v3
- Embed Multilingual v3
- Trong phần Vector database:
- Chọn “Quick create a new vector store” (khuyến nghị) hoặc chọn kho có sẵn.
- Các tùy chọn gồm:
- Amazon OpenSearch Serverless: Lý tưởng cho phản hồi phù hợp ngữ cảnh. Bạn có thể chọn cho mục đích hướng dẫn này.
- Amazon Aurora PostgreSQL Serverless: Tối ưu cho tìm kiếm tương đồng nhanh.
- Amazon Neptune Analytics: Phù hợp cho phân tích dạng đồ thị và RAG.
- Nhấp Next để rà soát và hoàn tất cấu hình.

Trang cấu hình Amazon Bedrock để chọn mô hình embedding và kho vector.
Bước 4: Rà soát và tạo
- Rà soát tất cả cấu hình.
- Xác nhận và nhấp Create để hoàn tất cơ sở tri thức.
- Sau khi tạo, cơ sở tri thức sẽ xuất hiện trong mục Knowledge Bases trên console.
Bước 5: Kiểm thử cơ sở tri thức
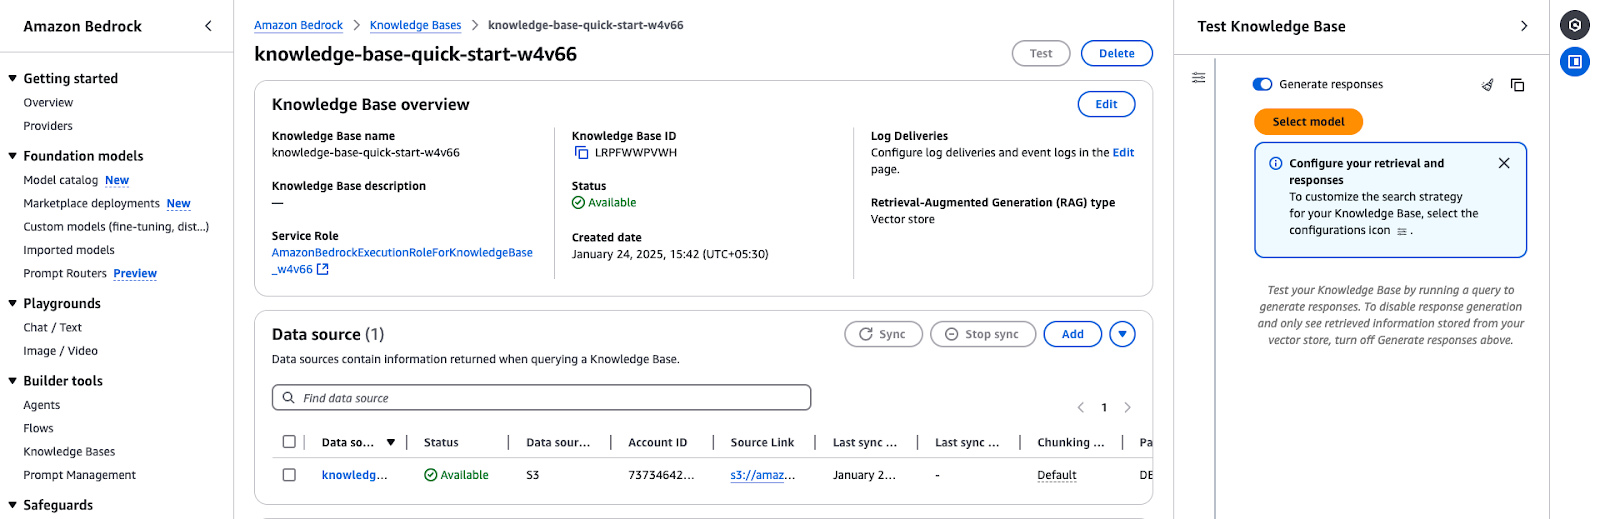
- Truy cập tổng quan cơ sở tri thức:
- Đi tới mục Knowledge Bases trong Amazon Bedrock Console.
- Chọn cơ sở tri thức bạn đã tạo (ví dụ,
knowledge-base-quick-start). - Rà soát thông tin tổng quan:
- Tên và ID Knowledge Base
- Đảm bảo trạng thái là “Available”.
- Xác minh vai trò dịch vụ đang dùng là chính xác.
- Đồng bộ và thêm nguồn dữ liệu:
- Nếu nguồn dữ liệu chưa được đồng bộ, nhấp Sync để bắt đầu.
- Bạn cũng có thể thêm tài liệu hoặc nguồn dữ liệu qua Add documents from S3.

Tổng quan Amazon Bedrock Knowledge Base hiển thị chi tiết cấu hình và trạng thái nguồn dữ liệu.
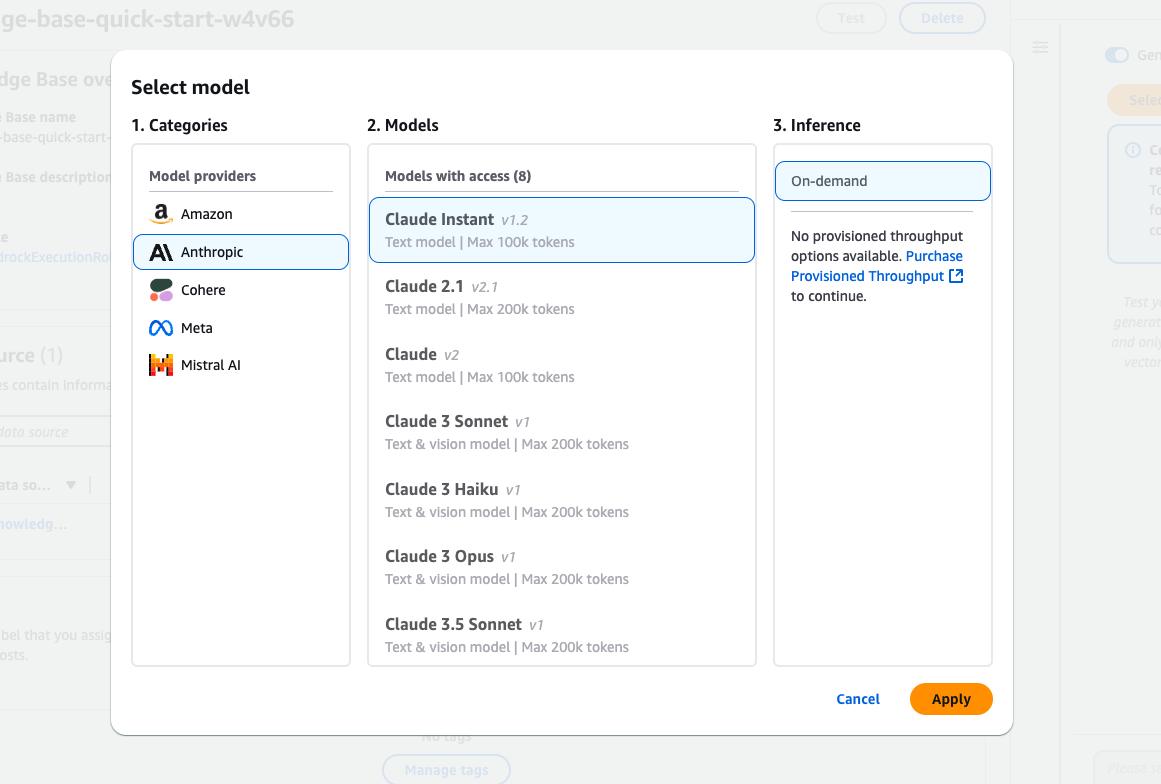
Bước 6: Chọn mô hình để kiểm thử
- Chọn mô hình nền tảng:
- Nhấp Select model trong bảng Test Knowledge Base.
- Duyệt các mô hình có sẵn từ Amazon, Anthropic và Cohere.
- Ví dụ: Chọn Claude Instant (v1.2) cho truy vấn văn bản.
- Loại suy luận:
- Chọn suy luận On-demand nếu bạn chưa thiết lập thông lượng cấp phát (provisioned throughput).
- Áp dụng mô hình:
- Nhấp Apply để hoàn tất chọn mô hình.

Giao diện chọn mô hình Amazon Bedrock với nhiều mô hình Claude từ Anthropic.
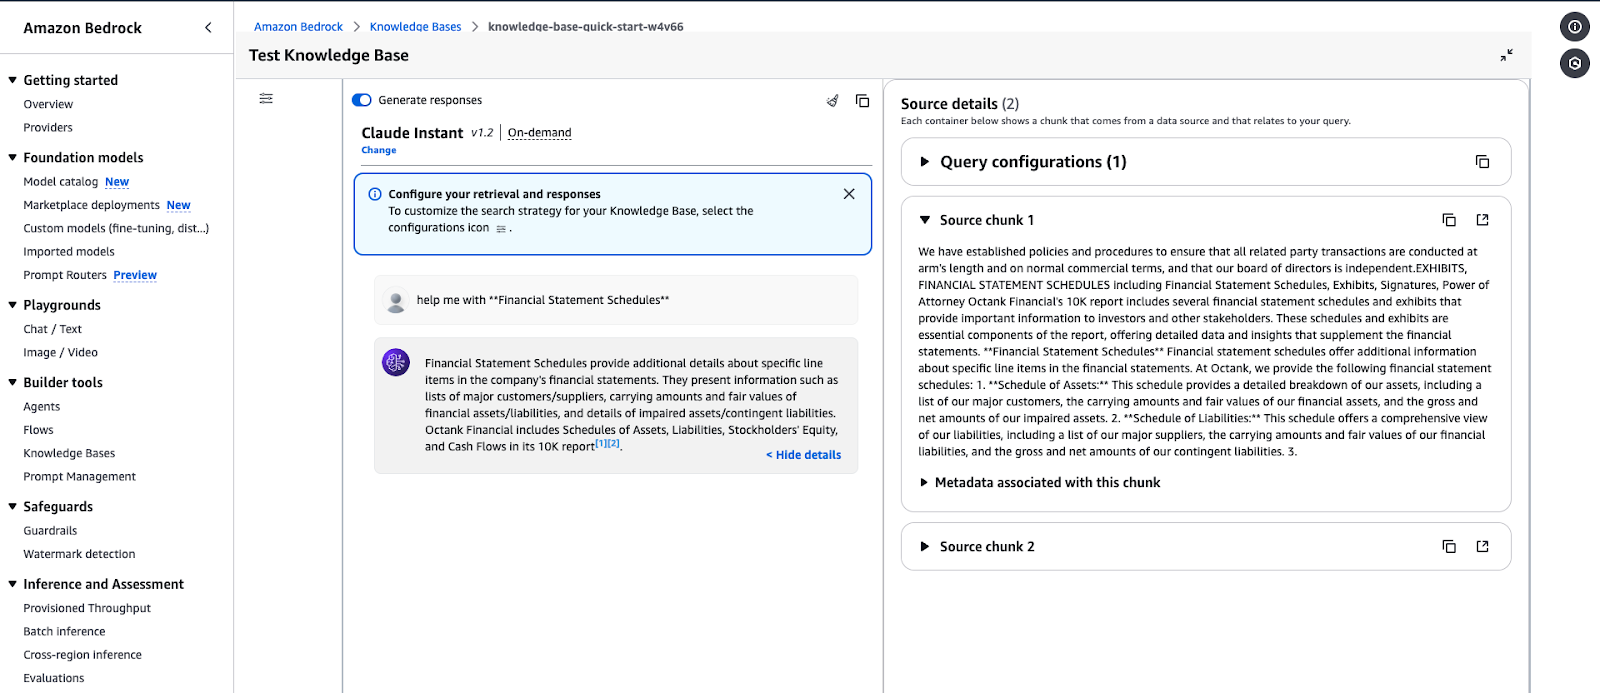
Bước 7: Chạy truy vấn và tạo phản hồi
- Tạo phản hồi:
- Nhập truy vấn vào ô nhập (ví dụ: “Help me with Financial Statement Schedules”).
- Nhấp Run để kiểm thử cơ sở tri thức.
- Xem chi tiết nguồn:
- Phản hồi sẽ bao gồm các khối dữ liệu liên quan đến truy vấn của bạn.
- Mở rộng Source Details để xem metadata và nguồn thông tin được truy xuất.
- Rà soát đầu ra:
- Xác thực phản hồi để đảm bảo phù hợp nội dung cơ sở tri thức.
- Tinh chỉnh cấu hình truy xuất nếu cần.

Giao diện kiểm thử Amazon Bedrock Knowledge Base hiển thị phản hồi cho một truy vấn.
Ví dụ đầu ra truy vấn:
- Truy vấn: “Help me with Financial Statement Schedules.”
- Phản hồi: Cơ sở tri thức sẽ truy xuất dữ liệu chi tiết các hạng mục trên báo cáo tài chính, như lịch trình tài sản, nợ phải trả và metadata liên quan.
Quản lý và triển khai mô hình AI ở quy mô lớn
Sử dụng các dịch vụ AWS như Lambda, Amazon Bedrock có thể quản lý và triển khai mô hình AI ở quy mô lớn. Cách tiếp cận tiết kiệm chi phí này đảm bảo tính sẵn sàng cao và tự động mở rộng cho các ứng dụng tích hợp AI.
Trong phần này, chúng ta sẽ dùng AWS Lambda để gọi một mô hình Bedrock một cách động, giúp bạn xử lý prompt theo yêu cầu.
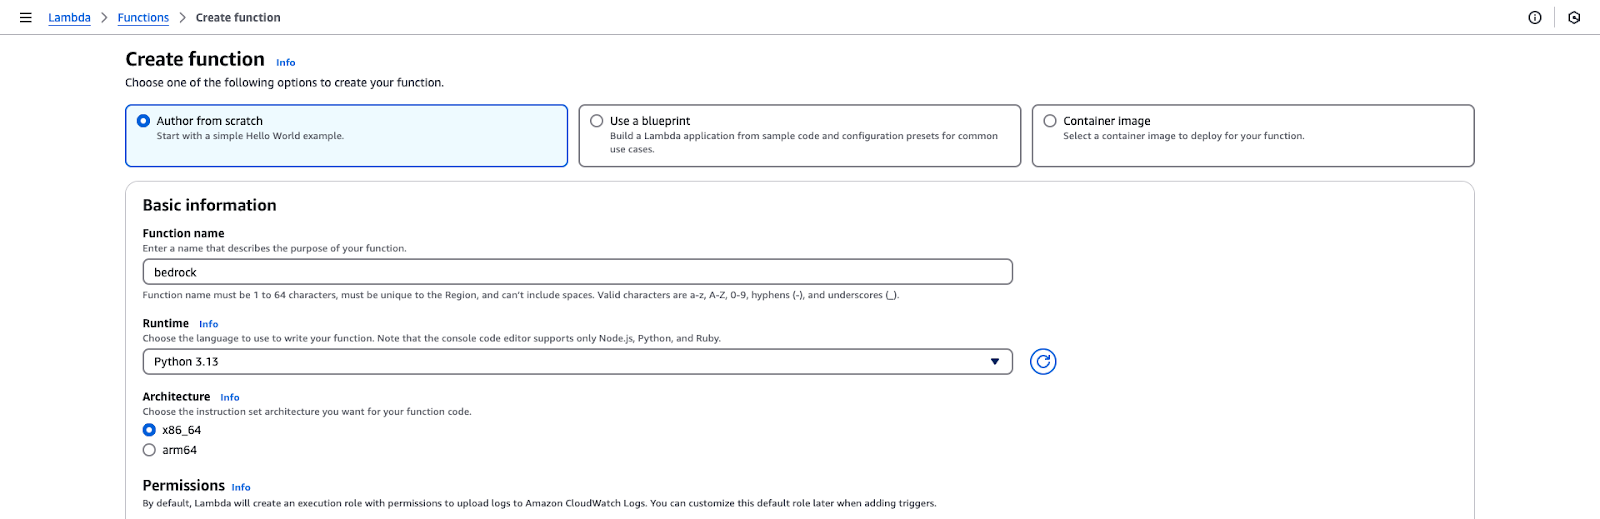
Bước 1: Tạo hàm AWS Lambda
- Đăng nhập AWS Management Console.
- Đi tới dịch vụ Lambda và nhấp Create function.
- Chọn cấu hình hàm:
- Chọn “Author from Scratch”.
- Tên hàm: bedrock.
- Runtime: Python 3.x.
- Quyền: Chọn IAM Role đã được tạo ở phần đầu hướng dẫn.
- Nhấp Create function để khởi tạo.

Trang tạo hàm AWS Lambda.
Bước 2: Thêm mã cho hàm Lambda
- Mở trình soạn thảo trong phần Code của Lambda console.
- Thay mã mặc định bằng mã được cung cấp trong Github Gist.
- Nhấp Deploy để lưu thay đổi.
Bước 3: Kiểm thử hàm Lambda
- Đi tới tab Test trong Lambda console và tạo sự kiện kiểm thử với JSON sau:
{
"prompt": "Write a formal apology letter for a late delivery."
}
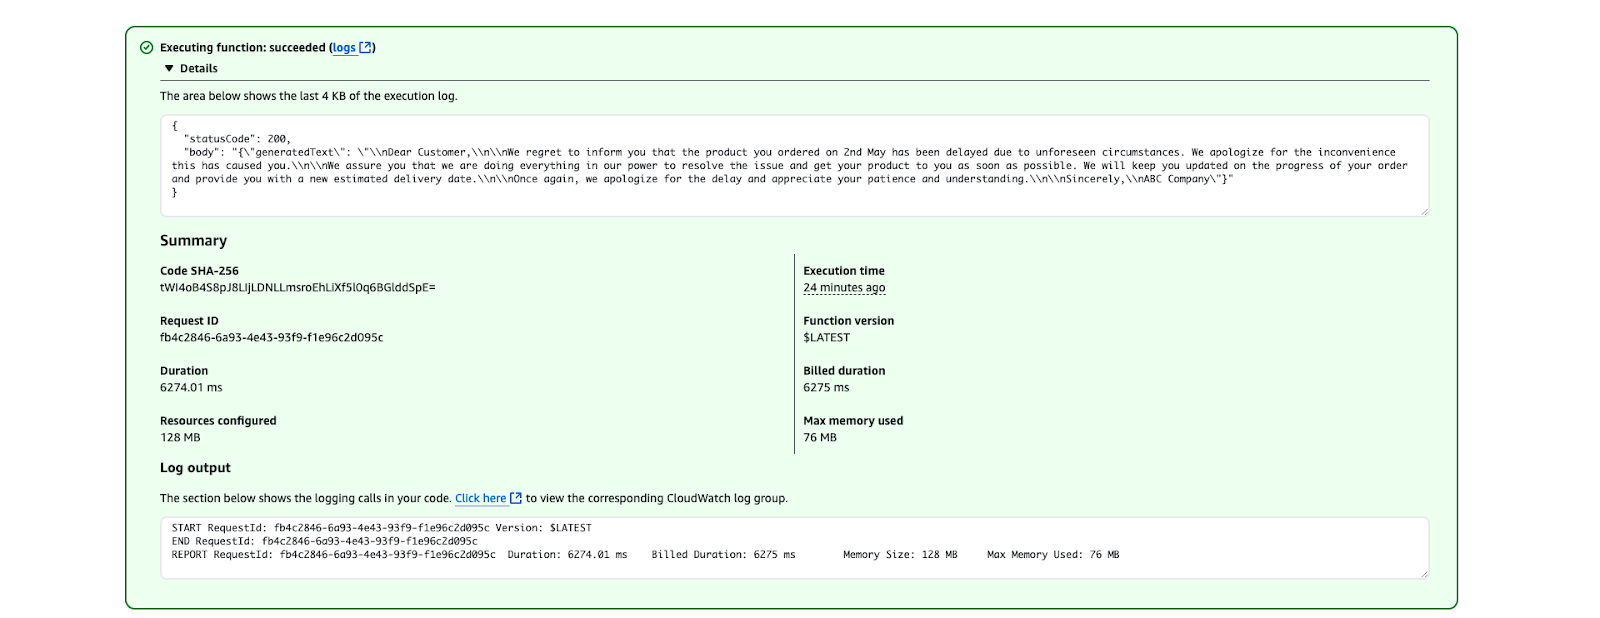
- Lưu sự kiện kiểm thử.
- Nhấp Test để gọi hàm Lambda.
- Kiểm tra đầu ra ở phần Execution results. Văn bản tạo ra sẽ giống như sau:

Kết quả thực thi AWS Lambda hiển thị hàm chạy thành công.
Thực tiễn tốt nhất khi triển khai mô hình AI
Tối ưu chi phí:
- Dùng suy luận on-demand cho các trường hợp sử dụng không thường xuyên.
- Cân nhắc thông lượng cấp phát nếu dự kiến có nhiều yêu cầu tần suất cao.
Bảo mật hàm Lambda:
- Giới hạn IAM role chỉ với quyền cần thiết.
- Dùng biến môi trường để tránh lộ dữ liệu nhạy cảm trong mã.
Giám sát và ghi log:
- Sử dụng log CloudWatch để theo dõi chỉ số gọi hàm và gỡ lỗi.
- Thiết lập cảnh báo cho lỗi hoặc độ trễ cao.
Thực tiễn tốt nhất khi sử dụng AWS Bedrock
Trong phần này, tôi chia sẻ một số thực tiễn tốt nhất khi làm việc với Amazon Bedrock, từ tối ưu chi phí đến đảm bảo bảo mật và độ chính xác.
Tối ưu chi phí
Quản lý chi phí trong AWS Bedrock có thể bao gồm tận dụng Amazon SageMaker để triển khai mô hình và sử dụng Spot instances để tiết kiệm đến 90% chi phí. Dưới đây là một số thực tiễn tốt nhất của tôi:
- Chọn mô hình nền tảng phù hợp: Chọn mô hình phù hợp nhu cầu. Ưu tiên mô hình nhỏ, ít tài nguyên cho tác vụ ít phức tạp để giảm chi phí tính toán. Ví dụ, dùng Amazon Titan cho tác vụ văn bản như tóm tắt, hoặc Stability AI cho tạo ảnh đơn giản.
- Batch inference: Thay vì xử lý từng yêu cầu riêng lẻ, hãy nhóm nhiều yêu cầu suy luận thành lô. Điều này giảm tần suất gọi mô hình, dẫn tới chi phí thấp hơn.
- Tận dụng chính sách vòng đời S3: Chỉ lưu dữ liệu cần thiết cho suy luận hoặc tinh chỉnh trên Amazon S3. Dùng chính sách vòng đời để tự động chuyển dữ liệu sang lớp lưu trữ rẻ hơn (ví dụ, S3 Glacier) hoặc xóa dữ liệu không dùng sau thời gian định sẵn.
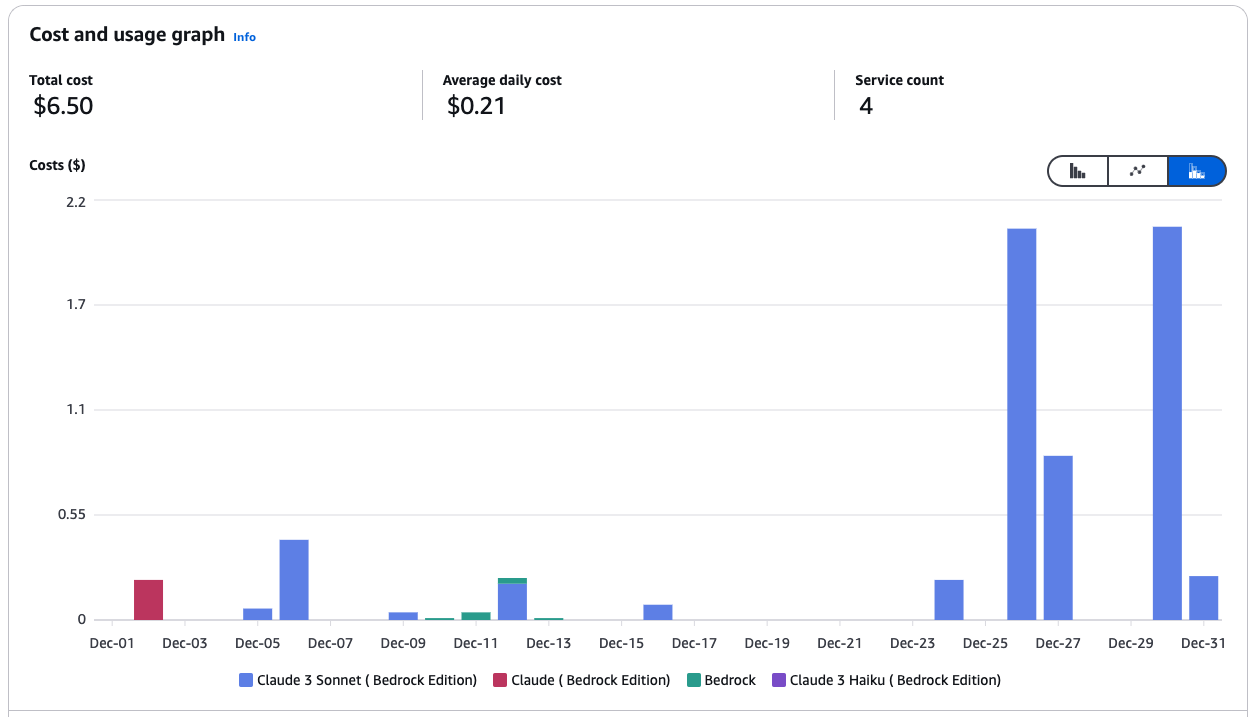
- Giám sát và kiểm soát chi tiêu: Dùng AWS Cost Explorer để phân tích mẫu chi tiêu và xác định khu vực cần tối ưu. Thiết lập AWS Budgets để nhận cảnh báo khi tiến gần ngưỡng chi phí định trước.

Biểu đồ chi phí và mức sử dụng cho dịch vụ Amazon Bedrock.
- Dùng Bedrock với SageMaker để tối ưu chi phí: Sử dụng mô hình nền tảng Bedrock trong SageMaker để tận dụng Spot instances được quản lý cho các job suy luận và huấn luyện.
- Dùng Spot instances trong SageMaker: Spot instances có thể giảm chi phí tới 90% so với On-Demand. SageMaker xử lý gián đoạn Spot thay bạn, tự động thử lại job huấn luyện nếu hết công suất Spot. Ví dụ:
from sagemaker.mxnet import MXNet
# Use spot instances for cost efficiency
use_spot_instances = True
# Maximum runtime for the training job (in seconds)
max_run = 600
# Maximum wait time for Spot instance availability (in seconds); set only if using Spot instances
max_wait = 1200 if use_spot_instances else None
# Define the MXNet estimator for the training job
mnist_estimator = MXNet(
entry_point='source_dir/mnist.py', # Path to the script that contains the model training code
role=role, # IAM role used for accessing AWS resources (e.g., S3, SageMaker)
output_path=model_artifacts_location, # S3 location to save the trained model artifacts
code_location=custom_code_upload_location, # S3 location to upload the training script
instance_count=1, # Number of instances to use for training
instance_type='ml.m4.xlarge', # Instance type for the training job
framework_version='1.6.0', # Version of the MXNet framework to use
py_version='py3', # Python version for the environment
distribution={'parameter_server': {'enabled': True}}, # Enable distributed training with a parameter server
hyperparameters={ # Training hyperparameters
'learning-rate': 0.1, # Learning rate for the training job
'epochs': 5 # Number of training epochs
},
use_spot_instances=use_spot_instances, # Enable Spot instances for cost savings
max_run=max_run, # Maximum runtime for the training job
max_wait=max_wait, # Maximum wait time for Spot instance availability
checkpoint_s3_uri=checkpoint_s3_uri # S3 URI for saving intermediate checkpoints
)
# Start the training job and specify the locations of training and testing datasets
mnist_estimator.fit({
'train': train_data_location, # S3 location of the training dataset
'test': test_data_location # S3 location of the testing/validation dataset
})
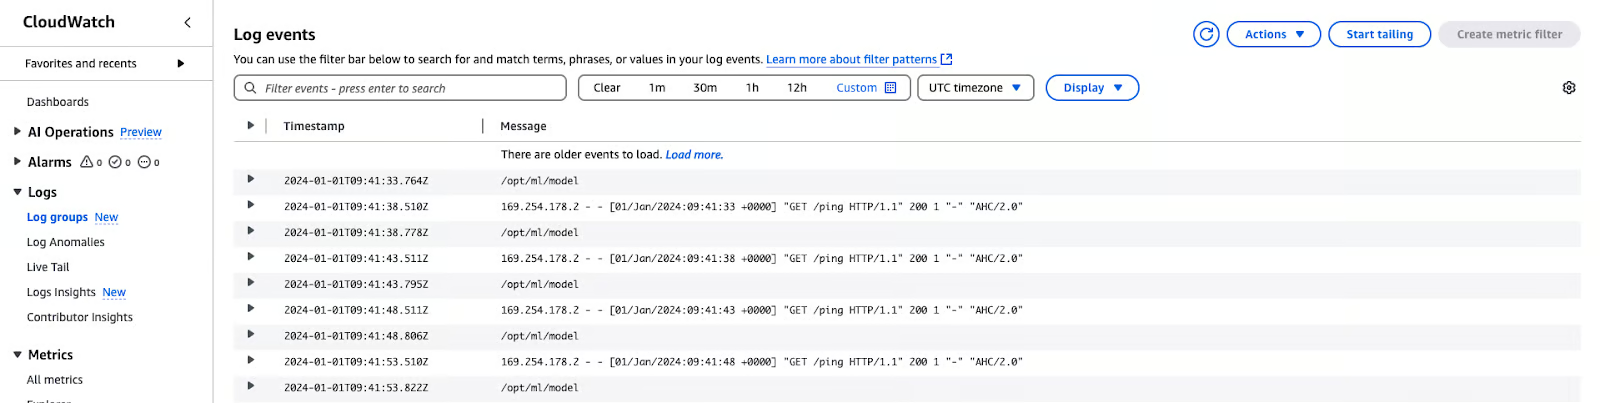
- Dùng số liệu và log CloudWatch: Chỉ số huấn luyện và log có sẵn trong Amazon CloudWatch, cung cấp nhận định về hiệu năng và mức sử dụng tài nguyên.

Log AWS CloudWatch
Bảo mật
Để đảm bảo bảo mật, tuân thủ và hiệu năng cho Amazon Bedrock, điều quan trọng là tuân theo các thực tiễn tốt nhất. Dưới đây là khuyến nghị của tôi:
- Áp dụng nguyên tắc đặc quyền tối thiểu: Giới hạn quyền IAM và vai trò dịch vụ ở mức cần thiết để ngăn truy cập trái phép.
- Xác thực vai trò dịch vụ và nhóm bảo mật: Đảm bảo agent Bedrock và job tùy biến mô hình được cấu hình đúng với vai trò dịch vụ và cài đặt bảo mật hoạt động.
- Chạy khối lượng công việc trong VPC: Tăng cường bảo mật bằng cách chạy job tùy biến và xử lý dữ liệu bên trong Virtual Private Cloud (VPC).
- Mã hóa dữ liệu quan trọng: Sử dụng Amazon KMS Customer-Managed Keys (CMK) để mã hóa phiên agent, không gian làm việc Bedrock Studio, mô hình tùy biến và dữ liệu tạm thời của cơ sở tri thức.
- Thiết lập chính sách xóa dữ liệu: Chỉ giữ dữ liệu lưu trong kho vector khi nguồn tri thức đang hoạt động; thiết lập tự động xóa khi không còn cần thiết.
- Tăng cường guardrails của Bedrock: Đặt Prompt Attack Strength ở mức CAO và bật bộ lọc thông tin nhạy cảm để bảo vệ khỏi tấn công và rò rỉ dữ liệu.
- Bảo vệ phiên của agent: Dùng guardrails để ngăn truy cập trái phép và bảo vệ tương tác nhạy cảm.
- Bật ghi log để tăng khả năng quan sát: Bật ghi log gọi mô hình ở cấp tài khoản để theo dõi hoạt động và phát hiện bất thường.
- Phòng vệ trước tấn công chéo dịch vụ: Dùng chính sách vai trò dịch vụ để ngăn Cross-Service Confused Deputy Attacks.
Giám sát và đánh giá mô hình
Đảm bảo mô hình chính xác, tin cậy và phù hợp mục tiêu kinh doanh đạt được thông qua giám sát và đánh giá mô hình. Dưới đây là một số thực tiễn tốt nhất:
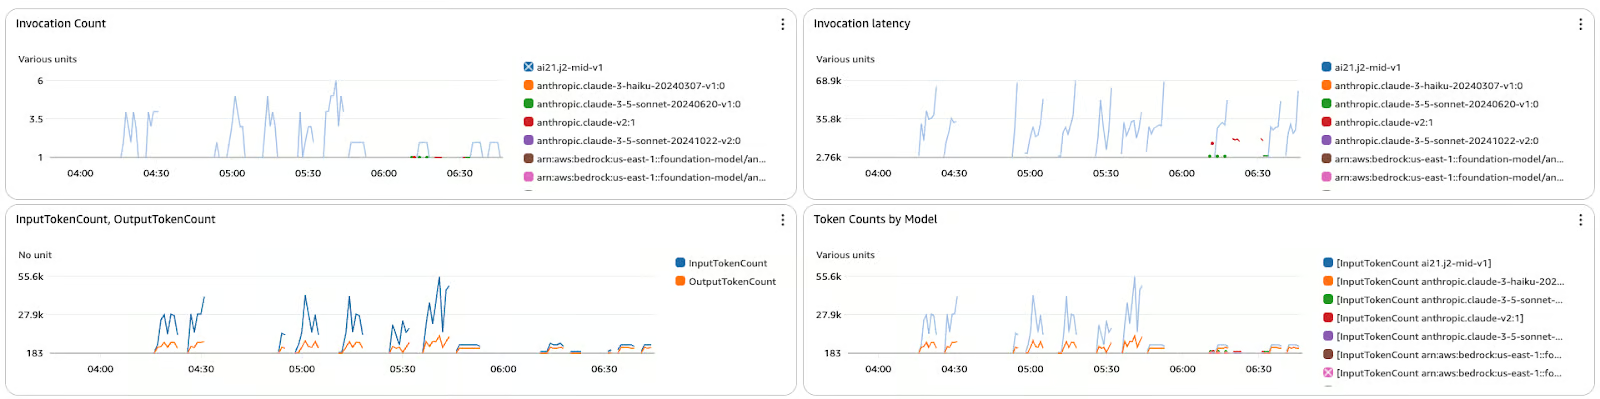
- Theo dõi chỉ số hiệu năng: Dùng CloudWatch để theo dõi độ trễ, lỗi và xu hướng gọi.
- Ghi log đầu vào và đầu ra: Bật ghi log chi tiết để gỡ lỗi và phân tích xu hướng.
- Kết hợp vòng phản hồi: Dùng các công cụ như Amazon A2I để có đánh giá của con người cho đầu ra quan trọng.
- Đánh giá đầu ra thường xuyên: So sánh đầu ra với tập dữ liệu kiểm định hoặc ground truth.
- Cải thiện mô hình liên tục: Tinh chỉnh mô hình bằng tập dữ liệu cập nhật hoặc dữ liệu theo miền khi cần.

Bảng điều khiển chỉ số hiển thị số lần gọi, độ trễ và số token cho các mô hình trong Amazon Bedrock.
Kết luận
AWS Bedrock đang thay đổi cách các ứng dụng AI tạo sinh được phát triển, cung cấp nền tảng tập trung để sử dụng mô hình nền tảng mà không lo về hạ tầng.
Từ đây, hướng dẫn từng bước này sẽ giúp bạn xác định mô hình phù hợp, xây dựng quy trình làm việc an toàn, có khả năng mở rộng và tích hợp các tính năng như retrieval-augmented generation (RAG) để tùy chỉnh sâu hơn. Với các thực tiễn tốt nhất về chi phí, bảo mật và giám sát, bạn đã sẵn sàng phát triển và quản lý các giải pháp AI để đáp ứng mục tiêu của mình.
Để nâng cao chuyên môn AWS của bạn, hãy khám phá các khóa học sau:
- AWS Cloud Technology and Services – Tìm hiểu các dịch vụ cốt lõi của AWS và cách xây dựng giải pháp cloud-native.
- AWS Security and Cost Management – Nắm vững chiến lược bảo mật môi trường AWS và tối ưu chi phí hiệu quả.
- Developing AI Applications – Đi sâu vào phát triển AI và học cách xây dựng, triển khai, mở rộng các giải pháp tích hợp AI.
Rahul Sharma là AWS Ambassador, Kiến trúc sư DevOps và blogger kỹ thuật, chuyên về điện toán đám mây, thực hành DevOps và công nghệ mã nguồn mở. Với chuyên môn về AWS, Kubernetes và Terraform, anh giúp đơn giản hóa các khái niệm phức tạp cho người học và chuyên gia thông qua những bài viết và hướng dẫn hấp dẫn. Rahul đam mê giải quyết các thách thức DevOps và chia sẻ hiểu biết nhằm trao quyền cho cộng đồng công nghệ.