Ana içeriğe atla

Amazon Bedrock: Yapay Zekâ Uygulamaları Geliştirmeye Yönelik Eksiksiz Rehber

Amazon Bedrock kullanarak üretken yapay zekâ uygulamalarını nasıl geliştireceğinizi keşfedin. Bu adım adım eğitim, özelliklerini, kurulumunu ve optimizasyon tekniklerini açıklar.
Güncel 3 Eki 2026  · 15 dk. oku

Yapay Zeka ile Keşfedin

ChatGPTClaudePerplexity

Üretken yapay zekâ, doğal dil işleme, bilgisayarlı görü ve daha birçok alanda ilerlemeyi tetikleyerek tüm sektörlerde oyunun kurallarını değiştirdi. Ancak bu potansiyeli kullanmak çoğu zaman maliyetler, karmaşık altyapı ve zorlu öğrenme eğrileri gibi sorunları da beraberinde getirdi. İşte tam bu noktada AWS Bedrock devreye giriyor – bu çözüm, altyapıyı yönetme gereği olmadan temel modelleri kullanmanıza olanak tanıyarak engelleri kaldırıyor.

Bu eğitim, Amazon Bedrock hakkında kapsamlı bir rehber olmayı amaçlıyor; ne olduğunu, nasıl çalıştığını ve nasıl kullanabileceğinizi açıklıyor. Rehberin sonunda, kendi üretken yapay zekâ uygulamalarınızı — ölçeklenebilir, esnek ve hedeflerinize uygun — geliştirmek için gereken bilgi ve becerilere sahip olacaksınız.

Amazon Bedrock nedir?

Amazon Bedrock, Amazon Web Services (AWS) tarafından sunulan ve üretken yapay zekânın temel yapı taşları olan temel modellere (FM'ler) erişim ve yönetim için geliştirilmiş yönetilen bir AWS hizmetidir. Bedrock, GPU sağlama, model hatları yapılandırma veya başka herhangi bir altyapıyı yönetme zorunluluğunu ortadan kaldırarak süreci son derece basitleştirir.

AWS Bedrock, yeniliğe açılan bir kapıdır. Geliştiricilerin Anthropic, Stability AI ve Amazon’un Titan’ı gibi önde gelen sağlayıcıların en yeni yapay zekâ modellerini keşfetmesine, test etmesine ve dağıtmasına olanak tanıyan birleştirilmiş bir platformdur.

Örneğin bir müşteri destek sohbet botu geliştirdiğinizi düşünün. AWS Bedrock ile gelişmiş bir dil modeli seçebilir, uygulamanızın ihtiyaçlarına göre ayarlayabilir ve sunucu yapılandırması kodu yazmak zorunda kalmadan uygulamanıza entegre edebilirsiniz.

AWS Bedrock’un özellikleri

AWS Bedrock’un özellikleri, bir yapay zekâ fikrinden üretime geçişi basitleştirmek ve hızlandırmak için tasarlanmıştır. Gelin ayrıntılı olarak inceleyelim.

Birden çok temel modele erişim

AWS Bedrock’un en önemli avantajlarından biri, sunulan temel model çeşitliliğidir. Metin tabanlı uygulamalar, görsel içerik veya güvenli ve yorumlanabilir yapay zekâ üzerinde çalışıyor olun, Bedrock sizin için uygun seçenekler sunar. Mevcut modellerden bazıları şunlardır:
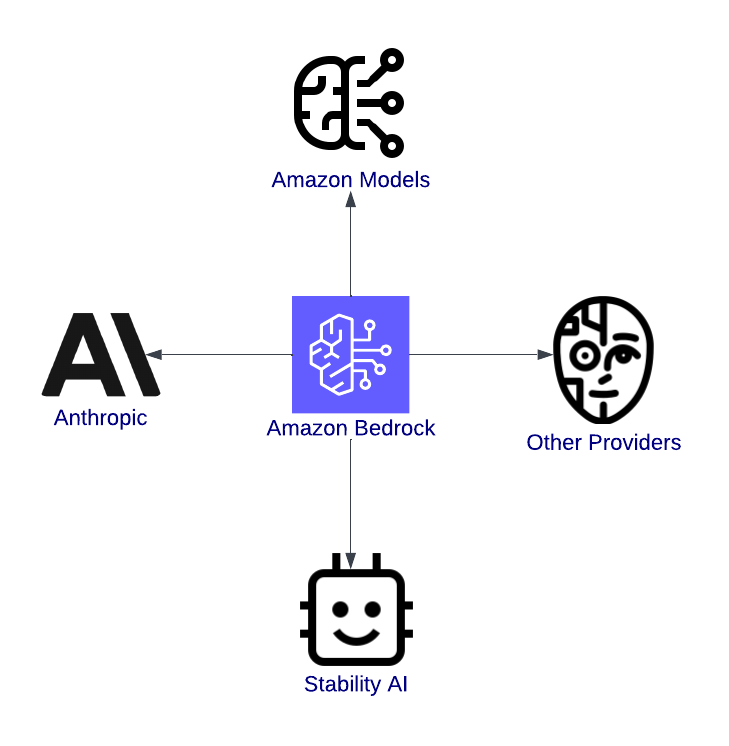
  • Amazon modelleri: Bu tescilli modeller, sohbet botları veya içerik üretimi uygulamaları için insan benzeri metin oluşturma, belgeleri özüne indirgeme ya da müşteri geri bildirimlerinin duygu analizini yapma gibi görevlerde kullanılabilir.
  • Anthropic modelleri: İyi ve güvenli yapay zekâ geliştirmeye odaklanan bu modeller, bankacılık veya sağlık gibi uyumluluk ve güven gerektiren sektörlere uygundur.
  • Stability AI: Stability AI modelleri, görüntü üretimiyle tanınır. Pazarlama, sanat veya ürün geliştirme için fikirleri görsellere dönüştürmeye yardımcı olurlar.

Amazon Bedrock’un, Amazon Modelleri, Anthropic, Stability AI ve diğer sağlayıcılara bağlanarak üretken yapay zekâ hizmetleri için bir merkez olarak rolünü gösteren diyagram.

Amazon Bedrock’a genel bakış; model entegrasyonlarını vurgular.

Altyapı yönetimi yok

AWS Bedrock altyapı yönetimini soyutlar, bu da şu anlama gelir:

  • GPU örnekleri sağlamanıza gerek yoktur.
  • Sunucusuz bir mimariyle yalnızca uygulama geliştirmeye odaklanabilirsiniz.
  • Kullanım kolaylığı, kurulum sürelerini çoğu zaman haftalardan saatlere indirir.

Ölçeklenebilirlik ve esneklik

Üretken yapay zekâ uygulamalarında talep genellikle öngörülemezdir. Bir sohbet botu yoğun saatlerde yüzlerce kullanıcıya yanıt verirken gece yalnızca birkaç kullanıcı olabilir. AWS Bedrock ise yerleşik ölçeklenebilirliğiyle bunu çözer:

  • Otomatik ölçekleme: Modeller, iş yükü artışlarını sizin müdahalenize gerek kalmadan otomatik olarak karşılayacak şekilde ayarlanır.
  • Paralel iş yükleri: Tek bir uygulama içinde farklı kullanım senaryoları için birden fazla modeli aynı anda çalıştırabilirsiniz.
  • Küresel erişilebilirlik: AWS’nin küresel ağıyla uygulamalarınızı kullanıcılarınıza yakın bölgelerde dağıtabilirsiniz; bu da gecikmeyi azaltır ve kullanıcı deneyimini iyileştirir.

AWS ekosistemiyle entegrasyon

AWS Bedrock yalnızca güçlü modeller sunmakla kalmaz — uçtan uca yapay zekâ iş akışlarını desteklemek için diğer AWS hizmetleriyle de entegre olur. Bazı entegrasyonlar şunlardır:

  • Amazon SageMaker: Temel modellerin belirli gereksinimlere göre ince ayar yapılmasını sağlar.
  • AWS Lambda: Yeni verilerle modeli ayarlama ya da çıkarım sonuçlarını gözden geçirme gibi olay güdümlü yapay zekâ uygulamalarını kolaylaştırır.
  • Amazon CloudWatch: Model performansını analiz etmek ve kullanıcı geri bildirimi toplamak için izleme ve günlükleme yetenekleri sağlar.
  • Amazon S3: Veri kümeleri için depolama çözümü olarak hizmet eder; performans takibi ve maliyet analizi yapılmasını mümkün kılar.

AWS Bedrock Kurulumu

Bu bölümde gerekli izinleri ayarlama, bir AWS hesabı oluşturma ve AWS Bedrock ile çalışmaya başlama adımlarını bulacaksınız.

Adım 1: AWS hesabı oluşturma (henüz yoksa)

Henüz hesabınız yoksa AWS’nin kayıt sayfasına giderek bir hesap oluşturun. Mevcut kullanıcılar için, IAM kullanıcınızın yönetici ayrıcalıklarına sahip olduğundan emin olun.
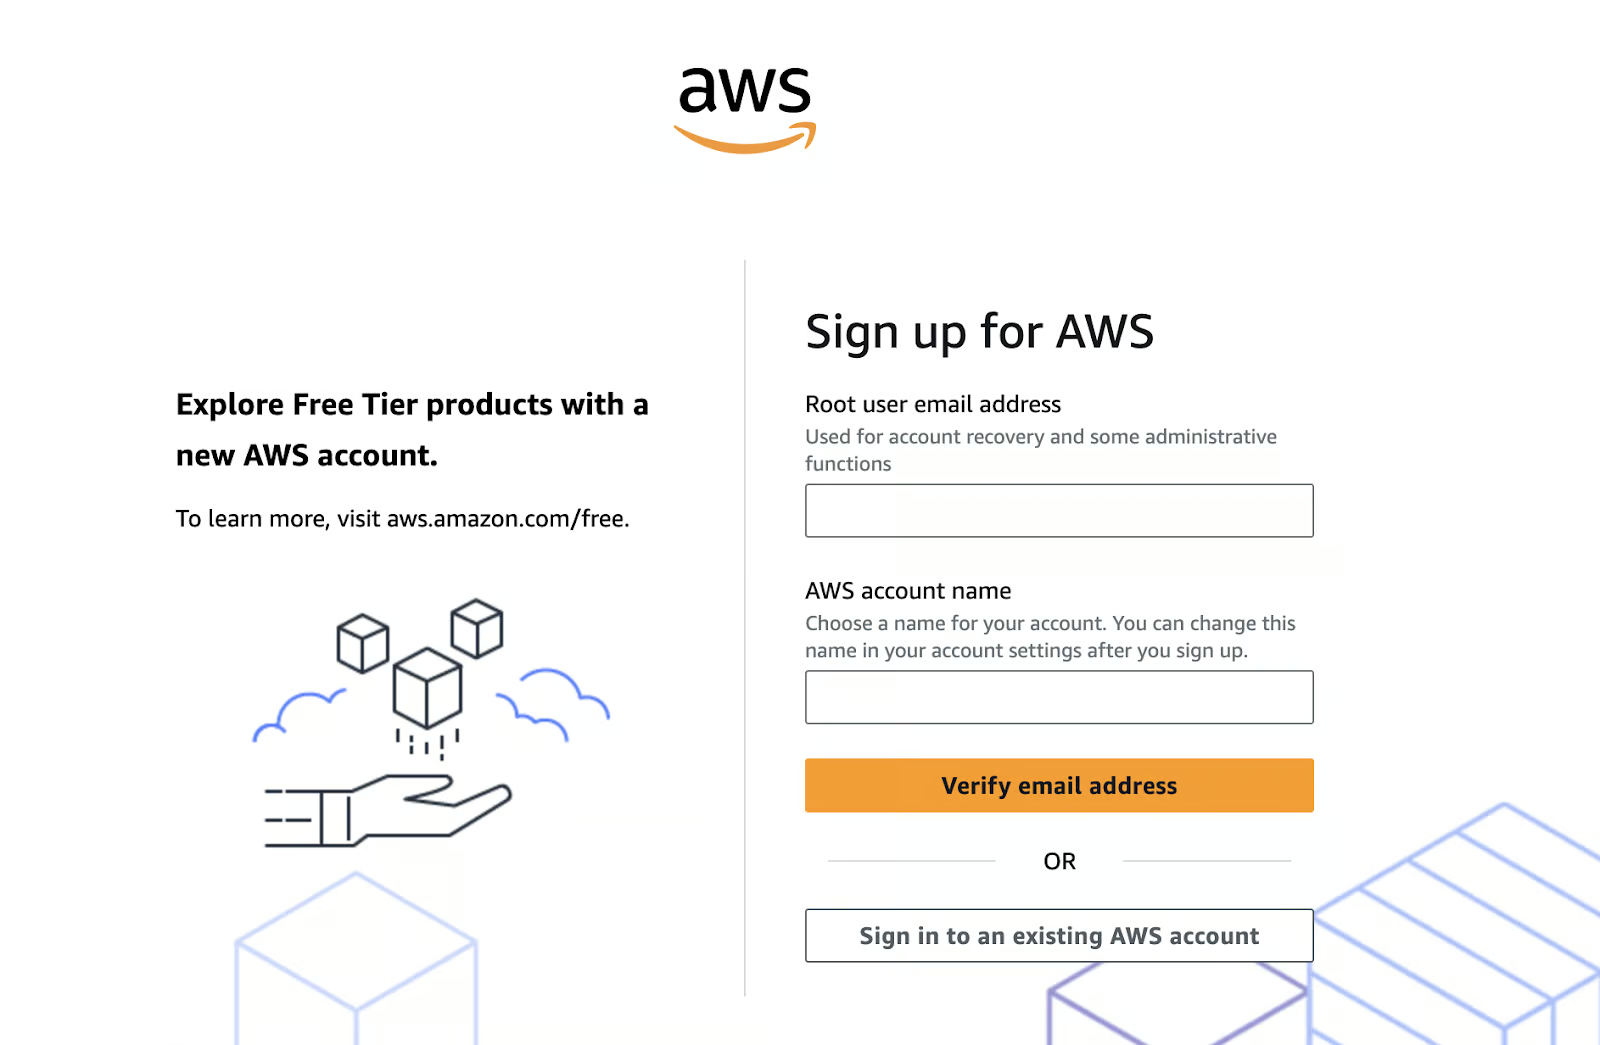
Kök kullanıcı e-posta adresi ve AWS hesap adı girişi için form içeren AWS kayıt sayfası.

Yeni hesaplar için Ücretsiz Katman ürün keşfini gösteren AWS kayıt sayfası.

Ayrıntılı adımlar arıyorsanız lütfen AWS'nin resmi rehberini ziyaret edin.

Adım 2: AWS Bedrock’a gitme

Amazon Bedrock, AWS Management Console üzerinden erişilebilir. Bulmak ve kullanmaya başlamak için şu adımları izleyin:
  • AWS Management Console’a giriş yapın: AWS Console adresine gidin ve giriş bilgilerinizi girin.
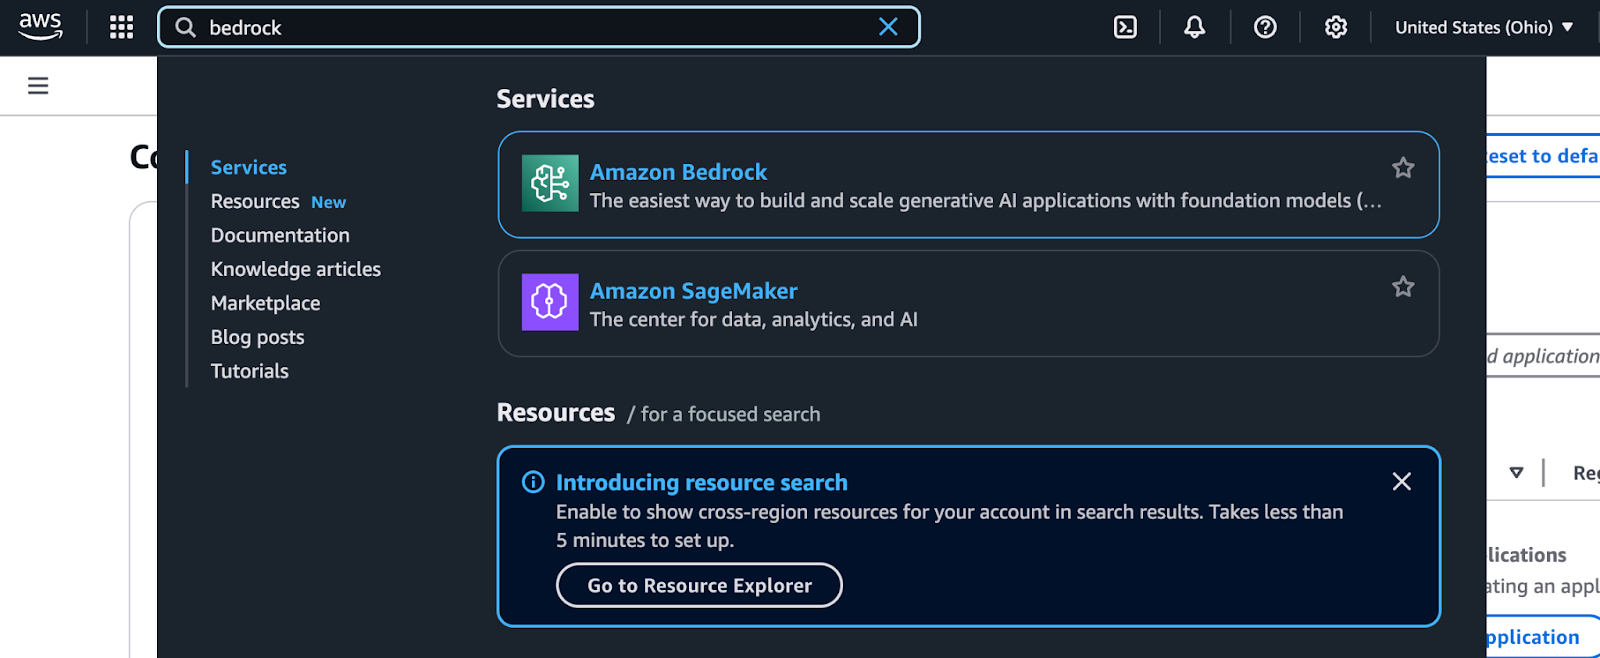
  • Bedrock’u arayın: Konsolun üst kısmındaki arama çubuğunu kullanın. “Bedrock” yazın ve açılır listeden seçin.

"Bedrock" için AWS Management Console arama sonuçlarının ekran görüntüsü; üretken yapay zekâ uygulamaları için Amazon Bedrock, veri ve yapay zekâ analitiği için Amazon SageMaker ve bölge çapında kaynak aramaya giriş vurgulanmış.

Bedrock için AWS Management Console arama sonuçları.
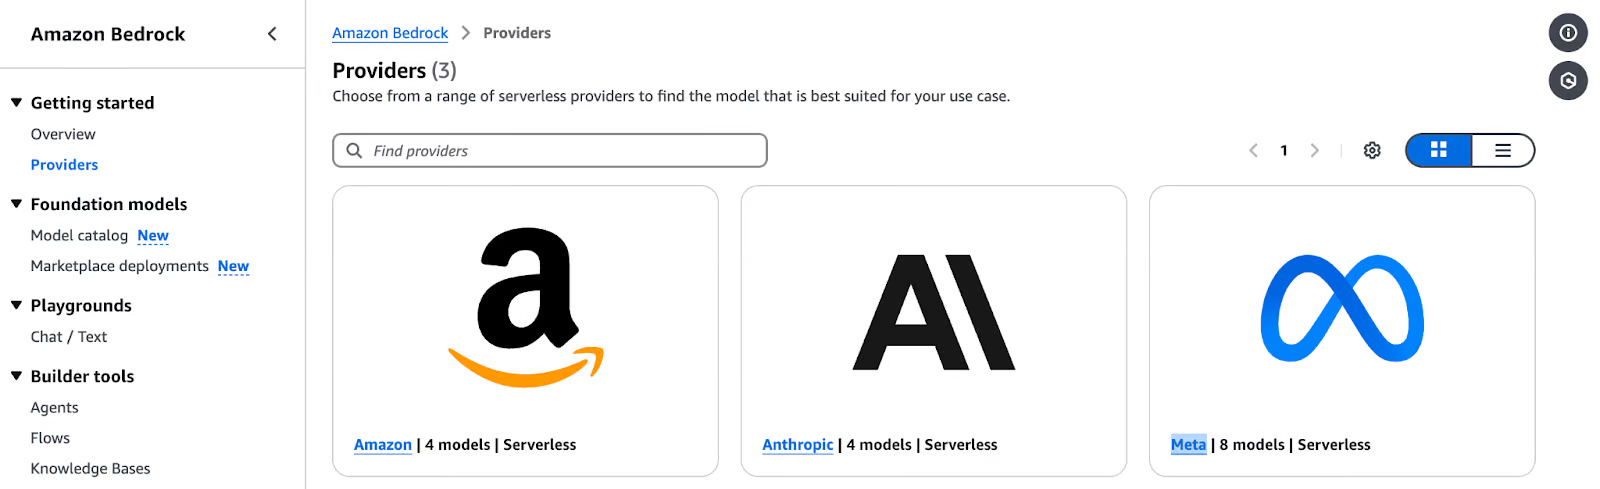
  • Bedrock panosunu keşfedin: Bedrock panosuna geçtiğinizde, model sağlayıcıları ve temel model seçeneklerini göreceksiniz.

Amazon, Anthropic ve Meta olmak üzere üç sunucusuz model sağlayıcısını gösteren Amazon Bedrock Providers sayfasının ekran görüntüsü

Amazon Bedrock Providers sayfası, Amazon’dan sunucusuz model seçeneklerini sergiliyor.
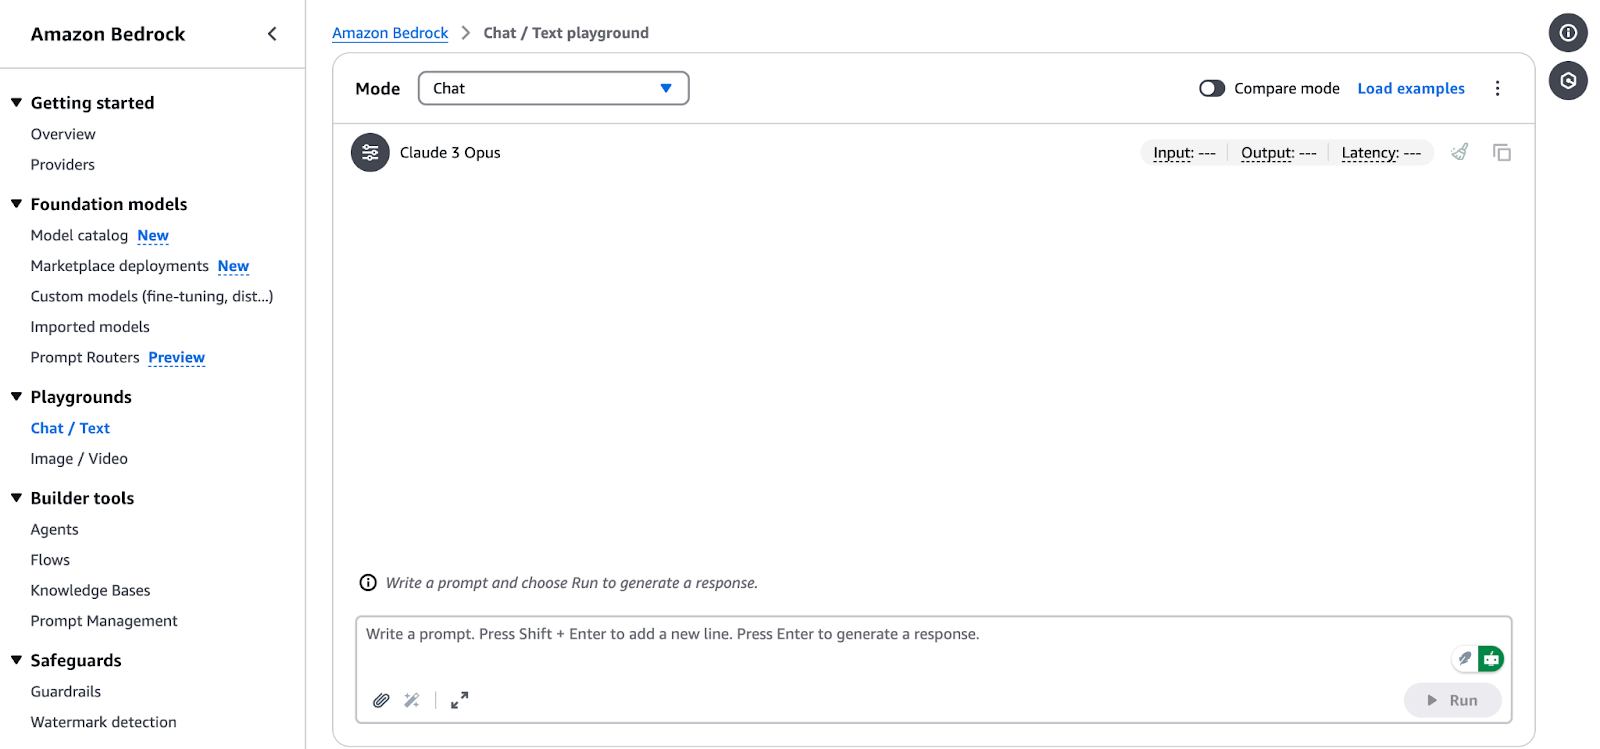
  • Bir model sağlayıcı ve temel model seçin:
    • Kullanım senaryonuza göre bir sağlayıcı seçin (ör. metin üretimi için Amazon Titan, görseller için Stability AI vb.).
    • Girdi türleri, desteklenen özellikler ve çıktı parametreleri gibi modele özgü seçenekleri keşfedin.
  • Test çıkarımı çalıştırın: AWS Bedrock, örnek çıkarımları doğrudan konsoldan çalıştırmanıza olanak tanır. Bu, modele uygulamanıza entegre etmeden önce her bir modelin nasıl çalıştığını görmek için harika bir yöntemdir.

Claude 3 Opus modelini içeren Amazon Bedrock Chat/Text Playground ekran görüntüsü. Arayüzde istem girişi, yanıt çalıştırma ve farklı modelleri karşılaştırma seçenekleri yer alıyor. Sol panelde "Getting started," "Foundation models," "Playgrounds," "Builder tools," ve "Safeguards" gibi seçenekler listelenmiş.

Amazon Bedrock Chat/Text Playground arayüzü.

Adım 3: IAM izinlerini ayarlama

AWS Kimlik ve Erişim Yönetimi (IAM), AWS Bedrock’a güvenli erişim için kritik öneme sahiptir. İzinleri yapılandırmak için şu adımları izleyin:
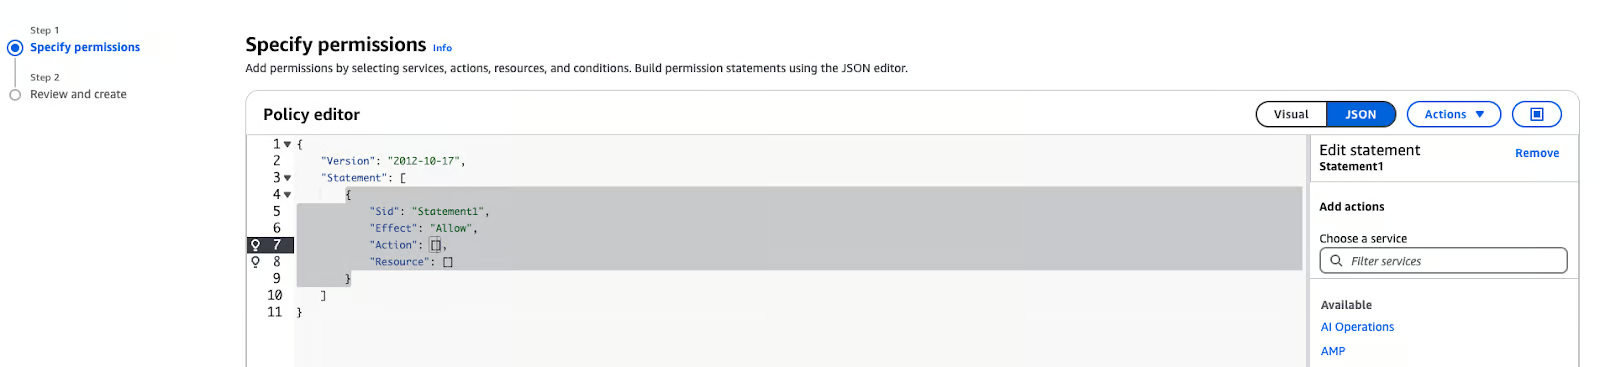
  • AWS Management Console’da IAM hizmetine gidin.
  • Kenar çubuğunda Roller'ı tıklayın ve İlke oluştur'yi seçin.
  • İzinleri belirt bölümünde “JSON”u seçin.

JSON modunda kısmen yapılandırılmış bir ilke gösteren AWS IAM Policy Editor ekran görüntüsü; "Action" ve "Resource" listeleri boş. Sol kenar çubuğunda iki adımlı süreç: "Specify permissions" ve "Review and create." Sağ panelde eylem ekleme, hizmet filtreleme ve ifade kaldırma seçenekleri var.

JSON modunda AWS IAM Policy Editor

  • Aşağıdaki ilkeyi metin kutusuna yapıştırın:
{
    "Version": "2012-10-17",
    "Statement": [        {
            "Sid": "BedrockFullAccess",
            "Effect": "Allow",
            "Action": ["bedrock:*"],
            "Resource": "*"
        }
    ]
}

Not: Yukarıdaki ilke, Amazon Bedrock hizmetine erişmesi gereken herhangi bir role eklenebilir. Bu bir SageMaker rolü veya bir kullanıcı olabilir. Amazon SageMaker kullanırken, not defterinizin yürütme rolü genellikle AWS Management Console’a giriş yapmak için kullandığınız kullanıcı veya rolden farklıdır. AWS Console kullanarak Amazon Bedrock hizmetini nasıl keşfedeceğinizi öğrenmek için, Console kullanıcı veya rolünüzü yetkilendirdiğinizden emin olun. Not defterlerini, AWS Bedrock hizmetine erişimi ve geçerli kimlik bilgileri olan herhangi bir ortamdan çalıştırabilirsiniz.

Üretken Yapay Zekâ Uygulamaları için Amazon Bedrock Kullanımı

Üretken yapay zekâ uygulamaları, metin üretimi, görsel oluşturma veya veri dönüştürme gibi belirli bir göreve göre ince ayar yapılan temel modellere dayanır. Aşağıda bir temel model seçme, temel çıkarım işleri yürütme ve model yanıtlarını ihtiyaçlarınıza göre uyarlama konusunda adım adım bir rehber bulacaksınız.

Bir temel model seçme

Doğru temel modeli seçmek önemlidir çünkü projenizin ihtiyaçlarına bağlıdır. Şöyle seçim yapabilirsiniz:

1. Kullanım senaryonuzu belirleyin:

  • Metin üretimi: Özetleme, içerik üretimi veya sohbet botu geliştirme gibi görevler için şu modelleri değerlendirin:
    • Amazon Titan Text G1: Bağlamı iyi anlayarak yüksek kaliteli metin üretir.
    • Anthropic Claude 3: Bağlama uygun ve tutarlı metin üretmede çok iyidir; bu nedenle konuşma tabanlı yapay zekâ uygulamaları için uygundur.
  • Görüntü üretimi: Projeniz görsel içerik veya görüntü oluşturmayla ilgiliyse Stability AI modelleri doğru seçimdir:
    • Stable Diffusion 3.5 Large: Metin açıklamalarından foto-gerçekçi veya sanatsal görüntüler üretmede çok başarılıdır.
  • Multimodal görevler: Hem metin hem de görsel işlemeye ihtiyaç duyan uygulamalar için Amazon Nova modelleri önerilir:
    • Nova Lite: Metin, görsel ve video girdi alıp metin çıktı üretebilen, maliyet duyarlı bir multimodal model.
    • Nova Pro: Daha karmaşık görevler için yetkin bir multimodal model.

2. Model yeteneklerini değerlendirin:

  • Her modelin belirli güçlü yönlerini inceleyerek projenizin ihtiyaçlarıyla uyumlu olduğundan emin olun. Desteklenen temel modeller hakkında ayrıntılı bilgi, yetenekleri ve desteklenen bölgeler dahil, AWS dokümantasyonunda mevcuttur.

Model erişimini etkinleştirme

Bu modelleri kullanmadan önce AWS hesabınızda model erişimini etkinleştirmeniz gerekir. Kurulum adımları şöyledir:
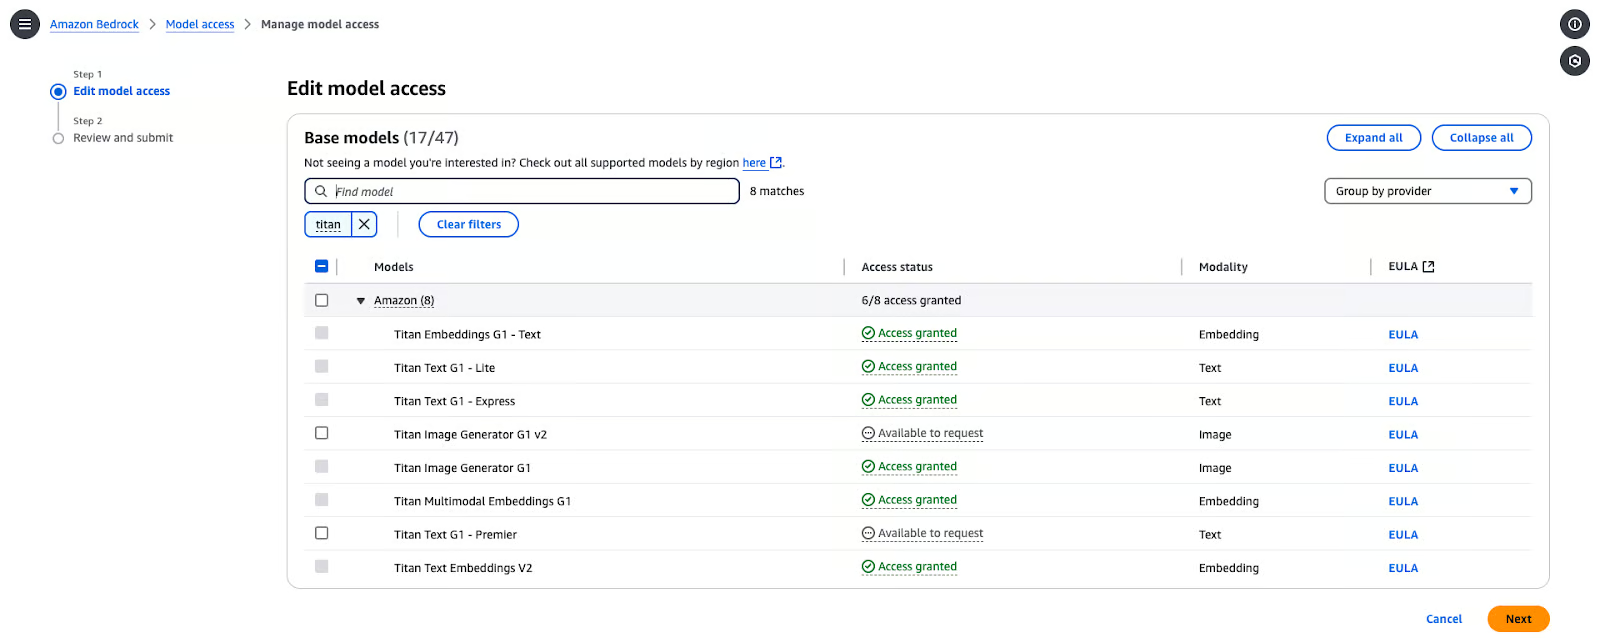
  • Bedrock Konsolu’nda Models access bölümüne gidin.
  • Konsolda Modify model access'ı tıklayın.
  • Sağlayıcılardan mevcut modelleri göz atın ve beğendiğinizi seçin. Bu örnekte Titan Text G1—Express seçilmiştir.

Amazon Titan modellerinin erişim durumlarını gösteren Amazon Bedrock "Edit model access" sayfasının ekran görüntüsü. Bazı modellerde "Access granted" yazarken, bazıları "Available to request" durumunda. Arayüzde model filtreleme, bölümleri genişletme/daraltma ve sağlayıcıya göre gruplama seçenekleri bulunuyor. Sol panelde iki adımlı süreç: "Edit model access" ve "Review and submit."

Amazon Bedrock model erişim yönetimi sayfası.

  • Next'i tıklayın ve ardından Review and submit'i seçin.

Temel çıkarım çalıştırma

AWS Bedrock’ta seçtiğiniz temel modeli kullanarak çıkarım yapmak için şu adımları izleyin:

  • Python için AWS SDK’yı (boto3) kurun:
pip install boto3
  • Bedrock istemcisini başlatın: Seçtiğiniz AWS bölgesinde bir Bedrock çalışma zamanı istemcisi oluşturun:
import boto3
import json
from botocore.exceptions import ClientError

# Set the AWS Region
region = "us-east-1"

# Initialize the Bedrock Runtime client
client = boto3.client("bedrock-runtime", region_name=region)
  • Modeli çağırın: Model kimliğini ve girdi istemini tanımlayın:
# Define the model ID for Amazon Titan Express v1
model_id = "amazon.titan-text-express-v1"

# Define the input prompt
prompt = """
Command: Compose an email from Tom, Customer Service Manager, to the customer "Nancy" 
who provided negative feedback on the service provided by our customer support 
Engineer"""
  • İstek yükünü biçimlendirin:
# Configure inference parameters
inference_parameters = {
   "inputText": prompt,
   "textGenerationConfig": {
       "maxTokenCount": 512,  # Limit the response length
       "temperature": 0.5,    # Control the randomness of the output
   },
}

# Convert the request payload to JSON
request_payload = json.dumps(inference_parameters)
  • Yanıtı işleyin:
try:
   # Invoke the model
   response = client.invoke_model(
       modelId=model_id,
       body=request_payload,
       contentType="application/json",
       accept="application/json"
   )

   # Decode the response body
   response_body = json.loads(response["body"].read())

   # Extract and print the generated text
   generated_text = response_body["results"][0]["outputText"]
   print("Generated Text:\n", generated_text)

except ClientError as e:
   print(f"ClientError: {e.response['Error']['Message']}")
except Exception as e:
   print(f"An error occurred: {e}")

Not: Tam kodu doğrudan şuradan erişip kopyalayabilirsiniz: GitHub Gist.

Aşağıdaki çıktıyı bekleyebilirsiniz:

% python3 main.py

Generated Text:
 
Tom:
Nancy,

I am writing to express my sincere apologies for the negative experience you had with our customer support engineer. It is unacceptable that we did not meet your expectations, and I want to assure you that we are taking steps to prevent this from happening in the future.

Sincerely,
Tom
Customer Service Manager

Model çıktılarının özelleştirilmesi

Model çıktısının davranışını ince ayar yapmak için temperature ve maxTokenCount gibi parametreleri ayarlayabilirsiniz:

  • temperature: Çıktının rastgeleliğini kontrol eder. Düşük değerler çıktıyı daha kararlı, yüksek değerler ise daha değişken kılar.
  • MaxTokenCount: Üretilen çıktının maksimum uzunluğunu belirler.

Örneğin:

inference_parameters = {
   "inputText": prompt,
   "textGenerationConfig": {
       "maxTokenCount": 256,  # Limit the response length
       "temperature": 0.7,    # Control the randomness of the output
   },
}

Bu parametreleri ayarlayarak, oluşturulan içeriğin yaratıcılığını ve uzunluğunu uygulamanızın ihtiyaçlarına daha iyi uyarlayabilirsiniz.

Gelişmiş Amazon Bedrock Özellikleri

Şimdi vitesi değiştirip iki ileri düzey yaklaşıma odaklanalım: Bilgi Getirmeyle Zenginleştirilmiş Üretim (RAG) kullanarak yapay zekâyı geliştirme ve modelleri ölçekli olarak yönetip dağıtma.

Bilgi getirmeyle zenginleştirilmiş üretim (RAG) ile yapay zekâ çıktılarının özelleştirilmesi

RAG için bir bilgi tabanına ihtiyaç duyarız. Amazon Bedrock’ta bilgi tabanını kurmadan önce bir S3 bucket oluşturup gerekli dosyaları yüklemeniz gerekir. Şu adımları izleyin:

Adım 1: S3 bucket oluşturun

  • AWS Management Console’a giriş yapın:
    • AWS Management Console’da S3 Hizmeti'ne gidin.
  • Yeni bir bucket oluşturun:
    • Create bucket'ı tıklayın.
    • Benzersiz bir bucket adı girin.
    • Özel güvenlik veya şifreleme gereksinimleriniz yoksa varsayılan ayarları bırakın.
  • Bucket ayarlarını yapılandırın:
    • Genel erişimi engellemenin etkin olduğundan emin olun; gerekmedikçe açmayın.
    • (İsteğe bağlı) Dosyalarınızın sürümlerini tutmak istiyorsanız sürüm oluşturmayı etkinleştirin.
  • Bucket’ı oluşturun:
    • Kurulumu tamamlamak için Create bucket'ı tıklayın.

Adım 2: Dosyaları S3 bucket’ına yükleyin

  • Dosyayı indirin:
    • Sağlanan GitHub bağlantısı, sahte veriler içeren örnek bir PDF dosyası sunar: octank_financial_10K.pdf. İsterseniz farklı bir dosya kullanabilirsiniz.
    • Dosyayı yerel bilgisayarınıza kaydedin.
  • Dosyayı S3’e yükleyin:
    • AWS Console’da yeni oluşturduğunuz S3 bucket’ını açın.
    • Upload'ı tıklayın ve octank_financial_10K.pdf dosyasını seçin.
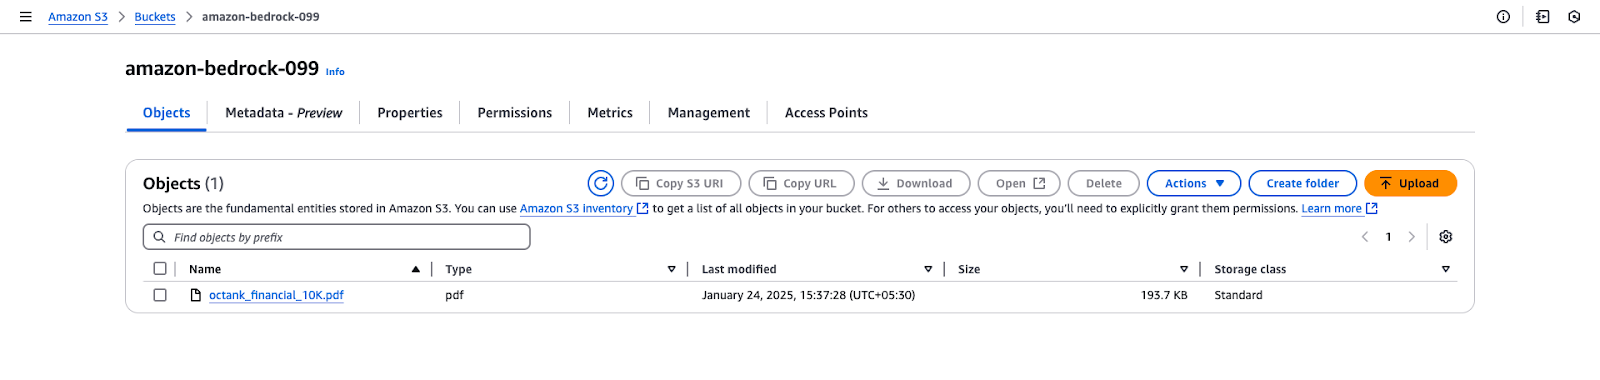
    • İzinleri gözden geçirin ve ayarlayın (varsayılan: özel).
    • Dosyayı bucket’a eklemek için Upload'ı tıklayın.

"amazon-bedrock-099" adlı bir Amazon S3 bucket’ının "Objects" sekmesini ve "octank_financial_10K.pdf" adlı tek bir PDF dosyasını gösteren ekran görüntüsü.

"amazon-bedrock-099" için Amazon S3 bucket görünümü.

Amazon Bedrock, vektör veritabanları tarafından desteklenen bir bilgi tabanı oluşturmanıza olanak tanır. Aşağıdaki adımlar, bir bilgi tabanı oluşturma, veri kaynağını yapılandırma ve gömme (embeddings) ile vektör depolarını seçme süreçlerinde size yol gösterecektir.

Adım 1: Bilgi tabanı ayrıntılarını sağlayın

  • Amazon Bedrock Konsolu’na gidin ve Builder tools bölümünün altındaki Knowledge Bases'i seçin.
  • Create Knowledge Base'i tıklayın ve aşağıdaki ayrıntıları doldurun:
    • Knowledge Base name: Benzersiz bir ad girin (ör. knowledge-base-quick-start).
    • Knowledge Base description: (İsteğe bağlı) Bilgi tabanını kısaca açıklayın.
  • IAM permissions bölümünde:
    • “Create and use a new service role” veya “Use an existing service role” seçeneklerinden birini seçin.
    • Hizmet rolünün Bedrock erişimi için gerekli izinlere sahip olduğundan emin olun.
    • Örnek Hizmet Rolü: AmazonBedrockExecutionRoleForKnowledgeBase.
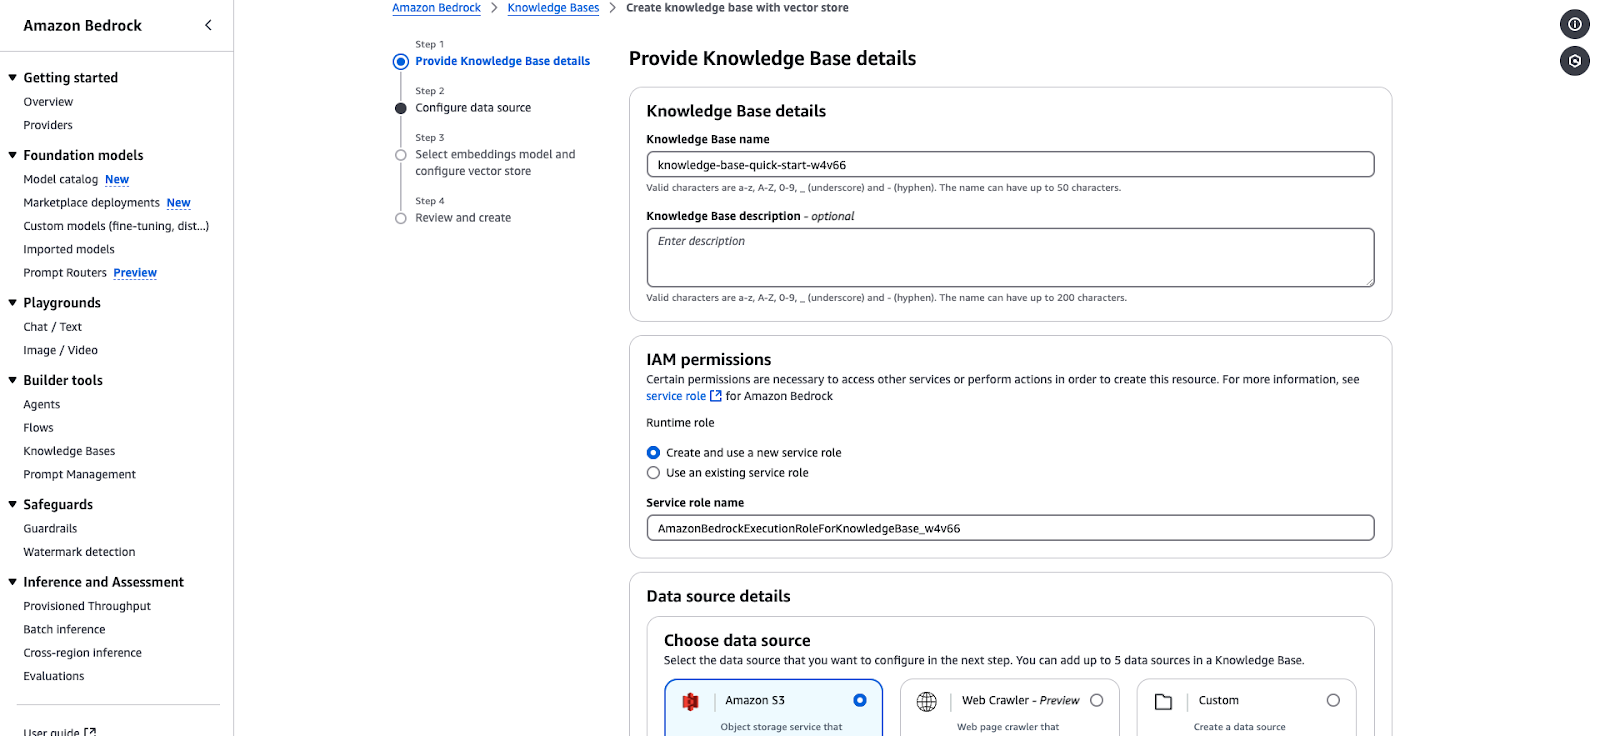
  • Veri kaynağını yapılandırmaya geçmek için Next'i tıklayın.

Amazon Bedrock Bilgi Tabanı oluşturma arayüzünün ekran görüntüsü; bir bilgi tabanını yapılandırma adımlarını gösterir.

Amazon Bedrock Bilgi Tabanı oluşturma sihirbazı.
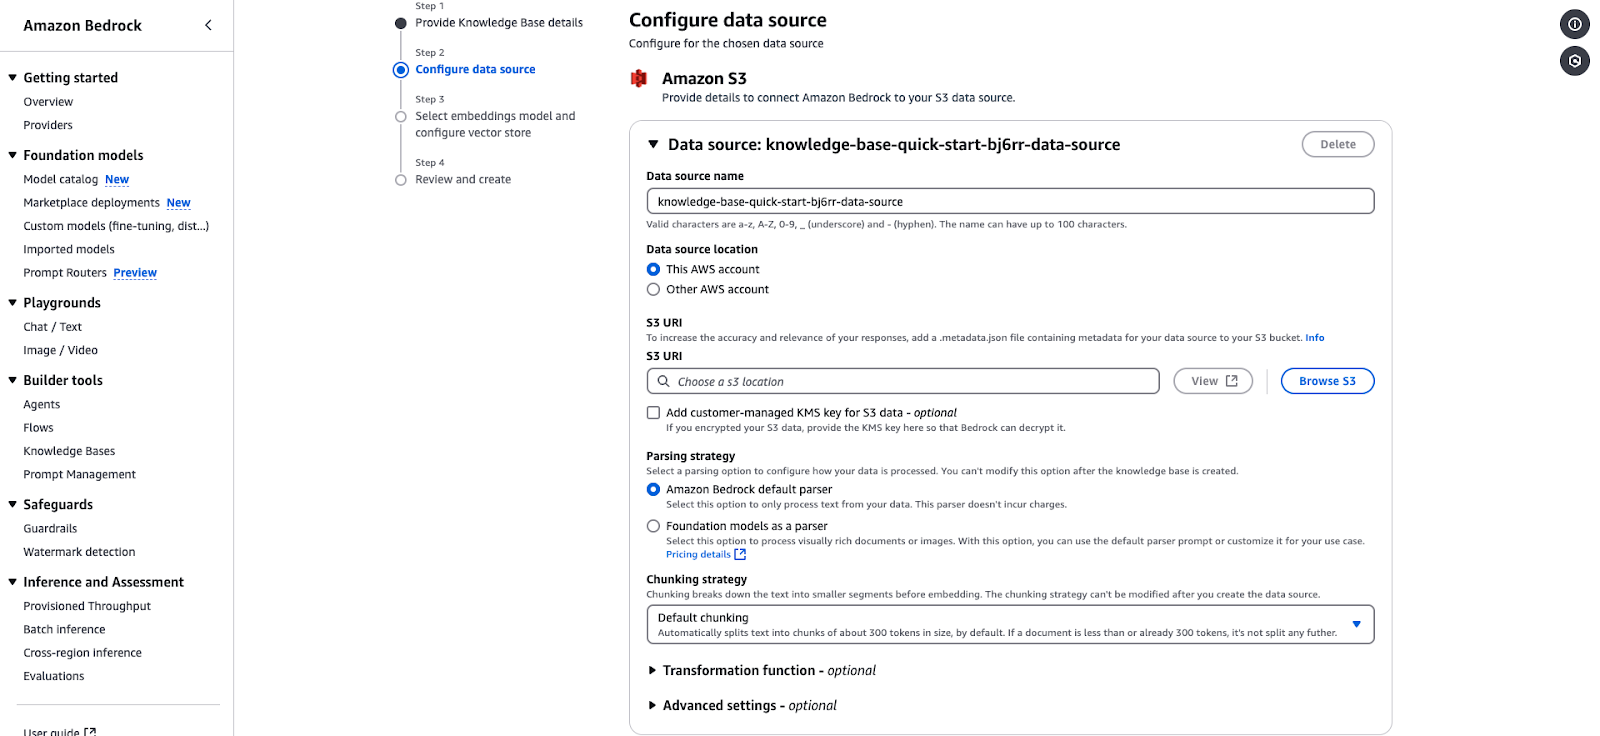
Adım 2: Veri kaynağını yapılandırın

  • Data source details bölümünde veri kaynağınızı seçin:
    • Amazon S3: Verileriniz S3’te depolandığı için bu seçeneği kullanın.
  • Şunları belirtin:
    • Data source location: "This AWS Account" veya "Other AWS Account" arasından seçin.
    • S3 URI: Verileri içeren S3 bucket URI’sini girin. Bir önceki adımda oluşturduğunuz S3’ü ve dosyayı seçin.
    • Encryption key: (İsteğe bağlı) Veriniz şifreliyse müşteri yönetimli bir KMS anahtarı ekleyin.
  • Ayrıştırma stratejisini yapılandırın:
    • Default parser: Düz metin verileri işler. Olduğu gibi bırakabilirsiniz.
    • Foundation models as parser: Karmaşık belgeleri veya görselleri işler. Olduğu gibi bırakabilirsiniz.
  • Parçalama (chunking) stratejisi:
    • Varsayılan ayar, gömmeler için metni yaklaşık 300 token’lık parçalara böler. Olduğu gibi bırakabilirsiniz.
  • (İsteğe bağlı) Verinizi ön işlemek için Transformation functions veya gelişmiş ayarlar ekleyin. Olduğu gibi bırakabilirsiniz.
  • Devam etmek için Next'i tıklayın.

Amazon S3 veri kaynağına bağlanma ayarlarını gösteren Amazon Bedrock veri kaynağı yapılandırma arayüzünün ekran görüntüsü

S3 tabanlı bir bilgi tabanını entegre etmek için Amazon Bedrock veri kaynağı yapılandırma sayfası.
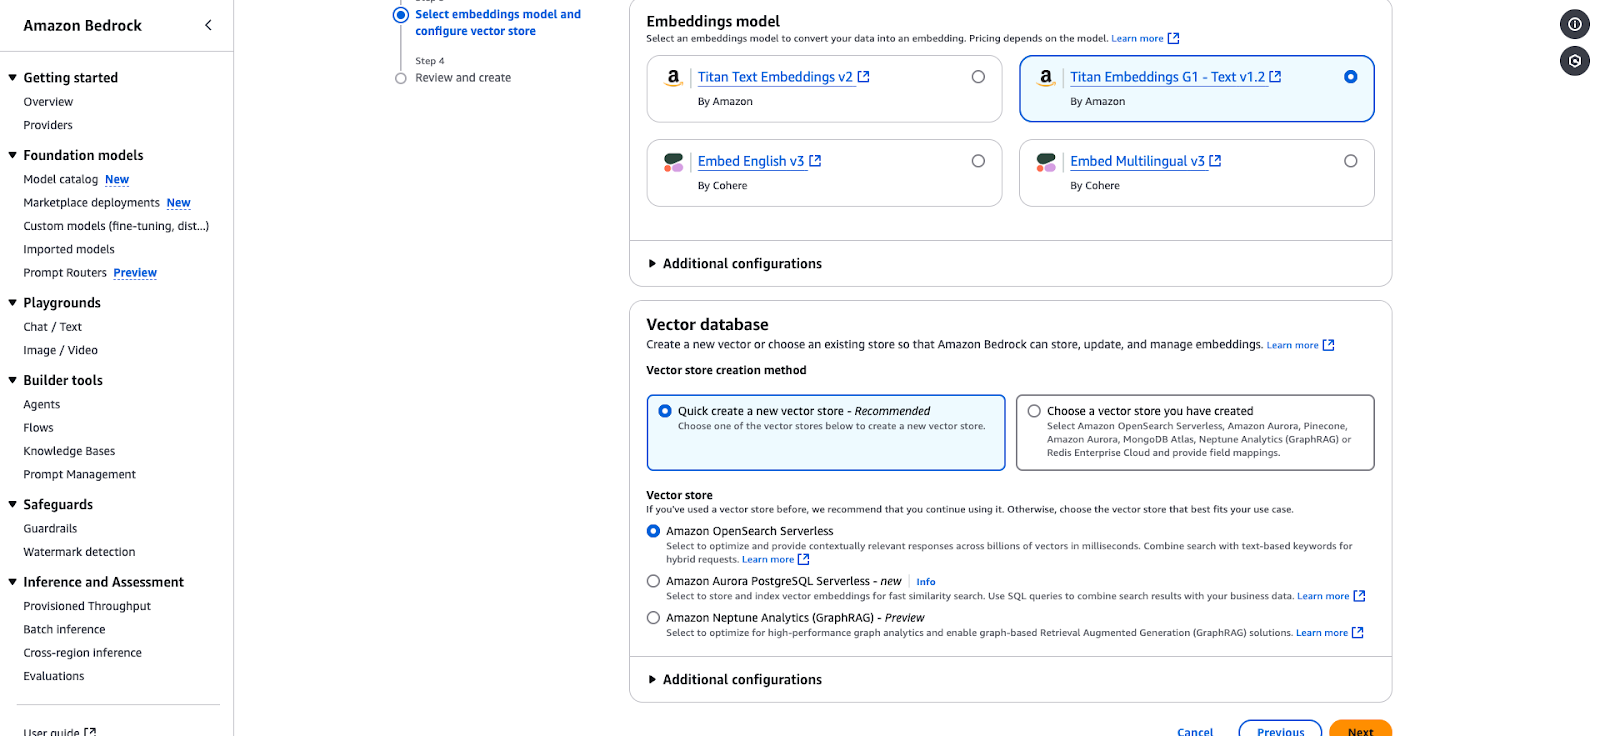
Adım 3: Gömme modelini seçin ve vektör deposunu yapılandırın

  • Verinizi vektör gösterimlerine dönüştürmek için bir Embeddings modeli seçin:
    • Titan Embeddings G1 - Text v1.2  (Bu eğitim için bunu seçebilirsiniz.)
    • Embed English v3
    • Embed Multilingual v3
  • Vector database bölümünde:
    • “Quick create a new vector store” (önerilir) seçeneğini kullanın veya mevcut bir depoyu seçin.
    • Seçenekler şunları içerir:
      • Amazon OpenSearch Serverless: Bağlamsal olarak uygun yanıtlar için idealdir. Bu eğitimde bunu seçebilirsiniz.
      • Amazon Aurora PostgreSQL Serverless: Hızlı benzerlik aramaları için optimize edilmiştir.
      • Amazon Neptune Analytics: Grafik tabanlı analitik ve Bilgi Getirmeyle Zenginleştirilmiş Üretim (RAG) için uygundur.
  • Yapılandırmanızı gözden geçirmek ve tamamlamak için Next'i tıklayın.

Bir gömme modeli seçme ve bir vektör veritabanı yapılandırma için Amazon Bedrock arayüzünün ekran görüntüsü.

Gömme modeli ve vektör deposu seçimi için Amazon Bedrock yapılandırma sayfası.

Adım 4: Gözden geçirin ve oluşturun

  • Tüm yapılandırmalarınızı gözden geçirin.
  • Onaylayın ve bilgi tabanını tamamlamak için Create'i tıklayın.
  • Oluşturulduktan sonra bilgi tabanınız konsoldaki Knowledge Bases bölümünde görünecektir.

Adım 5: Bilgi tabanını test edin

  • Bilgi tabanı genel bakışına erişin:
    • Amazon Bedrock Konsolu’nda Knowledge Bases bölümüne gidin.
    • Oluşturduğunuz bilgi tabanını seçin (ör. knowledge-base-quick-start).
    • Genel bakış ayrıntılarını gözden geçirin:
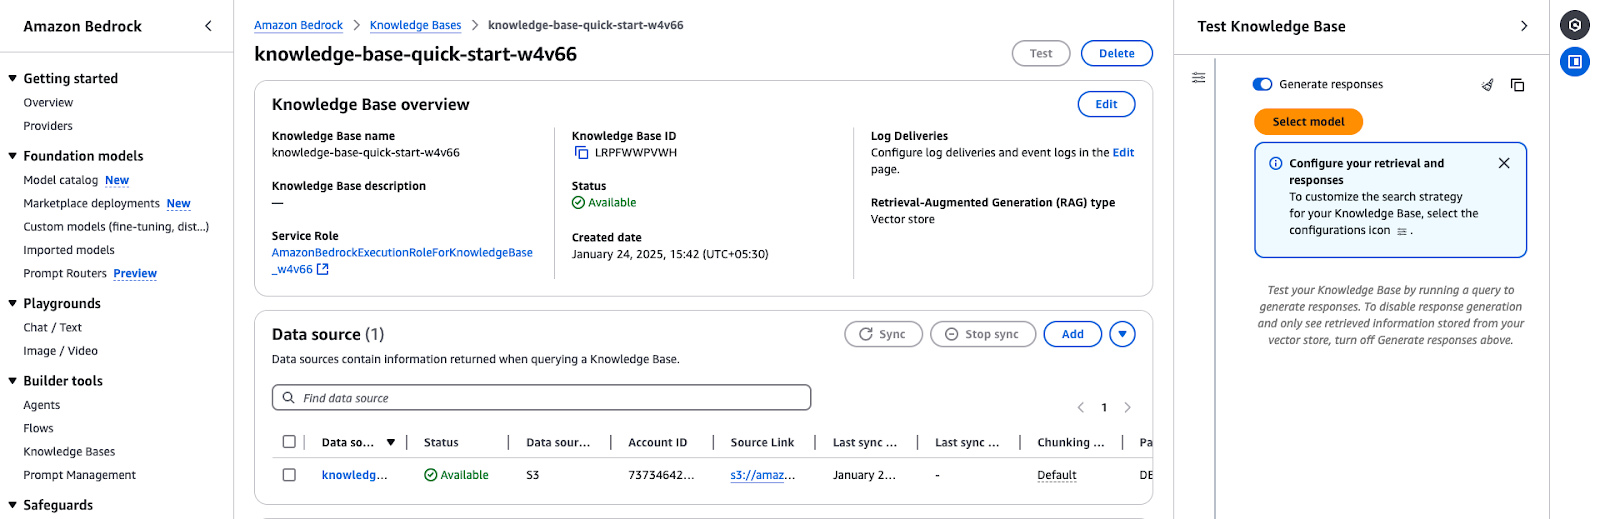
      • Bilgi tabanı adı ve kimliği
      • Durumunun “Available” olduğundan emin olun.
      • Doğru hizmet rolünün kullanıldığını doğrulayın.
  • Veri kaynaklarını eşitleyin ve ekleyin:
    • Veri kaynağı eşitlenmediyse süreci başlatmak için Sync'e tıklayın.
    • Add documents from S3 üzerinden daha fazla belge veya veri kaynağı da ekleyebilirsiniz.

Bilgi tabanı adı, kimliği, hizmet rolü, durum ve bilgi getirmeyle zenginleştirilmiş üretim (RAG) türü gibi temel ayrıntıları gösteren Amazon Bedrock Bilgi Tabanı genel bakış sayfasının ekran görüntüsü.

Amazon Bedrock Bilgi Tabanı genel bakışı, yapılandırma ayrıntılarını ve veri kaynağı durumunu gösterir.
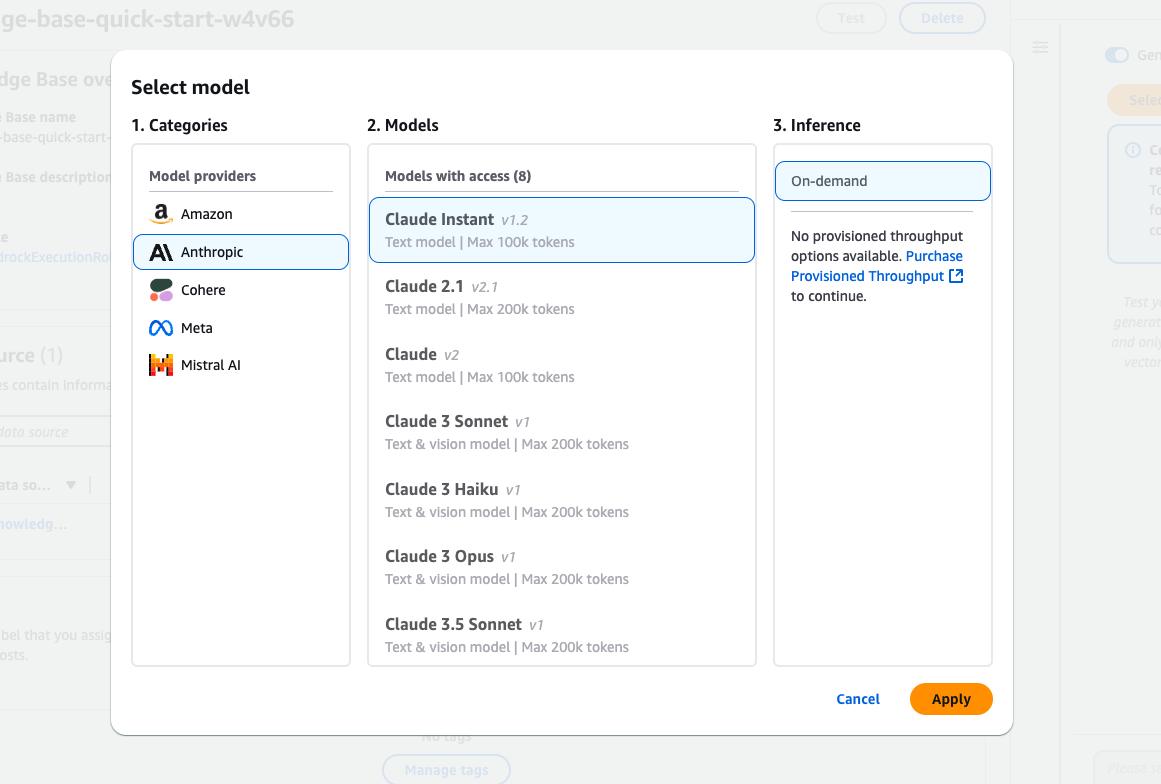
Adım 6: Test için bir model seçin

  • Bir temel model seçin:
    • Select model'i Test Knowledge Base panelinde tıklayın.
    • Amazon, Anthropic ve Cohere gibi sağlayıcılardan mevcut modelleri inceleyin.
    • Örnek: Metin tabanlı sorgular için Claude Instant (v1.2)'ı seçin.
  • Çıkarım türü:
    • Hazır kapasiteniz yoksa On-demand çıkarımı seçin.
  • Modeli uygulayın:
    • Model seçiminizi tamamlamak için Apply'a tıklayın.

Amazon, Anthropic, Cohere, Meta ve Mistral AI dahil model sağlayıcılarını gösteren Amazon Bedrock "Select model" arayüzünün ekran görüntüsü.

Amazon Bedrock model seçim arayüzü, Anthropic’ten çeşitli Claude modellerini içerir.
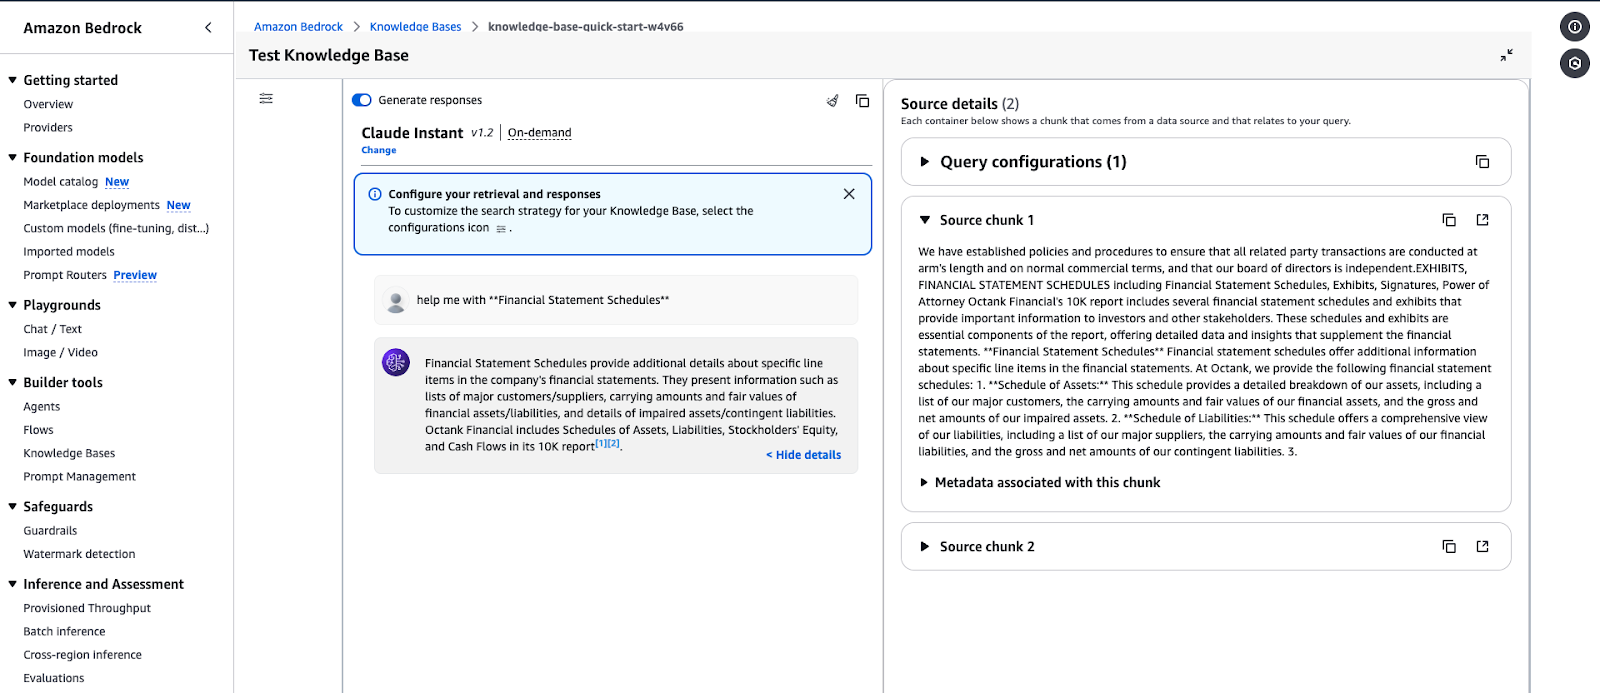
Adım 7: Sorgular çalıştırın ve yanıtlar üretin

  • Yanıt üretin:
    • Girdi kutusuna sorgunuzu yazın (ör. “Financial Statement Schedules konusunda bana yardımcı olun”).
    • Bilgi tabanını test etmek için Run'ı tıklayın.
  • Kaynak ayrıntılarını görüntüleyin:
    • Yanıt, sorgunuzla ilgili veri parçalarını içerecektir.
    • Alınan bilginin kaynak ve meta verilerini görmek için Source Details bölümünü genişletin.
  • Çıktıyı gözden geçirin:
    • Yanıtın bilgi tabanı içeriğiyle uyumlu olduğunu doğrulayın.
    • Gerekirse getirme yapılandırmalarını ince ayar yapın.

Amazon Bedrock Bilgi Tabanı test sayfasının ekran görüntüsü. Seçilen model "Claude Instant v1.2" ve anlık (on-demand) çıkarım ayarlı.

Bir sorguya verilen yanıtı gösteren Amazon Bedrock Bilgi Tabanı test arayüzü.

Örnek sorgu çıktısı:

  • Sorgu: “Financial Statement Schedules konusunda bana yardımcı olun.”
  • Yanıt: Bilgi tabanı, finansal tablolardaki belirli kalemler (varlık, yükümlülük çizelgeleri ve ilgili meta veriler gibi) hakkında ayrıntıları getirir.

Yapay zekâ modellerini ölçekli olarak yönetme ve dağıtma

AWS Lambda gibi AWS hizmetlerini kullanarak Amazon Bedrock, yapay zekâ modellerini ölçekli biçimde yönetip dağıtabilir. Bu maliyet etkin yaklaşım, yüksek erişilebilirlik sağlar ve yapay zekâ güdümlü uygulamalar için otomatik olarak ölçeklenir. 

Bu bölümde, istemleri isteğe bağlı olarak işleyebilmeniz için bir Bedrock modelini dinamik olarak çağırmak üzere AWS Lambda’yı kullanacağız.
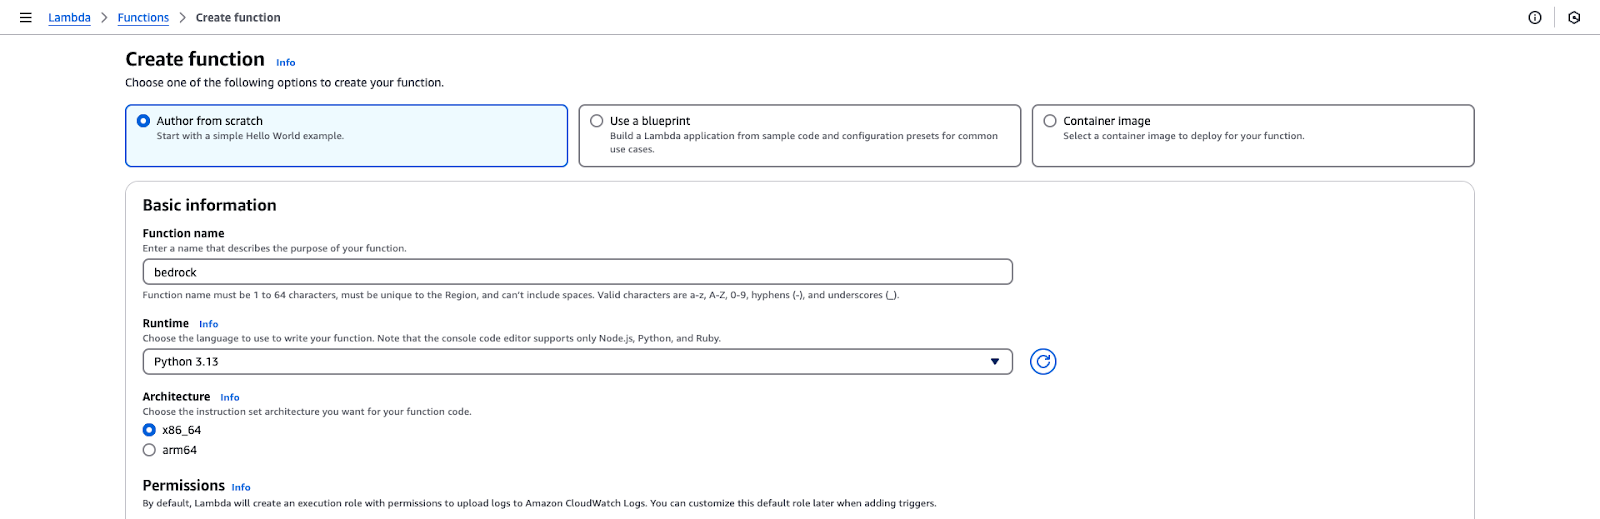
Adım 1: Bir AWS Lambda işlevi oluşturun

  • AWS Management Console’a giriş yapın.
  • Lambda hizmetine gidin ve Create function'ı tıklayın.
  • İşlev yapılandırmasını seçin:
    • “Author from Scratch” seçin.
    • İşlev adı: bedrock.
    • Çalışma zamanı: Python 3.x.
    • İzinler: Bu eğitimin başında oluşturulan IAM Rolünü seçin.
  • Kurulumu başlatmak için Create function'ı tıklayın.

AWS Lambda işlev oluşturma arayüzünün ekran görüntüsü. Seçili seçenek "Author from scratch" ve işlev adı "bedrock" olarak ayarlanmış.

AWS Lambda işlev oluşturma sayfası.

Adım 2: Lambda işlev kodunu ekleyin

  • Lambda konsolunun Code bölümünde işlev düzenleyicisini açın.
  • Varsayılan kodu, Github Gist'te sağlanan kodla değiştirin.
  • Değişiklikleri kaydetmek için Deploy'a tıklayın.

Adım 3: Lambda işlevini test edin

  • Lambda konsolunda Test sekmesine gidin ve aşağıdaki JSON ile bir test olayı oluşturun:
{
    "prompt": "Write a formal apology letter for a late delivery."
}
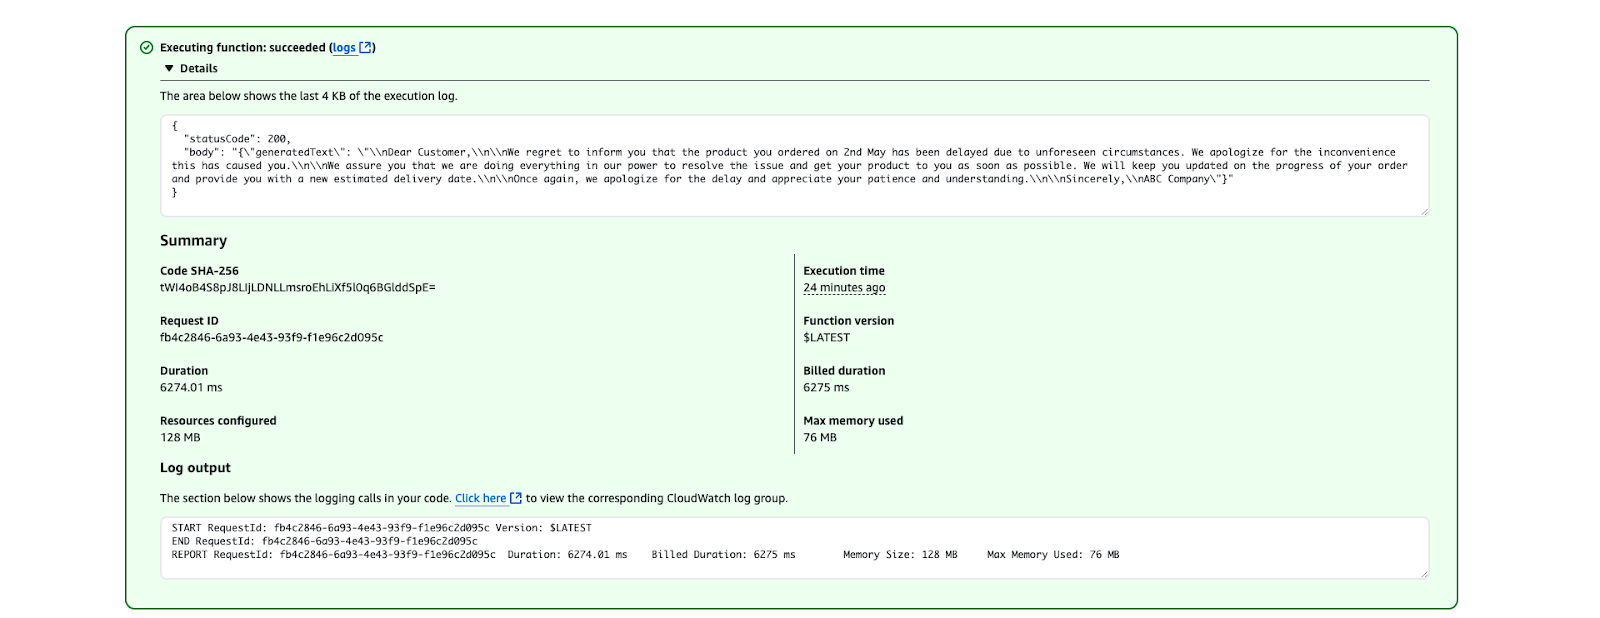
  • Test olayını kaydedin.
  • Lambda işlevini çağırmak için Test'i tıklayın.
  • Çıktıyı Execution results bölümünde kontrol edin. Oluşturulan metin şu şekilde görünmelidir:

Başarılı işlev yürütmesini gösteren AWS Lambda yürütme sonuçlarının ekran görüntüsü

Başarılı bir işlev çalıştırmasını gösteren AWS Lambda yürütme sonucu.

Yapay zekâ modeli dağıtımı için en iyi uygulamalar

Maliyeti optimize edin:

  • Ara sıra kullanım senaryoları için isteğe bağlı (on-demand) çıkarımı kullanın.
  • Yüksek frekansta istek bekleniyorsa sağlanmış aktarım kapasitesini değerlendirin.

Lambda işlevini güvenli hale getirin:

  • IAM rolünü yalnızca gerekli izinlerle sınırlandırın.
  • Hassas verileri kodda ifşa etmemek için ortam değişkenlerini kullanın.

İzleyin ve günlükleyin:

  • Çağrı metriklerini izlemek ve sorun gidermek için CloudWatch günlüklerini kullanın.
  • Hatalar veya yüksek gecikme için alarmlar kurun.

AWS Bedrock Kullanımı için En İyi Uygulamalar

Bu bölümde, Amazon Bedrock ile çalışırken maliyet optimizasyonundan güvenlik ve doğruluğa kadar bazı en iyi uygulamaları paylaşıyorum. 

Maliyet optimizasyonu

AWS Bedrock’ta maliyetleri yönetmek, modelleri dağıtmak için Amazon SageMaker’dan yararlanmayı ve Spot örneklerini kullanarak maliyetlerde %90’a varan tasarruf sağlamayı içerebilir. İşte bazı en iyi uygulamalarım:
  • Doğru temel modeli seçin: İhtiyaçlarınıza uygun modelleri seçin. Daha az karmaşık görevler için hesaplama maliyetlerini düşürmek üzere daha küçük, kaynak tüketimi düşük modelleri tercih edin. Örneğin, metin tabanlı görevler (özetleme gibi) için Amazon Titan Modelleri veya basit görüntü üretimi için Stability AI kullanılabilir.
  • Toplu çıkarım: İstekleri tek tek işlemek yerine, birden çok çıkarım isteğini gruplar halinde işleyin. Bu, model çağrılarının sıklığını azaltarak maliyetleri düşürür.
  • S3 yaşam döngüsü ilkelerinden yararlanın: Çıkarım veya ince ayar için yalnızca gerekli verileri Amazon S3’te saklayın. Verileri otomatik olarak daha ucuz katmanlara (ör. S3 Glacier) taşımak veya belirli bir sürenin ardından kullanılmayan verileri silmek için yaşam döngüsü ilkeleri kullanın.
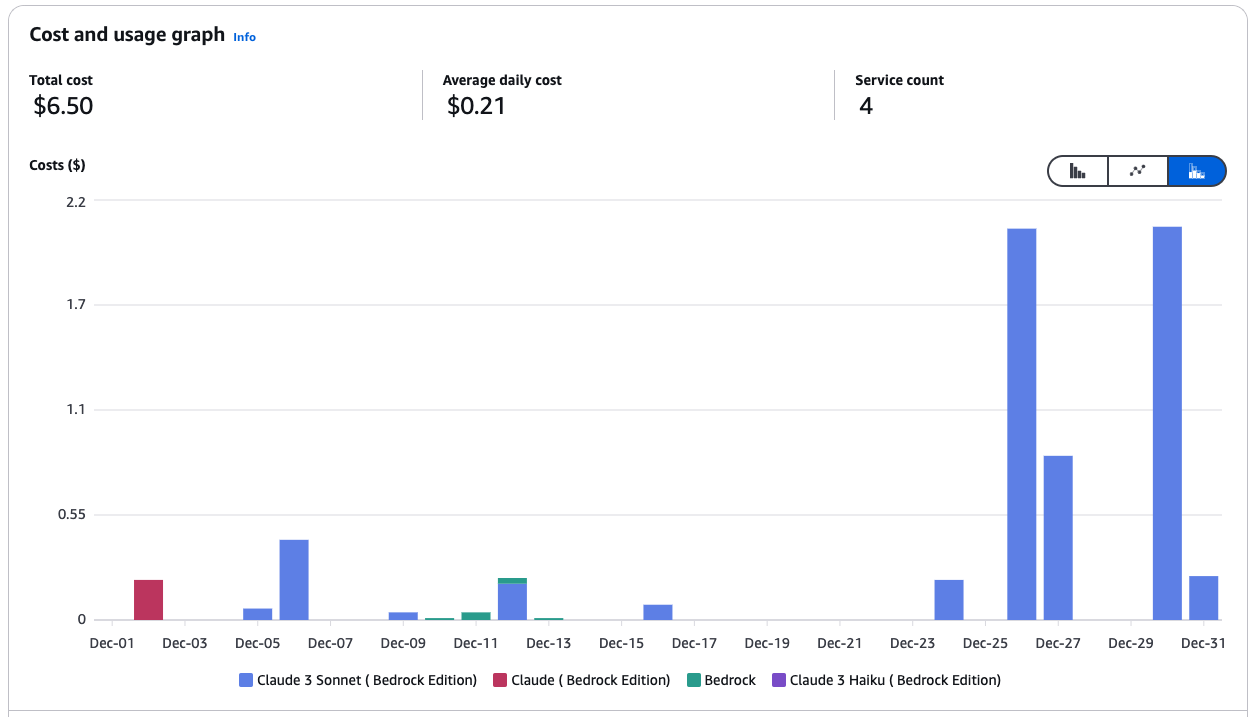
  • Harcamaları izleyin ve kontrol edin: AWS Cost Explorer ile harcama desenlerinizi analiz ederek optimizasyon alanlarını belirleyin. Önceden tanımlı maliyet eşiklerine yaklaştığınızda uyarı almak için AWS Budgets ayarlayın.

Amazon Bedrock hizmetlerinin maliyet ve kullanımını gösteren grafik

Amazon Bedrock hizmetleri için maliyet ve kullanım grafiği.

  • Maliyet etkinliği için Bedrock’u SageMaker ile kullanın: Yönetilen Spot örneklerinden yararlanmak için SageMaker’da Bedrock temel modellerini kullanın.
  • SageMaker’da Spot örnekleri kullanın: Spot örnekler Talep Üzerine örneklere kıyasla maliyetleri %90’a kadar azaltabilir. SageMaker, Spot kesintilerini sizin adınıza yönetir; Spot kapasitesi kullanılamaz hale gelirse eğitim işleri otomatik olarak yeniden denenir. Örnek:
from sagemaker.mxnet import MXNet

# Use spot instances for cost efficiency
use_spot_instances = True

# Maximum runtime for the training job (in seconds)
max_run = 600

# Maximum wait time for Spot instance availability (in seconds); set only if using Spot instances
max_wait = 1200 if use_spot_instances else None

# Define the MXNet estimator for the training job
mnist_estimator = MXNet(
    entry_point='source_dir/mnist.py',  # Path to the script that contains the model training code
    role=role,  # IAM role used for accessing AWS resources (e.g., S3, SageMaker)
    output_path=model_artifacts_location,  # S3 location to save the trained model artifacts
    code_location=custom_code_upload_location,  # S3 location to upload the training script
    instance_count=1,  # Number of instances to use for training
    instance_type='ml.m4.xlarge',  # Instance type for the training job
    framework_version='1.6.0',  # Version of the MXNet framework to use
    py_version='py3',  # Python version for the environment
    distribution={'parameter_server': {'enabled': True}},  # Enable distributed training with a parameter server
    hyperparameters={  # Training hyperparameters
        'learning-rate': 0.1,  # Learning rate for the training job
        'epochs': 5  # Number of training epochs
    },
    use_spot_instances=use_spot_instances,  # Enable Spot instances for cost savings
    max_run=max_run,  # Maximum runtime for the training job
    max_wait=max_wait,  # Maximum wait time for Spot instance availability
    checkpoint_s3_uri=checkpoint_s3_uri  # S3 URI for saving intermediate checkpoints
)

# Start the training job and specify the locations of training and testing datasets
mnist_estimator.fit({
    'train': train_data_location,  # S3 location of the training dataset
    'test': test_data_location  # S3 location of the testing/validation dataset
})
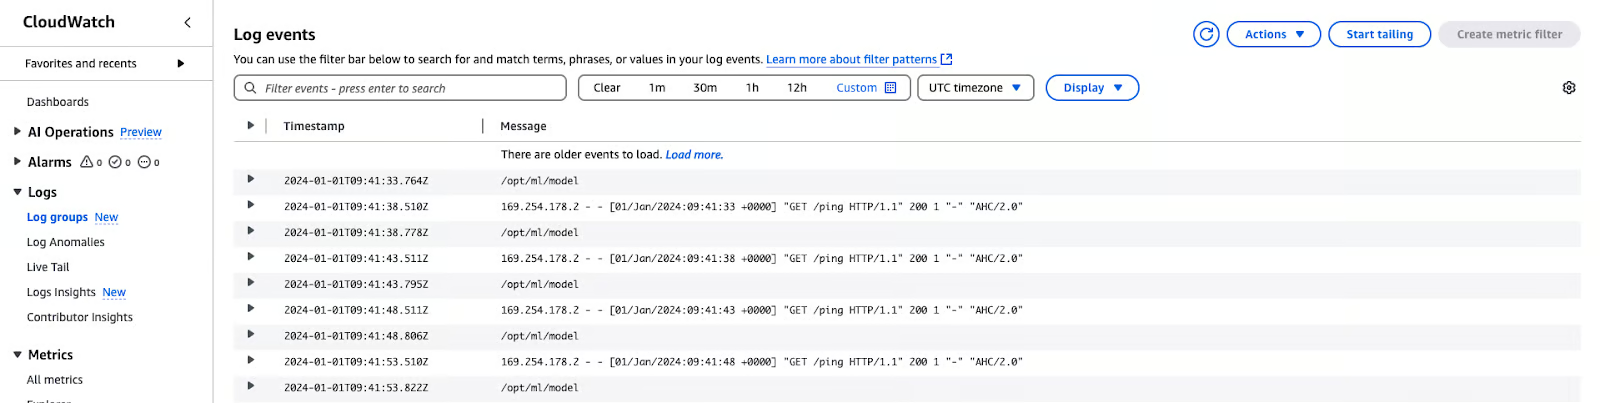
  • CloudWatch metrikleri ve günlüklerini kullanın: Eğitim metrikleri ve günlükleri Amazon CloudWatch'ta mevcuttur ve performans ile kaynak kullanımı hakkında içgörüler sağlar.

/opt/ml/model yolunda bir makine öğrenimi modeli için günlük girdilerini gösteren AWS CloudWatch günlük olayları ekran görüntüsü. Her günlük zaman damgası, kaynak IP ve /ping için 200 durum kodlu HTTP GET isteği içeriyor.

AWS CloudWatch günlükleri

Güvenlik

Amazon Bedrock’un güvenliği, uyumluluğu ve performansı için en iyi uygulamaları takip etmek önemlidir. Önerilerim şunlar:

  • Asgari ayrıcalık erişimi uygulayın: Yetkisiz erişimi önlemek için IAM izinlerini ve hizmet rollerini yalnızca gerekli kaynaklarla sınırlayın.
  • Hizmet rolleri ve güvenlik gruplarını doğrulayın: Bedrock ajanlarının ve model özelleştirme işlerinin etkin hizmet rolleri ve güvenlik ayarlarıyla doğru yapılandırıldığından emin olun.
  • İş yüklerini bir VPC içinde çalıştırın: Özelleştirme işleri ve veri işleme süreçlerini bir Sanal Özel Bulut (VPC) içinde çalıştırarak güvenliği artırın.
  • Kritik verileri şifreleyin: Amazon KMS Müşteri Yönetimli Anahtarlarını (CMK’lar) kullanarak ajan oturumlarını, Bedrock Studio çalışma alanlarını, özel modelleri ve geçici bilgi tabanı verilerini şifreleyin.
  • Veri silme ilkeleri uygulayın: Vektörde depolanan verileri yalnızca bilgi tabanı kaynakları etkin olduğunda tutun; artık gerekmediğinde otomatik silme ayarlayın.
  • Bedrock korumalarını güçlendirin: Düşman saldırılarına ve veri sızıntılarına karşı korunmak için Prompt Attack Strength’i HIGH olarak ayarlayın ve hassas bilgi filtrelerini etkinleştirin.
  • Ajan oturumlarını güvenli hale getirin: Yetkisiz erişimi önlemek ve hassas etkileşimleri korumak için koruma önlemleri (guardrails) kullanın.
  • Görünürlük için günlüklemeyi etkinleştirin: Faaliyetleri izlemek ve anormallikleri tespit etmek için hesap düzeyinde model çağrısı günlüklemesini açın.
  • Hizmetler arası saldırılara karşı korunun: Hizmet rolü ilkeleri kullanarak Cross-Service Confused Deputy saldırılarını önleyin.

Model izleme ve değerlendirme

Modellerin doğru, güvenilir ve iş hedefleriyle uyumlu olduğundan emin olmak, modelleri izlemek ve değerlendirmekle sağlanır. İşte bazı en iyi uygulamalar:
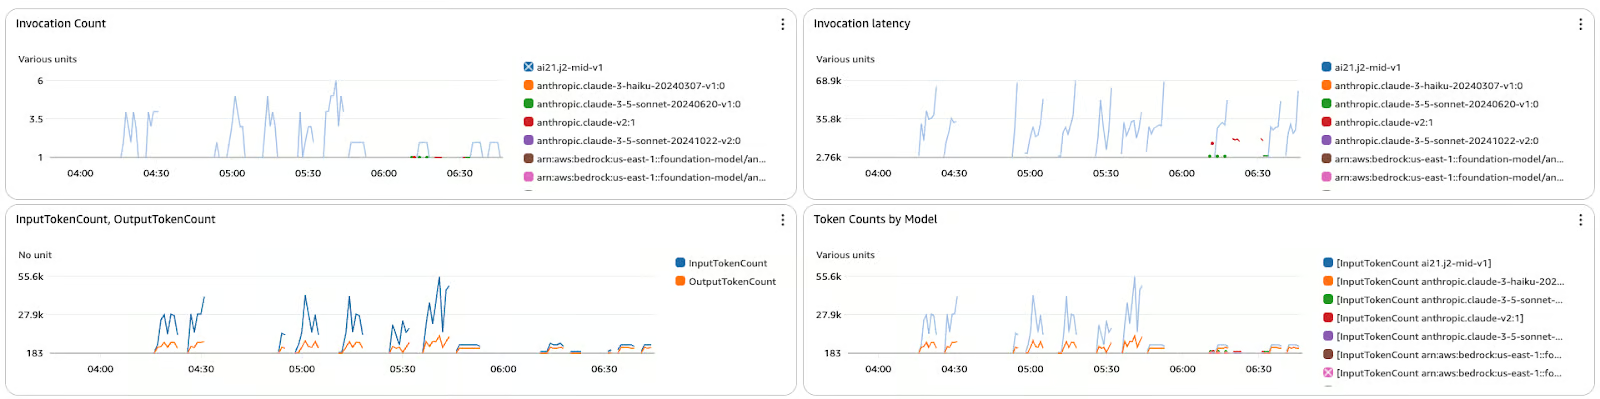
  • Performans metriklerini takip edin: Gecikme, hatalar ve çağrı eğilimlerini izlemek için CloudWatch kullanın.
  • Girdileri ve çıktıları günlüğe alın: Hata ayıklama ve eğilim analizi için ayrıntılı günlüklemeyi etkinleştirin.
  • Geri bildirim döngüleri ekleyin: Kritik çıktılar için insan değerlendirmelerini dahil etmek üzere Amazon A2I gibi araçları kullanın.
  • Çıktıları düzenli olarak değerlendirin: Çıktıları doğrulama veri kümeleri veya gerçek değerlerle karşılaştırın.
  • Modelleri sürekli iyileştirin: Gerek duyulduğunda güncellenmiş veri kümeleri veya belirli alan verileriyle modelleri ince ayar yapın.

Amazon Bedrock modelleri için metrikleri takip eden dört grafikli gösterge paneli.

Metrik gösterge paneli, Amazon Bedrock’taki çeşitli modeller için çağrı sayısı, gecikme ve token sayılarını görüntüler.

Sonuç

AWS Bedrock, üretken yapay zekâ uygulamalarının geliştirilme biçimini değiştiren ve altyapı endişesi olmaksızın temel modelleri kullanmak için merkezi bir platform sunan bir çözümdür. 

Bu noktadan itibaren, bu adım adım eğitim doğru modelleri belirlemenize, güvenli ve ölçeklenebilir iş akışları oluşturmanıza ve daha fazla özelleştirme için bilgi getirmeyle zenginleştirilmiş üretim (RAG) gibi özellikleri entegre etmenize yardımcı olacaktır. Maliyet, güvenlik ve izleme için en iyi uygulamalar yerindeyken, hedeflerinizi karşılayacak yapay zekâ çözümlerini geliştirmeye ve yönetmeye hazırsınız.

AWS uzmanlığınızı daha da derinleştirmek için şu kursları keşfedin:

Yapay Zeka Uygulamaları Geliştirin

OpenAI API'sını kullanarak AI uygulamaları oluşturmayı öğrenin.
Ücretsiz Olarak Beceri Geliştirmeye Başlayın

Rahul Sharma's photo
Author
Rahul Sharma
LinkedIn
Twitter

Rahul Sharma, bulut bilişim, DevOps uygulamaları ve açık kaynak teknolojiler konusunda uzmanlaşan bir AWS Elçisi, DevOps Mimarlı ve teknik blog yazarlıdır. AWS, Kubernetes ve Terraform konularındaki uzmanlığıyla, etkileyici makaleler ve eğiticiler aracılığıyla karmaşık kavramları öğrenenler ve profesyoneller için sadeleştirir. Rahul, DevOps zorluklarını çözmeye ve teknoloji topluluğuna güç katacak içgörüler paylaşmaya tutkuyla bağlıdır.

Konular
Cloud
AWS

Bu kurslarla AWS hakkında daha fazlasını öğrenin!

Kurs

AWS Bulut Teknolojisi ve Hizmetleri Kavramları

3 sa
21.9K
AWS ekosisteminde uygulamalı öğrenme ve pratik uygulamalarla AWS bulut teknolojisini öğrenin.
Ayrıntıları GörüntüleRight Arrow
Kursa Başla
Devamını GörRight Arrow
İlgili

blog

Hızlı Sevkiyat İçin Pratik Vibe Kodlama Teknoloji Yığını

Ön uç, arka uç, veritabanları, kimlik doğrulama, depolama, e-posta, test, dağıtım ve izleme için en iyi araçları keşfedin.
Abid Ali Awan's photo

Abid Ali Awan

14 dk.

blog

2026’da En Popüler 40 Yazılım Mühendisi Mülakat Sorusu

Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Dario Radečić's photo

Dario Radečić

15 dk.

Eğitim

.gitignore Nasıl Kullanılır: Örneklerle Pratik Bir Giriş

Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!
Kurtis Pykes 's photo

Kurtis Pykes

8 dk.

Eğitim

Python'da Listeyi String'e Nasıl Dönüştürürsünüz

Bu hızlı eğitimde, Python'da bir listeyi string'e nasıl dönüştüreceğinizi öğrenin.
Adel Nehme's photo

Adel Nehme

Devamını GörDevamını Gör