

学习路径
开发 AI 应用程序
21 小时
实践并学习路径你的进步。
使用 Google 继续我们将开发一个基于 Gradio 的论文分析器,允许用户:
为优化 Claude 3.7 Sonnet API 的成本,我们需要将其使用方式与项目需求对齐;输入 token 费用为 $3/百万,输出 token(包括思考模式)为 $15/百万。
我们可通过提示缓存、批处理,以及对长回复使用流式模式来降低开销。还可通过设置较低的思考 token 预算(自 1,024 token 起)来优化思考模式,仅在必要时再提高。
您可以在 Anthropic 官方文档中了解更多 API 成本优化方法。
在开始之前,先简要介绍一下思考模式,以防您还不熟悉。思考模式是 Claude 3.7 Sonnet 的新特性,它在生成最终答案前进行逐步推理。该模式允许模型:
简而言之,其工作方式如下:
开始之前,我们需要设置 Anthropic 的 API 密钥:
1. 登录 Anthropic 控制台:https://console.anthropic.com/
2. 点击 Get API Keys。
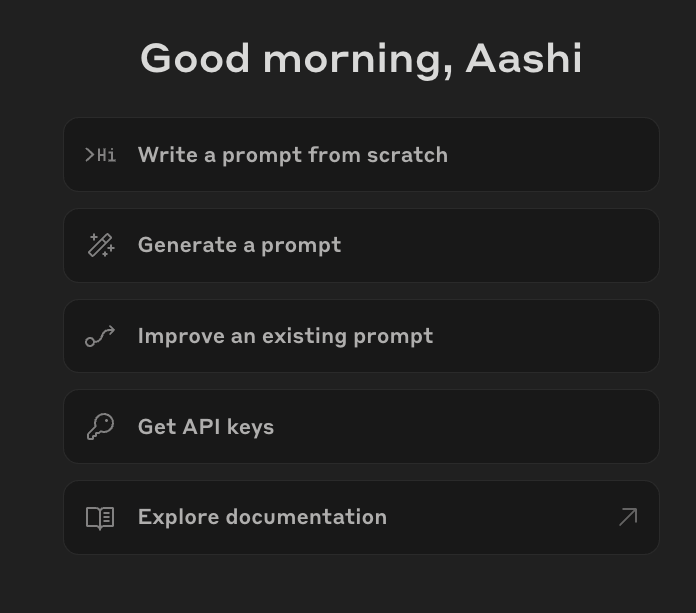
3. 系统会跳转到 API Keys 选项卡。点击 Create API Key,并输入密钥名称。
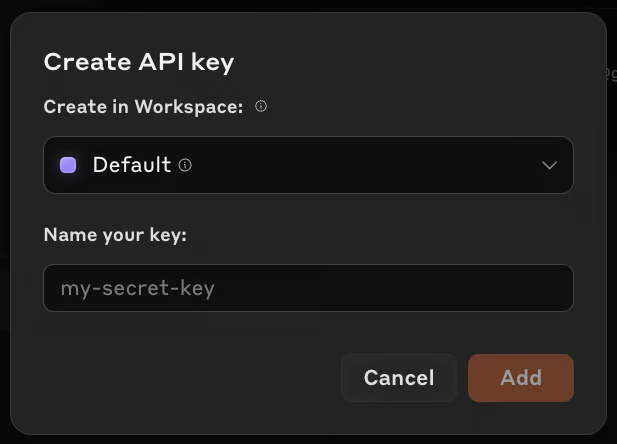
4. 复制该密钥并妥善保存备用。
5. 现在在 Billing 选项卡下为您的结算账户充值。点击购买额度,向账户添加约 $5(足以完成本项目)。
至此我们已获得 API 密钥。接下来确保安装所需依赖。
pip install anthropic gradio PyPDF2安装完成后,导入必要的库:
import anthropic
import PyPDF2
import os
import gradio as gr既然已导入所有必需库,接下来设置 Claude API。
如果您使用 Google Colab,可将 API 密钥保存在 Secrets 选项卡中,然后通过 get() 函数来访问。否则也可以将 API 密钥直接写入代码(不推荐)。
随后我们使用 Anthropic 库初始化 Claude 客户端,并传入 API 密钥。
# If using Google Colab Secrets
from google.colab import userdata
API_KEY = userdata.get('claude-3.7-sonnet')
client = anthropic.Anthropic(
    api_key=API_KEY,
)
至此完成了环境配置。接下来进行文本提取。
我们将使用 PyPDF2 从上传的 PDF 文件中提取文本。Claude 3.7 Sonnet 仅接受文本与图像作为输入。因此,我们预先提取文本,以高效处理并最大化结合思考模式的能力。
# Function to extract text from a PDF file
def extract_text_from_pdf(pdf_path):
    """Extracts text from a given PDF file."""
    text = ""
    with open(pdf_path, "rb") as f:
        reader = PyPDF2.PdfReader(f)
        for page in reader.pages:
            text += page.extract_text() + "\n"
    return text.strip()
extract_text_from_pdf() 函数读取 PDF 文件,使用 PyPDF2.PdfReader() 从每一页提取文本,并将其合并为一个字符串返回。
有了提取的文本后,我们继续使用 Claude 3.7 Sonnet 的思考与流式模式来分析多篇论文,并生成一个结构化的研究构想。
流式模式通过逐步传递结果高效处理大体量回复,缩短等待时间并避免 API 超时。思考模式允许模型在形成最终答案前生成结构化的内部思路,从而增强复杂推理并确保结论更有依据。
# Function to analyze research papers with streaming
def analyze_papers_streaming(paper_texts, paper_count):
    """Uses Claude 3.7 Sonnet with Thinking Mode in streaming mode to analyze papers, find drawbacks, and generate a research project."""
    formatted_papers = "\n\n".join([f"### Paper {i+1}:\n{paper}" for i, paper in enumerate(paper_texts)])
    prompt = f"""
        You are an AI research assistant. You have been provided with {paper_count} research papers.
        Your task is to analyze these papers and perform the following:
        1. **Summarize each paper** with its core contributions and findings.
        2. **Identify key drawbacks** of each paper, focusing on limitations, gaps, or areas needing improvement.
        3. **Find interconnections and citations** between the papers—what ideas, methods, or datasets do they share?
        4. **Propose a novel research idea** that addresses a major limitation across these papers.
            - Suggest how techniques from different papers can be combined to solve a problem.
            - Ensure the idea is practical and feasible for further research.
            - Justify why this approach is promising.
        Below are the research papers
        {formatted_papers}
    """
    results = {"thinking": "", "research_idea": ""}
    with client.messages.stream(
        model="claude-3-7-sonnet-20250219",
        max_tokens=25000,
        thinking={
            "type": "enabled",
            "budget_tokens": 16000  # Large budget for deep reasoning
        },
        messages=[{"role": "user", "content": prompt}]
    ) as stream:
        current_block_type = None
        for event in stream:
            if event.type == "content_block_start":
                current_block_type = event.content_block.type
            elif event.type == "content_block_delta":
                if event.delta.type == "thinking_delta":
                    results["thinking"] += event.delta.thinking
                elif event.delta.type == "text_delta":
                    results["research_idea"] += event.delta.text
            elif event.type == "message_stop":
                break
    return results["thinking"], results["research_idea"]
analyze_papers_streaming() 函数按以下步骤执行:
client.messages.stream() 发送请求到 Claude 3.7 Sonnet。这里启用思考模式,设置 budget_tokens=16000,并用 max_tokens=25000 以支持更长回复。content_block_start 事件以指示响应块的开始;生成过程中,thinking_delta 事件包含中间推理步骤,而 text_delta 事件提供最终的研究洞见。直到 message_stop 事件标志响应完成。您可以在此处了解更多关于扩展思考的提示工程技巧。
主逻辑完成后,我们将其集成到 Gradio,让用户上传论文并获得结构化洞见。
# Gradio UI function
def gradio_interface(pdfs):
    paper_texts = [extract_text_from_pdf(pdf.name) for pdf in pdfs]
    paper_count = len(paper_texts)  # Count number of provided papers
    thinking, research_idea = analyze_papers_streaming(paper_texts, paper_count)
    return thinking, research_idea

# Set up the Gradio app
demo = gr.Interface(
    fn=gradio_interface,
    inputs=gr.File(file_types=[".pdf"], label="Upload Research Papers", file_count="multiple"),
    outputs=[gr.Textbox(label="Thinking Process"), gr.Textbox(label="Research Idea")],
    title="Claude 3.7 Sonnet - Powered Research Paper Analyzer",
    description="Upload multiple research papers to extract insights, identify key limitations, and generate a novel research idea."
)
if __name__ == "__main__":
    demo.launch(debug=True)
以上代码搭建了一个 Gradio 界面,用户可上传多份 PDF,系统会提取文本、分析关键洞见,并使用 思考与流式模式生成新的研究构想。
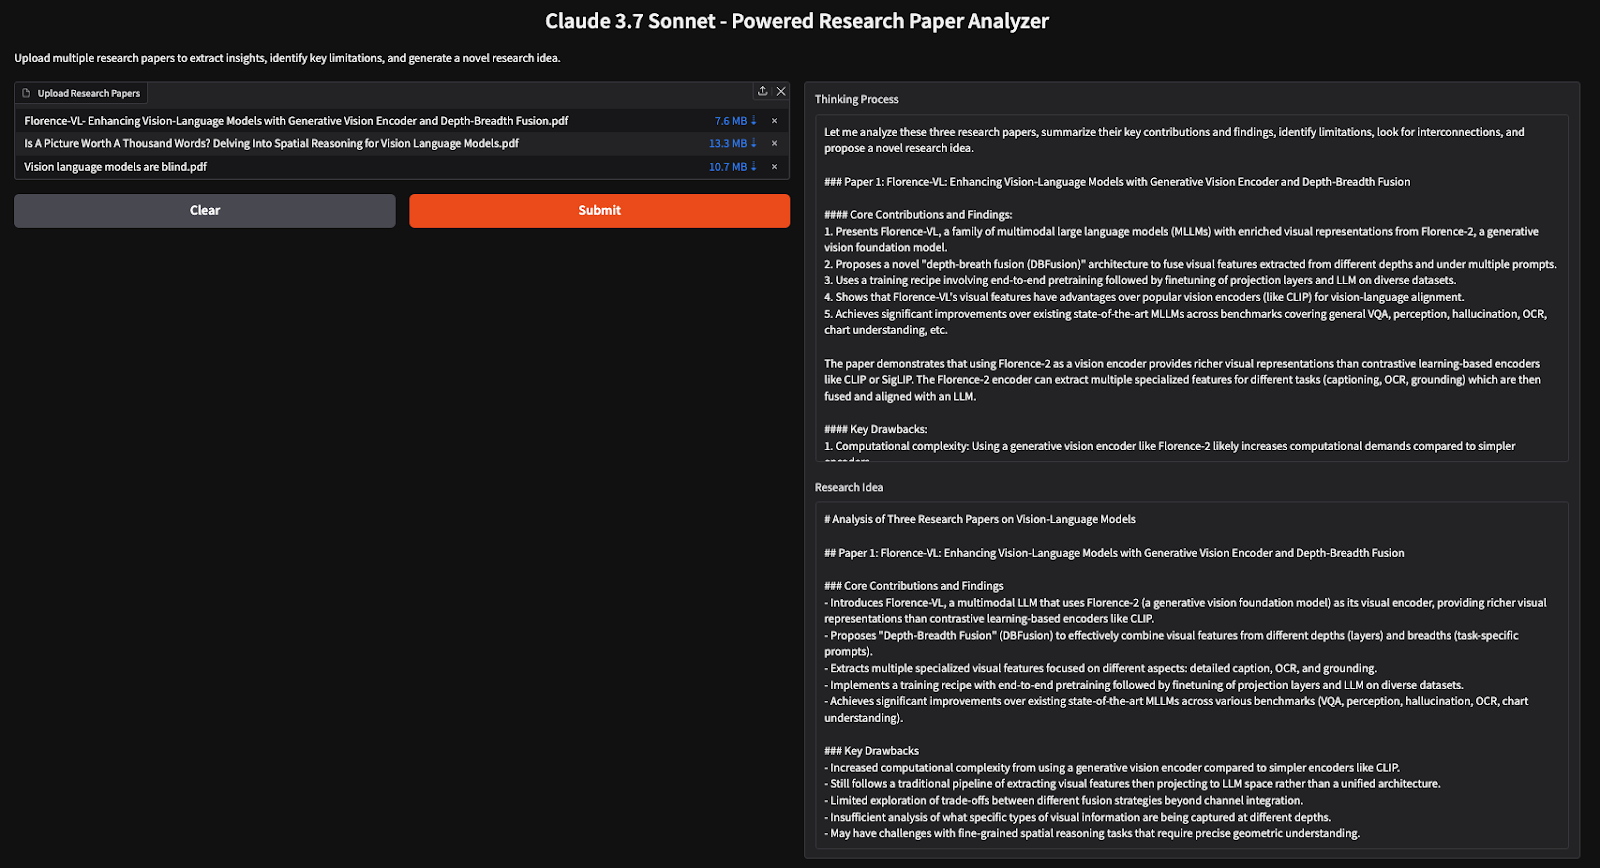
在本教程中,我们使用 Claude 3.7 Sonnet 构建了一个 AI 驱动的论文分析器,帮助研究者高效提取洞见、识别局限,并从多篇论文中生成新的研究构想。通过思考模式,模型能够进行深度推理,使其成为文献综述与研究综述的高效工具。
跟着这些课程学 AI!
学习路径
课程
实践并学习路径你的进步。
使用 Google 继续