
Last chance! 50% off DataCamp Premium
Sale ends in
Svilupperemo un Research Paper Analyzer basato su Gradio che consente agli utenti di:
Per ottimizzare i costi dell'API di Claude 3.7 Sonnet dobbiamo allinearne l'uso alle esigenze del progetto, dato che i token in input costano $3/M e quelli in output, inclusa la Thinking Mode, costano $15/M.
Dobbiamo ridurre le spese usando la cache dei prompt, l'elaborazione in batch e la modalità streaming per risposte lunghe. Possiamo anche ottimizzare la Thinking Mode impostando un budget di token più basso (a partire da 1.024 token) e aumentandolo solo quando necessario.
Puoi approfondire come ottimizzare i costi dell'API tramite la documentazione ufficiale di Anthropic.
Prima di iniziare, facciamo chiarezza su cos'è la thinking mode, nel caso non ti fosse familiare. La Thinking Mode è una nuova funzionalità di Claude 3.7 Sonnet che abilita un ragionamento passo-passo prima di generare la risposta finale. Permette al modello di:
In poche parole, funziona così:
Prima di iniziare, dobbiamo configurare la chiave API di Anthropic:
1. Inizia accedendo alla console Anthropic: https://console.anthropic.com/
2. Clicca su Get API Keys.
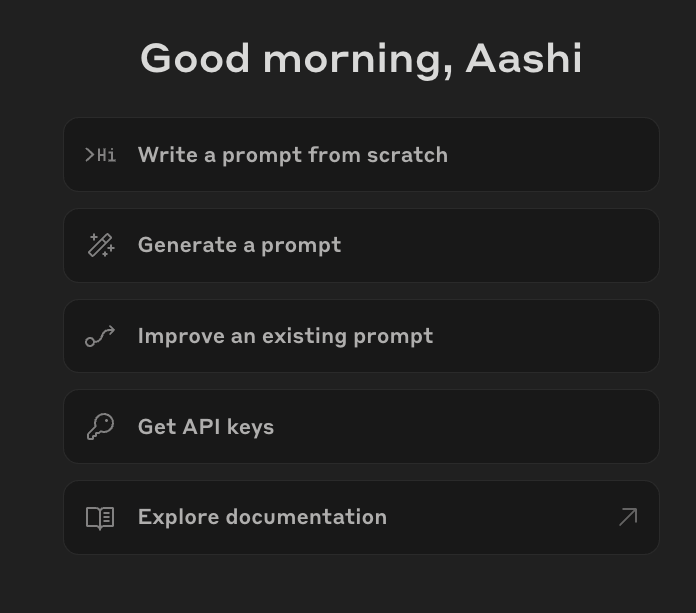
3. Verrai reindirizzato alla scheda API Keys. Clicca su Create API Key e inserisci il nome della chiave.
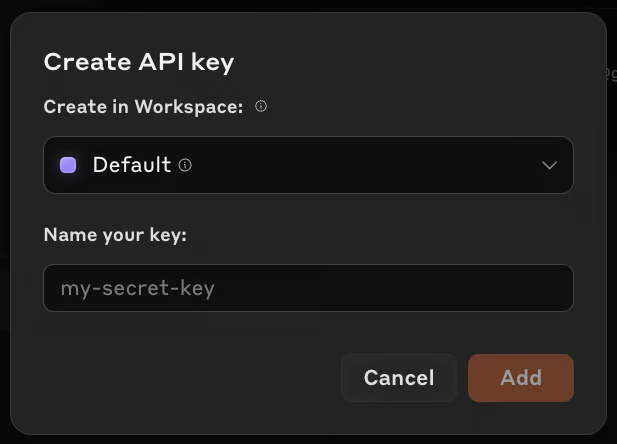
4. Copia questa chiave e conservala per usi futuri.
5. Ora aggiungi del credito al tuo account di fatturazione, nella scheda Billing. Clicca semplicemente su buy credits e aggiungi circa $5 al tuo account (sufficienti per questo progetto).
Ora abbiamo la chiave API pronta. Assicuriamoci di avere installate le dipendenze richieste.
pip install anthropic gradio PyPDF2Una volta installate, importa le librerie necessarie:
import anthropic
import PyPDF2
import os
import gradio as grOra che abbiamo importato tutte le librerie richieste, configuriamo l'API di Claude.
Se usi Google Colab, puoi salvare la chiave API nella scheda Secrets e poi usare la funzione get() per accedervi. In alternativa, puoi passare la chiave API direttamente nel codice (sconsigliato).
Inizializziamo quindi il client di Claude usando la libreria Anthropic e passando la chiave API.
# If using Google Colab Secrets
from google.colab import userdata
API_KEY = userdata.get('claude-3.7-sonnet')
client = anthropic.Anthropic(
    api_key=API_KEY,
)
Questo completa la configurazione. Ora passiamo all'estrazione del testo.
Useremo PyPDF2 per estrarre testo dai file PDF caricati. Claude 3.7 Sonnet accetta solo testo e immagini in input. Quindi estraiamo il testo in anticipo per un'elaborazione efficiente, massimizzando le capacità di Claude 3.7 Sonnet con la Thinking Mode.
# Function to extract text from a PDF file
def extract_text_from_pdf(pdf_path):
    """Extracts text from a given PDF file."""
    text = ""
    with open(pdf_path, "rb") as f:
        reader = PyPDF2.PdfReader(f)
        for page in reader.pages:
            text += page.extract_text() + "\n"
    return text.strip()
La funzione extract_text_from_pdf() legge un file PDF, estrae il testo da ogni pagina usando PyPDF2.PdfReader() e restituisce il testo combinato come stringa.
Ora che abbiamo il testo estratto, passiamo a usare la thinking e la streaming mode di Claude 3.7 Sonnet per analizzare più paper e generare un'idea di ricerca strutturata.
La modalità streaming garantisce una gestione efficiente delle risposte di grandi dimensioni fornendo i risultati in modo progressivo, riducendo i tempi di attesa e prevenendo i timeout dell'API. La thinking mode migliora il ragionamento complesso consentendo al modello di generare pensieri interni strutturati prima di formulare la risposta finale, assicurando insight ben motivati.
# Function to analyze research papers with streaming
def analyze_papers_streaming(paper_texts, paper_count):
    """Uses Claude 3.7 Sonnet with Thinking Mode in streaming mode to analyze papers, find drawbacks, and generate a research project."""
    formatted_papers = "\n\n".join([f"### Paper {i+1}:\n{paper}" for i, paper in enumerate(paper_texts)])
    prompt = f"""
        You are an AI research assistant. You have been provided with {paper_count} research papers.
        Your task is to analyze these papers and perform the following:
        1. **Summarize each paper** with its core contributions and findings.
        2. **Identify key drawbacks** of each paper, focusing on limitations, gaps, or areas needing improvement.
        3. **Find interconnections and citations** between the papers—what ideas, methods, or datasets do they share?
        4. **Propose a novel research idea** that addresses a major limitation across these papers.
            - Suggest how techniques from different papers can be combined to solve a problem.
            - Ensure the idea is practical and feasible for further research.
            - Justify why this approach is promising.
        Below are the research papers
        {formatted_papers}
    """
    results = {"thinking": "", "research_idea": ""}
    with client.messages.stream(
        model="claude-3-7-sonnet-20250219",
        max_tokens=25000,
        thinking={
            "type": "enabled",
            "budget_tokens": 16000  # Large budget for deep reasoning
        },
        messages=[{"role": "user", "content": prompt}]
    ) as stream:
        current_block_type = None
        for event in stream:
            if event.type == "content_block_start":
                current_block_type = event.content_block.type
            elif event.type == "content_block_delta":
                if event.delta.type == "thinking_delta":
                    results["thinking"] += event.delta.thinking
                elif event.delta.type == "text_delta":
                    results["research_idea"] += event.delta.text
            elif event.type == "message_stop":
                break
    return results["thinking"], results["research_idea"]
La funzione analyze_papers_streaming() esegue i seguenti passaggi:
client.messages.stream() per inviare la richiesta a Claude 3.7 Sonnet. Questo abilita la thinking mode con budget_tokens=16000 e max_tokens=25000 per risposte più estese.content_block_start che indicano l'inizio di un blocco di risposta. Man mano che il modello genera l'output, gli eventi thinking_delta contengono passaggi di ragionamento intermedi, mentre gli eventi text_delta forniscono gli insight finali di ricerca. Il processo continua fino a quando un evento message_stop segnala il completamento della risposta.Puoi approfondire come perfezionare le tecniche di prompting per il ragionamento esteso qui.
Ora che la logica principale è pronta, procediamo con l'integrazione in Gradio, permettendo agli utenti di caricare articoli scientifici e ricevere insight strutturati.
# Gradio UI function
def gradio_interface(pdfs):
    paper_texts = [extract_text_from_pdf(pdf.name) for pdf in pdfs]
    paper_count = len(paper_texts)  # Count number of provided papers
    thinking, research_idea = analyze_papers_streaming(paper_texts, paper_count)
    return thinking, research_idea

# Set up the Gradio app
demo = gr.Interface(
    fn=gradio_interface,
    inputs=gr.File(file_types=[".pdf"], label="Upload Research Papers", file_count="multiple"),
    outputs=[gr.Textbox(label="Thinking Process"), gr.Textbox(label="Research Idea")],
    title="Claude 3.7 Sonnet - Powered Research Paper Analyzer",
    description="Upload multiple research papers to extract insights, identify key limitations, and generate a novel research idea."
)
if __name__ == "__main__":
    demo.launch(debug=True)
Il codice sopra imposta una UI Gradio in cui gli utenti possono caricare più PDF, che vengono elaborati per estrarre testo, analizzare gli insight chiave e generare idee di ricerca originali usando thinking e streaming mode.
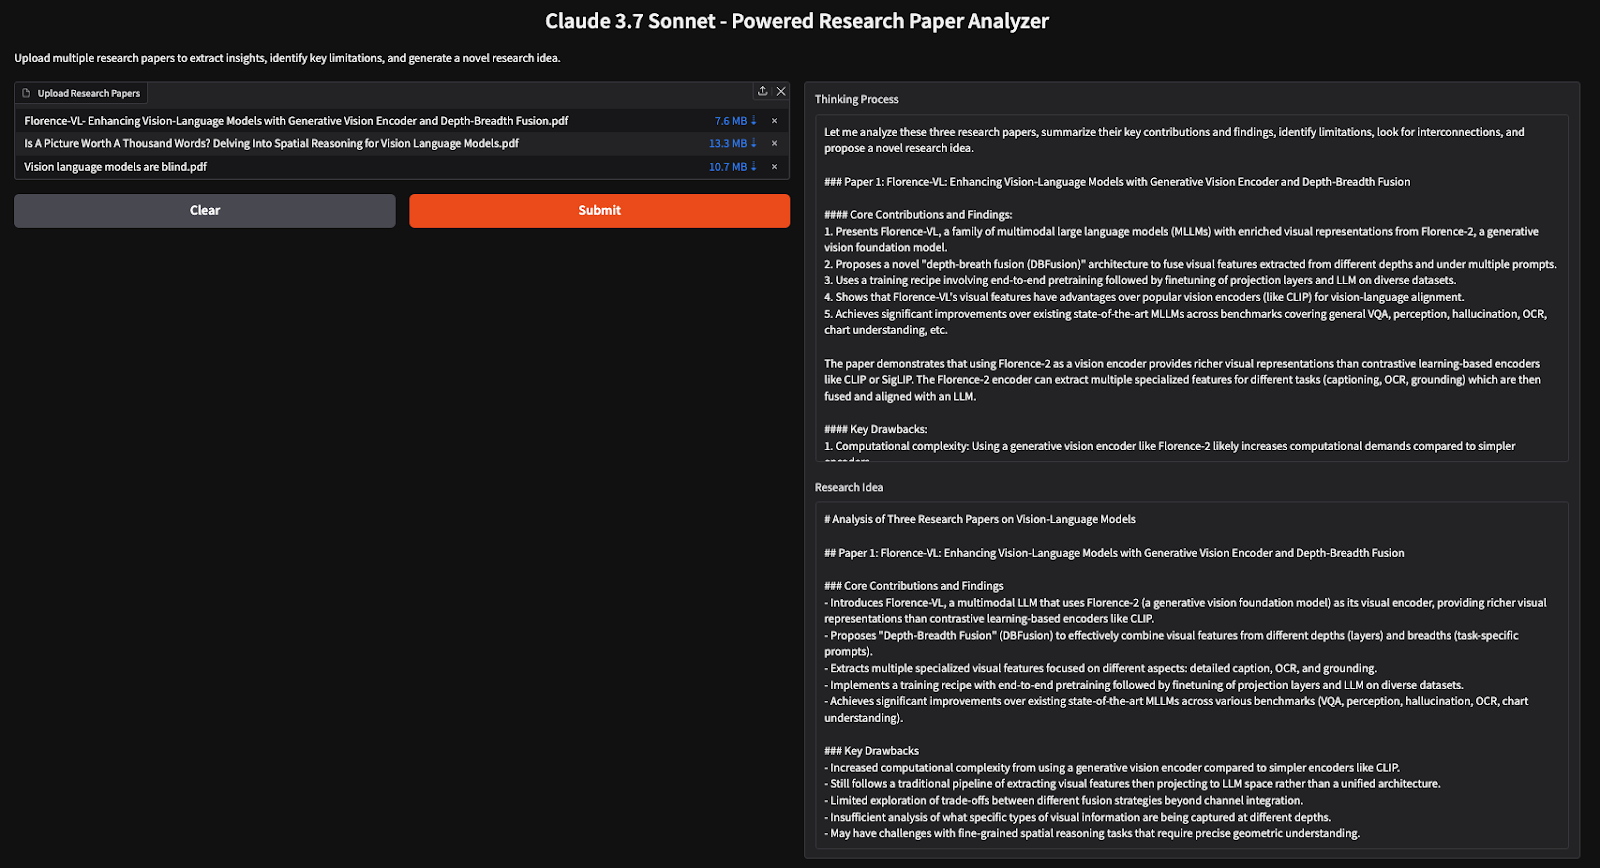
In questo tutorial abbiamo costruito un Research Paper Analyzer basato su IA utilizzando Claude 3.7 Sonnet, che permette ai ricercatori di estrarre rapidamente insight, identificare limiti e generare idee di ricerca originali a partire da più paper. Usando la thinking mode, il modello esegue un ragionamento profondo, rendendolo uno strumento efficace per review della letteratura e sintesi della ricerca.
Impara l'IA con questi corsi!
Programma
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min




