
学习路径
开发 AI 应用程序
21 小时
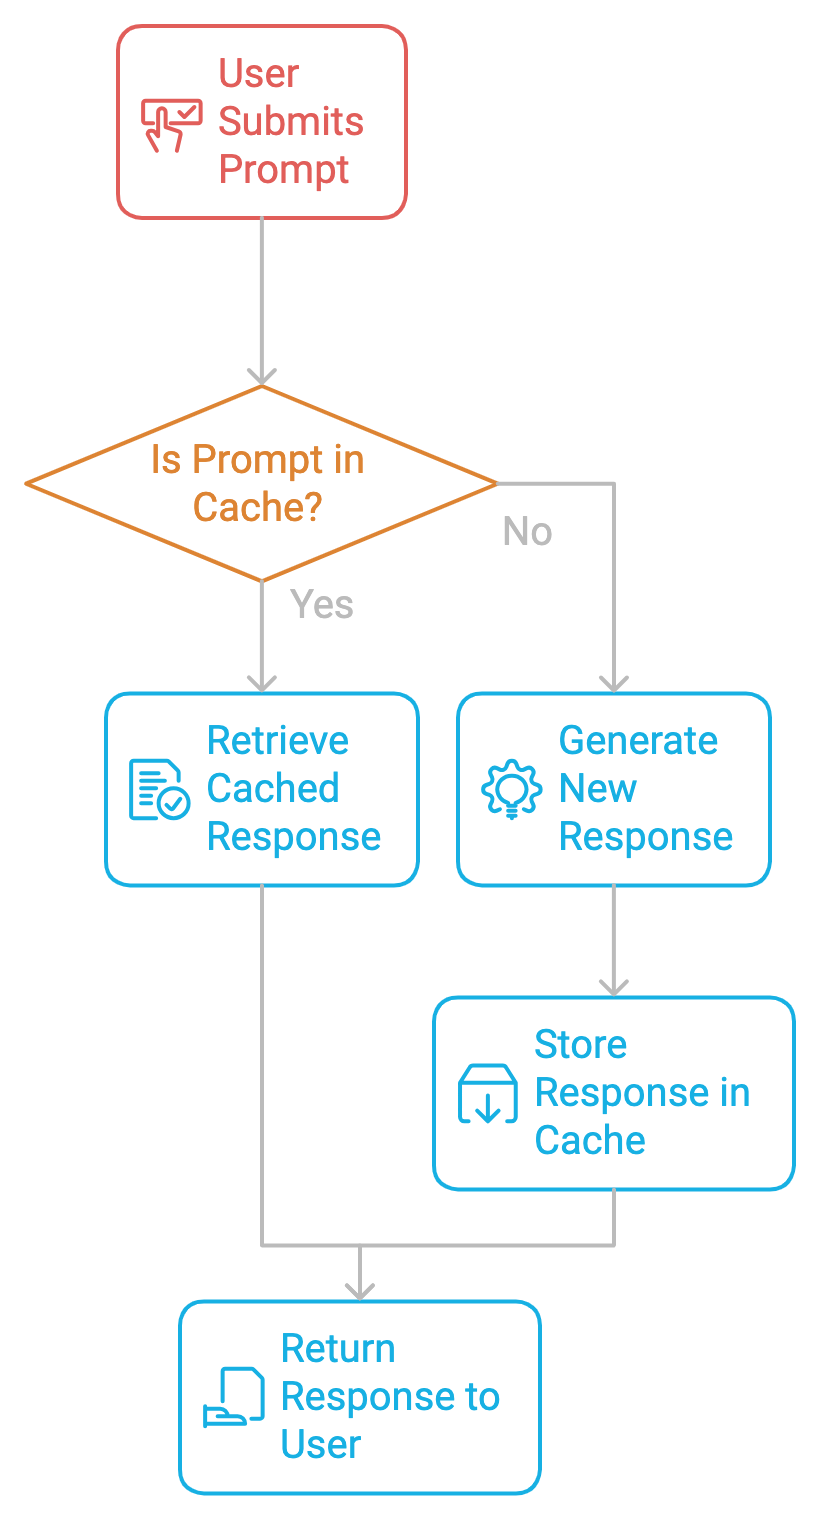
从本质上说,提示缓存在缓存中存储提示及其对应的响应。当再次提交相同或相似的提示时,系统会检索缓存的响应,而不是重新生成。这样可以避免重复计算,加快响应速度并降低成本。
提示缓存具有以下优势:
在深入实现提示缓存之前,我们需要注意以下几点。
为保证数据新鲜度,每条缓存的响应都应设置生存时间(TTL)。TTL 决定了缓存响应的有效期。一旦 TTL 过期,缓存项会被移除或更新,下次请求时将重新计算对应的提示。
这种机制能防止缓存存留过时信息。对于静态或更新不频繁的内容(如法律文档或产品手册),较长的 TTL 可以在不牺牲数据新鲜度的前提下减少重算。因此,合理调优 TTL 值对于在数据新鲜度与计算效率之间取得平衡至关重要。
有时两个提示相似但不完全相同。判断新提示与已缓存提示的相似度对于高效缓存至关重要。实现提示相似度通常需要模糊匹配或语义搜索等技术,利用向量嵌入表示提示并比较其相似性。
通过为相似提示缓存响应,系统既能减少重算,又能保持较高的响应准确度。但相似度阈值设得过宽可能导致错配,设得过严又可能错失缓存机会。
如 LRU(最近最少使用)等策略可用于管理缓存大小。LRU 会在缓存达到容量时移除最少被访问的数据。该策略适用于部分提示更为热门、需持续缓存,而不常见查询可被移除以给新请求腾出空间的场景。
实现提示缓存可分两步。
第一步是识别系统中经常重复的提示。无论是在构建聊天机器人、编码助手,还是文档处理器,我们都需要监控哪些提示被反复使用。一旦识别出这些提示,即可缓存以避免冗余计算。
识别后,将其响应与元数据(如 TTL、缓存命中/未命中率等)一并存入缓存。当用户再次提交相同提示时,系统直接检索缓存响应,跳过昂贵的生成过程。
有了理论基础,我们用 Ollama 在本地环境做个上手示例,对比启用缓存与不启用缓存的影响。这里我们使用一本在线深度学习书籍的数据与本地模型,来总结该书的前几页内容。我们将尝试多种 LLM,包括 Gemma2、Llama2 和Llama3,对比它们的表现。
此示例将使用BeautifulSoup,一个用于解析 HTML 与 XML 文档(包括标记不规范页面)的 Python 包。安装 BeautifulSoup,请运行:
!pip install BeautifulSoup我们还会用到Ollama。它可简化在本地系统上安装与管理大语言模型的流程。
开始之前,请下载并在桌面端安装 Ollama。我们可根据需求更换模型名称。访问 Ollama 官方网站的模型库,查看 Ollama 支持的不同模型。在终端运行以下命令:
ollama run llama3.1 一切就绪,开始吧!
我们先进行如下导入:
time:用于记录有无缓存代码的推理时间requests:用于发起 HTTP 请求并抓取网页数据BeautifulSoup:用于解析与清洗 HTML 内容Ollama:用于在本地使用 LLMimport time
import requests
from bs4 import BeautifulSoup
import ollama在下面的代码中,我们定义了函数 fetch_article_content,用于从给定 URL 抓取并清洗文本内容。它会尝试使用 requests 库获取网页内容,如遇网络错误或服务器问题等失败情况,最多重试三次。
函数使用 BeautifulSoup 解析 HTML 内容,并移除不必要的 <script> 与 <style> 标签。随后通过去除行首行尾空格、拆分行并重新组合为整洁的段落来进一步处理文本。若指定了内容上限,函数会将文本截断至该上限。若所有重试均失败,函数会在每次尝试间短暂等待后抛出异常。
下面是几个关键参数:
BeautifulSoup 移除 <script> 与 <style> 等不必要元素。def fetch_article_content(url, retries=3, content_limit=None):
attempt = 0
while attempt < retries:
try:
response = requests.get(url, timeout=30) # Add timeout to prevent hanging
response.raise_for_status() # Raise an error for bad responses (4xx, 5xx)
soup = BeautifulSoup(response.content, 'html.parser')
# Remove script and style elements
for script in soup(["script", "style"]):
script.decompose()
# Get text
text = soup.get_text()
# Break into lines and remove leading and trailing space on each
lines = (line.strip() for line in text.splitlines())
chunks = (phrase.strip() for line in lines for phrase in line.split(" "))
text = '\n'.join(chunk for chunk in chunks if chunk)
# Limit content if specified
if content_limit:
text = text[:content_limit]
return text
except (requests.exceptions.RequestException, requests.exceptions.ChunkedEncodingError) as e:
attempt += 1
print(f"Attempt {attempt} failed: {e}")
if attempt >= retries:
raise
time.sleep(2) # Wait before retrying接下来,我们从一本书中抓取内容用于推理。这里使用 Ian Goodfellow、Yoshua Bengio 和 Aaron Courville 撰写的深度学习书籍的一个 URL,借助 fetch_article_content 函数提取前 200,000 个字符。我们打印前 500 个字符作为预览。
book_url = "https://www.deeplearningbook.org/contents/intro.html"
book_content = fetch_article_content(book_url, content_limit=200000)
print(f"Fetched {len(book_content)} characters from the book.")
print("First 500 characters:")
print(book_content[:500])现在数据已提取并清洗完毕。接下来,我们通过 Ollama 使用 Llama3 进行无缓存推理。Ollama 提供多种可在本地实验的语言模型。
对于无缓存推理,我们在未启用缓存的情况下生成该书的摘要。我们先记录起始时间,再通过 ollama.generate() 函数生成响应。生成完成后,再用 response.get() 检查响应并提取摘要。
注意:我们仅统计生成响应所花费的时间(即 generate() 函数前后)。
def make_non_cached_inference(prompt):
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure
    print(f"Full response: {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    return generated_summary, end_time - start_time
上述代码的几个要点:
llama3),并获取响应。.get() 以避免 KeyError)。在无缓存推理之后,我们再进行有缓存推理实验。下面的函数会在可用时使用缓存结果生成书籍摘要。与前一步类似,我们用相同的代码生成响应。唯一的差别在于前置检查:若提示已在缓存中,模型不会再进行推理,而是直接使用缓存响应;否则,将结果存入缓存以备后用。
def make_cached_inference(prompt, cache):
    if prompt in cache:
        print("Using cached result...")
        return cache[prompt], 0  # Return cached response with 0 latency
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure (if needed)
    print(f"Full response (cached call): {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    cache[prompt] = generated_summary  # Store result in cache
    return generated_summary, end_time - start_time
上述代码的几个要点:
函数都已就位,下面是我们要使用的提示。欢迎自由尝试。它会取书籍的前 10,000 个字符,并要求模型生成摘要。
prompt = f"<book>{book_content[:10000]}</book>\nPlease provide a summary of this book."现在我们分别进行无缓存与有缓存推理,生成摘要并展示各自的用时与摘要。若已命中缓存,将以零延迟返回缓存摘要;否则会将结果存入缓存以备后续使用。
non_cached_response, non_cached_time = make_non_cached_inference(prompt)
print(f"Non-cached inference time: {non_cached_time:.2f} seconds")
print(f"Non-cached summary: {non_cached_response}")
cache = {}

# Cached inference to generate a summary
cached_response, cached_time = make_cached_inference(prompt, cache)
print(f"Cached inference time: {cached_time:.2f} seconds")
print(f"Cached summary: {cached_response}")
该代码展示了缓存如何通过存储结果来避免重复计算。对于重复提示,缓存结果能显著降低延迟,我们会在下一节中看到这一点。
基于上述代码,我们在同一数据上试验了四个不同模型。
|
模型 |
无缓存推理时间 |
有缓存推理时间 |
|
Llama2 |
143.98 秒 |
65.84 秒 |
|
Llama3 |
151.79 秒 |
42.48 秒 |
|
Gemma2 |
170.43 秒 |
61.84 秒 |
|
Phi3 |
239.55 秒 |
100.86 秒 |
基于我们在这四个模型上的推理用时实验,可以明显看出,有缓存推理能将推理时间显著降低。
由于缓存会占用系统内存,因此需要考虑一些有助于降低成本与内存需求的做法。
识别应用中反复出现相同或相似提示的区域。例如,常见客服问题如“如何修改我的 ATM 密码?”;常见编程问题如“如何用 Python 打印 Hello World?”;或经常被反复查看的长文档片段(如“请总结这本书/论文”)。对这些提示进行缓存能最大化效率。
向 LLM 提交提示时保持一致的结构有助于提升缓存命中率。良好的格式可包含精炼的用户输入与示例。指令越一致,找到匹配或相似缓存提示的概率就越高。
良好的缓存管理能在不膨胀内存与成本的前提下平衡内存约束与性能需求。根据应用需求设置合适的缓存大小与淘汰策略(如 LRU),以确保在不增加内存占用的情况下获得高效表现。
监控缓存命中率对于评估缓存策略的有效性至关重要。若命中率偏低,可考虑调整相似度阈值、增大缓存大小,或优化提示的一致性,以更好地匹配输入提示。
将上述缓存实践与优良的存储实践结合,能让应用以最佳状态运行。接下来,我们将介绍一些缓存存储与共享技术。
缓存的提示可以存储在本地(单台机器)或分布在多台服务器上。本地缓存管理更简单,但在大规模应用中可能吃力。相较之下,分布式缓存能服务更大的用户群并承载更高负载,但也更复杂且成本更高。
对于拥有多名用户或多套应用的组织,在系统间共享缓存提示可以通过集中式访问来降低成本并提升性能,让不同设备与用户以尽可能低的成本受益于既有响应,避免重复计算。
隐私是在存储缓存数据(尤其是用户输入与响应)时的关键考量。敏感数据应进行加密,并设置访问控制,确保只有授权用户可以访问缓存。可采用多种加密算法保护用户数据。另一项近来常见的做法是将计算放在本地设备上执行,保证数据不离开设备。
在跨多用户或多应用共享缓存提示的环境中,缓存预热与保活 ping 等技术有助于维持共享数据的可用性与新鲜度,减少缓存未命中,确保全网一致而迅捷的用户体验。下面更详细地介绍这些技术。
一种确保缓存始终包含相关数据的方式是对缓存进行“预热”,即预先填充常用提示。此技术可降低系统启动后的前几次交互延迟。比如在电商聊天机器人中,诸如“你们的退货政策是什么?”或“我的订单在哪里?”等常见问题可预先缓存,以便从一开始就能即时响应。系统重启、更新或发布后也适合进行缓存预热,以避免缓存为空导致最初响应变慢的“冷启动”。
为防止缓存项因不活跃而过期,可以定期发送保活 ping,确保热门的缓存提示在更长时间内保持新鲜可用。保活 ping 会周期性刷新特定缓存项,尤其是与高价值或高频请求提示相关的条目,即使它们近期未被使用,系统也能确保其新鲜与可用。
这对存在周期性流量模式的应用尤其有用,比如电商在季节性高峰期的咨询,或客服在高峰时段的交互。
成本优化是任何基于 AI 的应用的核心考量之一,从 API 调用次数到总体内存使用都需纳入考量。
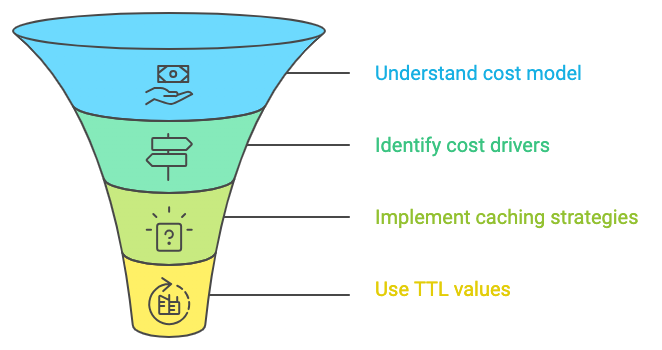
在尝试众多缓存示例的过程中,我们可能会遇到一些需要简单修复的问题。常见问题包括:
当在缓存中找不到提示时,就会发生缓存未命中。其原因可能是提示结构不一致,或相似度阈值过严。为解决此问题,需要检查提示是否一致,并调整相似度阈值以允许轻微变体。设想一个客服聊天机器人经常收到“你们的退款政策是什么?”并为此缓存了响应。但若用户询问“能介绍一下你们的退货政策吗?”,而系统的相似度阈值过严,就无法将其识别为相似提示,导致缓存未命中。
当底层数据或模型发生变化时,缓存失效是必要的。您可以设置自动失效策略来刷新缓存项,或在需要时对特定条目执行手动失效。比如某金融应用缓存了与税收法规相关的响应,如果税法发生变化,先前缓存的响应就会过时。系统可设置自动失效策略,在法规更新后刷新或清除缓存。
本文介绍了提示缓存的概念及其在 Ollama 中的实现。我们展示了提示缓存如何显著减少与 LLM 相关的推理时间与成本。
通过以下课程学习 AI!
学习路径
课程
课程