
Our biggest-ever sale. 60% off AI & data skills
Buy Now
Chúng ta sẽ phát triển Trình phân tích Bài báo Nghiên cứu dựa trên Gradio cho phép người dùng:
Để tối ưu chi phí cho API Claude 3.7 Sonnet, chúng ta cần điều chỉnh cách sử dụng theo nhu cầu dự án, vì token đầu vào có giá $3/M và token đầu ra, bao gồm Thinking Mode, có giá $15/M.
Cần giảm chi phí bằng cách sử dụng prompt caching, xử lý theo lô và chế độ streaming cho phản hồi dài. Ta còn có thể tối ưu Thinking Mode bằng cách đặt ngân sách token thấp hơn (bắt đầu từ 1.024 token) và chỉ tăng khi cần thiết.
Bạn có thể tìm hiểu thêm về tối ưu chi phí API qua tài liệu chính thức của Anthropic.
Trước khi bắt đầu, hãy làm rõ Thinking Mode là gì, phòng khi bạn chưa quen. Thinking Mode là tính năng mới trong Claude 3.7 Sonnet cho phép suy luận từng bước trước khi tạo câu trả lời cuối cùng. Nó cho phép mô hình:
Tóm gọn, cơ chế hoạt động như sau:
Trước khi bắt đầu, chúng ta cần thiết lập khóa API Anthropic:
1. Bắt đầu bằng cách đăng nhập vào bảng điều khiển Anthropic: https://console.anthropic.com/
2. Nhấp vào Get API Keys.
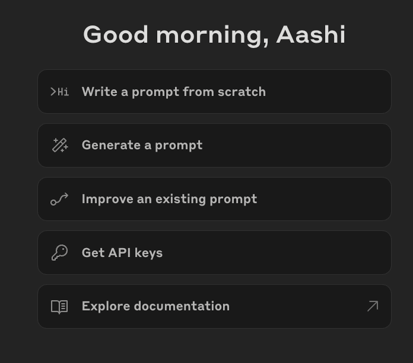
3. Bạn sẽ được chuyển đến tab API Keys. Nhấp vào Create API Key và nhập tên khóa của bạn.
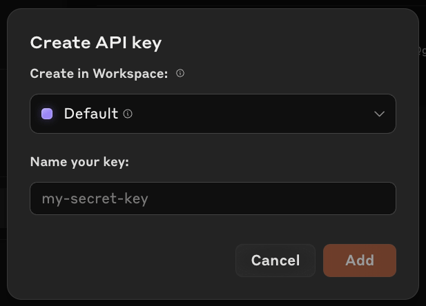
4. Sao chép khóa này và lưu lại để sử dụng sau.
5. Bây giờ, nạp một ít tiền vào tài khoản thanh toán, trong tab Billing. Chỉ cần nhấp vào mua credit và thêm khoảng $5 vào tài khoản của bạn (đủ cho dự án này).
Giờ chúng ta đã có API Key. Tiếp theo, đảm bảo các thư viện phụ thuộc cần thiết đã được cài đặt.
pip install anthropic gradio PyPDF2Sau khi cài đặt, import các thư viện cần thiết:
import anthropic
import PyPDF2
import os
import gradio as grGiờ khi đã import đủ thư viện, chúng ta thiết lập Claude API.
Nếu bạn dùng Google Colab, bạn có thể lưu khóa API trong tab Secrets và sau đó dùng hàm get() để truy cập. Nếu không, bạn có thể truyền trực tiếp khóa API vào mã (không khuyến nghị).
Tiếp theo, khởi tạo client Claude bằng thư viện Anthropic và truyền khóa API.
# If using Google Colab Secrets
from google.colab import userdata
API_KEY = userdata.get('claude-3.7-sonnet')
client = anthropic.Anthropic(
api_key=API_KEY,
)Phần thiết lập đã hoàn tất. Tiếp theo, chúng ta xử lý phần trích xuất văn bản.
Chúng ta sẽ dùng PyPDF2 để trích xuất văn bản từ các tệp PDF được tải lên. Claude 3.7 Sonnet chỉ chấp nhận văn bản và hình ảnh làm đầu vào. Vì vậy, ta trích xuất văn bản trước để xử lý hiệu quả, đồng thời tối đa hóa khả năng của Claude 3.7 Sonnet với Thinking Mode.
# Function to extract text from a PDF file
def extract_text_from_pdf(pdf_path):
"""Extracts text from a given PDF file."""
text = ""
with open(pdf_path, "rb") as f:
reader = PyPDF2.PdfReader(f)
for page in reader.pages:
text += page.extract_text() + "\n"
return text.strip()Hàm extract_text_from_pdf() đọc tệp PDF, trích xuất văn bản từ từng trang bằng PyPDF2.PdfReader(), và trả về chuỗi văn bản đã ghép nối.
Khi đã có văn bản trích xuất, ta tiếp tục sử dụng thinking và streaming mode của Claude 3.7 Sonnet để phân tích nhiều bài và tạo ý tưởng nghiên cứu có cấu trúc.
Chế độ streaming giúp xử lý hiệu quả các phản hồi lớn bằng cách trả kết quả dần, giảm thời gian chờ và tránh timeout API. Thinking mode tăng cường suy luận phức tạp bằng cách cho phép mô hình tạo ra các ý nghĩ nội bộ có cấu trúc trước khi hình thành câu trả lời cuối, đảm bảo insight có cơ sở vững chắc.
# Function to analyze research papers with streaming
def analyze_papers_streaming(paper_texts, paper_count):
"""Uses Claude 3.7 Sonnet with Thinking Mode in streaming mode to analyze papers, find drawbacks, and generate a research project."""
formatted_papers = "\n\n".join([f"### Paper {i+1}:\n{paper}" for i, paper in enumerate(paper_texts)])
prompt = f"""
You are an AI research assistant. You have been provided with {paper_count} research papers.
Your task is to analyze these papers and perform the following:
1. **Summarize each paper** with its core contributions and findings.
2. **Identify key drawbacks** of each paper, focusing on limitations, gaps, or areas needing improvement.
3. **Find interconnections and citations** between the papers—what ideas, methods, or datasets do they share?
4. **Propose a novel research idea** that addresses a major limitation across these papers.
- Suggest how techniques from different papers can be combined to solve a problem.
- Ensure the idea is practical and feasible for further research.
- Justify why this approach is promising.
Below are the research papers
{formatted_papers}
"""
results = {"thinking": "", "research_idea": ""}
with client.messages.stream(
model="claude-3-7-sonnet-20250219",
max_tokens=25000,
thinking={
"type": "enabled",
"budget_tokens": 16000 # Large budget for deep reasoning
},
messages=[{"role": "user", "content": prompt}]
) as stream:
current_block_type = None
for event in stream:
if event.type == "content_block_start":
current_block_type = event.content_block.type
elif event.type == "content_block_delta":
if event.delta.type == "thinking_delta":
results["thinking"] += event.delta.thinking
elif event.delta.type == "text_delta":
results["research_idea"] += event.delta.text
elif event.type == "message_stop":
break
return results["thinking"], results["research_idea"]Hàm analyze_papers_streaming() thực hiện các bước sau:
client.messages.stream() để gửi yêu cầu tới Claude 3.7 Sonnet. Điều này bật thinking mode với budget_tokens=16000 và max_tokens=25000 cho độ dài phản hồi mở rộng.content_block_start báo hiệu bắt đầu một khối phản hồi. Khi mô hình tạo đầu ra, các sự kiện thinking_delta chứa bước suy luận trung gian, trong khi text_delta cung cấp insight nghiên cứu cuối. Quá trình tiếp diễn cho đến khi sự kiện message_stop báo hoàn tất phản hồi.Bạn có thể tìm hiểu thêm về tinh chỉnh kỹ thuật prompt cho extended thinking tại đây.
Khi đã có logic chính, ta tiếp tục tích hợp vào Gradio, cho phép người dùng tải bài báo và nhận insight có cấu trúc.
# Gradio UI function
def gradio_interface(pdfs):
paper_texts = [extract_text_from_pdf(pdf.name) for pdf in pdfs]
paper_count = len(paper_texts) # Count number of provided papers
thinking, research_idea = analyze_papers_streaming(paper_texts, paper_count)
return thinking, research_idea
# Set up the Gradio app
demo = gr.Interface(
fn=gradio_interface,
inputs=gr.File(file_types=[".pdf"], label="Upload Research Papers", file_count="multiple"),
outputs=[gr.Textbox(label="Thinking Process"), gr.Textbox(label="Research Idea")],
title="Claude 3.7 Sonnet - Powered Research Paper Analyzer",
description="Upload multiple research papers to extract insights, identify key limitations, and generate a novel research idea."
)
if __name__ == "__main__":
demo.launch(debug=True)Đoạn mã trên thiết lập giao diện Gradio nơi người dùng có thể tải nhiều PDF, các tệp này sẽ được xử lý để trích xuất văn bản, phân tích insight chính và tạo ý tưởng nghiên cứu mới nhờ thinking và streaming mode.
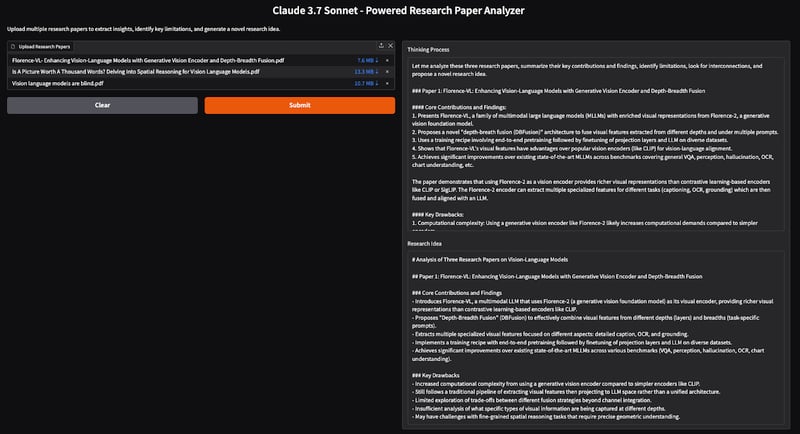
Trong hướng dẫn này, chúng ta đã xây dựng Trình phân tích Bài báo Nghiên cứu ứng dụng AI bằng Claude 3.7 Sonnet, giúp nhà nghiên cứu hiệu quả hơn trong việc trích xuất insight, xác định hạn chế và tạo ý tưởng nghiên cứu mới từ nhiều bài báo. Nhờ thinking mode, mô hình thực hiện suy luận sâu, trở thành công cụ hiệu quả cho tổng quan tài liệu và tổng hợp nghiên cứu.
Tôi là Chuyên gia Google Developers trong lĩnh vực ML (Gen AI), Chuyên gia Kaggle 3x và Đại sứ Women Techmakers với hơn 3 năm kinh nghiệm trong ngành công nghệ. Tôi đồng sáng lập một startup công nghệ y tế vào năm 2020 và hiện đang theo học thạc sĩ khoa học máy tính tại Georgia Tech, chuyên sâu về học máy.

blog
 Matt Crabtree• 10 phút
Học AI với các khóa học này!
Lộ trình
Học cách phát triển các ứng dụng được hỗ trợ bởi trí tuệ nhân tạo (AI) bằng cách sử dụng các công cụ phát triển AI mới nhất, bao gồm API OpenAI, Hugging Face và LangChain.
Khóa học
Tìm hiểu các phương pháp tiên tiến để tích hợp dữ liệu bên ngoài với LLMs bằng cách sử dụng Retrieval Augmented Generation (RAG) với LangChain.
Lộ trình
Thử nghiệm với Llama 3 để thực hiện suy luận trên các mô hình đã được huấn luyện sẵn, tinh chỉnh chúng trên các tập dữ liệu tùy chỉnh và tối ưu hóa hiệu suất.


Claude 3.7 Sonnet là mẫu AI mới nhất của Anthropic, cung cấp khả năng suy luận nâng cao nhờ Thinking Mode mới. Mô hình có thể xử lý ngữ cảnh 200K token, rất phù hợp cho phân tích nghiên cứu phức tạp.
Trong hướng dẫn này, tôi sẽ giải thích từng bước cách xây dựng Trình phân tích Bài báo Nghiên cứu sử dụng Claude 3.7 Sonnet, có khả năng:
Chúng ta cũng sẽ tích hợp Thinking Mode của Claude 3.7 Sonnet với Gradio để cho phép người dùng tải lên nhiều bài báo và nhận insight có cấu trúc.
Bài viết này tập trung vào phần thực hành—nếu bạn chỉ cần phần tổng quan, tôi khuyến nghị bài viết về Claude 3.7 Sonnet.
Và nếu bạn đang tìm một bản demo rõ ràng, hãy xem video hướng dẫn API Claude 3.7 Sonnet của chúng tôi và xây dựng một trợ lý nghiên cứu đa phương thức. Video sẽ hướng dẫn bạn cách truy cập thiết lập Anthropic API, trích xuất và xử lý PDF bằng PyPDF2 xử lý tài liệu, sử dụng thinking mode của Claude 3.7, và xây dựng một trợ lý nghiên cứu thực tế bằng Gradio. Bạn cũng có thể xem mẫu Claude mới nhất, Claude Sonnet 4.5, và Claude Agent SDK.