
Last chance! 50% off DataCamp Premium
Sale ends in
हम Gradio-आधारित Research Paper Analyzer विकसित करेंगे, जो उपयोगकर्ताओं को सक्षम करेगा:
Claude 3.7 Sonnet API की लागत अनुकूलित करने के लिए, हमें इसकी उपयोगिता को परियोजना की आवश्यकताओं के साथ संरेखित करना होगा, क्योंकि इनपुट टोकन की लागत $3/M है और आउटपुट टोकन, जिसमें Thinking Mode शामिल है, की लागत $15/M है।
हमें प्रॉम्प्ट कैशिंग, बैच प्रोसेसिंग और लंबी प्रतिक्रियाओं के लिए स्ट्रीमिंग मोड का उपयोग करके खर्च कम करने चाहिए। हम Thinking Mode को भी अनुकूलित कर सकते हैं, कम टोकन बजट (1,024 टोकन से शुरू) सेट करके और केवल आवश्यकता होने पर उसे बढ़ाकर।
आप Anthropic के आधिकारिक दस्तावेज़ के माध्यम से API लागत का अनुकूलन करने के बारे में और अधिक जान सकते हैं।
शुरू करने से पहले, यदि आप इससे परिचित नहीं हैं, तो आइए संक्षेप में समझें कि Thinking Mode क्या है। Thinking Mode Claude 3.7 Sonnet में एक नई सुविधा है जो अंतिम उत्तर जनरेट करने से पहले चरण-दर-चरण तर्क सक्षम करती है। यह मॉडल को सक्षम बनाता है:
संक्षेप में, यह इस प्रकार काम करता है:
शुरू करने से पहले, हमें Anthropic API कुंजी सेटअप करनी होगी:
1. Anthropic कंसोल में लॉग इन करके शुरू करें: https://console.anthropic.com/
2. Get API Keys पर क्लिक करें।
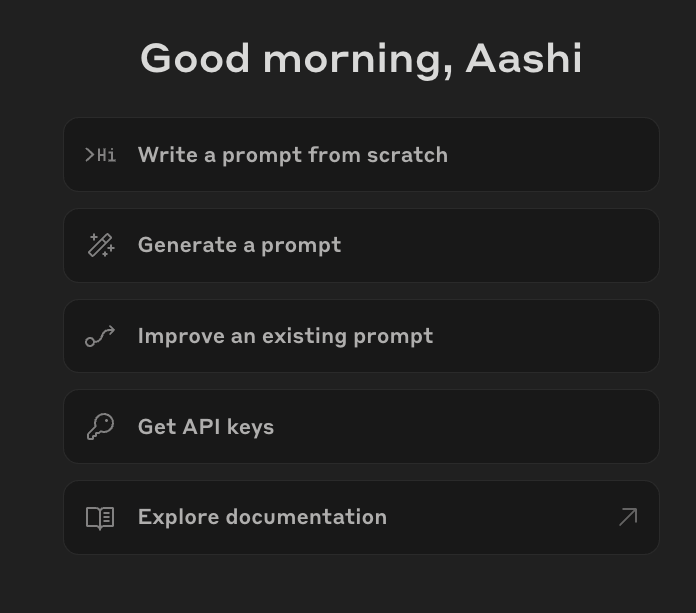
3. आपको API Keys टैब पर रीडायरेक्ट किया जाएगा। Create API Key पर क्लिक करें और अपनी कुंजी का नाम दर्ज करें।
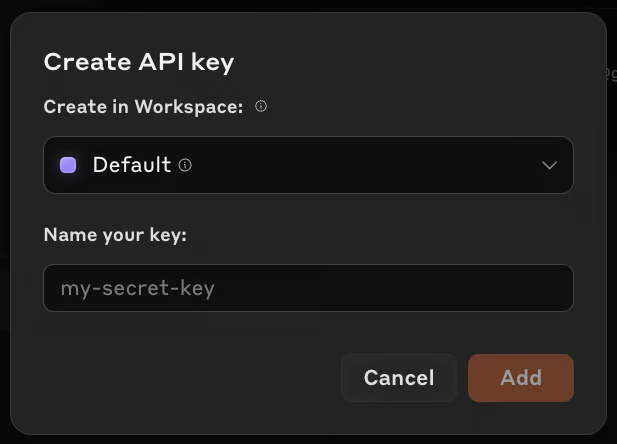
4. इस कुंजी को कॉपी करें और भविष्य के संदर्भ के लिए सुरक्षित रखें।
5. अब Billing टैब के अंतर्गत अपने बिलिंग खाते में कुछ क्रेडिट जोड़ें। बस buy credits पर क्लिक करें और अपने खाते में लगभग $5 जोड़ें (इस प्रोजेक्ट के लिए पर्याप्त)।
अब हमारे पास API Key है। आइए सुनिश्चित करें कि आवश्यक डिपेंडेंसियाँ इंस्टॉल हैं।
pip install anthropic gradio PyPDF2इंस्टॉल होने के बाद, आवश्यक लाइब्रेरी इम्पोर्ट करें:
import anthropic
import PyPDF2
import os
import gradio as grअब जब हमने सभी आवश्यक लाइब्रेरी इम्पोर्ट कर ली हैं, अगला कदम Claude API सेट करना है।
यदि आप Google Colab का उपयोग कर रहे हैं, तो आप API कुंजी को Secrets टैब में सहेज सकते हैं और फिर इसे एक्सेस करने के लिए get() फ़ंक्शन का उपयोग कर सकते हैं। अन्यथा, आप API कुंजी सीधे अपने कोड में पास कर सकते हैं (अनुशंसित नहीं)।
इसके बाद, हम Anthropic लाइब्रेरी का उपयोग करके Claude क्लाइंट प्रारंभ करते हैं और API कुंजी पास करते हैं।
# If using Google Colab Secrets
from google.colab import userdata
API_KEY = userdata.get('claude-3.7-sonnet')
client = anthropic.Anthropic(
    api_key=API_KEY,
)
यह हमारा सेटअप भाग पूरा करता है। अगला, हम टेक्स्ट एक्सट्रैक्शन पर काम करेंगे।
हम अपलोड की गई PDF फाइलों से टेक्स्ट निकालने के लिए PyPDF2 का उपयोग करेंगे। Claude 3.7 Sonnet केवल टेक्स्ट और छवियों को इनपुट के रूप में स्वीकार करता है। इसलिए, हम प्रोसेसिंग को कुशल बनाने के लिए पहले से टेक्स्ट निकालते हैं, साथ ही Thinking Mode के साथ Claude 3.7 Sonnet की क्षमताओं का अधिकतम लाभ उठाते हैं।
# Function to extract text from a PDF file
def extract_text_from_pdf(pdf_path):
    """Extracts text from a given PDF file."""
    text = ""
    with open(pdf_path, "rb") as f:
        reader = PyPDF2.PdfReader(f)
        for page in reader.pages:
            text += page.extract_text() + "\n"
    return text.strip()
फंक्शन extract_text_from_pdf() एक PDF फ़ाइल पढ़ता है, PyPDF2.PdfReader() का उपयोग करके प्रत्येक पृष्ठ से टेक्स्ट निकालता है और संयुक्त टेक्स्ट को एक स्ट्रिंग के रूप में लौटाता है।
अब जब हमारे पास निकाला हुआ टेक्स्ट है, तो हम Claude 3.7 Sonnet के thinking और streaming मोड का उपयोग करके कई पेपरों का विश्लेषण करेंगे और एक संरचित शोध आइडिया जनरेट करेंगे।
स्ट्रीमिंग मोड बड़े उत्तरों को क्रमिक रूप से डिलीवर करके कुशलता सुनिश्चित करता है, प्रतीक्षा समय कम करता है और API टाइमआउट रोकता है। Thinking mode जटिल तर्क को बेहतर बनाता है, क्योंकि मॉडल अंतिम उत्तर देने से पहले संरचित आंतरिक विचार तैयार करता है, जिससे उचित रूप से तर्कसंगत अंतर्दृष्टि मिलती है।
# Function to analyze research papers with streaming
def analyze_papers_streaming(paper_texts, paper_count):
    """Uses Claude 3.7 Sonnet with Thinking Mode in streaming mode to analyze papers, find drawbacks, and generate a research project."""
    formatted_papers = "\n\n".join([f"### Paper {i+1}:\n{paper}" for i, paper in enumerate(paper_texts)])
    prompt = f"""
        You are an AI research assistant. You have been provided with {paper_count} research papers.
        Your task is to analyze these papers and perform the following:
        1. **Summarize each paper** with its core contributions and findings.
        2. **Identify key drawbacks** of each paper, focusing on limitations, gaps, or areas needing improvement.
        3. **Find interconnections and citations** between the papers—what ideas, methods, or datasets do they share?
        4. **Propose a novel research idea** that addresses a major limitation across these papers.
            - Suggest how techniques from different papers can be combined to solve a problem.
            - Ensure the idea is practical and feasible for further research.
            - Justify why this approach is promising.
        Below are the research papers
        {formatted_papers}
    """
    results = {"thinking": "", "research_idea": ""}
    with client.messages.stream(
        model="claude-3-7-sonnet-20250219",
        max_tokens=25000,
        thinking={
            "type": "enabled",
            "budget_tokens": 16000  # Large budget for deep reasoning
        },
        messages=[{"role": "user", "content": prompt}]
    ) as stream:
        current_block_type = None
        for event in stream:
            if event.type == "content_block_start":
                current_block_type = event.content_block.type
            elif event.type == "content_block_delta":
                if event.delta.type == "thinking_delta":
                    results["thinking"] += event.delta.thinking
                elif event.delta.type == "text_delta":
                    results["research_idea"] += event.delta.text
            elif event.type == "message_stop":
                break
    return results["thinking"], results["research_idea"]
फंक्शन analyze_papers_streaming() निम्नलिखित चरणों का पालन करता है:
client.messages.stream() का उपयोग करके अनुरोध Claude 3.7 Sonnet को भेजना है। यह Thinking Mode को budget_tokens=16000 और विस्तारित प्रतिक्रिया लंबाई के लिए max_tokens=25000 के साथ सक्षम करता है।content_block_start इवेंट मिलते हैं जो प्रतिक्रिया ब्लॉक की शुरुआत दर्शाते हैं। जैसे-जैसे मॉडल आउटपुट जनरेट करता है, thinking_delta इवेंट में मध्यवर्ती तर्क चरण होते हैं, जबकि text_delta इवेंट अंतिम शोध अंतर्दृष्टि प्रदान करते हैं। प्रक्रिया तब तक चलती है जब तक कि message_stop इवेंट प्रतिक्रिया के पूर्ण होने का संकेत नहीं दे देता।विस्तारित थिंकिंग के लिए प्रॉम्प्टिंग तकनीकों को परिष्कृत करने के बारे में और जानने के लिए यहाँ देखें।
अब जब हमारा मुख्य लॉजिक बन चुका है, तो हम इसे Gradio में इंटीग्रेट करना जारी रखते हैं, ताकि उपयोगकर्ता शोध-पत्र अपलोड कर सकें और संरचित अंतर्दृष्टि प्राप्त कर सकें।
# Gradio UI function
def gradio_interface(pdfs):
    paper_texts = [extract_text_from_pdf(pdf.name) for pdf in pdfs]
    paper_count = len(paper_texts)  # Count number of provided papers
    thinking, research_idea = analyze_papers_streaming(paper_texts, paper_count)
    return thinking, research_idea

# Set up the Gradio app
demo = gr.Interface(
    fn=gradio_interface,
    inputs=gr.File(file_types=[".pdf"], label="Upload Research Papers", file_count="multiple"),
    outputs=[gr.Textbox(label="Thinking Process"), gr.Textbox(label="Research Idea")],
    title="Claude 3.7 Sonnet - Powered Research Paper Analyzer",
    description="Upload multiple research papers to extract insights, identify key limitations, and generate a novel research idea."
)
if __name__ == "__main__":
    demo.launch(debug=True)
उपरोक्त कोड एक Gradio UI सेट करता है जहाँ उपयोगकर्ता कई PDFs अपलोड कर सकते हैं, जिन्हें टेक्स्ट निकालने, प्रमुख अंतर्दृष्टि विश्लेषण करने और thinking और streaming मोड का उपयोग करके नए शोध विचार बनाने के लिए प्रोसेस किया जाता है।
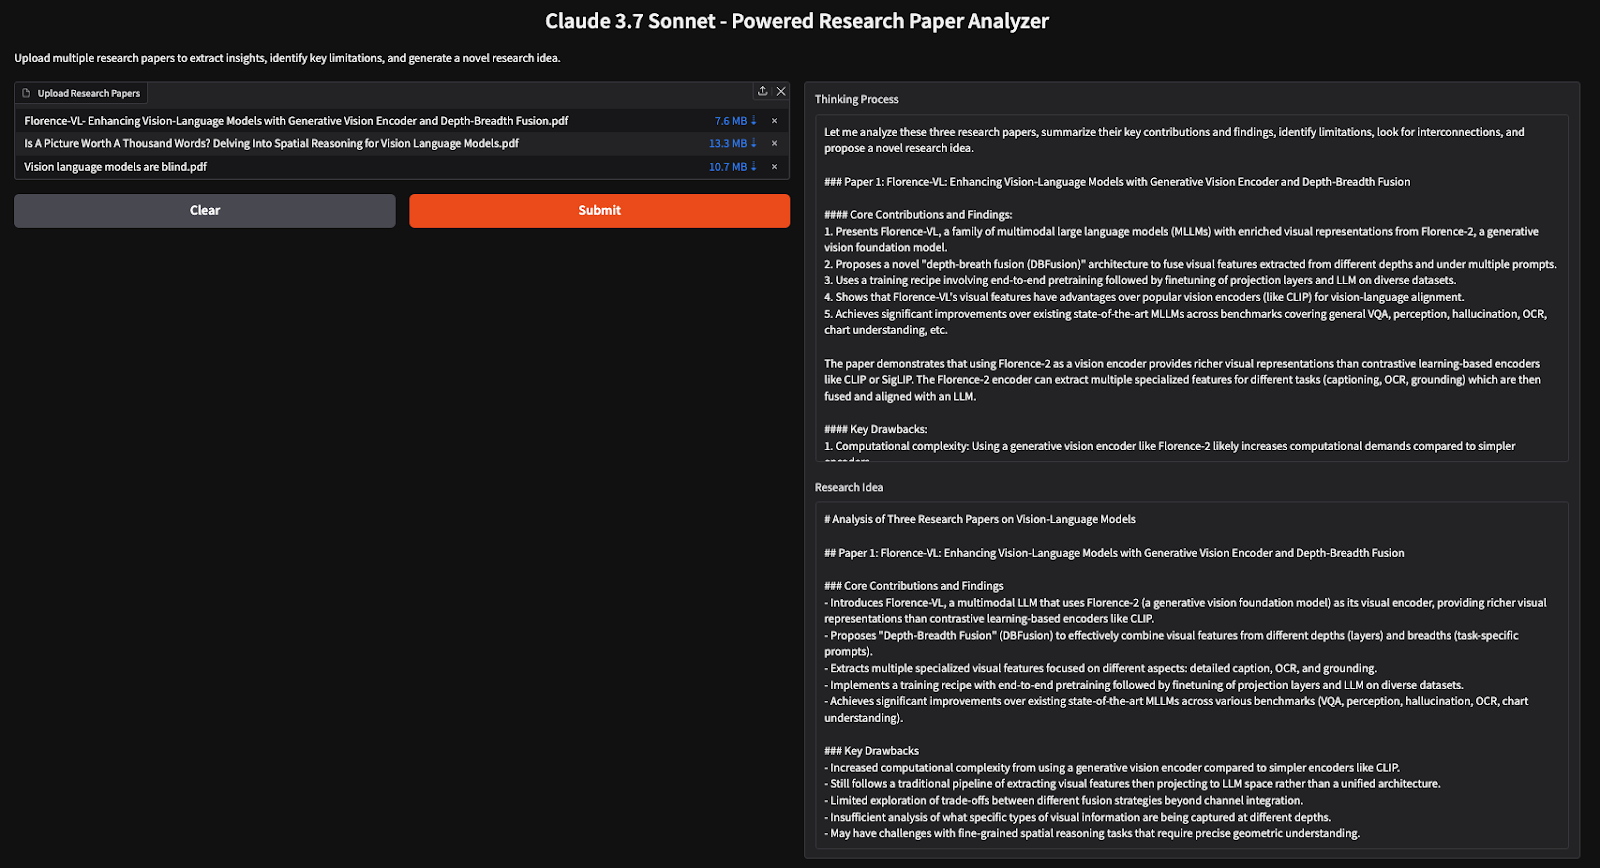
इस ट्यूटोरियल में, हमने Claude 3.7 Sonnet का उपयोग करके एक AI-संचालित Research Paper Analyzer बनाया, जो शोधकर्ताओं को कई पेपरों से कुशलतापूर्वक अंतर्दृष्टि निकालने, सीमाएँ पहचानने और नए शोध विचार उत्पन्न करने में सक्षम बनाता है। Thinking Mode का उपयोग करके, मॉडल गहन तर्क करता है, जिससे यह साहित्य समीक्षा और शोध संश्लेषण के लिए एक प्रभावी उपकरण बनता है।
इन पाठ्यक्रमों के साथ AI सीखें!
लर्निंग पाथ
कोर्स
लर्निंग पाथ
