
{count, plural, one {Program} other {Program}}
Yapay Zeka Uygulamaları Geliştirme
{hours} sa
Kullanıcıların şunları yapabilmesini sağlayan Gradio tabanlı bir Araştırma Makalesi Analizörü geliştireceğiz:
Claude 3.7 Sonnet API maliyetlerini optimize etmek için kullanımını proje ihtiyaçlarıyla hizalamamız gerekir; çünkü giriş tokenları $3/M ve Düşünme Modu dahil çıkış tokenları $15/M maliyetlidir.
Giderleri istem önbellekleme, toplu işleme ve uzun yanıtlarda akış modu kullanarak azaltmalıyız. Hatta Düşünme Modunu daha düşük bir token bütçesi (1.024 tokendan başlayarak) belirleyip yalnızca gerektiğinde artırarak optimize edebiliriz.
API maliyetini optimize etme hakkında daha fazla bilgiyi Anthropic’in resmi dokümantasyonunda bulabilirsiniz.
Başlamadan önce, aşina olmayanlar için düşünme modunun ne olduğuna kısaca değinelim. Düşünme Modu, Claude 3.7 Sonnet’te nihai yanıtı üretmeden önce adım adım akıl yürütmeyi etkinleştiren yeni bir özelliktir. Modele şunları sağlar:
Özetle, çalışma biçimi şöyledir:
Başlamadan önce Anthropic API anahtarını ayarlamamız gerekiyor:
1. Anthropic konsoluna giriş yaparak başlayın: https://console.anthropic.com/
2. Get API Keys seçeneğine tıklayın.
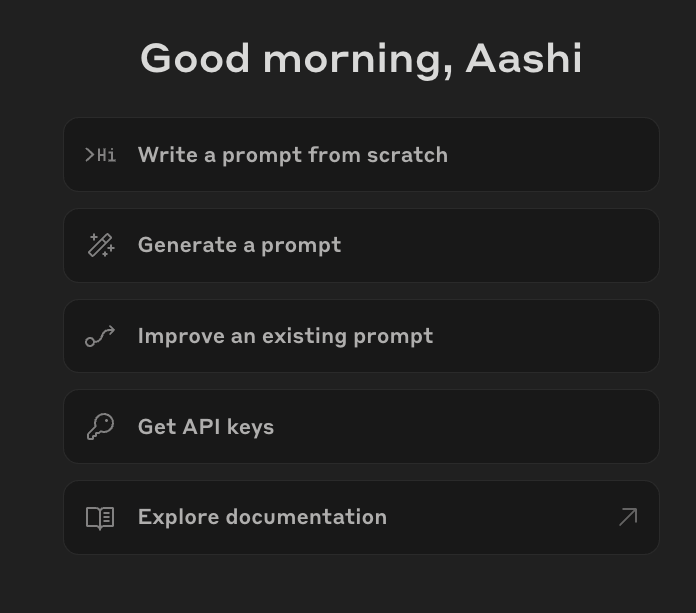
3. API Keys sekmesine yönlendirileceksiniz. Create API Key seçeneğine tıklayın ve anahtarınıza bir ad verin.
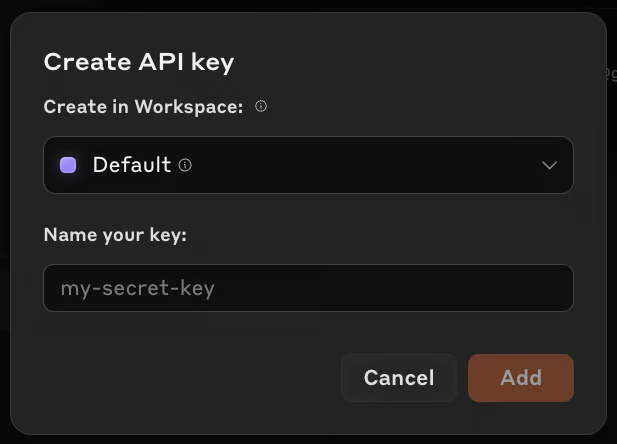
4. Bu anahtarı kopyalayıp daha sonra başvurmak üzere saklayın.
5. Şimdi Billing sekmesi altından fatura hesabınıza kredi ekleyin. Kredileri satın al’a tıklayıp hesabınıza yaklaşık 5 $ ekleyin (bu proje için yeterlidir).
Artık API Anahtarımız hazır. Şimdi gerekli bağımlılıkların kurulu olduğundan emin olalım.
pip install anthropic gradio PyPDF2Kurulum tamamlandıktan sonra gerekli kütüphaneleri içe aktarın:
import anthropic
import PyPDF2
import os
import gradio as grGerekli tüm kütüphaneleri içe aktardığımıza göre sırada Claude API'ini kurmak var.
Google Colab kullanıyorsanız, API anahtarını Secrets sekmesine kaydedip get() fonksiyonuyla erişebilirsiniz. Aksi halde, API anahtarını doğrudan kodunuza geçebilirsiniz (önerilmez).
Daha sonra Anthropic kütüphanesini kullanarak Claude istemcisini başlatır ve API anahtarını iletiriz.
# If using Google Colab Secrets
from google.colab import userdata
API_KEY = userdata.get('claude-3.7-sonnet')
client = anthropic.Anthropic(
    api_key=API_KEY,
)
Kurulum kısmını tamamladık. Sırada metin çıkarma bölümü var.
Yüklenen PDF dosyalarından metin çıkarmak için PyPDF2 kullanacağız. Claude 3.7 Sonnet girdi olarak yalnızca metin ve görselleri kabul eder. Bu nedenle, verimli işleme için metni önceden çıkarıp Düşünme Moduyla Claude 3.7 Sonnet'in yeteneklerini en üst düzeye çıkarırız.
# Function to extract text from a PDF file
def extract_text_from_pdf(pdf_path):
    """Extracts text from a given PDF file."""
    text = ""
    with open(pdf_path, "rb") as f:
        reader = PyPDF2.PdfReader(f)
        for page in reader.pages:
            text += page.extract_text() + "\n"
    return text.strip()
extract_text_from_pdf() fonksiyonu bir PDF dosyasını okur, her sayfadan PyPDF2.PdfReader() kullanarak metni çıkarır ve birleşik metni bir dize olarak döndürür.
Artık çıkarılmış metne sahip olduğumuza göre, birden çok makaleyi analiz etmek ve yapılandırılmış bir araştırma fikri üretmek için Claude 3.7 Sonnet'in düşünme ve akış modunu kullanmaya geçiyoruz.
Akış modu, büyük yanıtların aşamalı olarak iletilmesini sağlayarak bekleme sürelerini azaltır ve API zaman aşımı riskini düşürür. Düşünme modu ise, modelin nihai yanıtı oluşturmadan önce yapılandırılmış içsel düşünceler üretmesine olanak tanıyarak karmaşık akıl yürütmeyi güçlendirir ve gerekçelendirilmiş içgörüler sağlar.
# Function to analyze research papers with streaming
def analyze_papers_streaming(paper_texts, paper_count):
    """Uses Claude 3.7 Sonnet with Thinking Mode in streaming mode to analyze papers, find drawbacks, and generate a research project."""
    formatted_papers = "\n\n".join([f"### Paper {i+1}:\n{paper}" for i, paper in enumerate(paper_texts)])
    prompt = f"""
        You are an AI research assistant. You have been provided with {paper_count} research papers.
        Your task is to analyze these papers and perform the following:
        1. **Summarize each paper** with its core contributions and findings.
        2. **Identify key drawbacks** of each paper, focusing on limitations, gaps, or areas needing improvement.
        3. **Find interconnections and citations** between the papers—what ideas, methods, or datasets do they share?
        4. **Propose a novel research idea** that addresses a major limitation across these papers.
            - Suggest how techniques from different papers can be combined to solve a problem.
            - Ensure the idea is practical and feasible for further research.
            - Justify why this approach is promising.
        Below are the research papers
        {formatted_papers}
    """
    results = {"thinking": "", "research_idea": ""}
    with client.messages.stream(
        model="claude-3-7-sonnet-20250219",
        max_tokens=25000,
        thinking={
            "type": "enabled",
            "budget_tokens": 16000  # Large budget for deep reasoning
        },
        messages=[{"role": "user", "content": prompt}]
    ) as stream:
        current_block_type = None
        for event in stream:
            if event.type == "content_block_start":
                current_block_type = event.content_block.type
            elif event.type == "content_block_delta":
                if event.delta.type == "thinking_delta":
                    results["thinking"] += event.delta.thinking
                elif event.delta.type == "text_delta":
                    results["research_idea"] += event.delta.text
            elif event.type == "message_stop":
                break
    return results["thinking"], results["research_idea"]
analyze_papers_streaming() fonksiyonu şu adımları gerçekleştirir:
client.messages.stream() kullanarak isteği Claude 3.7 Sonnet'e göndeririz. Bu, budget_tokens=16000 ile düşünme modunu ve geniş yanıt uzunluğu için max_tokens=25000 değerini etkinleştirir.content_block_start olaylarını alırız. Model çıktı ürettikçe thinking_delta olayları ara akıl yürütme adımlarını, text_delta olayları ise nihai araştırma içgörülerini içerir. Süreç, yanıtın tamamlandığını bildiren message_stop olayıyla sona erer.Genişletilmiş düşünme için istem oluşturma tekniklerini iyileştirme hakkında daha fazla bilgiyi burada bulabilirsiniz.
Artık ana mantığımız hazır olduğuna göre, bunu Gradio ile entegre etmeye devam ediyoruz. Böylece kullanıcılar araştırma makaleleri yükleyip yapılandırılmış içgörüler alabilecek.
# Gradio UI function
def gradio_interface(pdfs):
    paper_texts = [extract_text_from_pdf(pdf.name) for pdf in pdfs]
    paper_count = len(paper_texts)  # Count number of provided papers
    thinking, research_idea = analyze_papers_streaming(paper_texts, paper_count)
    return thinking, research_idea

# Set up the Gradio app
demo = gr.Interface(
    fn=gradio_interface,
    inputs=gr.File(file_types=[".pdf"], label="Upload Research Papers", file_count="multiple"),
    outputs=[gr.Textbox(label="Thinking Process"), gr.Textbox(label="Research Idea")],
    title="Claude 3.7 Sonnet - Powered Research Paper Analyzer",
    description="Upload multiple research papers to extract insights, identify key limitations, and generate a novel research idea."
)
if __name__ == "__main__":
    demo.launch(debug=True)
Yukarıdaki kod, kullanıcıların birden çok PDF yükleyebileceği bir Gradio arayüzü kurar; PDF'ler metin çıkarmak üzere işlenir, temel içgörüler analiz edilir ve düşünme ve akış modu kullanılarak yeni araştırma fikirleri üretilir.
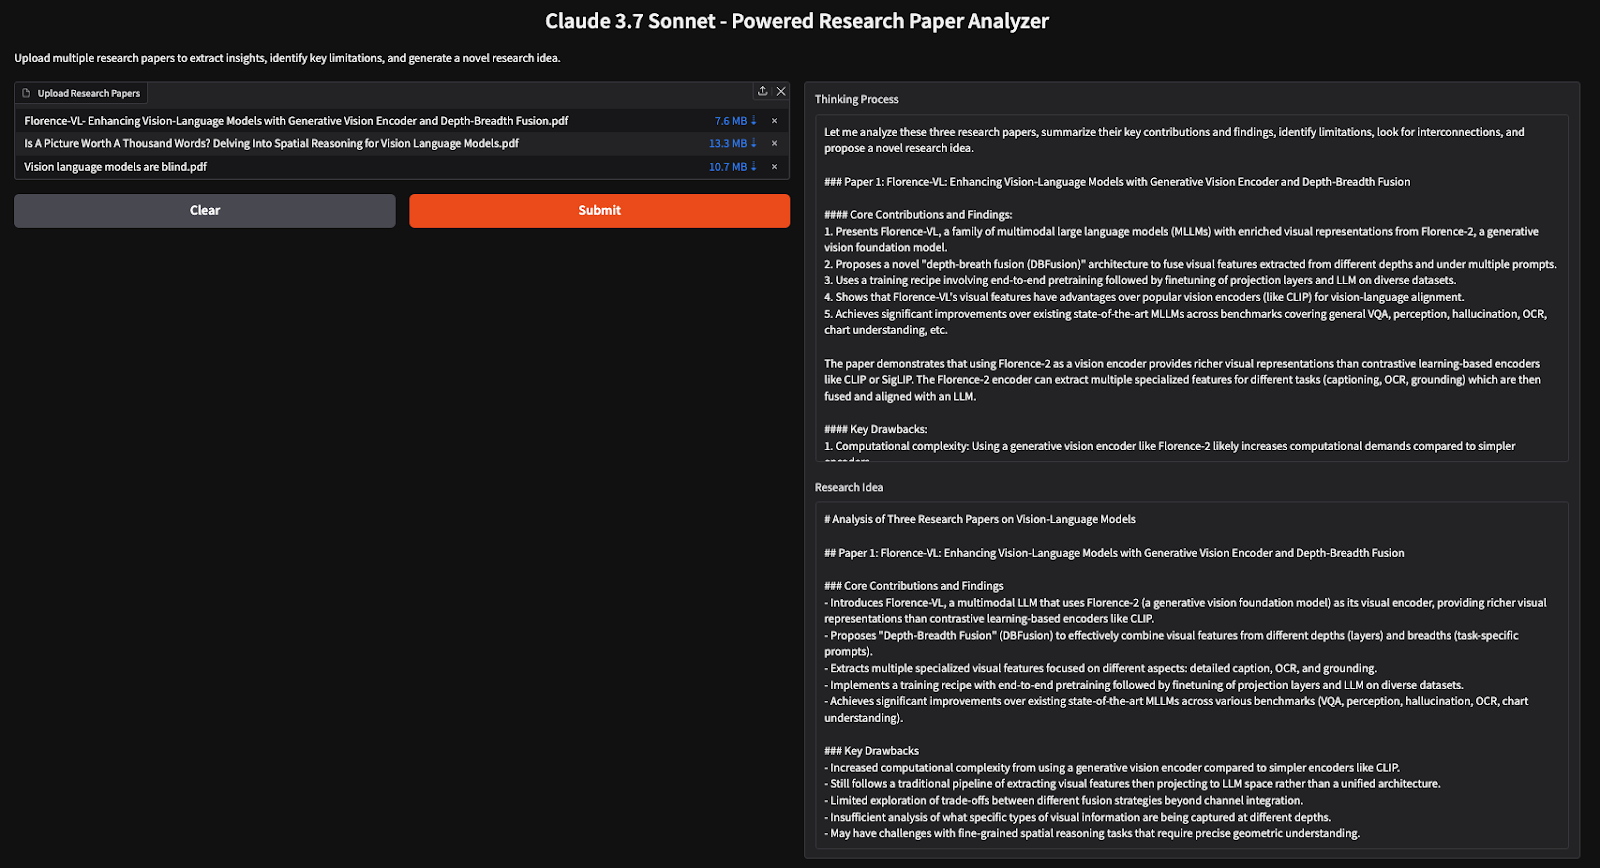
Bu öğreticide, Claude 3.7 Sonnet kullanarak araştırmacıların birden çok makaleden içgörüleri verimli biçimde çıkarmasına, sınırlamaları belirlemesine ve yeni araştırma fikirleri üretmesine olanak tanıyan yapay zeka destekli bir Araştırma Makalesi Analizörü oluşturduk. Düşünme modunu kullanarak model derin akıl yürütme yapar ve bu da onu literatür taramaları ve araştırma sentezi için etkili bir araç haline getirir.
Bu kurslarla yapay zekayı öğrenin!
{count, plural, one {Program} other {Program}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.




