
学习路径
AI 基础知识
10 小时
把代码交给模型只是容易的那一部分。难的是其余一切:决定它可以读取哪些文件、执行它请求的工具调用、知道何时应该停止,以及决定要为多少推理付费。
Claude Opus 5 把最后一个决策显式化了。effort 参数有五个档位,Anthropic 表示提高该值恰好能提升编码代理这类工作的效果。这个说法容易复述、难以验证,所以我想要一个狭义的答案:在一个真实缺陷上,测试要么通过要么失败,把 effort 调高能否得到更好的修复?
为此,我们将构建一个小型修复缺陷的代理,并在每个 effort 档位上运行同一个任务。过程中我们将涵盖:
调用 claude-opus-5 并解析以思考块开头的响应
用 effort 控制推理深度,并据此设置 max_tokens 的大小
运行能应对思考块和工具错误的多轮工具回路
返回经 Pydantic 校验的结构化报告而非散文描述
在五个 effort 档位下衡量成功率、令牌、时延和成本
在单次运行内用提示缓存降低重复输入成本
先剧透结论:在这个任务上,最便宜的档位每次都修复了缺陷,而更高档没有带来更好结果。这个结果只针对这个代码库,更有用的是产生它的整套装置。
代理会接收一个缺陷报告和对一个小型 Python 仓库的受控访问,然后着手处理:列出文件、读取相关文件、运行测试套、打补丁、重跑并报告。
Claude 从不会直接触碰文件系统。它会发出带名称和 JSON 参数的工具请求,我们的 Python 代码决定是否执行以及返回什么。这条边界就是整个安全模型——每当代理看起来“自行其是”时都值得记住这一点。
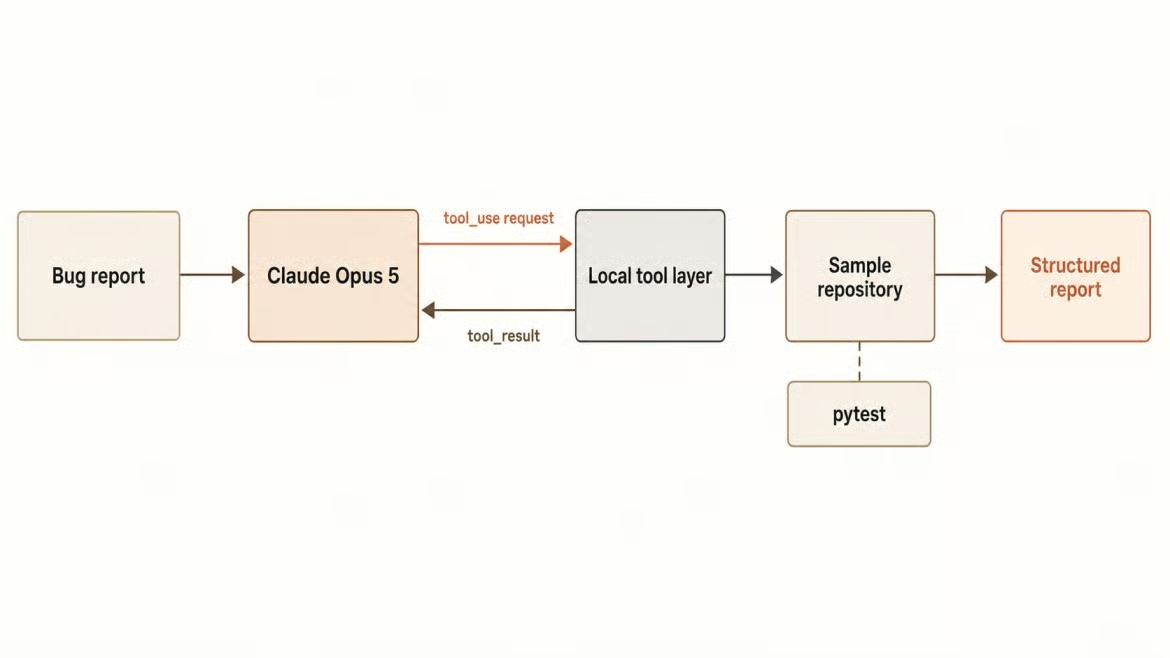
缺陷报告通过受控工具流转。作者供图。
您需要 Python 3.10 或更高版本、具有 claude-opus-5 访问权限的 API 密钥、用于重置示例仓库的 Git,以及足够的 pytest 知识来读懂失败。完整项目在 GitHub 上,若您更愿意整体阅读;下文各节会逐步构建。
git clone https://github.com/KhalidAbdelaty/claude-opus-5-api-tutorial.git
cd claude-opus-5-api-tutorial
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install -r requirements.txt
将 .env.example 复制为 .env 并填入您的密钥。构建出的任何东西,密钥都应保存在服务器侧,绝不放在请求体里,也不要出现在日志中。
# agent/config.py
MODEL = "claude-opus-5"

PRICE_INPUT = 5.00
PRICE_OUTPUT = 25.00
PRICE_CACHE_WRITE_5M = 6.25
PRICE_CACHE_READ = 0.50

MAX_TOKENS = 32_000
MAX_ITERATIONS = 10
这四个价格之后会用到。按基础输入价统一计费会把缓存写入低估四分之一、把缓存读取高估十倍——这种误差会把基准看起来“美化”。
公平的比较需要一个每次都以相同方式失败的缺陷,所以我在做代理前先写了夹具。示例仓库是一个计费服务,包含一个共享的日期工具、一个订阅模块和一个发票模块。该工具函数文档描述了一种行为,实际实现的是另一种。
# billing/timeutils.py
def days_between(start: datetime, end: datetime) -> int:
    """Return the number of days from start to end, counting a partial day as a full day.

    Billing treats any remaining fraction of a day as a whole day, so a customer
    with four hours left has one day remaining, not zero.
    """
    delta = end - start
    return delta.days
timedelta.days 是取整的,所以剩余十小时的试用会被报为零天。有两个模块调用了这个工具函数,于是一个缺陷暴露为两个看似无关的失败: test_trial_active_on_final_day 会提前把客户锁在门外,而 test_prorated_credit_counts_partial_day 则会少算一天退款。
缺陷报告只提到了第一个症状,就像客服工单会那样。还有一个陷阱:把 is_trial_active 修改为接受零,会让报告中的测试通过、却让发票测试继续失败,从而能检测到浅层修复。基线是两个失败、四个通过,提交到 Git,方便用 git checkout -- . 在不同运行之间复原。
在用任何工具前,先确认鉴权和响应解析没问题。Messages API 需要一个模型字符串、必填的 max_tokens,以及一组消息。
from anthropic import Anthropic
from dotenv import load_dotenv

load_dotenv()
client = Anthropic()

response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "A pytest assertion fails with: assert 0 == 1. What should I check first?"}],
)

print([block.type for block in response.content])
text = next((b.text for b in response.content if b.type == "text"), "")
第一个 print 就是要点。它返回 ['thinking', 'text'],因为思考默认开启且思考块先到达。
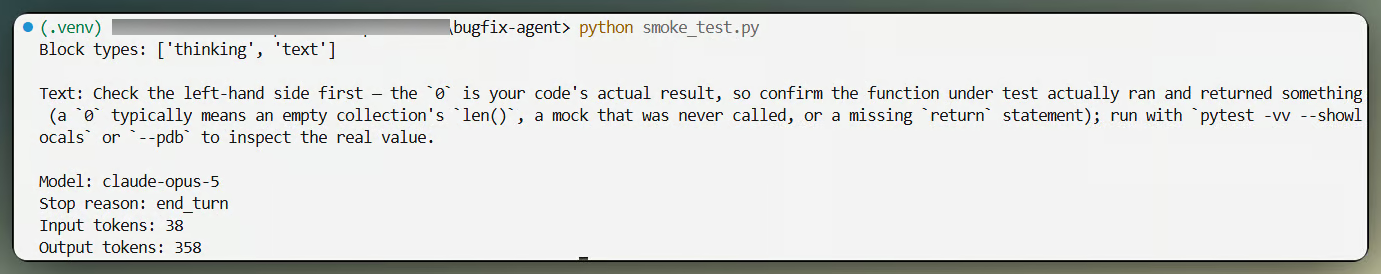
首次调用先返回思考再返回文本。作者供图。
任何直接取 response.content[0].text 的代码在 Opus 5 上都会抛 AttributeError 。请按块类型过滤。同时,移除 temperature、 top_p 和 top_k 的非默认值,因为该模型会对此返回 400。
思考与 effort 是两个常被混淆的控制项。思考 是模型在回答前是否进行推理,刚才的首次调用已经显示它在这样做。effort 则是它进行多少推理,覆盖每个输出令牌,包括工具调用。下面的小节介绍各档位、会触顶的令牌上限,以及 API 唯一会拒绝的组合。
effort 在 output_config 内设置,无需 beta 头。
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    output_config={"effort": "xhigh"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": bug_report}],
)
API 默认是 high,显式传 "high" 与省略等效。Anthropic 建议针对代理式编码从 xhigh 起步,并指出 low 与 medium 在 Opus 5 上都比早期 Opus 型号更强。他们也提醒 max 可能会把简单任务想太多,这也是我测到的最有意思的一点。
如前所述, max_tokens 同时覆盖推理和答案,所以按无思考模型调的值会让 Opus 5 半途被截断。还有个常见的限制。
client.messages.create(model="claude-opus-5", max_tokens=32000, messages=[...])
# ValueError: Streaming is required for operations that may take longer than 10 minutes.
SDK 会拒绝非流式且 max_tokens 超过 21,333 的请求。这是客户端校验而非 API 规则,解决方法是使用流式:循环调用 client.messages.stream() 并读取 get_final_message(),同样的 32,000 就能通过。我选在这个上限,是为了给更高 effort 留出空间。
您可以关闭思考,但只能在 high 或更低 effort。与 xhigh 或 max 的组合会被直接拒绝。
effort=high  accepted, blocks=['text']
effort=xhigh HTTP 400: output_config.effort 'xhigh' is not supported when thinking
             is disabled on this model. Use effort 'high' or below, or enable thinking.
高于 high effort 时禁用思考会被拒绝。作者供图。
注意成功调用的块列表:只有 ['text'],思考块消失。降低 effort 本就是更稳妥的成本控制,因此我在全程都保持思考开启。
工具让模型成为代理,也正是代理变得不再安全的地方。每个定义包含名称、描述和 JSON 输入模式,并且每次请求每个工具定义都会消耗输入令牌。我把集合控制在五个,按潜在破坏力分组如下。
list_files 和 search_code 让模型能自行找到相关文件,而无需把整个仓库贴进提示中。 read_file 按仓库相对路径拉取单个文件,安全检查也在这里实现。
def _resolve(relative_path: str) -> Path:
    """Resolve a repository-relative path, refusing anything outside the repo."""
    candidate = Path(relative_path)
    if candidate.is_absolute():
        raise ToolError("Absolute paths are not allowed.")

    resolved = (REPO_ROOT / candidate).resolve()
    if resolved != REPO_ROOT.resolve() and REPO_ROOT.resolve() not in resolved.parents:
        raise ToolError("Path escapes the repository.")
    return resolved
先解析再比较,否则 ../../.ssh/id_rsa 就能径直走出沙箱。返回的文件大小限制为 8,000 个字符,因为每个工具结果都会在后续每次请求里重发,您每次都要为此付费。
run_tests 不接收任何参数。命令在配置中固定,因此模型无法请求任意 shell 命令。
def run_tests() -> str:
    completed = subprocess.run(
        [sys.executable, "-m", "pytest", "tests", "-q", "--no-header", "--tb=short"],
        cwd=REPO_ROOT, capture_output=True, text=True, timeout=120,
    )
    output = (completed.stdout + completed.stderr).strip()
    return f"exit_code: {completed.returncode}\n{output[:3000]}"
只允许一个命令是能做到的最强白名单。如果之后需要更多命令,请把它们做成单独命名的工具,而不是作为 command 参数。
对于写操作,我采用精确字符串替换而不是 unified diff,因为 diff 会在空白字符上出错,浪费一个回合。该工具会拒绝非 Python 文件、限制补丁大小,并拒绝歧义。
occurrences = source.count(old_text)
if occurrences == 0:
    raise ToolError("old_text was not found in the file. Read the file and retry.")
if occurrences > 1:
    raise ToolError(f"old_text appears {occurrences} times. Include more context.")
这些错误会作为工具结果返回给 Claude,而不是让回路崩溃,模型会读取并用更多上下文重试。
当各部分就绪后,回路很短:带着工具定义发送任务,检查返回的块,执行被请求的内容,回传结果,如此循环,直到模型不再请求。
for iteration in range(1, max_iterations + 1):
    with client.messages.stream(
        model=MODEL,
        max_tokens=32_000,
        system=SYSTEM_PROMPT,
        tools=TOOLS,
        output_config={"effort": effort},
        output_format=RepairReport,
        cache_control={"type": "ephemeral"},
        messages=messages,
    ) as stream:
        response = stream.get_final_message()

    usage.add(response.usage)
    messages.append({"role": "assistant", "content": response.content})

    if response.stop_reason != "tool_use":
        break

    tool_results = []
    for block in response.content:
        if block.type == "tool_use":
            output, is_error = execute(block.name, dict(block.input or {}))
            tool_results.append({
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": output,
                "is_error": is_error,
            })
    messages.append({"role": "user", "content": tool_results})
其中三行是“承重”的。把 response.content 整体追加,而不是只挑您关心的块,能保留 thinking 与 redacted_thinking;若过滤掉,模型会在每个工具结果后重新开始推理。 tool_result 块必须在用户消息中排在首位,因为其前有文本会返回 400。且 is_error 告诉 Claude 有工具失败,比无声的空字符串更好。
系统提示在每次运行中都保持不变,这样对比才有意义。它要求模型先调查再编辑,找根因而不是表象,用最小可行改动修复,并把运行测试套作为任务的一部分。它没有包含“请再次检查你的工作”。Opus 5 会自我校验,Anthropic 的建议是在迁移时移除这些指令,因为它们只会增加时延和令牌而不改进补丁。
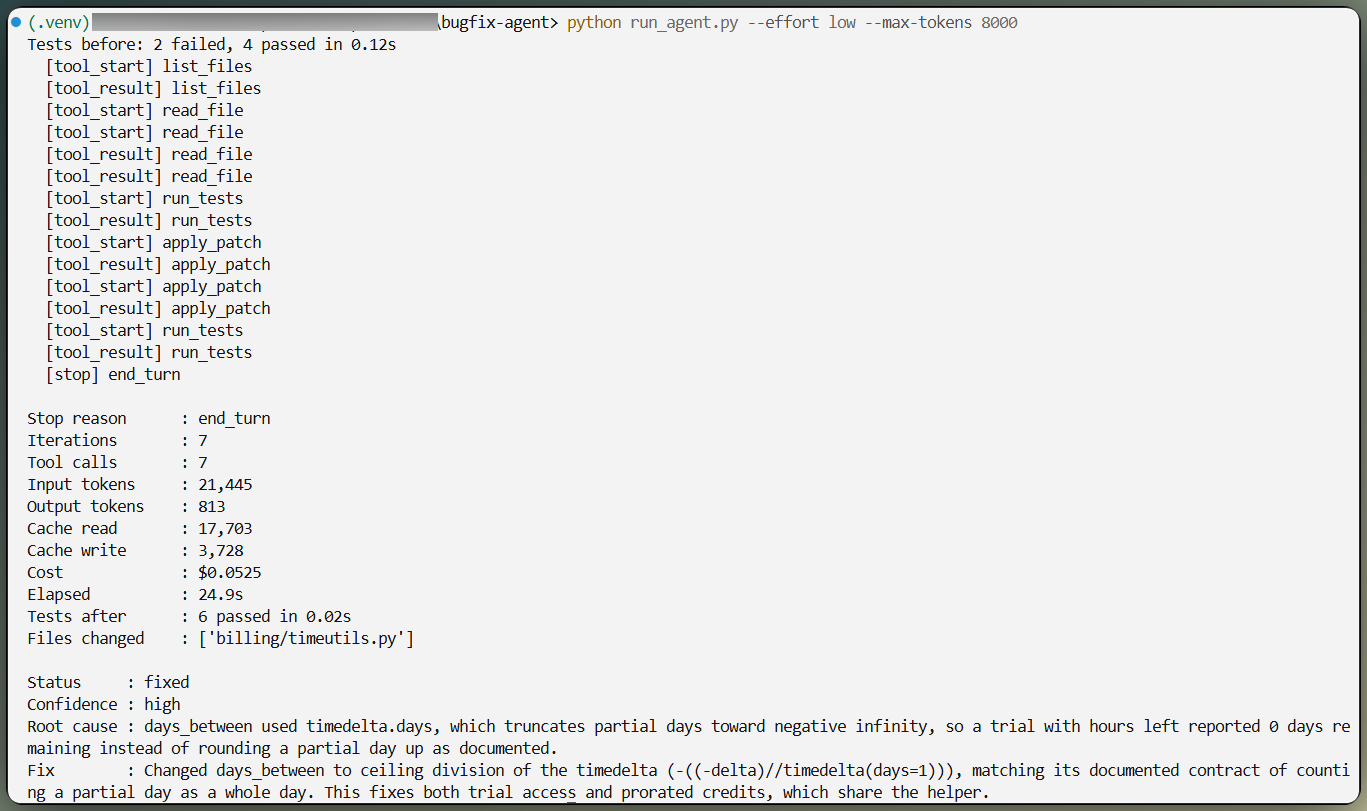
代理先检查、后打补丁、再重跑测试。作者供图。
单次运行用散文足够。要做需要横向比较的基准,我希望有强类型对象,所以回路把一个 Pydantic 模型作为 output_format 传入,SDK 会把它转为带约束解码的 JSON 模式。
class RepairReport(BaseModel):
    status: Literal["fixed", "partial", "not_fixed"]
    root_cause: str
    files_inspected: list[str]
    files_changed: list[str]
    fix_summary: str
    tests_before: str
    tests_after: str
    remaining_risks: list[str]
    confidence: Literal["low", "medium", "high"]

    @field_validator("status", "confidence", mode="before")
    @classmethod
    def _normalize_case(cls, value):
        """Enum capitalization is not guaranteed, so fold it before validating."""
return value.strip().lower() if isinstance(value, str) else value这个校验器物有所值。结构化输出 不保证枚举大小写,因此期望 "high" 的模式可能会收到 "High" ,且不会报错也不会有特殊停止原因,严格的 Literal 校验会拒绝一个本质上正确的响应。
把时延与成本排除在该模式之外。模型报告它的结论;运行器则通过重跑 pytest 和读取 git diff 来衡量实际发生了什么。后来我很庆幸有这层分离,原因从基准结果里一目了然。
这正是本教程的实验:同一个缺陷、同一提示、同一工具,分别在 low、medium、high、xhigh 和 max。输出并非确定性的,且该模型拒绝采样参数,所以每个档位重复多次是我唯一能做的控制。
每次运行都从干净的基线提交开始,然后分别在前后测量测试套。缺陷报告、系统提示、工具定义、迭代上限与 max_tokens 在各处都完全一致,只变 effort 字符串。我每个档位跑了三次。
一个预算保护器包住整个过程,在每次请求后按真实的四种费率汇总成本,并在达到上限时停止。代理回路很容易超支,自己可控的停机条件胜过事后发现账单。
以下是每个档位三次运行的平均值,测量日期为 2026 年 7 月 26 日。
|
Effort |
测试套通过 |
工具调用数 |
输出令牌 |
首次输出用时 |
总用时 |
每次运行成本 |
|
|
3/3 |
8.0 |
827 |
2.9s |
24s |
$0.0387 |
|
|
3/3 |
8.0 |
1,008 |
2.7s |
26s |
$0.0466 |
|
|
3/3 |
10.0 |
1,352 |
2.9s |
29s |
$0.0659 |
|
|
3/3 |
11.3 |
1,546 |
2.8s |
35s |
$0.0778 |
|
|
2/3 |
8.3 |
1,787 |
6.6s |
38s |
$0.0762 |
所有与仓库充分交互的档位都在共享日期工具里找到了相同的根因,并在同一文件用大约四行修复。没有一个去“上钩”修改试用检查。15 次全矩阵的成本是 $0.92。
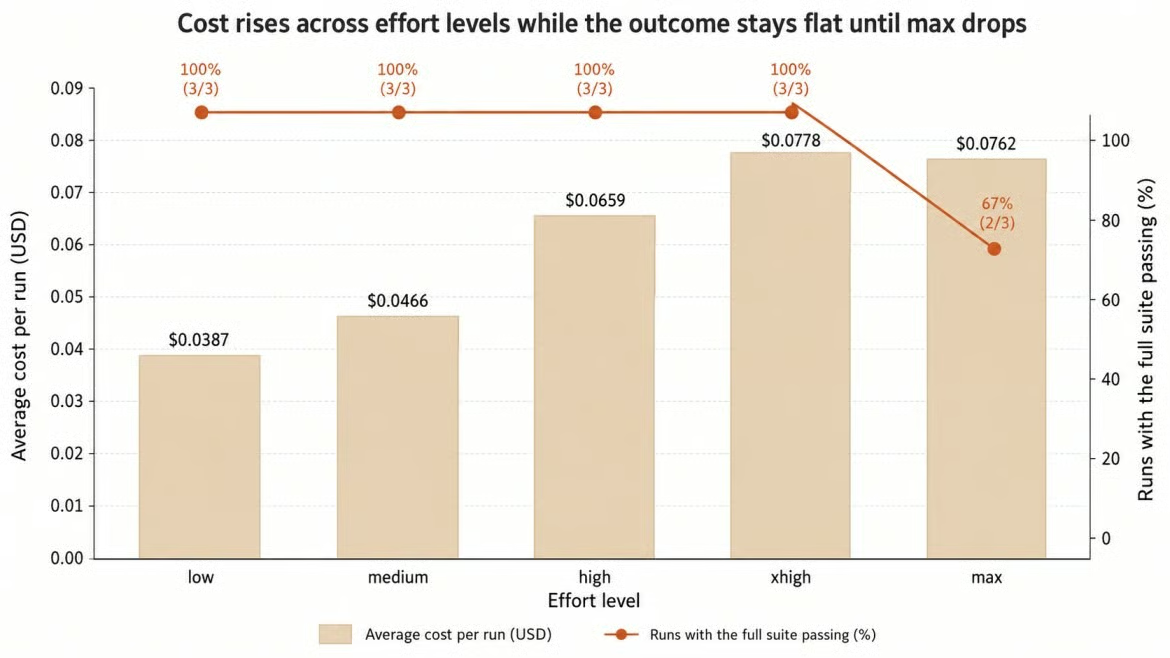
成本上升,但结果不变。作者供图。
坦率地说,这个任务不够难,无法把梯子的顶端与底端拉开差距。从 low 到 xhigh ,成本翻倍、时间多了 11 秒,但结果相同。要交付的话,我会用 low,把省下的钱花在测试覆盖率上。
关于 max 那一行需要解释。三次运行中有一次在第一回合就返回了结构上有效的报告,却一次工具也没调用,root_cause 填的是 "b0",fix_summary 为空。Pydantic 接受了它,因为形状没错。测试未被触及。若剔除这一例,另两次 max 都修复了缺陷,但平均 12.5 次工具调用、每次 $0.1112,约为 low 的三倍成本。
我认为这个失败比表格更有启发。一个模式能保证结构,保证不了实质;若应用信任 report.status,就会把一次什么都没做的运行记作“部分成功”。运行器之所以抓住了,是因为它跑了 pytest 而不是相信模型。不管您从这篇文章得到什么,请务必带走这一点。而且您的任务不是我的任务,请把这些都当作方法,而不是结果。
缓存能让回路更省,而且作用于单次运行内部,而非跨 effort 档位。更改 effort 值会使已缓存前缀失效,所以每个档位都要各自付缓存创建成本,且不会继承热缓存。在单次运行内就不同了,因为系统提示和工具定义不变,而历史在增长。
顶层的 cache_control 字段可以开启自动缓存,它会把断点设在最后一个可缓存块上,并随会话增长向前推进。
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    tools=TOOLS,
    cache_control={"type": "ephemeral"},
    messages=messages,
)
连续两回合就能清楚看到效果:
turn 1: uncached_input=2  cache_write=1231  cache_read=0     output=26
turn 2: uncached_input=2  cache_write=111   cache_read=1231  output=108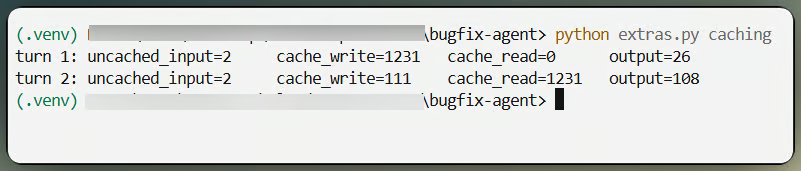
下一回合读回缓存前缀。作者供图。
稳定前缀是 1,231 个令牌,明显高于我之前列出的缓存下限。第二回合以十分之一的输入费率读回它,只把新的工具结果写入缓存。在一次完整的 xhigh 运行中,大约 36,200 个输入令牌里有约 32,600 来自缓存。缓存对输出令牌没有帮助。
这是我觉得最有用的模式:先用只读工具启动代理,待诊断出问题后再授予写入权限。若直接添加工具,需要修改位于缓存前缀最前面的 tools 数组,这会让整段会话缓存失效。
对话中途变更工具 解决了这个问题。先把所有工具都声明好,保证数组永不变化,然后用 tool_addition 和 tool_removal 块从某一时点开始提供或撤回单个工具。这些块放在 role: "system" 的消息里,且系统消息不能是 messages 的第一条。这两个限制都不在直觉范围里,我也是您想象的那样摸索出来的。
withhold_patch = {
    "role": "system",
    "content": [{"type": "tool_removal",
                 "tool": {"type": "tool_reference", "name": "apply_patch"}}],
}
messages = [{"role": "user", "content": task_prompt}, withhold_patch]
后面把 tool_removal 换成 tool_addition,工具就会回来。在我的运行中,模型用了五回合做只读调查,停下给出诊断,然后才拿到 apply_patch,第六和第七回合用它,随后测试套通过。缓存全程有效,共读回 25,557 个令牌。证据先行、写入后到,这才是该模式的真正理由。先把固定工具的回路打通,再加这个扩展。
代理式任务由多次请求组成,所以成本体现在总和里,而非最终响应。每次响应都会返回四个数字,且各自按不同费率计费。
def cost_usd(self) -> float:
    return (
        self.input_tokens * 5.00
        + self.output_tokens * 25.00
        + self.cache_creation_input_tokens * 6.25
        + self.cache_read_input_tokens * 0.50
    ) / 1_000_000
总输入是三个输入字段的总和,因为单看 input_tokens 只统计最后一个缓存断点之后的内容——这也是常见的漏算方式。输出令牌包含思考与工具调用以及可见文本,且其费率是输入的五倍,因此在上面的每次运行中都占主导。
规模化时要注意一件事:前几回合的思考块会留在上下文里,并在每个后续回合再次计费,因此长回路的成本会高于工具结果本身所暗示的。用于离线评估的 Batch API 会把两种费率都减半。Fast 模式则反过来,分别按每百万令牌 $10 与 $50 计费,目前作为限量开放的研究预览。
还有一种做法是给整段回路设上限而不是单次请求。任务预算会给模型一个建议额度和倒计时以作节奏控制,目前在 task-budgets-2026-03-13 beta 头后面,最低 20,000 令牌。我本来写了一个章节,后来删了,因为在这里我没测到差异,而无结果的事不必写三段。只要工作量未接近预算,基本都会如此。
大多数现有的 Claude 代码只要改下模型字符串就能跑。失败主要集中在几个点上,我们在构建代理时刚好都遇到了,所以把这当作清单,而非新一轮讲解。Anthropic 的迁移指南里有完整版本。
response.content[0] 现在通常是思考块,而不是文本
从选定块重组助手消息的回路会丢掉 thinking 与 redacted_thinking
max_tokens 按无思考模型调的值会被截断,且高于 21,333 就必须流式
关闭思考会在 xhigh 或 max effort 时返回 400
非默认的 temperature、 top_p 和 top_k 会被拒绝
从旧提示里带过来的“验证”指令会让 Opus 5 过度自检
Priority Tier 和网页抓取工具在 Opus 5 上不可用
effort 值值得重新摸清,而不是沿用上一个模型调出来的值
最后这一点是我最想强调的,而本文就是论证。结果证明我调好的档位恰好是整梯子里最便宜的。
上线前有两点要改变。代理生成的代码是不可信的,因此工具层应运行在隔离环境里,并设置 CPU、内存和时间限制;生成的补丁在合并前应经过人工审阅。
第二点不那么直观。Opus 5 会运行安全分类器,而一个读取安全相关代码的代理处于 "cyber" 边界附近;但拒绝是以 HTTP 200 返回、且带 stop_reason: "refusal",因此基于 5xx 比例的监控看不到它。请单独埋点拒绝,基于 stop_reason 分支而不是其下的 stop_details(它可能为 null),并在基准测试时关闭 fallbacks,以明确是哪一个模型作答。
当错误答案的代价高于请求本身时,用 Opus 5。多文件调试、根因分析、全仓库审查、长工具回路、迁移规划都适用,effort 梯子让您能把常规案例跑便宜,把难题再升级。
格式化、分类以及高量低复杂度的工作请跳过它,此时 Claude Sonnet 5 更划算。对任何您无法验证的任务也应跳过,因为本文中的价值都来自能如实回应的测试套。多花一倍钱买 Fable 5 只在我文首标出的那些工作上才值。
我真正会给的路由建议是:度量任务难度,让它来决定 effort 档位,而不是因为听起来更安全就把一切都送到梯子顶端。那并不更安全。正如基准显示的,它是在用更贵的方式拿到同样的补丁,而且有一次还给出了一份“无内容”的报告。
仓库里的 Streamlit 应用 可以让您亲自试试:选一个 effort 档位,观看推理与工具调用的实时到达,并在同一次运行中读取令牌、成本与时延。它会像基准那样重置仓库,因此表格是您的测量结果,而非我的。下面的录屏展示了流程。
与 DataCamp 一起学习
学习路径
课程
课程