Programa
Fundamentos da IA
10 h
Enviar código para um modelo é a parte fácil. O trabalho está em tudo ao redor: decidir quais arquivos ele pode ler, executar as chamadas de ferramentas que ele pedir, saber quando parar e escolher quanto raciocínio vale a pena pagar.
O Claude Opus 5 deixa essa última decisão explícita. O parâmetro effort tem cinco níveis, e a Anthropic diz que gastar mais nele compensa exatamente no tipo de trabalho que um agente de código faz. É fácil repetir essa afirmação e mais difícil validar, então busquei uma resposta direta: em um bug real, com testes que passam ou falham, aumentar o effort gera uma correção melhor?
Para descobrir, vamos construir um agente simples para corrigir bugs e rodar a mesma tarefa em todos os níveis de effort. No caminho, vamos cobrir:
Como chamar claude-opus-5 e fazer o parsing de uma resposta que começa com um bloco de pensamento
Controlar a profundidade do raciocínio com effort e dimensionar o max_tokens em torno disso
Executar um loop de ferramentas multi-turno que resiste a blocos de pensamento e erros de ferramentas
Retornar um relatório Pydantic validado em vez de texto corrido
Medir sucesso, tokens, latência e custo em todos os cinco níveis de effort
Reduzir custo de input repetido com cache de prompt dentro de uma mesma execução
Adiantando o final: nesta tarefa, a configuração mais barata corrigiu o bug em todas as execuções, e nada acima dela foi melhor. Esse resultado é específico a este repositório; o mais útil é o aparato que o produziu.
O agente recebe um bug report e acesso controlado a um repositório pequeno em Python, depois ataca o problema: lista arquivos, lê os relevantes, roda a suíte, aplica o patch, roda de novo e reporta.
O Claude nunca toca o sistema de arquivos. Ele emite uma solicitação de ferramenta com um nome e argumentos JSON, e nosso código Python decide se executa e o que devolver. Essa fronteira é todo o modelo de segurança — vale lembrar sempre que o agente parecer estar agindo sozinho.
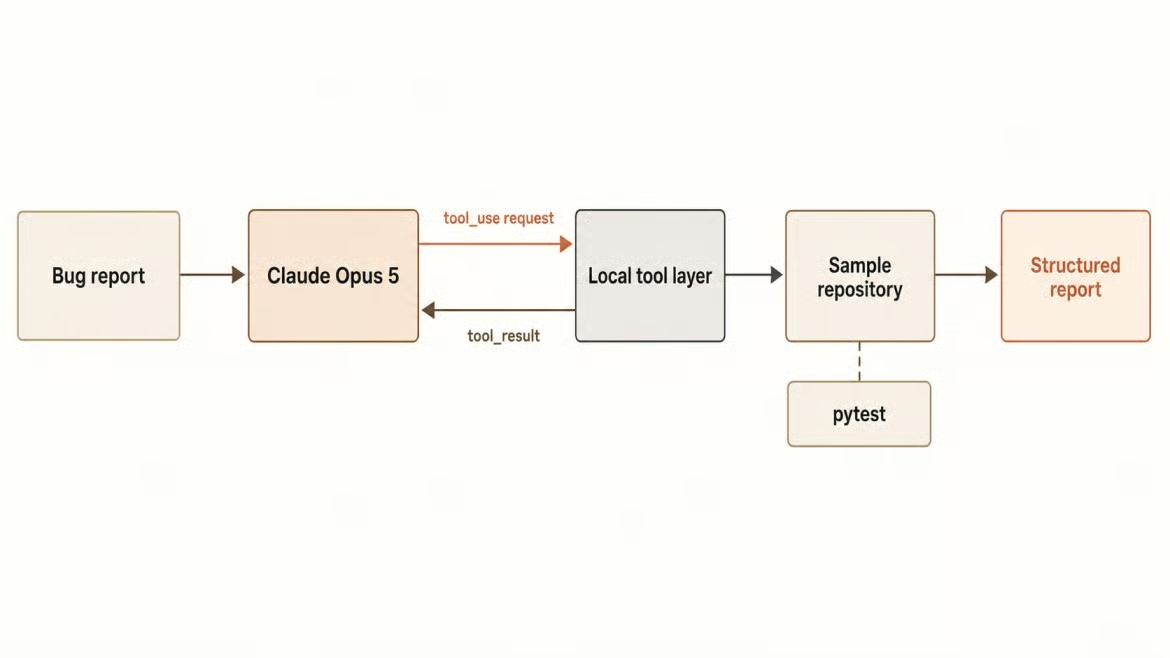
O bug report passa por ferramentas controladas. Imagem do autor.
Você vai precisar de Python 3.10 ou superior, uma chave de API com acesso a claude-opus-5, Git para resetar o repositório de exemplo e conhecimento suficiente de pytest para ler uma falha. O projeto final está no GitHub se você preferir ver tudo pronto; as seções abaixo constroem por partes.
git clone https://github.com/KhalidAbdelaty/claude-opus-5-api-tutorial.git
cd claude-opus-5-api-tutorial
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install -r requirements.txt
Copie .env.example para .env e coloque sua chave lá. A chave deve ficar no servidor de qualquer coisa que você construir a partir disso — nunca no corpo da requisição e nunca em logs.
# agent/config.py
MODEL = "claude-opus-5"

PRICE_INPUT = 5.00
PRICE_OUTPUT = 25.00
PRICE_CACHE_WRITE_5M = 6.25
PRICE_CACHE_READ = 0.50

MAX_TOKENS = 32_000
MAX_ITERATIONS = 10
Esses quatro preços importam lá na frente. Cobrar tudo pela tarifa-base de input subestima gravações em cache em um quarto e superestima leituras de cache em dez vezes — o tipo de erro que faz um benchmark parecer melhor do que foi.
Uma comparação justa precisa de um bug que falhe do mesmo jeito sempre, então montei o cenário antes do agente. O repositório de exemplo é um serviço de cobrança com um helper de datas compartilhado, um módulo de assinaturas e um de faturas. O helper documenta um comportamento e implementa outro.
# billing/timeutils.py
def days_between(start: datetime, end: datetime) -> int:
    """Return the number of days from start to end, counting a partial day as a full day.

    Billing treats any remaining fraction of a day as a whole day, so a customer
    with four hours left has one day remaining, not zero.
    """
    delta = end - start
    return delta.days
timedelta.days trunca, então dez horas de teste restante viram zero dias. Dois módulos chamam esse helper, então um defeito aparece como duas falhas sem relação: test_trial_active_on_final_day bloqueia clientes antes da hora, e test_prorated_credit_counts_partial_day encurta um reembolso em um dia.
O bug report cita só o primeiro sintoma, como faria um chamado de suporte. Há também uma armadilha: alterar is_trial_active para aceitar zero faz o teste reportado passar e deixa o teste de fatura quebrado, então uma correção rasa é detectável. O baseline são duas falhas e quatro passes, commitado no Git para git checkout -- . restaurar entre execuções.
Antes de qualquer ferramenta, confirme que autenticação e parsing da resposta funcionam. A Messages API precisa de uma string de modelo, um max_tokens obrigatório e um array de mensagens.
from anthropic import Anthropic
from dotenv import load_dotenv

load_dotenv()
client = Anthropic()

response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "A pytest assertion fails with: assert 0 == 1. What should I check first?"}],
)

print([block.type for block in response.content])
text = next((b.text for b in response.content if b.type == "text"), "")
Esse primeiro print é o objetivo do teste. Ele retorna ['thinking', 'text'], porque o pensamento vem ativado por padrão e o bloco de thinking chega primeiro.
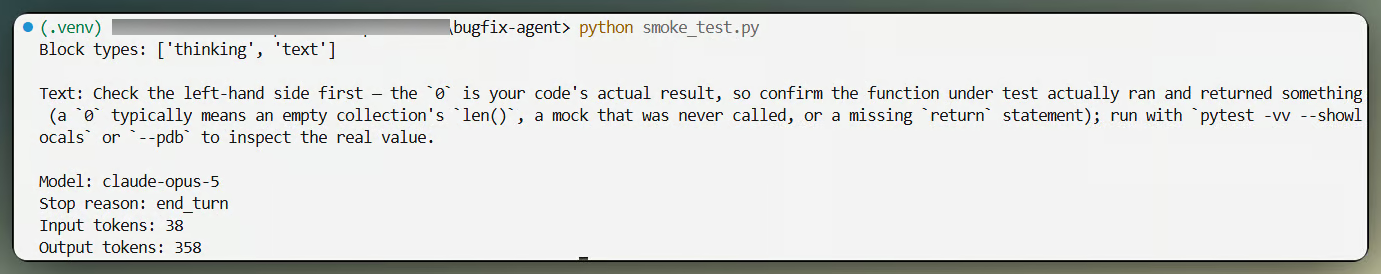
Primeira chamada retorna thinking e depois text. Imagem do autor.
Qualquer código que tente response.content[0].text vai lançar AttributeError no Opus 5. Filtre por tipo de bloco. Aproveite e remova temperature, top_p e top_k de qualquer requisição que você esteja migrando, porque valores não padrão retornam 400 neste modelo.
Thinking e effort são dois controles que costumam ser confundidos. Thinking é se o modelo raciocina antes de responder, o que a primeira chamada já mostrou. Effort é quanto ele raciocina, ao longo de todos os tokens de saída — incluindo chamadas de ferramentas. As subseções abaixo cobrem os níveis, o teto de tokens e a única combinação que a API rejeita.
Effort é definido dentro de output_config, sem precisar de header beta.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    output_config={"effort": "xhigh"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": bug_report}],
)
O padrão da API é high, e passar "high" explicitamente é o mesmo que omitir. A Anthropic sugere começar em xhigh para agentes de código e observa que low e medium estão mais fortes no Opus 5 do que em modelos Opus anteriores. Eles também alertam que max pode pensar demais em tarefas simples — que foi a parte mais interessante do que medi.
Como mencionei, max_tokens cobre o raciocínio e a resposta, então um valor ajustado para um modelo sem thinking vai truncar o Opus 5 no meio da tarefa. Há também uma restrição que pega muita gente.
client.messages.create(model="claude-opus-5", max_tokens=32000, messages=[...])
# ValueError: Streaming is required for operations that may take longer than 10 minutes.
Os SDKs recusam uma requisição sem streaming acima de 21.333 em max_tokens. É validação no client, não regra da API, então a solução é usar streaming: o loop chama client.messages.stream() e lê get_final_message(), e os mesmos 32.000 passam. Fiquei nesse valor para ter margem nos níveis de effort mais altos.
Dá para desligar o thinking, mas só em effort high ou abaixo. Combinar com xhigh ou max é rejeitado.
effort=high  accepted, blocks=['text']
effort=xhigh HTTP 400: output_config.effort 'xhigh' is not supported when thinking
             is disabled on this model. Use effort 'high' or below, or enable thinking.
Thinking desativado é rejeitado acima de high. Imagem do autor.
Note a lista de blocos na chamada aceita: ['text'] sozinho — sem thinking. Reduzir o effort já é a forma mais segura de cortar custo, então mantive o thinking ligado o tempo todo.
Ferramentas transformam um modelo em agente — e também é onde ele deixa de ser seguro. Cada definição tem nome, descrição e um schema de input em JSON, e todas custam tokens de input a cada requisição. Mantive o conjunto em cinco, agrupadas abaixo pelo potencial de dano.
list_files e search_code permitem ao modelo encontrar o arquivo relevante sem colar o repositório inteiro no prompt. read_file puxa um arquivo por caminho relativo ao repositório — e é aí que ficam as checagens de segurança.
def _resolve(relative_path: str) -> Path:
    """Resolve a repository-relative path, refusing anything outside the repo."""
    candidate = Path(relative_path)
    if candidate.is_absolute():
        raise ToolError("Absolute paths are not allowed.")

    resolved = (REPO_ROOT / candidate).resolve()
    if resolved != REPO_ROOT.resolve() and REPO_ROOT.resolve() not in resolved.parents:
        raise ToolError("Path escapes the repository.")
    return resolved
Resolva antes de comparar — ou ../../.ssh/id_rsa sai da sua sandbox. Arquivos retornados são limitados a 8.000 caracteres, porque cada resultado de ferramenta é reenviado em todas as chamadas seguintes — e você paga sempre.
run_tests não recebe argumentos. O comando fica fixo na configuração — o modelo não tem como pedir um shell arbitrário.
def run_tests() -> str:
    completed = subprocess.run(
        [sys.executable, "-m", "pytest", "tests", "-q", "--no-header", "--tb=short"],
        cwd=REPO_ROOT, capture_output=True, text=True, timeout=120,
    )
    output = (completed.stdout + completed.stderr).strip()
    return f"exit_code: {completed.returncode}\n{output[:3000]}"
Uma allowlist de um comando é a allowlist mais segura possível. Se precisar de mais comandos, adicione-os como ferramentas separadas, nunca como um argumento command.
Para escrita, usei substituição por string exata em vez de diff unificado, porque diffs falham com espaços em branco e desperdiçam um turno. A ferramenta rejeita arquivos que não sejam Python, limita o tamanho do patch e recusa ambiguidade.
occurrences = source.count(old_text)
if occurrences == 0:
    raise ToolError("old_text was not found in the file. Read the file and retry.")
if occurrences > 1:
    raise ToolError(f"old_text appears {occurrences} times. Include more context.")
Esses erros voltam para o Claude como resultados de ferramenta, em vez de derrubar o loop. O modelo lê e tenta de novo com mais contexto.
O loop fica curto quando as peças estão no lugar. Envie a tarefa com as definições de ferramentas, inspecione os blocos retornados, execute o que foi pedido, envie os resultados de volta e repita até o modelo parar de pedir.
for iteration in range(1, max_iterations + 1):
    with client.messages.stream(
        model=MODEL,
        max_tokens=32_000,
        system=SYSTEM_PROMPT,
        tools=TOOLS,
        output_config={"effort": effort},
        output_format=RepairReport,
        cache_control={"type": "ephemeral"},
        messages=messages,
    ) as stream:
        response = stream.get_final_message()

    usage.add(response.usage)
    messages.append({"role": "assistant", "content": response.content})

    if response.stop_reason != "tool_use":
        break

    tool_results = []
    for block in response.content:
        if block.type == "tool_use":
            output, is_error = execute(block.name, dict(block.input or {}))
            tool_results.append({
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": output,
                "is_error": is_error,
            })
    messages.append({"role": "user", "content": tool_results})
Três linhas aí são cruciais. Adicionar response.content inteiro, e não só os blocos que você quer, mantém thinking e redacted_thinking intactos; filtre e o modelo reinicia o raciocínio a cada resultado de ferramenta. Blocos tool_result precisam vir primeiro na mensagem do usuário — texto antes deles retorna 400. E is_error avisa ao Claude que a ferramenta falhou, melhor do que um vazio silencioso.
O system prompt fica fixo em todas as execuções para a comparação fazer sentido. Ele orienta o modelo a investigar antes de editar, achar a causa raiz em vez do sintoma, fazer a menor mudança possível e tratar rodar a suíte como parte da tarefa. O que ele não inclui é “verifique seu trabalho”. O Opus 5 já se verifica, e a orientação da Anthropic é remover essas instruções na migração, porque só aumentam latência e tokens sem melhorar o patch.
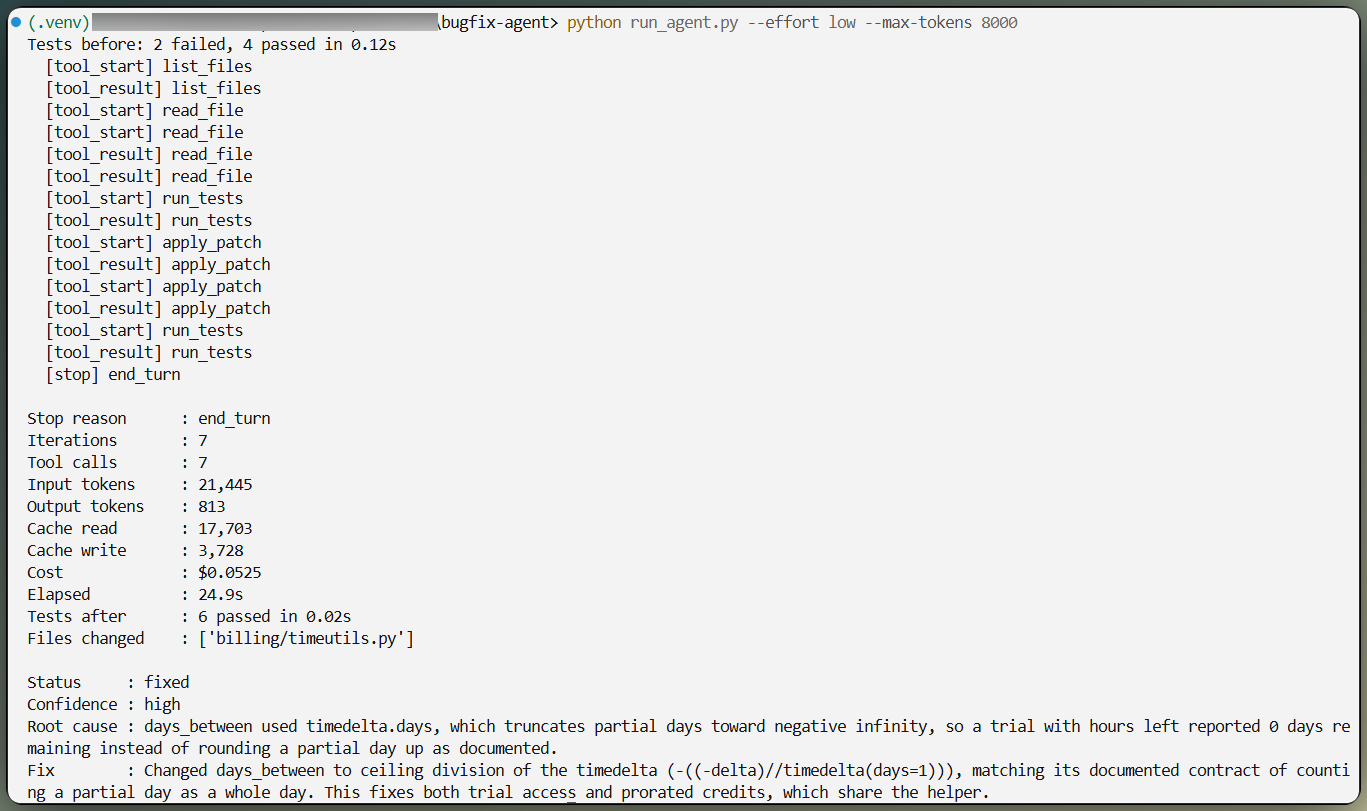
O agente inspeciona, aplica o patch e roda os testes de novo. Imagem do autor.
Texto corrido serve para uma execução. Para um benchmark que precisa comparar várias, eu quero um objeto tipado, então o loop passa um modelo Pydantic em output_format e o SDK o transforma em um schema JSON com decodificação restrita.
class RepairReport(BaseModel):
    status: Literal["fixed", "partial", "not_fixed"]
    root_cause: str
    files_inspected: list[str]
    files_changed: list[str]
    fix_summary: str
    tests_before: str
    tests_after: str
    remaining_risks: list[str]
    confidence: Literal["low", "medium", "high"]

    @field_validator("status", "confidence", mode="before")
    @classmethod
    def _normalize_case(cls, value):
        """Enum capitalization is not guaranteed, so fold it before validating."""
        return value.strip().lower() if isinstance(value, str) else value
O validador se paga. Structured outputs não garantem capitalização de enums, então um schema que espera "high" pode receber "High" sem erro nem stop reason especial, e um Literal estrito rejeitaria uma resposta basicamente correta.
Mantenha latência e custo fora desse schema. O modelo reporta o que concluiu; o runner mede o que aconteceu ao rodar pytest de novo e ler o git diff. Fiquei grato por essa separação depois — o benchmark deixa claro por quê.
Este é o experimento para o qual o tutorial existe: o mesmo bug, o mesmo prompt, as mesmas ferramentas, em low, medium, high, xhigh e max. A saída não é determinística e parâmetros de amostragem são rejeitados neste modelo, então repetir cada nível é o único controle que tenho.
Cada execução parte do commit limpo, mede a suíte antes e depois. O bug report, o system prompt, as ferramentas, o limite de iterações e o max_tokens são idênticos — só muda o effort. Rodei cada nível três vezes.
Um guardião de orçamento envolve tudo, somando o custo real nas quatro tarifas a cada requisição e parando no teto. Loops de agente são um jeito fácil de gastar demais — melhor parar sob seu controle do que descobrir depois.
Aqui estão as médias de três execuções por nível, medidas em 26 de julho de 2026.
|
Effort |
Suíte passou |
Chamadas de ferramenta |
Tokens de saída |
Tempo até a primeira saída |
Tempo total |
Custo por execução |
|
|
3/3 |
8,0 |
827 |
2,9s |
24s |
$0,0387 |
|
|
3/3 |
8,0 |
1.008 |
2,7s |
26s |
$0,0466 |
|
|
3/3 |
10,0 |
1.352 |
2,9s |
29s |
$0,0659 |
|
|
3/3 |
11,3 |
1.546 |
2,8s |
35s |
$0,0778 |
|
|
2/3 |
8,3 |
1.787 |
6,6s |
38s |
$0,0762 |
Todos os níveis que sengajaram com o repositório acharam a mesma causa raiz no helper de datas compartilhado e corrigiram com cerca de quatro linhas em um arquivo. Ninguém caiu na isca de mexer no check de teste grátis. As quinze execuções custaram $0,92.
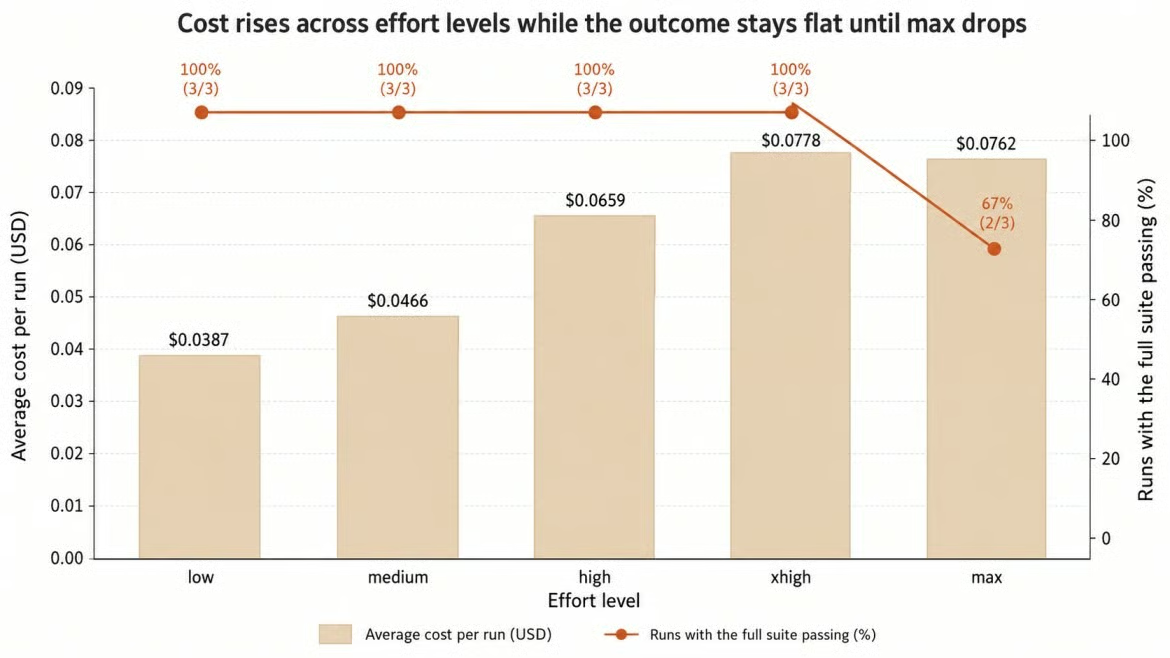
O custo sobe e o resultado não. Imagem do autor.
A leitura honesta é que a tarefa não era difícil o suficiente para separar o topo da escada da base. Ir de low a xhigh dobrou o custo e adicionou onze segundos para um resultado idêntico. Se eu fosse enviar isso para produção, rodaria low e gastaria a diferença em cobertura de testes.
A linha de max precisa de explicação. Uma de suas três execuções retornou um relatório válido pelo schema no primeiro turno sem chamar nenhuma ferramenta, com root_cause como "b0" e fix_summary vazio. O Pydantic aceitou porque o formato batia. Os testes ficaram intocados. Excluindo essa, as outras duas tentativas em max corrigiram o bug com 12,5 chamadas de ferramenta e $0,1112 cada — cerca de três vezes o custo de low.
Acho essa falha mais instrutiva que a tabela. Um schema garante estrutura, não substância, e um app que confiasse em report.status teria registrado um “sucesso parcial” em uma execução que não fez nada. O runner pegou porque rodou o pytest em vez de acreditar no modelo. Seja qual for seu aprendizado aqui, leve isso. E como sua tarefa não é a minha, trate tudo como método — não como resultado.
É no cache que o loop fica barato — e ele funciona dentro de uma execução, não entre níveis de effort. Mudar o valor de effort invalida prefixos em cache, então cada nível paga a criação do seu próprio cache — sem aquecimento herdado. Dentro de uma execução é diferente, porque o system prompt e as ferramentas não mudam enquanto o histórico cresce.
Um campo cache_control no nível superior ativa o cache automático, que posiciona um breakpoint no último bloco em cache e o move adiante conforme a conversa cresce.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    tools=TOOLS,
    cache_control={"type": "ephemeral"},
    messages=messages,
)
Duas voltas consecutivas mostram bem o efeito:
turn 1: uncached_input=2  cache_write=1231  cache_read=0     output=26
turn 2: uncached_input=2  cache_write=111   cache_read=1231  output=108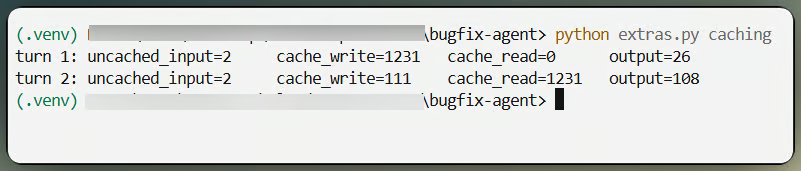
Prefixo em cache lido no turno seguinte. Imagem do autor.
O prefixo estável tem 1.231 tokens — bem acima do mínimo que citei. No turno dois ele é lido a um décimo da tarifa de input, enquanto só o novo resultado de ferramenta é gravado. Em uma execução xhigh completa, cerca de 32.600 de ~36.200 tokens de input vieram do cache. Cache não afeta tokens de saída.
Este é o padrão que achei mais útil: comece o agente com ferramentas só de leitura e conceda escrita só depois do diagnóstico. Feito ingenuamente, adicionar uma ferramenta exige editar o array tools, que fica no início do prefixo em cache — e invalida tudo.
Mudanças de ferramentas no meio da conversa resolvem. Declare todas as ferramentas desde o início para o array nunca mudar; depois use blocos tool_addition e tool_removal para oferecer ou retirar ferramentas a partir de um ponto. Os blocos vão dentro de uma mensagem role: "system", e uma mensagem de sistema não pode ser a primeira entrada em messages. Nenhuma dessas restrições está onde você esperaria — aprendi do jeito que você está imaginando.
withhold_patch = {
    "role": "system",
    "content": [{"type": "tool_removal",
                 "tool": {"type": "tool_reference", "name": "apply_patch"}}],
}
messages = [{"role": "user", "content": task_prompt}, withhold_patch]
Troque tool_removal por tool_addition depois e a ferramenta volta. Na minha execução, o modelo passou cinco turnos investigando só com leitura, parou com o diagnóstico e só então recebeu apply_patch, que usou nos turnos seis e sete antes da suíte passar. O cache se manteve, com 25.557 tokens lidos. Escrita chegou depois da evidência — que é o grande argumento para o padrão. Faça o loop fixo de ferramentas funcionar primeiro e só depois adicione isso.
Uma tarefa agentic tem muitas requisições — então o custo está na soma, não na última resposta. Quatro números voltam em toda resposta — e cada um cobra uma tarifa diferente.
def cost_usd(self) -> float:
    return (
        self.input_tokens * 5.00
        + self.output_tokens * 25.00
        + self.cache_creation_input_tokens * 6.25
        + self.cache_read_input_tokens * 0.50
    ) / 1_000_000
O input total é a soma dos três campos de input, porque input_tokens sozinho conta só o que vem depois do último breakpoint de cache — um jeito comum de subnotificar. Tokens de saída incluem thinking e chamadas de ferramenta além do texto visível — e a cinco vezes a tarifa de input, dominam cada execução acima.
Outra coisa para observar em escala: blocos de thinking de turnos anteriores ficam no contexto e são cobrados de novo em todo turno seguinte, então loops longos custam mais do que as ferramentas sugerem. Para avaliação offline, a Batch API corta as duas tarifas pela metade. O Fast mode vai no sentido oposto, a $10 e $50 por milhão de tokens, como preview de pesquisa com acesso controlado.
Também dá para limitar o loop inteiro e não só uma requisição. Task budgets dão ao modelo uma cota consultiva e uma contagem regressiva para se guiar — em beta atrás de task-budgets-2026-03-13, com piso de 20.000 tokens. Eu tinha uma seção sobre isso e cortei — não medi diferença aqui, e um não-resultado não precisa de três parágrafos. Espere o mesmo quando o trabalho nem chegar perto do orçamento.
A maior parte do código existente do Claude roda após trocar a string do modelo. As falhas se concentram em poucos pontos — passamos por todos enquanto construíamos o agente — então trate isso como checklist, não como uma nova explicação. O guia de migração da Anthropic traz a versão completa.
response.content[0] agora costuma ser um bloco de thinking, não texto
Um loop que reconstrói a mensagem do assistente a partir de blocos selecionados perde thinking e redacted_thinking
max_tokens ajustado para um modelo sem thinking vai truncar — e qualquer coisa acima de 21.333 precisa de streaming
Desligar thinking retorna 400 em effort xhigh ou max
Valores não padrão de temperature, top_p e top_k são rejeitados
Instruções de verificação trazidas de prompts antigos fazem o Opus 5 “verificar demais”
Priority Tier e a ferramenta de busca na web não estão disponíveis no Opus 5
Effort merece uma nova rodada de testes — não reutilize o valor que você ajustou no modelo anterior
Esse último é o ponto pelo qual eu mais insistiria — e este artigo é o argumento. Minha configuração ajustada acabou sendo a mais barata da escada.
Duas coisas mudam antes de ir a produção. Código gerado por agente é código não confiável — então a camada de ferramentas deve rodar isolada, com limites de CPU, memória e tempo; e um patch gerado deve passar por revisão humana antes de fazer merge.
A segunda é menos óbvia. O Opus 5 roda classificadores de segurança — e um agente lendo código próximo de segurança fica perto do limite "cyber" — mas uma recusa chega como HTTP 200 com stop_reason: "refusal", então monitoramento baseado em taxa de 5xx não vê. Instrua recusas separadamente, ramifique por stop_reason e não pelos stop_details abaixo dele (que podem ser null) e desligue fallbacks em benchmarks para saber qual modelo respondeu.
Use o Opus 5 quando uma resposta errada custa mais do que a requisição. Depuração multi-arquivo, análise de causa raiz, revisão de repositório, loops longos de ferramentas e planejamento de migração se encaixam — e a escada de effort deixa você rodar casos rotineiros barato e escalar nos difíceis.
Evite para formatação, classificação e alto volume de baixa complexidade — onde Claude Sonnet 5 é a troca mais vantajosa. Evite também para o que você não consegue validar — todo o valor aqui veio de uma suíte de testes que responde honestamente. Pagar o dobro por Fable 5 só se paga no tipo de trabalho que destaquei lá no início.
Meu conselho de roteamento de verdade: meça a dificuldade da tarefa e deixe isso escolher o nível de effort, em vez de mandar tudo para o topo da escada porque “parece mais seguro”. Não é mais seguro. Como o benchmark mostrou, foi o jeito caro de chegar ao mesmo patch — e uma vez gerou um relatório sobre nada.
O app em Streamlit no repositório permite que você rode isso: escolha um nível de effort, acompanhe ao vivo o raciocínio e as chamadas de ferramentas, e veja tokens, custo e latência na mesma execução. Ele reseta o repositório como no benchmark, então a tabela que ele gera é a sua medição — não a minha. A gravação abaixo mostra o fluxo.
Aprenda com a DataCamp
Programa
Curso
Curso
blog
DataCamp Team
5 min
Tutorial
Abid Ali Awan
Tutorial
Tutorial
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
14 min