Cursus
Principes fondamentaux de l'IA
10 h
Envoyer du code à un modèle, c’est la partie facile. Le vrai travail est tout autour : décider quels fichiers il peut lire, exécuter les appels d’outils qu’il demande, savoir quand s’arrêter, et choisir combien de raisonnement vous êtes prêt à payer.
Claude Opus 5 rend cette dernière décision explicite. Le paramètre effort propose cinq niveaux, et Anthropic affirme qu’y consacrer davantage paie précisément pour le travail qu’un agent de code réalise. Facile à répéter, plus difficile à vérifier. Je voulais donc une réponse étroite : sur un vrai bug, avec des tests qui passent ou échouent, augmenter l’effort produit‑il une meilleure correction ?
Pour le découvrir, nous allons construire un petit agent de correction et exécuter la même tâche à chaque niveau d’effort. Au passage, nous verrons :
Appeler claude-opus-5 et analyser une réponse qui commence par un bloc de réflexion
Contrôler la profondeur de raisonnement avec effort et dimensionner max_tokens en conséquence
Exécuter une boucle d’outils multi‑tours qui résiste aux blocs de réflexion et aux erreurs d’outils
Retourner un rapport Pydantic validé plutôt qu’un texte libre
Mesurer la réussite, les jetons, la latence et le coût sur les cinq niveaux d’effort
Réduire le coût d’entrée répété grâce au cache d’invite au sein d’une même exécution
Je vous donne la fin : sur cette tâche, le réglage le moins cher a corrigé le bug à chaque exécution, et rien au‑dessus n’a fait mieux. Ce résultat est propre à ce dépôt ; l’intérêt, c’est surtout l’outillage qui l’a produit.
L’agent prend un rapport de bug et un accès contrôlé à un petit dépôt Python, puis déroule la méthode : lister les fichiers, lire les bons, exécuter la suite, patcher, relancer, et rendre compte.
Claude ne touche jamais au système de fichiers. Il émet une requête d’outil avec un nom et des arguments JSON, et notre code Python décide de l’exécuter ou non et de quoi renvoyer. Cette frontière est tout le modèle de sécurité ; gardez‑la en tête quand l’agent semble agir « tout seul ».
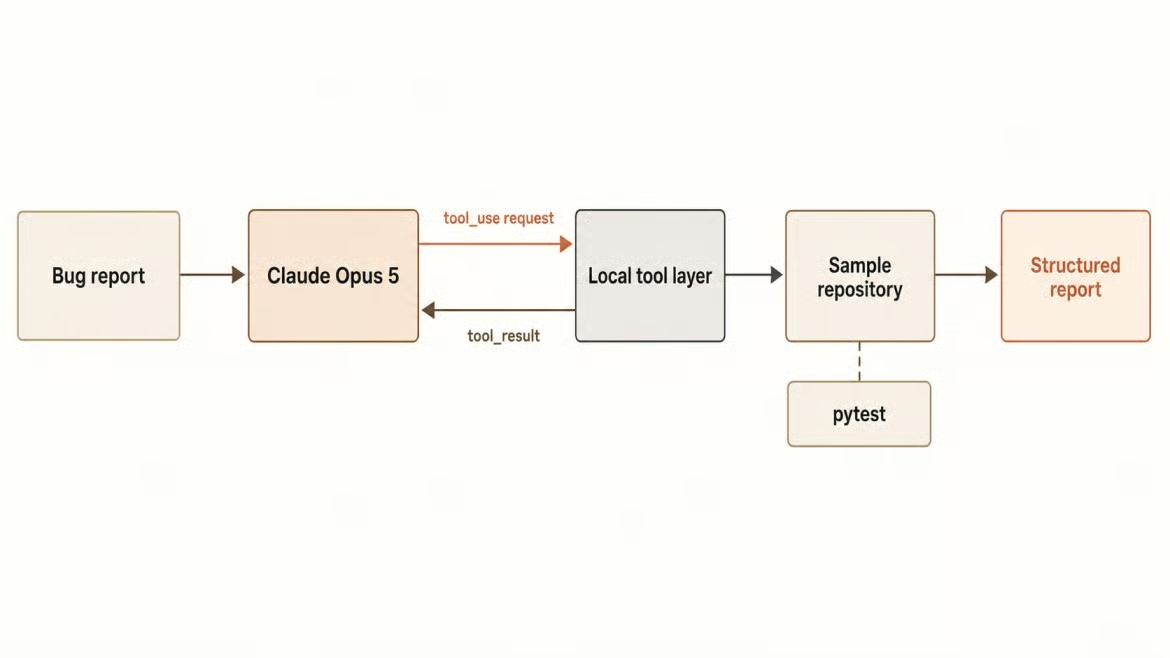
Le rapport transite via des outils contrôlés. Image de l’auteur.
Il vous faut Python 3.10 ou plus, une clé API avec accès à claude-opus-5, Git pour réinitialiser le dépôt d’exemple, et suffisamment de pytest pour lire un échec. Le projet finalisé est sur GitHub si vous préférez tout lire d’un bloc ; les sections ci‑dessous le construisent pas à pas.
git clone https://github.com/KhalidAbdelaty/claude-opus-5-api-tutorial.git
cd claude-opus-5-api-tutorial
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install -r requirements.txt
Copiez .env.example vers .env et ajoutez votre clé. Cette clé doit rester côté serveur pour tout ce que vous bâtissez à partir d’ici : jamais dans un corps de requête, jamais dans des logs.
# agent/config.py
MODEL = "claude-opus-5"

PRICE_INPUT = 5.00
PRICE_OUTPUT = 25.00
PRICE_CACHE_WRITE_5M = 6.25
PRICE_CACHE_READ = 0.50

MAX_TOKENS = 32_000
MAX_ITERATIONS = 10
Ces quatre tarifs compteront plus loin. Facturer tout au tarif d’entrée de base sous‑estime de 25 % les écritures de cache et surestime par dix les lectures de cache — de quoi rendre un benchmark plus flatteur qu’il ne l’a été.
Pour une comparaison équitable, il faut un bug qui échoue toujours de la même façon, donc j’ai écrit le jeu d’essai avant l’agent. Le dépôt d’exemple est un service de facturation avec un utilitaire de dates partagé, un module d’abonnements et un module de factures. L’utilitaire documente un comportement et en implémente un autre.
# billing/timeutils.py
def days_between(start: datetime, end: datetime) -> int:
    """Return the number of days from start to end, counting a partial day as a full day.

    Billing treats any remaining fraction of a day as a whole day, so a customer
    with four hours left has one day remaining, not zero.
    """
    delta = end - start
    return delta.days
timedelta.days tronque, donc dix heures d’essai restantes se retrouvent à zéro jour. Deux modules appellent cet utilitaire : un défaut unique se manifeste par deux échecs distincts : test_trial_active_on_final_day bloque trop tôt l’accès client, et test_prorated_credit_counts_partial_day rognait un remboursement d’un jour.
Le rapport de bug ne mentionne que le premier symptôme, comme un ticket support. Il y a aussi un piège : patcher is_trial_active pour accepter zéro fait passer le test signalé et laisse celui des factures en échec ; une correction superficielle est donc détectable. La ligne de base est de deux échecs et quatre succès, committée dans Git pour que git checkout -- . la restaure entre deux exécutions.
Avant tout outil, vérifiez l’authentification et l’analyse de réponse. L’API Messages requiert une chaîne de modèle, un max_tokens obligatoire, et un tableau de messages.
from anthropic import Anthropic
from dotenv import load_dotenv

load_dotenv()
client = Anthropic()

response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "A pytest assertion fails with: assert 0 == 1. What should I check first?"}],
)

print([block.type for block in response.content])
text = next((b.text for b in response.content if b.type == "text"), "")
Ce premier print est l’objectif de l’exercice. Il renvoie ['thinking', 'text'], car la réflexion est activée par défaut et le bloc de réflexion arrive en premier.
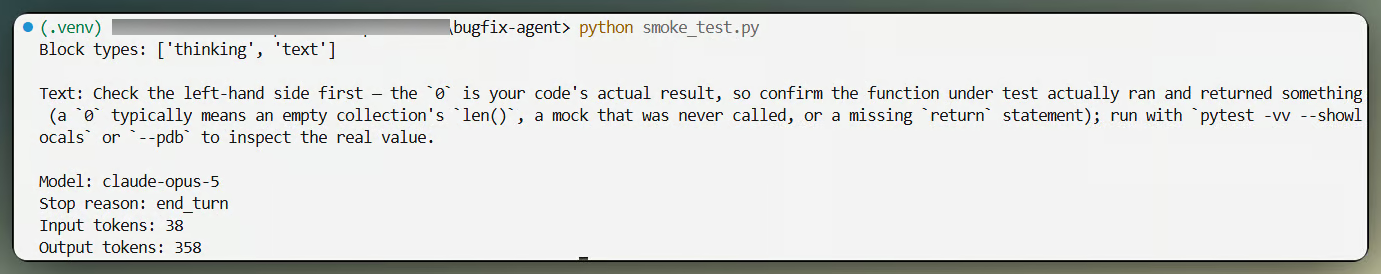
Premier appel : réflexion puis texte. Image de l’auteur.
Tout code qui tente response.content[0].text lèvera un AttributeError sur Opus 5. Filtrez par type de bloc à la place. Profitez‑en pour supprimer temperature, top_p et top_k de toute requête migrée : des valeurs non par défaut renvoient un 400 sur ce modèle.
La réflexion et l’effort sont deux leviers souvent confondus. Thinking détermine si le modèle raisonne avant de répondre, ce que le premier appel a montré. Effort détermine combien il raisonne, sur chaque jeton de sortie, appels d’outils compris. Les sous‑sections ci‑dessous détaillent l’échelle, le plafond de jetons, et la seule combinaison que l’API refuse.
Effort se règle dans output_config, sans en‑tête bêta.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    output_config={"effort": "xhigh"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": bug_report}],
)
La valeur par défaut de l’API est high ; passer "high" explicitement équivaut à l’omettre. Anthropic suggère de partir de xhigh pour le codage agentique, et précise que low et medium sont plus performants sur Opus 5 que sur les modèles Opus précédents. Ils avertissent aussi que max peut « sur‑réfléchir » des tâches simples — c’est devenu l’observation la plus intéressante de ma mesure.
Comme indiqué plus haut, max_tokens couvre le raisonnement comme la réponse, donc une valeur réglée pour un modèle sans réflexion coupera Opus 5 en plein milieu. Il y a aussi une contrainte piégeuse.
client.messages.create(model="claude-opus-5", max_tokens=32000, messages=[...])
# ValueError: Streaming is required for operations that may take longer than 10 minutes.
Les SDK refusent une requête non‑streamée au‑dessus de 21 333 max_tokens. C’est une validation côté client, pas une règle d’API ; la solution est donc de streamer : la boucle appelle client.messages.stream() puis lit get_final_message(), et les mêmes 32 000 passent. Je me suis arrêté là pour laisser de la marge aux niveaux d’effort supérieurs.
Vous pouvez désactiver la réflexion, mais seulement à high ou moins. La combiner avec xhigh ou max est directement rejeté.
effort=high  accepted, blocks=['text']
effort=xhigh HTTP 400: output_config.effort 'xhigh' is not supported when thinking
             is disabled on this model. Use effort 'high' or below, or enable thinking.
Réflexion désactivée refusée au‑delà de high. Image de l’auteur.
Notez la liste des blocs sur l’appel accepté : ['text'] uniquement, le bloc de réflexion disparaît. Réduire l’effort reste de toute façon le levier de coût le plus sûr ; j’ai donc laissé la réflexion activée partout.
Les outils transforment un modèle en agent, et c’est aussi là que l’agent peut cesser d’être sûr. Chaque définition contient un nom, une description et un schéma d’entrée JSON, et chacune coûte des jetons d’entrée à chaque requête. J’ai limité l’ensemble à cinq, regroupés ci‑dessous selon leur capacité de nuisance.
list_files et search_code permettent au modèle d’identifier le bon fichier sans coller tout le dépôt dans l’invite. read_file lit un fichier par chemin relatif au dépôt ; c’est là que vivent les contrôles de sécurité.
def _resolve(relative_path: str) -> Path:
    """Resolve a repository-relative path, refusing anything outside the repo."""
    candidate = Path(relative_path)
    if candidate.is_absolute():
        raise ToolError("Absolute paths are not allowed.")

    resolved = (REPO_ROOT / candidate).resolve()
    if resolved != REPO_ROOT.resolve() and REPO_ROOT.resolve() not in resolved.parents:
        raise ToolError("Path escapes the repository.")
    return resolved
Résolvez avant de comparer, sinon ../../.ssh/id_rsa sortira de votre bac à sable. Les fichiers renvoyés sont plafonnés à 8 000 caractères, car chaque résultat d’outil est renvoyé à chaque requête suivante — et vous le payez à chaque fois.
run_tests ne prend aucun argument. La commande est fixée en configuration, donc le modèle ne peut pas demander une commande shell arbitraire.
def run_tests() -> str:
    completed = subprocess.run(
        [sys.executable, "-m", "pytest", "tests", "-q", "--no-header", "--tb=short"],
        cwd=REPO_ROOT, capture_output=True, text=True, timeout=120,
    )
    output = (completed.stdout + completed.stderr).strip()
    return f"exit_code: {completed.returncode}\n{output[:3000]}"
Une allowlist de un est la plus stricte possible. Si vous ajoutez d’autres commandes, créez‑les en tant qu’outils nommés distincts, pas comme un argument command.
Pour l’écriture, j’ai choisi le remplacement de chaîne exacte plutôt qu’un diff unifié, car les diffs échouent souvent sur des espaces et gaspillent un tour. L’outil rejette les fichiers non‑Python, limite la taille du patch et refuse toute ambiguïté.
occurrences = source.count(old_text)
if occurrences == 0:
    raise ToolError("old_text was not found in the file. Read the file and retry.")
if occurrences > 1:
    raise ToolError(f"old_text appears {occurrences} times. Include more context.")
Ces erreurs sont renvoyées à Claude comme résultats d’outil, sans faire crasher la boucle ; le modèle les lit et réessaie avec plus de contexte.
La boucle est courte une fois les pièces en place. Envoyez la tâche avec les définitions d’outils, inspectez les blocs renvoyés, exécutez ce qui est demandé, renvoyez les résultats, et répétez jusqu’à ce que le modèle cesse de demander.
for iteration in range(1, max_iterations + 1):
    with client.messages.stream(
        model=MODEL,
        max_tokens=32_000,
        system=SYSTEM_PROMPT,
        tools=TOOLS,
        output_config={"effort": effort},
        output_format=RepairReport,
        cache_control={"type": "ephemeral"},
        messages=messages,
    ) as stream:
        response = stream.get_final_message()

    usage.add(response.usage)
    messages.append({"role": "assistant", "content": response.content})

    if response.stop_reason != "tool_use":
        break

    tool_results = []
    for block in response.content:
        if block.type == "tool_use":
            output, is_error = execute(block.name, dict(block.input or {}))
            tool_results.append({
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": output,
                "is_error": is_error,
            })
    messages.append({"role": "user", "content": tool_results})
Trois lignes sont cruciales. Ajouter response.content en entier, plutôt que seulement les blocs utiles, conserve thinking et redacted_thinking ; si vous les filtrez, le modèle recommence à raisonner après chaque résultat d’outil. Les blocs tool_result doivent apparaître en premier dans le message utilisateur, sinon un 400 est renvoyé. Et is_error indique à Claude qu’un outil a échoué, bien mieux qu’une chaîne vide silencieuse.
L’invite système reste fixe à chaque exécution pour que la comparaison ait du sens. Elle demande d’enquêter avant d’éditer, de trouver la cause racine plutôt que le symptôme, de faire le changement minimal efficace, et de considérer l’exécution de la suite comme faisant partie de la tâche. Ce qu’elle n’ordonne pas, c’est « vérifiez‑vous ». Opus 5 se vérifie lui‑même ; Anthropic recommande de retirer ces consignes en migration, car elles ajoutent latence et jetons sans améliorer le patch.
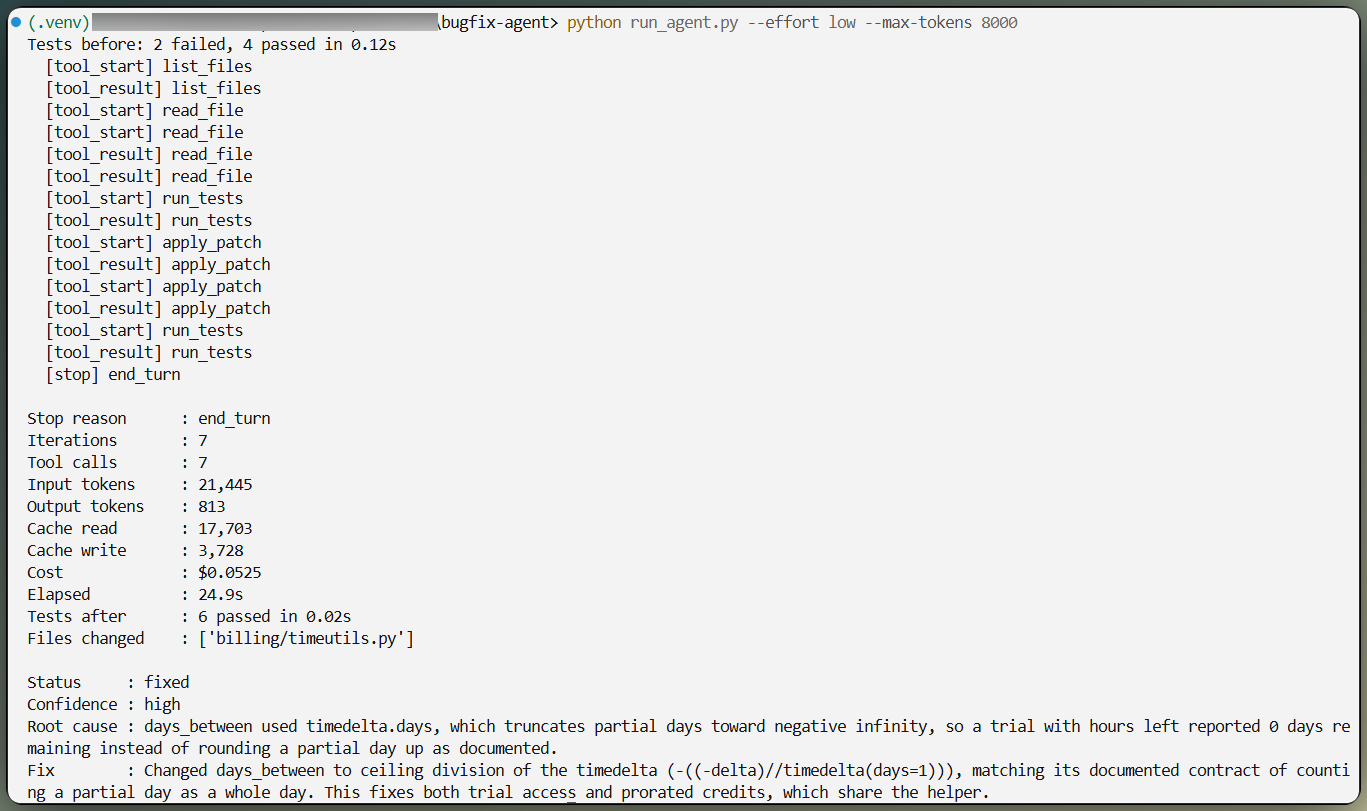
Inspection, patch, puis relance des tests. Image de l’auteur.
Un texte libre suffit pour une exécution. Pour un benchmark à comparer, je veux un objet typé, donc la boucle passe un modèle Pydantic en output_format, et le SDK le convertit en schéma JSON avec décodage contraint.
class RepairReport(BaseModel):
    status: Literal["fixed", "partial", "not_fixed"]
    root_cause: str
    files_inspected: list[str]
    files_changed: list[str]
    fix_summary: str
    tests_before: str
    tests_after: str
    remaining_risks: list[str]
    confidence: Literal["low", "medium", "high"]

    @field_validator("status", "confidence", mode="before")
    @classmethod
    def _normalize_case(cls, value):
        """Enum capitalization is not guaranteed, so fold it before validating."""
        return value.strip().lower() if isinstance(value, str) else value
Le validateur mérite sa place. Les sorties structurées ne garantissent pas la casse des énumérations ; un schéma qui attend "high" peut recevoir "High" sans erreur ni stop reason particulier, et une validation stricte via Literal rejèterait une réponse pourtant correcte dans l’ensemble.
Tenez la latence et le coût hors de ce schéma. Le modèle rapporte ce qu’il conclut ; le runner mesure ce qui s’est passé en relançant pytest et en lisant git diff. J’ai apprécié cette séparation ensuite, pour des raisons mises en évidence par le benchmark.
Voici l’expérience au cœur du tutoriel : le même bug, la même invite, les mêmes outils, à low, medium, high, xhigh et max. La sortie n’est pas déterministe, et les paramètres d’échantillonnage sont refusés sur ce modèle : répéter chaque niveau est donc mon seul levier de contrôle.
Chaque exécution repart de ce commit de référence propre, puis mesure la suite avant et après. Le rapport de bug, l’invite système, les définitions d’outils, le plafond d’itérations et max_tokens sont identiques partout ; seule la chaîne d’effort change. J’ai lancé chaque niveau trois fois.
Un garde‑fou budgétaire enveloppe l’ensemble, en additionnant le coût réel à quatre taux après chaque requête et en s’arrêtant à un plafond. Les boucles d’agent font vite grimper la facture ; mieux vaut une condition d’arrêt que vous maîtrisez qu’un montant découvert après coup.
Voici les moyennes sur trois exécutions par niveau, mesurées le 26 juillet 2026.
|
Effort |
Suite réussie |
Appels d’outils |
Jetons de sortie |
Temps jusqu’à la 1re sortie |
Temps total |
Coût par run |
|
|
3/3 |
8.0 |
827 |
2,9 s |
24 s |
$0.0387 |
|
|
3/3 |
8.0 |
1 008 |
2,7 s |
26 s |
$0.0466 |
|
|
3/3 |
10.0 |
1 352 |
2,9 s |
29 s |
$0.0659 |
|
|
3/3 |
11.3 |
1 546 |
2,8 s |
35 s |
$0.0778 |
|
|
2/3 |
8.3 |
1 787 |
6,6 s |
38 s |
$0.0762 |
À chaque niveau qui s’est engagé avec le dépôt, la même cause racine a été trouvée dans l’utilitaire de date partagé et corrigée en environ quatre lignes dans un fichier. Aucun n’a mordu à l’hameçon en patchant le contrôle d’essai. L’ensemble des quinze exécutions a coûté 0,92 $.
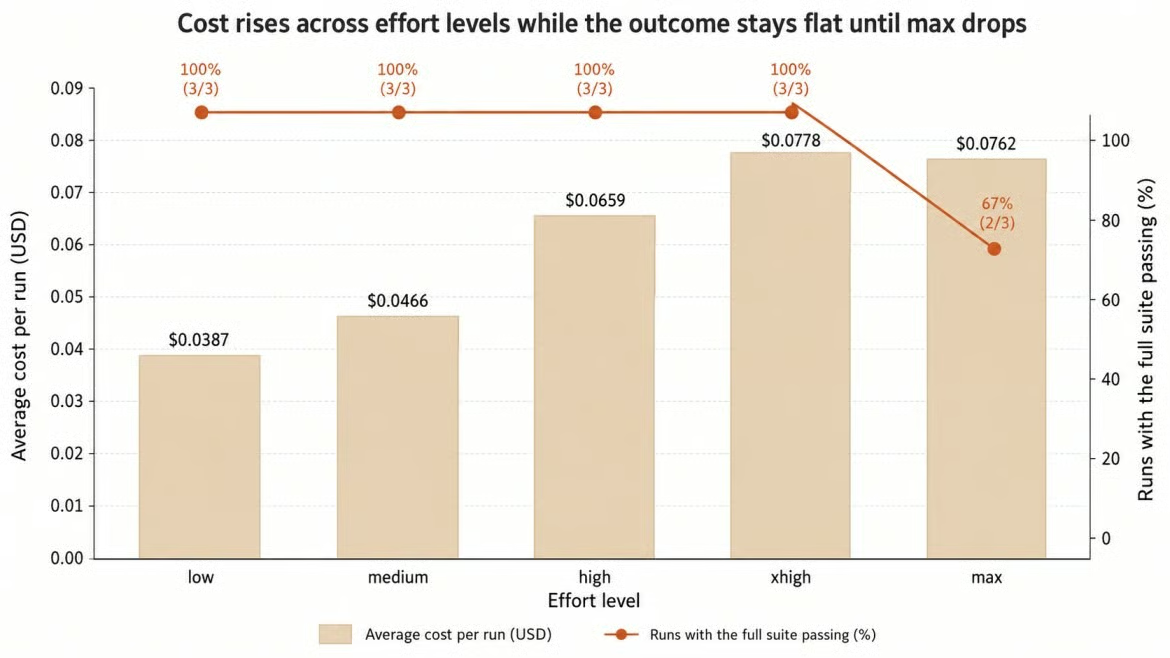
Le coût grimpe, pas le résultat. Image de l’auteur.
L’analyse honnête : cette tâche n’était pas assez difficile pour départager le haut et le bas de l’échelle. Passer de low à xhigh a doublé le coût et ajouté onze secondes pour un résultat identique. En production, je choisirais low et j’investirais l’écart dans la couverture de tests.
La ligne max demande une explication. L’une des trois exécutions a renvoyé un rapport conforme au schéma dès le premier tour sans appeler le moindre outil, avec root_cause réglé à "b0" et un fix_summary vide. Pydantic l’a accepté car la forme était correcte. Les tests n’avaient pas bougé. En l’excluant, les deux autres tentatives max ont corrigé le bug avec 12,5 appels d’outils et 0,1112 $ chacun — environ trois fois le coût de low.
Cet échec est plus instructif que le tableau. Un schéma garantit la structure, pas la substance ; une application qui ferait confiance à report.status aurait journalisé un « succès partiel » pour une exécution qui n’a rien fait. Le runner l’a intercepté car il a relancé pytest au lieu de croire le modèle. S’il y a une seule chose à retenir, c’est celle‑ci. Et puisque votre tâche n’est pas la mienne, considérez tout ceci comme une méthode, pas un verdict.
Le cache est là où la boucle devient économique, et il fonctionne au sein d’une exécution (pas entre niveaux d’effort). Changer la valeur d’effort invalide les préfixes mis en cache ; chaque niveau paye donc sa création de cache, sans réutilisation d’un cache « chaud ». À l’intérieur d’un run, c’est différent : l’invite système et les définitions d’outils restent stables tandis que l’historique grandit.
Un champ cache_control de haut niveau active la mise en cache automatique, qui place un point d’arrêt au dernier bloc éligible et le décale au fil de la conversation.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    tools=TOOLS,
    cache_control={"type": "ephemeral"},
    messages=messages,
)
Deux tours consécutifs montrent bien l’effet :
turn 1: uncached_input=2  cache_write=1231  cache_read=0     output=26
turn 2: uncached_input=2  cache_write=111   cache_read=1231  output=108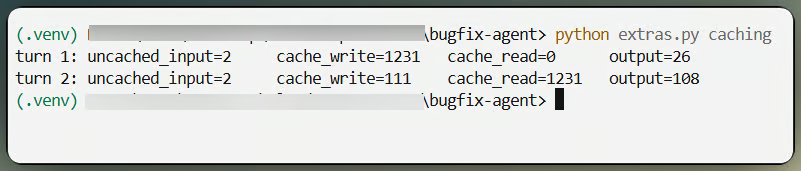
Le préfixe mis en cache est relu au tour suivant. Image de l’auteur.
Le préfixe stable fait 1 231 jetons, au‑dessus du minimum de cache mentionné. Au tour 2, il est relu à un dixième du tarif d’entrée tandis que seul le nouveau résultat d’outil est écrit. Sur un run complet en xhigh, environ 32 600 des ~36 200 jetons d’entrée sont venus du cache. Le cache ne s’applique pas aux jetons de sortie.
Voici le schéma le plus utile que j’ai trouvé : démarrer l’agent avec des outils en lecture seule, puis n’accorder l’écriture qu’après le diagnostic. Naïvement, ajouter un outil revient à modifier le tableau tools, situé au début du préfixe mis en cache, ce qui invalide tout le cache.
Les changements d’outils en cours de conversation résolvent cela. Déclarez tous les outils dès le départ pour que le tableau ne change jamais, puis utilisez les blocs tool_addition et tool_removal pour proposer ou retirer des outils à partir d’un point donné. Ces blocs voyagent dans un message role: "system", et un message système ne peut pas être la première entrée de messages. Deux contraintes là où on ne les attend pas — je les ai découvertes comme vous l’imaginez.
withhold_patch = {
    "role": "system",
    "content": [{"type": "tool_removal",
                 "tool": {"type": "tool_reference", "name": "apply_patch"}}],
}
messages = [{"role": "user", "content": task_prompt}, withhold_patch]
Remplacez plus tard tool_removal par tool_addition et l’outil revient. Dans mon exécution, le modèle a passé cinq tours en enquête lecture seule, s’est arrêté avec son diagnostic, puis a reçu apply_patch qu’il a utilisé aux tours 6 et 7 avant que la suite ne passe. Le cache a tenu, avec 25 557 jetons relus. Les droits d’écriture n’arrivent qu’une fois les preuves réunies — c’est tout l’intérêt du schéma. Faites d’abord fonctionner la boucle à outils fixes, puis ajoutez cela.
Une tâche agentique, c’est plusieurs requêtes ; le coût est donc la somme, pas la réponse finale. Quatre nombres reviennent à chaque réponse, chacun facturé à un tarif différent.
def cost_usd(self) -> float:
    return (
        self.input_tokens * 5.00
        + self.output_tokens * 25.00
        + self.cache_creation_input_tokens * 6.25
        + self.cache_read_input_tokens * 0.50
    ) / 1_000_000
L’entrée totale est la somme des trois champs d’entrée, car input_tokens seul ne compte que ce qui vient après le dernier point d’arrêt du cache — façon classique de sous‑déclarer. Les jetons de sortie incluent réflexion et appels d’outils, en plus du texte visible, et à cinq fois le tarif d’entrée, ils dominent chaque run ci‑dessus.
À surveiller en montant en charge : les blocs de réflexion des tours précédents restent en contexte et sont refacturés à chaque tour suivant, donc les longues boucles coûtent plus que ce que suggèrent les résultats d’outils. Pour l’évaluation hors‑ligne, l’API Batch divise les deux tarifs par deux. Fast mode fait l’inverse (10 $ et 50 $ par million de jetons), en aperçu recherche avec accès restreint.
Il existe aussi un plafonnement de toute la boucle plutôt que d’une requête : les budgets de tâche donnent au modèle une enveloppe indicative et un compte à rebours, en bêta derrière task-budgets-2026-03-13, avec un plancher à 20 000 jetons. J’avais une section prête et je l’ai coupée : je n’ai rien mesuré ici, et une non‑conclusion ne mérite pas trois paragraphes. Attendez‑vous au même effet tant que le travail reste loin du budget.
La plupart du code Claude existant fonctionne après avoir changé la chaîne de modèle. Les échecs se regroupent à quelques endroits — nous les avons tous rencontrés en construisant l’agent ; considérez ceci comme une checklist plutôt qu’une nouvelle explication. Le guide de migration d’Anthropic couvre la version complète.
response.content[0] est le plus souvent un bloc de réflexion désormais, pas du texte
Une boucle qui reconstruit le message assistant depuis des blocs sélectionnés supprime thinking et redacted_thinking
max_tokens réglé pour un modèle sans réflexion va tronquer, et toute valeur au‑dessus de 21 333 doit streamer
Désactiver la réflexion renvoie un 400 à xhigh ou max d’effort
Des valeurs non par défaut pour temperature, top_p et top_k sont rejetées
Des consignes de vérification héritées d’anciennes invites font « sur‑vérifier » Opus 5
Priority Tier et l’outil de web fetch ne sont pas disponibles sur Opus 5
Effort mérite un nouveau balayage, pas la valeur réglée pour l’ancien modèle
C’est ce dernier point que je défendrais le plus ; cet article en est la démonstration. Mon réglage « tourné fin » s’est révélé être le moins cher de l’échelle.
Deux choses changent avant la mise en production. Le code généré par l’agent n’est pas de confiance : la couche d’outils doit vivre dans un environnement isolé, avec des limites CPU, mémoire et temps, et un patch généré doit passer devant un humain avant fusion.
La seconde est moins évidente. Opus 5 exécute des classifieurs de sécurité, et un agent lisant du code proche de la sécurité frôle la frontière "cyber", mais un refus arrive en HTTP 200 avec stop_reason: "refusal" ; un monitoring basé sur le taux de 5xx ne verra donc rien. Instrumentez les refus à part, branchez‑vous sur stop_reason plutôt que sur stop_details (qui peut être null), et coupez les fallbacks en benchmark pour savoir quel modèle a répondu.
Choisissez Opus 5 quand une mauvaise réponse coûte plus cher que la requête. Débogage multi‑fichiers, analyse de causes racines, revue à l’échelle d’un dépôt, longues boucles d’outils, et planning de migration s’y prêtent. L’échelle d’effort vous permet de traiter le courant à moindre coût et d’escalader les cas difficiles.
Évitez‑le pour la mise en forme, la classification et les volumes élevés à faible complexité, où Claude Sonnet 5 est un meilleur compromis. Évitez‑le aussi pour tout ce que vous ne pouvez pas valider : toute la valeur ici vient d’une suite de tests honnête. Payer le double pour Fable 5 ne s’amortit que sur le travail cité plus haut.
Le conseil de routage que je donnerais vraiment : mesurez la difficulté de la tâche et laissez‑la choisir le niveau d’effort, plutôt que d’envoyer tout en haut de l’échelle parce que « ça semble plus sûr ». Ce n’est pas plus sûr. Comme le benchmark l’a montré, c’était la façon chère d’obtenir le même patch et, une fois, un rapport sur… rien.
L’application Streamlit du dépôt vous permet de le tester : choisissez un niveau d’effort, regardez en direct le raisonnement et les appels d’outils, et lisez jetons, coût et latence sur la même exécution. Elle réinitialise le dépôt comme le benchmark ; le tableau produit est votre mesure, pas la mienne. L’enregistrement ci‑dessous montre le flux.
Apprenez avec DataCamp
Cursus
Cours
Cours
blog
Tutoriel
Kurtis Pykes
15 min
Tutoriel
Tutoriel
DataCamp Team
3 min
Tutoriel
Laiba Siddiqui
6 min
Tutoriel
Derrick Mwiti
10 min