
Programa
Fundamentos de la IA
10 h
Enviar código a un modelo es la parte fácil. El trabajo está en todo lo demás: decidir a qué archivos puede acceder, ejecutar las llamadas a herramientas que pide, saber cuándo debe parar y elegir cuánto razonamiento merece la pena pagar.
Claude Opus 5 hace explícita esa última decisión. El parámetro effort tiene cinco niveles, y Anthropic afirma que invertir más rinde justo en el tipo de trabajo que hace un agente de código. Es fácil repetir esa promesa y más difícil comprobarla, así que fui a por una respuesta acotada. En un bug real, con tests que pasan o fallan, ¿subir el effort mejora la reparación?
Para averiguarlo, crearemos un pequeño agente que corrige bugs y ejecutaremos la misma tarea en cada nivel de effort. Por el camino veremos:
Cómo llamar a claude-opus-5 y analizar una respuesta que empieza con un bloque de pensamiento
Cómo controlar la profundidad del razonamiento con effort y ajustar max_tokens en consecuencia
Cómo ejecutar un bucle de herramientas multi-turno que sobrevive a bloques de pensamiento y a errores de herramienta
Cómo devolver un informe Pydantic validado en lugar de prosa
Cómo medir éxito, tokens, latencia y coste en los cinco niveles de effort
Cómo recortar costes repetidos con caché de prompts dentro de una misma ejecución
Te adelanto el final: en esta tarea, el ajuste más barato arregló el bug en todas las ejecuciones, y nada por encima lo mejoró. Ese resultado es específico de este repositorio; lo más útil es el montaje que lo produjo.
El agente recibe un informe de bug y acceso controlado a un repositorio pequeño de Python, y se pone manos a la obra: listar archivos, leer los relevantes, ejecutar la suite, parchear, volver a ejecutar y reportar.
Claude nunca toca el sistema de archivos. Emite una petición de herramienta con un nombre y argumentos JSON, y nuestro código Python decide si ejecutarla y qué devolver. Ese límite es todo el modelo de seguridad; conviene recordarlo cuando el agente parezca actuar por su cuenta.
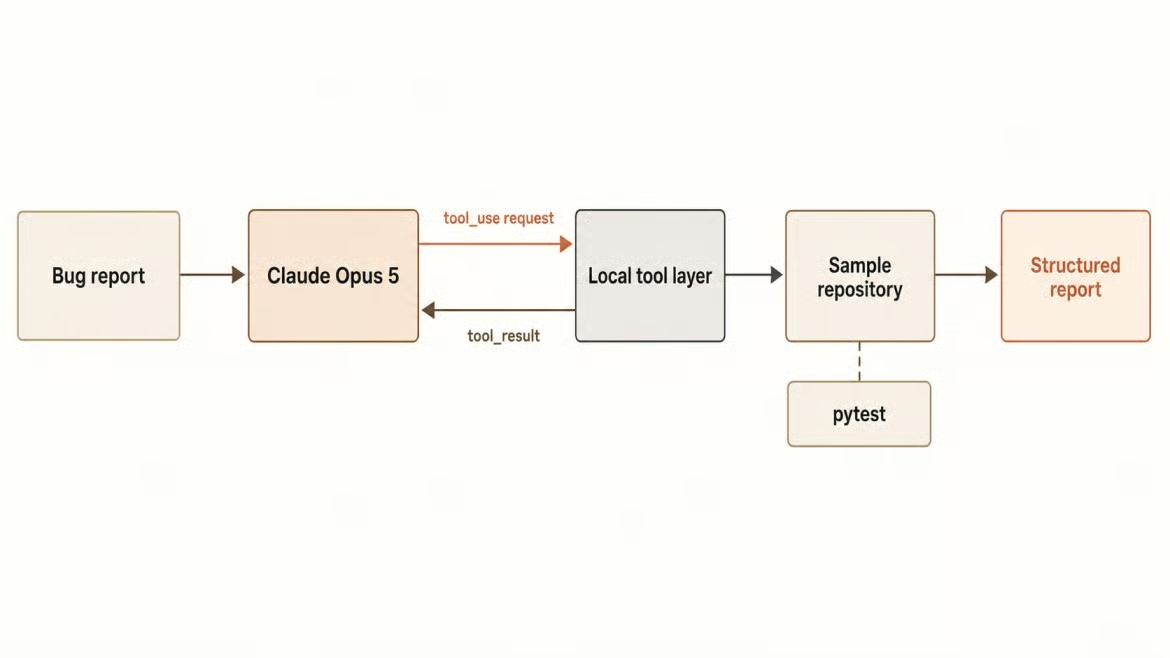
El informe pasa por herramientas controladas. Imagen del autor.
Necesitas Python 3.10 o superior, una clave de API con acceso a claude-opus-5, Git para resetear el repositorio de ejemplo y la suficiente familiaridad con pytest para leer un fallo. El proyecto terminado está en GitHub si prefieres verlo entero; a continuación lo construimos por piezas.
git clone https://github.com/KhalidAbdelaty/claude-opus-5-api-tutorial.git
cd claude-opus-5-api-tutorial
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install -r requirements.txt
Copia .env.example a .env y pon tu clave. En cualquier cosa que construyas a partir de aquí, la clave debe quedarse en el servidor: nunca la envíes en el cuerpo de una petición ni la escribas en logs.
# agent/config.py
MODEL = "claude-opus-5"

PRICE_INPUT = 5.00
PRICE_OUTPUT = 25.00
PRICE_CACHE_WRITE_5M = 6.25
PRICE_CACHE_READ = 0.50

MAX_TOKENS = 32_000
MAX_ITERATIONS = 10
Esos cuatro precios importan después. Cobrar todo al precio base de entrada subestima las escrituras de caché en un 25% y sobrestima las lecturas por diez, justo el tipo de error que hace que un benchmark parezca mejor de lo que fue.
Para una comparativa justa hace falta un bug que falle siempre igual, así que escribí el fixture antes que el agente. El repositorio de ejemplo es un servicio de facturación con un helper de fechas compartido, un módulo de suscripciones y otro de facturas. El helper documenta un comportamiento y implementa otro.
# billing/timeutils.py
def days_between(start: datetime, end: datetime) -> int:
    """Return the number of days from start to end, counting a partial day as a full day.

    Billing treats any remaining fraction of a day as a whole day, so a customer
    with four hours left has one day remaining, not zero.
    """
    delta = end - start
    return delta.days
timedelta.days trunca, así que diez horas restantes de prueba gratuita se reportan como cero días. Dos módulos llaman a este helper, así que un defecto aflora como dos fallos sin relación: test_trial_active_on_final_day bloquea a clientes antes de tiempo y test_prorated_credit_counts_partial_day recorta un día en un reembolso.
El informe de bug solo menciona el primer síntoma, como haría un ticket de soporte. Y hay trampa: parchear is_trial_active para aceptar cero hace que el test reportado pase y deja roto el de facturas, con lo que un arreglo superficial se detecta. La línea base son dos fallos y cuatro aciertos, con commit en Git para que git checkout -- . lo restaure entre ejecuciones.
Antes de usar herramientas, confirma que la autenticación y el parsing de la respuesta funcionan. La API de Messages necesita el nombre del modelo, un max_tokens obligatorio y un array de mensajes.
from anthropic import Anthropic
from dotenv import load_dotenv

load_dotenv()
client = Anthropic()

response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "A pytest assertion fails with: assert 0 == 1. What should I check first?"}],
)

print([block.type for block in response.content])
text = next((b.text for b in response.content if b.type == "text"), "")
Ese primer print es la clave. Devuelve ['thinking', 'text'], porque el pensamiento está activado por defecto y el bloque de pensamiento llega primero.
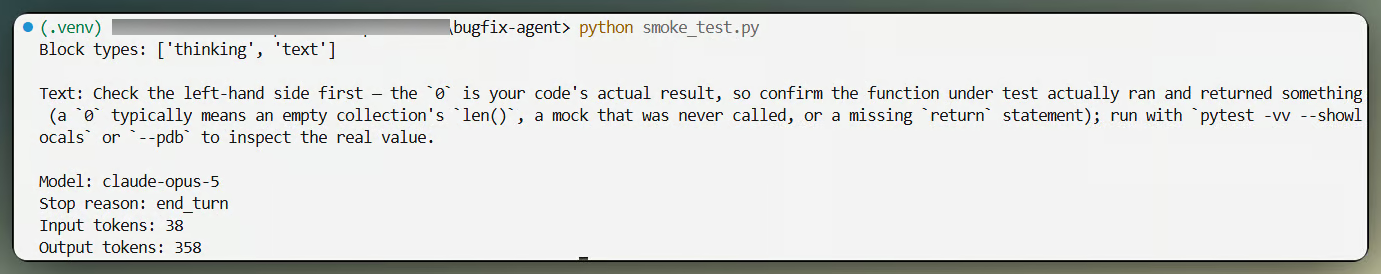
La primera llamada devuelve thinking y luego text. Imagen del autor.
Cualquier código que acceda a response.content[0].text lanzará un AttributeError en Opus 5. Filtra por tipo de bloque. Y ya que estás, elimina temperature, top_p y top_k de cualquier petición que migres, porque valores no predeterminados devuelven un 400 en este modelo.
Thinking y effort son dos controles que a menudo se confunden. Thinking indica si el modelo razona antes de responder, como ya vimos en la primera llamada. Effort es cuánto razona, a lo largo de todos los tokens de salida, incluidas las llamadas a herramientas. Abajo cubro la escalera de niveles, el techo de tokens al que choca y la única combinación que la API rechaza.
Effort se ajusta en output_config, y no hace falta cabecera beta.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    output_config={"effort": "xhigh"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": bug_report}],
)
El valor por defecto de la API es high, y pasar "high" explícitamente es lo mismo que omitirlo. Anthropic sugiere empezar en xhigh para agentes de código y señala que low y medium son más fuertes en Opus 5 que en modelos Opus anteriores. También advierten que max puede sobrepensar tareas sencillas, que fue lo más interesante que medí.
Como decía, max_tokens cubre el razonamiento además de la respuesta, así que un valor ajustado para un modelo sin thinking cortará a Opus 5 a mitad de tarea. Además hay una restricción que suele pillar a la gente.
client.messages.create(model="claude-opus-5", max_tokens=32000, messages=[...])
# ValueError: Streaming is required for operations that may take longer than 10 minutes.
Los SDK rechazan peticiones no streaming por encima de 21.333 max_tokens. Es una validación del cliente, no una regla de la API, así que la solución es hacer streaming: el bucle llama a client.messages.stream() y lee get_final_message(), y así pasan los 32.000. Me quedé ahí para dejar margen a los niveles de effort más altos.
Puedes apagar thinking, pero solo con effort high o inferior. Combinarlo con xhigh o max se rechaza de plano.
effort=high  accepted, blocks=['text']
effort=xhigh HTTP 400: output_config.effort 'xhigh' is not supported when thinking
             is disabled on this model. Use effort 'high' or below, or enable thinking.
Thinking desactivado se rechaza por encima de high. Imagen del autor.
Fíjate en la lista de bloques de la llamada aceptada: solo ['text'] , sin bloque de pensamiento. Bajar el effort es además el control de costes más seguro, así que mantuve thinking activado en todo momento.
Las herramientas convierten un modelo en un agente, y también es donde un agente deja de ser seguro. Cada definición es un nombre, una descripción y un esquema de entrada JSON, y todas consumen tokens de entrada en cada petición. Mantuve el conjunto en cinco, agrupadas abajo por el daño que pueden causar.
list_files y search_code permiten al modelo encontrar el archivo relevante sin pegar el repo entero en el prompt. read_file trae un archivo por ruta relativa al repo, y ahí viven los chequeos de seguridad.
def _resolve(relative_path: str) -> Path:
    """Resolve a repository-relative path, refusing anything outside the repo."""
    candidate = Path(relative_path)
    if candidate.is_absolute():
        raise ToolError("Absolute paths are not allowed.")

    resolved = (REPO_ROOT / candidate).resolve()
    if resolved != REPO_ROOT.resolve() and REPO_ROOT.resolve() not in resolved.parents:
        raise ToolError("Path escapes the repository.")
    return resolved
Resuelve antes de comparar, o ../../.ssh/id_rsa se sale de tu sandbox sin pestañear. Los archivos devueltos se limitan a 8.000 caracteres, porque cada resultado de herramienta se reenvía en cada petición posterior y lo pagas cada vez.
run_tests no acepta argumentos. El comando está fijado en la configuración, así que el modelo no puede pedir un comando de shell arbitrario.
def run_tests() -> str:
    completed = subprocess.run(
        [sys.executable, "-m", "pytest", "tests", "-q", "--no-header", "--tb=short"],
        cwd=REPO_ROOT, capture_output=True, text=True, timeout=120,
    )
    output = (completed.stdout + completed.stderr).strip()
    return f"exit_code: {completed.returncode}\n{output[:3000]}"
Una allowlist de uno es la allowlist más fuerte posible. Si más adelante necesitas más comandos, añádelos como herramientas separadas con nombre, no como un argumento command.
Para escribir, usé sustitución exacta de cadenas en lugar de un diff unificado, porque los diffs fallan con espacios en blanco de formas que desperdician turnos. La herramienta rechaza archivos que no sean Python, limita el tamaño del patch y rehúsa la ambigüedad.
occurrences = source.count(old_text)
if occurrences == 0:
    raise ToolError("old_text was not found in the file. Read the file and retry.")
if occurrences > 1:
    raise ToolError(f"old_text appears {occurrences} times. Include more context.")
Esos errores vuelven a Claude como resultados de herramienta en lugar de romper el bucle, y el modelo los lee y reintenta con más contexto.
El bucle es corto una vez que las piezas encajan. Envía la tarea con las definiciones de herramientas, inspecciona los bloques devueltos, ejecuta lo que se pide, devuelve los resultados y repite hasta que el modelo deje de pedir.
for iteration in range(1, max_iterations + 1):
    with client.messages.stream(
        model=MODEL,
        max_tokens=32_000,
        system=SYSTEM_PROMPT,
        tools=TOOLS,
        output_config={"effort": effort},
        output_format=RepairReport,
        cache_control={"type": "ephemeral"},
        messages=messages,
    ) as stream:
        response = stream.get_final_message()

    usage.add(response.usage)
    messages.append({"role": "assistant", "content": response.content})

    if response.stop_reason != "tool_use":
        break

    tool_results = []
    for block in response.content:
        if block.type == "tool_use":
            output, is_error = execute(block.name, dict(block.input or {}))
            tool_results.append({
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": output,
                "is_error": is_error,
            })
    messages.append({"role": "user", "content": tool_results})
Tres líneas sostienen todo. Añadir response.content completo, y no solo los bloques que te interesan, mantiene thinking y redacted_thinking intactos; si los filtras, el modelo reinicia su razonamiento tras cada resultado de herramienta. Los bloques tool_result deben ir los primeros en el mensaje del usuario: si hay texto antes, devuelve un 400. Y is_error le dice a Claude que una herramienta falló, mejor que un string vacío silencioso.
El prompt del sistema permanece fijo en todas las ejecuciones para que la comparación tenga sentido. Indica investigar antes de editar, encontrar la causa raíz y no solo el síntoma reportado, hacer el cambio más pequeño que funcione y tratar ejecutar la suite como parte de la tarea. Lo que omite es "revisa tu trabajo dos veces". Opus 5 se verifica a sí mismo, y Anthropic recomienda quitar esas instrucciones al migrar, porque añaden latencia y tokens sin mejorar el patch.
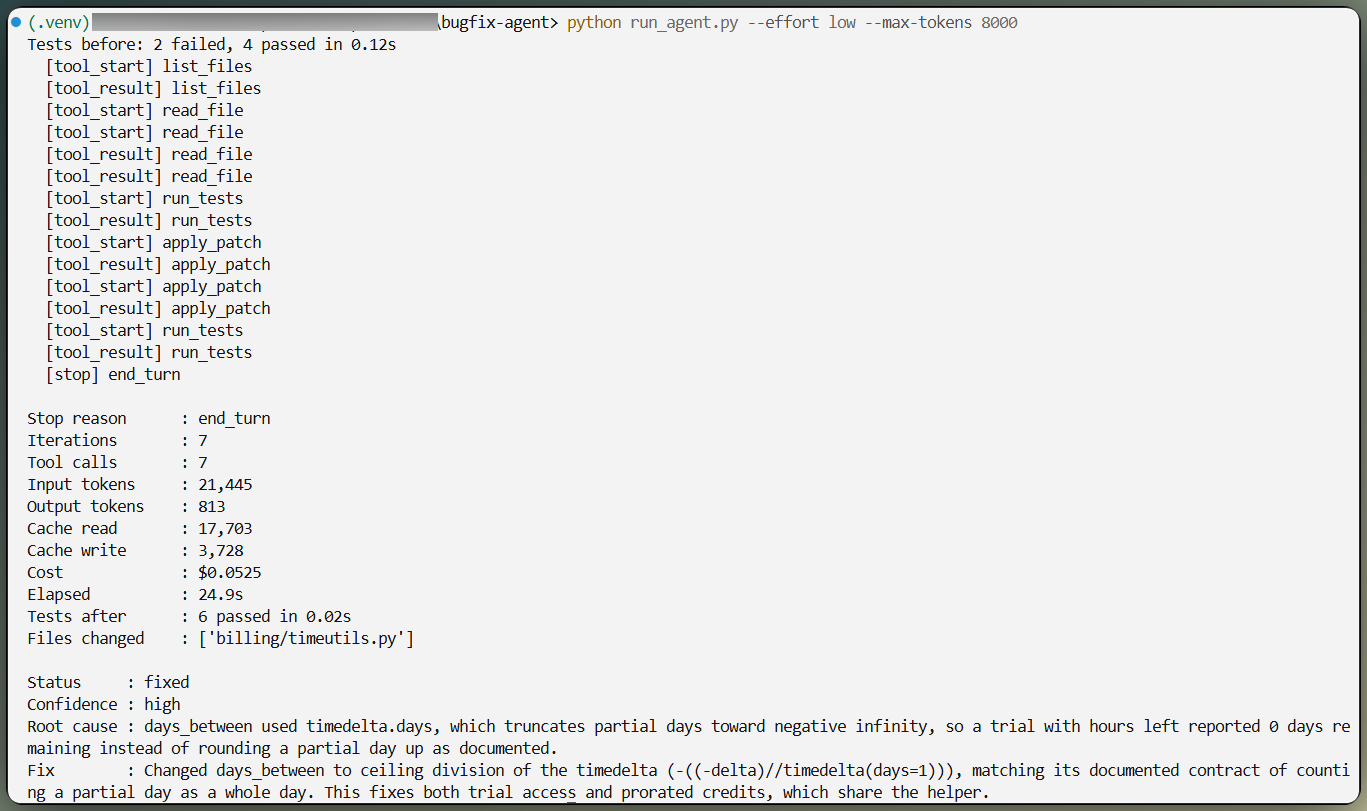
El agente investiga, parchea y vuelve a ejecutar tests. Imagen del autor.
La prosa sirve para una ejecución. Para un benchmark que compara muchas, prefiero un objeto tipado, así que el bucle pasa un modelo de Pydantic como output_format y el SDK lo convierte en un esquema JSON con decodificación controlada.
class RepairReport(BaseModel):
    status: Literal["fixed", "partial", "not_fixed"]
    root_cause: str
    files_inspected: list[str]
    files_changed: list[str]
    fix_summary: str
    tests_before: str
    tests_after: str
    remaining_risks: list[str]
    confidence: Literal["low", "medium", "high"]

    @field_validator("status", "confidence", mode="before")
    @classmethod
    def _normalize_case(cls, value):
        """Enum capitalization is not guaranteed, so fold it before validating."""
        return value.strip().lower() if isinstance(value, str) else value
El validador se gana su lugar. Los outputs estructurados no garantizan la capitalización de los enum, así que un esquema que espera "high" puede recibir "High" sin error ni stop reason especial, y una validación estricta con Literal rechazaría una respuesta básicamente correcta.
Mantén latencia y coste fuera de este esquema. El modelo informa de lo que concluyó; el runner mide lo que pasó reejecutando pytest y leyendo git diff. Esa separación me alegró más tarde, por razones que el benchmark deja claras.
Este es el experimento por el que existe el tutorial: el mismo bug, el mismo prompt, las mismas herramientas, en low, medium, high, xhigh y max. La salida no es determinista, y este modelo rechaza parámetros de muestreo, así que repetir cada nivel es el único control que tengo.
Cada ejecución parte de ese commit limpio de referencia, luego mide la suite antes y después. El informe de bug, el prompt del sistema, las herramientas, el límite de iteraciones y max_tokens son idénticos en todas partes; solo cambia el string de effort. Ejecuté cada nivel tres veces.
Un guardarraíl de presupuesto envuelve todo, sumando el coste real a cuatro tarifas tras cada petición y parando en un techo. Los bucles de agentes son una forma fácil de pasarte de gasto, y un stop condition que controlas vale más que enterarte después.
Aquí están las medias de tres ejecuciones por nivel, medidas el 26 de julio de 2026.
|
Effort |
Suite aprobada |
Llamadas a herramientas |
Tokens de salida |
Tiempo hasta primer output |
Tiempo total |
Coste por ejecución |
|
|
3/3 |
8.0 |
827 |
2.9s |
24s |
$0.0387 |
|
|
3/3 |
8.0 |
1,008 |
2.7s |
26s |
$0.0466 |
|
|
3/3 |
10.0 |
1,352 |
2.9s |
29s |
$0.0659 |
|
|
3/3 |
11.3 |
1,546 |
2.8s |
35s |
$0.0778 |
|
|
2/3 |
8.3 |
1,787 |
6.6s |
38s |
$0.0762 |
Todos los niveles que se engancharon con el repo encontraron la misma causa raíz en el helper de fechas compartido y lo arreglaron con unas cuatro líneas en un archivo. Ninguno cayó en la trampa de parchear la comprobación del trial. Toda la matriz de quince ejecuciones costó 0,92 $.
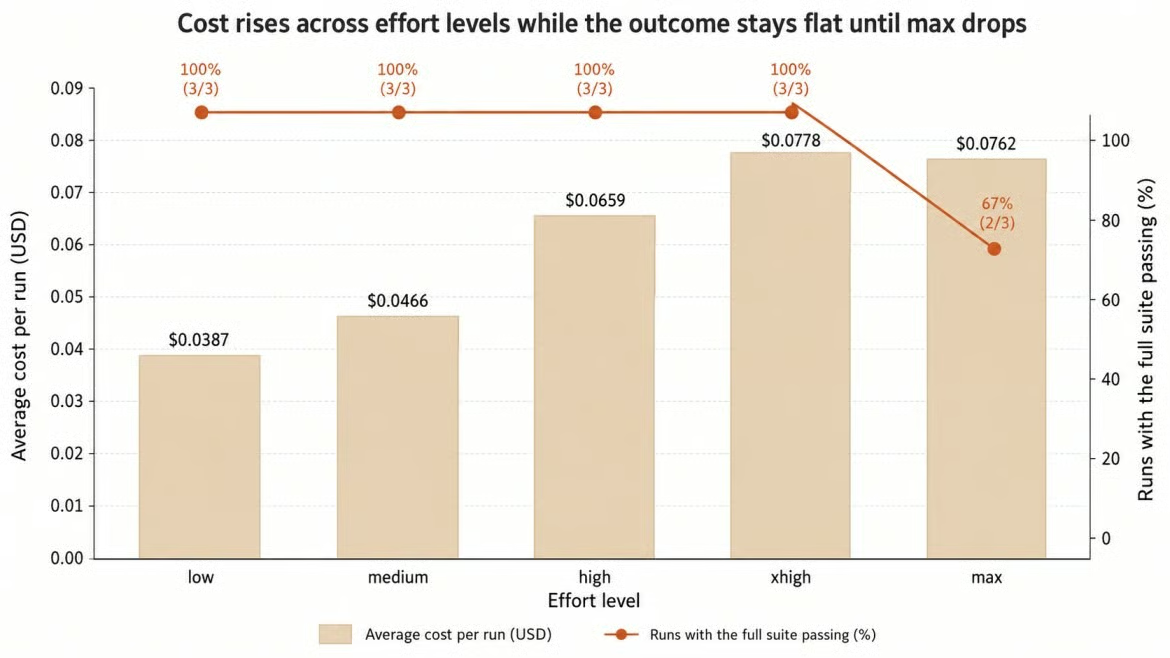
El coste sube, el resultado no. Imagen del autor.
La lectura honesta es que esta tarea no era lo bastante difícil para separar la parte alta de la baja de la escalera. Pasar de low a xhigh dobló el coste y añadió once segundos para un resultado idéntico. Si esto saliera a producción, correría en low y gastaría la diferencia en cobertura de tests.
Esa fila de max necesita explicación. Una de sus tres ejecuciones devolvió un informe válido según el esquema en el primer turno sin llamar a ninguna herramienta, con root_cause como "b0" y fix_summary vacío. Pydantic lo aceptó porque la forma era correcta. Los tests ni se tocaron. Si lo excluimos, los otros dos intentos en max arreglaron el bug con 12,5 llamadas a herramientas y 0,1112 $ cada uno, aproximadamente el triple del coste de low.
Ese fallo me parece más instructivo que la tabla. Un esquema garantiza estructura, no sustancia, y una aplicación que confiara en report.status habría registrado un "éxito parcial" en una ejecución que no hizo nada. El runner lo detectó porque ejecutó pytest en lugar de creer al modelo. Sea lo que sea que saques de este artículo, quédate con eso. Y como tu tarea no es la mía, toma todo esto como un método más que como un resultado.
La caché es donde el bucle se abarata, y funciona dentro de una ejecución más que entre niveles de effort. Cambiar el valor de effort invalida los prefijos en caché, así que cada nivel paga su coste de creación de caché y no se arrastra ninguna caché caliente. Dentro de una ejecución es distinto, porque el prompt del sistema y las definiciones de herramientas no cambian mientras crece el historial.
Un campo cache_control a nivel superior activa el caché automático, que coloca el punto de corte en el último bloque cacheable y lo mueve hacia delante según crece la conversación.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    tools=TOOLS,
    cache_control={"type": "ephemeral"},
    messages=messages,
)
Dos turnos consecutivos lo muestran claro:
turn 1: uncached_input=2  cache_write=1231  cache_read=0     output=26
turn 2: uncached_input=2  cache_write=111   cache_read=1231  output=108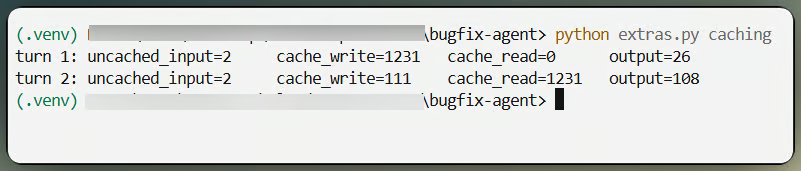
El prefijo en caché se lee en el siguiente turno. Imagen del autor.
El prefijo estable es de 1.231 tokens, por encima del mínimo de caché que comenté. En el turno dos se lee a una décima del precio de entrada mientras solo se escribe el nuevo resultado de herramienta. En una ejecución completa a xhigh, unos 32.600 de unos 36.200 tokens de entrada vinieron de caché. La caché no afecta a los tokens de salida.
Este es el patrón que más útil me resultó. Arranca el agente con herramientas de solo lectura y concede acceso de escritura solo después de que haya diagnosticado el problema. Si lo haces de forma ingenua, añadir una herramienta implica editar el array de tools, que está al frente del prefijo cacheado e invalida toda la conversación.
Los cambios de herramientas a mitad de conversación lo resuelven. Declara todas las herramientas desde el principio para que el array no cambie nunca, y usa bloques tool_addition y tool_removal para ofrecer o retirar herramientas individuales a partir de un punto. Los bloques viajan dentro de un mensaje con role: "system", y un mensaje de sistema no puede ser la primera entrada en messages. Ninguna de las dos restricciones está donde esperarías, y las descubrí como imaginas.
withhold_patch = {
    "role": "system",
    "content": [{"type": "tool_removal",
                 "tool": {"type": "tool_reference", "name": "apply_patch"}}],
}
messages = [{"role": "user", "content": task_prompt}, withhold_patch]
Cambia tool_removal por tool_addition más tarde y la herramienta vuelve. En mi ejecución, el modelo pasó cinco turnos investigando en solo lectura, paró con su diagnóstico y solo entonces recibió apply_patch, que usó en los turnos seis y siete antes de que la suite pasara. La caché se mantuvo, con 25.557 tokens leídos. El acceso de escritura llegó tras reunir las pruebas, que es el verdadero argumento del patrón. Haz funcionar primero el bucle con herramientas fijas y luego añade esto.
Una tarea agentic son muchas peticiones, así que el coste está en la suma, no en la última respuesta. En cada respuesta vuelven cuatro números, y cada uno se factura a una tarifa distinta.
def cost_usd(self) -> float:
    return (
        self.input_tokens * 5.00
        + self.output_tokens * 25.00
        + self.cache_creation_input_tokens * 6.25
        + self.cache_read_input_tokens * 0.50
    ) / 1_000_000
El total de entrada es la suma de los tres campos de entrada, porque input_tokens por sí solo cuenta solo lo que queda tras el último punto de caché, que es una forma común de infrainformar. Los tokens de salida incluyen thinking y llamadas a herramientas además del texto visible, y a cinco veces la tarifa de entrada dominan todas las ejecuciones de arriba.
Algo a vigilar a medida que escales: los bloques de pensamiento de turnos previos permanecen en contexto y se vuelven a facturar en cada turno posterior, así que los bucles largos cuestan más de lo que sugieren los resultados de herramientas. Para evaluación offline, la Batch API reduce ambas tarifas a la mitad. Fast mode va al otro extremo, a 10$ y 50$ por millón de tokens, como vista previa de investigación con acceso limitado.
También hay una forma de limitar todo el bucle, no solo una petición. Los presupuestos de tarea le dan al modelo una asignación orientativa y una cuenta atrás para que se autorregule, en beta tras task-budgets-2026-03-13, con un suelo de 20.000 tokens. Tenía una sección escrita y la quité, porque aquí no medí diferencia y un no-resultado no necesita tres párrafos. Espera lo mismo siempre que el trabajo no se acerque al presupuesto.
La mayoría del código existente de Claude funciona tras cambiar el string del modelo. Los fallos se concentran en pocos puntos, y hemos pasado por todos mientras construíamos el agente, así que tómalo como checklist más que como explicación nueva. La guía de migración de Anthropic tiene la versión completa.
response.content[0] suele ser ahora un bloque de thinking, no texto
Un bucle que recompone el mensaje del asistente a partir de bloques seleccionados pierde thinking y redacted_thinking
max_tokens ajustado para un modelo sin thinking truncará, y cualquier valor por encima de 21.333 debe ir en streaming
Desactivar thinking devuelve 400 con effort xhigh o max
Se rechazan valores no predeterminados de temperature, top_p y top_k
Instrucciones de verificación heredadas de prompts antiguos hacen que Opus 5 sobreverifique
Priority Tier y la herramienta de web fetch no están disponibles en Opus 5
Effort merece una nueva pasada en lugar del valor que ajustaste para el modelo anterior
Esta última es la que defendería con más fuerza, y este artículo es el argumento. Mi valor ajustado resultó ser el más barato de la escalera.
Dos cosas cambian antes de enviar esto a producción. El código generado por el agente no es de confianza, así que la capa de herramientas debe ir en un entorno aislado con límites de CPU, memoria y tiempo, y un patch generado debe pasar por una revisión humana antes de hacer merge.
La segunda es menos obvia. Opus 5 ejecuta clasificadores de seguridad, y un agente que lee código cercano a seguridad roza el borde "cyber", pero una negativa llega como HTTP 200 con stop_reason: "refusal", así que el monitoreo basado en tasas de 5xx no ve ninguna. Instrumenta las negativas por separado, ramifica según stop_reason en lugar de los campos stop_details por debajo, que pueden ser null, y desactiva fallbacks en benchmarks para saber qué modelo respondió.
Usa Opus 5 cuando una respuesta incorrecta cueste más que la propia petición. Depuración multiarchivo, análisis de causa raíz, revisión de repositorios completos, bucles largos de herramientas y planificación de migraciones encajan, y la escalera de effort te permite ejecutar los casos rutinarios barato y subir el nivel en los difíciles.
Evítalo para formateo, clasificación y trabajo de alto volumen y baja complejidad, donde Claude Sonnet 5 es mejor equilibrio. Evítalo también para cualquier cosa que no puedas validar: todo el valor aquí vino de una suite de tests que responde con honestidad. Pagar el doble por Fable 5 solo compensa en el trabajo que destaqué arriba.
El consejo de enrutado que de verdad daría es medir la dificultad de la tarea y dejar que eso elija el nivel de effort, en lugar de mandar todo a lo alto de la escalera porque suena más seguro. No lo es. Como mostró el benchmark, fue la forma cara de obtener el mismo patch, y una vez produjo un informe sobre nada.
La app de Streamlit del repo te permite ejecutarlo tú mismo: elige un nivel de effort, observa en directo el razonamiento y las llamadas a herramientas, y lee tokens, coste y latencia en la misma ejecución. Resetea el repo igual que en el benchmark, así que la tabla que construye es tu medición, no la mía. La grabación de pantalla de abajo muestra el flujo.
Aprende con DataCamp
Programa
Curso
Curso
Tutorial
Abid Ali Awan
Tutorial
Zoumana Keita
12 min
Tutorial
Tutorial
Tutorial
Richie Cotton
14 min
Tutorial
Dimitri Didmanidze
8 min


