
Program
Dasar-Dasar Kecerdasan Buatan
10 jam
Mengirim kode ke model itu mudah. Pekerjaan sesungguhnya ada di sekelilingnya: memutuskan file mana yang boleh dibaca, mengeksekusi pemanggilan tool yang diminta, mengetahui kapan harus berhenti, dan memilih seberapa besar penalaran yang ingin Anda biayai.
Claude Opus 5 membuat keputusan terakhir itu eksplisit. Parameter effort memiliki lima pengaturan, dan Anthropic mengatakan mengeluarkan biaya lebih banyak akan terbayar tepat pada pekerjaan yang dilakukan agen pengodean. Klaim itu mudah diulang dan lebih sulit diperiksa, jadi saya menginginkan jawaban yang sempit. Pada satu bug nyata, dengan pengujian yang hanya bisa lulus atau gagal, apakah menaikkan effort menghasilkan perbaikan yang lebih baik?
Untuk mengetahuinya, kita akan membangun agen kecil untuk memperbaiki bug dan menjalankan tugas yang sama pada setiap tingkat effort. Sepanjang jalan kita akan membahas:
Memanggil claude-opus-5 dan mengurai respons yang diawali blok thinking
Mengendalikan kedalaman penalaran dengan effort dan menentukan ukuran max_tokens di sekitarnya
Menjalankan loop tool multi-giliran yang tahan terhadap blok thinking dan error tool
Mengembalikan laporan Pydantic tervalidasi alih-alih prosa
Mengukur keberhasilan, token, latensi, dan biaya di kelima tingkat effort
Memangkas biaya input berulang dengan cache prompt di dalam satu run
Saya bocorkan akhirnya: pada tugas ini, pengaturan termurah memperbaiki bug di setiap run, dan tidak ada pengaturan di atasnya yang lebih baik. Hasil itu spesifik pada repositori ini, dan bagian yang lebih berguna adalah rig yang menghasilkannya.
Agen menerima laporan bug dan akses terkendali ke sebuah repositori Python kecil, lalu mengerjakan masalahnya: daftar file, baca yang relevan, jalankan suite, tambal, jalankan ulang, dan laporkan.
Claude tidak pernah menyentuh filesystem. Ia mengeluarkan permintaan tool dengan nama dan argumen JSON, dan kode Python kita yang memutuskan apakah akan menjalankannya dan apa yang dikembalikan. Batas itu adalah seluruh model keamanan, patut diingat kapan pun agen terlihat seolah bertindak sendiri.
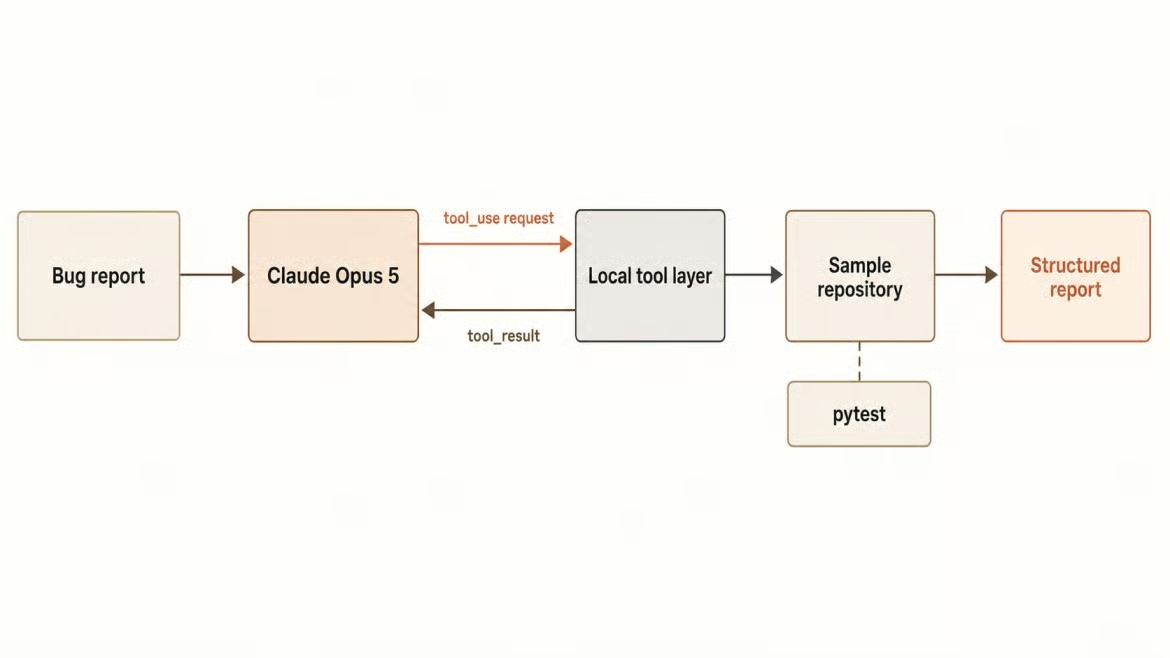
Laporan bug mengalir melalui tools terkontrol. Gambar oleh Penulis.
Anda memerlukan Python 3.10 atau lebih baru, kunci API dengan akses ke claude-opus-5, Git untuk mereset repositori contoh, dan cukup pytest untuk membaca kegagalan. Proyek jadi ada di GitHub jika Anda lebih suka membacanya secara utuh; bagian-bagian di bawah ini membangunnya selangkah demi selangkah.
git clone https://github.com/KhalidAbdelaty/claude-opus-5-api-tutorial.git
cd claude-opus-5-api-tutorial
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install -r requirements.txt
Salin .env.example ke .env dan masukkan kunci Anda. Kunci tersebut harus berada di sisi server dari apa pun yang Anda bangun dari sini, jangan pernah di body request dan jangan pernah di baris log.
# agent/config.py
MODEL = "claude-opus-5"

PRICE_INPUT = 5.00
PRICE_OUTPUT = 25.00
PRICE_CACHE_WRITE_5M = 6.25
PRICE_CACHE_READ = 0.50

MAX_TOKENS = 32_000
MAX_ITERATIONS = 10
Empat harga itu penting nanti. Menagih semuanya pada tarif input dasar meremehkan penulisan cache seperempat dan melebihkan pembacaan cache sepuluh kali lipat, jenis kesalahan yang membuat benchmark terlihat lebih baik dari yang sebenarnya.
Perbandingan yang adil membutuhkan bug yang gagal dengan cara yang sama setiap kali, jadi saya menulis fixture sebelum agennya. Repositori contoh adalah layanan penagihan dengan helper tanggal bersama, modul langganan, dan modul faktur. Helper mendokumentasikan satu perilaku dan mengimplementasikan yang lain.
# billing/timeutils.py
def days_between(start: datetime, end: datetime) -> int:
    """Return the number of days from start to end, counting a partial day as a full day.

    Billing treats any remaining fraction of a day as a whole day, so a customer
    with four hours left has one day remaining, not zero.
    """
    delta = end - start
    return delta.days
timedelta.days melakukan pembulatan ke bawah, jadi sisa masa uji coba sepuluh jam dilaporkan sebagai nol hari. Dua modul memanggil helper ini, sehingga satu cacat muncul sebagai dua kegagalan yang tidak terkait: test_trial_active_on_final_day mengunci pelanggan lebih awal, dan test_prorated_credit_counts_partial_day mengurangi pengembalian dana satu hari.
Laporan bug hanya menyebutkan gejala pertama, seperti tiket dukungan. Ada juga jebakan: menambal is_trial_active agar menerima nol membuat pengujian yang dilaporkan lulus dan membiarkan uji faktur tetap rusak, sehingga perbaikan dangkal dapat terdeteksi. Basisnya adalah dua kegagalan dan empat lolos, dikomit ke Git sehingga git checkout -- . mengembalikannya di antara run.
Sebelum ada tools, pastikan autentikasi dan penguraian respons berfungsi. Messages API membutuhkan string model, max_tokens yang wajib, dan array messages.
from anthropic import Anthropic
from dotenv import load_dotenv

load_dotenv()
client = Anthropic()

response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "A pytest assertion fails with: assert 0 == 1. What should I check first?"}],
)

print([block.type for block in response.content])
text = next((b.text for b in response.content if b.type == "text"), "")
Cetakan pertama print itulah inti latihannya. Ia mengembalikan ['thinking', 'text'], karena thinking aktif secara default dan blok thinking datang lebih dulu.
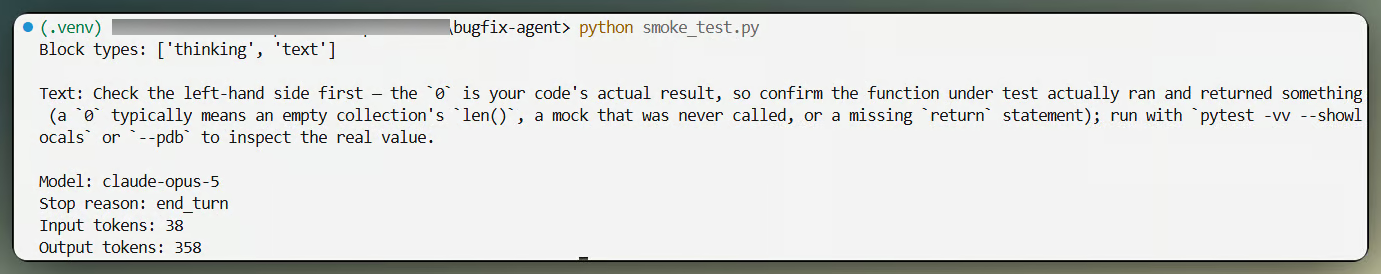
Panggilan pertama mengembalikan thinking lalu text. Gambar oleh Penulis.
Kode apa pun yang mencoba response.content[0].text akan memicu AttributeError di Opus 5. Saring berdasarkan tipe blok saja. Sekalian, hilangkan temperature, top_p, dan top_k dari request yang Anda porting, karena nilai non-bawaan akan mengembalikan 400 pada model ini.
Thinking dan effort adalah dua kontrol yang sering disamakan. Thinking adalah apakah model melakukan penalaran sebelum menjawab, yang sudah ditunjukkan pada panggilan pertama. Effort adalah seberapa banyak penalaran yang dilakukan, pada setiap token output, termasuk pemanggilan tool. Subbagian di bawah ini membahas tingkatannya, plafon token yang mengenainya, dan satu kombinasi yang ditolak API.
Effort diatur di dalam output_config, dan tidak perlu header beta.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    output_config={"effort": "xhigh"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": bug_report}],
)
Default API adalah high, dan menyertakan "high" secara eksplisit sama saja dengan menghilangkannya. Anthropic menyarankan memulai dari xhigh untuk pengodean agen dan mencatat bahwa low dan medium lebih kuat di Opus 5 daripada pada model Opus sebelumnya. Panduan mereka juga memperingatkan bahwa max dapat berpikir berlebihan pada tugas yang lebih sederhana, yang ternyata menjadi hal paling menarik yang saya ukur.
Seperti saya sebutkan sebelumnya, max_tokens mencakup penalaran sekaligus jawabannya, jadi nilai yang disetel untuk model tanpa thinking akan memotong Opus 5 di tengah tugas. Ada juga batasan yang sering menjebak orang.
client.messages.create(model="claude-opus-5", max_tokens=32000, messages=[...])
# ValueError: Streaming is required for operations that may take longer than 10 minutes.
SDK menolak request non-streaming di atas 21.333 max_tokens. Itu validasi sisi klien, bukan aturan API, jadi solusinya adalah streaming: loop memanggil client.messages.stream() dan membaca get_final_message(), dan nilai 32.000 yang sama lolos. Saya menetapkannya di sana karena memberi ruang untuk tingkat effort yang lebih tinggi.
Anda bisa mematikan thinking, tetapi hanya pada effort high atau di bawahnya. Menggabungkannya dengan xhigh atau max ditolak mentah-mentah.
effort=high  accepted, blocks=['text']
effort=xhigh HTTP 400: output_config.effort 'xhigh' is not supported when thinking
             is disabled on this model. Use effort 'high' or below, or enable thinking.
Thinking dinonaktifkan ditolak di atas effort high. Gambar oleh Penulis.
Perhatikan daftar blok pada panggilan yang diterima: hanya ['text'] , blok thinking hilang. Menurunkan effort memang kontrol biaya yang lebih aman, jadi saya membiarkan thinking tetap aktif sepanjang waktu.
Tools mengubah model menjadi agen, dan juga di situlah agen berhenti menjadi aman. Setiap definisi berisi nama, deskripsi, dan skema input JSON, dan semuanya menghabiskan token input pada setiap request. Saya membatasi set menjadi lima, dikelompokkan di bawah berdasarkan seberapa besar kerusakan yang bisa ditimbulkan.
list_files dan search_code memungkinkan model menemukan file relevan tanpa menempelkan repositori ke dalam prompt. read_file mengambil satu file dengan path relatif terhadap repositori, dan di situlah pemeriksaan keamanannya berada.
def _resolve(relative_path: str) -> Path:
    """Resolve a repository-relative path, refusing anything outside the repo."""
    candidate = Path(relative_path)
    if candidate.is_absolute():
        raise ToolError("Absolute paths are not allowed.")

    resolved = (REPO_ROOT / candidate).resolve()
    if resolved != REPO_ROOT.resolve() and REPO_ROOT.resolve() not in resolved.parents:
        raise ToolError("Path escapes the repository.")
    return resolved
Lakukan resolve sebelum membandingkan, atau ../../.ssh/id_rsa akan berjalan keluar dari sandbox Anda. File yang dikembalikan dibatasi hingga 8.000 karakter, karena setiap hasil tool dikirim ulang pada setiap request berikutnya dan Anda membayarnya setiap kali.
run_tests tidak menerima argumen. Perintah ditetapkan di konfigurasi, sehingga model tidak memiliki cara untuk meminta perintah shell sewenang-wenang.
def run_tests() -> str:
    completed = subprocess.run(
        [sys.executable, "-m", "pytest", "tests", "-q", "--no-header", "--tb=short"],
        cwd=REPO_ROOT, capture_output=True, text=True, timeout=120,
    )
    output = (completed.stdout + completed.stderr).strip()
    return f"exit_code: {completed.returncode}\n{output[:3000]}"
Daftar putih dengan satu entri adalah daftar putih terkuat yang tersedia. Jika Anda membutuhkan lebih banyak perintah nanti, tambahkan sebagai tools bernama terpisah, bukan sebagai argumen command .
Untuk penulisan saya menggunakan penggantian string persis alih-alih unified diff, karena diff gagal pada whitespace dengan cara yang membuang satu giliran. Tool menolak file non-Python, membatasi ukuran patch, dan menolak ambiguitas.
occurrences = source.count(old_text)
if occurrences == 0:
    raise ToolError("old_text was not found in the file. Read the file and retry.")
if occurrences > 1:
    raise ToolError(f"old_text appears {occurrences} times. Include more context.")
Error tersebut dikembalikan ke Claude sebagai hasil tool alih-alih membuat loop crash, dan model membacanya serta mencoba lagi dengan konteks lebih banyak.
Loop ini singkat setelah bagiannya siap. Kirim tugas dengan definisi tool, periksa blok yang dikembalikan, eksekusi yang diminta, kirim kembali hasilnya, dan ulangi sampai model berhenti meminta.
for iteration in range(1, max_iterations + 1):
    with client.messages.stream(
        model=MODEL,
        max_tokens=32_000,
        system=SYSTEM_PROMPT,
        tools=TOOLS,
        output_config={"effort": effort},
        output_format=RepairReport,
        cache_control={"type": "ephemeral"},
        messages=messages,
    ) as stream:
        response = stream.get_final_message()

    usage.add(response.usage)
    messages.append({"role": "assistant", "content": response.content})

    if response.stop_reason != "tool_use":
        break

    tool_results = []
    for block in response.content:
        if block.type == "tool_use":
            output, is_error = execute(block.name, dict(block.input or {}))
            tool_results.append({
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": output,
                "is_error": is_error,
            })
    messages.append({"role": "user", "content": tool_results})
Tiga baris di sana bersifat krusial. Menambahkan response.content secara utuh, bukan hanya blok yang Anda pedulikan, menjaga thinking dan redacted_thinking tetap utuh; jika Anda menyaringnya, model mengulang penalarannya setelah setiap hasil tool. Blok tool_result harus muncul lebih dulu di pesan user, karena teks sebelum itu akan mengembalikan 400. Dan is_error memberi tahu Claude sebuah tool gagal, yang lebih baik daripada string kosong tanpa bunyi.
System prompt tetap sama di setiap run agar perbandingan bermakna. Ia mengarahkan model untuk menyelidiki sebelum mengedit, menemukan akar penyebab alih-alih gejala yang dilaporkan, membuat perubahan sekecil mungkin yang berhasil, dan memperlakukan menjalankan suite sebagai bagian dari tugas. Yang dihilangkan adalah "periksa ulang pekerjaan Anda." Opus 5 memverifikasi dirinya sendiri, dan panduan Anthropic adalah menghapus instruksi tersebut saat migrasi, karena menambah latensi dan token tanpa memperbaiki patch.
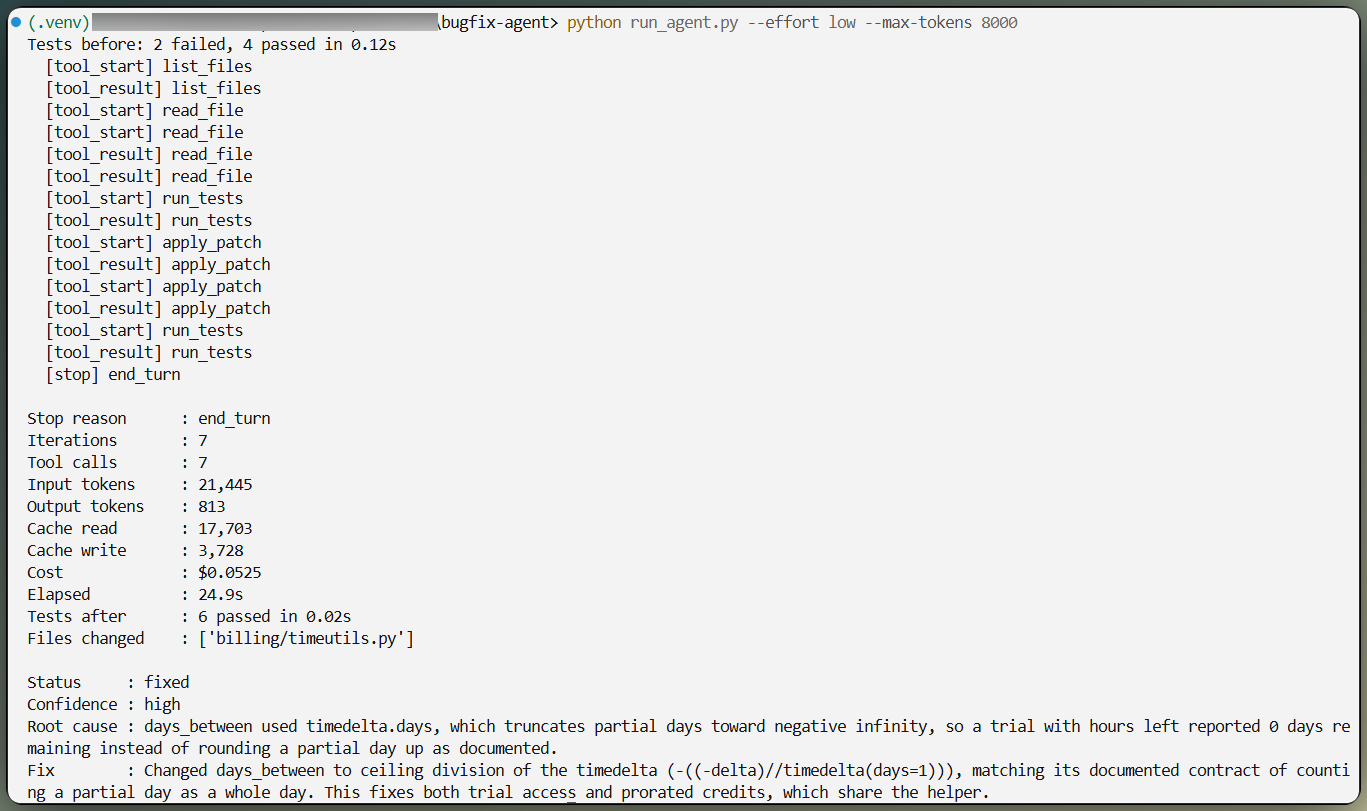
Agen memeriksa, menambal, lalu menjalankan ulang pengujian. Gambar oleh Penulis.
Prosa memadai untuk satu run. Untuk benchmark yang harus membandingkan banyak run, saya menginginkan objek bertipe, jadi loop mengoper sebuah model Pydantic sebagai output_format dan SDK mengubahnya menjadi skema JSON dengan dekode terbatasi.
class RepairReport(BaseModel):
    status: Literal["fixed", "partial", "not_fixed"]
    root_cause: str
    files_inspected: list[str]
    files_changed: list[str]
    fix_summary: str
    tests_before: str
    tests_after: str
    remaining_risks: list[str]
    confidence: Literal["low", "medium", "high"]

    @field_validator("status", "confidence", mode="before")
    @classmethod
    def _normalize_case(cls, value):
        """Enum capitalization is not guaranteed, so fold it before validating."""
        return value.strip().lower() if isinstance(value, str) else value
Validator itu layak tempatnya. Keluaran terstruktur tidak menjamin kapitalisasi enum, jadi skema yang mengharapkan "high" bisa menerima "High" tanpa error dan tanpa alasan berhenti khusus, dan validasi Literal yang ketat akan menolak respons yang pada dasarnya benar.
Jauhkan latensi dan biaya dari skema ini. Model melaporkan apa yang disimpulkan; runner mengukur apa yang terjadi dengan menjalankan ulang pytest dan membaca git diff. Saya senang ada pemisahan itu nantinya, karena alasan yang jelas pada benchmark.
Ini adalah eksperimen yang menjadi alasan tutorial ini: bug yang sama, prompt yang sama, tools yang sama, pada low, medium, high, xhigh, dan max. Output tidak deterministik, dan parameter sampling ditolak pada model ini, jadi mengulang tiap tingkat adalah satu-satunya kontrol yang saya miliki.
Setiap run dimulai dari commit baseline yang bersih itu, lalu mengukur suite sebelum dan sesudah. Laporan bug, system prompt, definisi tool, batas iterasi, dan max_tokens identik di mana pun, dan hanya string effort yang berubah. Saya menjalankan setiap tingkat tiga kali.
Penjaga anggaran membungkus keseluruhan, menjumlahkan biaya empat tarif nyata setelah setiap request dan berhenti pada plafon. Loop agen adalah cara mudah untuk berlebih belanja, dan kondisi berhenti yang Anda kendalikan lebih baik daripada mengetahui angkanya belakangan.
Berikut rata-rata dari tiga run per tingkat, diukur pada 26 Juli 2026.
|
Effort |
Suite lulus |
Pemanggilan tool |
Token output |
Waktu ke output pertama |
Total waktu |
Biaya per run |
|
|
3/3 |
8,0 |
827 |
2,9 dtk |
24 dtk |
$0,0387 |
|
|
3/3 |
8,0 |
1.008 |
2,7 dtk |
26 dtk |
$0,0466 |
|
|
3/3 |
10,0 |
1.352 |
2,9 dtk |
29 dtk |
$0,0659 |
|
|
3/3 |
11,3 |
1.546 |
2,8 dtk |
35 dtk |
$0,0778 |
|
|
2/3 |
8,3 |
1.787 |
6,6 dtk |
38 dtk |
$0,0762 |
Setiap tingkat yang terlibat dengan repositori menemukan akar penyebab yang sama di helper tanggal bersama dan memperbaikinya dengan sekitar empat baris di satu file. Tidak satu pun yang terpancing menambal pemeriksaan masa uji coba. Seluruh matriks lima belas run berbiaya $0,92.
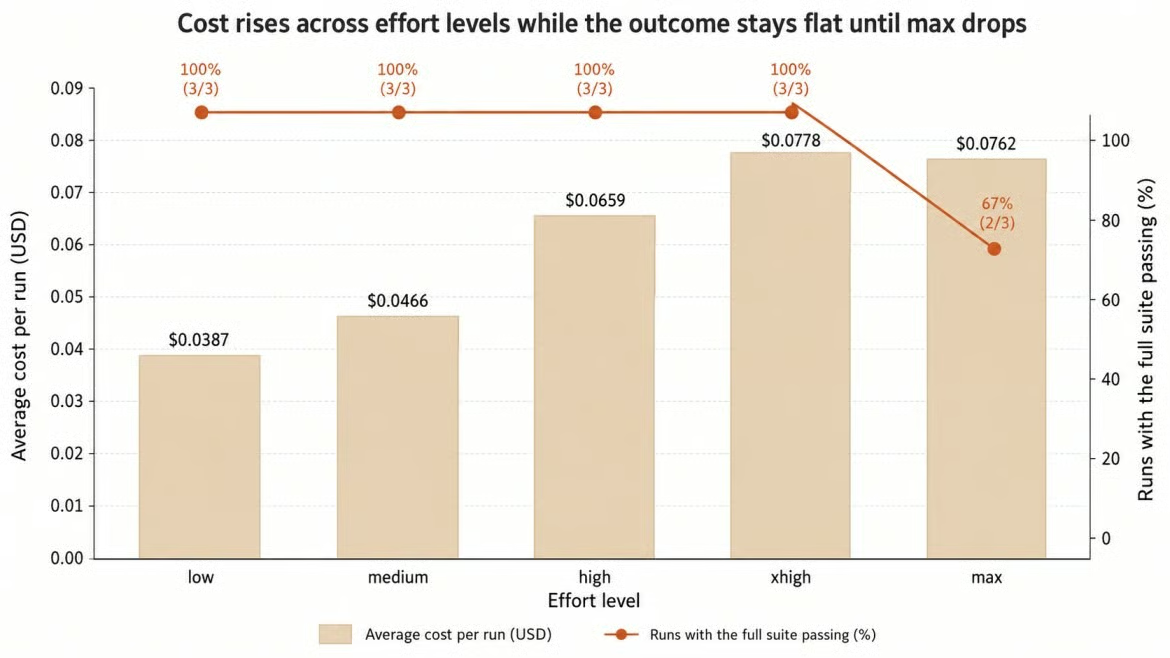
Biaya naik, hasil tidak. Gambar oleh Penulis.
Pembacaan jujurnya adalah tugas ini tidak cukup sulit untuk membedakan puncak tangga dari dasarnya. Beralih dari low ke xhigh menggandakan biaya dan menambah sebelas detik untuk hasil yang identik. Jika ini dikirim ke produksi, saya akan menjalankan low dan menghabiskan selisihnya untuk cakupan tes.
Baris max itu butuh penjelasan. Salah satu dari tiga run-nya mengembalikan laporan valid skema pada giliran pertama tanpa memanggil satu tool pun, dengan root_cause disetel ke "b0" dan fix_summary kosong. Pydantic menerimanya karena bentuknya benar. Pengujian tidak tersentuh. Jika dikecualikan, dua upaya max lainnya memperbaiki bug pada 12,5 pemanggilan tool dan $0,1112 masing-masing, kira-kira tiga kali biaya low.
Saya menganggap kegagalan itu lebih instruktif daripada tabelnya. Skema menjamin struktur, bukan substansi, dan aplikasi yang mempercayai report.status akan mencatat keberhasilan "parsial" pada run yang tidak melakukan apa-apa. Runner menangkapnya karena menjalankan pytest alih-alih mempercayai model. Apa pun yang Anda ambil dari artikel ini, ambil itu. Dan karena tugas Anda bukan milik saya, perlakukan semua ini sebagai metode, bukan hasil.
Caching adalah tempat loop menjadi murah, dan ia bekerja dalam satu run alih-alih lintas tingkat effort. Mengubah nilai effort membatalkan prefix yang di-cache, jadi tiap tingkat membayar biaya pembuatan cachenya sendiri dan tidak ada cache hangat yang dibawa. Di dalam satu run berbeda, karena system prompt dan definisi tool tidak pernah berubah sementara riwayat bertambah.
Field cache_control tingkat atas mengaktifkan caching otomatis, yang menempatkan breakpoint pada blok cacheable terakhir dan memindahkannya maju seiring percakapan bertambah.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    tools=TOOLS,
    cache_control={"type": "ephemeral"},
    messages=messages,
)
Dua giliran berturut-turut menunjukkan efeknya dengan jelas:
turn 1: uncached_input=2  cache_write=1231  cache_read=0     output=26
turn 2: uncached_input=2  cache_write=111   cache_read=1231  output=108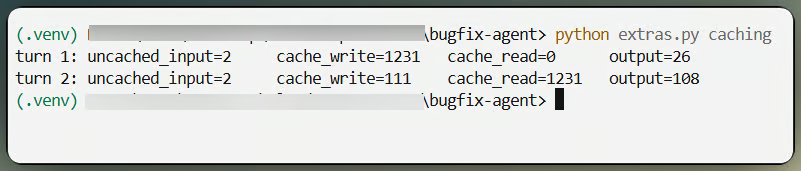
Prefiks yang di-cache dibaca kembali pada giliran berikutnya. Gambar oleh Penulis.
Prefiks stabilnya 1.231 token, nyaman di atas minimum cache yang saya sebutkan sebelumnya. Pada giliran kedua ia dibaca kembali pada sepersepuluh tarif input sementara hanya hasil tool baru yang ditulis. Di seluruh run xhigh penuh, kira-kira 32.600 dari sekitar 36.200 token input berasal dari cache. Caching tidak berpengaruh pada token output.
Berikut pola yang paling berguna saya temukan. Mulai agen dengan tools baca-saja, lalu berikan akses tulis hanya setelah ia mendiagnosis masalah. Jika dilakukan polos, menambahkan tool berarti mengedit array tools, yang berada di bagian depan prefiks cache dan membatalkan cache seluruh percakapan.
Perubahan tool di tengah percakapan menyelesaikannya. Deklarasikan semua tool sejak awal sehingga array tidak pernah berubah, lalu gunakan blok tool_addition dan tool_removal untuk menawarkan atau menarik kembali tool individual dari satu titik ke depan. Blok tersebut berjalan di dalam pesan role: "system", dan pesan system tidak boleh menjadi entri pertama dalam messages. Kedua batasan itu bukan tempat Anda akan mencarinya, dan saya menemukan keduanya seperti yang Anda bayangkan.
withhold_patch = {
    "role": "system",
    "content": [{"type": "tool_removal",
                 "tool": {"type": "tool_reference", "name": "apply_patch"}}],
}
messages = [{"role": "user", "content": task_prompt}, withhold_patch]
Tukar tool_removal dengan tool_addition nanti dan tool kembali. Pada run saya model menghabiskan lima giliran untuk investigasi baca-saja, berhenti dengan diagnosisnya, dan baru kemudian menerima apply_patch, yang digunakan pada giliran enam dan tujuh sebelum suite lulus. Cache tetap bertahan, dengan 25.557 token dibaca ulang. Akses tulis datang setelah buktinya ada, itulah argumen nyata untuk pola tersebut. Dapatkan loop tool tetap berjalan dulu, lalu tambahkan ini.
Tugas agen terdiri dari banyak request, jadi biaya berada pada jumlah total alih-alih respons terakhir. Empat angka kembali pada setiap respons, dan masing-masing ditagih pada tarif berbeda.
def cost_usd(self) -> float:
    return (
        self.input_tokens * 5.00
        + self.output_tokens * 25.00
        + self.cache_creation_input_tokens * 6.25
        + self.cache_read_input_tokens * 0.50
    ) / 1_000_000
Total input adalah jumlah dari ketiga field input, karena input_tokens saja hanya menghitung apa yang jatuh setelah breakpoint cache terakhir, yang sering menyebabkan pelaporan kurang. Token output mencakup thinking dan panggilan tool serta teks yang terlihat, dan dengan tarif lima kali lipat input, mereka mendominasi setiap run di atas.
Satu hal yang perlu diperhatikan saat Anda menskalakan: blok thinking dari giliran sebelumnya tetap berada di konteks dan ditagih lagi pada setiap giliran berikutnya, sehingga loop panjang biayanya lebih besar daripada yang disarankan hasil tool. Untuk evaluasi offline, Batch API memangkas dua tarif tersebut menjadi setengah. Fast mode bergerak sebaliknya pada $10 dan $50 per sejuta token, sebagai pratinjau riset dengan akses terbatas.
Ada juga cara untuk membatasi seluruh loop alih-alih satu request. Task budgets memberikan model alokasi nasihat dan hitung mundur untuk disesuaikan, dalam beta di balik task-budgets-2026-03-13, dengan batas bawah 20.000 token. Saya sempat menulis bagian tentang itu dan menghapusnya, karena saya tidak mengukur perbedaan di sini dan non-hasil tidak butuh tiga paragraf. Harapkan hal yang sama kapan pun pekerjaan tidak pernah mendekati anggaran.
Sebagian besar kode Claude yang ada berjalan setelah Anda mengubah string model. Kegagalan mengelompok di beberapa tempat, dan kita mengenai semuanya saat membangun agen, jadi perlakukan ini sebagai daftar periksa alih-alih penjelasan baru. Panduan migrasi Anthropic memuat versi lengkap.
response.content[0] kini biasanya blok thinking, bukan text
Loop yang membangun ulang pesan asisten dari blok terpilih menjatuhkan thinking dan redacted_thinking
max_tokens yang dituning untuk model tanpa thinking akan terpotong, dan apa pun di atas 21.333 harus streaming
Menonaktifkan thinking mengembalikan 400 pada effort xhigh atau max
Nilai non-bawaan temperature, top_p, dan top_k ditolak
Instruksi verifikasi yang dibawa dari prompt lama membuat Opus 5 memverifikasi berlebihan
Priority Tier dan tool fetch web tidak tersedia di Opus 5
Effort layak disapu ulang alih-alih nilai yang Anda tuning untuk model sebelumnya
Yang terakhir itulah poin yang paling saya perjuangkan, dan artikel ini adalah argumennya. Pengaturan yang saya tuning ternyata menjadi yang termurah di tangga.
Dua hal berubah sebelum ini dikirim. Kode yang dihasilkan agen adalah kode yang tidak tepercaya, jadi lapisan tool berada di lingkungan terisolasi dengan batas CPU, memori, dan waktu, dan patch yang dihasilkan harus di depan manusia sebelum digabung.
Yang kedua kurang jelas. Opus 5 menjalankan pengklasifikasi keamanan, dan agen yang membaca kode yang berdekatan dengan keamanan berada dekat batas "cyber", namun penolakan datang sebagai HTTP 200 dengan stop_reason: "refusal", sehingga pemantauan yang dibangun di atas tingkat 5xx tidak pernah melihatnya. Instrumentasikan penolakan secara terpisah, bercabang pada stop_reason alih-alih field stop_details di bawahnya, yang bisa null, dan matikan fallbacks selama benchmark agar Anda tahu model mana yang menjawab.
Gunakan Opus 5 ketika jawaban yang salah biayanya lebih besar daripada request-nya. Debugging multi-file, analisis akar penyebab, tinjauan seluruh repositori, loop tool yang panjang, dan perencanaan migrasi semuanya cocok, dan tangga effort memungkinkan Anda menjalankan kasus rutin dengan murah dan meningkatkan saat sulit.
Lewati untuk pemformatan, klasifikasi, dan pekerjaan volume tinggi berkompleksitas rendah, di mana Claude Sonnet 5 adalah pertukaran yang lebih baik. Lewati juga untuk apa pun yang tidak bisa Anda validasi, karena semua nilai di sini datang dari suite tes yang menjawab dengan jujur. Membayar dua kali lipat untuk Fable 5 hanya berfaedah pada pekerjaan yang saya tandai di atas.
Saran perutean yang benar-benar akan saya berikan adalah mengukur tingkat kesulitan tugas dan biarkan itu memilih tingkat effort, alih-alih mengirim semuanya ke puncak tangga karena terdengar lebih aman. Itu tidak lebih aman. Seperti yang ditunjukkan benchmark, itu adalah cara mahal untuk mendapatkan patch yang sama, dan sekali waktu menghasilkan laporan tentang kehampaan.
Aplikasi Streamlit di repo memungkinkan Anda menjalankannya sendiri: pilih tingkat effort, saksikan penalaran dan pemanggilan tool datang secara live, dan baca token, biaya, dan latensi dari run yang sama. Ia mereset repositori dengan cara yang sama seperti benchmark, sehingga tabel yang dibangun adalah pengukuran Anda, bukan milik saya. Rekaman layar di bawah menunjukkan alurnya.
Belajar bersama DataCamp
Program
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt



