
Lộ trình
Cơ bản về Trí tuệ Nhân tạo
10 giờ
Gửi mã cho mô hình là phần dễ. Phần khó là mọi thứ xung quanh: quyết định mô hình được đọc những tệp nào, thực thi các lệnh gọi công cụ mà nó yêu cầu, biết khi nào nên dừng, và chọn mức độ suy luận đáng để chi trả.
Claude Opus 5 khiến quyết định cuối cùng đó trở nên tường minh. Tham số effort có năm mức, và Anthropic cho rằng chi nhiều effort hơn sẽ có lợi đúng ở công việc mà một agent viết mã thực hiện. Khẳng định đó dễ lặp lại nhưng khó kiểm chứng, nên tôi muốn một câu trả lời hẹp. Trên một lỗi thật, với bài kiểm thử chỉ pass hoặc fail, tăng effort có tạo ra bản sửa tốt hơn không?
Để tìm hiểu, chúng ta sẽ xây một agent sửa lỗi nhỏ và chạy cùng một nhiệm vụ ở mọi mức effort. Trong quá trình đó, chúng ta sẽ đề cập:
Gọi claude-opus-5 và phân tích phản hồi mở đầu bằng khối thinking
Kiểm soát độ sâu suy luận với effort và đặt kích thước max_tokens phù hợp quanh nó
Chạy vòng lặp công cụ đa lượt có thể vượt qua các khối thinking và lỗi công cụ
Trả về báo cáo Pydantic đã được kiểm tra hợp lệ thay vì văn bản tự do
Đo lường tỉ lệ thành công, token, độ trễ và chi phí trên cả năm mức effort
Cắt giảm chi phí input lặp lại bằng prompt caching trong một lần chạy
Tiết lộ trước cái kết: với nhiệm vụ này, thiết lập rẻ nhất đã sửa lỗi trong mọi lần chạy, và không mức nào cao hơn làm tốt hơn. Kết quả đó chỉ đúng cho repository này, và phần hữu ích hơn là bộ đo đạc đã tạo ra nó.
Agent nhận một báo cáo lỗi và quyền truy cập có kiểm soát vào một repository Python nhỏ, rồi xử lý vấn đề: liệt kê tệp, đọc các tệp liên quan, chạy bộ kiểm thử, vá, chạy lại và báo cáo.
Claude không chạm vào hệ thống tệp. Nó phát ra một yêu cầu công cụ với tên và đối số JSON, và mã Python của chúng ta quyết định có chạy hay không và sẽ gửi về gì. Ranh giới đó chính là toàn bộ mô hình bảo mật, đáng ghi nhớ mỗi khi agent có vẻ như đang tự hành động.
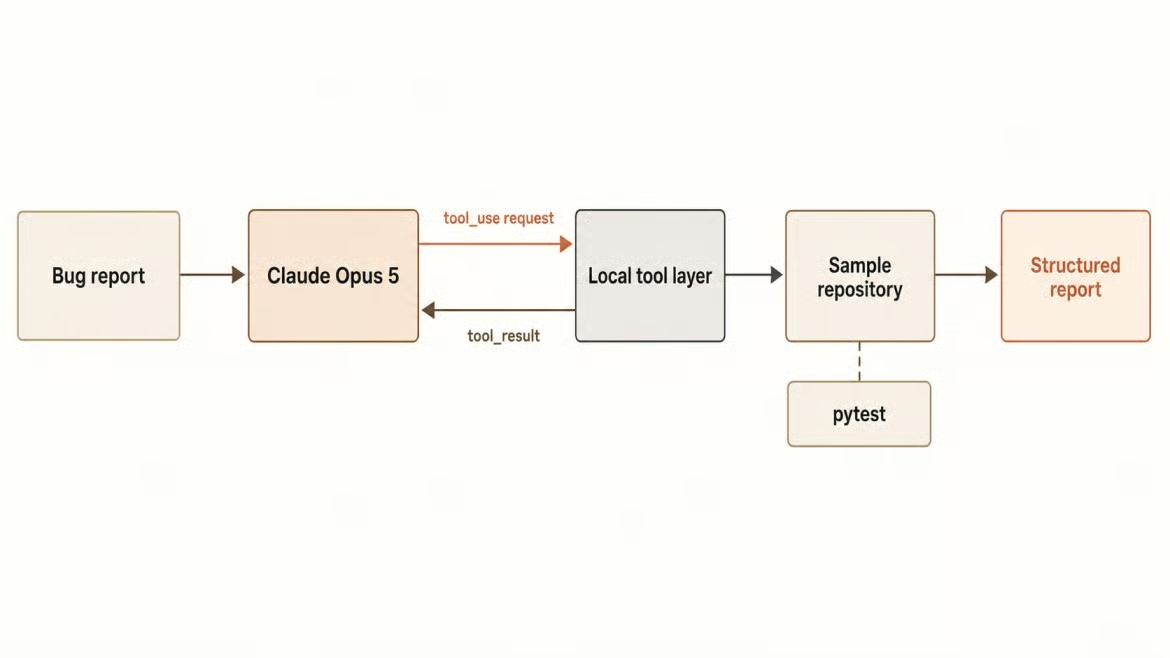
Báo cáo lỗi đi qua các công cụ được kiểm soát. Hình: Tác giả.
Bạn cần Python 3.10 trở lên, một khóa API có quyền truy cập claude-opus-5, Git để reset repository mẫu, và đủ quen thuộc với pytest để đọc lỗi. Dự án hoàn chỉnh nằm trên GitHub nếu bạn muốn đọc trọn gói; các phần dưới sẽ xây dựng từng mảnh.
git clone https://github.com/KhalidAbdelaty/claude-opus-5-api-tutorial.git
cd claude-opus-5-api-tutorial
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install -r requirements.txt
Sao chép .env.example thành .env và đặt khóa của bạn vào đó. Khóa phải nằm ở phía máy chủ của bất kỳ thứ gì bạn xây từ đây, không bao giờ ở thân yêu cầu và không bao giờ trong log.
# agent/config.py
MODEL = "claude-opus-5"

PRICE_INPUT = 5.00
PRICE_OUTPUT = 25.00
PRICE_CACHE_WRITE_5M = 6.25
PRICE_CACHE_READ = 0.50

MAX_TOKENS = 32_000
MAX_ITERATIONS = 10
Bốn đơn giá đó sẽ quan trọng về sau. Tính tất cả theo mức input cơ bản sẽ đánh giá thấp chi phí ghi cache đi một phần tư và thổi phồng chi phí đọc cache lên gấp mười, kiểu sai lệch khiến một benchmark trông tốt hơn thực tế.
Một so sánh công bằng cần một lỗi thất bại theo cùng một cách mỗi lần, vì vậy tôi viết fixture trước khi viết agent. Repository mẫu là một dịch vụ tính phí với helper ngày dùng chung, module đăng ký thuê bao và module hóa đơn. Helper mô tả một hành vi nhưng lại triển khai hành vi khác.
# billing/timeutils.py
def days_between(start: datetime, end: datetime) -> int:
    """Return the number of days from start to end, counting a partial day as a full day.

    Billing treats any remaining fraction of a day as a whole day, so a customer
    with four hours left has one day remaining, not zero.
    """
    delta = end - start
    return delta.days
timedelta.days sẽ làm tròn xuống, vì vậy mười giờ dùng thử còn lại sẽ báo là không còn ngày nào. Hai module gọi helper này, nên một lỗi lộ ra thành hai lỗi không liên quan: test_trial_active_on_final_day khóa khách hàng sớm, và test_prorated_credit_counts_partial_day hoàn tiền thiếu một ngày.
Báo cáo lỗi chỉ nhắc đến triệu chứng đầu tiên, giống như một phiếu hỗ trợ. Cũng có một cái bẫy: vá is_trial_active để chấp nhận zero sẽ làm bài test được báo cáo pass và để bài test hóa đơn vẫn hỏng, vì vậy một bản vá nông sẽ bị phát hiện. Trạng thái gốc là hai lỗi và bốn pass, đã commit vào Git để git checkout -- . khôi phục lại giữa các lần chạy.
Trước khi có công cụ nào, hãy xác nhận việc xác thực và phân tích phản hồi. Messages API cần một chuỗi model, một max_tokens bắt buộc, và một mảng messages.
from anthropic import Anthropic
from dotenv import load_dotenv

load_dotenv()
client = Anthropic()

response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "A pytest assertion fails with: assert 0 == 1. What should I check first?"}],
)

print([block.type for block in response.content])
text = next((b.text for b in response.content if b.type == "text"), "")
Lệnh print đầu tiên là trọng tâm của bài tập. Nó trả về ['thinking', 'text'], vì thinking bật mặc định và khối thinking đến trước.
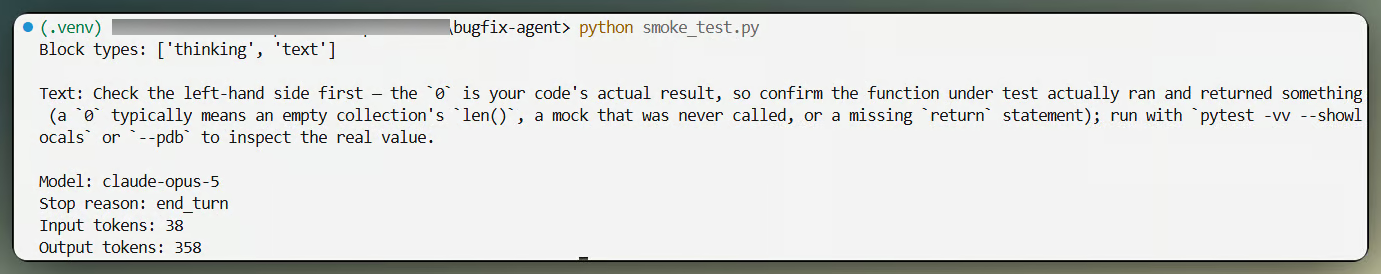
Cuộc gọi đầu trả về thinking rồi text. Hình: Tác giả.
Bất kỳ mã nào cố gắng truy cập response.content[0].text sẽ phát sinh AttributeError trên Opus 5. Hãy lọc theo kiểu block. Đồng thời bỏ temperature, top_p và top_k khỏi mọi request mà bạn đang port, vì giá trị khác mặc định sẽ trả về 400 trên model này.
Thinking và effort là hai nút điều khiển thường bị nhầm lẫn. Thinking là việc mô hình suy luận trước khi trả lời hay không, điều mà cuộc gọi đầu tiên đã cho thấy. Effort là mức độ suy luận nó thực hiện, trên mọi token đầu ra, bao gồm cả lệnh gọi công cụ. Các tiểu mục dưới đây nói về nấc thang effort, trần token mà nó chạm và một kết hợp duy nhất bị API từ chối.
Effort được đặt trong output_config, và không cần beta header.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    output_config={"effort": "xhigh"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": bug_report}],
)
Mặc định của API là high, và truyền "high" tường minh cũng như bỏ qua không truyền. Anthropic gợi ý bắt đầu ở xhigh cho tác vụ agent viết mã và lưu ý low và medium mạnh hơn trên Opus 5 so với các model Opus trước. Hướng dẫn của họ cũng cảnh báo rằng max có thể suy nghĩ quá mức ở tác vụ đơn giản, điều hóa ra là phần thú vị nhất tôi đo được.
Như đã nói, max_tokens bao gồm cả suy luận lẫn câu trả lời, nên một giá trị tinh chỉnh cho mô hình không có thinking sẽ khiến Opus 5 bị cắt giữa nhiệm vụ. Cũng có một ràng buộc dễ khiến mọi người mắc lỗi.
client.messages.create(model="claude-opus-5", max_tokens=32000, messages=[...])
# ValueError: Streaming is required for operations that may take longer than 10 minutes.
Các SDK từ chối yêu cầu không streaming khi max_tokens vượt 21.333. Đây là kiểm tra phía client chứ không phải quy tắc API, nên cách khắc phục là stream: vòng lặp gọi client.messages.stream() và đọc get_final_message(), và mức 32.000 vẫn dùng được. Tôi chọn mức này vì còn dư địa cho các mức effort cao hơn.
Bạn có thể tắt thinking, nhưng chỉ ở effort high hoặc thấp hơn. Kết hợp với xhigh hoặc max sẽ bị từ chối ngay.
effort=high  accepted, blocks=['text']
effort=xhigh HTTP 400: output_config.effort 'xhigh' is not supported when thinking
             is disabled on this model. Use effort 'high' or below, or enable thinking.
Tắt thinking bị từ chối ở effort trên high. Hình: Tác giả.
Lưu ý danh sách block ở cuộc gọi được chấp nhận: chỉ có ['text'] , khối thinking biến mất. Giảm effort vốn dĩ là cách kiểm soát chi phí an toàn hơn, nên tôi giữ thinking bật suốt quá trình.
Công cụ biến mô hình thành agent, và cũng là nơi agent thôi còn an toàn. Mỗi định nghĩa gồm tên, mô tả và schema input JSON, và mỗi cái đều tốn token đầu vào ở mọi request. Tôi giữ bộ công cụ ở mức năm cái, nhóm dưới đây theo mức độ rủi ro có thể gây ra.
list_files và search_code cho phép mô hình tìm tệp liên quan mà không phải dán toàn bộ repository vào prompt. read_file kéo một tệp theo đường dẫn tương đối với repository, và đó là nơi đặt các kiểm tra an toàn.
def _resolve(relative_path: str) -> Path:
    """Resolve a repository-relative path, refusing anything outside the repo."""
    candidate = Path(relative_path)
    if candidate.is_absolute():
        raise ToolError("Absolute paths are not allowed.")

    resolved = (REPO_ROOT / candidate).resolve()
    if resolved != REPO_ROOT.resolve() and REPO_ROOT.resolve() not in resolved.parents:
        raise ToolError("Path escapes the repository.")
    return resolved
Hãy resolve trước khi so sánh, nếu không ../../.ssh/id_rsa sẽ đi thẳng ra khỏi sandbox của bạn. Tệp trả về bị giới hạn 8.000 ký tự, vì mọi kết quả công cụ đều được gửi lại trong mọi request sau và bạn sẽ trả tiền cho nó mỗi lần.
run_tests không nhận tham số. Lệnh được cố định trong cấu hình, nên mô hình không có cách nào yêu cầu lệnh shell tùy ý.
def run_tests() -> str:
    completed = subprocess.run(
        [sys.executable, "-m", "pytest", "tests", "-q", "--no-header", "--tb=short"],
        cwd=REPO_ROOT, capture_output=True, text=True, timeout=120,
    )
    output = (completed.stdout + completed.stderr).strip()
    return f"exit_code: {completed.returncode}\n{output[:3000]}"
Danh sách trắng chỉ có một mục là danh sách trắng mạnh nhất có thể. Nếu sau này cần thêm lệnh, hãy thêm dưới dạng các công cụ riêng có tên, không phải một đối số command .
Với thao tác ghi tôi dùng thay thế chuỗi chính xác thay vì unified diff, vì diff dễ hỏng do khoảng trắng theo cách lãng phí một lượt. Công cụ từ chối tệp không phải Python, giới hạn kích thước patch và từ chối mơ hồ.
occurrences = source.count(old_text)
if occurrences == 0:
    raise ToolError("old_text was not found in the file. Read the file and retry.")
if occurrences > 1:
    raise ToolError(f"old_text appears {occurrences} times. Include more context.")
Những lỗi đó được gửi lại cho Claude như kết quả công cụ thay vì làm sập vòng lặp, và mô hình sẽ đọc rồi thử lại với thêm ngữ cảnh.
Vòng lặp khá ngắn khi các mảnh ghép đã sẵn sàng. Gửi nhiệm vụ kèm định nghĩa công cụ, kiểm tra các block trả về, thực thi những gì được yêu cầu, gửi kết quả lại, và lặp cho đến khi mô hình ngừng yêu cầu.
for iteration in range(1, max_iterations + 1):
    with client.messages.stream(
        model=MODEL,
        max_tokens=32_000,
        system=SYSTEM_PROMPT,
        tools=TOOLS,
        output_config={"effort": effort},
        output_format=RepairReport,
        cache_control={"type": "ephemeral"},
        messages=messages,
    ) as stream:
        response = stream.get_final_message()

    usage.add(response.usage)
    messages.append({"role": "assistant", "content": response.content})

    if response.stop_reason != "tool_use":
        break

    tool_results = []
    for block in response.content:
        if block.type == "tool_use":
            output, is_error = execute(block.name, dict(block.input or {}))
            tool_results.append({
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": output,
                "is_error": is_error,
            })
    messages.append({"role": "user", "content": tool_results})
Ba dòng ở đó là then chốt. Thêm toàn bộ response.content, thay vì chỉ các block bạn quan tâm, giữ cho thinking và redacted_thinking còn nguyên; lọc bỏ chúng khiến mô hình khởi động lại suy luận sau mỗi kết quả công cụ. Các block tool_result phải đứng đầu trong thông điệp của user, vì nếu có text trước chúng sẽ trả về 400. Và is_error báo cho Claude biết một công cụ đã thất bại, tốt hơn là một chuỗi rỗng im lặng.
System prompt giữ nguyên giữa mọi lần chạy để so sánh có ý nghĩa. Nó yêu cầu mô hình điều tra trước khi sửa, tìm nguyên nhân gốc thay vì triệu chứng được báo, thực hiện thay đổi nhỏ nhất có hiệu quả, và coi việc chạy bộ kiểm thử là một phần của nhiệm vụ. Điều nó không nhắc đến là "hãy kiểm tra lại công việc của bạn." Opus 5 tự xác minh, và hướng dẫn của Anthropic là bỏ những chỉ dẫn đó khi chuyển đổi, vì chúng chỉ thêm độ trễ và token mà không cải thiện bản vá.
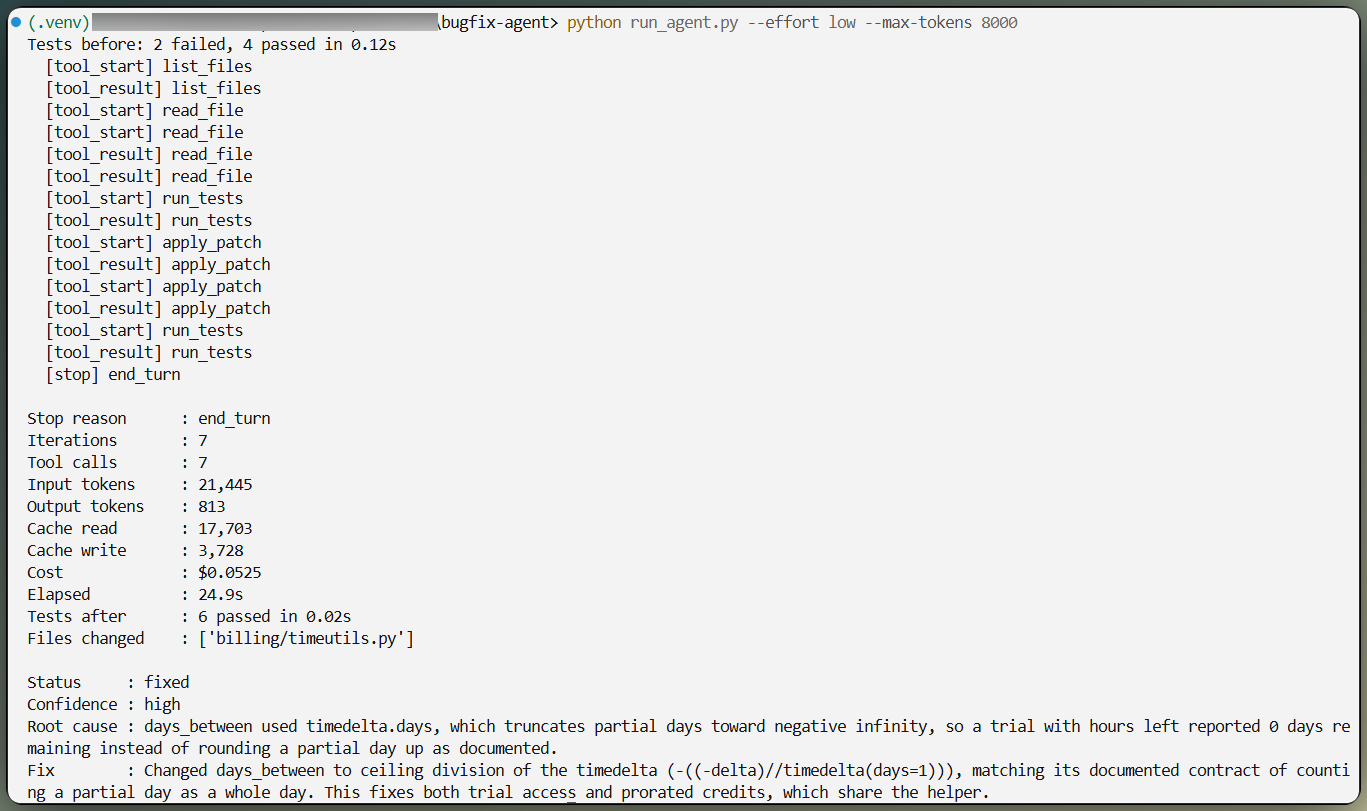
Agent kiểm tra, vá, rồi chạy lại kiểm thử. Hình: Tác giả.
Văn bản tự do là đủ cho một lần chạy. Với benchmark phải so sánh nhiều lần, tôi muốn một đối tượng có kiểu, nên vòng lặp truyền một model Pydantic làm output_format và SDK biến nó thành JSON schema với giải mã có ràng buộc.
class RepairReport(BaseModel):
    status: Literal["fixed", "partial", "not_fixed"]
    root_cause: str
    files_inspected: list[str]
    files_changed: list[str]
    fix_summary: str
    tests_before: str
    tests_after: str
    remaining_risks: list[str]
    confidence: Literal["low", "medium", "high"]

    @field_validator("status", "confidence", mode="before")
    @classmethod
    def _normalize_case(cls, value):
        """Enum capitalization is not guaranteed, so fold it before validating."""
        return value.strip().lower() if isinstance(value, str) else value
Validator này rất đáng giá. Structured outputs không đảm bảo viết hoa enum, nên một schema kỳ vọng "high" có thể nhận "High" mà không báo lỗi và không có stop reason đặc biệt, và kiểm tra nghiêm ngặt với Literal sẽ từ chối một phản hồi vốn dĩ là đúng về cơ bản.
Giữ độ trễ và chi phí ra khỏi schema này. Mô hình báo cáo những gì nó kết luận; trình chạy đo những gì đã xảy ra bằng cách chạy lại pytest và đọc git diff. Tôi đã mừng vì sự tách biệt đó về sau, vì lý do mà benchmark sẽ làm rõ.
Đây là thí nghiệm mà hướng dẫn này sinh ra để làm: cùng một lỗi, cùng một prompt, cùng các công cụ, ở các mức low, medium, high, xhigh, và max. Đầu ra không tất định, và các tham số sampling bị từ chối trên model này, nên lặp lại mỗi mức là cách kiểm soát duy nhất tôi có.
Mỗi lần chạy bắt đầu từ commit gốc sạch đó, rồi đo bộ kiểm thử trước và sau. Báo cáo lỗi, system prompt, định nghĩa công cụ, trần số lượt và max_tokens đều giống nhau, chỉ khác chuỗi effort. Tôi chạy mỗi mức ba lần.
Một bộ bảo vệ ngân sách bao quanh toàn bộ quá trình, cộng dồn chi phí thực với bốn mức giá sau mỗi request và dừng ở một trần. Vòng lặp agent rất dễ vượt chi, và điều kiện dừng do bạn kiểm soát tốt hơn là phát hiện con số sau đó.
Đây là trung bình trên ba lần chạy mỗi mức, đo ngày 26 tháng 7, 2026.
|
Effort |
Bộ kiểm thử pass |
Số lần gọi công cụ |
Token đầu ra |
Thời gian đến đầu ra đầu tiên |
Tổng thời gian |
Chi phí mỗi lần chạy |
|
|
3/3 |
8.0 |
827 |
2.9s |
24s |
$0.0387 |
|
|
3/3 |
8.0 |
1,008 |
2.7s |
26s |
$0.0466 |
|
|
3/3 |
10.0 |
1,352 |
2.9s |
29s |
$0.0659 |
|
|
3/3 |
11.3 |
1,546 |
2.8s |
35s |
$0.0778 |
|
|
2/3 |
8.3 |
1,787 |
6.6s |
38s |
$0.0762 |
Mọi mức độ đã tương tác với repository đều tìm ra cùng một nguyên nhân gốc trong helper ngày dùng chung và sửa bằng khoảng bốn dòng trong một tệp. Không mức nào mắc bẫy và vá phần kiểm tra trial. Toàn bộ ma trận mười lăm lượt tốn $0,92.
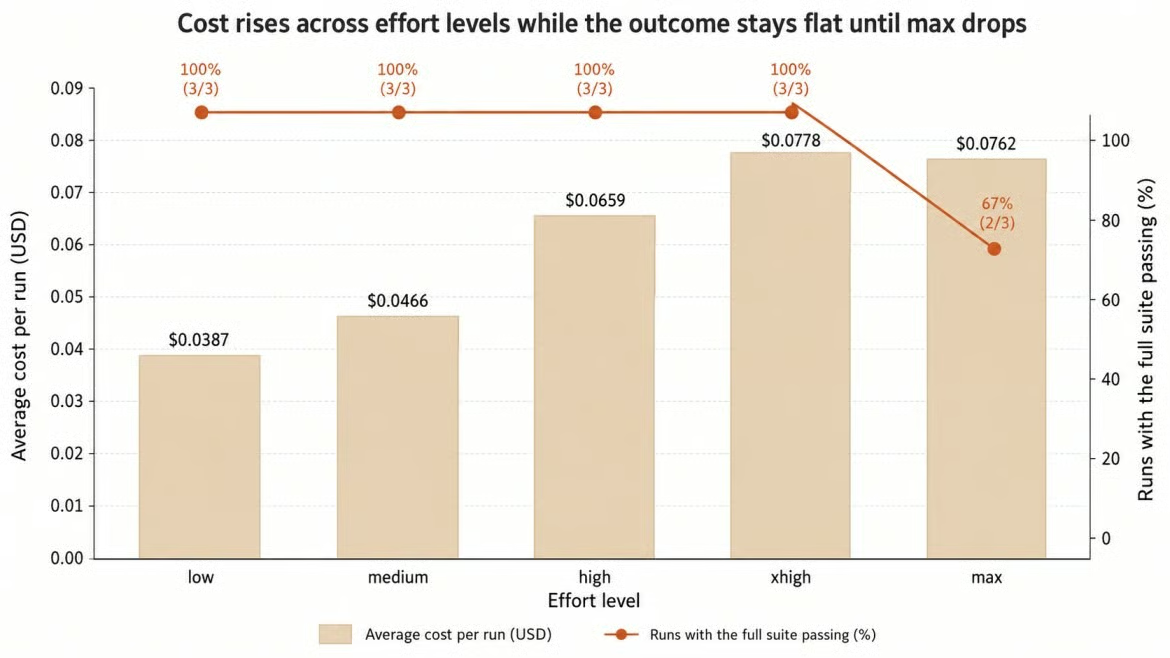
Chi phí tăng nhưng kết quả không đổi. Hình: Tác giả.
Cách đọc trung thực là nhiệm vụ này không đủ khó để phân biệt đầu và cuối của thang effort. Từ low lên xhigh đã nhân đôi chi phí và thêm mười một giây cho một kết quả y hệt. Nếu triển khai, tôi sẽ chạy low và dùng phần chênh đó để tăng độ phủ kiểm thử.
Dòng max cần lời giải thích. Một trong ba lần chạy trả về một báo cáo hợp lệ theo schema ngay ở lượt đầu mà không gọi công cụ nào, với root_cause đặt thành "b0" và fix_summary trống. Pydantic chấp nhận vì hình dạng dữ liệu đúng. Tests không bị đụng đến. Loại trừ trường hợp đó, hai lần thử max còn lại sửa lỗi với trung bình 12,5 lần gọi công cụ và $0,1112 mỗi lần, xấp xỉ gấp ba chi phí của low.
Tôi thấy lỗi đó mang tính hướng dẫn hơn cả bảng biểu. Một schema đảm bảo cấu trúc, không đảm bảo nội dung, và một ứng dụng tin vào report.status có thể đã log một thành công "partial" cho một lượt chạy không làm gì cả. Trình chạy đã bắt được vì nó chạy pytest thay vì tin vào mô hình. Dù bạn rút ra điều gì, hãy rút ra điều đó. Và vì nhiệm vụ của bạn không phải của tôi, hãy coi tất cả như một phương pháp hơn là một kết quả.
Caching là nơi vòng lặp trở nên rẻ, và nó hoạt động trong một lần chạy chứ không phải giữa các mức effort. Thay đổi giá trị effort sẽ làm mất hiệu lực tiền tố đã cache, nên mỗi mức tự trả chi phí tạo cache và không chia sẻ cache ấm. Bên trong một lần chạy thì khác, vì system prompt và định nghĩa công cụ không đổi trong khi lịch sử dài ra.
Trường cache_control ở cấp cao nhất bật tự động caching, đặt điểm ngắt ở block cacheable cuối cùng và dịch chuyển nó lên khi hội thoại lớn dần.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    tools=TOOLS,
    cache_control={"type": "ephemeral"},
    messages=messages,
)
Hai lượt liên tiếp cho thấy hiệu ứng rõ ràng:
turn 1: uncached_input=2  cache_write=1231  cache_read=0     output=26
turn 2: uncached_input=2  cache_write=111   cache_read=1231  output=108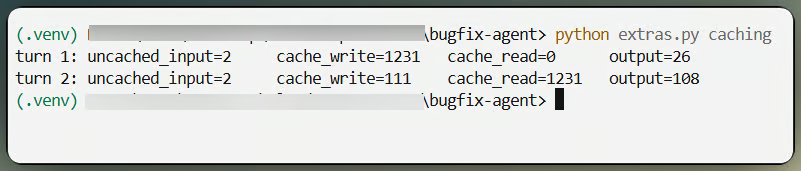
Tiền tố đã cache được đọc lại ở lượt sau. Hình: Tác giả.
Tiền tố ổn định là 1.231 token, vượt thoải mái mức tối thiểu cache mà tôi đã nêu. Ở lượt hai, nó được đọc lại với giá bằng một phần mười mức input, trong khi chỉ kết quả công cụ mới được ghi. Trong một lượt xhigh đầy đủ, khoảng 32.600 trong số khoảng 36.200 token input đến từ cache. Caching không tác dụng với token đầu ra.
Đây là mẫu tôi thấy hữu ích nhất. Khởi động agent với công cụ chỉ-đọc, rồi chỉ cấp quyền ghi sau khi đã chẩn đoán vấn đề. Làm ngây thơ, thêm một công cụ nghĩa là sửa mảng tools, vốn nằm ở đầu tiền tố đã cache và làm mất hiệu lực cache của cả cuộc hội thoại.
Thay đổi công cụ giữa hội thoại giải quyết điều đó. Khai báo tất cả công cụ ngay từ đầu để mảng không đổi, rồi dùng các block tool_addition và tool_removal để cấp hoặc rút từng công cụ kể từ một thời điểm. Các block này đi trong một thông điệp role: "system", và một system message không thể là mục đầu tiên trong messages. Ràng buộc nào cũng không nằm ở nơi bạn nghĩ, và tôi phát hiện cả hai theo đúng cách bạn tưởng tượng.
withhold_patch = {
    "role": "system",
    "content": [{"type": "tool_removal",
                 "tool": {"type": "tool_reference", "name": "apply_patch"}}],
}
messages = [{"role": "user", "content": task_prompt}, withhold_patch]
Đổi tool_removal thành tool_addition về sau và công cụ sẽ quay lại. Trong lượt chạy của tôi, mô hình dành năm lượt cho điều tra chỉ-đọc, dừng lại với chẩn đoán, rồi mới nhận apply_patch, mà nó dùng ở lượt sáu và bảy trước khi bộ kiểm thử pass. Cache giữ nguyên, với 25.557 token được đọc lại. Quyền ghi đến sau khi bằng chứng đã đầy đủ, đó mới là lý do thực sự cho mẫu này. Hãy làm cho vòng lặp công cụ cố định hoạt động trước, rồi mới thêm phần này.
Một tác vụ agent gồm nhiều request, nên chi phí nằm ở tổng chứ không phải phản hồi cuối. Bốn con số trả về ở mỗi phản hồi, và mỗi số tính phí theo một mức khác nhau.
def cost_usd(self) -> float:
    return (
        self.input_tokens * 5.00
        + self.output_tokens * 25.00
        + self.cache_creation_input_tokens * 6.25
        + self.cache_read_input_tokens * 0.50
    ) / 1_000_000
Tổng input là tổng của cả ba trường input, vì input_tokens một mình chỉ tính phần sau điểm ngắt cache cuối cùng, một cách phổ biến làm báo cáo thiếu. Token đầu ra bao gồm thinking và lệnh gọi công cụ cũng như text hiển thị, và ở mức giá gấp năm lần input chúng chi phối mọi lượt chạy ở trên.
Một điều cần chú ý khi bạn mở rộng: các khối thinking của lượt trước vẫn ở trong ngữ cảnh và bị tính phí lại ở mọi lượt sau, vì vậy các vòng lặp dài tốn nhiều hơn những gì kết quả công cụ gợi ý. Với đánh giá ngoại tuyến, Batch API giảm một nửa cả hai mức. Fast mode đi theo hướng ngược lại ở $10 và $50 cho mỗi triệu token, như một bản xem trước phục vụ nghiên cứu có kiểm soát quyền truy cập.
Cũng có cách đặt trần cho cả vòng lặp thay vì một request. Task budgets đưa cho mô hình một hạn mức tư vấn và bộ đếm ngược để điều tiết, đang beta sau task-budgets-2026-03-13, với sàn 20.000 token. Tôi đã viết một mục về chúng rồi cắt bỏ, vì tôi không đo được khác biệt ở đây và một kết quả âm thì không cần ba đoạn văn. Hãy kỳ vọng điều tương tự bất cứ khi nào công việc không chạm gần trần ngân sách.
Hầu hết mã Claude hiện có sẽ chạy sau khi bạn đổi chuỗi model. Lỗi tập trung ở vài chỗ, và ta đã chạm hết khi xây agent, nên hãy coi đây là danh sách kiểm thay vì giải thích mới. Hướng dẫn di trú của Anthropic có phiên bản đầy đủ.
response.content[0] giờ thường là khối thinking, không phải text
Vòng lặp dựng lại thông điệp assistant từ các block chọn lọc sẽ làm rơi thinking và redacted_thinking
max_tokens tinh chỉnh cho mô hình không thinking sẽ bị cắt, và bất kỳ giá trị nào trên 21.333 phải stream
Tắt thinking sẽ trả về 400 ở effort xhigh hoặc max
Các giá trị temperature, top_p và top_k không mặc định sẽ bị từ chối
Chỉ dẫn xác minh mang từ prompt cũ sang khiến Opus 5 xác minh quá mức
Priority Tier và công cụ web fetch không có trên Opus 5
Effort xứng đáng được rà soát lại thay vì dùng lại giá trị đã tinh chỉnh cho model trước
Điểm cuối cùng là điều tôi muốn nhấn mạnh nhất, và bài viết này chính là lập luận. Thiết lập tôi tinh chỉnh hóa ra lại là rẻ nhất trên thang effort.
Có hai điều cần thay đổi trước khi triển khai. Mã do agent tạo ra là mã không đáng tin cậy, nên lớp công cụ phải nằm trong môi trường cách ly với giới hạn CPU, bộ nhớ và thời gian, và một bản vá được tạo phải đến tay con người trước khi merge.
Điều thứ hai ít hiển nhiên hơn. Opus 5 chạy các bộ phân loại an toàn, và một agent đọc mã gần với lĩnh vực bảo mật nằm sát ranh giới "cyber", nhưng một lần từ chối đến dưới dạng HTTP 200 với stop_reason: "refusal", nên hệ thống giám sát dựa trên tỉ lệ 5xx sẽ không thấy. Hãy đo lường các lần từ chối riêng, rẽ nhánh theo stop_reason thay vì các trường stop_details bên dưới, vốn có thể là null, và tắt fallbacks trong benchmark để biết model nào đã trả lời.
Hãy dùng Opus 5 khi một câu trả lời sai còn tốn kém hơn chi phí request. Gỡ lỗi đa tệp, phân tích nguyên nhân gốc, rà soát toàn repository, vòng lặp công cụ dài và lập kế hoạch di trú đều phù hợp, và thang effort cho phép bạn xử lý trường hợp thường nhật với chi phí thấp và leo thang cho ca khó.
Bỏ qua nó cho các tác vụ định dạng, phân loại, và khối lượng lớn - độ phức tạp thấp, nơi Claude Sonnet 5 là lựa chọn tốt hơn. Cũng bỏ qua cho bất cứ thứ gì bạn không thể kiểm chứng, vì toàn bộ giá trị ở đây đến từ một bộ kiểm thử trả lời trung thực. Trả gấp đôi cho Fable 5 chỉ đáng ở những công việc tôi đã nêu ở trên.
Lời khuyên định tuyến tôi thực sự muốn đưa ra là hãy đo độ khó của nhiệm vụ và để nó chọn mức effort, thay vì gửi mọi thứ lên đỉnh thang vì nghe có vẻ an toàn. Nó không an toàn hơn. Như benchmark đã chỉ ra, đó là cách đắt tiền để nhận cùng một bản vá, và từng có lần nó tạo ra một báo cáo về hư vô.
Ứng dụng Streamlit trong repo cho phép bạn tự chạy: chọn mức effort, xem suy luận và lệnh gọi công cụ đến theo thời gian thực, và đọc token, chi phí, độ trễ từ cùng một lượt chạy. Nó reset repository giống như benchmark, nên bảng mà nó tạo là phép đo của bạn chứ không phải của tôi. Video ghi màn hình dưới đây cho thấy quy trình.
Học với DataCamp
Lộ trình
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
