
Leerpad
AI-basisprincipes
10 uur
Code naar een model sturen is het makkelijke deel. Het werk zit eromheen: bepalen welke bestanden het mag lezen, de tool-calls uitvoeren waar het om vraagt, weten wanneer het moet stoppen en kiezen hoeveel redenering je wilt betalen.
Claude Opus 5 maakt die laatste keuze expliciet. De effort-parameter heeft vijf instellingen, en Anthropic zegt dat meer uitgeven precies loont op het werk dat een coding agent doet. Die claim is makkelijk te herhalen en lastiger te controleren, dus ik wilde een smal antwoord. Op één echte bug, met tests die slagen of falen: levert meer effort een betere reparatie op?
Om dat te achterhalen bouwen we een kleine bugfix-agent en draaien we dezelfde taak op elk effort-niveau. Onderweg behandelen we:
Aanroepen van claude-opus-5 en een response parsen die begint met een thinking-blok
De diepte van redeneren sturen met effort en max_tokens daarop afstemmen
Een multi-turn tool-loop draaien die thinking-blokken en toolfouten overleeft
Een gevalideerd Pydantic-rapport teruggeven in plaats van proza
Succes, tokens, latency en kosten meten over alle vijf effort-niveaus
Herhaalde inputkosten verlagen met promptcaching binnen één run
Ik verklap vast het einde: op deze taak repareerde de goedkoopste instelling de bug in elke run, en niets daarboven deed het beter. Dat resultaat is specifiek voor deze repository; het nuttigste deel is de rig die het opleverde.
De agent krijgt een bugrapport en gecontroleerde toegang tot een kleine Python-repository en pakt het probleem aan: bestanden opvragen, de relevante lezen, de suite draaien, patchen, opnieuw draaien en rapporteren.
Claude raakt het bestandssysteem nooit aan. Het geeft een toolverzoek met een naam en JSON-argumenten, en onze Python-code beslist of het uitgevoerd wordt en wat er teruggestuurd wordt. Die scheidslijn ís het hele beveiligingsmodel, het onthouden waard wanneer de agent lijkt te handelen op eigen houtje.
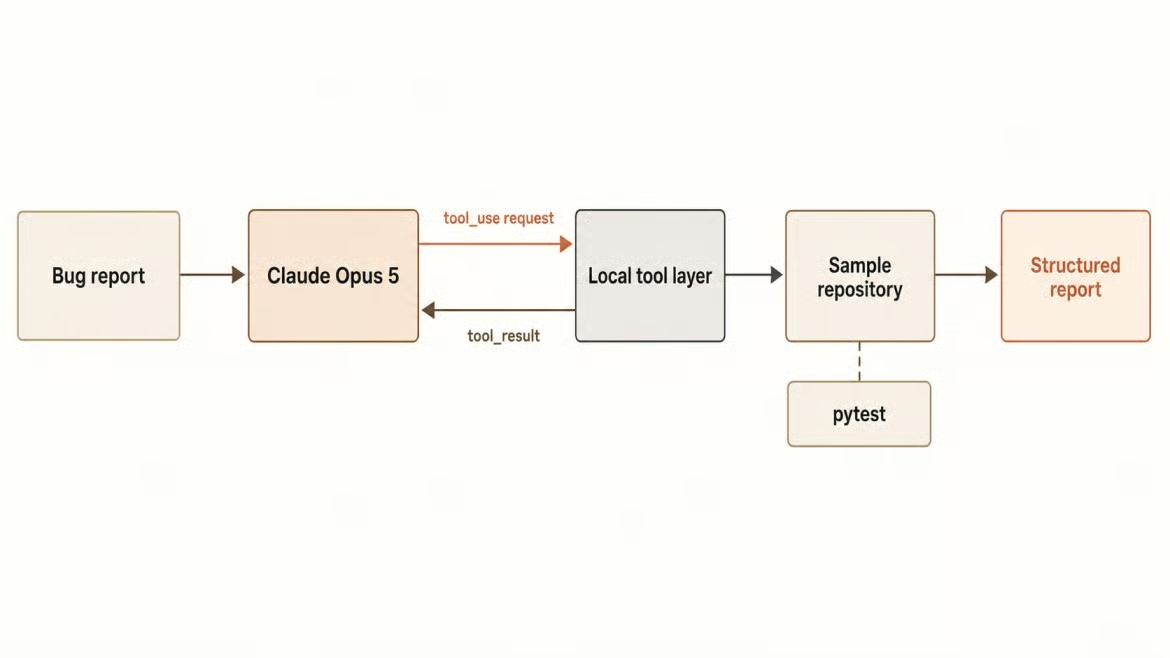
Bugrapport loopt via gecontroleerde tools. Afbeelding door de auteur.
Je hebt Python 3.10 of nieuwer nodig, een API-sleutel met toegang tot claude-opus-5, Git om de voorbeeldrepository te resetten, en genoeg pytest-kennis om een failure te lezen. Het afgeronde project staat op GitHub als je het liever in één keer leest; de secties hieronder bouwen het stap voor stap op.
git clone https://github.com/KhalidAbdelaty/claude-opus-5-api-tutorial.git
cd claude-opus-5-api-tutorial
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install -r requirements.txt
Kopieer .env.example naar .env en zet je sleutel erin. De sleutel hoort aan de serverzijde van alles wat je hierop bouwt, nooit in een request body en nooit in een logregel.
# agent/config.py
MODEL = "claude-opus-5"

PRICE_INPUT = 5.00
PRICE_OUTPUT = 25.00
PRICE_CACHE_WRITE_5M = 6.25
PRICE_CACHE_READ = 0.50

MAX_TOKENS = 32_000
MAX_ITERATIONS = 10
Die vier prijzen zijn later van belang. Alles afrekenen aan het basisinvoertarief onderschat cache-writes met een kwart en overschat cache-reads tienvoudig, precies het soort fout dat een benchmark mooier laat lijken dan hij was.
Een eerlijke vergelijking vraagt om een bug die elke keer op dezelfde manier faalt, dus ik schreef de fixture vóór de agent. De voorbeeldrepository is een billing-service met een gedeelde datumhelper, een subscriptions-module en een invoices-module. De helper documenteert één gedrag en implementeert een ander.
# billing/timeutils.py
def days_between(start: datetime, end: datetime) -> int:
    """Return the number of days from start to end, counting a partial day as a full day.

    Billing treats any remaining fraction of a day as a whole day, so a customer
    with four hours left has one day remaining, not zero.
    """
    delta = end - start
    return delta.days
timedelta.days truncteert, dus tien uur resterende proefperiode wordt gerapporteerd als nul dagen. Twee modules roepen deze helper aan, dus één defect uit zich als twee ogenschijnlijk losse failures: test_trial_active_on_final_day sluit klanten te vroeg uit, en test_prorated_credit_counts_partial_day kort een refund met een dag in.
Het bugrapport noemt alleen het eerste symptoom, zoals een supportticket zou doen. Er zit ook een val: is_trial_active patchen om nul toe te staan laat de gerapporteerde test slagen maar laat de factuurtest kapot, dus een oppervlakkige fix is detecteerbaar. De baseline is twee failures en vier passes, gecommit naar Git zodat git checkout -- . het tussen runs herstelt.
Voor je tools gebruikt: bevestig dat authenticatie en response-parsing werken. De Messages API heeft een modelstring nodig, een verplichte max_tokens en een messages-array.
from anthropic import Anthropic
from dotenv import load_dotenv

load_dotenv()
client = Anthropic()

response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "A pytest assertion fails with: assert 0 == 1. What should I check first?"}],
)

print([block.type for block in response.content])
text = next((b.text for b in response.content if b.type == "text"), "")
Die eerste print is het punt van de oefening. Hij geeft ['thinking', 'text'] terug, omdat thinking standaard aan staat en het thinking-blok eerst binnenkomt.
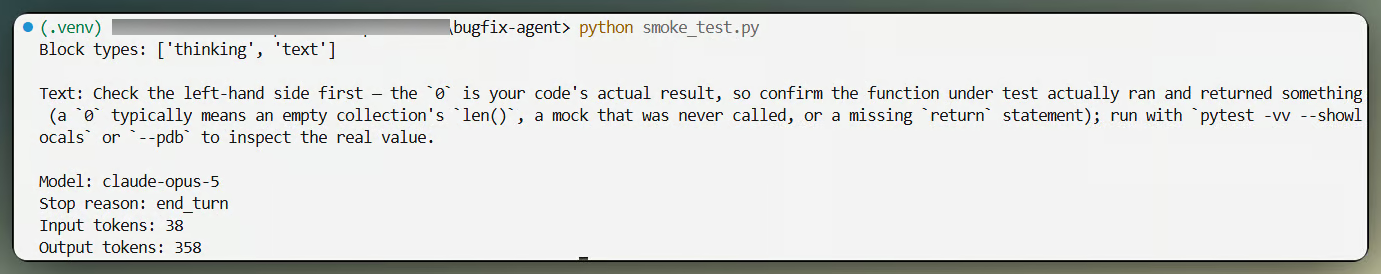
Eerste call retourneert thinking en daarna text. Afbeelding door de auteur.
Alle code die grijpt naar response.content[0].text zal op Opus 5 een AttributeError gooien. Filter in plaats daarvan op bloktype. Laat, terwijl je bezig bent, temperature, top_p en top_k weg uit elke request die je port, want niet-standaardwaarden geven op dit model een 400.
Thinking en effort zijn twee knoppen die vaak door elkaar gehaald worden. Thinking is of het model redeneert vóór het antwoorden, wat we bij de eerste call al zagen. Effort is hoeveel het redeneert, over elk outputtoken, inclusief tool-calls. De subsections hieronder behandelen de ladder, het tokenplafond waar het op botst en de ene combinatie die de API afwijst.
Effort stel je in binnen output_config, en er is geen beta-header nodig.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    output_config={"effort": "xhigh"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": bug_report}],
)
De API-standaard is high, en "high" expliciet meegeven is hetzelfde als het weglaten. Anthropic raadt aan te starten op xhigh voor agentisch coderen en merkt op dat low en medium sterker zijn op Opus 5 dan op eerdere Opus-modellen. Hun advies waarschuwt ook dat max simpelere taken kan overdenken, wat uiteindelijk het interessantste was dat ik mat.
Zoals ik eerder noemde, omvat max_tokens de redenering én het antwoord, dus een waarde afgestemd op een model zonder thinking kapt Opus 5 halverwege af. Er is ook een beperking die mensen vaak verrast.
client.messages.create(model="claude-opus-5", max_tokens=32000, messages=[...])
# ValueError: Streaming is required for operations that may take longer than 10 minutes.
De SDK's weigeren een niet-streamende request boven 21.333 max_tokens. Dat is client-side validatie in plaats van een API-regel, dus de fix is streamen: de loop roept client.messages.stream() aan en leest get_final_message(), en dezelfde 32.000 gaat erdoor. Ik koos daarvoor omdat het ruimte laat voor de hogere effort-niveaus.
Je kunt thinking uitzetten, maar alleen bij high effort of lager. Combineren met xhigh of max wordt direct afgewezen.
effort=high  accepted, blocks=['text']
effort=xhigh HTTP 400: output_config.effort 'xhigh' is not supported when thinking
             is disabled on this model. Use effort 'high' or below, or enable thinking.
Uitgeschakelde thinking afgewezen boven high effort. Afbeelding door de auteur.
Let op de bloklijst bij de geaccepteerde call: alleen ['text'] , thinking-blok weg. Effort verlagen is sowieso de veiligere kostenbeheersing, dus ik liet thinking overal aan.
Tools maken van een model een agent, en zijn ook waar een agent onveilig kan worden. Elke definitie is een naam, een beschrijving en een JSON-inputschema, en elke tool kost inputtokens bij elk verzoek. Ik hield de set op vijf, hieronder gegroepeerd naar hoeveel schade ze kunnen aanrichten.
list_files en search_code laten het model het relevante bestand vinden zonder de repository in de prompt te plakken. read_file haalt één bestand op via een pad relatief aan de repository, en daar zitten de veiligheidschecks.
def _resolve(relative_path: str) -> Path:
    """Resolve a repository-relative path, refusing anything outside the repo."""
    candidate = Path(relative_path)
    if candidate.is_absolute():
        raise ToolError("Absolute paths are not allowed.")

    resolved = (REPO_ROOT / candidate).resolve()
    if resolved != REPO_ROOT.resolve() and REPO_ROOT.resolve() not in resolved.parents:
        raise ToolError("Path escapes the repository.")
    return resolved
Resolveer vóór je vergelijkt, anders loopt ../../.ssh/id_rsa zo je sandbox uit. Teruggegeven bestanden zijn begrensd op 8.000 tekens, omdat elk toolresultaat bij elk volgend verzoek opnieuw verstuurd wordt en je er elke keer voor betaalt.
run_tests neemt geen argumenten. Het commando staat vast in de configuratie, dus het model kan niet om een willekeurig shell-commando vragen.
def run_tests() -> str:
    completed = subprocess.run(
        [sys.executable, "-m", "pytest", "tests", "-q", "--no-header", "--tb=short"],
        cwd=REPO_ROOT, capture_output=True, text=True, timeout=120,
    )
    output = (completed.stdout + completed.stderr).strip()
    return f"exit_code: {completed.returncode}\n{output[:3000]}"
Een allowlist van één is de sterkste allowlist die er is. Als je later meer commando's nodig hebt, voeg ze dan toe als aparte benoemde tools, niet als een command -argument.
Voor writes gebruikte ik exacte-stringvervanging in plaats van een unified diff, omdat diffs falen op whitespace op manieren die een beurt verspillen. De tool wijst niet-Python-bestanden af, begrenst de patchgrootte en weigert ambiguïteit.
occurrences = source.count(old_text)
if occurrences == 0:
    raise ToolError("old_text was not found in the file. Read the file and retry.")
if occurrences > 1:
    raise ToolError(f"old_text appears {occurrences} times. Include more context.")
Die fouten gaan terug naar Claude als toolresultaten in plaats van de loop te laten crashen, en het model leest ze en probeert het opnieuw met meer context.
De loop is kort zodra de onderdelen er zijn. Stuur de taak met de tooldefinities, inspecteer de teruggestuurde blokken, voer uit wat er is gevraagd, stuur de resultaten terug en herhaal tot het model stopt met vragen.
for iteration in range(1, max_iterations + 1):
    with client.messages.stream(
        model=MODEL,
        max_tokens=32_000,
        system=SYSTEM_PROMPT,
        tools=TOOLS,
        output_config={"effort": effort},
        output_format=RepairReport,
        cache_control={"type": "ephemeral"},
        messages=messages,
    ) as stream:
        response = stream.get_final_message()

    usage.add(response.usage)
    messages.append({"role": "assistant", "content": response.content})

    if response.stop_reason != "tool_use":
        break

    tool_results = []
    for block in response.content:
        if block.type == "tool_use":
            output, is_error = execute(block.name, dict(block.input or {}))
            tool_results.append({
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": output,
                "is_error": is_error,
            })
    messages.append({"role": "user", "content": tool_results})
Drie regels zijn hier cruciaal. response.content in zijn geheel toevoegen, in plaats van alleen de blokken die je nodig hebt, houdt thinking en redacted_thinking intact; filter je ze weg, dan begint het model na elk toolresultaat opnieuw te redeneren. tool_result -blokken moeten eerst komen in het user-bericht, want tekst ervoor geeft een 400. En is_error vertelt Claude dat een tool faalde, beter dan een stille lege string.
De system prompt blijft vast over elke run zodat de vergelijking ergens op slaat. Hij zegt het model te onderzoeken vóór het editen, de root cause te vinden in plaats van het gemelde symptoom, de kleinste verandering te maken die werkt en het draaien van de suite als onderdeel van de taak te zien. Wat hij niet zegt is "controleer je werk nog eens." Opus 5 verifieert zichzelf, en Anthropic raadt aan die instructies te verwijderen bij migratie, omdat ze latency en tokens toevoegen zonder de patch te verbeteren.
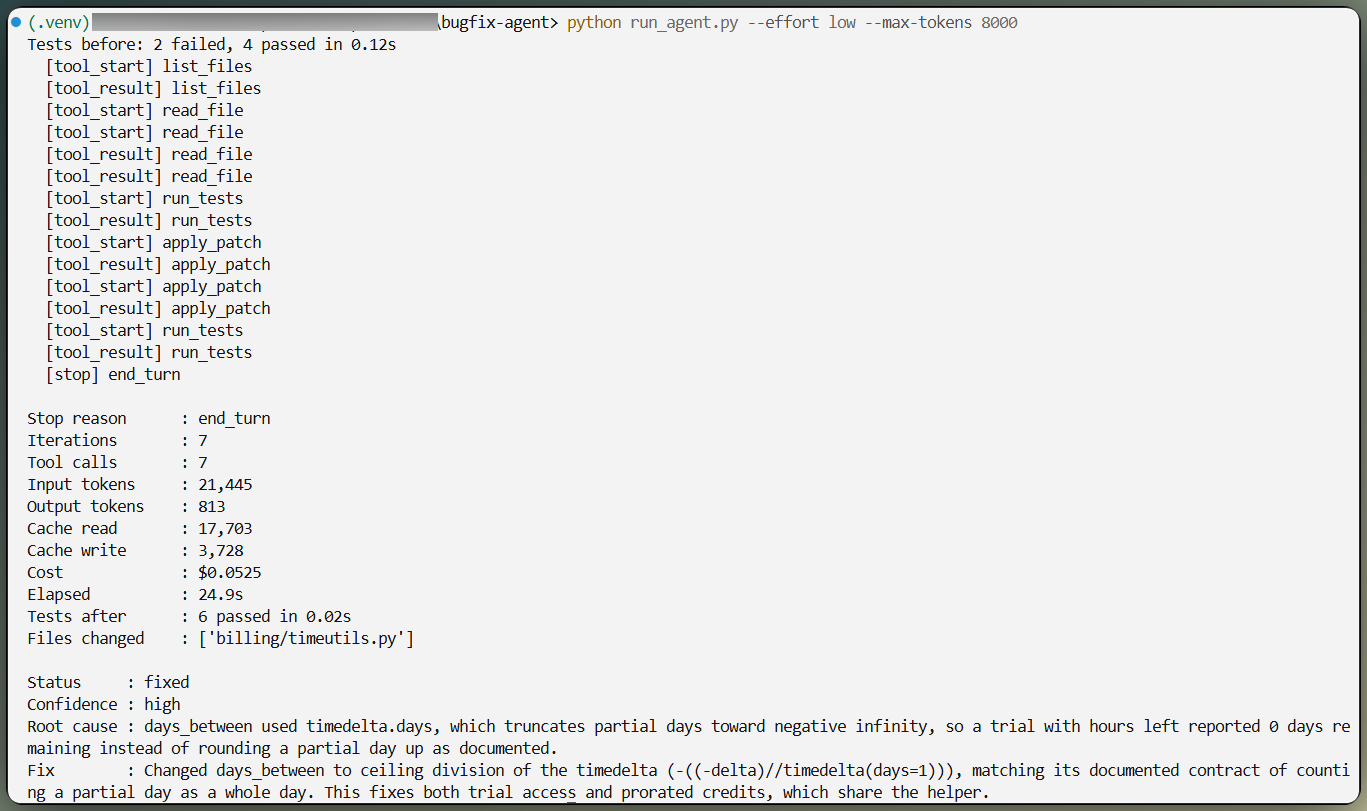
Agent inspecteert, patcht, en draait daarna tests opnieuw. Afbeelding door de auteur.
Proza is prima voor één run. Voor een benchmark die er veel moet vergelijken wil ik een getypeerd object, dus de loop geeft een Pydantic-model mee als output_format en de SDK maakt er een JSON-schema met beperkte decodering van.
class RepairReport(BaseModel):
    status: Literal["fixed", "partial", "not_fixed"]
    root_cause: str
    files_inspected: list[str]
    files_changed: list[str]
    fix_summary: str
    tests_before: str
    tests_after: str
    remaining_risks: list[str]
    confidence: Literal["low", "medium", "high"]

    @field_validator("status", "confidence", mode="before")
    @classmethod
    def _normalize_case(cls, value):
        """Enum capitalization is not guaranteed, so fold it before validating."""
        return value.strip().lower() if isinstance(value, str) else value
De validator verdient zijn plek. Gestructureerde outputs garanderen geen hoofdlettergebruik voor enums, dus een schema dat "high" verwacht kan "High" krijgen zonder fout en zonder speciale stopreden, en strikte Literal -validatie zou een response afwijzen die in de kern correct is.
Houd latency en kosten uit dit schema. Het model rapporteert wat het concludeerde; de runner meet wat er gebeurde door pytest opnieuw te draaien en git diff te lezen. Ik was later blij met die scheiding, om redenen die de benchmark duidelijk maakt.
Dit is het experiment waar de tutorial voor bestaat: dezelfde bug, dezelfde prompt, dezelfde tools, op low, medium, high, xhigh en max. Output is niet deterministisch, en sampling-parameters worden op dit model afgewezen, dus elk niveau herhalen is de enige controle die ik heb.
Elke run start vanaf die schone baseline-commit en meet dan de suite vóór en na. Het bugrapport, de system prompt, de tooldefinities, de iteratielimiet en max_tokens zijn overal identiek, en alleen de effort-string verandert. Ik draaide elk niveau drie keer.
Een budgetbewaker wikkelt alles in, telt na elke request de echte kosten met vier tarieven op en stopt bij een plafond. Agent-loops zijn een makkelijke manier om te veel uit te geven, en een stopconditie die je zelf bepaalt is beter dan het getal later ontdekken.
Hier zijn de gemiddelden over drie runs per niveau, gemeten op 26 juli 2026.
|
Effort |
Suite geslaagd |
Tool-calls |
Outputtokens |
Tijd tot eerste output |
Totale tijd |
Kosten per run |
|
|
3/3 |
8.0 |
827 |
2,9s |
24s |
$0.0387 |
|
|
3/3 |
8.0 |
1.008 |
2,7s |
26s |
$0.0466 |
|
|
3/3 |
10,0 |
1.352 |
2,9s |
29s |
$0.0659 |
|
|
3/3 |
11,3 |
1.546 |
2,8s |
35s |
$0.0778 |
|
|
2/3 |
8,3 |
1.787 |
6,6s |
38s |
$0.0762 |
Elk niveau dat zich met de repository bezighield vond dezelfde root cause in de gedeelde datumhelper en repareerde het met zo'n vier regels in één bestand. Geen enkele trapte in de val om de trial-check te patchen. De hele matrix van vijftien runs kostte $0,92.
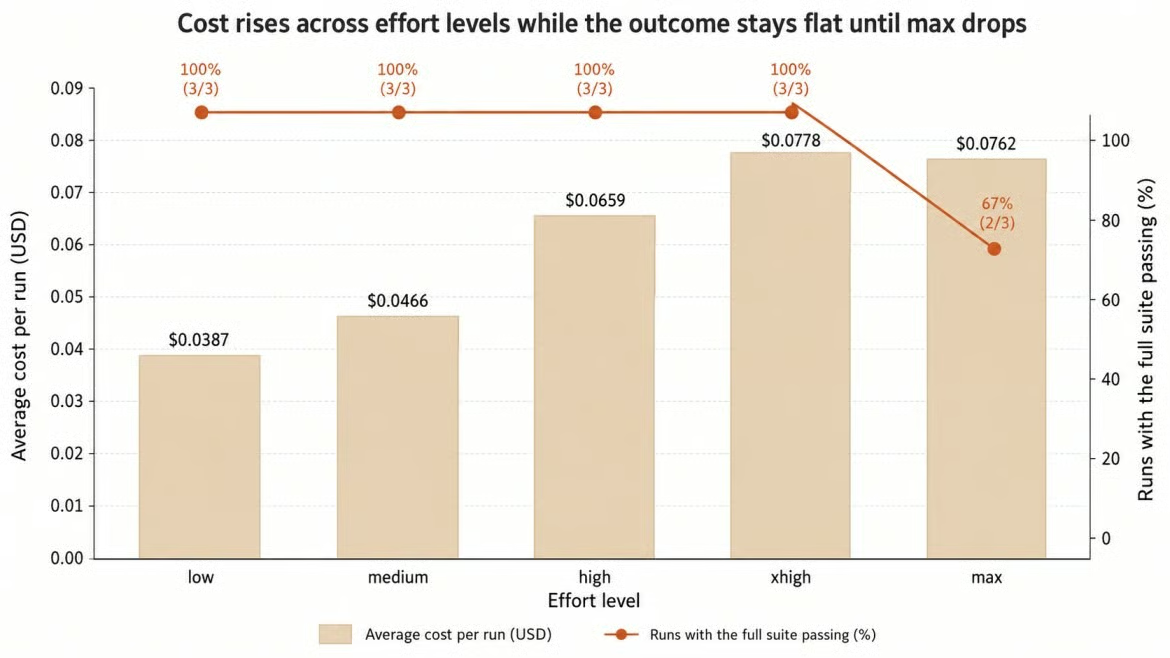
Kosten stijgen, de uitkomst niet. Afbeelding door de auteur.
De eerlijke lezing is dat deze taak niet moeilijk genoeg was om de top van de ladder van de bodem te scheiden. Van low naar xhigh verdubbelde de kosten en voegde elf seconden toe voor een identieke uitkomst. Als ik dit zou shippen, zou ik low draaien en het verschil uitgeven aan testdekking.
Die max -rij vraagt om uitleg. Eén van de drie runs gaf in de eerste beurt een schema-geldig rapport terug zonder één tool aan te roepen, met root_cause ingesteld op "b0" en een lege fix_summary. Pydantic accepteerde het omdat de vorm klopte. De tests bleven onaangeroerd. Zonder die run repareerden de andere twee max-pogingen de bug met 12,5 tool-calls en $0,1112 per stuk, grofweg driemaal de kosten van low.
Ik vind die misser leerzamer dan de tabel. Een schema garandeert structuur, geen inhoud, en een applicatie die report.status vertrouwt, had een "gedeeltelijk" succes gelogd op een run die niets deed. De runner ving het omdat die pytest draaide in plaats van het model te geloven. Wat je ook meeneemt uit dit artikel: neem dat mee. En omdat jouw taak de mijne niet is, behandel dit alles als een methode in plaats van een resultaat.
Caching is waar de loop goedkoop wordt, en het werkt binnen één run in plaats van over effort-niveaus heen. De effortwaarde veranderen maakt gecachte prefixes ongeldig, dus elk niveau betaalt zijn eigen cache-creatiekosten en geen warme cache wordt meegenomen. Binnen één run is het anders, omdat de system prompt en tooldefinities nooit veranderen terwijl de geschiedenis groeit.
Een top-level cache_control-veld zet automatische caching aan, wat het breekpunt bij het laatste cachebare blok zet en het vooruit schuift naarmate het gesprek groeit.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    tools=TOOLS,
    cache_control={"type": "ephemeral"},
    messages=messages,
)
Twee opeenvolgende beurten laten het effect duidelijk zien:
turn 1: uncached_input=2  cache_write=1231  cache_read=0     output=26
turn 2: uncached_input=2  cache_write=111   cache_read=1231  output=108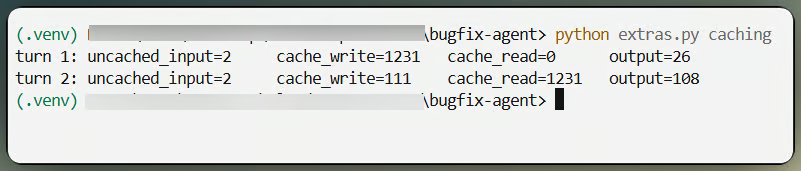
Gecachte prefix wordt in de volgende beurt teruggelezen. Afbeelding door de auteur.
De stabiele prefix is 1.231 tokens, ruim boven het cacheminimum dat ik eerder noemde. In beurt twee wordt hij teruggelezen tegen een tiende van het inkooptarief, terwijl alleen het nieuwe toolresultaat wordt weggeschreven. Over een volledige xhigh-run kwamen grofweg 32.600 van circa 36.200 inputtokens uit de cache. Caching doet niets voor outputtokens.
Dit is het patroon dat ik het nuttigst vond. Start de agent met read-only tools en geef pas schrijfrechten nadat het de oorzaak heeft vastgesteld. Doe je het naïef, dan betekent een tool toevoegen dat je de tools-array wijzigt, die helemaal vooraan in de gecachte prefix staat en de cache van het hele gesprek ongeldig maakt.
Toolwijzigingen midden in een gesprek lossen dat op. Declareer elke tool vooraf zodat de array nooit verandert, en gebruik daarna tool_addition- en tool_removal-blokken om individuele tools vanaf een bepaald punt aan te bieden of in te trekken. De blokken reizen mee in een role: "system"-bericht, en een system-bericht mag niet de eerste entry in messages zijn. Geen van beide beperkingen staat waar je ze zou verwachten, en ik ontdekte ze precies zoals jij je voorstelt.
withhold_patch = {
    "role": "system",
    "content": [{"type": "tool_removal",
                 "tool": {"type": "tool_reference", "name": "apply_patch"}}],
}
messages = [{"role": "user", "content": task_prompt}, withhold_patch]
Vervang later tool_removal door tool_addition en de tool komt terug. In mijn run besteedde het model vijf beurten aan read-only onderzoek, stopte met zijn diagnose, en kreeg pas daarna apply_patch, dat het gebruikte in beurten zes en zeven voordat de suite slaagde. De cache hield stand, met 25.557 tokens teruggelezen. Schrijfrechten kwamen pas nadat het bewijs er lag, en dát is het echte argument voor dit patroon. Laat eerst de fixed-tool-loop werken en voeg dit daarna toe.
Een agentische taak is veel requests, dus de kosten zitten in de som in plaats van in het laatste antwoord. Vier getallen komen terug op elke response en elk wordt afgerekend tegen een ander tarief.
def cost_usd(self) -> float:
    return (
        self.input_tokens * 5.00
        + self.output_tokens * 25.00
        + self.cache_creation_input_tokens * 6.25
        + self.cache_read_input_tokens * 0.50
    ) / 1_000_000
Totale input is de som van alle drie inputvelden, want input_tokens alleen telt alleen wat na het laatste cache-breekpunt valt, een veelvoorkomende manier om te laag te rapporteren. Outputtokens omvatten thinking en tool-calls evenals zichtbare tekst, en tegen vijf keer het inkooptarief domineren ze elke run hierboven.
Let op één ding als je opschaalt: thinking-blokken van eerdere beurten blijven in context en worden op elke volgende beurt opnieuw afgerekend, dus lange loops kosten meer dan de toolresultaten suggereren. Voor offline-evaluatie halveert de Batch API beide tarieven. Fast mode gaat de andere kant op met $10 en $50 per miljoen tokens, als een toegangsgestuurde research preview.
Er is ook een manier om de hele loop te begrenzen in plaats van één request. Task budgets geven het model een adviserend tegoed en een afteller om op te timen, in beta achter task-budgets-2026-03-13, met een ondergrens van 20.000 tokens. Ik had er een sectie over en heb die geschrapt, omdat ik hier geen verschil mat en een niet-result geen drie alinea's nodig heeft. Verwacht hetzelfde wanneer het werk het budget nooit benadert.
De meeste bestaande Claude-code draait zodra je de modelstring wijzigt. De failures clusteren op een paar plekken, en we raakten ze allemaal tijdens het bouwen van de agent, dus beschouw dit als de checklist in plaats van een nieuwe uitleg. Anthropics migratiegids bevat de volledige versie.
response.content[0] is nu meestal een thinking-blok, niet text
Een loop die het assistant-bericht opnieuw opbouwt uit geselecteerde blokken laat thinking en redacted_thinking vallen
max_tokens afgestemd op een niet-thinking model zal afkappen, en alles boven 21.333 moet streamen
Thinking uitschakelen geeft een 400 bij xhigh of max effort
Niet-standaard temperature, top_p en top_k worden afgewezen
Verificatie-instructies die zijn overgenomen uit oudere prompts laten Opus 5 over-verifiëren
Priority Tier en de web-fetch-tool zijn niet beschikbaar op Opus 5
Effort verdient een nieuwe sweep in plaats van de waarde die je voor het vorige model had afgestemd
Die laatste is het punt waar ik het hardst voor zou pleiten, en dit artikel ís het pleidooi. Mijn afgestemde instelling bleek de goedkoopste op de ladder.
Twee dingen veranderen vóór je dit shipt. Agent-gegenereerde code is onbetrouwbare code, dus de toollaag hoort in een geïsoleerde omgeving met limieten op CPU, geheugen en tijd, en een gegenereerde patch hoort vóór een mens te komen voordat hij merge't.
Het tweede is minder voor de hand liggend. Opus 5 draait safety-classifiers, en een agent die security-achtige code leest zit dicht bij de "cyber"-grens, maar een weigering komt binnen als HTTP 200 met stop_reason: "refusal", dus monitoring gebouwd op 5xx-ratio's ziet er nooit één. Instrumenteer weigeringen apart, tak op stop_reason in plaats van op de onderliggende stop_details-velden, die null kunnen zijn, en zet fallbacks uit tijdens benchmarks zodat je weet welk model antwoordde.
Gebruik Opus 5 als een fout antwoord meer kost dan de request. Debuggen over meerdere bestanden, root-cause-analyse, repository-brede review, lange tool-loops en migratieplanning passen allemaal, en de effort-ladder laat je routinegevallen goedkoop draaien en de moeilijke opschalen.
Sla het over voor formatting, classificatie en hoogvolume-laagcomplex werk, waar Claude Sonnet 5 de betere trade-off is. Sla het ook over voor alles wat je niet kunt valideren, want alle waarde hier kwam van een testsuite die eerlijk antwoordt. Dubbel betalen voor Fable 5 verdient zich alleen terug op het werk dat ik bovenaan aanstipte.
Het routeringsadvies dat ik écht zou geven: meet de taakkennelijkheid en laat die het effort-niveau kiezen, in plaats van alles naar de top van de ladder te sturen omdat dat veiliger klinkt. Het is niet veiliger. Zoals de benchmark liet zien, was het de dure manier om dezelfde patch te krijgen, en één keer leverde het een rapport over niets op.
De Streamlit-app in de repo laat je dit zelf draaien: kies een effort-niveau, kijk hoe de redenering en tool-calls live binnenkomen en lees de tokens, kosten en latency van dezelfde run af. Hij reset de repository net zoals de benchmark deed, dus de tabel die hij opbouwt is jouw meting in plaats van de mijne. De schermopname hieronder toont de workflow.
Leren met DataCamp
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

