
Programma
Nozioni di base sull'intelligenza artificiale
10 ore
Inviare codice a un modello è la parte facile. Il lavoro vero è tutto il resto: decidere quali file può leggere, eseguire le chiamate agli strumenti che richiede, sapere quando deve fermarsi e scegliere quanta capacità di ragionamento acquistare.
Claude Opus 5 rende esplicita quest’ultima decisione. Il parametro effort ha cinque impostazioni, e Anthropic afferma che spenderne di più ripaga proprio sul tipo di lavoro che fa un coding agent. Ripetere la tesi è facile, verificarla molto meno, quindi volevo una risposta circoscritta. Su un bug reale, con test che passano o falliscono, alzare l’effort produce una correzione migliore?
Per scoprirlo, costruiremo un piccolo agente che corregge bug ed eseguiremo lo stesso task a ogni livello di effort. Lungo il percorso vedremo:
Chiamare claude-opus-5 e analizzare una risposta che inizia con un blocco di thinking
Controllare la profondità di ragionamento con effort e dimensionare max_tokens di conseguenza
Eseguire un loop multi-turn di tool che sopravvive a thinking block ed errori degli strumenti
Restituire un report Pydantic validato invece di prosa
Misurare successo, token, latenza e costo su tutti e cinque i livelli di effort
Ridurre i costi di input ripetuti con il prompt caching all’interno di una singola esecuzione
Spoiler: su questo task, l’impostazione più economica ha corretto il bug a ogni esecuzione, e nulla sopra ha fatto meglio. Quel risultato è specifico a questo repository, e la parte più utile è il rig che l’ha prodotto.
L’agente riceve un bug report e un accesso controllato a un piccolo repository Python, poi lavora il problema: elenca i file, legge quelli rilevanti, esegue la suite, applica la patch, riesegue e fa un report.
Claude non tocca mai il filesystem. Emette una richiesta di tool con un nome e argomenti JSON, e il nostro codice Python decide se eseguirla e cosa restituire. Quel confine è l’intero modello di sicurezza, da tenere a mente ogni volta che l’agente sembra agire da solo.
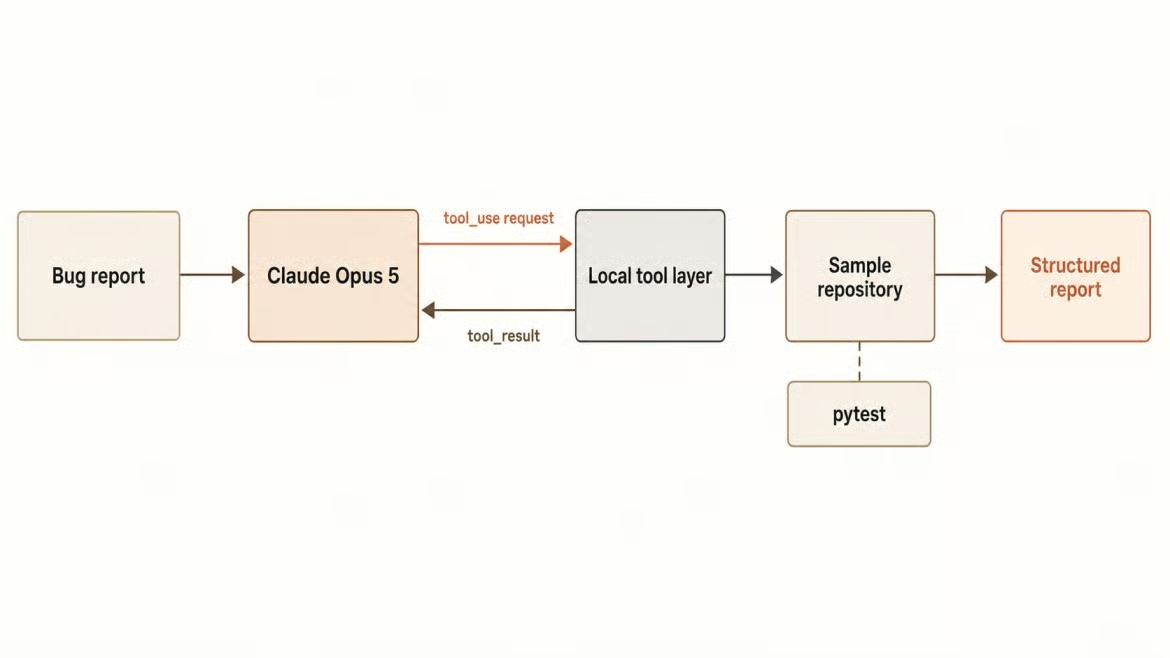
Il bug report passa attraverso strumenti controllati. Immagine dell’autore.
Ti serve Python 3.10 o successivo, una chiave API con accesso a claude-opus-5, Git per ripristinare il repository di esempio e sufficiente familiarità con pytest per leggere un failure. Il progetto finito è su GitHub se preferisci leggerlo completo; le sezioni sotto lo costruiscono pezzo per pezzo.
git clone https://github.com/KhalidAbdelaty/claude-opus-5-api-tutorial.git
cd claude-opus-5-api-tutorial
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install -r requirements.txt
Copia .env.example in .env e inserisci la tua chiave. La chiave appartiene sempre al lato server di qualunque cosa costruirai a partire da questo, mai nel body di una request e mai in un log.
# agent/config.py
MODEL = "claude-opus-5"

PRICE_INPUT = 5.00
PRICE_OUTPUT = 25.00
PRICE_CACHE_WRITE_5M = 6.25
PRICE_CACHE_READ = 0.50

MAX_TOKENS = 32_000
MAX_ITERATIONS = 10
Quei quattro prezzi conteranno più avanti. Addebitare tutto alla tariffa base di input sottostima le scritture in cache di un quarto e sovrastima le letture in cache di dieci volte: l’errore tipico che fa sembrare un benchmark migliore di quanto sia stato.
Un confronto equo richiede un bug che fallisca sempre allo stesso modo, quindi ho scritto il fixture prima dell’agente. Il repository di esempio è un servizio di fatturazione con un helper condiviso per le date, un modulo per gli abbonamenti e uno per le fatture. L’helper documenta un comportamento e ne implementa un altro.
# billing/timeutils.py
def days_between(start: datetime, end: datetime) -> int:
    """Return the number of days from start to end, counting a partial day as a full day.

    Billing treats any remaining fraction of a day as a whole day, so a customer
    with four hours left has one day remaining, not zero.
    """
    delta = end - start
    return delta.days
timedelta.days tronca, quindi dieci ore di trial rimanenti risultano in zero giorni. Due moduli chiamano questo helper, per cui un singolo difetto si manifesta come due failure indipendenti: test_trial_active_on_final_day blocca i clienti in anticipo e test_prorated_credit_counts_partial_day riduce un rimborso di un giorno.
Il bug report menziona solo il primo sintomo, come farebbe un ticket di supporto. C’è anche una trappola: modificare is_trial_active per accettare zero fa passare il test riportato e lascia rotto il test della fattura, quindi una correzione superficiale è rilevabile. Il baseline è due failure e quattro pass, committati su Git così git checkout -- . lo ripristina tra le esecuzioni.
Prima degli strumenti, verifica che autenticazione e parsing della risposta funzionino. La Messages API richiede la stringa del modello, un max_tokens obbligatorio e un array di messaggi.
from anthropic import Anthropic
from dotenv import load_dotenv

load_dotenv()
client = Anthropic()

response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "A pytest assertion fails with: assert 0 == 1. What should I check first?"}],
)

print([block.type for block in response.content])
text = next((b.text for b in response.content if b.type == "text"), "")
Quella prima print è il punto dell’esercizio. Restituisce ['thinking', 'text'], perché il thinking è attivo per impostazione predefinita e il blocco di thinking arriva per primo.
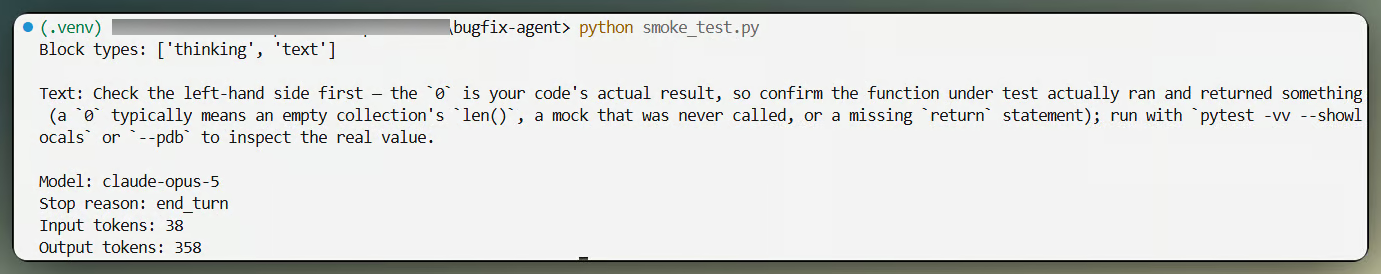
La prima chiamata restituisce thinking poi text. Immagine dell’autore.
Qualsiasi codice che accede a response.content[0].text solleverà un AttributeError su Opus 5. Filtra invece per tipo di blocco. Già che ci sei, rimuovi temperature, top_p e top_k da qualsiasi richiesta che stai portando, perché valori non predefiniti restituiscono un 400 su questo modello.
Thinking ed effort sono due controlli che spesso si confondono. Thinking indica se il modello ragiona prima di rispondere, come la prima chiamata ha già mostrato. Effort è quanto ragionamento fa, su ogni token di output, incluse le chiamate agli strumenti. Le sottosezioni sotto coprono la scala, il tetto di token che incontra e l’unica combinazione rifiutata dall’API.
Effort si imposta dentro output_config, e non serve alcun header beta.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    output_config={"effort": "xhigh"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": bug_report}],
)
Il valore predefinito dell’API è high, e passare "high" esplicitamente equivale a ometterlo. Anthropic suggerisce di partire da xhigh per coding agentici e nota che low e medium sono più forti su Opus 5 che sui precedenti Opus. La loro guida avverte anche che max può sovra-ragionare su task semplici, che è poi la cosa più interessante che ho misurato.
Come accennato, max_tokens copre il ragionamento oltre che la risposta, quindi un valore tarato su un modello senza thinking troncherà Opus 5 a metà task. C’è anche un vincolo che trae in inganno molti.
client.messages.create(model="claude-opus-5", max_tokens=32000, messages=[...])
# ValueError: Streaming is required for operations that may take longer than 10 minutes.
Le SDK rifiutano una richiesta non in streaming sopra 21.333 max_tokens. È una validazione lato client più che una regola dell’API, quindi la soluzione è lo streaming: il loop chiama client.messages.stream() e legge get_final_message(), e gli stessi 32.000 passano. Mi sono fermato lì perché lascia margine per i livelli di effort più alti.
Puoi spegnere il thinking, ma solo a effort high o inferiore. Combinarlo con xhigh o max viene rifiutato a priori.
effort=high  accepted, blocks=['text']
effort=xhigh HTTP 400: output_config.effort 'xhigh' is not supported when thinking
             is disabled on this model. Use effort 'high' or below, or enable thinking.
Thinking disabilitato rifiutato sopra high effort. Immagine dell’autore.
Nota l’elenco dei blocchi nella chiamata accettata: ['text'] da solo, blocco di thinking sparito. Abbassare l’effort è comunque il controllo dei costi più sicuro, quindi ho lasciato thinking attivo ovunque.
Gli strumenti trasformano un modello in un agente e sono anche il punto in cui un agente smette di essere sicuro. Ogni definizione è un nome, una descrizione e uno schema di input JSON, e ognuna costa token di input a ogni richiesta. Ho mantenuto il set a cinque, raggruppati sotto in base al potenziale danno.
list_files e search_code permettono al modello di trovare il file rilevante senza incollare l’intero repository nel prompt. read_file estrae un file con un percorso relativo al repository, e lì vivono i controlli di sicurezza.
def _resolve(relative_path: str) -> Path:
    """Resolve a repository-relative path, refusing anything outside the repo."""
    candidate = Path(relative_path)
    if candidate.is_absolute():
        raise ToolError("Absolute paths are not allowed.")

    resolved = (REPO_ROOT / candidate).resolve()
    if resolved != REPO_ROOT.resolve() and REPO_ROOT.resolve() not in resolved.parents:
        raise ToolError("Path escapes the repository.")
    return resolved
Risolvi prima di confrontare, altrimenti ../../.ssh/id_rsa esce dritto dalla sandbox. I file restituiti sono limitati a 8.000 caratteri, perché ogni risultato di tool viene rinviato a ogni richiesta successiva e lo paghi ogni volta.
run_tests non accetta argomenti. Il comando è fisso nella configurazione, quindi il modello non può chiedere un comando shell arbitrario.
def run_tests() -> str:
    completed = subprocess.run(
        [sys.executable, "-m", "pytest", "tests", "-q", "--no-header", "--tb=short"],
        cwd=REPO_ROOT, capture_output=True, text=True, timeout=120,
    )
    output = (completed.stdout + completed.stderr).strip()
    return f"exit_code: {completed.returncode}\n{output[:3000]}"
Una allowlist di uno è la allowlist più forte disponibile. Se in seguito ti servono più comandi, aggiungili come strumenti separati con un nome, non come argomento command.
Per le scritture ho usato la sostituzione di stringhe esatta invece di un diff unificato, perché i diff falliscono sugli spazi in modi che sprecano un turno. Lo strumento rifiuta file non Python, limita la dimensione della patch e rifiuta l’ambiguità.
occurrences = source.count(old_text)
if occurrences == 0:
    raise ToolError("old_text was not found in the file. Read the file and retry.")
if occurrences > 1:
    raise ToolError(f"old_text appears {occurrences} times. Include more context.")
Quegli errori tornano a Claude come risultati di tool invece di mandare in crash il loop, e il modello li legge e riprova con più contesto.
Il loop è breve una volta assemblati i pezzi. Invia il task con le definizioni degli strumenti, ispeziona i blocchi restituiti, esegui ciò che è stato richiesto, rimanda i risultati e ripeti finché il modello smette di chiedere.
for iteration in range(1, max_iterations + 1):
    with client.messages.stream(
        model=MODEL,
        max_tokens=32_000,
        system=SYSTEM_PROMPT,
        tools=TOOLS,
        output_config={"effort": effort},
        output_format=RepairReport,
        cache_control={"type": "ephemeral"},
        messages=messages,
    ) as stream:
        response = stream.get_final_message()

    usage.add(response.usage)
    messages.append({"role": "assistant", "content": response.content})

    if response.stop_reason != "tool_use":
        break

    tool_results = []
    for block in response.content:
        if block.type == "tool_use":
            output, is_error = execute(block.name, dict(block.input or {}))
            tool_results.append({
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": output,
                "is_error": is_error,
            })
    messages.append({"role": "user", "content": tool_results})
Tre righe lì sono fondamentali. Accodare response.content per intero, invece dei soli blocchi che ti interessano, mantiene thinking e redacted_thinking intatti; filtrarli fa ripartire il ragionamento del modello dopo ogni risultato di tool. I blocchi tool_result devono venire per primi nel messaggio dell’utente, perché del testo prima di loro restituisce un 400. E is_error dice a Claude che uno strumento è fallito, meglio di una stringa vuota silenziosa.
Il system prompt resta fisso in ogni esecuzione così il confronto ha senso. Dice al modello di investigare prima di modificare, trovare la root cause invece del sintomo riportato, fare il cambiamento più piccolo che funziona e trattare l’esecuzione della suite come parte del task. Ciò che omette è “ricontrolla il tuo lavoro”. Opus 5 si verifica da solo, e la guida di Anthropic è di rimuovere quelle istruzioni nella migrazione, perché aggiungono latenza e token senza migliorare la patch.
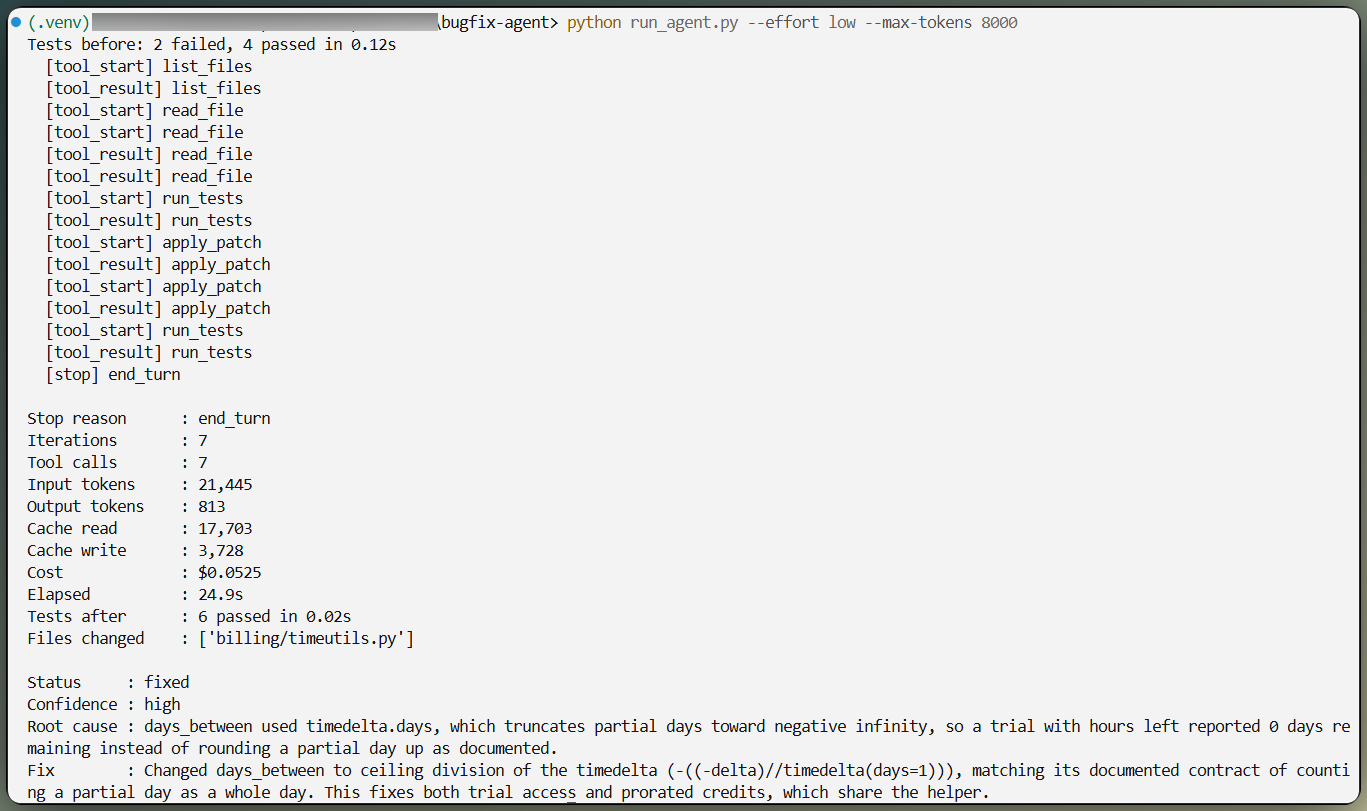
L’agente ispeziona, applica la patch e poi riesegue i test. Immagine dell’autore.
La prosa va bene per una singola esecuzione. Per un benchmark che deve confrontarne molte, voglio un oggetto tipizzato, quindi il loop passa un modello Pydantic come output_format e la SDK lo trasforma in uno schema JSON con decodifica vincolata.
class RepairReport(BaseModel):
    status: Literal["fixed", "partial", "not_fixed"]
    root_cause: str
    files_inspected: list[str]
    files_changed: list[str]
    fix_summary: str
    tests_before: str
    tests_after: str
    remaining_risks: list[str]
    confidence: Literal["low", "medium", "high"]

    @field_validator("status", "confidence", mode="before")
    @classmethod
    def _normalize_case(cls, value):
        """Enum capitalization is not guaranteed, so fold it before validating."""
        return value.strip().lower() if isinstance(value, str) else value
Il validator si guadagna il posto. Le structured outputs non garantiscono la capitalizzazione degli enum, quindi uno schema che si aspetta "high" può ricevere "High" senza errore e senza uno stop reason speciale, e una validazione Literal rigida rifiuterebbe una risposta sostanzialmente corretta.
Tieni latenza e costi fuori da questo schema. Il modello riporta ciò che ha concluso; il runner misura ciò che è successo rieseguendo pytest e leggendo git diff. Sono stato felice di quella separazione dopo, per motivi che il benchmark rende ovvi.
Questo è l’esperimento per cui esiste il tutorial: lo stesso bug, lo stesso prompt, gli stessi strumenti, a low, medium, high, xhigh e max. L’output non è deterministico e i parametri di sampling sono rifiutati su questo modello, quindi ripetere ogni livello è l’unico controllo che ho.
Ogni esecuzione parte da quel commit baseline pulito, poi misura la suite prima e dopo. Bug report, system prompt, definizioni degli strumenti, limite di iterazioni e max_tokens sono identici ovunque, e cambia solo la stringa di effort. Ho eseguito ogni livello tre volte.
Un guardrail di budget avvolge il tutto, sommando il costo reale a quattro tariffe dopo ogni richiesta e fermandosi a un tetto. I loop agentici sono un modo facile per sforare, e una condizione di stop che controlli tu è meglio di scoprire il numero dopo.
Ecco le medie su tre esecuzioni per livello, misurate il 26 luglio 2026.
|
Effort |
Suite superata |
Chiamate ai tool |
Token di output |
Tempo al primo output |
Tempo totale |
Costo per esecuzione |
|
|
3/3 |
8.0 |
827 |
2,9s |
24s |
$0.0387 |
|
|
3/3 |
8.0 |
1.008 |
2,7s |
26s |
$0.0466 |
|
|
3/3 |
10.0 |
1.352 |
2,9s |
29s |
$0.0659 |
|
|
3/3 |
11,3 |
1.546 |
2,8s |
35s |
$0.0778 |
|
|
2/3 |
8,3 |
1.787 |
6,6s |
38s |
$0.0762 |
Ogni livello che si è ingaggiato con il repository ha trovato la stessa root cause nell’helper condiviso per le date e l’ha corretta con circa quattro righe in un file. Nessuno ha abboccato e patchato il controllo del trial. Tutta la matrice di quindici esecuzioni è costata $0,92.
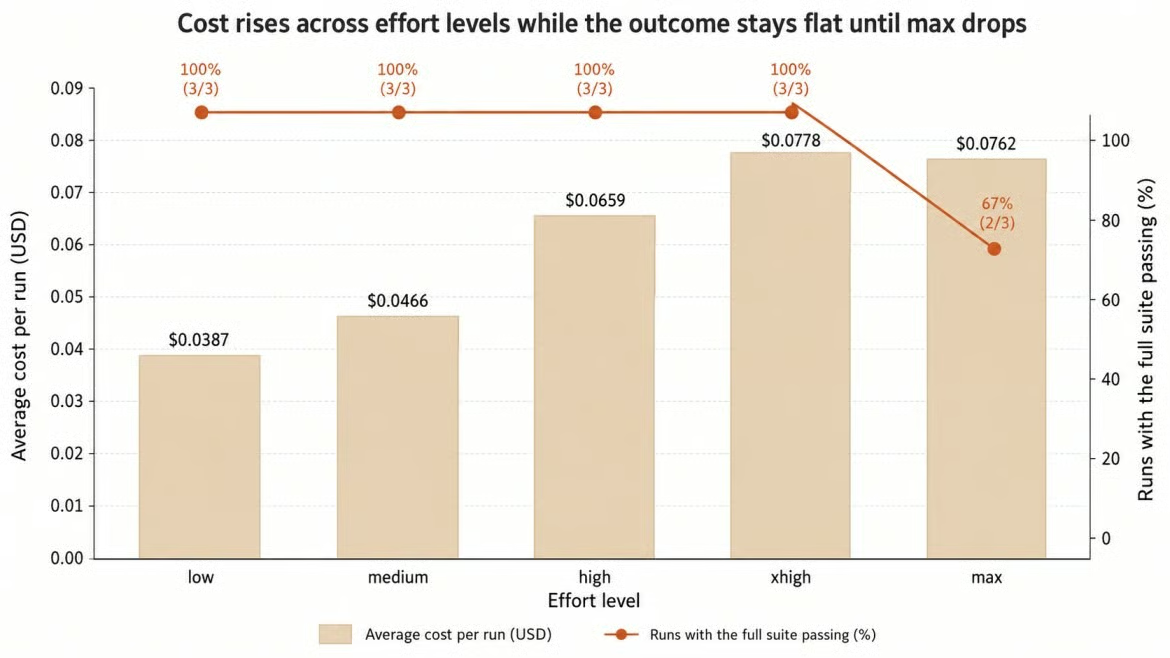
Il costo sale, l’esito no. Immagine dell’autore.
La lettura onesta è che questo task non era abbastanza difficile da separare la cima della scala dal fondo. Passare da low a xhigh ha raddoppiato il costo e aggiunto undici secondi per un esito identico. In produzione, eseguirei low e spenderei la differenza nella copertura dei test.
Quella riga max richiede una spiegazione. Una delle tre esecuzioni ha restituito un report valido rispetto allo schema al primo turno senza chiamare un solo tool, con root_cause impostato a "b0" e un fix_summary vuoto. Pydantic l’ha accettato perché la forma era corretta. I test erano intatti. Escludendola, le altre due prove a max hanno corretto il bug con 12,5 chiamate agli strumenti e $0,1112 ciascuna, circa tre volte il costo di low.
Trovo quel fallimento più istruttivo della tabella. Uno schema garantisce la struttura, non la sostanza, e un’applicazione che si fida di report.status avrebbe registrato un successo “parziale” su un’esecuzione che non ha fatto nulla. Il runner l’ha intercettato perché ha eseguito pytest invece di credere al modello. Qualunque cosa tu prenda da questo articolo, prendi questo. E poiché il tuo task non è il mio, tratta tutto ciò come un metodo più che un risultato.
Il caching è dove il loop diventa economico, e funziona all’interno di un’esecuzione piuttosto che tra livelli di effort. Cambiare il valore di effort invalida i prefissi in cache, quindi ogni livello paga il proprio costo di creazione cache e nessuna cache calda viene portata oltre. All’interno di un’esecuzione è diverso, perché system prompt e definizioni degli strumenti non cambiano mai mentre la cronologia cresce.
Un campo cache_control a livello superiore attiva il caching automatico, che posiziona il breakpoint all’ultimo blocco cacheable e lo sposta in avanti man mano che la conversazione cresce.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    tools=TOOLS,
    cache_control={"type": "ephemeral"},
    messages=messages,
)
Due turni consecutivi mostrano chiaramente l’effetto:
turn 1: uncached_input=2  cache_write=1231  cache_read=0     output=26
turn 2: uncached_input=2  cache_write=111   cache_read=1231  output=108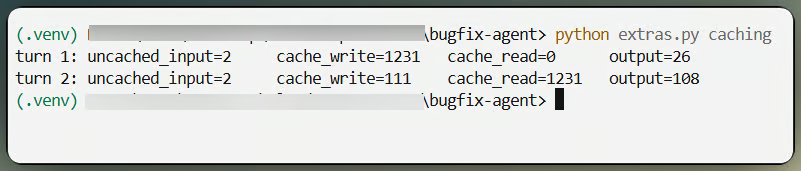
Prefisso in cache riletto al turno successivo. Immagine dell’autore.
Il prefisso stabile è di 1.231 token, comodamente sopra il minimo di cache che ho citato. Al secondo turno viene riletto a un decimo della tariffa di input mentre solo il nuovo risultato del tool viene scritto. Su un’esecuzione completa a xhigh, circa 32.600 dei circa 36.200 token di input sono arrivati dalla cache. Il caching non ha effetto sui token di output.
Ecco il pattern che ho trovato più utile. Avvia l’agente con strumenti in sola lettura, poi concedi accesso in scrittura solo dopo che ha diagnosticato il problema. Fatto ingenuamente, aggiungere uno strumento significa modificare l’array tools, che sta all’inizio del prefisso in cache e invalida la cache dell’intera conversazione.
Le modifiche agli strumenti a conversazione in corso risolvono. Dichiara ogni strumento in anticipo così l’array non cambia mai, poi usa i blocchi tool_addition e tool_removal per offrire o ritirare singoli strumenti da un punto in poi. I blocchi viaggiano dentro un messaggio con role: "system", e un messaggio di sistema non può essere la prima voce in messages. Nessuno dei due vincoli è dove ti aspetteresti, e li ho scoperti proprio come immagini.
withhold_patch = {
    "role": "system",
    "content": [{"type": "tool_removal",
                 "tool": {"type": "tool_reference", "name": "apply_patch"}}],
}
messages = [{"role": "user", "content": task_prompt}, withhold_patch]
Sostituisci tool_removal con tool_addition più tardi e lo strumento torna. Nella mia esecuzione il modello ha passato cinque turni in indagine in sola lettura, si è fermato con la diagnosi, e solo allora ha ricevuto apply_patch, che ha usato ai turni sei e sette prima che la suite passasse. La cache ha retto per tutto il tempo, con 25.557 token riletti. L’accesso in scrittura è arrivato dopo che le evidenze c’erano, che è il vero motivo del pattern. Fai funzionare prima il loop a strumenti fissi, poi aggiungi questo.
Un task agentico sono molte richieste, quindi il costo vive nella somma più che nella risposta finale. Quattro numeri tornano a ogni risposta, e ciascuno è fatturato a una tariffa diversa.
def cost_usd(self) -> float:
    return (
        self.input_tokens * 5.00
        + self.output_tokens * 25.00
        + self.cache_creation_input_tokens * 6.25
        + self.cache_read_input_tokens * 0.50
    ) / 1_000_000
Il totale degli input è la somma di tutti e tre i campi di input, perché input_tokens da solo conta solo ciò che cade dopo l’ultimo breakpoint di cache, un modo comune di sottostimare. I token di output includono thinking e chiamate agli strumenti oltre al testo visibile, e a cinque volte la tariffa di input dominano ogni esecuzione sopra.
Una cosa da osservare mentre scali: i blocchi di thinking dei turni precedenti restano in contesto e vengono fatturati di nuovo a ogni turno successivo, quindi i loop lunghi costano più di quanto suggeriscano i risultati degli strumenti. Per valutazioni offline, la Batch API dimezza entrambe le tariffe. La Fast mode va nella direzione opposta a $10 e $50 per milione di token, come anteprima di ricerca con accesso controllato.
C’è anche un modo per limitare l’intero loop invece che una richiesta. I task budget consegnano al modello un allowance consultivo e un conto alla rovescia a cui adeguarsi, in beta dietro task-budgets-2026-03-13, con un minimo di 20.000 token. Avevo scritto una sezione al riguardo e l’ho tagliata, perché qui non ho misurato differenze e un non-risultato non merita tre paragrafi. Aspettati lo stesso quando il lavoro non si avvicina mai al budget.
La maggior parte del codice Claude esistente gira una volta cambiata la stringa del modello. I failure si concentrano in pochi punti, e li abbiamo toccati tutti costruendo l’agente, quindi trattalo come una checklist più che come una nuova spiegazione. La guida di migrazione di Anthropic contiene la versione completa.
response.content[0] ora è di solito un blocco di thinking, non testo
Un loop che ricostruisce il messaggio dell’assistente da blocchi selezionati perde thinking e redacted_thinking
max_tokens tarato su un modello senza thinking troncherà, e qualsiasi valore sopra 21.333 deve andare in streaming
Disattivare il thinking restituisce un 400 a effort xhigh o max
Valori non predefiniti di temperature, top_p e top_k sono rifiutati
Istruzioni di verifica portate da prompt più vecchi fanno sovra-verificare Opus 5
Priority Tier e lo strumento di web fetch non sono disponibili su Opus 5
Effort merita una nuova taratura anziché il valore ottimizzato per il modello precedente
Quest’ultimo è il punto per cui insisterei di più, e questo articolo è l’argomentazione. La mia impostazione ottimizzata si è rivelata la più economica sulla scala.
Due cose cambiano prima della messa in produzione. Il codice generato da un agente è codice non affidabile, quindi il livello degli strumenti appartiene a un ambiente isolato con limiti su CPU, memoria e tempo, e una patch generata va davanti a un umano prima del merge.
La seconda è meno ovvia. Opus 5 esegue classificatori di sicurezza, e un agente che legge codice vicino alla sicurezza siede vicino al confine "cyber", ma un rifiuto arriva come HTTP 200 con stop_reason: "refusal", quindi un monitoraggio basato sui tassi di 5xx non ne vede uno. Strumenta i rifiuti separatamente, dirama su stop_reason piuttosto che sui campi stop_details sottostanti, che possono essere null, e disattiva i fallbacks durante i benchmark così sai quale modello ha risposto.
Usa Opus 5 quando una risposta sbagliata costa più della richiesta. Debug multi-file, analisi della root cause, revisione a livello di repository, loop lunghi di strumenti e pianificazione di migrazioni rientrano tutti, e la scala di effort ti consente di gestire i casi di routine a basso costo ed elevare quelli difficili.
Evitalo per formattazione, classificazione e lavoro ad alto volume e bassa complessità, dove Claude Sonnet 5 è lo scambio migliore. Evitalo anche per qualsiasi cosa tu non possa validare, dato che tutto il valore qui è arrivato da una test suite che risponde onestamente. Pagare il doppio per Fable 5 vale solo sul lavoro che ho evidenziato all’inizio.
Il consiglio di routing che darei davvero è di misurare la difficoltà del task e lasciare che scelga il livello di effort, invece di mandare tutto in cima alla scala perché sembra più sicuro. Non è più sicuro. Come ha mostrato il benchmark, è stato il modo costoso per ottenere la stessa patch, e una volta ha prodotto un report sul nulla.
La app Streamlit nel repo ti permette di provarlo: scegli un livello di effort, guarda in diretta il ragionamento e le chiamate agli strumenti, e leggi token, costo e latenza dalla stessa esecuzione. Reimposta il repository come ha fatto il benchmark, quindi la tabella che costruisce è la tua misurazione, non la mia. La registrazione schermo sotto mostra il flusso.
Impara con DataCamp
Programma
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



