
Program
AI Temelleri
10 sa
Koda bir modeli beslemek işin kolay kısmı. Zor olan, etrafındaki her şey: hangi dosyaları okuyabileceğine karar vermek, istediği araç çağrılarını yürütmek, ne zaman durması gerektiğini bilmek ve ne kadar muhakeme için ödeme yapılacağını seçmek.
Claude Opus 5 son kararı açık hale getiriyor. effort parametresinin beş ayarı var ve Anthropic, daha fazlasını harcamanın tam da bir kodlama aracısının yaptığı işlerde karşılığını verdiğini söylüyor. Bu iddiayı tekrarlamak kolay, sınamak zordur; bu yüzden dar bir cevap istedim. Gerçek bir hatada, geçer veya kalır testlerle, çabayı artırmak daha iyi bir onarım sağlıyor mu?
Bunu öğrenmek için küçük bir hata düzeltme aracısı oluşturacak ve aynı görevi her çaba düzeyinde çalıştıracağız. Bu sırada şunları ele alacağız:
claude-opus-5 çağırmak ve düşünme bloğu ile başlayan bir yanıtı ayrıştırmak
effort ile muhakeme derinliğini kontrol etmek ve bunun etrafında max_tokens boyutlandırmak
Düşünme blokları ve araç hatalarına dayanıklı çok turlu bir araç döngüsü çalıştırmak
Düz yazı yerine doğrulanmış bir Pydantic raporu döndürmek
Tüm beş çaba düzeyi boyunca başarıyı, tokenları, gecikmeyi ve maliyeti ölçmek
Tek bir çalışmada istem önbelleklemesi ile tekrarlanan girdi maliyetini düşürmek
Sonu baştan söyleyeyim: bu görevde, en ucuz ayar her çalıştırmada hatayı düzeltti ve üstündeki hiçbir ayar daha iyisini yapmadı. Bu sonuç bu depoya özgü; işe yarayan asıl şey ise bunu üreten düzenek.
Aracı, bir hata raporu ve küçük bir Python deposuna kontrollü erişim alır; ardından problemi çözer: dosyaları listeler, ilgili olanları okur, paketi çalıştırır, yamayı uygular, tekrar çalıştırır ve raporlar.
Claude dosya sistemine asla dokunmaz. Bir ad ve JSON argümanlarla araç isteği üretir; Python kodumuz ise bunu çalıştırıp çalıştırmamaya ve ne döndürüleceğine karar verir. Bu sınır tüm güvenlik modelidir; aracı kendi kendine hareket ediyormuş gibi göründüğünde bunu hatırlamaya değer.
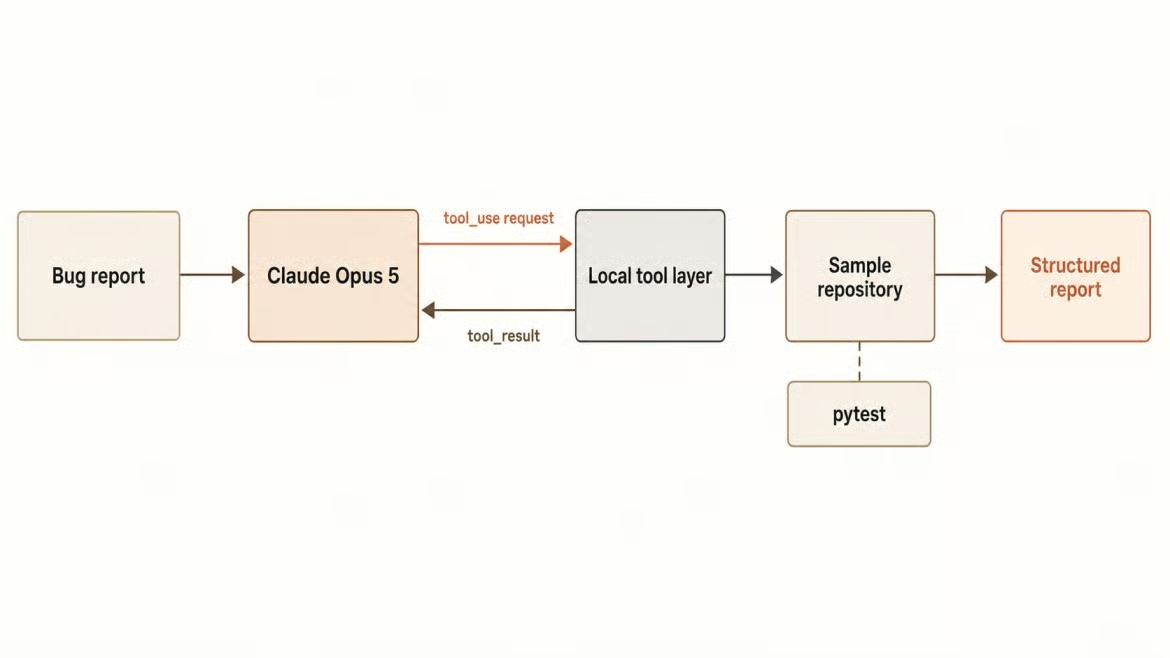
Hata raporu kontrollü araçlardan geçer. Görsel: Yazar.
Python 3.10 veya üzeri, claude-opus-5 erişimi olan bir API anahtarı, örnek depoyu sıfırlamak için Git ve bir hatayı okuyacak kadar pytest aşinalığına ihtiyacınız var. Biten proje GitHub’da; isterseniz baştan sona oradan okuyabilirsiniz. Aşağıdaki bölümler ise projeyi parça parça inşa ediyor.
git clone https://github.com/KhalidAbdelaty/claude-opus-5-api-tutorial.git
cd claude-opus-5-api-tutorial
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install -r requirements.txt
.env.example dosyasını .env olarak kopyalayın ve anahtarınızı içine koyun. Bu anahtar, bundan inşa edeceğiniz her şeyin sunucu tarafına aittir; asla bir istek gövdesine ve asla bir günlük satırına yazmayın.
# agent/config.py
MODEL = "claude-opus-5"

PRICE_INPUT = 5.00
PRICE_OUTPUT = 25.00
PRICE_CACHE_WRITE_5M = 6.25
PRICE_CACHE_READ = 0.50

MAX_TOKENS = 32_000
MAX_ITERATIONS = 10
Bu dört fiyatlandırma ileride önemli olacak. Her şeyi temel giriş oranıyla ücretlendirmek, önbellek yazmalarını dörtte bir eksik ve önbellek okumalarını on kat fazla hesaplar; bu da bir kıyaslamayı gerçekte olduğundan daha iyi gösteren türden bir hatadır.
Adil bir karşılaştırma, her seferinde aynı şekilde başarısız olan bir hataya ihtiyaç duyar; bu yüzden aracıdan önce yerleşik düzeneği yazdım. Örnek depo; paylaşılan bir tarih yardımcı aracı, bir abonelik modülü ve bir fatura modülüne sahip bir faturalandırma hizmeti. Yardımcı, bir davranışı belgeliyor ama başka birini uyguluyor.
# billing/timeutils.py
def days_between(start: datetime, end: datetime) -> int:
    """Return the number of days from start to end, counting a partial day as a full day.

    Billing treats any remaining fraction of a day as a whole day, so a customer
    with four hours left has one day remaining, not zero.
    """
    delta = end - start
    return delta.days
timedelta.days keser; bu nedenle kalan on saatlik deneme süresi sıfır gün olarak raporlanır. Bu yardımcıyı iki modül çağırıyor; bu yüzden tek bir kusur iki ilgisiz hata olarak ortaya çıkıyor: test_trial_active_on_final_day müşterileri erken kilitler ve test_prorated_credit_counts_partial_day bir geri ödemeyi bir gün eksik hesaplar.
Hata raporu, bir destek bileti gibi yalnızca ilk semptomdan bahseder. Ayrıca bir tuzak vardır: is_trial_active öğesini sıfırı kabul edecek şekilde yamalamak, raporlanan testi geçirir ancak fatura testini bozuk bırakır; bu nedenle yüzeysel bir düzeltme tespit edilebilir. Başlangıç durumu iki başarısızlık ve dört geçiştir; Git’e işlenmiştir ki git checkout -- . çalıştırmalar arasında bunu geri yüklesin.
Herhangi bir araçtan önce, kimlik doğrulama ve yanıt ayrıştırmanın çalıştığını doğrulayın. Mesajlar API’si bir model dizesi, zorunlu bir max_tokens ve bir mesajlar dizisi ister.
from anthropic import Anthropic
from dotenv import load_dotenv

load_dotenv()
client = Anthropic()

response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "A pytest assertion fails with: assert 0 == 1. What should I check first?"}],
)

print([block.type for block in response.content])
text = next((b.text for b in response.content if b.type == "text"), "")
İlk print ifadesi, alıştırmanın asıl amacıdır. ['thinking', 'text'] döner; çünkü düşünme varsayılan olarak açıktır ve düşünme bloğu önce gelir.
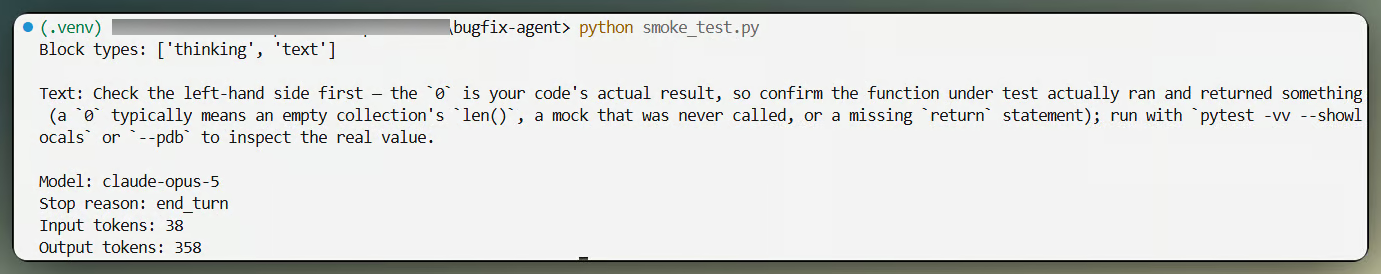
İlk çağrı önce düşünme, sonra metin döndürür. Görsel: Yazar.
response.content[0].text alanına uzanan herhangi bir kod, Opus 5’te bir AttributeError yükseltir. Bunun yerine blok tipine göre filtreleyin. Hazır başlamışken, bu modele taşırken temperature, top_p ve top_k’yi de bırakın; çünkü varsayılan olmayan değerler bu modelde 400 döndürür.
Düşünme ve çaba, sıklıkla karıştırılan iki kontroldür. Düşünme, modelin yanıtlamadan önce muhakeme edip etmediğidir; ki ilk çağrı zaten bunu yaptığını gösterdi. Çaba ise, üretilen her çıktı tokenı boyunca — araç çağrıları dahil — ne kadar muhakeme yapıldığıdır. Aşağıdaki alt bölümler, kademeyi, hitap ettiği token sınırını ve API’nin reddettiği tek kombinasyonu kapsar.
Çaba, output_config içinde ayarlanır ve beta başlığı gerekmez.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    output_config={"effort": "xhigh"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": bug_report}],
)
API varsayılanı high’dır; "high"’ı açıkça geçirmek, hiç iletmemekle aynıdır. Anthropic, araçsal kodlama için xhigh ile başlamayı önerir ve low ile medium’un Opus 5’te önceki Opus modellerine göre daha güçlü olduğuna dikkat çeker. Rehber ayrıca max ’in daha basit görevlerde aşırı düşünebileceği konusunda uyarır; bu da ölçtüğüm en ilginç şey çıktı.
Daha önce belirttiğim gibi, max_tokens hem muhakemeyi hem de yanıtı kapsar; bu yüzden düşünmesiz bir model için ayarlanmış bir değer, Opus 5’i görevin ortasında keser. Ayrıca insanları hazırlıksız yakalayan bir kısıt da var.
client.messages.create(model="claude-opus-5", max_tokens=32000, messages=[...])
# ValueError: Streaming is required for operations that may take longer than 10 minutes.
SDK’lar, 21.333’ün üzerindeki max_tokens için akışsız bir isteği reddeder. Bu, bir API kuralından ziyade istemci tarafı doğrulamadır; bu yüzden çözüm akıştır: döngü client.messages.stream() çağırır ve get_final_message() okur; aynı 32.000 de böyle geçer. Ben, daha yüksek çaba düzeylerine alan bıraktığı için bu değerde karar kıldım.
Düşünmeyi kapatabilirsiniz; ancak yalnızca high çaba veya altındayken. Bunu xhigh ya da max ile birleştirmek doğrudan reddedilir.
effort=high  accepted, blocks=['text']
effort=xhigh HTTP 400: output_config.effort 'xhigh' is not supported when thinking
             is disabled on this model. Use effort 'high' or below, or enable thinking.
Düşünme, high üstünde kapalıyken reddedilir. Görsel: Yazar.
Kabul edilen çağrıdaki blok listesine dikkat edin: tek başına ['text']; düşünme bloğu yok. Çabayı düşürmek zaten daha güvenli bir maliyet kontrolüdür; bu nedenle düşünmeyi baştan sona açık tuttum.
Araçlar, bir modeli aracıya dönüştürür; aynı zamanda bir aracının güvenli olmaktan çıktığı yerdir. Her tanım bir ad, bir açıklama ve bir JSON girdi şemasından oluşur ve her biri her istekte giriş tokenlarına mal olur. Seti beş araçla sınırlı tuttum; aşağıda verebilecekleri zarara göre grupladım.
list_files ve search_code, modeli depoyu isteme yapıştırmadan ilgili dosyayı bulmasını sağlar. read_file depoya göre göreli bir yolla tek dosya çeker ve güvenlik kontrolleri burada bulunur.
def _resolve(relative_path: str) -> Path:
    """Resolve a repository-relative path, refusing anything outside the repo."""
    candidate = Path(relative_path)
    if candidate.is_absolute():
        raise ToolError("Absolute paths are not allowed.")

    resolved = (REPO_ROOT / candidate).resolve()
    if resolved != REPO_ROOT.resolve() and REPO_ROOT.resolve() not in resolved.parents:
        raise ToolError("Path escapes the repository.")
    return resolved
Karşılaştırmadan önce resolve edin; yoksa ../../.ssh/id_rsa kum havuzunuzdan dümdüz yürür çıkar. Döndürülen dosyalar 8.000 karakterle sınırlandırılır; çünkü her araç sonucu her sonraki istekte yeniden gönderilir ve her seferinde bunun ücretini ödersiniz.
run_tests argüman almaz. Komut yapılandırmada sabittir; bu nedenle modelin keyfi bir kabuk komutu istemesinin bir yolu yoktur.
def run_tests() -> str:
    completed = subprocess.run(
        [sys.executable, "-m", "pytest", "tests", "-q", "--no-header", "--tb=short"],
        cwd=REPO_ROOT, capture_output=True, text=True, timeout=120,
    )
    output = (completed.stdout + completed.stderr).strip()
    return f"exit_code: {completed.returncode}\n{output[:3000]}"
Tek maddelik bir izin listesi, mümkün olan en güçlü izin listesidir. Daha sonra daha fazla komuta ihtiyacınız olursa, bunları ayrı adlandırılmış araçlar olarak ekleyin; bir command argümanı olarak değil.
Yazmalar için birleşik diff yerine birebir metin değiştirmeyi kullandım; çünkü diff’ler boşluklarda bir tur boşa harcatan şekillerde başarısız olur. Araç, Python dışı dosyaları reddeder, yama boyutunu sınırlar ve belirsizliği geri çevirir.
occurrences = source.count(old_text)
if occurrences == 0:
    raise ToolError("old_text was not found in the file. Read the file and retry.")
if occurrences > 1:
    raise ToolError(f"old_text appears {occurrences} times. Include more context.")
Bu hatalar döngüyü çökertmek yerine araç sonuçları olarak Claude’a geri gider; model bunları okur ve daha fazla bağlamla yeniden dener.
Parçalar yerli yerine oturduğunda döngü kısadır. Görevi araç tanımlarıyla gönderin, dönen blokları inceleyin, isteneni yürütün, sonuçları geri gönderin ve model talep etmeyi bırakana kadar tekrarlayın.
for iteration in range(1, max_iterations + 1):
    with client.messages.stream(
        model=MODEL,
        max_tokens=32_000,
        system=SYSTEM_PROMPT,
        tools=TOOLS,
        output_config={"effort": effort},
        output_format=RepairReport,
        cache_control={"type": "ephemeral"},
        messages=messages,
    ) as stream:
        response = stream.get_final_message()

    usage.add(response.usage)
    messages.append({"role": "assistant", "content": response.content})

    if response.stop_reason != "tool_use":
        break

    tool_results = []
    for block in response.content:
        if block.type == "tool_use":
            output, is_error = execute(block.name, dict(block.input or {}))
            tool_results.append({
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": output,
                "is_error": is_error,
            })
    messages.append({"role": "user", "content": tool_results})
Orada üç satır yük taşıyor. Yalnızca ilgilendiğiniz bloklar yerine response.content’ı bütünüyle eklemek, thinking ve redacted_thinking bloklarını sağlam tutar; bunları filtrelerseniz model her araç sonucundan sonra muhakemesine yeniden başlar. tool_result blokları, kullanıcı mesajında ilk gelmelidir; çünkü öncesindeki metin 400 döndürür. Ve is_error , bir aracın başarısız olduğunu Claude’a bildirir; sessiz bir boş dizeden iyidir.
Sistem yönergesi her çalıştırmada sabit kalır ki karşılaştırmanın anlamı olsun. Modele, düzenleme yapmadan önce araştırmasını, raporlanan semptom yerine kök nedeni bulmasını, işe yarayan en küçük değişikliği yapmasını ve paketi çalıştırmayı görevin bir parçası olarak görmesini söyler. İçermediği şey ise "işini iki kez kontrol et"tir. Opus 5 kendini doğrular ve Anthropic’in rehberi, taşınırken bu talimatların kaldırılmasını önerir; çünkü düzeltmeyi iyileştirmeden gecikme ve token eklerler.
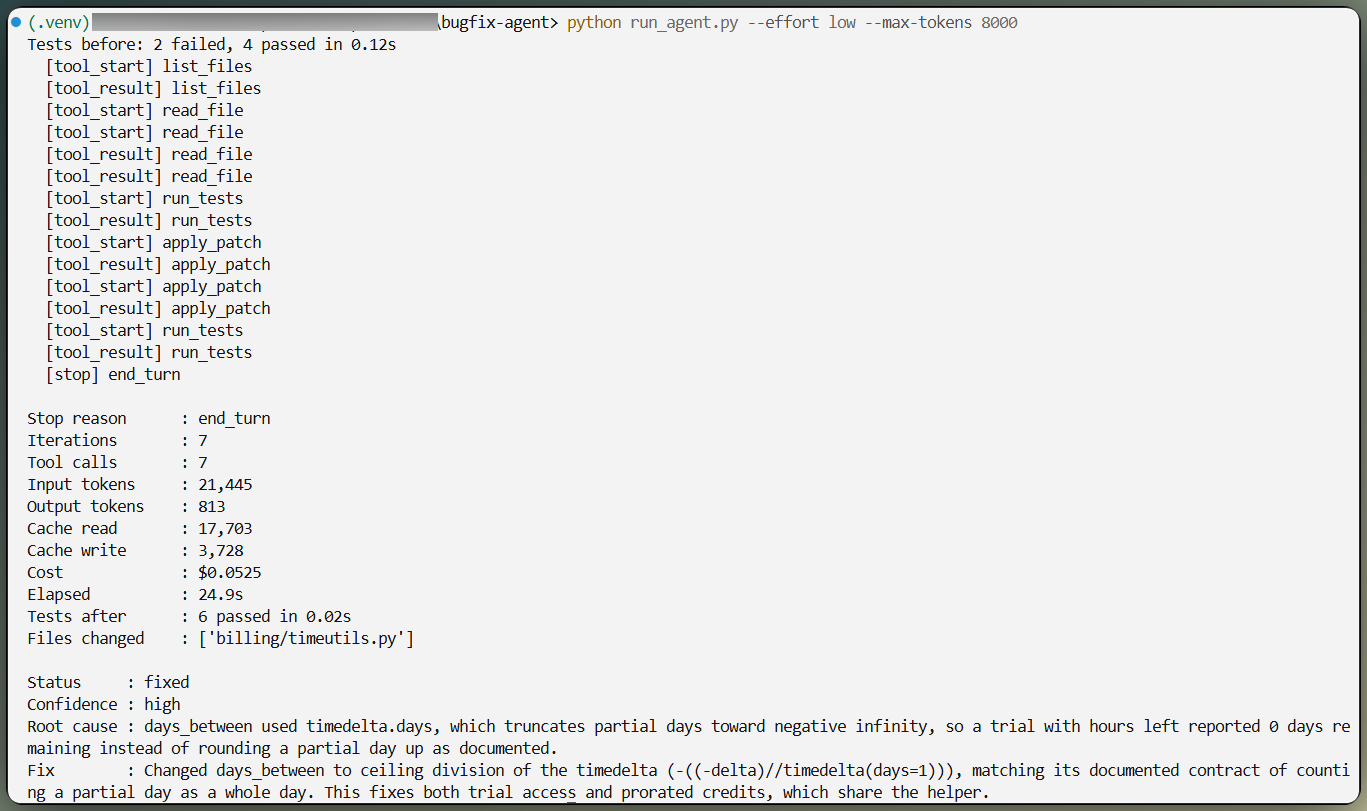
Aracı inceler, yamalar ve ardından testleri tekrar çalıştırır. Görsel: Yazar.
Düz yazı tek bir koşu için iyidir. Birçok koşuyu karşılaştırması gereken bir kıyaslama için tipli bir nesne isterim; bu yüzden döngü, Pydantic modelini output_format olarak geçirir ve SDK bunu kısıtlı kod çözmeyle bir JSON şemasına dönüştürür.
class RepairReport(BaseModel):
    status: Literal["fixed", "partial", "not_fixed"]
    root_cause: str
    files_inspected: list[str]
    files_changed: list[str]
    fix_summary: str
    tests_before: str
    tests_after: str
    remaining_risks: list[str]
    confidence: Literal["low", "medium", "high"]

    @field_validator("status", "confidence", mode="before")
    @classmethod
    def _normalize_case(cls, value):
        """Enum capitalization is not guaranteed, so fold it before validating."""
        return value.strip().lower() if isinstance(value, str) else value
Doğrulayıcı yerini hak ediyor. Yapılandırılmış çıktılar, enum büyük/küçük harfini garanti etmez; bu yüzden "high" bekleyen bir şema, "High" alabilir; üstelik hata da vermez, özel bir durdurma nedeni de döndürmez; bu da katı Literal doğrulamasının, esasen doğru olan bir yanıtı reddedeceği anlamına gelir.
Gecikme ve maliyeti bu şemadan uzak tutun. Model, vardığı sonucu raporlar; çalıştırıcı ise pytest’i yeniden çalıştırarak ve git diff okuyarak gerçekte olanı ölçer. Bunu daha sonra ayırmış olmaktan memnun kaldım; kıyaslama nedenini bariz biçimde gösteriyor.
Bu, eğitimin var olma sebebi olan deneydir: aynı hata, aynı istem, aynı araçlar; low, medium, high, xhigh ve max düzeylerinde. Çıktı belirli değildir ve örnekleme parametreleri bu modelde reddedilir; bu nedenle her düzeyi tekrarlamak elimdeki tek kontroldür.
Her koşu o temiz başlangıç işleminden başlar; sonra paketi önce ve sonra ölçer. Hata raporu, sistem istemi, araç tanımları, yineleme sınırı ve max_tokens her yerde aynıdır; yalnızca çaba dizesi değişir. Her düzeyi üç kez çalıştırdım.
Bir bütçe koruması, her isteğin ardından gerçek dört-oranlı maliyeti toplayıp bir tavana ulaşınca durdurarak her şeyi sarmalar. Aracı döngüleri, fazla harcamanın kolay bir yoludur ve sizin kontrol ettiğiniz bir durdurma koşulu, sayıyı sonradan keşfetmeye yeğdir.
Aşağıda, düzey başına üç koşunun ortalamaları yer alıyor; 26 Temmuz 2026’da ölçüldü.
|
Çaba |
Takım geçti |
Araç çağrıları |
Çıktı tokenları |
İlk çıktıya kadar süre |
Toplam süre |
Koşu başı maliyet |
|
|
3/3 |
8.0 |
827 |
2.9s |
24s |
$0.0387 |
|
|
3/3 |
8.0 |
1,008 |
2.7s |
26s |
$0.0466 |
|
|
3/3 |
10.0 |
1,352 |
2.9s |
29s |
$0.0659 |
|
|
3/3 |
11.3 |
1,546 |
2.8s |
35s |
$0.0778 |
|
|
2/3 |
8.3 |
1,787 |
6.6s |
38s |
$0.0762 |
Depoyla etkileşime giren her düzey, paylaşılan tarih yardımcısındaki aynı kök nedeni buldu ve tek dosyada yaklaşık dört satırla düzeltti. Hiçbiri oltaya düşüp deneme kontrolünü yamalamadı. On beş koşuluk matrisin toplam maliyeti 0,92 $ oldu.
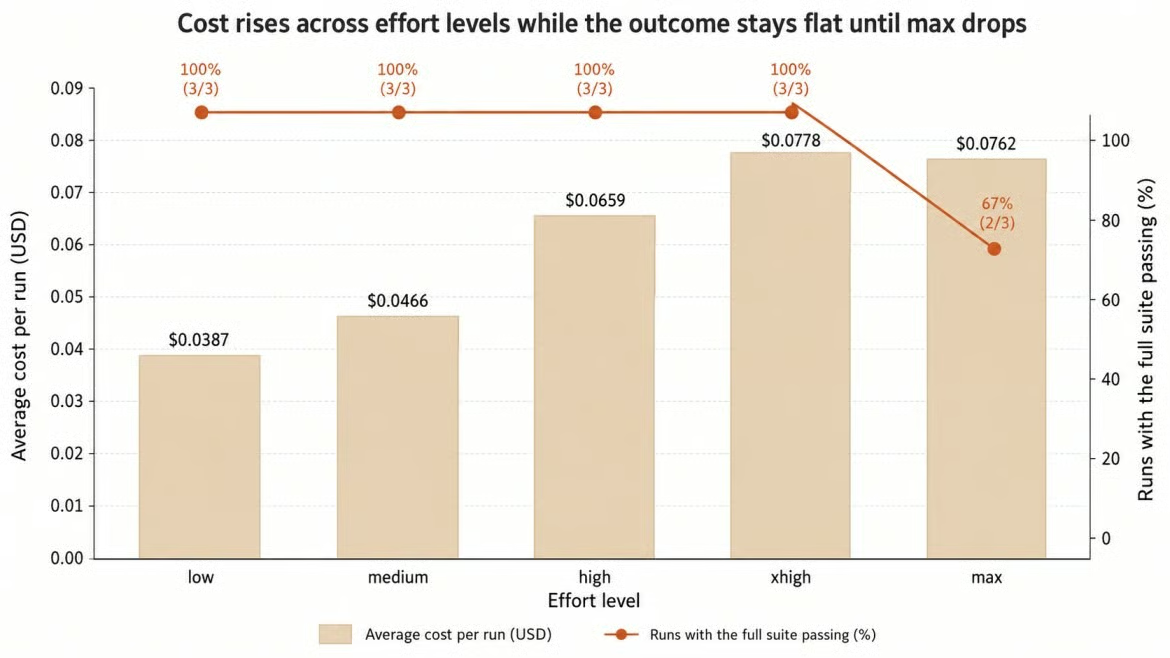
Maliyet artıyor, sonuç değişmiyor. Görsel: Yazar.
Dürüst okuma, bu görevin merdivenin tepesini dipten ayıracak kadar zor olmadığıdır. low ’dan xhigh ’a çıkmak, aynı sonuç için maliyeti iki katına çıkarıp on bir saniye ekledi. Bunu üretime gönderirken low çalıştırır ve farkı test kapsamına harcardım.
Şu max satırı bir açıklama gerektiriyor. Üç koşusundan biri, tek bir araç çağrısı yapmadan, ilk turda şemaya uygun bir rapor döndürdü; root_cause "b0" olarak ayarlanmıştı ve fix_summary boştı. Pydantic, şekil doğru olduğu için bunu kabul etti. Testlere dokunulmamıştı. Bunu dışarıda bırakırsak, diğer iki max denemesi hatayı, 12,5 araç çağrısı ve koşu başına 0,1112 $ ile düzeltti; bu da low’un yaklaşık üç katı maliyet demek.
Bu başarısızlığı tablodan daha öğretici buluyorum. Bir şema, özü değil yapıyı garanti eder ve report.status’a güvenen bir uygulama, hiçbir şey yapmayan bir koşuda "kısmi" bir başarıyı günlüğe kaydederdi. Çalıştırıcı bunu, modele inanmak yerine pytest çalıştırdığı için yakaladı. Bu yazıdan ne alırsanız alın, bunu alın. Ve göreviniz benimkinden farklı olduğundan, tüm bunları bir sonuçtan çok bir yöntem olarak görün.
Önbellekleme, döngünün ucuzladığı yerdir ve çaba düzeyleri arasında değil, bir koşu içinde çalışır. Çaba değerini değiştirmek, önbelleğe alınmış önekleri geçersiz kılar; bu nedenle her düzey kendi önbellek oluşturma maliyetini öder ve sıcak önbellek devredilmez. Tek bir koşu içinde durum farklıdır; çünkü sistem istemi ve araç tanımları hiç değişmezken geçmiş büyür.
Üst düzey bir cache_control alanı, otomatik önbelleklemeyi açar; bu da kesme noktasını son önbelleğe alınabilir bloğa koyar ve konuşma büyüdükçe onu ileri taşır.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    tools=TOOLS,
    cache_control={"type": "ephemeral"},
    messages=messages,
)
Ardışık iki tur, etkiyi net gösterir:
turn 1: uncached_input=2  cache_write=1231  cache_read=0     output=26
turn 2: uncached_input=2  cache_write=111   cache_read=1231  output=108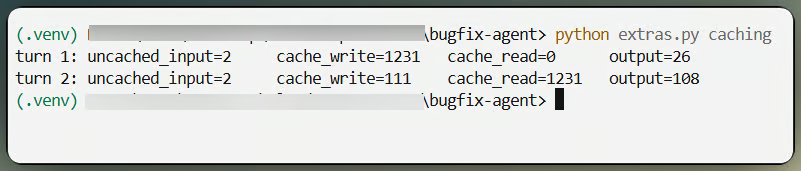
Önbelleğe alınmış önek, bir sonraki turda geri okunur. Görsel: Yazar.
Sabit önek 1.231 token; daha önce belirttiğim önbellek asgarisinin rahat üstünde. İkinci turda, yeni araç sonucu yazılırken on kat daha düşük giriş oranıyla geri okunur. Tam bir xhigh koşusu boyunca, yaklaşık 36.200 giriş tokenının yaklaşık 32.600’ü önbellekten geldi. Önbellekleme, çıktı tokenları için hiçbir şey yapmaz.
En faydalı bulduğum desen şu. Aracıyı salt-okunur araçlarla başlatın; yazma erişimini yalnızca sorunu teşhis ettikten sonra verin. Saf bir yaklaşımla araç eklemek, tools dizisini düzenlemek anlamına gelir; bu dizi ise önbelleğe alınmış öneğin en önünde durur ve tüm konuşmanın önbelleğini geçersiz kılar.
Konuşma ortasında araç değişiklikleri bunu çözer. Diziyi hiç değiştirmeyecek şekilde her aracı en baştan bildirin; sonra bireysel araçları bir noktadan itibaren sunmak veya geri çekmek için tool_addition ve tool_removal bloklarını kullanın. Bloklar bir role: "system" mesajının içinde gider ve bir sistem mesajı, messages içinde ilk giriş olamaz. Bu kısıtların hiçbiri bakacağınız yerde değildir; ben de ikisini muhtemelen tahmin ettiğiniz şekilde buldum.
withhold_patch = {
    "role": "system",
    "content": [{"type": "tool_removal",
                 "tool": {"type": "tool_reference", "name": "apply_patch"}}],
}
messages = [{"role": "user", "content": task_prompt}, withhold_patch]tool_removal’ı daha sonra tool_addition ile değiştirin ve araç geri gelir. Benim koşumda model, beş turu salt-okunur araştırmaya harcadı; teşhisiyle durdu ve ancak sonra apply_patch aldı; bunu altıncı ve yedinci turlarda kullandı; sonra paket geçti. Önbellek boyunca tutundu; 25.557 token geri okundu. Yazma erişimi, kanıt geldikten sonra ulaştı; bu da desenin gerçek gerekçesidir. Önce sabit araç döngüsünü çalıştırın; sonra bunu ekleyin.
Araçsal bir görev çok sayıda istek demektir; bu nedenle maliyet, son yanıttan ziyade toplamda yaşar. Her yanıtta dört sayı döner ve her biri farklı bir oranla faturalandırılır.
def cost_usd(self) -> float:
    return (
        self.input_tokens * 5.00
        + self.output_tokens * 25.00
        + self.cache_creation_input_tokens * 6.25
        + self.cache_read_input_tokens * 0.50
    ) / 1_000_000
Toplam girdi, üç girdi alanının toplamıdır; çünkü tek başına input_tokens yalnızca son önbellek kesme noktasından sonra geleni sayar; bu da eksik bildirme için yaygın bir yoldur. Çıktı tokenları, görünen metnin yanı sıra düşünme ve araç çağrılarını da içerir ve giriş oranının beş katında oldukları için yukarıdaki her koşuya hakim olurlar.
Ölçek büyütürken dikkat edilmesi gereken bir şey daha: önceki turlardaki düşünme blokları bağlamda kalır ve sonraki her turda yeniden faturalandırılır; bu yüzden uzun döngüler, araç sonuçlarının ima ettiğinden daha pahalıdır. Çevrimdışı değerlendirme için, Toplu API her iki oranı da yarıya indirir. Hızlı mod ise erişim kontrollü bir araştırma önizlemesi olarak milyon token başına 10 $ ve 50 $’a gider.
Bir de tek bir isteği değil, tüm döngüyü sınırlamanın bir yolu var. Görev bütçeleri, modele beta’da task-budgets-2026-03-13 arkasında tavsiye niteliğinde bir ödenek ve buna göre bir geri sayım verir; asgari 20.000 token. Bununla ilgili bir bölüm yazmıştım ve kestim; çünkü burada hiçbir fark ölçmedim ve sonuçsuz bir şey üç paragrafa ihtiyaç duymaz. İş, bütçeye yaklaşmadığında aynı şeyi bekleyin.
Mevcut çoğu Claude kodu, model dizesini değiştirdiğinizde çalışır. Hatalar birkaç noktada kümelenir ve aracı inşa ederken her birine rastladık; bu yüzden bunu yeni bir açıklamadan çok bir kontrol listesi olarak görün. Anthropic’in geçiş rehberi tam sürümü taşır.
response.content[0] artık genellikle metin değil, bir düşünme bloğudur
Seçili bloklardan asistan mesajı yeniden kurulan bir döngü, thinking ve redacted_thinking’i düşürür
max_tokens düşünmesiz bir model için ayarlanmışsa keser ve 21.333’ün üzerindeki her şey akış gerektirir
Düşünmenin kapatılması, xhigh veya max çabada 400 döndürür
Varsayılan olmayan temperature, top_p ve top_k reddedilir
Eski istemlerden taşınan doğrulama talimatları, Opus 5’i aşırı doğrulamaya iter
Priority Tier ve web fetch aracı, Opus 5’te mevcut değildir
Çaba, önceki modelde ayarladığınız değerden ziyade baştan bir taramayı hak eder
Sonuncusu en ısrarla savunacağım noktadır ve bu makale o savın kendisidir. İnce ayarlı ayarım, merdivendeki en ucuz ayar çıktı.
Bu, canlıya çıkmadan önce iki şey değişir. Aracı tarafından üretilen kod güvensiz koddur; bu yüzden araç katmanı, CPU, bellek ve zaman sınırları olan yalıtılmış bir ortamda olmalı ve üretilen bir yama, birleştirilmeden önce bir insanın önüne gitmelidir.
İkincisi daha az barizdir. Opus 5 güvenlik sınıflandırıcıları çalıştırır; güvenliğe yakın kod okuyan bir aracı, "cyber" sınırına yakındır; ancak bir ret, stop_reason: "refusal" ile HTTP 200 olarak gelir; bu yüzden 5xx oranlarına dayalı izleme, bunu hiç görmez. Retleri ayrı enstrümanlayın; altında null olabilen stop_details alanları yerine stop_reason’da dallanın ve hangi modelin yanıt verdiğini bilmek için kıyaslamalar sırasında fallbacks’ı kapatın.
Yanlış bir yanıtın maliyeti isteğin maliyetinden yüksek olduğunda Opus 5’i kullanın. Çok dosyalı hata ayıklama, kök neden analizi, depo genelinde inceleme, uzun araç döngüleri ve geçiş planlama buna uyar; çaba kademesi, rutin vakaları ucuza çalıştırmanıza ve zorlarda yükseltmenize imkân verir.
Biçimlendirme, sınıflandırma ve yüksek hacimli düşük karmaşıklık işleri için atlayın; burada Claude Sonnet 5 daha iyi dengedir. Doğrulayamayacağınız her şey için de atlayın; zira buradaki tüm değer dürüstçe yanıt veren bir test paketinden geldi. Fable 5’e iki kat ödemek, yalnızca en başta işaretlediğim işlerde karşılığını verir.
Gerçekte vereceğim yönlendirme, görev zorluğunu ölçmek ve buna göre çaba düzeyini seçmek; "daha güvenli" göründüğü için her şeyi merdivenin tepesine göndermek değil. Bu, daha güvenli değildir. Kıyaslamanın gösterdiği gibi, aynı yamayı almak için pahalı yoldu ve bir defasında hiçbir şey hakkında bir rapor üretti.
Depodaki Streamlit uygulaması bunu kendiniz çalıştırmanıza olanak tanır: bir çaba düzeyi seçin, muhakemeyi ve araç çağrılarını canlı izleyin ve aynı koşudan tokenları, maliyeti ve gecikmeyi okuyun. Depoyu, kıyaslamanın yaptığı gibi sıfırlar; böylece oluşturduğu tablo, benim değil sizin ölçümünüz olur. Aşağıdaki ekran kaydı iş akışını gösterir.
DataCamp ile öğrenin
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




