
课程
数据隐私入门
2 小时
30.7K
上个学期,我的数据库系统课程布置了一个看似简单的期末项目:构建一个可运行的电商应用,包含用户认证、购物车和订单处理。问题在于?我们必须用真实的数据模式来证明其有效性,而不是用三个名为 "Ali"、"Shahd" 和 "Khalid" 的测试用户糊弄过去。
我的团队立刻遇到了难题。我们需要数百条具有不同购买历史的客户记录,以测试批量订单、退款和库存管理等边界情况。我们不能从现有网站抓取真实数据——这既不道德也违法。手工创建数百条逼真的记录又会耗费大量时间。就在这时,教授向我们介绍了数据脱敏。
本文将分享我在实施数据脱敏技术中的亲身经验。您将了解什么是数据脱敏、何时以及为何需要它,以及如何应用具体技术在保持数据可用性的同时保护敏感信息。我会结合项目中的实用示例,并告诉您如何避免我在过程中踩过的坑。
刚听到“数据脱敏”这个词时,我脑海里浮现的是政府文档的涂黑处理,把敏感部分抹掉。实际上,数据脱敏更复杂也更有用。它会创建在结构上相似但在事实层面虚假的数据版本。
技术上,脱敏通过用虚构的替代值替换原始数据,同时保留其格式、类型和统计特性。在我们的电商项目中,我们从一个数据生成工具获取了一小份逼真的客户信息数据集,并应用脱敏技术生成变体。比如,将 khalid.abdelaty@company.com 替换为 ahmed.j@enterprise.com。两者都是通过校验的有效邮箱格式,但脱敏版本不会泄露任何真实人物信息。
不同人称呼这个概念的方式不同。Data obfuscation(数据混淆)强调隐藏本身。Pseudonymization(假名化)特指在保留必要情况下可重新识别能力的同时,用替代标识取代可识别信息。Tokenization(令牌化)则是以随机生成的令牌替换敏感值。这些术语高度重叠,在文档和教程中,人们经常交替使用。
此时您也许会想,这些新邮箱或 ID 是否某种程度上来自原数据?简短回答:取决于所用的脱敏技术。更多信息我放在了常见问题中。
当教授指出我们的“课堂项目”其实反映了真实生产挑战时,我才真正意识到其重要性。公司需要用接近生产的数据测试软件,分析师需要用具有真实模式的数据构建模型。但在这些环境中使用真实客户数据会带来严重问题。
合规位于大多数组织关注点的首位。欧洲隐私法规 GDPR 要求组织最小化数据处理并通过适当的技术措施保护个人信息。HIPAA 要求医疗服务提供者即便在测试环境中也要保护患者信息。加州消费者隐私法为加州居民提供了类似保护。从业务角度看,违反这些法规意味着巨额罚款。从道德角度看,人们理所当然地期望他们的数据被保护。
数据脱敏还提供关键的安全收益。每增加一个保存真实数据的环境,攻击面就会扩大。开发服务器的安全控制通常弱于生产系统,开发者还常在本地机器上处理数据,而这些机器可能未加密。每种情形都引入了泄露风险;通过确保非生产环境不包含真实信息,数据脱敏可以消除这些风险。
最让我惊讶的是它带来的实际开发收益。我们的 QA 测试发现了许多用三位测试用户永远发现不了的缺陷。一个队友的代码在处理带撇号的名字(如 "O'Brien")时崩了。另一个在处理使用加号别名的邮箱(如 "user+tag@domain.com")时出错。之所以能发现这些边界情况,是因为我们依据真实模式生成的脱敏数据集包含了生产数据的复杂性。
理解适用场景后,我开始能在各种语境中识别脱敏。最明显的场景与我们的课堂项目类似:软件开发与测试。构建新功能或调试现有代码时,开发者需要能代表真实世界复杂度的数据。我曾花了数小时调试为何我们购物车的计算在某些商品组合上会出错。这个问题只有在我们的脱敏数据集包含诸如零元商品和数量上限等边界情况时才会出现。
数据分析和研究项目常常需要具有真实统计特性的大型数据集。一位队友在另一个分析项目中需要客户购买模式来构建推荐算法。她并不需要真实的客户姓名或地址,只需要行为模式。脱敏数据既提供了这些模式,又保护了隐私。
外部协作是另一个常见用例。公司经常为集成项目雇佣顾问或承包商,他们需要逼真的数据,但不应接触敏感客户信息。员工培训同样是实际应用。在接触生产系统之前,人们需要具备逼真但安全数据的练习环境。最后一个例子是云端开发也受益于脱敏,尽管主要云服务商会将自有的脱敏工具作为其安全服务的一部分提供。
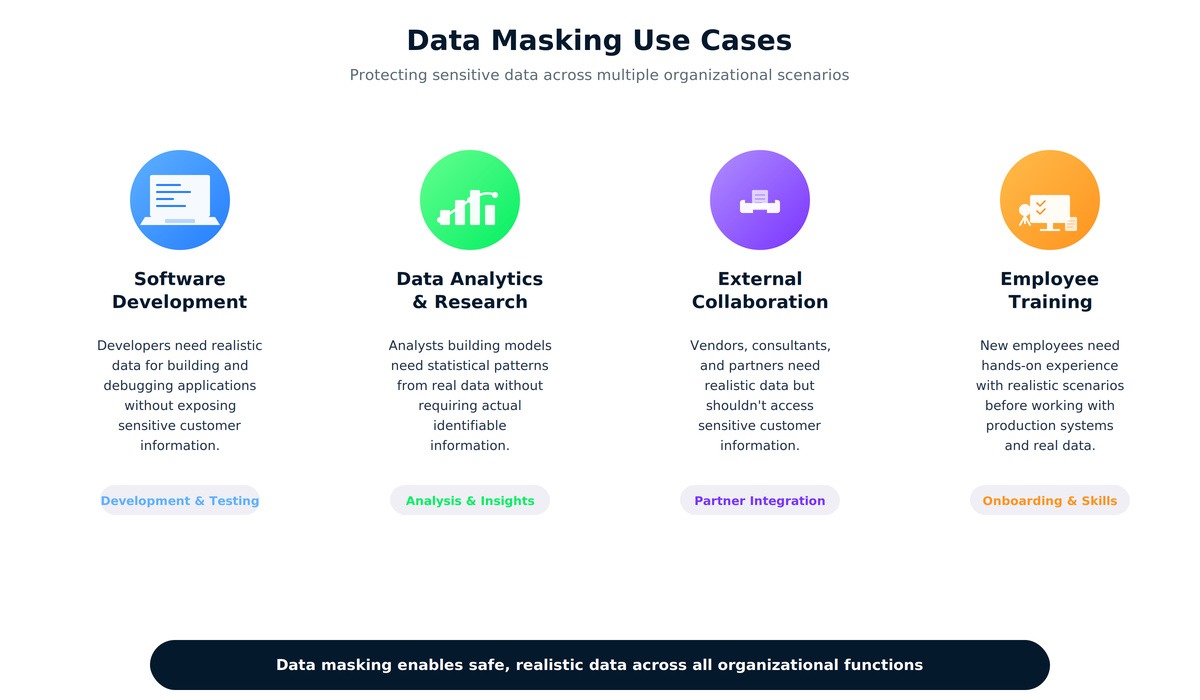
数据脱敏服务于从开发到合规的多种组织需求
在深入具体技术之前,值得先了解主要的脱敏类型及其适用场景。
静态脱敏在存储的数据集上操作,创建与原始数据相互独立的脱敏副本。这正是我们在电商项目中使用的方法。我运行了一个 Python 脚本读取初始数据集,应用脱敏转换,并将结果写入一个新文件,供大家开发使用。创建后,这个脱敏数据集保持稳定,直到需要用新模式刷新。其优势很快就显现:性能开销只在脱敏过程中发生一次,非常适合非生产环境——一次脱敏,多次复用。
动态脱敏在用户访问数据时实时发生,并基于权限应用转换。我第一次接触这个概念是在阅读数据库安全特性时。系统管理员可查看完整的客户记录,而客服代表看到的是被脱敏的信用卡号。底层数据不变,但每位用户看到的内容取决于其授权级别。该方法适用于生产系统,根据角色为不同用户提供不同视图。
确定性脱敏确保一致性:相同输入总被替换为相同输出。如果客户 "Sarah Ali" 在一张表里被替换为 "Eman Mohamed",那么在所有出现 Sarah Ali 的地方都应一致替换。正如我将在技术部分解释的,这种一致性对于维护跨数据库表的关系至关重要。我们的项目要求确定性脱敏,以保证客户 ID 在客户表、订单表和评价表中保持一致。
即时脱敏在环境间数据传输时应用转换。我在为个人项目搭建部署流水线时试验过这种方式。脱敏在数据抽取过程中完成,而不是单独步骤,这简化了工作流,特别适合 CI/CD 流水线。
研究人员需要访问数据模式以发现趋势、检验假设并构建可靠模型,但共享真实世界数据往往有暴露敏感信息的风险。统计混淆(另一种数据脱敏形式)提供了解决方案。正确实施时,它会保留关键统计特性——比如均值、方差和相关性,同时对个体记录保密。这样,分析师就能在不损害隐私的情况下从数据中得出有效洞见。
在我们的项目里,理论在这里落地。接下来每种技术都解决了我们遇到的某个具体难题。
对于大多数可识别个人身份信息,替换成了我的默认方法。概念很直接:用逼真但完全虚构的值替换敏感值。姓名变成其他姓名,邮箱变成其他邮箱。替换值保留相同格式,并在外观上足够“真”。
在电商项目中,我需要快速脱敏客户信息。我发现了Faker 库,可通过 pip install Faker 安装,并写了一个简单的脱敏函数。Faker 能生成大量逼真的假数据,非常适合脱敏操作:
from faker import Faker
import pandas as pd

fake = Faker()

def mask_customer_data(customer_df):
    masked_df = customer_df.copy()

    masked_df['first_name'] = [fake.first_name() for _ in range(len(masked_df))]
    masked_df['last_name'] = [fake.last_name() for _ in range(len(masked_df))]
    masked_df['email'] = [fake.email() for _ in range(len(masked_df))]

    return masked_df

# Example usage
original_customers = pd.DataFrame({
    'customer_id': ['C001', 'C002', 'C003'],
    'first_name': ['Khalid', 'Sarah', 'Mohamed'],
    'last_name': ['Abdelaty', 'Ahmed', 'Ali'],
    'email': ['khalid.a@email.com', 'sarah.a@email.com', 'mali@email.com']
})

masked_customers = mask_customer_data(original_customers)上述代码接收一个pandas 的客户记录 DataFrame,并将可识别信息替换为虚构替代值。在我们的初始数据集上运行大约两分钟,就生成了数百个看起来很真实的客户姓名和邮箱。Faker 处理了生成多样、可信姓名和正确格式邮箱的复杂性。我也了解到,由于输出是随机生成的,无法直接被重新识别,这一点让我很放心。
我学到的一点是:脱敏数据需要足够“真实”,以免在开发时让大脑本能地排斥。早期我试过用随机字母组合,但给名为 "Xkqp Mmwz" 的客户调试代码感觉很荒诞,反而更难专注于逻辑问题。像 "Jennifer Martinez" 和 "Robert Chen" 这种 Faker 生成的名字就自然得多,便于认真工作。
若要进一步学习 Python 中的数据处理,我们的Python 数据科学入门课程涵盖了实施这些及其他技术所需的核心 DataFrame 操作。
洗牌解决了一个我起初没预料到的问题。我们的项目包含一个管理后台,展示按客户人群划分的平均购买金额。我们需要逼真的购买金额以测试聚合查询是否正确,但不需要将具体客户与具体购买关联。
洗牌会在列内随机重排值,同时保留整体分布:
import numpy as np
import pandas as pd

def shuffle_column(df, column_name):
    shuffled_df = df.copy()
    shuffled_values = shuffled_df[column_name].values
    np.random.seed(42)  # For reproducibility
    np.random.shuffle(shuffled_values)
    shuffled_df[column_name] = shuffled_values
    return shuffled_df

# Example with purchase data
purchase_data = pd.DataFrame({
    'customer_id': ['C001', 'C002', 'C003'],
    'product': ['Laptop', 'Headphones', 'Mouse'],
    'amount': [1200, 85, 25]
})

shuffled_purchases = shuffle_column(purchase_data, 'amount')
洗牌后,购买金额仍存在于数据集中(我们仍可计算准确的均值和分布),但 C001 客户与 1200 美元购买之间的联系被打断。C001 客户现在可能显示为 25 美元的购买。
关键点在于:洗牌在打破个体层面关联的同时,保留了聚合分析所需的统计特性。当您测试面向聚合而非个体记录的功能时,这非常合适。
部分脱敏只显示必要信息,隐藏其余部分。这种技术很常见:网站将信用卡号显示为 ****-****-****-1234,应用将电话号码显示为 (***) ***-5678。
在我们的项目中实现它很直接:
def mask_credit_card(card_number):
    visible_digits = 4
    masked_portion = '*' * (len(card_number) - visible_digits)
    return masked_portion + card_number[-visible_digits:]

def mask_phone(phone):
    return '***-***-' + phone[-4:]

# Examples
print(mask_credit_card('4532123456781234'))  # ************1234

print(mask_phone('555-0123'))  # ***-***-0123
我们在订单历史视图中使用了它,客户需要确认用于支付的卡片。显示后四位足以帮助识别,而不暴露完整卡号。这种做法在实用性与隐私之间找到了平衡。
有时最简单的解决方案就是完全移除数据。置空会将不必要用于测试的信息替换为 NULL 或空字符串。
def null_fields(df, fields_to_null):
    masked_df = df.copy()
    for field in fields_to_null:
        masked_df[field] = None
    return masked_df
我们的客户记录包含一个“备注”字段,供假想的客服人员写内部评论。该字段与购物车逻辑或支付处理测试无关,所以我直接将其置空。既然可以从测试数据中移除,何必费力造假备注?
这让我明白了一个重要道理:别把脱敏搞复杂。该脱敏的脱敏,不该存在的干脆移除。
当保持与原始数据的任何关联都没有意义时,随机化会为字段生成全新的值。这对标识符和参考号很有用:
import random
import string

def randomize_order_id():
    return 'ORD-' + ''.join(random.choices(string.ascii_uppercase + string.digits, k=8))

order_ids = [randomize_order_id() for _ in range(5)]
print(order_ids)
我们的订单 ID 不需要与原始数据集中的任何内容匹配。它们只需要看起来逼真且唯一。随机生成两者兼顾。每个像 "ORD-K7M2N9P4" 这样的 ID 看起来都像可信的订单编号,同时不指向任何真实信息。
令牌化用随机生成的令牌替换敏感值,同时将原始数据安全地存放在一个独立的、高度受保护的系统中。与其他脱敏技术不同,令牌化设计为可逆,但必须通过受控访问实现。我在研究支付处理要求时了解了这种方法:
import uuid

# Note: Production token vaults use encrypted database storage, not in-memory dicts
class TokenVault:
    def __init__(self):
        self.token_map = {}
        self.reverse_map = {}

    def tokenize(self, sensitive_value):
        if sensitive_value in self.token_map:
            return self.token_map[sensitive_value]

        token = str(uuid.uuid4())
        self.token_map[sensitive_value] = token
        self.reverse_map[token] = sensitive_value
        return token

    def detokenize(self, token):
        return self.reverse_map.get(token)

vault = TokenVault()
token = vault.tokenize('4532-1234-5678-9012')
print(f"Token: {token}")
original = vault.detokenize(token)
print(f"Original: {original}")
我们在课堂项目中没有实现令牌化,因为无需可逆。但阅读支付系统后,用例就清晰了:应用数据库只存令牌(无用的随机字符串),真正的支付信息保存在完全独立、重兵把守的令牌库里。如果应用数据库被攻破,攻击者得到的也只是无意义的令牌,若不攻破令牌库,就无法访问真实信用卡号。这种架构隔离使令牌化在支付合规中特别有价值。
密码学技术使用数学算法转换数据。教授反复强调绝不要存明文密码后,我为我们的密码存储实现了哈希。在生产系统中,应使用 bcrypt 或 Argon2,它们引入盐并在计算上更昂贵,以抵抗暴力破解。这里演示 bcrypt,Argon2 也同样适用于生产:
import bcrypt

def hash_password(password):
    # Generate a salt and hash the password
    salt = bcrypt.gensalt()
    hashed = bcrypt.hashpw(password.encode(), salt)
    return hashed

def verify_password(password, hashed):
    # Verify a password against its hash
    return bcrypt.checkpw(password.encode(), hashed)

# Store the hash, never the actual password
password = 'user_password_123'
password_hash = hash_password(password)
print(f"Stored hash: {password_hash}")
# Output: Stored hash: b'$2b$12$K7g.../XYZ' (different each time due to random salt)

# Verify during login
is_valid = verify_password('user_password_123', password_hash)
print(f"Password valid: {is_valid}")  # Output: Password valid: True
哈希是一种单向转换,适用于校验。刚测试时让我惊讶的是,bcrypt 因随机盐每次都会生成不同的哈希,但 verify_password() 仍能正确匹配原密码。盐确保即便密码相同也会产生不同哈希,从而抵御彩虹表攻击。登录时,我们对提交的密码进行哈希,并用 bcrypt 的校验函数安全比较。即便开发者有数据库访问权限,也看不到用户密码。
注意:使用该示例需要通过 pip install bcrypt 安装 bcrypt。
加密与哈希不同,它允许用密钥解密回原始形式。我们的项目不需要加密,但我理解其用途:当授权方需要访问真实数据,同时又要保护其免受未授权访问时使用。
这两种相关技术在可逆性上有所不同。假名化用替代标识取代可识别信息,同时保留必要时重新识别个体的能力。匿名化则彻底移除可识别信息,使重新识别变得不可能。
def pseudonymize_data(df, id_column, key_mapping=None):
    if key_mapping is None:
        key_mapping = {}

    pseudo_df = df.copy()

    for idx, original_id in enumerate(pseudo_df[id_column].unique()):
        if original_id not in key_mapping:
            key_mapping[original_id] = f"PSEUDO_{idx:06d}"
        pseudo_df.loc[pseudo_df[id_column] == original_id, id_column] = key_mapping[original_id]

    return pseudo_df, key_mapping

# Using pseudonymization
customer_data = pd.DataFrame({
    'customer_id': ['C001', 'C002', 'C001'],
    'purchase': ['Laptop', 'Mouse', 'Keyboard']
})

pseudonymized_data, mapping = pseudonymize_data(customer_data, 'customer_id')
我们的项目使用假名化,在隐藏真实客户标识符的同时,保持同一客户在多次购买中的一致性。客户 C001 的三次购买都映射到同一假名,从而既能分析个体客户行为,又不暴露真实身份。
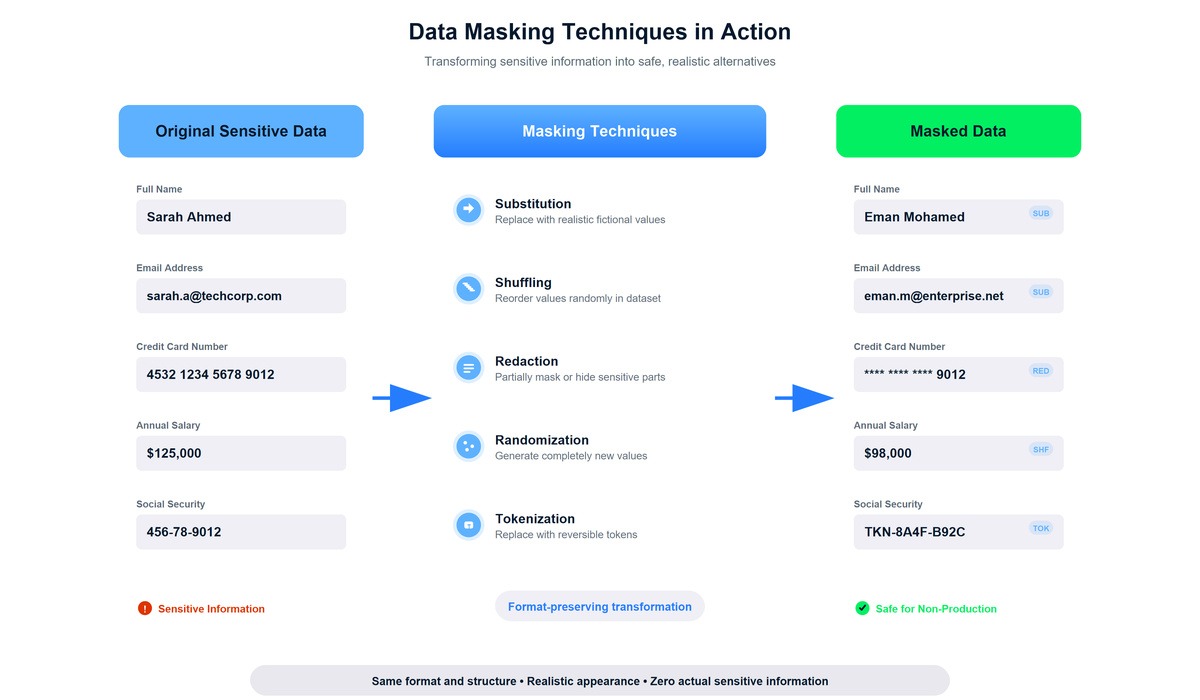
多种脱敏技术在保持格式与可用性的同时转化敏感数据
一开始,我把数据脱敏与加密、匿名化混为一谈,因为它们都涉及保护敏感信息。理解其差异有助于在不同场景下选择合适技术。下面我以更清晰的方式分解关键区别,帮助您判断各自的使用时机。
|
方法 |
工作原理 |
可逆性 |
最佳用例 |
|
数据脱敏 |
用虚构但逼真的值替换敏感数据 |
不可逆(无源数据库无法恢复) |
开发、测试与分析环境中需要真实数据结构但不需要真实取值的场景 |
|
加密 |
用数学算法对数据进行加扰 |
可用解密密钥逆转 |
在授权用户需要访问原始取值时保护传输或存储中的数据 |
|
匿名化 |
移除或泛化可识别信息 |
不可逆(旨在防止重新识别) |
在保护个人隐私的前提下,发布用于研究或公共使用的数据集 |
|
合成数据 |
用统计模型或机器学习生成完全人工的数据集 |
不适用(无原始数据可逆回) |
训练机器学习模型,或当即便是脱敏的真实数据也显得过于风险的场景 |
在数据库安全单元中,我清楚地体会到加密与脱敏的区别。我们对数据库备份进行加密,以防被盗后仍无用;而对开发数据库进行脱敏,因为开发者需要使用数据,但不应看到真实客户数据。正如前文所述,加密保护的是最终会被解密的数据;而脱敏创造的是永久安全的替代数据。
脱敏与匿名化的区别在于目标不同。匿名化专注于移除可识别信息,通过如泛化(将精确年龄替换为年龄段)、抑制(完全移除识别属性)等技术防止重新识别。脱敏则强调为开发、测试与分析保留数据的实用性。
一位同学在机器学习项目中用真实数据模式生成的合成数据。合成数据不包含任何真实记录,但保留了模型训练所需的统计特性。我之所以为我们的项目选择脱敏而非合成数据,是因为我们需要测试特定情景,比如处理重复邮箱或处理国际地址。合成数据可能无法覆盖这些边界情况,而脱敏的真实数据能保留它们。
实施脱敏让我明白,在保护敏感信息的同时保持数据可用性,需要应对许多只有亲历后才会意识到的挑战。下面我按经历带您过一遍主要障碍与解决办法。
属性保持比预期更棘手。简单的随机替换会打破应用所依赖的模式。信用卡号需符合Luhn 算法的校验,邮箱地址需要正确格式的域名,邮编与地理区域对应。我第一次脱敏时为信用卡字段随机生成了 16 位数字,看起来没问题,但一测试发现支付校验逻辑全部拒绝,因为我忘了信用卡号包含用 Luhn 算法计算的校验位。
语义完整性不仅仅是格式。脱敏数据应避免明显荒诞的组合。测试时,一位队友发现我们的脱敏数据集中把阿拉斯加的邮编分配给了佛罗里达的街道地址。虽然格式上合法,但地理不匹配很可疑。我花了一个下午改进语义一致性,通过生成地理一致的完整地址,而不是随意拼接地址组件。
跨表的参照完整性带来了显著复杂性。正如技术章节所述,我们的数据库有客户、订单和评价三张表,客户 ID 出现在三者中。如果脱敏对客户 ID 的转换不一致,关系会彻底破坏。这在我第一次尝试后就发生了,30% 的集成测试失败,因为客户订单不再关联到客户记录。转机在于我意识到需要按依赖顺序处理各表,并使用确定性脱敏,以确保 C001 在所有地方始终被转换为相同的脱敏 ID。
在安全与分析价值间取得平衡需要持续判断。更激进的脱敏提供更好的隐私,但会降低实用性。例如,将所有年龄四舍五入到整十岁可以提升隐私,但会消除有价值的基于年龄的分析。我们的项目偏向实用性,因为我们在构建需要真实数据行为的应用功能。在有真实客户数据和合规义务的生产场景中,我会更重视隐私防护,并可能接受较低的数据实用性。
统计关系可能被扭曲。如果您有两个相关列,如收入与支出,并将它们独立打乱,相关性很可能会变化。从统计角度看,独立打乱会改变变量的联合分布。为保持这种关系,分析师有时会使用保持秩次的转换,比如用同一随机置换同时洗两列,或添加保持联合排序的可控噪声。
学完这些单项技术后,我想看看它们如何在真实场景中协同工作。下面是一个完整示例,演示如何在具有相关订单的客户数据库上进行脱敏,这正是我们电商项目面临的挑战。
from faker import Faker
import pandas as pd
import numpy as np
import uuid

fake = Faker()
Faker.seed(42)  # For reproducible results

# Original datasets (simulating real customer data)
customers_original = pd.DataFrame({
    'customer_id': ['C001', 'C002', 'C003'],
    'first_name': ['Khalid', 'Sarah', 'Mohamed'],
    'last_name': ['Abdelaty', 'Ahmed', 'Ali'],
    'email': ['khalid.a@email.com', 'sarah.a@email.com', 'mali@email.com'],
    'phone': ['555-0123', '555-0124', '555-0125'],
    'credit_card': ['4532-1234-5678-9012', '4556-7890-1234-5678', '4539-8765-4321-0987'],
    'internal_notes': ['VIP customer', 'Requested callback', 'Payment issue resolved']
})

orders_original = pd.DataFrame({
    'order_id': ['ORD001', 'ORD002', 'ORD003', 'ORD004'],
    'customer_id': ['C001', 'C002', 'C001', 'C003'],
    'product': ['Laptop', 'Mouse', 'Keyboard', 'Monitor'],
    'amount': [1299.99, 29.99, 89.99, 399.99]
})

# Step 1: Create deterministic ID mapping to maintain referential integrity
def create_id_mapping(ids):
    """Create consistent pseudonymous IDs"""
    mapping = {}
    for idx, original_id in enumerate(ids):
        mapping[original_id] = f"CUST_{idx:06d}"
    return mapping

customer_id_mapping = create_id_mapping(customers_original['customer_id'].unique())

# Step 2: Mask customer data using multiple techniques
def mask_customer_database(df, id_mapping):
    masked = df.copy()

    # Pseudonymization: Replace customer IDs consistently
    masked['customer_id'] = masked['customer_id'].map(id_mapping)

    # Substitution: Replace names and emails with realistic fake data
    masked['first_name'] = [fake.first_name() for _ in range(len(masked))]
    masked['last_name'] = [fake.last_name() for _ in range(len(masked))]
    masked['email'] = [fake.email() for _ in range(len(masked))]

    # Partial masking/redaction: Show last 4 digits of phone and credit card
    masked['phone'] = masked['phone'].apply(lambda x: '***-' + x[-4:])
    masked['credit_card'] = masked['credit_card'].apply(lambda x: '****-****-****-' + x[-4:])

    # Nulling: Remove internal notes entirely
    masked['internal_notes'] = None

    return masked

# Step 3: Mask order data with referential integrity
def mask_order_database(df, id_mapping):
    masked = df.copy()

    # Pseudonymization: Use same customer ID mapping to maintain relationships
    masked['customer_id'] = masked['customer_id'].map(id_mapping)

    # Randomization: Generate new order IDs
    masked['order_id'] = [f"ORD-{uuid.uuid4().hex[:8].upper()}" for _ in range(len(masked))]

    # Shuffling: Preserve amount distribution but break individual associations
    shuffled_amounts = masked['amount'].values.copy()
    np.random.shuffle(shuffled_amounts)
    masked['amount'] = shuffled_amounts

    return masked

# Apply masking
customers_masked = mask_customer_database(customers_original, customer_id_mapping)
orders_masked = mask_order_database(orders_original, customer_id_mapping)

print("=== MASKED CUSTOMER DATA ===")
print(customers_masked)
print("\n=== MASKED ORDER DATA ===")
print(orders_masked)

# Verify referential integrity is maintained
print("\n=== VERIFICATION: JOIN STILL WORKS ===")
joined = customers_masked.merge(orders_masked, on='customer_id')
print(f"Original orders: {len(orders_original)}, Joined orders: {len(joined)}")
print("✓ All order-customer relationships preserved!")
当我在项目数据(500 条客户记录、1200 条订单)上运行这套完整的脱敏流水线时,执行约 2 秒,完全能满足我们每周刷新开发数据库的节奏。有几件事一下子就通了:
参照完整性运转良好。客户 CUST_000000(原为 C001)在客户表与订单表中都有关联。驱动我们订单历史功能的 JOIN 查询在脱敏数据上与原来完全一致,因为我们对两张表都使用了相同的 customer_id_mapping。
每种技术各司其职。 替换让客户姓名看起来真实;部分脱敏让我们在不暴露完整卡号的情况下核对支付方式;洗牌在断开金额与特定客户关联的同时,保留了分析看板展示准确营收分布的能力;置空则移除了测试不需要的数据。
输出看起来、用起来都像真数据。开发时浏览脱敏数据库,一切都很自然。邮箱能正确校验,电话显示正常。数据不会“嚷嚷着这是假数据”,这让我能专注于调试应用逻辑,而不是被明显的人为测试数据分散注意力。
数据质量保持较高水平。 我们仍能测试诸如一名客户拥有多笔订单等边界情况,计算聚合统计,并验证数据库约束。脱敏在保护每一个敏感信息的同时,保留了我们所需的复杂性与关系。
这种方法把最初看似棘手的问题——创建一个安全而逼真的测试数据库——转化为系统化、可复现的流程。每次刷新开发数据库,运行这段脱敏脚本都不到一分钟,让我们完全确信不会有任何真实客户数据泄露。
从全面的数据发现开始。 敏感信息可能出现在姓名、邮箱等显性字段之外的意外位置。我们的数据库中,客户备注字段包含自由文本,可能含有个人信息。我学会了系统性地审查每个字段,而不仅仅是显而易见的。生产系统中,组织会使用自动化数据发现工具,扫描符合个人可识别信息模式的内容。
尽早建立清晰的脱敏政策。 起初不同队友独立做脱敏决策,导致不一致。有人把电话完全脱敏,有人做部分脱敏,还有人保持不变。我们最终统一标准:姓名与邮箱完全脱敏,电话与卡号部分脱敏,内部备注置空。成文的政策应明确哪些数据元素需要脱敏、不同类型适用哪些技术,以及如何处理边界情况。
使用保留格式的算法。 这类算法不是用随机值替换,而是生成满足与原数据相同校验规则的逼真替代值。如前所示,我在信用卡脱敏时需要生成通过 Luhn 校验的号码,而邮箱脱敏需要使用格式正确、域名模式有效的地址。
严格测试脱敏质量。 我在用于开发前编写了简单测试来验证脱敏数据质量。这些测试检查脱敏邮箱是否能通过正则校验、客户 ID 脱敏后是否仍唯一、外键关系是否仍有效,以及脱敏数据集大小是否与原始一致。这些测试能在应用测试前捕捉到如重复生成、参照完整性破坏等问题。
将整个流程自动化。 我第一次脱敏要手动运行 Python 脚本并到处拷文件,很快就变得乏味。后来我做了一个一体化脚本:读取原数据、应用所有脱敏转换、校验结果并写出脱敏数据。对于有持续集成流水线的真实项目,脱敏应作为自动化步骤集成,让开发者无需操心。
确保不可逆且可复现。 脱敏过程应不可逆以提供真正保护,但在需要用一致结果刷新测试数据库时又要可复现。正如完整示例中所示,使用具有一致随机种子的确定性技术即可实现这种平衡。
随着人工智能与机器学习的发展,数据脱敏也在快速演进。虽然我们的课堂项目使用的是传统脱敏技术,但现代方案越来越多地借助 AI 来自动化并增强脱敏流程。
让我最兴奋的是自动化数据发现。我花了好几个小时手动审查数据库模式,以识别哪些字段包含敏感信息。想象一下,有个工具能通过分析模式、列名和取值分布自动识别敏感字段,而无需人工审查。一个机器学习系统可能会识别一个古怪命名的列“user_identifier”其实是邮箱地址——这类情况我在手工检查时很容易忽视。这会大幅节省我的时间。
我也一直在阅读关于超越传统脱敏的隐私保护型机器学习技术。比如差分隐私会向训练数据或模型输出添加精心校准的数学噪声。联邦学习让模型在分布式数据集上训练,而无需集中敏感信息。这些方法适用于标准脱敏可能会剥离模型所需模式的场景。
利用生成式 AI 的合成数据生成尤其让我对未来项目充满兴趣。AI 系统基于真实数据模式生成完全人工的数据集,而不是对真实记录进行脱敏。我尚未亲自尝试,但能理解其吸引力——尤其是在需要海量训练数据集,或即便脱敏后的真实数据也显得风险较高的场景。挑战在于确保合成数据能准确呈现那些让脱敏真实数据对测试特别有价值的边界情况与复杂性。
展望该领域的走向,云原生开发工作流正在将自动化脱敏作为标准基础设施加以整合。与其让我用 Python 脚本手动运行,部署流水线可以在供应开发数据库时自动处理脱敏。开发者可在与数据库模式相邻的配置文件中声明脱敏需求。这就是我未来项目里想要实现的自动化,让脱敏从手工的预处理步骤转变为自动的基础设施行为。
不过,AI 对数据隐私而言是一把双刃剑。它提升了脱敏技术的同时,也让重新识别攻击更为复杂。机器学习模型可以将看似匿名的数据与公共信息交叉比对,从而重新识别个体。研究人员曾著名地通过将“匿名化”的 Netflix 数据与 IMDb 影评关联重新识别了人群。随着脱敏工具变得更智能,破解方法也在升级。
数据脱敏在数据可用性与隐私之间找到了理想平衡。通过采用合适的技术,如替换、确定性脱敏和保留格式的方法,您可以在保护敏感信息的同时保持数据的真实感。
先识别最关键的数据集,并在非生产环境中应用脱敏。尽早自动化,让隐私保护成为工作流的标准组成部分。
若想深入学习,请探索我们的 Python 数据隐私与匿名化 或 人人可学的数据工程 课程。
与 DataCamp 一起学习
课程
课程
课程