
Khóa học
Nhập môn Quyền riêng tư Dữ liệu
2 giờ
30.8K
Học kỳ trước, môn hệ quản trị cơ sở dữ liệu của tôi giao một đồ án cuối kỳ thoạt nhìn khá đơn giản: xây dựng một ứng dụng thương mại điện tử hoạt động đầy đủ với xác thực người dùng, giỏ hàng và xử lý đơn hàng. Điểm mấu chốt? Chúng tôi phải chứng minh ứng dụng hoạt động với các mẫu dữ liệu thực tế, không chỉ ba người dùng thử tên là "Ali," "Shahd," và "Khalid."
Nhóm của tôi gặp ngay một vấn đề. Chúng tôi cần hàng trăm bản ghi khách hàng với lịch sử mua hàng đa dạng để kiểm thử các trường hợp biên như đơn hàng số lượng lớn, hoàn tiền và quản lý tồn kho. Chúng tôi không thể quét dữ liệu thật từ các trang web hiện có; điều đó vừa phi đạo đức vừa bất hợp pháp. Tạo thủ công hàng trăm bản ghi trông như thật sẽ tốn vô số thời gian. Đó là lúc giáo sư giới thiệu cho chúng tôi về che giấu dữ liệu (data masking).
Trong bài viết này, tôi sẽ chia sẻ những gì tôi học được từ trải nghiệm tự triển khai các kỹ thuật che giấu dữ liệu. Bạn sẽ biết che giấu dữ liệu là gì, khi nào và vì sao nó quan trọng, cũng như cách áp dụng các kỹ thuật cụ thể để bảo vệ thông tin nhạy cảm mà vẫn duy trì giá trị sử dụng của dữ liệu. Tôi sẽ trình bày các ví dụ thực tế từ dự án của mình và chỉ cho bạn cách tránh những sai lầm tôi từng mắc phải.
Khi lần đầu nghe thuật ngữ "che giấu dữ liệu," tôi hình dung giống như bôi đen văn bản trong tài liệu chính phủ, chỉ đơn giản che đi phần nhạy cảm. Thực tế tinh vi và hữu ích hơn nhiều. Che giấu dữ liệu tạo ra các phiên bản dữ liệu nhạy cảm có cấu trúc tương tự nhưng sai sự thật về mặt nội dung.
Về mặt kỹ thuật, quá trình này thay thế các giá trị gốc bằng các giá trị hư cấu nhưng vẫn giữ nguyên định dạng, kiểu và thuộc tính thống kê. Với dự án thương mại điện tử, chúng tôi lấy một tập nhỏ thông tin khách hàng trông như thật từ công cụ sinh dữ liệu và áp dụng kỹ thuật che giấu để tạo biến thể. Một email như khalid.abdelaty@company.com trở thành ahmed.j@enterprise.com. Cả hai đều là định dạng email hợp lệ vượt qua các kiểm tra xác thực, nhưng phiên bản đã che giấu không tiết lộ gì về người thật.
Bạn sẽ bắt gặp khái niệm này dưới các tên gọi khác nhau tùy người sử dụng. Data obfuscation (làm rối dữ liệu) nhấn mạnh khía cạnh che giấu. Pseudonymization (bút danh hóa) nói riêng về việc thay thế thông tin nhận dạng nhưng vẫn có khả năng tái nhận dạng khi cần. Tokenization (mã hóa bằng token) liên quan đến việc thay thế giá trị nhạy cảm bằng các token được tạo ngẫu nhiên. Các thuật ngữ này chồng lấn đáng kể và theo những gì tôi thấy trong tài liệu và hướng dẫn, mọi người thường dùng chúng gần như thay thế cho nhau.
Lúc này, bạn có thể thắc mắc những email hay ID mới đó có được suy ra từ dữ liệu gốc theo cách nào không. Câu trả lời ngắn gọn: còn tùy kỹ thuật che giấu. Tôi để thêm thông tin về việc này trong phần Câu hỏi thường gặp.
Tầm quan trọng trở nên rõ ràng khi giáo sư chỉ ra rằng "đồ án lớp" của chúng tôi phản chiếu các thách thức sản xuất thực tế. Doanh nghiệp cần kiểm thử phần mềm với dữ liệu giống sản xuất, và nhà phân tích cần xây dựng mô hình với các mẫu thực tế. Nhưng việc dùng dữ liệu khách hàng thật trong những môi trường này tạo ra vấn đề nghiêm trọng.
Tuân thủ quy định đứng đầu mối quan tâm của hầu hết tổ chức. GDPR, quy định bảo mật của châu Âu, yêu cầu tổ chức giảm thiểu xử lý dữ liệu và bảo vệ thông tin cá nhân bằng biện pháp kỹ thuật phù hợp. HIPAA yêu cầu nhà cung cấp dịch vụ y tế bảo vệ thông tin bệnh nhân ngay cả trong môi trường thử nghiệm. Đạo luật Quyền riêng tư của Người tiêu dùng California mở rộng các bảo vệ tương tự cho cư dân California. Về kinh doanh, vi phạm các quy định này đồng nghĩa với mức phạt khổng lồ. Về đạo đức, mọi người kỳ vọng dữ liệu của họ được bảo vệ.
Che giấu dữ liệu cũng mang lại lợi ích bảo mật quan trọng. Mỗi môi trường bổ sung có dữ liệu thật đều làm tăng bề mặt tấn công. Máy chủ phát triển thường có kiểm soát bảo mật yếu hơn hệ thống sản xuất, và nhà phát triển thường làm việc với dữ liệu trên máy cá nhân có thể không được mã hóa. Mỗi kịch bản như vậy đều giới thiệu rủi ro rò rỉ mà che giấu dữ liệu loại bỏ bằng cách đảm bảo các môi trường ngoài sản xuất không bao giờ chứa thông tin thật.
Điều khiến tôi ngạc nhiên nhất là những lợi ích phát triển thực tế. Kiểm thử QA của chúng tôi phát hiện các lỗi mà bộ dữ liệu ba người dùng ban đầu chẳng thể lộ ra. Mã của một thành viên bị hỏng khi xử lý tên có dấu nháy đơn như "O'Brien." Một người khác vỡ ở địa chỉ email dùng dấu cộng như "user+tag@domain.com." Những trường hợp biên này chỉ xuất hiện vì bộ dữ liệu đã che giấu, được dẫn xuất từ các mẫu thực tế, chứa mức độ phức tạp mà dữ liệu sản xuất thực có.
Hiểu khi nào áp dụng giúp tôi nhận ra nó trong nhiều ngữ cảnh khác nhau. Kịch bản rõ ràng nhất giống đồ án của chúng tôi: phát triển và kiểm thử phần mềm. Khi xây tính năng mới hoặc gỡ lỗi mã hiện có, nhà phát triển cần dữ liệu đại diện độ phức tạp ngoài đời. Tôi đã dành hàng giờ gỡ lỗi vì sao phép tính giỏ hàng hỏng với một số tổ hợp sản phẩm. Lỗi chỉ xuất hiện vì bộ dữ liệu đã che giấu của chúng tôi bao gồm các trường hợp biên như sản phẩm giá 0 và giới hạn số lượng.
Phân tích dữ liệu và dự án nghiên cứu thường đòi hỏi tập dữ liệu lớn với thuộc tính thống kê thực tế. Một đồng đội làm dự án phân tích riêng cần mẫu hành vi mua hàng của khách để xây thuật toán gợi ý. Cô ấy không cần tên hay địa chỉ thật, chỉ cần mẫu hành vi. Dữ liệu đã che giấu cung cấp được các mẫu đó mà vẫn bảo vệ quyền riêng tư.
Hợp tác bên ngoài là trường hợp sử dụng phổ biến khác. Doanh nghiệp thường thuê tư vấn hoặc nhà thầu cho dự án tích hợp, những người cần dữ liệu thực tế nhưng không nên truy cập thông tin nhạy cảm của khách hàng. Đào tạo nhân viên cũng là ứng dụng thực tiễn khác. Trước khi ai đó chạm vào hệ thống sản xuất, họ cần môi trường thực hành với dữ liệu trông thực tế nhưng an toàn. Cuối cùng, phát triển trên đám mây cũng hưởng lợi từ che giấu, dù các nhà cung cấp đám mây lớn có sẵn công cụ che giấu như một phần dịch vụ bảo mật.
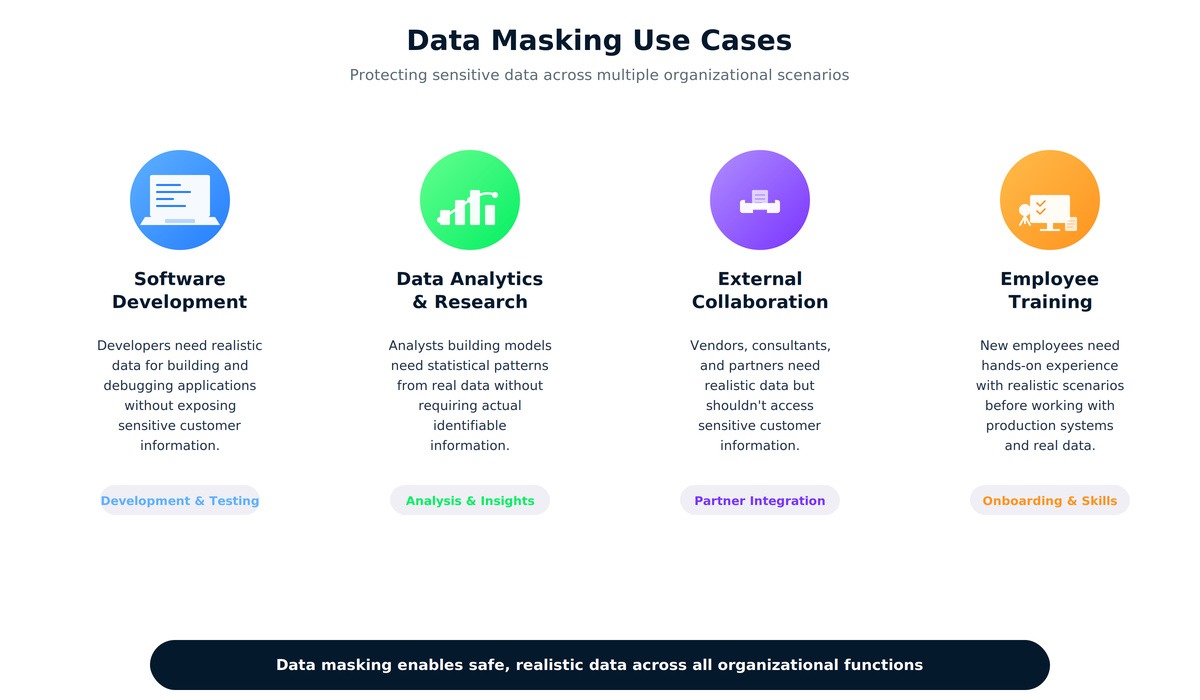
Che giấu dữ liệu phục vụ nhiều nhu cầu tổ chức từ phát triển đến tuân thủ
Trước khi đi vào kỹ thuật cụ thể, đáng để hiểu các loại che giấu chính và khi nào dùng mỗi loại.
Che giấu tĩnh hoạt động trên tập dữ liệu đã lưu trữ, tạo các bản sao đã che giấu tồn tại độc lập với dữ liệu gốc. Đây là cách chúng tôi dùng cho dự án thương mại điện tử. Tôi chạy một script Python đọc tập dữ liệu ban đầu, áp dụng biến đổi che giấu và ghi kết quả ra tệp mới mà cả nhóm cùng dùng để phát triển. Sau khi tạo, tập dữ liệu đã che giấu vẫn ổn định cho đến khi cần làm mới với các mẫu mới. Ưu điểm hiện rõ: tác động hiệu năng chỉ xảy ra một lần trong quá trình che giấu, lý tưởng cho môi trường ngoài sản xuất nơi bạn che một lần và dùng bản sao nhiều lần.
Che giấu động diễn ra theo thời gian thực khi người dùng truy cập dữ liệu, áp dụng biến đổi dựa trên quyền hạn. Lần đầu tôi gặp khái niệm này khi đọc về tính năng bảo mật cơ sở dữ liệu. Quản trị viên hệ thống thấy bản ghi khách hàng đầy đủ còn nhân viên hỗ trợ chỉ thấy số thẻ tín dụng đã che. Dữ liệu cơ sở không đổi, nhưng những gì mỗi người dùng thấy phụ thuộc mức uỷ quyền. Cách này phù hợp hệ thống sản xuất nơi người dùng khác nhau cần góc nhìn khác nhau theo vai trò.
Che giấu xác định đảm bảo tính nhất quán bằng cách luôn thay thế cùng một đầu vào bằng cùng một đầu ra. Nếu khách hàng "Sarah Ali" trở thành "Eman Mohamed" trong một bảng, biến đổi đó áp dụng ở mọi nơi Sarah Ali xuất hiện. Như tôi sẽ giải thích trong phần kỹ thuật, tính nhất quán này cực kỳ quan trọng để duy trì mối quan hệ giữa các bảng. Dự án của chúng tôi yêu cầu che giấu xác định để giữ ID khách hàng nhất quán giữa bảng customers, orders và reviews.
Che giấu tức thời áp dụng biến đổi trong lúc truyền dữ liệu giữa các môi trường. Tôi đã thử cách này khi thiết lập pipeline triển khai cho một dự án cá nhân. Che giấu diễn ra trong quá trình trích xuất dữ liệu thay vì một bước riêng, giúp đơn giản hóa quy trình và đặc biệt phù hợp cho pipeline CI/CD.
Nhà nghiên cứu cần truy cập mẫu dữ liệu để khám phá xu hướng, kiểm định giả thuyết và xây mô hình đáng tin cậy, nhưng chia sẻ dữ liệu thực tế thường có nguy cơ lộ thông tin nhạy cảm. Làm mờ thống kê (một dạng che giấu dữ liệu khác) là giải pháp. Khi làm đúng, nó giữ lại thuộc tính thống kê thiết yếu - ví dụ trung bình, phương sai và tương quan - đồng thời giữ bí mật các bản ghi cá nhân. Điều này cho phép nhà phân tích rút ra insight hợp lệ từ dữ liệu mà không đánh đổi quyền riêng tư.
Đây là phần lý thuyết gặp thực hành trong dự án của chúng tôi. Mỗi kỹ thuật tôi trình bày dưới đây giải quyết một thách thức cụ thể mà chúng tôi đã gặp.
Thay thế trở thành cách mặc định của tôi cho hầu hết thông tin nhận dạng cá nhân. Khái niệm rất trực quan: thay giá trị nhạy cảm bằng các giá trị thay thế trông thực tế nhưng hoàn toàn hư cấu. Tên trở thành tên khác. Địa chỉ email thành email khác. Giá trị thay thế giữ nguyên định dạng và trông chân thực với bất kỳ ai xem dữ liệu.
Với dự án thương mại điện tử, tôi cần che giấu thông tin khách hàng nhanh chóng. Tôi phát hiện thư viện Faker, có thể cài bằng pip install Faker, và xây một hàm che giấu đơn giản. Faker tạo ra vô số dữ liệu giả trông như thật, rất phù hợp cho thao tác che giấu:
from faker import Faker
import pandas as pd

fake = Faker()

def mask_customer_data(customer_df):
    masked_df = customer_df.copy()

    masked_df['first_name'] = [fake.first_name() for _ in range(len(masked_df))]
    masked_df['last_name'] = [fake.last_name() for _ in range(len(masked_df))]
    masked_df['email'] = [fake.email() for _ in range(len(masked_df))]

    return masked_df

# Example usage
original_customers = pd.DataFrame({
    'customer_id': ['C001', 'C002', 'C003'],
    'first_name': ['Khalid', 'Sarah', 'Mohamed'],
    'last_name': ['Abdelaty', 'Ahmed', 'Ali'],
    'email': ['khalid.a@email.com', 'sarah.a@email.com', 'mali@email.com']
})

masked_customers = mask_customer_data(original_customers)
Đoạn mã trên nhận một DataFrame pandas các bản ghi khách hàng và thay thế thông tin nhận dạng bằng giá trị hư cấu. Chạy trên tập dữ liệu ban đầu của chúng tôi mất khoảng hai phút và tạo ra hàng trăm tên và email trông rất thực tế. Thư viện Faker lo phần phức tạp khi sinh tên đa dạng, đáng tin và địa chỉ email đúng định dạng. Tôi cũng học được rằng vì đầu ra được tạo ngẫu nhiên nên không thể trực tiếp tái nhận dạng, điều mà tôi đánh giá cao.
Một điều tôi rút ra: Dữ liệu đã che giấu cần đủ chân thật để não bạn không “khước từ” trong lúc phát triển. Ban đầu, tôi thử dùng chuỗi chữ cái ngẫu nhiên, nhưng gỡ lỗi với khách hàng tên "Xkqp Mmwz" thật nực cười và khiến tôi khó tập trung vào vấn đề logic hơn. Các tên Faker sinh ra như "Jennifer Martinez" và "Robert Chen" tự nhiên đủ để làm việc nghiêm túc.
Để học thêm về thao tác dữ liệu trong Python, khóa học Giới thiệu Khoa học Dữ liệu bằng Python của chúng tôi bao quát các thao tác DataFrame nền tảng giúp triển khai những kỹ thuật này và các kỹ thuật khác dễ dàng hơn nhiều.
Xáo trộn giải quyết một vấn đề tôi không lường trước. Dự án của chúng tôi có bảng điều khiển quản trị hiển thị mức chi tiêu trung bình theo nhân khẩu học khách hàng. Chúng tôi cần các khoản chi tiêu trông thực tế để kiểm tra câu lệnh tổng hợp có hoạt động đúng, nhưng không cần gắn khách hàng cụ thể với khoản chi cụ thể.
Xáo trộn hoán vị ngẫu nhiên các giá trị trong một cột đồng thời giữ nguyên phân phối tổng thể:
import numpy as np
import pandas as pd

def shuffle_column(df, column_name):
    shuffled_df = df.copy()
    shuffled_values = shuffled_df[column_name].values
    np.random.seed(42)  # For reproducibility
    np.random.shuffle(shuffled_values)
    shuffled_df[column_name] = shuffled_values
    return shuffled_df

# Example with purchase data
purchase_data = pd.DataFrame({
    'customer_id': ['C001', 'C002', 'C003'],
    'product': ['Laptop', 'Headphones', 'Mouse'],
    'amount': [1200, 85, 25]
})

shuffled_purchases = shuffle_column(purchase_data, 'amount')
Sau khi xáo trộn, các khoản chi tiêu vẫn tồn tại trong tập dữ liệu (chúng tôi vẫn có thể tính trung bình và phân phối chính xác), nhưng mối liên kết giữa khách hàng C001 và khoản chi $1.200 đã bị phá vỡ. Giờ đây C001 có thể hiển thị khoản chi $25.
Điểm mấu chốt: Xáo trộn duy trì các thuộc tính thống kê cần cho phân tích tổng hợp đồng thời phá vỡ liên kết ở cấp cá nhân. Nó hoàn hảo khi bạn kiểm thử tính năng làm việc với số liệu tổng hợp thay vì từng bản ghi.
Che một phần chỉ hiển thị thông tin cần thiết và ẩn phần còn lại. Kỹ thuật này quen thuộc vì tôi thấy ở khắp nơi, trang web hiển thị số thẻ tín dụng như ****-****-****-1234 hoặc ứng dụng hiện số điện thoại như (***) ***-5678.
Triển khai cho dự án của chúng tôi khá đơn giản:
def mask_credit_card(card_number):
    visible_digits = 4
    masked_portion = '*' * (len(card_number) - visible_digits)
    return masked_portion + card_number[-visible_digits:]

def mask_phone(phone):
    return '***-***-' + phone[-4:]

# Examples
print(mask_credit_card('4532123456781234'))  # ************1234

print(mask_phone('555-0123'))  # ***-***-0123
Chúng tôi dùng cách này cho màn hình lịch sử đơn hàng, nơi khách cần xác nhận thẻ đã dùng để mua. Hiển thị bốn số cuối đủ để nhận diện mà không lộ toàn bộ số. Cảm giác đây là cân bằng hợp lý giữa tiện dụng và quyền riêng tư.
Đôi khi giải pháp đơn giản nhất là loại bỏ dữ liệu hoàn toàn. Gán NULL thay thế giá trị trường bằng NULL hoặc chuỗi rỗng khi thông tin không cần cho kiểm thử.
def null_fields(df, fields_to_null):
    masked_df = df.copy()
    for field in fields_to_null:
        masked_df[field] = None
    return masked_df
Bản ghi khách hàng của chúng tôi có trường "notes" nơi nhân viên chăm sóc khách hàng giả định có thể ghi chú nội bộ. Trường này không liên quan đến kiểm thử logic giỏ hàng hay xử lý thanh toán, nên tôi đơn giản gán NULL. Tại sao phải tạo ghi chú giả khi có thể loại bỏ hẳn khỏi dữ liệu thử?
Điều này dạy tôi bài học quan trọng về che giấu: đừng làm phức tạp hóa mọi thứ. Che những gì cần che, bỏ những gì không cần tồn tại.
Ngẫu nhiên hóa tạo giá trị hoàn toàn mới cho các trường mà việc giữ bất kỳ liên kết nào với dữ liệu gốc là vô nghĩa. Cách này hữu ích cho định danh và số tham chiếu:
import random
import string

def randomize_order_id():
    return 'ORD-' + ''.join(random.choices(string.ascii_uppercase + string.digits, k=8))

order_ids = [randomize_order_id() for _ in range(5)]
print(order_ids)
ID đơn hàng của chúng tôi không cần khớp với bất kỳ thứ gì trong tập dữ liệu gốc. Chúng chỉ cần trông thực tế và là duy nhất. Sinh ngẫu nhiên đáp ứng cả hai. Mỗi ID tạo ra như "ORD-K7M2N9P4" trông như tham chiếu đơn hàng hợp lý mà không liên kết với bất kỳ thứ gì thật.
Tokenization thay thế giá trị nhạy cảm bằng các token sinh ngẫu nhiên đồng thời lưu trữ dữ liệu gốc trong một hệ thống riêng biệt, được bảo vệ cực kỳ nghiêm ngặt. Khác với các kỹ thuật che giấu khác, tokenization được thiết kế để có thể đảo ngược, nhưng chỉ thông qua truy cập kiểm soát. Tôi biết về cách này khi nghiên cứu yêu cầu xử lý thanh toán:
import uuid

# Note: Production token vaults use encrypted database storage, not in-memory dicts
class TokenVault:
    def __init__(self):
        self.token_map = {}
        self.reverse_map = {}

    def tokenize(self, sensitive_value):
        if sensitive_value in self.token_map:
            return self.token_map[sensitive_value]

        token = str(uuid.uuid4())
        self.token_map[sensitive_value] = token
        self.reverse_map[token] = sensitive_value
        return token

    def detokenize(self, token):
        return self.reverse_map.get(token)

vault = TokenVault()
token = vault.tokenize('4532-1234-5678-9012')
print(f"Token: {token}")
original = vault.detokenize(token)
print(f"Original: {original}")
Chúng tôi không triển khai tokenization trong đồ án vì không cần khả năng đảo ngược. Nhưng đọc về hệ thống thanh toán khiến trường hợp sử dụng trở nên rõ ràng: Cơ sở dữ liệu ứng dụng chỉ lưu token (chuỗi ngẫu nhiên vô dụng), còn chi tiết thanh toán thực ở trong một kho token riêng biệt, bảo mật nghiêm ngặt. Nếu cơ sở dữ liệu ứng dụng bị xâm phạm, kẻ tấn công chỉ có token vô dụng, không thể truy cập số thẻ thật nếu không xâm nhập được chính kho token. Phân tách kiến trúc này khiến tokenization đặc biệt giá trị cho tuân thủ xử lý thanh toán.
Kỹ thuật mật mã biến đổi dữ liệu bằng thuật toán toán học. Tôi triển khai băm cho lưu trữ mật khẩu sau khi giáo sư nhấn mạnh không bao giờ lưu mật khẩu dạng rõ. Với hệ thống sản xuất, bạn nên dùng bcrypt hoặc Argon2, tích hợp salt và được thiết kế tốn tài nguyên để chống tấn công vét cạn. Tôi minh họa bcrypt ở đây, dù Argon2 cũng rất tốt cho sản xuất:
import bcrypt

def hash_password(password):
    # Generate a salt and hash the password
    salt = bcrypt.gensalt()
    hashed = bcrypt.hashpw(password.encode(), salt)
    return hashed

def verify_password(password, hashed):
    # Verify a password against its hash
    return bcrypt.checkpw(password.encode(), hashed)

# Store the hash, never the actual password
password = 'user_password_123'
password_hash = hash_password(password)
print(f"Stored hash: {password_hash}")
# Output: Stored hash: b'$2b$12$K7g.../XYZ' (different each time due to random salt)

# Verify during login
is_valid = verify_password('user_password_123', password_hash)
print(f"Password valid: {is_valid}")  # Output: Password valid: True
Băm tạo biến đổi một chiều hữu ích cho việc xác thực. Khi tôi thử lần đầu, tôi ngạc nhiên vì bcrypt tạo hash khác nhau mỗi lần do salt ngẫu nhiên, nhưng verify_password() vẫn khớp đúng mật khẩu gốc. Salt đảm bảo ngay cả mật khẩu giống hệt cũng cho ra hash khác nhau, bảo vệ trước tấn công bảng cầu vồng. Khi đăng nhập, chúng tôi băm mật khẩu gửi lên và dùng hàm xác thực của bcrypt để so sánh an toàn. Điều này có nghĩa ngay cả nhà phát triển có quyền truy cập cơ sở dữ liệu cũng không thấy mật khẩu người dùng.
Lưu ý: Bạn cần cài bcrypt với pip install bcrypt để chạy ví dụ này.
Mã hóa khác băm ở chỗ có thể giải mã về dạng gốc bằng khóa. Chúng tôi không cần mã hóa cho dự án, nhưng tôi hiểu mục đích của nó: Dùng khi bên được ủy quyền cần truy cập dữ liệu thật, nhưng bạn muốn bảo vệ khỏi truy cập trái phép.
Hai kỹ thuật liên quan này khác nhau ở khả năng đảo ngược. Bút danh hóa thay thế thông tin nhận dạng nhưng vẫn có khả năng tái nhận dạng cá nhân khi cần. Ẩn danh hóa loại bỏ hoàn toàn thông tin nhận dạng, khiến việc tái nhận dạng là không thể.
def pseudonymize_data(df, id_column, key_mapping=None):
    if key_mapping is None:
        key_mapping = {}

    pseudo_df = df.copy()

    for idx, original_id in enumerate(pseudo_df[id_column].unique()):
        if original_id not in key_mapping:
            key_mapping[original_id] = f"PSEUDO_{idx:06d}"
        pseudo_df.loc[pseudo_df[id_column] == original_id, id_column] = key_mapping[original_id]

    return pseudo_df, key_mapping

# Using pseudonymization
customer_data = pd.DataFrame({
    'customer_id': ['C001', 'C002', 'C001'],
    'purchase': ['Laptop', 'Mouse', 'Keyboard']
})

pseudonymized_data, mapping = pseudonymize_data(customer_data, 'customer_id')
Dự án của chúng tôi dùng bút danh hóa để duy trì tính nhất quán của khách hàng qua nhiều lượt mua trong khi ẩn ID khách hàng thật. Ba lần mua của khách hàng C001 đều ánh xạ về cùng một bút danh, giúp phân tích hành vi từng khách mà không lộ danh tính thật.
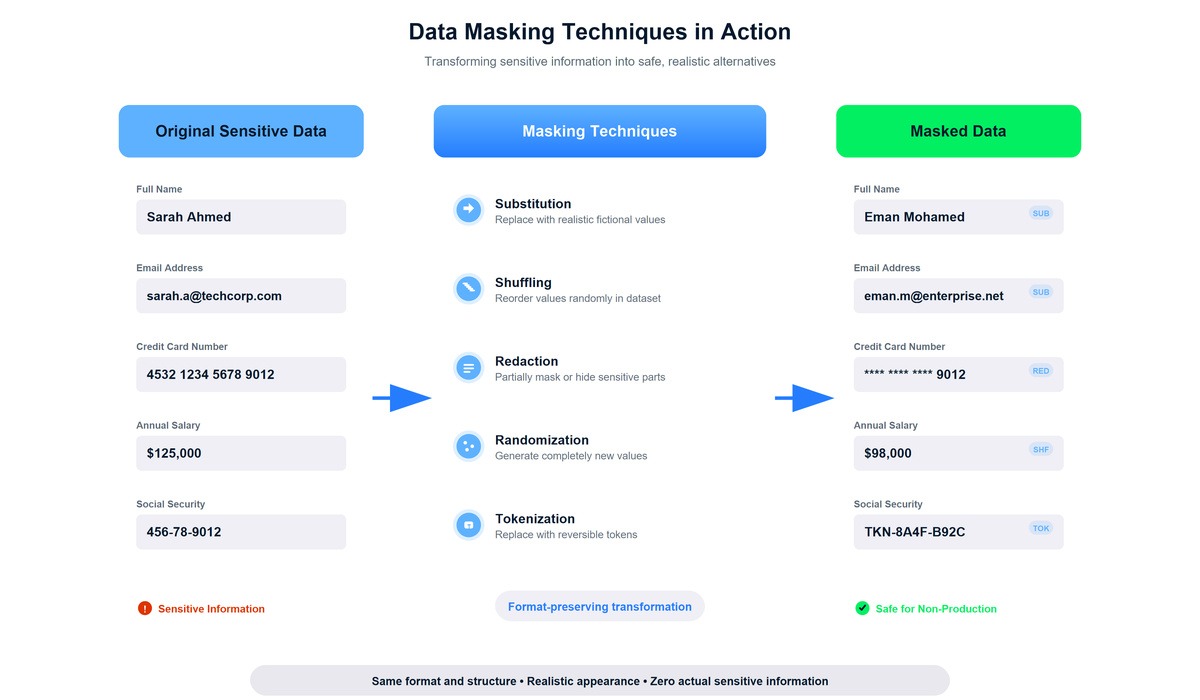
Nhiều kỹ thuật che giấu biến đổi dữ liệu nhạy cảm trong khi vẫn giữ định dạng và khả năng sử dụng
Ban đầu, tôi nhầm lẫn che giấu dữ liệu với mã hóa và ẩn danh hóa vì tất cả đều liên quan đến bảo vệ thông tin nhạy cảm. Hiểu sự khác biệt giúp tôi chọn kỹ thuật phù hợp cho từng kịch bản. Hãy để tôi phân tách những điểm khác nhau chính theo cách làm rõ khi nào dùng mỗi phương pháp.
|
Phương pháp |
Cách hoạt động |
Khả năng đảo ngược |
Trường hợp sử dụng tốt nhất |
|
Che giấu dữ liệu |
Thay thế dữ liệu nhạy cảm bằng các giá trị hư cấu nhưng trông thực tế |
Không thể đảo ngược (không thể khôi phục nếu không có cơ sở dữ liệu nguồn) |
Môi trường phát triển, kiểm thử và phân tích nơi cần cấu trúc dữ liệu thực tế nhưng không cần giá trị thật |
|
Mã hóa |
Xáo trộn dữ liệu bằng thuật toán toán học |
Có thể đảo ngược bằng khóa giải mã |
Bảo vệ dữ liệu khi truyền hoặc lưu trữ khi người dùng được ủy quyền cần truy cập giá trị gốc |
|
Ẩn danh hóa |
Loại bỏ hoặc tổng quát hóa thông tin nhận dạng |
Không thể đảo ngược (thiết kế để ngăn tái nhận dạng) |
Công bố tập dữ liệu cho nghiên cứu hoặc sử dụng công cộng trong khi bảo vệ quyền riêng tư cá nhân |
|
Dữ liệu tổng hợp (Synthetic Data) |
Sinh ra toàn bộ tập dữ liệu giả bằng mô hình thống kê hoặc ML |
Không áp dụng (không có dữ liệu gốc để đảo ngược về) |
Huấn luyện mô hình machine learning hoặc các kịch bản mà ngay cả dữ liệu thật đã che giấu cũng bị xem là quá rủi ro |
Tôi thấy rõ sự khác biệt giữa mã hóa và che giấu trong học phần bảo mật cơ sở dữ liệu. Chúng tôi mã hóa bản sao lưu cơ sở dữ liệu để nếu bị đánh cắp thì vô dụng, nhưng che giấu cơ sở dữ liệu phát triển vì nhà phát triển cần làm việc với dữ liệu, chỉ là không phải dữ liệu khách hàng thật. Như tôi đã đề cập, mã hóa bảo vệ dữ liệu mà bạn sẽ giải mã sau này, trong khi che giấu tạo ra bản thay thế an toàn vĩnh viễn.
Sự khác nhau giữa che giấu và ẩn danh hóa nhấn mạnh các mục tiêu khác nhau. Ẩn danh hóa tập trung vào việc loại bỏ thông tin nhận dạng để ngăn tái nhận dạng cá nhân thông qua các kỹ thuật như tổng quát hóa (thay tuổi chính xác bằng khoảng tuổi) và loại bỏ (bỏ hẳn thuộc tính nhận dạng). Che giấu nhấn mạnh duy trì tính hữu dụng của dữ liệu cho phát triển, kiểm thử và phân tích.
Một bạn cùng lớp làm dự án machine learning đã dùng dữ liệu tổng hợp sinh từ mẫu của một tập dữ liệu thật. Dữ liệu tổng hợp không chứa bản ghi thực nào nhưng mô phỏng thuộc tính thống kê cần cho huấn luyện mô hình. Tôi chọn che giấu thay vì dữ liệu tổng hợp cho dự án vì chúng tôi cần kiểm thử các kịch bản cụ thể như xử lý email trùng lặp hoặc địa chỉ quốc tế. Dữ liệu tổng hợp có thể không bao quát những trường hợp biên này, trong khi dữ liệu thật đã che giấu vẫn giữ được.
Triển khai che giấu khiến tôi nhận ra rằng bảo vệ thông tin nhạy cảm đồng thời duy trì tính hữu dụng của dữ liệu đòi hỏi vượt qua những thách thức không hiển nhiên cho đến khi bạn gặp chúng. Hãy để tôi điểm qua những trở ngại lớn mà tôi gặp và cách tôi giải quyết.
Bảo toàn thuộc tính khó hơn dự kiến. Đơn giản thay thế ngẫu nhiên các giá trị sẽ phá vỡ các mẫu mà ứng dụng phụ thuộc. Số thẻ tín dụng tuân theo thuật toán Luhn để kiểm tra tổng, email yêu cầu tên miền định dạng đúng, và mã ZIP tương ứng vùng địa lý. Tôi học điều này theo cách khó khi lần che giấu đầu tôi tạo số 16 chữ số ngẫu nhiên cho trường thẻ tín dụng. Mọi thứ trông ổn cho đến khi kiểm thử cho thấy logic xác thực thanh toán từ chối tất cả vì tôi quên rằng số thẻ có chữ số kiểm tra tính bằng thuật toán Luhn.
Tính toàn vẹn ngữ nghĩa quan trọng vượt ra ngoài định dạng. Dữ liệu che giấu nên tránh các kết hợp vô nghĩa rõ ràng. Trong kiểm thử, một đồng đội nhận ra bộ dữ liệu che giấu của chúng tôi có mã ZIP Alaska gán cho địa chỉ đường phố ở Florida. Mặc dù về mặt định dạng là hợp lệ, sự lệch địa lý trông đáng ngờ. Tôi đã dành một buổi chiều cải thiện tính nhất quán ngữ nghĩa bằng cách sinh địa chỉ hoàn chỉnh trong đó mọi thành phần khớp về mặt địa lý thay vì ghép ngẫu nhiên.
Tính toàn vẹn tham chiếu giữa các bảng gây phức tạp đáng kể. Như tôi giải thích ở phần kỹ thuật, cơ sở dữ liệu của chúng tôi có các bảng customers, orders và reviews với ID khách hàng xuất hiện ở cả ba. Nếu che giấu biến đổi ID khách hàng không nhất quán, các quan hệ sẽ đứt hoàn toàn. Điều này đã xảy ra sau lần che giấu đầu tiên của tôi, 30% bài kiểm thử tích hợp thất bại vì đơn hàng không liên kết được với bản ghi khách hàng. Bước đột phá đến khi tôi nhận ra cần xử lý các bảng theo thứ tự phụ thuộc, dùng che giấu xác định để đảm bảo khách hàng C001 luôn trở thành cùng một ID che giấu ở mọi nơi xuất hiện.
Cân bằng bảo mật với giá trị phân tích đòi hỏi phán đoán liên tục. Che giấu mạnh tay hơn mang lại quyền riêng tư tốt hơn nhưng giảm tính hữu dụng. Ví dụ, làm tròn mọi độ tuổi đến thập kỷ gần nhất cải thiện quyền riêng tư nhưng loại bỏ phân tích theo tuổi hữu ích. Dự án của chúng tôi ưu tiên tính hữu dụng vì chúng tôi xây tính năng ứng dụng cần hành vi dữ liệu thực tế. Trong bối cảnh sản xuất thật với dữ liệu khách hàng và yêu cầu tuân thủ, tôi sẽ phải cân nhắc bảo vệ quyền riêng tư nặng hơn và có thể chấp nhận giảm tính hữu dụng dữ liệu.
Quan hệ thống kê có thể bị bóp méo. Nếu bạn có hai cột tương quan, như thu nhập và chi tiêu, và bạn xáo trộn từng cột độc lập, tương quan có thể thay đổi. Về góc độ thống kê, xáo trộn độc lập làm biến dạng phân phối kết hợp. Để duy trì mối quan hệ này, nhà phân tích đôi khi dùng biến đổi bảo toàn hạng như xáo trộn cả hai cột bằng cùng một hoán vị ngẫu nhiên hoặc thêm nhiễu được kiểm soát để giữ thứ tự tương đối của chúng.
Sau khi học các kỹ thuật riêng lẻ, tôi muốn xem chúng phối hợp ra sao trong kịch bản thực tế. Dưới đây là ví dụ hoàn chỉnh minh họa che giấu một cơ sở dữ liệu khách hàng với đơn hàng liên quan, đúng thách thức chúng tôi gặp trong dự án thương mại điện tử.
from faker import Faker
import pandas as pd
import numpy as np
import uuid

fake = Faker()
Faker.seed(42)  # For reproducible results

# Original datasets (simulating real customer data)
customers_original = pd.DataFrame({
    'customer_id': ['C001', 'C002', 'C003'],
    'first_name': ['Khalid', 'Sarah', 'Mohamed'],
    'last_name': ['Abdelaty', 'Ahmed', 'Ali'],
    'email': ['khalid.a@email.com', 'sarah.a@email.com', 'mali@email.com'],
    'phone': ['555-0123', '555-0124', '555-0125'],
    'credit_card': ['4532-1234-5678-9012', '4556-7890-1234-5678', '4539-8765-4321-0987'],
    'internal_notes': ['VIP customer', 'Requested callback', 'Payment issue resolved']
})

orders_original = pd.DataFrame({
    'order_id': ['ORD001', 'ORD002', 'ORD003', 'ORD004'],
    'customer_id': ['C001', 'C002', 'C001', 'C003'],
    'product': ['Laptop', 'Mouse', 'Keyboard', 'Monitor'],
    'amount': [1299.99, 29.99, 89.99, 399.99]
})

# Step 1: Create deterministic ID mapping to maintain referential integrity
def create_id_mapping(ids):
    """Create consistent pseudonymous IDs"""
    mapping = {}
    for idx, original_id in enumerate(ids):
        mapping[original_id] = f"CUST_{idx:06d}"
    return mapping

customer_id_mapping = create_id_mapping(customers_original['customer_id'].unique())

# Step 2: Mask customer data using multiple techniques
def mask_customer_database(df, id_mapping):
    masked = df.copy()

    # Pseudonymization: Replace customer IDs consistently
    masked['customer_id'] = masked['customer_id'].map(id_mapping)

    # Substitution: Replace names and emails with realistic fake data
    masked['first_name'] = [fake.first_name() for _ in range(len(masked))]
    masked['last_name'] = [fake.last_name() for _ in range(len(masked))]
    masked['email'] = [fake.email() for _ in range(len(masked))]

    # Partial masking/redaction: Show last 4 digits of phone and credit card
    masked['phone'] = masked['phone'].apply(lambda x: '***-' + x[-4:])
    masked['credit_card'] = masked['credit_card'].apply(lambda x: '****-****-****-' + x[-4:])

    # Nulling: Remove internal notes entirely
    masked['internal_notes'] = None

    return masked

# Step 3: Mask order data with referential integrity
def mask_order_database(df, id_mapping):
    masked = df.copy()

    # Pseudonymization: Use same customer ID mapping to maintain relationships
    masked['customer_id'] = masked['customer_id'].map(id_mapping)

    # Randomization: Generate new order IDs
    masked['order_id'] = [f"ORD-{uuid.uuid4().hex[:8].upper()}" for _ in range(len(masked))]

    # Shuffling: Preserve amount distribution but break individual associations
    shuffled_amounts = masked['amount'].values.copy()
    np.random.shuffle(shuffled_amounts)
    masked['amount'] = shuffled_amounts

    return masked

# Apply masking
customers_masked = mask_customer_database(customers_original, customer_id_mapping)
orders_masked = mask_order_database(orders_original, customer_id_mapping)

print("=== MASKED CUSTOMER DATA ===")
print(customers_masked)
print("\n=== MASKED ORDER DATA ===")
print(orders_masked)

# Verify referential integrity is maintained
print("\n=== VERIFICATION: JOIN STILL WORKS ===")
joined = customers_masked.merge(orders_masked, on='customer_id')
print(f"Original orders: {len(orders_original)}, Joined orders: {len(joined)}")
print("✓ All order-customer relationships preserved!")
Khi tôi chạy toàn bộ pipeline che giấu này trên dữ liệu dự án (500 bản ghi khách hàng với 1.200 đơn hàng), thời gian thực thi khoảng 2 giây, hoàn toàn chấp nhận được cho chu kỳ làm mới cơ sở dữ liệu phát triển hàng tuần của chúng tôi. Vài điều trở nên rõ ràng:
Tính toàn vẹn tham chiếu hoạt động hoàn hảo. Khách hàng CUST_000000 (ban đầu là C001) có đơn hàng ở cả bảng customers và orders. Câu lệnh JOIN hỗ trợ tính năng lịch sử đơn hàng hoạt động y hệt với dữ liệu đã che giấu vì chúng tôi dùng cùng một customer_id_mapping cho cả hai bảng.
Mỗi kỹ thuật phục vụ một mục đích cụ thể. Thay thế giúp tên khách hàng trông thực. Che một phần cho phép xác minh phương thức thanh toán mà không lộ toàn bộ số thẻ. Xáo trộn giữ khả năng bảng điều khiển phân tích của chúng tôi hiển thị phân phối doanh thu chính xác trong khi tách các khoản tiền khỏi khách hàng cụ thể. Gán NULL loại bỏ dữ liệu không cần cho kiểm thử.
Kết quả trông và hoạt động như dữ liệu thật. Khi tôi duyệt cơ sở dữ liệu đã che giấu trong quá trình phát triển, mọi thứ đều cảm thấy chân thực. Email được xác thực đúng. Số điện thoại hiển thị đúng. Dữ liệu không “gào lên” rằng nó là giả, giúp tôi tập trung gỡ lỗi logic ứng dụng thay vì bị xao nhãng bởi dữ liệu thử nghiệm quá giả tạo.
Chất lượng dữ liệu vẫn cao. Chúng tôi vẫn có thể kiểm thử các trường hợp biên như khách hàng có nhiều đơn hàng, tính toán thống kê tổng hợp và xác minh ràng buộc cơ sở dữ liệu. Che giấu đã giữ được độ phức tạp và các mối quan hệ cần thiết đồng thời bảo vệ mọi mẩu thông tin nhạy cảm.
Cách tiếp cận này biến một vấn đề từng có vẻ quá sức—tạo cơ sở dữ liệu thử nghiệm an toàn nhưng thực tế—thành một quy trình có hệ thống và có thể lặp lại. Mỗi lần làm mới cơ sở dữ liệu phát triển, chạy script che giấu này mất chưa đầy một phút và cho chúng tôi sự yên tâm rằng không có dữ liệu khách hàng thật nào có thể rò rỉ.
Bắt đầu bằng khám phá dữ liệu toàn diện. Thông tin nhạy cảm xuất hiện ở những nơi bất ngờ ngoài các trường hiển nhiên như tên và email. Cơ sở dữ liệu của chúng tôi có trường ghi chú khách hàng chứa văn bản tự do có thể bao gồm thông tin cá nhân. Tôi học cách rà soát có hệ thống mọi trường, không chỉ những trường rõ ràng. Trong hệ thống sản xuất, tổ chức dùng công cụ khám phá dữ liệu tự động quét các mẫu khớp thông tin nhận dạng cá nhân.
Thiết lập chính sách che giấu rõ ràng từ sớm. Ban đầu các thành viên đưa ra quyết định che giấu độc lập, tạo ra sự không nhất quán. Một người che hoàn toàn số điện thoại, người khác che một phần, người thứ ba để nguyên. Cuối cùng chúng tôi tiêu chuẩn hóa: che hoàn toàn cho tên và email, che một phần cho số điện thoại và thẻ, gán NULL cho ghi chú nội bộ. Chính sách được lập thành văn bản chỉ rõ phần tử dữ liệu nào cần che, kỹ thuật nào áp dụng cho từng loại và cách xử lý trường hợp biên.
Dùng thuật toán bảo toàn định dạng. Thay vì thay bằng giá trị ngẫu nhiên, các thuật toán này tạo giá trị thay thế trông thực tế và đáp ứng cùng quy tắc xác thực như dữ liệu gốc. Như tôi đã minh họa, che giấu thẻ tín dụng cần sinh số vượt qua kiểm tra Luhn, và che giấu email cần địa chỉ đúng định dạng với mẫu tên miền hợp lệ.
Kiểm thử chất lượng che giấu nghiêm ngặt. Tôi viết các bài kiểm thử đơn giản để xác minh chất lượng dữ liệu đã che trước khi dùng cho phát triển. Những bài này kiểm tra email đã che có vượt regex hay không, ID khách hàng có còn duy nhất sau khi che, quan hệ khóa ngoại có còn hợp lệ, và kích thước tập dữ liệu đã che có bằng bản gốc. Chúng giúp phát hiện vấn đề như sinh trùng lặp và đứt toàn vẹn tham chiếu trước khi gặp trong kiểm thử ứng dụng.
Tự động hóa toàn bộ quy trình. Lần đầu tôi che giấu bằng cách chạy thủ công các script Python và sao chép tệp, rất nhanh trở nên nhàm chán. Tôi đã tạo một script duy nhất xử lý toàn bộ: đọc dữ liệu gốc, áp dụng mọi biến đổi che giấu, xác thực kết quả và ghi đầu ra đã che. Với dự án thực có pipeline tích hợp liên tục, che giấu sẽ tích hợp như một bước tự động mà nhà phát triển không cần nghĩ đến.
Đảm bảo không thể đảo ngược và có thể lặp lại. Quy trình che giấu nên không thể đảo ngược để thực sự bảo vệ, nhưng có thể lặp lại khi bạn cần làm mới cơ sở dữ liệu thử với kết quả nhất quán. Dùng kỹ thuật xác định với seed nhất quán, như tôi đã trình bày trong ví dụ hoàn chỉnh, mang lại cân bằng này.
Che giấu dữ liệu đang phát triển nhanh cùng trí tuệ nhân tạo và machine learning. Trong khi dự án lớp của chúng tôi dùng kỹ thuật truyền thống, các giải pháp hiện đại ngày càng tận dụng AI để tự động hóa và nâng cao quá trình che giấu.
Điều khiến tôi hứng thú nhất là khám phá dữ liệu tự động. Tôi đã dành hàng giờ xem xét thủ công lược đồ cơ sở dữ liệu để xác định trường nào chứa thông tin nhạy cảm. Hãy tưởng tượng một công cụ tự động nhận diện trường nhạy cảm bằng cách phân tích mẫu, tên cột và phân phối giá trị thay vì yêu cầu rà soát thủ công. Một hệ thống ML có thể nhận ra rằng một cột có tên kỳ lạ "user_identifier" thực ra chứa địa chỉ email, điều tôi rất dễ bỏ lỡ khi kiểm tra thủ công. Điều này sẽ giúp tôi tiết kiệm đáng kể thời gian.
Tôi cũng đã đọc về các kỹ thuật machine learning bảo toàn quyền riêng tư vượt ra ngoài che giấu truyền thống. Chẳng hạn, quyền riêng tư vi sai thêm nhiễu toán học được hiệu chỉnh cẩn thận vào dữ liệu huấn luyện hoặc đầu ra mô hình. Học liên kết (Federated learning) huấn luyện mô hình trên các tập dữ liệu phân tán mà không tập trung thông tin nhạy cảm. Những cách tiếp cận này giải quyết các tình huống mà che giấu tiêu chuẩn có thể loại bỏ các mẫu mà mô hình cần học.
Sinh dữ liệu tổng hợp bằng AI tạo sinh đặc biệt thu hút tôi cho các dự án tương lai. Thay vì che giấu bản ghi thật, hệ thống AI được huấn luyện trên mẫu dữ liệu thật để sinh ra toàn bộ tập dữ liệu giả. Tôi chưa tự triển khai, nhưng thấy rõ sức hấp dẫn cho các kịch bản cần tập huấn luyện khổng lồ hoặc nơi ngay cả dữ liệu thật đã che giấu cũng bị xem là rủi ro. Thách thức là đảm bảo dữ liệu tổng hợp đại diện chính xác các trường hợp biên và độ phức tạp đã khiến dữ liệu thật đã che giấu trở nên quý giá cho việc kiểm thử của chúng tôi.
Nhìn về tương lai, quy trình phát triển gốc đám mây đang bắt đầu tích hợp che giấu tự động như hạ tầng tiêu chuẩn. Thay vì che giấu là thứ tôi chạy thủ công bằng script Python, pipeline triển khai có thể xử lý tự động khi cung cấp cơ sở dữ liệu phát triển. Nhà phát triển sẽ chỉ định yêu cầu che giấu trong tệp cấu hình cùng với lược đồ cơ sở dữ liệu. Đó là kiểu tự động hóa tôi muốn triển khai trong các dự án sau, biến che giấu từ một bước tiền xử lý thủ công thành hành vi tự động của hạ tầng.
Tuy nhiên, AI là con dao hai lưỡi với quyền riêng tư dữ liệu. Trong khi nó cải thiện kỹ thuật che giấu, nó cũng làm các cuộc tấn công tái nhận dạng tinh vi hơn. Mô hình machine learning có thể đối chiếu dữ liệu tưởng như ẩn danh với thông tin công khai để tái nhận dạng cá nhân. Các nhà nghiên cứu từng tái nhận dạng người trong dữ liệu Netflix "đã ẩn danh" bằng cách liên hệ với các bài đánh giá trên IMDb. Khi công cụ che giấu thông minh hơn, phương pháp phá vỡ chúng cũng vậy.
Che giấu dữ liệu đạt cân bằng hoàn hảo giữa tính hữu dụng và quyền riêng tư. Bằng cách áp dụng đúng kỹ thuật như thay thế, che giấu xác định và phương pháp bảo toàn định dạng, bạn có thể duy trì dữ liệu trông thực tế trong khi bảo vệ thông tin nhạy cảm.
Hãy bắt đầu bằng cách xác định các tập dữ liệu quan trọng nhất và áp dụng che giấu ở môi trường ngoài sản xuất. Tự động hóa sớm để biến bảo vệ quyền riêng tư thành phần tiêu chuẩn trong quy trình làm việc của bạn.
Để nâng cao kỹ năng, hãy khám phá các khóa học Quyền riêng tư dữ liệu và Ẩn danh hóa bằng Python hoặc Kỹ thuật Dữ liệu cho Mọi người.
Học với DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
