
{count, plural, one {कोर्स} other {कोर्स}}
डेटा प्राइवेसी परिचय
{hours} घंटा
30.9K
पिछले सेमेस्टर में, मेरे डेटाबेस सिस्टम्स कोर्स ने एक फाइनल प्रोजेक्ट दिया जो शुरू में आसान लगा: यूज़र ऑथेंटिकेशन, शॉपिंग कार्ट और ऑर्डर प्रोसेसिंग के साथ एक काम करने वाला ई‑कॉमर्स ऐप बनाइए। ट्विस्ट क्या था? हमें यह साबित करना था कि यह सिर्फ "Ali," "Shahd," और "Khalid" नाम के तीन टेस्ट यूज़र्स से नहीं, बल्कि यथार्थवादी डेटा पैटर्न्स के साथ भी काम करता है।
मेरी टीम तुरंत एक समस्या से टकराई। हमें सैकड़ों कस्टमर रिकॉर्ड्स चाहिए थे जिनमें विविध खरीदारी इतिहास हो, ताकि बल्क ऑर्डर्स, रिफंड्स और इन्वेंटरी मैनेजमेंट जैसे एज़ केस टेस्ट किए जा सकें। मौजूदा साइट्स से असली डेटा स्क्रैप करना नैतिक और कानूनी रूप से गलत था। सैकड़ों यथार्थवादी रिकॉर्ड्स हाथ से बनाना बहुत समय लेता। तभी हमारे प्रोफेसर ने हमें डेटा मास्किंग से परिचित कराया।
इस लेख में, मैं डेटा मास्किंग तकनीकों को लागू करने के अपने अनुभव से सीखी बातें साझा करूँगा। आप जानेंगे कि डेटा मास्किंग क्या है, कब और क्यों मायने रखती है, और संवेदनशील जानकारी की सुरक्षा करते हुए डेटा की उपयोगिता बनाए रखने के लिए विशिष्ट तकनीकें कैसे लागू करें। मैं अपने प्रोजेक्ट से व्यावहारिक उदाहरणों के साथ चलूँगा और वे गलतियाँ दिखाऊँगा जिनसे बचना चाहिए।
जब मैंने पहली बार "डेटा मास्किंग" सुना, तो दिमाग में सरकारी दस्तावेज़ों में टेक्स्ट ब्लैकआउट करने जैसा कुछ आया। हकीकत इससे कहीं ज़्यादा परिष्कृत और उपयोगी है। डेटा मास्किंग संवेदनशील डेटा के संरचनात्मक रूप से समान लेकिन तथ्यात्मक रूप से झूठे संस्करण बनाती है।
तकनीकी प्रक्रिया में मूल डेटा मानों को ऐसे काल्पनिक विकल्पों से बदलना शामिल है जो फ़ॉर्मैट, प्रकार और सांख्यिकीय गुणों को बनाए रखें। हमारे ई‑कॉमर्स प्रोजेक्ट के लिए, हमने एक डेटा जनरेशन टूल से वास्तविक‑दिखने वाली ग्राहक जानकारी का छोटा डेटा सेट लिया और विविधता लाने के लिए मास्किंग तकनीकें लागू कीं। जैसे एक ईमेल khalid.abdelaty@company.com बदलकर ahmed.j@enterprise.com हो गया। दोनों मान्य ईमेल फ़ॉर्मैट हैं जो वैलिडेशन जांच पास करते हैं, लेकिन मास्क किया गया संस्करण वास्तविक व्यक्तियों के बारे में कुछ उजागर नहीं करता।
आप इसे अलग‑अलग नामों से सुनेंगे—किसके द्वारा बात की जा रही है, इस पर निर्भर करता है। Data obfuscation छिपाने के पहलू पर ज़ोर देता है। Pseudonymization विशेष रूप से पहचान योग्य जानकारी को बदलने को संदर्भित करता है, जबकि ज़रूरत पड़ने पर पुनः‑पहचान की क्षमता बनाए रखता है। Tokenization में संवेदनशील मानों को यादृच्छिक रूप से उत्पन्न टोकनों से बदलना शामिल है। ये शब्द काफी हद तक ओवरलैप करते हैं, और डॉक्यूमेंटेशन व ट्यूटोरियल्स में लोग अक्सर इन्हें कुछ हद तक परस्पर उपयोग करते हैं।
इस बिंदु पर, आप सोच रहे होंगे कि क्या नए ईमेल या आईडी किसी तरह मूल डेटा से व्युत्पन्न हैं। छोटा जवाब: यह मास्किंग तकनीक पर निर्भर करता है। मैंने इसके बारे में और जानकारी FAQs में जोड़ी है।
महत्व तब क्लिक हुआ जब हमारे प्रोफेसर ने बताया कि हमारा "क्लास प्रोजेक्ट" वास्तविक प्रोडक्शन चुनौतियों का प्रतिबिंब है। कंपनियों को प्रोडक्शन जैसे डेटा के साथ सॉफ्टवेयर का परीक्षण करना पड़ता है, और विश्लेषकों को यथार्थवादी पैटर्न्स के साथ मॉडल बनाने होते हैं। लेकिन इन वातावरणों में वास्तविक ग्राहक डेटा का उपयोग गंभीर समस्याएँ पैदा करता है।
विनियामक अनुपालन अधिकांश संगठनों की चिंताओं में शीर्ष पर होता है। GDPR, यूरोपीय गोपनीयता विनियमन, संगठनों को डेटा प्रोसेसिंग को न्यूनतम रखने और उचित तकनीकी उपायों के माध्यम से व्यक्तिगत जानकारी की रक्षा करने का निर्देश देता है। HIPAA स्वास्थ्य सेवा प्रदाताओं से परीक्षण वातावरणों में भी रोगी जानकारी की रक्षा करने की मांग करता है। California Consumer Privacy Act कैलिफ़ोर्निया निवासियों को समान सुरक्षा प्रदान करता है। व्यापारिक दृष्टिकोण से, इन विनियमों का उल्लंघन भारी जुर्मानों का कारण बनता है। नैतिक दृष्टि से, लोग उम्मीद करते हैं कि उनका डेटा सुरक्षित हो।
डेटा मास्किंग महत्वपूर्ण सुरक्षा लाभ भी प्रदान करती है। वास्तविक डेटा रखने वाला हर अतिरिक्त वातावरण अटैक सरफेस बढ़ाता है। विकास सर्वर आमतौर पर प्रोडक्शन सिस्टम्स की तुलना में कमजोर सुरक्षा नियंत्रण रखते हैं, और डेवलपर्स अक्सर स्थानीय मशीनों पर डेटा के साथ काम करते हैं जो एन्क्रिप्टेड नहीं हो सकतीं। प्रत्येक परिदृश्य उल्लंघन जोखिम लाता है, जिसे डेटा मास्किंग समाप्त कर देता है—क्योंकि यह सुनिश्चित करता है कि नॉन‑प्रोडक्शन वातावरण में कभी वास्तविक जानकारी न हो।
मुझे सबसे ज़्यादा यह देखकर आश्चर्य हुआ कि व्यावहारिक डेवलपमेंट लाभ क्या हैं। हमारे QA परीक्षणों ने ऐसे बग्स उजागर किए जिन्हें हम अपने मूल तीन‑यूज़र टेस्ट डेटा सेट के साथ कभी नहीं पाते। एक टीम सदस्य का कोड उन नामों पर टूट गया जिनमें अपॉस्ट्रॉफी थी, जैसे "O'Brien." दूसरे का उन ईमेल पतों पर टूटा जो प्लस‑साइन उर्फ़ का उपयोग करते थे, जैसे "user+tag@domain.com." ये एज़ केस इसलिए सामने आए क्योंकि हमारे मास्क किए गए डेटा सेट, जो यथार्थवादी पैटर्न्स से निकला था, में वही जटिलता थी जो वास्तविक प्रोडक्शन डेटा में होती है।
यह समझना कि मास्किंग कब लागू होती है, मुझे इसे अलग‑अलग संदर्भों में पहचानने में मददगार रहा। सबसे स्पष्ट परिदृश्य हमारे क्लास प्रोजेक्ट जैसा है: सॉफ्टवेयर विकास और परीक्षण। नई फीचर्स बनाते समय या मौजूदा कोड को डिबग करते समय, डेवलपर्स को वास्तविक‑दुनिया की जटिलता का प्रतिनिधित्व करने वाला डेटा चाहिए। मैंने घंटों यह डिबग करने में बिताए कि कुछ प्रोडक्ट संयोजनों पर हमारा शॉपिंग कार्ट कैलकुलेशन क्यों टूट रहा था। बग सिर्फ इसलिए दिखा क्योंकि हमारे मास्क किए गए डेटा सेट में शून्य‑डॉलर आइटम्स और क्वांटिटी लिमिट्स जैसे एज़ केस शामिल थे।
डेटा एनालिटिक्स और रिसर्च प्रोजेक्ट्स को अक्सर बड़े डेटा सेट्स चाहिए होते हैं जिनमें यथार्थवादी सांख्यिकीय गुण हों। एक टीममेट जो एक अलग एनालिटिक्स प्रोजेक्ट पर काम कर रही थी, उसे रिकमेंडेशन एल्गोरिद्म बनाने के लिए ग्राहक खरीद पैटर्न चाहिए थे। उसे वास्तविक ग्राहक के नाम या पते नहीं चाहिए थे, सिर्फ व्यवहारिक पैटर्न्स। मास्क किया गया डेटा उन पैटर्न्स को प्रदान करता है, जबकि गोपनीयता सुरक्षित रहती है।
बाहरी सहयोग एक और आम उपयोग‑मामला है। कंपनियाँ अक्सर इंटिग्रेशन प्रोजेक्ट्स के लिए कंसल्टेंट्स या कॉन्ट्रैक्टर्स रखती हैं जिन्हें यथार्थवादी डेटा चाहिए, लेकिन संवेदनशील ग्राहक जानकारी का एक्सेस नहीं मिलना चाहिए। कर्मचारी प्रशिक्षण एक और व्यावहारिक अनुप्रयोग है। प्रोडक्शन सिस्टम्स को हाथ लगाने से पहले, उन्हें यथार्थवादी लेकिन सुरक्षित डेटा वाले प्रैक्टिस वातावरण चाहिए। अंतिम उदाहरण के रूप में, क्लाउड डेवलपमेंट भी मास्किंग से लाभान्वित होता है, हालांकि बड़े क्लाउड प्रदाता अपनी सुरक्षा सेवाओं के हिस्से के रूप में अपने मास्किंग टूल्स प्रदान करते हैं।
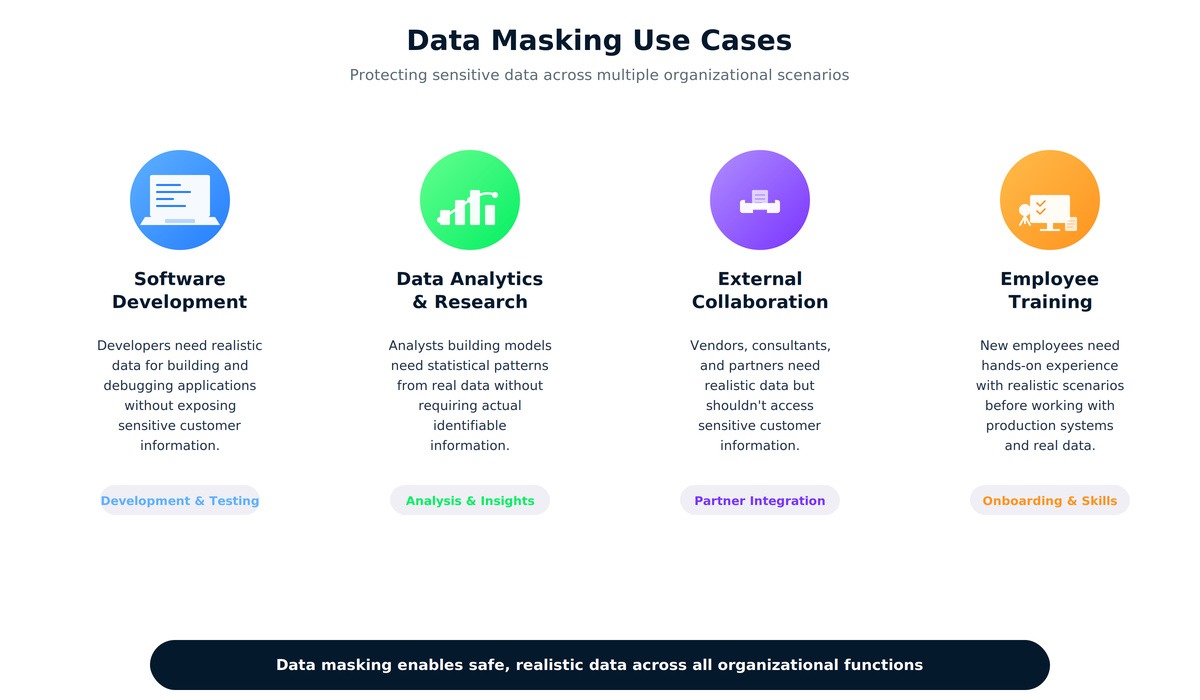
डेटा मास्किंग विकास से लेकर अनुपालन तक अनेक संगठनात्मक आवश्यकताओं की पूर्ति करती है
विशिष्ट तकनीकों में उतरने से पहले, मुख्य प्रकारों और प्रत्येक का उपयोग कब करना है, यह समझना फ़ायदेमंद है।
स्टैटिक मास्किंग स्टोर किए गए डेटा सेट्स पर काम करती है, मूल डेटा से स्वतंत्र मौजूद मास्क की हुई कॉपियाँ बनाती है। हमने अपने ई‑कॉमर्स प्रोजेक्ट के लिए यही किया। मैंने एक Python स्क्रिप्ट चलाई जिसने आरंभिक डेटा सेट पढ़ा, मास्किंग ट्रांसफ़ॉर्मेशन लागू किए, और परिणामों को एक नई फ़ाइल में लिखा जिसे हम सबने डेवलपमेंट के लिए इस्तेमाल किया। एक बार बन जाने के बाद, वह मास्क किया गया डेटा सेट तब तक स्थिर रहा जब तक हमें नए पैटर्न्स के साथ उसे रीफ़्रेश करने की ज़रूरत नहीं पड़ी। फ़ायदा जल्दी स्पष्ट हो गया: परफ़ॉर्मेंस इम्पैक्ट मास्किंग के दौरान एक बार हुआ, जिससे यह उन नॉन‑प्रोडक्शन वातावरणों के लिए आदर्श बना जहाँ आप एक बार मास्क करते हैं और कॉपी को बार‑बार उपयोग करते हैं।
डायनेमिक मास्किंग वास्तविक समय में तब होती है जब यूज़र डेटा तक पहुँचते हैं, और परमिशन के आधार पर ट्रांसफ़ॉर्मेशन लागू होते हैं। मैंने पहले यह अवधारणा डेटाबेस सुरक्षा फ़ीचर्स के बारे में पढ़ते हुए देखी। एक सिस्टम एडमिनिस्ट्रेटर पूर्ण कस्टमर रिकॉर्ड्स देखता है, जबकि एक सपोर्ट प्रतिनिधि मास्क किए हुए क्रेडिट कार्ड नंबर देखता है। अंतर्निहित डेटा अपरिवर्तित रहता है, लेकिन हर यूज़र क्या देखता है, यह उसके ऑथराइज़ेशन स्तर पर निर्भर करता है। यह तरीका प्रोडक्शन सिस्टम्स के लिए उपयुक्त है जहाँ अलग‑अलग यूज़र्स को भूमिकाओं के आधार पर अलग‑अलग दृश्य चाहिए।
डेटर्मिनिस्टिक मास्किंग संगति सुनिश्चित करती है—एक ही इनपुट हमेशा एक ही आउटपुट से बदला जाता है। यदि ग्राहक "Sarah Ali" एक टेबल में "Eman Mohamed" बनती हैं, तो जहाँ‑जहाँ Sarah Ali दिखाई देती हैं, वही ट्रांसफ़ॉर्मेशन लागू होगा। जैसा कि मैं तकनीकों वाले सेक्शन में समझाऊँगा, यह संगति डेटाबेस टेबल्स के बीच रिश्तों को बनाए रखने के लिए बेहद महत्वपूर्ण है। हमारे प्रोजेक्ट को customers, orders, और reviews टेबल्स में ग्राहक आईडी को सुसंगत रखने के लिए डेटर्मिनिस्टिक मास्किंग की आवश्यकता थी।
ऑन‑द‑फ्लाई मास्किंग वातावरणों के बीच डेटा ट्रांसफ़र के दौरान ट्रांसफ़ॉर्मेशन लागू करती है। मैंने इसे एक पर्सनल प्रोजेक्ट के डिप्लॉयमेंट पाइपलाइन सेटअप करते समय आज़माया। मास्किंग डेटा एक्सट्रैक्शन के दौरान हुई, न कि एक अलग स्टेप के रूप में, जिससे वर्कफ़्लो सरल हो गया और यह CI/CD पाइपलाइनों के लिए विशेष रूप से आदर्श बना।
शोधकर्ताओं को प्रवृत्तियाँ खोजने, हाइपोथेसिस टेस्ट करने और भरोसेमंद मॉडल बनाने के लिए डेटा पैटर्न्स तक पहुँच चाहिए, लेकिन वास्तविक‑दुनिया का डेटा साझा करना अक्सर संवेदनशील जानकारी उजागर करने का जोखिम लाता है। सांख्यिकीय ऑबफ़स्केशन (डेटा मास्किंग का एक अन्य रूप) एक समाधान प्रदान करता है। सही तरीके से किया जाए, तो यह आवश्यक सांख्यिकीय गुणों—जैसे माध्य, वैरियंस और कोरिलेशन—को संरक्षित रखता है, साथ ही व्यक्तिगत रिकॉर्ड्स को गुप्त रखता है। इससे विश्लेषक गोपनीयता से समझौता किए बिना मान्य अंतर्दृष्टियाँ निकाल सकते हैं।
यहीं पर हमारे प्रोजेक्ट में सिद्धांत और व्यवहार मिले। अगला सेक्शन जिन तकनीकों से होकर गुज़रेगा, हर एक ने हमारी किसी विशेष चुनौती को सुलझाया।
सब्स्टिट्यूशन अधिकांश व्यक्तिगत पहचान योग्य जानकारी के लिए मेरा डिफ़ॉल्ट तरीका बन गया। अवधारणा सीधी है: संवेदनशील मानों को यथार्थवादी लेकिन पूरी तरह काल्पनिक विकल्पों से बदलें। नाम दूसरे नाम बन जाते हैं। ईमेल पते दूसरे ईमेल पते बन जाते हैं। रिप्लेसमेंट मान एक जैसा फ़ॉर्मैट बनाए रखते हैं और डेटा देखने वाले किसी भी व्यक्ति को असली लगते हैं।
हमारे ई‑कॉमर्स प्रोजेक्ट के लिए, मुझे ग्राहक जानकारी जल्दी मास्क करनी थी। मुझे Faker लाइब्रेरी मिली, जिसे pip install Faker से इन्स्टॉल किया जा सकता है, और मैंने एक सरल मास्किंग फ़ंक्शन बनाया। Faker तरह‑तरह का यथार्थवादी नकली डेटा जनरेट करता है, जो मास्किंग ऑपरेशनों के लिए एकदम उपयुक्त है:
from faker import Faker
import pandas as pd

fake = Faker()

def mask_customer_data(customer_df):
    masked_df = customer_df.copy()

    masked_df['first_name'] = [fake.first_name() for _ in range(len(masked_df))]
    masked_df['last_name'] = [fake.last_name() for _ in range(len(masked_df))]
    masked_df['email'] = [fake.email() for _ in range(len(masked_df))]

    return masked_df

# Example usage
original_customers = pd.DataFrame({
    'customer_id': ['C001', 'C002', 'C003'],
    'first_name': ['Khalid', 'Sarah', 'Mohamed'],
    'last_name': ['Abdelaty', 'Ahmed', 'Ali'],
    'email': ['khalid.a@email.com', 'sarah.a@email.com', 'mali@email.com']
})

masked_customers = mask_customer_data(original_customers)
ऊपर दिया गया कोड एक pandas DataFrame में मौजूद ग्राहक रिकॉर्ड्स की पहचान योग्य जानकारी को काल्पनिक विकल्पों से बदल देता है। हमारे आरंभिक डेटा सेट पर इसे चलाने में शायद दो मिनट लगे और इससे हमें सैकड़ों यथार्थवादी‑दिखने वाले ग्राहक नाम और ईमेल पते मिल गए। Faker लाइब्रेरी ने विविध, भरोसेमंद नाम और सही फ़ॉर्मैट वाले ईमेल जनरेट करने की जटिलता संभाली। मैंने यह भी सीखा कि, क्योंकि आउटपुट यादृच्छिक रूप से जनरेट होते हैं, वे सीधे री‑आइडेंटिफ़ाइबल नहीं होते—जो मुझे अच्छा लगा।
एक सीख: मास्क किया गया डेटा इतना असल लगे कि डेवलपमेंट के दौरान आपका दिमाग उसे न ठुकराए। शुरू में, मैंने यादृच्छिक अक्षर संयोजन इस्तेमाल किए, लेकिन "Xkqp Mmwz" जैसे ग्राहकों के साथ कोड डिबग करना हास्यास्पद लगा और वास्तविक लॉजिक समस्याओं पर ध्यान केंद्रित करना कठिन हो गया। "Jennifer Martinez" और "Robert Chen" जैसे Faker‑जनित नाम काम करने के लिए पर्याप्त स्वाभाविक लगे।
Python में डेटा मैनिपुलेशन के बारे में और सीखने के लिए, हमारा Introduction to Data Science in Python कोर्स मूलभूत DataFrame ऑपरेशन्स कवर करता है, जो इन और अन्य तकनीकों को लागू करना काफी आसान बना देते हैं।
शफ़लिंग ने एक ऐसी समस्या हल की जिसकी मैंने शुरुआत में कल्पना नहीं की थी। हमारे प्रोजेक्ट में एक एडमिन डैशबोर्ड था जो ग्राहक डेमोग्राफ़िक के आधार पर औसत खरीद राशि दिखाता था। हमें अपने एग्रीगेशन क्वेरीज़ को ठीक से जाँचने के लिए यथार्थवादी खरीद राशियों की ज़रूरत थी, लेकिन हमें विशिष्ट ग्राहकों को विशिष्ट खरीद से जोड़ने की ज़रूरत नहीं थी।
शफ़लिंग एक कॉलम के भीतर मानों को यादृच्छिक रूप से पुनः क्रमित करती है, जबकि समग्र वितरण बनाए रखती है:
import numpy as np
import pandas as pd

def shuffle_column(df, column_name):
    shuffled_df = df.copy()
    shuffled_values = shuffled_df[column_name].values
    np.random.seed(42)  # For reproducibility
    np.random.shuffle(shuffled_values)
    shuffled_df[column_name] = shuffled_values
    return shuffled_df

# Example with purchase data
purchase_data = pd.DataFrame({
    'customer_id': ['C001', 'C002', 'C003'],
    'product': ['Laptop', 'Headphones', 'Mouse'],
    'amount': [1200, 85, 25]
})

shuffled_purchases = shuffle_column(purchase_data, 'amount')
शफ़लिंग के बाद, खरीद राशियाँ अभी भी डेटा सेट में मौजूद रहीं (हम अब भी सटीक औसत और वितरण की गणना कर सकते थे), लेकिन ग्राहक C001 और $1,200 खरीद के बीच का संबंध टूट गया। अब ग्राहक C001 शायद $25 की खरीद दिखाए।
मुख्य समझ: शफ़लिंग एग्रीगेट विश्लेषण के लिए आवश्यक सांख्यिकीय गुण बनाए रखती है, जबकि व्यक्तिगत‑स्तर के संबंधों को तोड़ देती है। यह तब एकदम उपयुक्त है जब आप ऐसी फ़ीचर्स का परीक्षण कर रहे हों जो व्यक्तिगत रिकॉर्ड्स के बजाय एग्रीगेट्स के साथ काम करती हैं।
आंशिक मास्किंग आवश्यक जानकारी ही दिखाती है और बाकी छुपाती है। यह तकनीक परिचित लगी क्योंकि मैंने इसे हर जगह देखा है—वेबसाइट्स क्रेडिट कार्ड नंबरों को ****-****-****-1234 की तरह दिखाती हैं या ऐप्स फ़ोन नंबरों को (***) ***-5678 की तरह।
इसे हमारे प्रोजेक्ट के लिए लागू करना सीधा था:
def mask_credit_card(card_number):
    visible_digits = 4
    masked_portion = '*' * (len(card_number) - visible_digits)
    return masked_portion + card_number[-visible_digits:]

def mask_phone(phone):
    return '***-***-' + phone[-4:]

# Examples
print(mask_credit_card('4532123456781234'))  # ************1234

print(mask_phone('555-0123'))  # ***-***-0123
हमने इसे ऑर्डर हिस्ट्री व्यू में इस्तेमाल किया, जहाँ ग्राहकों को यह सत्यापित करना होता था कि उन्होंने किस कार्ड से खरीदारी की। अंतिम चार अंकों को दिखाना पहचान के लिए पर्याप्त था, बिना पूर्ण नंबर उजागर किए। यह उपयोगिता और गोपनीयता के बीच सही संतुलन जैसा लगा।
कभी‑कभी सबसे सरल समाधान डेटा को पूरी तरह हटा देना होता है। नलिंग उन फ़ील्ड मानों को NULL या खाली स्ट्रिंग से बदल देती है जब जानकारी परीक्षण के लिए आवश्यक नहीं होती।
def null_fields(df, fields_to_null):
    masked_df = df.copy()
    for field in fields_to_null:
        masked_df[field] = None
    return masked_df
हमारे ग्राहक रिकॉर्ड्स में एक "notes" फ़ील्ड शामिल था जहाँ काल्पनिक कस्टमर सर्विस प्रतिनिधि आंतरिक टिप्पणियाँ लिख सकते थे। यह फ़ील्ड शॉपिंग कार्ट लॉजिक या पेमेंट प्रोसेसिंग की जाँच के लिए प्रासंगिक नहीं थी, इसलिए मैंने इसे नल कर दिया। जब हम टेस्ट डेटा से फ़ील्ड ही हटा सकते थे, तो नकली नोट्स बनाने की क्या ज़रूरत?
इसने मुझे मास्किंग के बारे में एक महत्वपूर्ण सबक सिखाया: चीज़ों को ज़रूरत से ज़्यादा जटिल न बनाएँ। जिसे मास्क करना है, उसे मास्क करें; जिसे होने की ज़रूरत नहीं, उसे हटा दें।
रैंडमाइज़ेशन उन फ़ील्ड्स के लिए पूरी तरह नए मान जनरेट करता है जहाँ मूल डेटा से किसी भी प्रकार का संबंध बनाए रखना बेकार है। यह पहचानकर्ताओं और संदर्भ नंबरों के लिए अच्छी तरह काम करता है:
import random
import string

def randomize_order_id():
    return 'ORD-' + ''.join(random.choices(string.ascii_uppercase + string.digits, k=8))

order_ids = [randomize_order_id() for _ in range(5)]
print(order_ids)
हमारे ऑर्डर आईडीज़ को मूल डेटा सेट से किसी चीज़ से मेल खाने की ज़रूरत नहीं थी। उन्हें सिर्फ यथार्थवादी दिखना था और यूनिक होना था। रैंडम जनरेशन ने दोनों आवश्यकताएँ संभाल लीं। "ORD-K7M2N9P4" जैसी हर जनरेट हुई आईडी एक संभावित ऑर्डर रेफ़रेंस दिखती थी, बिना किसी वास्तविक चीज़ से जुड़ी हुई।
टोकनाइज़ेशन संवेदनशील मानों को यादृच्छिक रूप से उत्पन्न टोकनों से बदल देता है, जबकि मूल डेटा को अलग, अत्यधिक सुरक्षित सिस्टम में सुरक्षित रूप से संग्रहीत रखता है। अन्य मास्किंग तकनीकों के विपरीत, टोकनाइज़ेशन रिवर्सिबिलिटी के लिए डिज़ाइन किया गया है, परंतु केवल नियंत्रित एक्सेस के माध्यम से। मैंने यह तरीका पेमेंट प्रोसेसिंग आवश्यकताओं पर रिसर्च करते समय सीखा:
import uuid

# Note: Production token vaults use encrypted database storage, not in-memory dicts
class TokenVault:
    def __init__(self):
        self.token_map = {}
        self.reverse_map = {}

    def tokenize(self, sensitive_value):
        if sensitive_value in self.token_map:
            return self.token_map[sensitive_value]

        token = str(uuid.uuid4())
        self.token_map[sensitive_value] = token
        self.reverse_map[token] = sensitive_value
        return token

    def detokenize(self, token):
        return self.reverse_map.get(token)

vault = TokenVault()
token = vault.tokenize('4532-1234-5678-9012')
print(f"Token: {token}")
original = vault.detokenize(token)
print(f"Original: {original}")
हमने क्लास प्रोजेक्ट में टोकनाइज़ेशन लागू नहीं किया क्योंकि हमें रिवर्सिबिलिटी की ज़रूरत नहीं थी। लेकिन पेमेंट सिस्टम्स के बारे में पढ़कर उपयोग‑मामला साफ़ हो गया: आपका एप्लिकेशन डेटाबेस केवल टोकन्स (बेकार रैंडम स्ट्रिंग्स) स्टोर करता है, जबकि वास्तविक पेमेंट डिटेल्स पूरी तरह अलग, भारी सुरक्षा वाले टोकन वॉल्ट में होते हैं। यदि आपका एप्लिकेशन डेटाबेस समझौता हो जाता है, तो अटैकर को केवल बेकार टोकन्स मिलते हैं—वास्तविक क्रेडिट कार्ड नंबरों तक पहुँचने का कोई तरीका नहीं होता, जब तक कि वॉल्ट खुद न तोड़ा जाए। यही आर्किटेक्चरल विभाजन पेमेंट प्रोसेसिंग कंप्लायंस के लिए टोकनाइज़ेशन को विशेष रूप से मूल्यवान बनाता है।
क्रिप्टोग्राफ़िक तकनीकें गणितीय एल्गोरिद्म का उपयोग कर डेटा को ट्रांसफ़ॉर्म करती हैं। मैंने पासवर्ड स्टोरेज के लिए हैशिंग लागू की, जब हमारे प्रोफेसर ने ज़ोर देकर कहा कि कभी भी प्लेन‑टेक्स्ट पासवर्ड स्टोर न करें। प्रोडक्शन सिस्टम्स के लिए, आपको bcrypt या Argon2 का उपयोग करना चाहिए, जो सॉल्ट शामिल करते हैं और ब्रूट‑फोर्स अटैक्स का प्रतिरोध करने के लिए कम्प्यूटेशनली महंगे होते हैं। मैं यहाँ bcrypt दिखा रहा हूँ, हालांकि Argon2 भी प्रोडक्शन के लिए उत्कृष्ट है:
import bcrypt

def hash_password(password):
    # Generate a salt and hash the password
    salt = bcrypt.gensalt()
    hashed = bcrypt.hashpw(password.encode(), salt)
    return hashed

def verify_password(password, hashed):
    # Verify a password against its hash
    return bcrypt.checkpw(password.encode(), hashed)

# Store the hash, never the actual password
password = 'user_password_123'
password_hash = hash_password(password)
print(f"Stored hash: {password_hash}")
# Output: Stored hash: b'$2b$12$K7g.../XYZ' (different each time due to random salt)

# Verify during login
is_valid = verify_password('user_password_123', password_hash)
print(f"Password valid: {is_valid}")  # Output: Password valid: True
हैशिंग एक‑तरफ़ा ट्रांसफ़ॉर्मेशन बनाती है जो वेरिफ़िकेशन के लिए उपयोगी है। जब मैंने इसे पहली बार टेस्ट किया, तो यह देखकर हैरानी हुई कि रैंडम सॉल्ट की वजह से bcrypt हर बार अलग हैश बनाता है, फिर भी verify_password() मूल पासवर्ड से सही मिलान कर लेता है। सॉल्ट सुनिश्चित करता है कि समान पासवर्ड भी अलग‑अलग हैश पैदा करें, जिससे रेनबो टेबल अटैक्स से सुरक्षा मिलती है। लॉगिन के दौरान, हम सबमिटेड पासवर्ड को हैश करते हैं और bcrypt के वेरिफ़िकेशन फ़ंक्शन से सुरक्षित तरीके से तुलना करते हैं। इसका मतलब है कि डेटाबेस तक पहुंच वाले डेवलपर्स भी यूज़र पासवर्ड नहीं देख सकते।
नोट: इस उदाहरण का उपयोग करने के लिए आपको pip install bcrypt से bcrypt इंस्टॉल करना होगा।
एन्क्रिप्शन हैशिंग से इसलिए भिन्न है क्योंकि यह कुंजियों का उपयोग कर मूल रूप में डिक्रिप्शन की अनुमति देता है। हमें अपने प्रोजेक्ट के लिए एन्क्रिप्शन की ज़रूरत नहीं थी, लेकिन इसका उद्देश्य समझ में आता है: जब अधिकृत पक्षों को वास्तविक डेटा तक पहुँच चाहिए, पर आप उसे अनधिकृत पहुँच से बचाना चाहते हैं, तब इसका उपयोग करें।
ये संबंधित तकनीकें अपनी रिवर्सिबिलिटी में भिन्न हैं। छद्मनामकरण पहचान योग्य जानकारी को बदलता है, जबकि ज़रूरत पड़ने पर व्यक्तियों की पुनः‑पहचान की क्षमता बनाए रखता है। अज्ञातकरण पहचान योग्य जानकारी को पूरी तरह हटा देता है, जिससे पुनः‑पहचान असंभव हो जाती है।
def pseudonymize_data(df, id_column, key_mapping=None):
    if key_mapping is None:
        key_mapping = {}

    pseudo_df = df.copy()

    for idx, original_id in enumerate(pseudo_df[id_column].unique()):
        if original_id not in key_mapping:
            key_mapping[original_id] = f"PSEUDO_{idx:06d}"
        pseudo_df.loc[pseudo_df[id_column] == original_id, id_column] = key_mapping[original_id]

    return pseudo_df, key_mapping

# Using pseudonymization
customer_data = pd.DataFrame({
    'customer_id': ['C001', 'C002', 'C001'],
    'purchase': ['Laptop', 'Mouse', 'Keyboard']
})

pseudonymized_data, mapping = pseudonymize_data(customer_data, 'customer_id')
हमारे प्रोजेक्ट ने वास्तविक ग्राहक पहचानकर्ताओं को छुपाते हुए कई ख़रीदारियों में ग्राहक की निरंतरता बनाए रखने के लिए छद्मनामकरण का उपयोग किया। ग्राहक C001 की तीनों खरीदें एक ही छद्मनाम पर मैप हुईं, जिससे वास्तविक पहचान उजागर किए बिना व्यक्तिगत ग्राहक व्यवहार का विश्लेषण संभव हो गया।
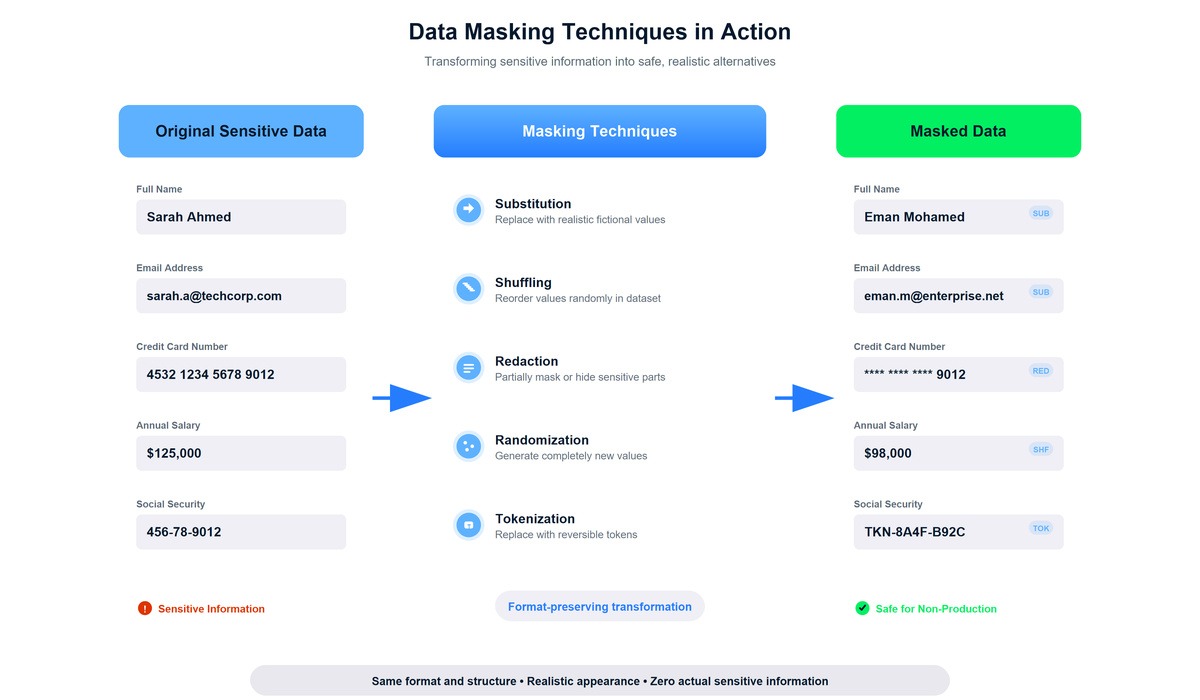
कई मास्किंग तकनीकें फ़ॉर्मैट और उपयोगिता बनाए रखते हुए संवेदनशील डेटा को ट्रांसफ़ॉर्म करती हैं
शुरुआत में, मैंने डेटा मास्किंग को एन्क्रिप्शन और अज्ञातकरण से गड़बड़ाया, क्योंकि तीनों में संवेदनशील जानकारी की सुरक्षा शामिल है। इन भेदों को समझने से मुझे अलग‑अलग परिदृश्यों के लिए उपयुक्त तकनीकें चुनने में मदद मिली। आइए मुख्य अंतर ऐसे तरीके से समझें जो बताए कि कब किसका उपयोग करें।
|
दृष्टिकोण |
यह कैसे काम करता है |
रिवर्सिबिलिटी |
सर्वोत्तम उपयोग‑मामला |
|
डेटा मास्किंग |
संवेदनशील डेटा को काल्पनिक लेकिन यथार्थवादी मानों से बदलता है |
अपरिवर्तनीय (सोर्स डेटाबेस के बिना पुनर्प्राप्ति नहीं) |
डेवलपमेंट, टेस्टिंग और एनालिटिक्स वातावरण जहाँ यथार्थवादी डेटा संरचना चाहिए लेकिन वास्तविक मान नहीं |
|
एन्क्रिप्शन |
गणितीय एल्गोरिद्म का उपयोग कर डेटा को गड़बड़ा देता है |
डिक्रिप्शन कुंजियों से परिवर्तनीय |
डेटा को ट्रांज़िट या स्टोरेज में तब सुरक्षित रखना जब अधिकृत यूज़र्स को मूल मानों तक पहुँच चाहिए |
|
अज्ञातकरण |
पहचान योग्य जानकारी हटाता या सामान्यीकृत करता है |
अपरिवर्तनीय (पुनः‑पहचान रोकने के लिए डिज़ाइन) |
अनुसंधान या सार्वजनिक उपयोग के लिए डेटा सेट प्रकाशित करना, जबकि व्यक्तिगत गोपनीयता की रक्षा करना |
|
सिंथेटिक डेटा |
सांख्यिकीय मॉडलों या ML का उपयोग कर पूरी तरह कृत्रिम डेटा सेट बनाता है |
लागू नहीं (वापस जाने के लिए कोई मूल डेटा नहीं) |
मशीन लर्निंग मॉडलों का प्रशिक्षण या वे परिदृश्य जहाँ मास्क किया गया वास्तविक डेटा भी बहुत जोखिम भरा लगे |
एन्क्रिप्शन बनाम मास्किंग का अंतर मुझे हमारे डेटाबेस सुरक्षा यूनिट के दौरान स्पष्ट हुआ। हमने डेटाबेस बैकअप्स को एन्क्रिप्ट किया ताकि वे चोरी होने पर बेकार हों, लेकिन डेवलपमेंट डेटाबेस को मास्क किया क्योंकि डेवलपर्स को डेटा के साथ काम करना था—बस वास्तविक ग्राहक डेटा नहीं। जैसा कि पहले बताया, एन्क्रिप्शन उस डेटा की रक्षा करता है जिसे आप अंततः डिक्रिप्ट करेंगे, जबकि मास्किंग स्थायी रूप से सुरक्षित विकल्प बनाती है।
मास्किंग और अज्ञातकरण के बीच का अंतर अलग लक्ष्यों पर बल देता है। अज्ञातकरण विशेष रूप से पहचान योग्य जानकारी हटाने पर केंद्रित है ताकि पुनः‑पहचान रोकी जा सके—जैसे जनरलाइज़ेशन (सटीक आयु को आयु‑श्रेणियों से बदलना) और सप्रेशन (पहचान गुणों को पूरी तरह हटाना)। मास्किंग विकास, परीक्षण और एनालिटिक्स के लिए डेटा उपयोगिता बनाए रखने पर ज़ोर देती है।
मेरे एक सहपाठी ने एक मशीन लर्निंग प्रोजेक्ट पर वास्तविक डेटा सेट के पैटर्न्स से जनित सिंथेटिक डेटा इस्तेमाल किया। सिंथेटिक डेटा में कोई वास्तविक रिकॉर्ड नहीं थे, परंतु मॉडल प्रशिक्षण के लिए आवश्यक सांख्यिकीय गुणों की नकल थी। मैंने अपने प्रोजेक्ट के लिए सिंथेटिक डेटा पर मास्किंग इसलिए चुनी क्योंकि हमें विशिष्ट परिदृश्यों की जाँच करनी थी—जैसे डुप्लीकेट ईमेल एड्रेस हैंडल करना या अंतरराष्ट्रीय पते प्रोसेस करना। सिंथेटिक डेटा ये एज़ केस हमेशा कैप्चर नहीं कर सकता, जबकि मास्क किया गया वास्तविक डेटा उन्हें संरक्षित रखता है।
मास्किंग लागू करने से पता चला कि संवेदनशील जानकारी की सुरक्षा करते हुए डेटा उपयोगिता बनाए रखना ऐसी चुनौतियाँ लेकर आता है जो तब तक स्पष्ट नहीं होतीं जब तक आप उनसे टकराएँ नहीं। मैं जिन बड़े अवरोधों से गुज़रा और उन्हें कैसे सुलझाया, वह साझा करता हूँ।
एट्रिब्यूट प्रिज़र्वेशन उम्मीद से कठिन निकली। महज़ यादृच्छिक रूप से मान बदलने से वे पैटर्न टूट जाते हैं जिन पर एप्लिकेशन निर्भर करते हैं। क्रेडिट कार्ड नंबर Luhn एल्गोरिद्म का पालन करते हैं, ईमेल पतों के लिए सही डोमेन फ़ॉर्मैट चाहिए, और ZIP कोड भौगोलिक क्षेत्रों से संबद्ध होते हैं। मैंने यह तब सीखा जब पहली मास्किंग में मैंने क्रेडिट कार्ड फ़ील्ड्स के लिए यादृच्छिक 16‑अंकीय नंबर बना दिए। सबकुछ ठीक दिखता था, जब तक टेस्टिंग में पता नहीं चला कि हमारे पेमेंट वैलिडेशन लॉजिक ने हर कार्ड नंबर को खारिज कर दिया—क्योंकि मैं भूल गया था कि क्रेडिट कार्ड नंबरों में Luhn एल्गोरिद्म से निकला चेक डिजिट होता है।
सामंतिक अखंडता फ़ॉर्मैट से आगे मायने रखती है। मास्क किया गया डेटा स्पष्ट रूप से बेतुके संयोजनों से बचे। टेस्टिंग के दौरान, एक टीममेट ने नोटिस किया कि हमारे मास्क किए डेटा सेट में फ्लोरिडा की सड़कों के पतों पर अलास्का ZIP कोड असाइन थे। फ़ॉर्मैट तकनीकी रूप से मान्य थे, पर भौगोलिक असंगति संदिग्ध लग रही थी। मैंने एक दोपहर भौगोलिक रूप से मेल खाने वाले पूर्ण पते जनरेट कर, सामंतिक संगति सुधारने में बिताई, न कि एड्रेस कम्पोनेंट्स को यादृच्छिक रूप से जोड़ने में।
टेबल्स के बीच रेफ़रेंशियल इंटेग्रिटी ने काफी जटिलता पैदा की। जैसा कि तकनीकों वाले सेक्शन में समझाया, हमारे डेटाबेस में customers, orders, और reviews टेबल्स में ग्राहक आईडी आती थीं। यदि मास्किंग ने ग्राहक आईडी को असंगत रूप से बदला, तो ये रिश्ते पूरी तरह टूट जाते। ऐसा मेरे साथ पहली कोशिश में हुआ—हमारे 30% इंटीग्रेशन टेस्ट फेल हुए क्योंकि ग्राहक ऑर्डर्स अब ग्राहक रिकॉर्ड्स से लिंक नहीं थे। सफलता तब मिली जब समझ आया कि मुझे डिपेंडेंसी ऑर्डर में टेबल्स प्रोसेस करनी होंगी और डेटर्मिनिस्टिक मास्किंग का उपयोग करना होगा ताकि C001 हर जगह एक ही मास्क की गई आईडी बने।
सुरक्षा और विश्लेषणात्मक मूल्य में संतुलन निरंतर निर्णय चाहता है। अधिक आक्रामक मास्किंग बेहतर गोपनीयता देती है लेकिन उपयोगिता घटाती है। उदाहरण के लिए, सभी आयु को निकटतम दशक तक राउंड करना गोपनीयता सुधारता है, पर आयु‑आधारित विश्लेषण की उपयोगिता खत्म कर सकता है। हमारे प्रोजेक्ट ने उपयोगिता को तरजीह दी क्योंकि हम ऐसी एप्लिकेशन फ़ीचर्स बना रहे थे जिन्हें यथार्थवादी डेटा व्यवहार चाहिए था। वास्तविक प्रोडक्शन परिदृश्य में, जहाँ वास्तविक ग्राहक डेटा और कंप्लायंस दायित्व होते हैं, मैं गोपनीयता सुरक्षा को अधिक वज़न दूँगा और संभवतः घटती डेटा उपयोगिता स्वीकार करूँगा।
सांख्यिकीय संबंध विकृत हो सकते हैं। यदि आपके पास दो सहसम्बद्ध कॉलम हैं, जैसे आय और ख़र्च, और आप दोनों को स्वतंत्र रूप से गड़बड़ा दें, तो कोरिलेशन बदल सकता है। सांख्यिकीय दृष्टि से, स्वतंत्र स्क्रैम्बलिंग वेरिएबल्स के संयुक्त वितरण को बदल देती है। इस संबंध को संरक्षित रखने के लिए, विश्लेषक कभी‑कभी रैंक‑प्रिज़र्विंग ट्रांसफ़ॉर्मेशन अपनाते हैं—जैसे दोनों कॉलम्स को एक ही यादृच्छिक परमीटेशन से शफ़ल करना या नियंत्रित शोर जोड़ना जो संयुक्त ऑर्डरिंग बनाए रखे।
इन व्यक्तिगत तकनीकों को सीखने के बाद, मैं देखना चाहता था कि वे एक यथार्थवादी परिदृश्य में साथ में कैसे काम करती हैं। यहाँ एक संपूर्ण उदाहरण है जो संबंधित ऑर्डर्स के साथ एक ग्राहक डेटाबेस को मास्क करना दिखाता है—ठीक वही चुनौती जिसका हमने अपने ई‑कॉमर्स प्रोजेक्ट में सामना किया।
from faker import Faker
import pandas as pd
import numpy as np
import uuid

fake = Faker()
Faker.seed(42)  # For reproducible results

# Original datasets (simulating real customer data)
customers_original = pd.DataFrame({
    'customer_id': ['C001', 'C002', 'C003'],
    'first_name': ['Khalid', 'Sarah', 'Mohamed'],
    'last_name': ['Abdelaty', 'Ahmed', 'Ali'],
    'email': ['khalid.a@email.com', 'sarah.a@email.com', 'mali@email.com'],
    'phone': ['555-0123', '555-0124', '555-0125'],
    'credit_card': ['4532-1234-5678-9012', '4556-7890-1234-5678', '4539-8765-4321-0987'],
    'internal_notes': ['VIP customer', 'Requested callback', 'Payment issue resolved']
})

orders_original = pd.DataFrame({
    'order_id': ['ORD001', 'ORD002', 'ORD003', 'ORD004'],
    'customer_id': ['C001', 'C002', 'C001', 'C003'],
    'product': ['Laptop', 'Mouse', 'Keyboard', 'Monitor'],
    'amount': [1299.99, 29.99, 89.99, 399.99]
})

# Step 1: Create deterministic ID mapping to maintain referential integrity
def create_id_mapping(ids):
    """Create consistent pseudonymous IDs"""
    mapping = {}
    for idx, original_id in enumerate(ids):
        mapping[original_id] = f"CUST_{idx:06d}"
    return mapping

customer_id_mapping = create_id_mapping(customers_original['customer_id'].unique())

# Step 2: Mask customer data using multiple techniques
def mask_customer_database(df, id_mapping):
    masked = df.copy()

    # Pseudonymization: Replace customer IDs consistently
    masked['customer_id'] = masked['customer_id'].map(id_mapping)

    # Substitution: Replace names and emails with realistic fake data
    masked['first_name'] = [fake.first_name() for _ in range(len(masked))]
    masked['last_name'] = [fake.last_name() for _ in range(len(masked))]
    masked['email'] = [fake.email() for _ in range(len(masked))]

    # Partial masking/redaction: Show last 4 digits of phone and credit card
    masked['phone'] = masked['phone'].apply(lambda x: '***-' + x[-4:])
    masked['credit_card'] = masked['credit_card'].apply(lambda x: '****-****-****-' + x[-4:])

    # Nulling: Remove internal notes entirely
    masked['internal_notes'] = None

    return masked

# Step 3: Mask order data with referential integrity
def mask_order_database(df, id_mapping):
    masked = df.copy()

    # Pseudonymization: Use same customer ID mapping to maintain relationships
    masked['customer_id'] = masked['customer_id'].map(id_mapping)

    # Randomization: Generate new order IDs
    masked['order_id'] = [f"ORD-{uuid.uuid4().hex[:8].upper()}" for _ in range(len(masked))]

    # Shuffling: Preserve amount distribution but break individual associations
    shuffled_amounts = masked['amount'].values.copy()
    np.random.shuffle(shuffled_amounts)
    masked['amount'] = shuffled_amounts

    return masked

# Apply masking
customers_masked = mask_customer_database(customers_original, customer_id_mapping)
orders_masked = mask_order_database(orders_original, customer_id_mapping)

print("=== MASKED CUSTOMER DATA ===")
print(customers_masked)
print("\n=== MASKED ORDER DATA ===")
print(orders_masked)

# Verify referential integrity is maintained
print("\n=== VERIFICATION: JOIN STILL WORKS ===")
joined = customers_masked.merge(orders_masked, on='customer_id')
print(f"Original orders: {len(orders_original)}, Joined orders: {len(joined)}")
print("✓ All order-customer relationships preserved!")
जब मैंने यह संपूर्ण मास्किंग पाइपलाइन हमारे प्रोजेक्ट डेटा (500 ग्राहक रिकॉर्ड्स और 1,200 ऑर्डर्स) पर चलाई, तो इसे चलने में लगभग 2 सेकंड लगे—जो हमारी साप्ताहिक डेवलपमेंट डेटाबेस रीफ़्रेश साइकिल के लिए पूरी तरह स्वीकार्य था। कई बातें स्पष्ट हो गईं:
रेफ़रेंशियल इंटेग्रिटी बेहतरीन तरीके से काम की। ग्राहक CUST_000000 (मूल रूप से C001) के ऑर्डर्स customers और orders दोनों टेबल्स में थे। हमारी ऑर्डर हिस्ट्री फ़ीचर को चलाने वाली JOIN क्वेरीज़ मास्क किए डेटा पर भी समान रूप से काम करती रहीं, क्योंकि हमने दोनों टेबल्स के लिए एक ही customer_id_mapping का उपयोग किया।
हर तकनीक ने विशिष्ट उद्देश्य पूरा किया। सब्स्टिट्यूशन ने ग्राहक नामों को यथार्थवादी दिखाया। आंशिक मास्किंग ने पूरे कार्ड नंबर उजागर किए बिना भुगतान विधि सत्यापित करने दी। शफ़लिंग ने हमारी एनालिटिक्स डैशबोर्ड्स की राजस्व वितरण सही दिखाने की क्षमता बनाए रखी, जबकि राशियों को विशिष्ट ग्राहकों से अलग कर दिया। नलिंग ने वह डेटा हटा दिया जिसकी हमें टेस्टिंग के लिए ज़रूरत नहीं थी।
आउटपुट असली डेटा जैसा दिखा और बर्ताव किया। डेवलपमेंट के दौरान जब मैंने मास्क किए डेटाबेस को ब्राउज़ किया, सबकुछ प्रामाणिक लगा। ईमेल पते सही तरीके से वैलिडेट हुए। फ़ोन नंबर ठीक से दिखे। डेटा "यह नकली है" चिल्लाता नहीं था, जिससे मैं स्पष्ट रूप से एप्लिकेशन लॉजिक डिबग करने पर केंद्रित रह सका, न कि स्पष्ट रूप से कृत्रिम टेस्ट डेटा से भटका।
डेटा गुणवत्ता उच्च बनी रही। हम अब भी कई ऑर्डर्स वाले ग्राहकों जैसे एज़ केस टेस्ट कर सके, एग्रीगेट आँकड़े निकाल सके, और डेटाबेस कंस्ट्रेंट्स वेरिफ़ाई कर सके। मास्किंग ने आवश्यक जटिलता और संबंधों को संरक्षित रखा, जबकि हर संवेदनशील जानकारी की रक्षा की।
इस दृष्टिकोण ने उस समस्या को, जो शुरू में भारी लग रही थी—एक सुरक्षित लेकिन यथार्थवादी टेस्ट डेटाबेस बनाना—को एक तंत्रबद्ध, पुनरुत्पाद्य प्रक्रिया में बदल दिया। हर बार जब हम डेवलपमेंट डेटाबेस रीफ़्रेश करते, यह मास्किंग स्क्रिप्ट एक मिनट से भी कम में चलती और हमें पूरा भरोसा देती कि कोई वास्तविक ग्राहक डेटा लीक नहीं हो सकता।
व्यापक डेटा डिस्कवरी से शुरुआत करें। संवेदनशील जानकारी स्पष्ट फ़ील्ड्स—जैसे नाम और ईमेल—के परे भी अप्रत्याशित जगहों पर दिखाई दी। हमारे डेटाबेस में कस्टमर नोट्स फ़ील्ड्स थे जिनमें फ्री‑टेक्स्ट एंट्रीज़ थीं और वे व्यक्तिगत जानकारी शामिल कर सकती थीं। मैंने सीखा कि हर फ़ील्ड को व्यवस्थित रूप से रिव्यू करना चाहिए, सिर्फ़ स्पष्ट रूप से संवेदनशील को नहीं। प्रोडक्शन सिस्टम्स में, संगठन स्वचालित डेटा डिस्कवरी टूल्स का उपयोग करते हैं जो व्यक्तिगत पहचान योग्य जानकारी से मिलते पैटर्न्स के लिए स्कैन करते हैं।
शुरू में ही स्पष्ट मास्किंग नीतियाँ स्थापित करें। अलग‑अलग टीम सदस्य शुरू में स्वतंत्र मास्किंग निर्णय लेते थे, जिससे असंगतियाँ बनीं। किसी ने फ़ोन नंबर पूरी तरह मास्क कर दिए, किसी ने आंशिक मास्किंग की, और किसी ने उन्हें छुआ तक नहीं। अंततः हमने अपना दृष्टिकोण मानकीकृत किया: नाम और ईमेल के लिए पूर्ण मास्किंग, फ़ोन नंबरों और कार्ड्स के लिए आंशिक मास्किंग, और आंतरिक नोट्स के लिए नलिंग। दस्तावेजीकृत नीतियाँ बताती हैं कि किन डेटा एलिमेंट्स को मास्क करना है, अलग‑अलग प्रकारों पर कौन‑सी तकनीकें लागू होंगी, और एज़ केसेज़ को कैसे संभालना है।
फ़ॉर्मैट‑प्रिज़र्विंग एल्गोरिद्म का उपयोग करें। डेटा को यादृच्छिक मानों से बदलने के बजाय, ये एल्गोरिद्म ऐसे यथार्थवादी रिप्लेसमेंट जनरेट करते हैं जो मूल डेटा के समान वैलिडेशन नियमों को संतुष्ट करें। जैसा मैंने पहले दिखाया, मेरे क्रेडिट कार्ड मास्किंग को Luhn वैलिडेशन पास करने वाले नंबर जनरेट करने थे, और ईमेल मास्किंग को वैध डोमेन पैटर्न्स वाले सही फ़ॉर्मैटेड पते।
मास्किंग गुणवत्ता का कठोर परीक्षण करें। मैंने डेवलपमेंट में उपयोग करने से पहले मास्क किए डेटा की गुणवत्ता की जाँच के लिए सरल टेस्ट लिखे। इन टेस्ट्स ने देखा कि मास्क किए ईमेल पते regex वैलिडेशन पास करते हैं या नहीं, मास्किंग के बाद ग्राहक आईडीज़ यूनिक बनी रहती हैं या नहीं, फ़ॉरेन की रिलेशनशिप्स मान्य रहती हैं या नहीं, और मास्क किया गया डेटा सेट आकार में मूल के बराबर है या नहीं। इन टेस्ट्स ने डुप्लीकेट जनरेशन और रेफ़रेंशियल इंटेग्रिटी ब्रेक्स जैसी समस्याएँ एप्लिकेशन टेस्टिंग में आने से पहले पकड़ लीं।
पूरी प्रक्रिया को ऑटोमेट करें। मेरी पहली मास्किंग कोशिश में हाथ से Python स्क्रिप्ट चलाना और फ़ाइलें कॉपी करना शामिल था—जो जल्दी ही थकाऊ हो गया। अंततः मैंने एक ही स्क्रिप्ट बना दी जो पूरी प्रक्रिया संभालती थी: मूल डेटा पढ़ो, सभी मास्किंग ट्रांसफ़ॉर्मेशन लागू करो, परिणामों को वैलिडेट करो, और मास्क आउटपुट लिखो। वास्तविक प्रोजेक्ट्स में, जहाँ कंटीन्यूअस इंटीग्रेशन पाइपलाइंस होती हैं, मास्किंग एक स्वचालित स्टेप के रूप में इंटीग्रेट होगी—ताकि डेवलपर्स को इसके बारे में सोचना भी न पड़े।
अपरिवर्तनीयता और दोहराव सुनिश्चित करें। मास्किंग प्रक्रिया वास्तविक सुरक्षा देने के लिए अपरिवर्तनीय होनी चाहिए, लेकिन जब आपको टेस्ट डेटाबेस को सुसंगत परिणामों के साथ रीफ़्रेश करना हो, तब दोहराए जाने योग्य भी। जैसा मैंने पूर्ण उदाहरण में दिखाया, निरंतर सीड्स के साथ डेटर्मिनिस्टिक तकनीकें यह संतुलन प्रदान करती हैं।
कृत्रिम बुद्धिमत्ता और मशीन लर्निंग के साथ डेटा मास्किंग तेजी से विकसित हो रही है। जबकि हमारे क्लास प्रोजेक्ट में पारंपरिक मास्किंग तकनीकें थीं, आधुनिक समाधान बढ़ते हुए AI का उपयोग करके मास्किंग प्रक्रिया को स्वचालित और बेहतर बना रहे हैं।
मेरे लिए सबसे रोमांचक संभावना ऑटोमेटेड डेटा डिस्कवरी है। मैंने कौन‑से फ़ील्ड्स में संवेदनशील जानकारी है, यह पहचानने के लिए हमारे डेटाबेस स्कीमा की मैन्युअल समीक्षा में घंटे लगाए। कल्पना कीजिए ऐसा टूल जो पैटर्न्स, कॉलम नामों और वैल्यू डिस्ट्रीब्यूशंस का विश्लेषण कर संवेदनशील फ़ील्ड्स स्वतः पहचान ले—बिना मैन्युअल समीक्षा के। कोई ML सिस्टम पहचान सकता है कि अजीब‑सा नाम "user_identifier" वास्तव में ईमेल पते रखता है—ऐसी चीज़ जिसे मैं मैन्युअल निरीक्षण के दौरान आसानी से चूक सकता था। इससे मेरा काफी समय बच जाता।
मैंने पारंपरिक मास्किंग से आगे जाने वाली गोपनीयता‑संरक्षण मशीन लर्निंग तकनीकों के बारे में भी पढ़ा है। उदाहरण के लिए, डिफ़रेंशियल प्राइवेसी प्रशिक्षण डेटा या मॉडल आउटपुट्स में सावधानीपूर्वक कैलिब्रेटेड गणितीय शोर जोड़ती है। Federated learning संवेदनशील जानकारी को केंद्रीकृत किए बिना वितरित डेटा सेट्स पर मॉडल्स को प्रशिक्षित करती है। ये दृष्टिकोण उन परिदृश्यों को संबोधित करते हैं जहाँ मानक मास्किंग वे पैटर्न्स हटा सकती है जिनकी मॉडल्स को सीखने के लिए ज़रूरत होती है।
जनरेटिव AI पर आधारित सिंथेटिक डेटा जनरेशन मुझे भविष्य के प्रोजेक्ट्स के लिए विशेष रूप से रोचक लगता है। वास्तविक रिकॉर्ड्स को मास्क करने के बजाय, वास्तविक डेटा पैटर्न्स पर प्रशिक्षित AI सिस्टम्स पूरी तरह कृत्रिम डेटा सेट जनरेट करते हैं। मैंने अभी तक खुद यह लागू नहीं किया है, लेकिन बड़े प्रशिक्षण डेटा सेट्स की ज़रूरत वाले परिदृश्यों या जहाँ मास्क किया गया वास्तविक डेटा भी जोखिम भरा लगे, वहाँ इसकी अपील समझता हूँ। चुनौती होगी यह सुनिश्चित करना कि सिंथेटिक डेटा वे एज़ केसेज़ और जटिलता सटीक रूप से दर्शाए जो हमारे परीक्षण के लिए मास्क किए वास्तविक डेटा को इतना मूल्यवान बनाते थे।
जहाँ तक क्षेत्र की दिशा का सवाल है, क्लाउड‑नेटिव डेवलपमेंट वर्कफ़्लो मास्किंग को मानक इंफ्रास्ट्रक्चर के रूप में शामिल करना शुरू कर रहे हैं। Python स्क्रिप्ट्स से मैन्युअल रूप से मास्किंग चलाने के बजाय, डिप्लॉयमेंट पाइपलाइंस डेवलपमेंट डेटाबेस प्रोविज़न करते समय इसे स्वचालित रूप से संभाल सकती हैं। डेवलपर्स डेटाबेस स्कीमाज़ के साथ‑साथ कॉन्फ़िगरेशन फ़ाइलों में मास्किंग आवश्यकताएँ निर्दिष्ट करेंगे। यही वह ऑटोमेशन है जिसे मैं भविष्य के प्रोजेक्ट्स में लागू करना पसंद करूँगा—मास्किंग को मैन्युअल प्री‑प्रोसेसिंग स्टेप से स्वचालित इंफ्रास्ट्रक्चर बिहेवियर में बदलना।
हालाँकि, AI डेटा गोपनीयता के लिए दोधारी तलवार है। जहाँ यह मास्किंग तकनीकों में सुधार करता है, वहीं पुनः‑पहचान हमलों को भी अधिक परिष्कृत बनाता है। मशीन लर्निंग मॉडल्स, दिखने में अज्ञात किए गए डेटा को सार्वजनिक जानकारी से क्रॉस‑रेफ़रेंस कर व्यक्तियों की पुनः‑पहचान कर सकते हैं। शोधकर्ताओं ने प्रसिद्ध रूप से "अज्ञात" Netflix डेटा में लोगों की पुनः‑पहचान IMDb रिव्यूज़ से सहसंबंध कर की थी। जैसे‑जैसे मास्किंग टूल्स स्मार्ट होते जाते हैं, उन्हें तोड़ने के तरीके भी।
डेटा मास्किंग डेटा उपयोगिता और गोपनीयता के बीच सही संतुलन बनाती है। सब्स्टिट्यूशन, डेटर्मिनिस्टिक मास्किंग और फ़ॉर्मैट‑प्रिज़र्विंग जैसी सही तकनीकें लागू कर, आप यथार्थवादी डेटा बनाए रखते हुए संवेदनशील जानकारी की सुरक्षा कर सकते हैं।
अपनी सबसे महत्वपूर्ण डेटा सेट्स की पहचान से शुरू करें और नॉन‑प्रोडक्शन वातावरणों में मास्किंग लागू करें। वर्कफ़्लो में गोपनीयता सुरक्षा को मानक बनाने के लिए शुरुआत में ही ऑटोमेशन जोड़ें।
अपने कौशल को गहरा करने के लिए, हमारे Data Privacy and Anonymization in Python या Data Engineering for Everyone कोर्सेज़ देखें।
DataCamp के साथ सीखें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}