
{count, plural, other {课程}}
假设检验是统计学中的关键环节,帮助您在广泛领域中做出明智决策——从医学到经济学,再到社会科学。本文将带您了解假设检验的核心概念、类型、步骤以及实际应用,确保您能够自信地解释并呈现统计结论。
如果您准备进一步学习假设检验,请选择符合您偏好技术的课程:Python 中的假设检验、R 中的假设检验,或Google 表格统计学入门。此外,我们还有不依赖特定技术的统计学入门课程。
什么是假设检验?
假设检验是一种用于检验关于总体参数的假设或设想的统计程序。它包含提出原假设(H0)和备择假设(Ha)、收集数据,并判断证据是否足以拒绝原假设。
假设检验的主要目的,是基于一个数据样本对总体做出推断。它使研究者和分析师能够量化数据中观察到的差异或关系是偶然出现的可能性,还是反映了总体中的真实效应。
假设检验的步骤
让我们一步步走过如何进行一次假设检验。
步骤 1:陈述您的假设
首先将研究问题表述为两个相互竞争的假设:
- 原假设(H0):默认假设为没有效应或没有差异。
- 备择假设(Ha):认为存在效应或差异的假设。
例如:
- H0:男性的平均身高等于女性的平均身高。
- Ha:男性的平均身高不等于女性的平均身高。
步骤 2:收集并准备数据
通过实验、问卷或观察性研究收集数据。确保数据收集方法能够检验假设并具有总体代表性。此步骤通常包括:
- 界定目标总体。
- 选择合适的抽样方法。
- 确定样本量。
- 收集并整理数据。
步骤 3:选择合适的统计检验
根据数据类型和假设选择统计检验。选择取决于以下因素:
- 数据类型(连续型、分类型等)
- 数据分布(正态、非正态)
- 样本量
- 比较的组数
常见检验包括:
-
t 检验(用于比较均值)
-
卡方检验(用于分类数据)
-
方差分析(ANOVA)(用于比较多个组的均值)
步骤 4:计算检验统计量与 p 值
使用统计软件或公式计算检验统计量及相应的 p 值。该步骤量化样本数据相对于原假设的偏离程度。
p 值是假设检验中的重要概念。它表示在原假设为真时,观察到像样本数据这样极端结果的概率。
步骤 5:做出决策
将 p 值与预先设定的显著性水平(α,通常设为 0.05)进行比较。决策规则如下:
- 若 p 值 ≤ α:拒绝原假设,表明有证据支持备择假设。
- 若 p 值 > α:不拒绝原假设,表明证据不足以支持备择假设。
需注意,不拒绝原假设并不等于证明其为真;这仅意味着没有足够证据得出相反结论。
步骤 6:呈现您的发现
报告结果,包括检验统计量、p 值和结论。讨论研究发现是否支持最初的假设及其意义。呈现结果时,请考虑:
- 提供研究背景。
- 清晰陈述假设。
- 报告检验统计量与 p 值。
- 用通俗语言解释结果。
- 讨论研究发现的实际意义。
假设检验的类型
假设检验可大致分为两大类:
参数检验
参数检验假设数据服从特定概率分布,通常为正态分布。当满足假设条件时,这类检验通常更有力。常见的参数检验包括:
- t 检验(单样本、独立样本、配对样本)
- 方差分析 ANOVA(单因素、双因素、重复测量)
- Z 检验(单样本、双样本)
- F 检验(单因素、双因素)
非参数检验
非参数检验不对数据分布作特定假设。在处理有序数据,或当参数检验的前提条件被违反时非常有用。示例包括:
- Mann-Whitney U 检验
- Wilcoxon 符号秩检验
- Kruskal-Wallis 检验
选择合适的检验
选择假设检验时,研究者通常会考虑以下几类因素:
- 数据分布:判断数据是否近似正态分布,因为许多检验假设正态性。
- 组数:明确比较的组数(例如 1 组、2 组或更多)。
- 组间独立性:判断各组是否独立(不同受试者)或相关(同一受试者多次测量)。
- 数据类型:
- 连续型(如身高、体重),
- 有序型(如排名),
- 名义型(如无序类别)。
基于上述因素,您可以选择合适的统计检验。例如,若数据近似正态分布,且您有两个独立组并为连续型数据,可使用独立样本 t 检验。若数据不服从正态分布、为两个独立组且为有序型数据,则推荐使用 Mann-Whitney U 检验。
为帮助选择合适的检验,可参考假设检验流程图,作为一般性指南:
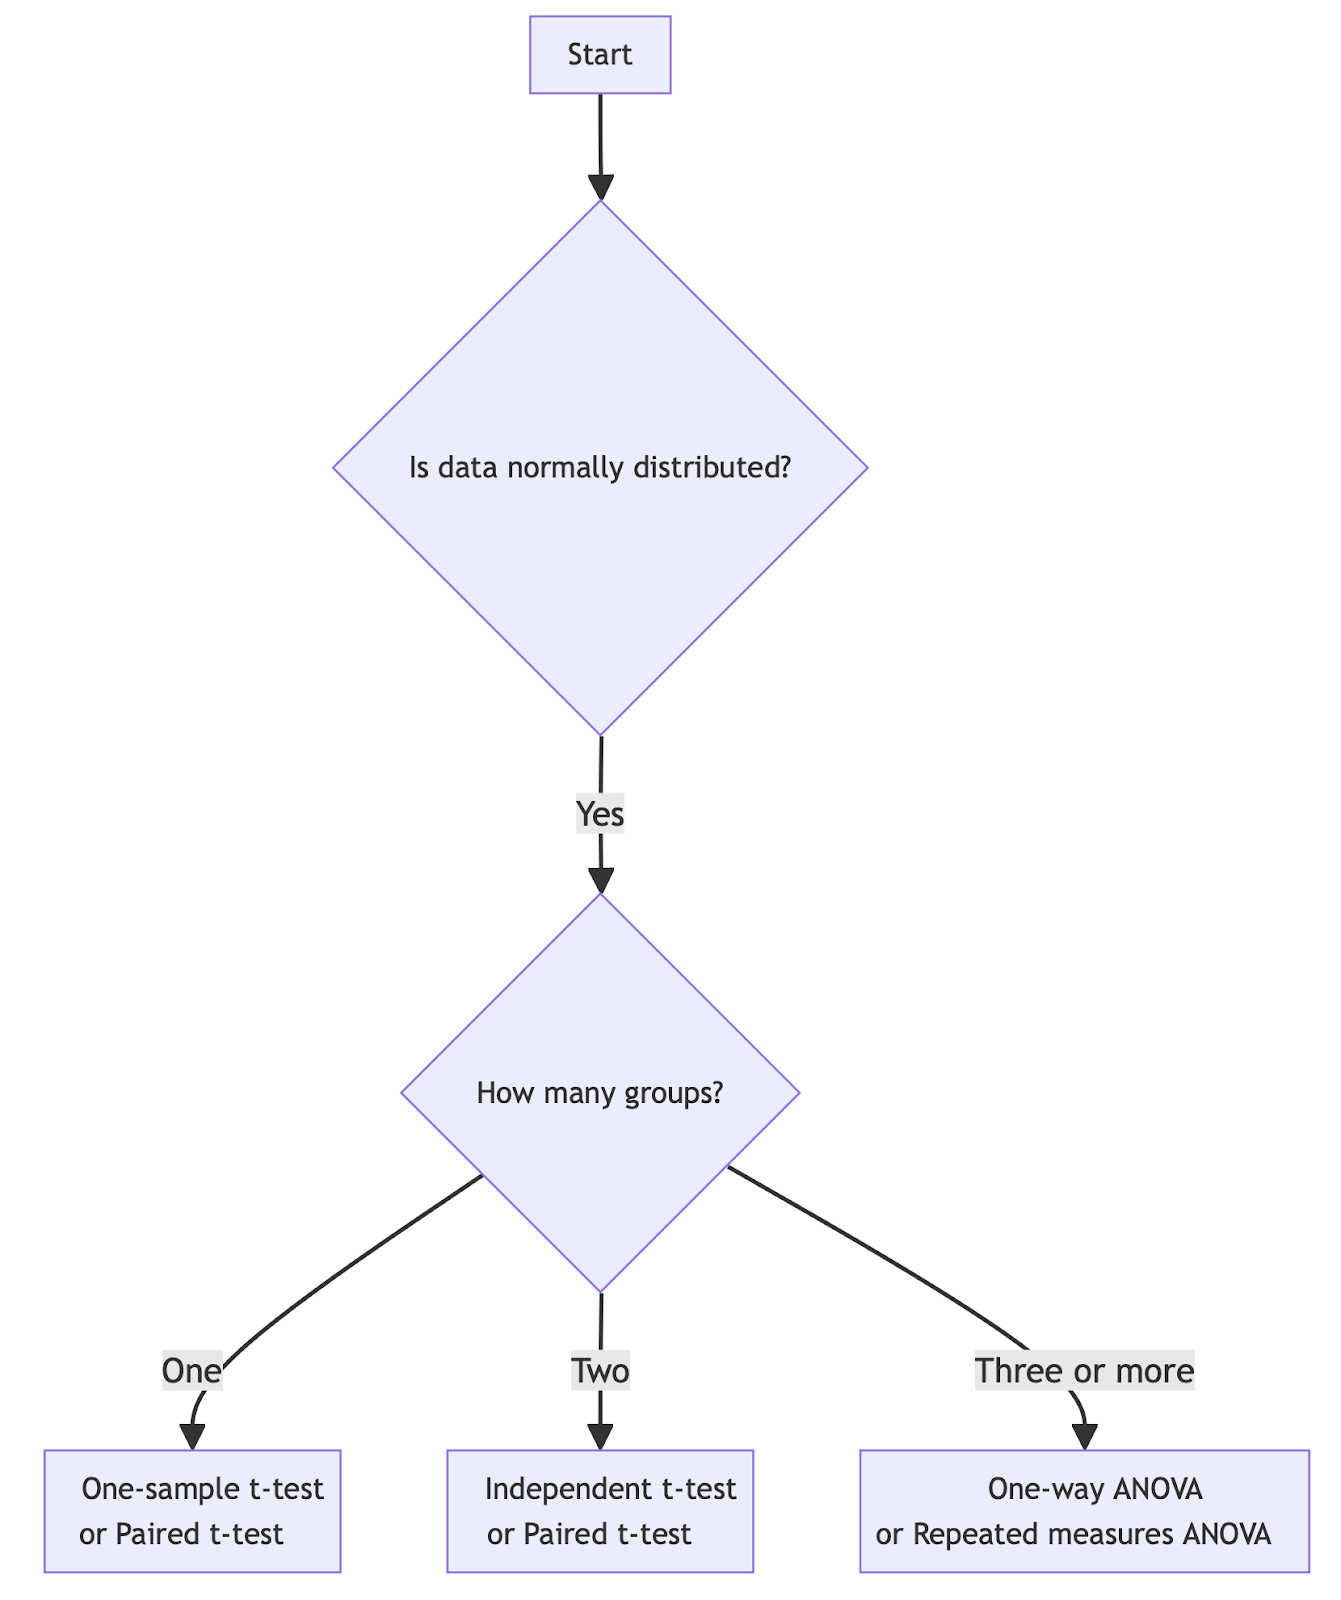
为近似正态分布数据选择合适的假设检验。图片作者自制。
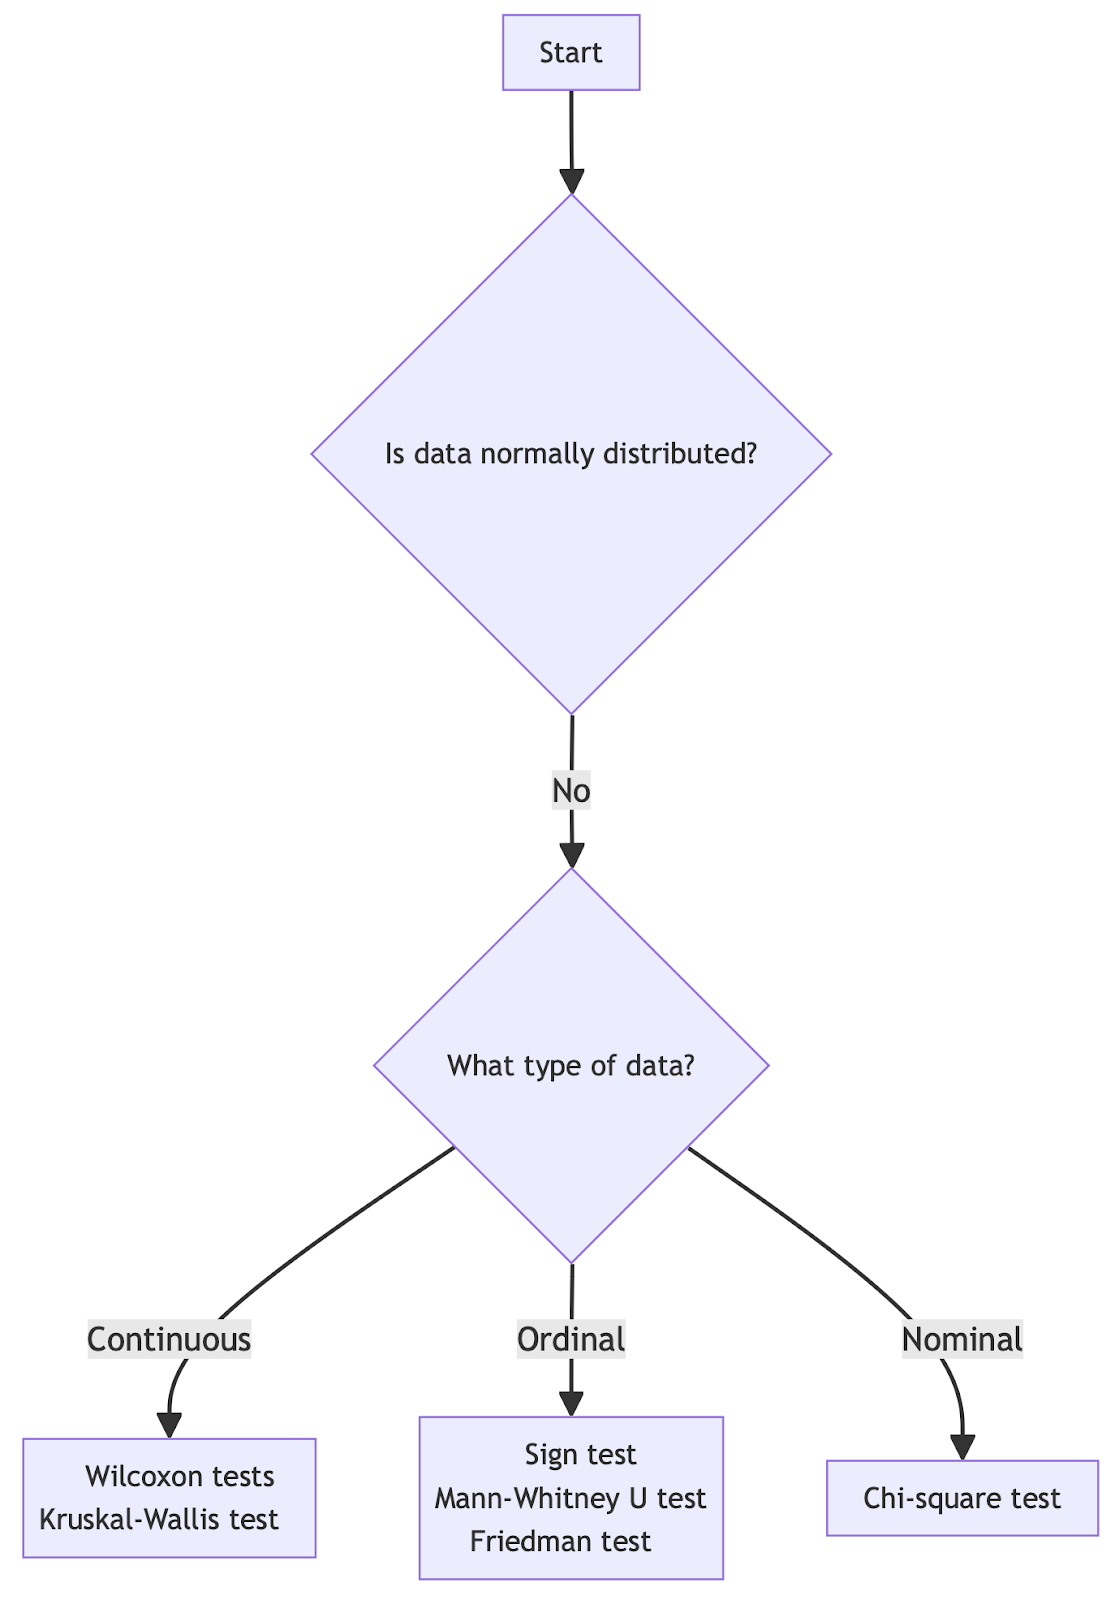
为非正态分布数据选择合适的假设检验。图片作者自制。
假设检验的现代方法
除了传统方法,还有几种现代方法:
置换或随机化检验
此类方法通过对观测数据进行多次随机重排,构造在原假设下可能结果的分布。它们在样本量较小或参数检验前提不满足时尤为有用。
自助法(Bootstrapping)
自助法是一种重抽样技术,即从原始数据集中进行有放回的重复抽样。可用于估计统计量的抽样分布并构建置信区间。
蒙特卡罗模拟
蒙特卡罗方法通过重复的随机抽样得到数值结果。在假设检验中,它们可用于为复杂统计模型估计 p 值,或在解析解难以获得时提供近似。
控制误差
进行假设检验时,最好理解并控制潜在误差:
第一类错误与第二类错误
- 第一类错误:在原假设真实时错误地拒绝它(假阳性)。
- 第二类错误:在原假设为假时未能拒绝它(假阴性)。
显著性水平(α)直接控制第一类错误的概率。降低 α 会减少第一类错误的机会,但会增加第二类错误的风险。
平衡这些错误的方法包括:
- 根据各类错误的后果调整显著性水平。
- 增大样本量以提高检验效能(功效)。
- 在合适的情形下使用单侧检验。
“抽屉效应”
“抽屉效应”指的是一种发表偏倚:具有显著结果的研究更可能被发表,而不显著的研究更可能被搁置。这会导致文献中效应被高估。缓解方法包括:
- 考虑对研究进行预注册。
- 发表所有结果,无论是否显著。
- 开展考虑发表偏倚的元分析。
- 事先进行数据模拟。
关键术语与定义
- 原假设(H0):默认假设为没有效应或没有差异。
- 备择假设(Ha):认为存在效应或差异的假设。
- p 值:在原假设为真时观察到检验结果的概率。
- 显著性水平(α):用于拒绝原假设的阈值,常设为 0.05。
- 检验统计量:用于将观测数据与原假设进行比较的标准化数值。
- 第一类错误:拒绝真实的原假设(假阳性)。
- 第二类错误:未能拒绝错误的原假设(假阴性)。
- 统计功效:正确拒绝错误原假设的概率。
- 置信区间:很可能包含真实总体参数的取值范围。
- 效应量:衡量所检验差异或关系大小的指标。
结语
请记住,假设检验只是统计推断工具箱中的一部分。始终同时关注研究发现的实际意义,而不仅是统计显著性。随着经验积累,您将逐渐掌握在各种真实场景中何时以及如何应用这些技术。
若想进一步提升统计素养,您可以探索主题,例如2024 年如何成为统计学家,了解这一领域的发展及成功所需技能。此外,练习2024 年统计面试 35 问并学习我们的用 R 练习统计面试题课程,有助于精进技能并为面试做好准备。
Vinod Chugani 的职业生涯始于东京,曾任摩根大通最年轻的对冲基金销售台负责人,随后在雷曼兄弟创下个人销售纪录,之后又打造了覆盖 30 个国家的电子分销业务,营收突破 1 亿新元,随后转向数据领域。他毕业于杜克大学经济学专业,亦为 NYC Data Science Academy 校友,并在 100 多名申请者中成为Hugo Bowne-Anderson 在 Maven 开设的 “Building AI Applications” 课程的三位奖学金获得者之一。目前,他为 DataCamp、KDnuggets、Machine Learning Mastery 和 Statology 撰稿,内容涵盖从统计学到代理式 AI 等主题,并在 NYC Data Science Academy 指导数据从业者,已完成超过 1,000 场一对一辅导。
常见问题解答
为什么在进行假设检验时要控制实验环境?
在进行假设检验时控制实验环境,可最大限度减少可能影响结果的外部变量。通过这种控制,实验中观察到的效应更能自信地归因于所研究的自变量,而非其他无关因素,从而增强检验结果的有效性。
什么是原假设?
原假设通常用H0表示,是关于被检验组别或条件之间不存在效应或差异的默认假设。它是研究者希望通过统计分析加以推翻或否定的陈述。对原假设的拒绝或不拒绝,为变量之间的关系提供关键洞见。
在假设检验中,p 值与置信区间之间有何关系?
p 值和置信区间都是基于样本数据对总体进行推断的工具。p 值表示在原假设为真时,观察到与样本同等极端结果的概率。置信区间则提供一个范围,真实的总体参数很可能落在其中。如果均值差或效应量的置信区间不包含原假设的“无效值”(例如差异为 0),这表明在该置信水平下可以拒绝原假设,通常与较小的 p 值相一致。
什么是第一类错误和第二类错误?
第一类错误发生在错误地拒绝原假设时,本质上是检测到并不存在的效应(假阳性)。第二类错误发生在错误地未能拒绝原假设时,即错过了实际存在的效应(假阴性)。在统计分析中平衡这两类错误至关重要。
样本量如何影响假设检验?
样本量会直接影响假设检验的功效(即正确拒绝错误原假设、避免第二类错误的概率)。更大的样本量通常能提供对总体参数更准确可靠的估计,提高检验功效,并缩小置信区间的误差范围。
如果我的样本数据不具有总体代表性怎么办?
如果样本数据不能代表总体,假设检验的结果可能存在偏差,且难以推广到更广泛的人群。这可能源于有缺陷的抽样方法(如选择偏倚),未能涵盖总体的多样性或特征。
参数检验与非参数检验有何区别?
参数检验假设数据服从特定分布。非参数检验不对数据的分布作任何特定假设。它们用于处理有序数据、非正态分布数据或样本量较小的情形。
统计显著性与实际显著性有什么区别?
统计显著性告诉我们某一效应由偶然产生的可能性,而实际显著性则关注该效应在现实中的影响或重要性。如果效应量很小、对现实影响不大,即便结果在统计上显著,也可能缺乏实际意义。
