什么是 PyCaret
注意:本教程创建于 2021 年,PyCaret 目前已不再积极维护;某些步骤可能无法在当前版本的 DataLab 或其他工具中正常运行。
PyCaret 是一个开源、低代码的 Python 机器学习库,可用于自动化机器学习工作流。它是一个端到端的机器学习与模型管理工具,能够以指数级速度缩短实验周期,让您更高效。
与其他开源机器学习库相比,PyCaret 是一种替代性的低代码库,能将上百行代码浓缩为寥寥数行,从而使实验更快、更高效。本质上,PyCaret 是对多种机器学习库与框架的 Python 封装,如 scikit-learn、XGBoost、LightGBM、CatBoost、spaCy、Optuna、Hyperopt、Ray 等。
PyCaret 的设计与简洁性灵感源自 Gartner 首次提出的“公民数据科学家”这一新兴角色。公民数据科学家是能够完成此前需要更多技术专长才能进行的简单到中等复杂分析任务的高级用户。
PyCaret 简单易用。在 PyCaret 中执行的所有操作都会按顺序存储在一个可直接用于部署的流水线中。无论是缺失值填补、类别数据转换、特征工程,还是超参数调优,PyCaret 都能自动完成。想进一步了解 PyCaret,请观看这段一分钟视频。
PyCaret 的模块
PyCaret 的 API 采用模块化设计。每个模块支持一种监督学习(分类和回归)或非监督学习(聚类、异常检测、NLP、关联规则挖掘)。用于时间序列预测的新模块近期以测试版形式单独发布为一个pip 包。
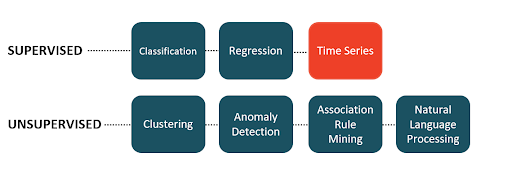 图片来源:[Ali, Moez]。
安装 PyCaret
通过 pip 安装 PyCaret 非常简单,只需几分钟。PyCaret 的默认安装仅安装在 requirements.txt 文件(仓库中)列出的硬依赖。
注意:本教程创建于 2021 年,PyCaret 目前已不再积极维护;某些步骤可能无法在当前版本的 DataLab 或其他工具中正常运行。
pip install pycaret
技术支持
要安装完整版本:
pip install pycaret[full]
技术支持
功能特性
PyCaret 的最大卖点是其简洁性。与其他自动化机器学习软件相比,PyCaret 十分灵活,提供统一的 API,且几乎没有学习成本。
PyCaret 功能丰富。您可以用几行代码就完成从数据处理到模型训练再到云端部署的全流程。它在初始化实验时会自动应用大量预处理变换。PyCaret 的模型库包含 70 多个可用于监督与非监督任务的未训练模型。
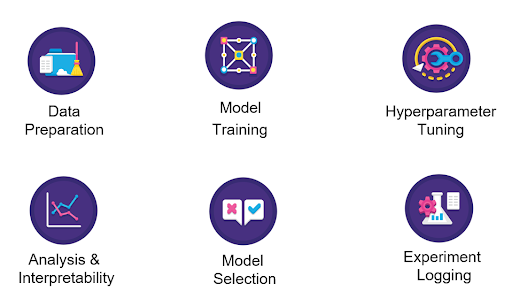
您还可以在 GPU 上使用 PyCaret,将工作流提速 10 倍。要在 GPU 上训练模型,只需在 setup 函数中传入 use_gpu = True,代码完全不需要改动。
PyCaret 是一个“玻璃盒”方案。它提供大量功能用于与模型交互并分析性能和结果。所有标准图形(如混淆矩阵、AUC、残差、特征重要性)对所有模型均可用。它还集成了用于解释任意复杂树模型输出的 SHAP 库。
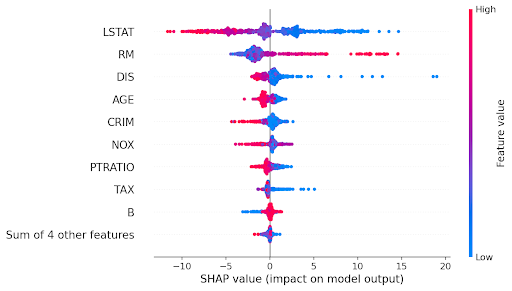 (蜂群图示例)
PyCaret 还与 MLflow 集成以提供 MLOps 功能。当您在 setup 函数中传入 log_experiment = True 时,会自动记录指标、参数和制品。
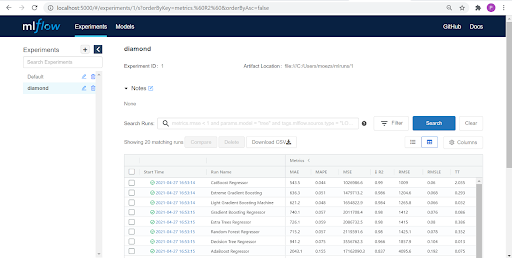 (作者供图)
PyCaret 中的预处理
所有预处理变换都在 setup 函数中完成。PyCaret 在 setup 中提供了 25 种以上的预处理变换。要了解更多关于 PyCaret 预处理能力的信息,请点击这里。
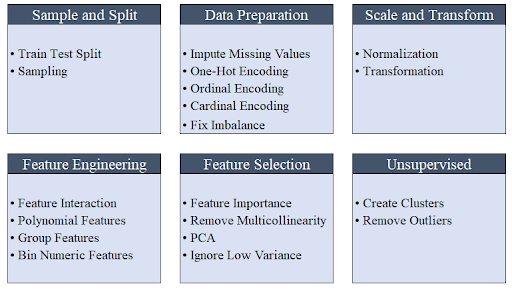 (作者供图)
PyCaret 的模块
示例:端到端 ML 用例
这是一条典型的机器学习工作流。在任何机器学习项目中,正确界定问题是第一步,做好这一步可能需要几天到数周时间。
数据获取与 ETL(抽取-转换-加载)的复杂度也会因组织的技术成熟度与规模而异。在这一阶段,通常会有数据工程团队协作完成。
探索性数据分析(EDA)阶段包括对原始数据进行探索,以评估数据质量(缺失值、离群点等)、特征相关性,并验证业务假设。
对于数据准备、模型训练与选择,PyCaret 会在幕后完成繁重工作。数据准备包括缺失值填补、缩放(min-max、z-score 等)、类别编码(独热编码、序数编码等)、特征工程(多项式、特征交互、比率等)与特征选择等变换。
数据准备完成后,模型训练与选择阶段会拟合多种算法,并通过某种测试策略(多为交叉验证)评估性能。
最后,将选定的最佳模型部署为用于推断的 API 端点。部署完成后,对 API 的监控以及对生产环境中模型性能的跟踪将长期持续。
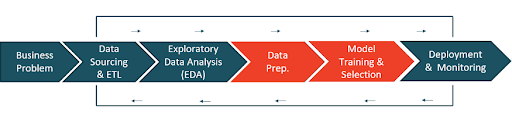 (作者供图)
问题描述
根据切工、颜色、形状等属性预测钻石价格。
数据获取
# 从 pycaret 加载数据集
from pycaret.datasets import get_data
data = get_data('diamond')
技术支持
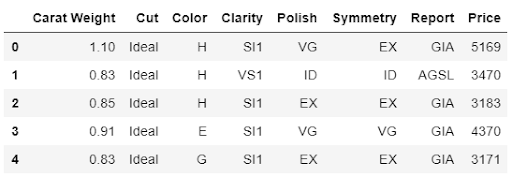
探索性数据分析(EDA)
我们快速做一些可视化,评估自变量(重量、切工、颜色、净度等)与目标变量 Price 的关系:
# 绘制克拉重量与 Price 的散点图
import plotly.express as px
fig = px.scatter(x=data['Carat Weight'], y=data['Price'], facet_col = data['Cut'], opacity = 0.25, trendline='ols', trendline_color_override = 'red')
fig.show()
技术支持
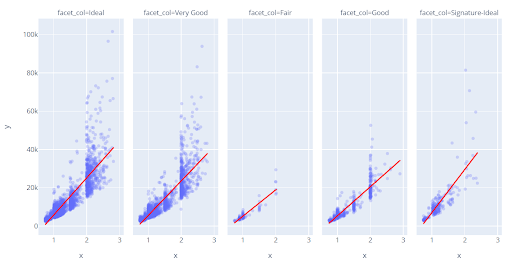
来看一下目标变量 Price 的直方图。
# 绘制直方图
fig = px.histogram(data, x=["Price"])
fig.show()
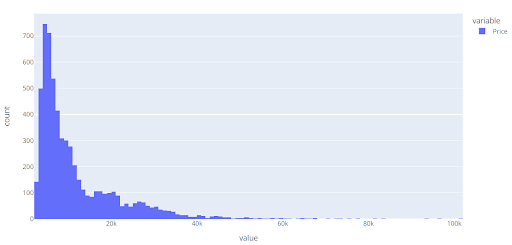
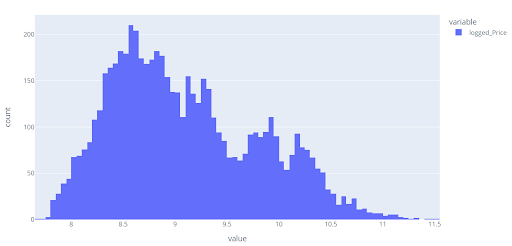
注意到 Price 的分布右偏,我们可以快速检查一下对数变换是否能改变目标变量的分布(形状)。
# 绘制直方图
data['logged_Price'] = np.log(data['Price'])
fig = px.histogram(data, x=["logged_Price"])
fig.show()
数据清洗与准备
在 PyCaret 中,所有实验都必须使用 setup 函数初始化。它负责模型训练前所需的全部数据准备工作。除了执行一些默认的基础处理任务外,PyCaret 还提供了丰富的预处理功能。要了解 PyCaret 中所有预处理功能,请点击此处。
# 初始化 setup
from pycaret.regression import *
s = setup(data, target = 'Price', transform_target = True, log_experiment = True, experiment_name = 'diamond')
技术支持
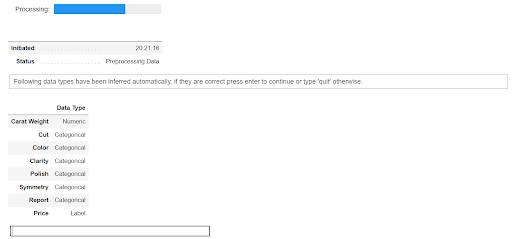
当您在 PyCaret 中初始化 setup 函数时,它会分析数据集并推断所有输入特征的数据类型。如果数据类型均被正确识别,按回车继续。也可以通过参数覆盖 PyCaret 中的数据类型。此外,如果您在 Python 脚本中使用 PyCaret,可在 setup 中传入 silent = True 以静默此确认步骤。
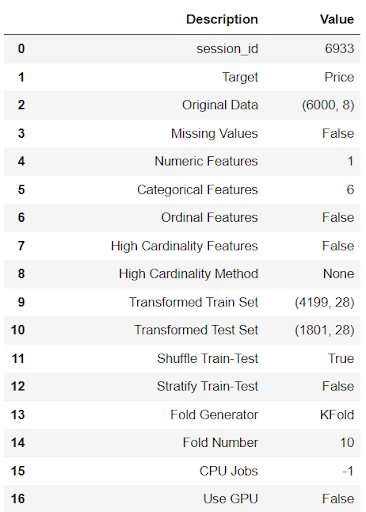 (setup 输出 — 为展示起见已截断)
ML 模型训练与选择
完成 setup 后,变换后的数据即可用于模型训练。您可以使用 compare_models 函数开始训练过程。它会训练模型库中的所有算法,并通过 k 折交叉验证评估多个性能指标。
# 比较所有模型
best = compare_models()
技术支持
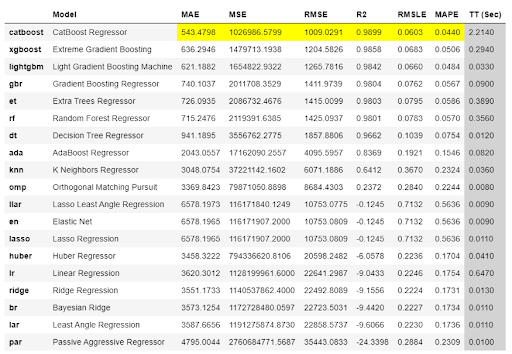 (compare_models 输出)
compare_models 的输出展示了所有模型的交叉验证指标均值。默认按 “R2”(从高到低)排序,也可通过在 compare_models 中传入 sort 参数进行更改。
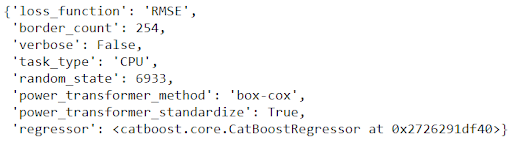
compare_models 完成后会返回最佳模型(此例为 CatBoost Regressor)。默认仅返回最佳模型,但可通过 n_select 参数更改。例如在 compare_models 中传入 n_select = 3 将返回前三个模型的列表。
# 查看最佳模型的最终参数
best.get_params()
技术支持
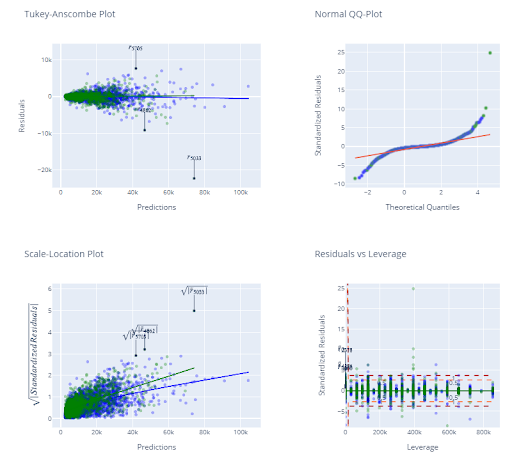
我们也可以使用 plot_model 函数查看诊断信息和其他分析图。
# 查看已训练模型的残差
plot_model(best, plot = 'residuals_interactive')
技术支持
plot_model(best, plot = ‘feature’)
技术支持
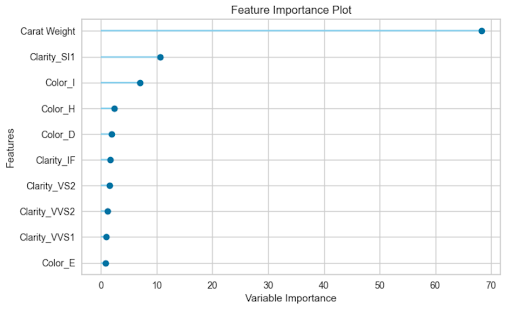
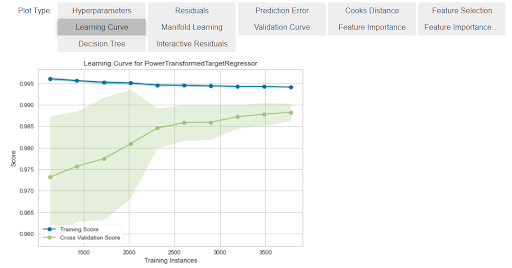
还有一个名为 evaluate_model 的函数,可在 Jupyter Notebook 中便捷地浏览所有可用的分析图。
evaluate_model(best)
技术支持
ML 模型的部署与监控
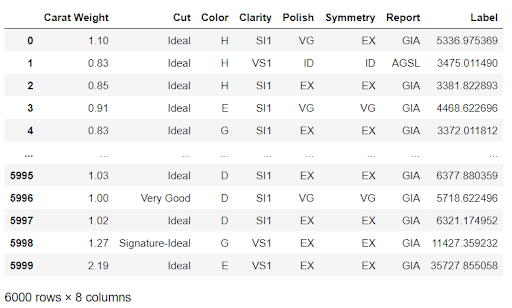
现在我们可以使用最终模型,通过 predict_model 函数对未见数据生成预测:
# 复制数据并移除目标变量
data_unseen = data.copy()
data_unseen.drop(‘Price’, axis = 1, inplace = True)
predictions = predict_model(best, data = data_unseen)
技术支持
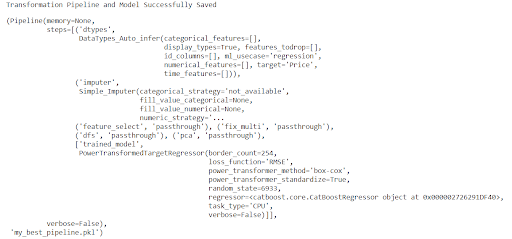
为了日后使用,您可以使用 save_model 函数保存整个流水线。
save_model(best, ‘my_best_pipeline’)
技术支持
实验记录
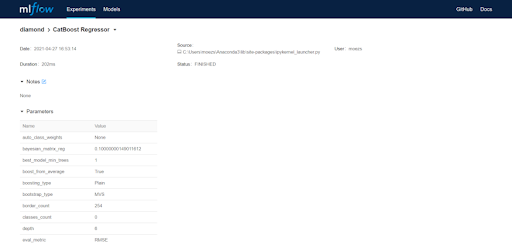
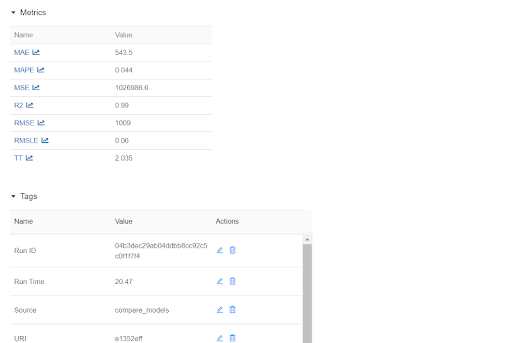
还记得我们在 setup 函数中传入了 log_experiment = True 和 experiment_name = 'diamond' 吗?来看一下 PyCaret 在幕后做了什么。要见证“魔法”,先启动 MLflow 服务器:
# 在 notebook 中
!mlflow ui

# 在命令行中
mlflow ui
技术支持
现在打开浏览器,输入 “localhost:5000”。您会看到如下界面:
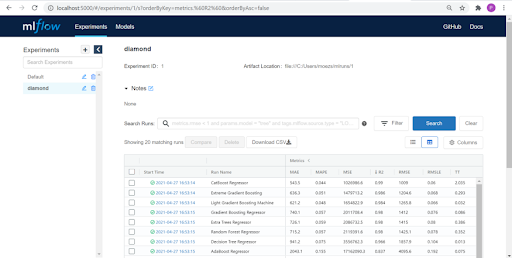
上表中的每一条目代表一次训练运行,产出一个已训练的流水线和一系列元数据,如运行时间、性能指标、模型超参数、标签等。我们点开其中一个模型:
PyCaret 时间序列预测
PyCaret 的新时间序列模块现已提供测试版。延续 PyCaret 的简洁理念,它与现有 API 保持一致,并集成功能齐全:统计检验、模型训练与选择(30+ 算法)、模型分析、自动超参数调优、实验记录、云端部署等。以上所有功能,同样只需少量代码(与 PyCaret 其他模块一致)。如果要使用此测试版新模块,建议在单独的 conda 环境中安装以避免依赖冲突。
pip install pycaret-ts-alpha技术支持
时间序列数据是最常见的数据类型之一,掌握其处理方法是进行预测与趋势报告的关键数据科学技能。如果您想进一步学习 Python 中的时间序列分析与预测,DataCamp 提供了优质的课程合集。您可以从Time Series with Python 学习路径开始,或选择以下课程之一:
PyCaret 集成
PyCaret 常见问答
-
PyCaret 目前是否仅支持 Python?是的,PyCaret 目前仅支持 Python。
-
PyCaret 与 scikit-learn、XGBoost、LightGBM 等其他开源机器学习库有何不同?与其他开源机器学习库相比,PyCaret 是一种替代性的低代码库,能用极少的代码替代上百行实现。本质上,PyCaret 是对多种机器学习库与框架(如 scikit-learn、XGBoost、LightGBM、CatBoost、spaCy、Optuna、Hyperopt、Ray 等)的 Python 封装。
-
PyCaret 支持哪些用例?截至 2.3.4 版本,PyCaret 支持二分类/多分类、回归、聚类、异常检测、自然语言处理(主题建模)和关联规则挖掘。PyCaret 还将其新的时间序列模块以测试版形式作为单独的pip 安装包发布。
-
可以在 GPU 上使用 PyCaret 吗?可以。您可以在 PyCaret 中使用 GPU 训练模型,将工作流提速 10 倍。只需在 setup 函数中传入 use_gpu = True。API 的使用方式无需更改,但在某些情况下,可能需要另行安装部分未包含在默认或完整版本中的额外库。
-
能在 PyCaret 中调优模型超参数吗?可以。您可以在 PyCaret 中自动调优任意模型的超参数。它与 sklearn、optuna、tune-sklearn 和 ray 集成,可进行不同的调优(如随机网格搜索或贝叶斯网格搜索)。
-
PyCaret 是否免费?PyCaret 完全免费且开源,使用 MIT 许可协议。
| PyCaret 资源 | ---- |
|---|
| ⭐ 教程 | 初次接触 PyCaret?请查看官方笔记本! |
| 📋 笔记本 | 社区创建的示例笔记本。 |
| 📙 博客 | 贡献者撰写的教程与文章。 |
| 📚 文档 | PyCaret 的详细 API 文档 |
| 📺 视频教程 | 我们在各类活动中的视频教程。 |
| 📢 讨论 | 有问题?欢迎与社区和贡献者交流。 |
| 🛠️ <atarget="_blank" href="https://github.com/pycaret/pycaret/blob/master/CHANGELOG.md">更新日志 | 变更与版本历史。 |
| 🌳 路线图 | PyCaret 的软件与社区发展规划。 |


什么是 PyCaret
注意:本教程创建于 2021 年,PyCaret 目前已不再积极维护;某些步骤可能无法在当前版本的 DataLab 或其他工具中正常运行。
PyCaret 是一个开源、低代码的 Python 机器学习库,可用于自动化机器学习工作流。它是一个端到端的机器学习与模型管理工具,能够以指数级速度缩短实验周期,让您更高效。
与其他开源机器学习库相比,PyCaret 是一种替代性的低代码库,能将上百行代码浓缩为寥寥数行,从而使实验更快、更高效。本质上,PyCaret 是对多种机器学习库与框架的 Python 封装,如 scikit-learn、XGBoost、LightGBM、CatBoost、spaCy、Optuna、Hyperopt、Ray 等。
PyCaret 的设计与简洁性灵感源自 Gartner 首次提出的“公民数据科学家”这一新兴角色。公民数据科学家是能够完成此前需要更多技术专长才能进行的简单到中等复杂分析任务的高级用户。
PyCaret 简单易用。在 PyCaret 中执行的所有操作都会按顺序存储在一个可直接用于部署的流水线中。无论是缺失值填补、类别数据转换、特征工程,还是超参数调优,PyCaret 都能自动完成。想进一步了解 PyCaret,请观看这段一分钟视频。
PyCaret 的模块
PyCaret 的 API 采用模块化设计。每个模块支持一种监督学习(分类和回归)或非监督学习(聚类、异常检测、NLP、关联规则挖掘)。用于时间序列预测的新模块近期以测试版形式单独发布为一个pip 包。
安装 PyCaret
通过 pip 安装 PyCaret 非常简单,只需几分钟。PyCaret 的默认安装仅安装在 requirements.txt 文件(仓库中)列出的硬依赖。
注意:本教程创建于 2021 年,PyCaret 目前已不再积极维护;某些步骤可能无法在当前版本的 DataLab 或其他工具中正常运行。
要安装完整版本:
功能特性
PyCaret 的最大卖点是其简洁性。与其他自动化机器学习软件相比,PyCaret 十分灵活,提供统一的 API,且几乎没有学习成本。
PyCaret 功能丰富。您可以用几行代码就完成从数据处理到模型训练再到云端部署的全流程。它在初始化实验时会自动应用大量预处理变换。PyCaret 的模型库包含 70 多个可用于监督与非监督任务的未训练模型。
您还可以在 GPU 上使用 PyCaret,将工作流提速 10 倍。要在 GPU 上训练模型,只需在 setup 函数中传入 use_gpu = True,代码完全不需要改动。
PyCaret 是一个“玻璃盒”方案。它提供大量功能用于与模型交互并分析性能和结果。所有标准图形(如混淆矩阵、AUC、残差、特征重要性)对所有模型均可用。它还集成了用于解释任意复杂树模型输出的 SHAP 库。
PyCaret 还与 MLflow 集成以提供 MLOps 功能。当您在 setup 函数中传入 log_experiment = True 时,会自动记录指标、参数和制品。
PyCaret 中的预处理
所有预处理变换都在 setup 函数中完成。PyCaret 在 setup 中提供了 25 种以上的预处理变换。要了解更多关于 PyCaret 预处理能力的信息,请点击这里。
PyCaret 的模块
示例:端到端 ML 用例
这是一条典型的机器学习工作流。在任何机器学习项目中,正确界定问题是第一步,做好这一步可能需要几天到数周时间。
数据获取与 ETL(抽取-转换-加载)的复杂度也会因组织的技术成熟度与规模而异。在这一阶段,通常会有数据工程团队协作完成。
探索性数据分析(EDA)阶段包括对原始数据进行探索,以评估数据质量(缺失值、离群点等)、特征相关性,并验证业务假设。
对于数据准备、模型训练与选择,PyCaret 会在幕后完成繁重工作。数据准备包括缺失值填补、缩放(min-max、z-score 等)、类别编码(独热编码、序数编码等)、特征工程(多项式、特征交互、比率等)与特征选择等变换。
数据准备完成后,模型训练与选择阶段会拟合多种算法,并通过某种测试策略(多为交叉验证)评估性能。
最后,将选定的最佳模型部署为用于推断的 API 端点。部署完成后,对 API 的监控以及对生产环境中模型性能的跟踪将长期持续。
问题描述
根据切工、颜色、形状等属性预测钻石价格。
数据获取
探索性数据分析(EDA)
我们快速做一些可视化,评估自变量(重量、切工、颜色、净度等)与目标变量 Price 的关系:
来看一下目标变量 Price 的直方图。
# 绘制直方图 fig = px.histogram(data, x=["Price"]) fig.show()注意到 Price 的分布右偏,我们可以快速检查一下对数变换是否能改变目标变量的分布(形状)。
# 绘制直方图 data['logged_Price'] = np.log(data['Price']) fig = px.histogram(data, x=["logged_Price"]) fig.show()数据清洗与准备
在 PyCaret 中,所有实验都必须使用 setup 函数初始化。它负责模型训练前所需的全部数据准备工作。除了执行一些默认的基础处理任务外,PyCaret 还提供了丰富的预处理功能。要了解 PyCaret 中所有预处理功能,请点击此处。
当您在 PyCaret 中初始化 setup 函数时,它会分析数据集并推断所有输入特征的数据类型。如果数据类型均被正确识别,按回车继续。也可以通过参数覆盖 PyCaret 中的数据类型。此外,如果您在 Python 脚本中使用 PyCaret,可在 setup 中传入 silent = True 以静默此确认步骤。
ML 模型训练与选择
完成 setup 后,变换后的数据即可用于模型训练。您可以使用 compare_models 函数开始训练过程。它会训练模型库中的所有算法,并通过 k 折交叉验证评估多个性能指标。
compare_models 的输出展示了所有模型的交叉验证指标均值。默认按 “R2”(从高到低)排序,也可通过在 compare_models 中传入 sort 参数进行更改。
compare_models 完成后会返回最佳模型(此例为 CatBoost Regressor)。默认仅返回最佳模型,但可通过 n_select 参数更改。例如在 compare_models 中传入 n_select = 3 将返回前三个模型的列表。
我们也可以使用 plot_model 函数查看诊断信息和其他分析图。
还有一个名为 evaluate_model 的函数,可在 Jupyter Notebook 中便捷地浏览所有可用的分析图。
ML 模型的部署与监控
现在我们可以使用最终模型,通过
predict_model函数对未见数据生成预测:为了日后使用,您可以使用 save_model 函数保存整个流水线。
实验记录
还记得我们在 setup 函数中传入了 log_experiment = True 和 experiment_name = 'diamond' 吗?来看一下 PyCaret 在幕后做了什么。要见证“魔法”,先启动 MLflow 服务器:
现在打开浏览器,输入 “localhost:5000”。您会看到如下界面:
上表中的每一条目代表一次训练运行,产出一个已训练的流水线和一系列元数据,如运行时间、性能指标、模型超参数、标签等。我们点开其中一个模型:
PyCaret 时间序列预测
PyCaret 的新时间序列模块现已提供测试版。延续 PyCaret 的简洁理念,它与现有 API 保持一致,并集成功能齐全:统计检验、模型训练与选择(30+ 算法)、模型分析、自动超参数调优、实验记录、云端部署等。以上所有功能,同样只需少量代码(与 PyCaret 其他模块一致)。如果要使用此测试版新模块,建议在单独的 conda 环境中安装以避免依赖冲突。
时间序列数据是最常见的数据类型之一,掌握其处理方法是进行预测与趋势报告的关键数据科学技能。如果您想进一步学习 Python 中的时间序列分析与预测,DataCamp 提供了优质的课程合集。您可以从Time Series with Python 学习路径开始,或选择以下课程之一:
PyCaret 集成
PyCaret 常见问答
PyCaret 目前是否仅支持 Python?是的,PyCaret 目前仅支持 Python。
PyCaret 与 scikit-learn、XGBoost、LightGBM 等其他开源机器学习库有何不同?与其他开源机器学习库相比,PyCaret 是一种替代性的低代码库,能用极少的代码替代上百行实现。本质上,PyCaret 是对多种机器学习库与框架(如 scikit-learn、XGBoost、LightGBM、CatBoost、spaCy、Optuna、Hyperopt、Ray 等)的 Python 封装。
PyCaret 支持哪些用例?截至 2.3.4 版本,PyCaret 支持二分类/多分类、回归、聚类、异常检测、自然语言处理(主题建模)和关联规则挖掘。PyCaret 还将其新的时间序列模块以测试版形式作为单独的pip 安装包发布。
可以在 GPU 上使用 PyCaret 吗?可以。您可以在 PyCaret 中使用 GPU 训练模型,将工作流提速 10 倍。只需在 setup 函数中传入 use_gpu = True。API 的使用方式无需更改,但在某些情况下,可能需要另行安装部分未包含在默认或完整版本中的额外库。
能在 PyCaret 中调优模型超参数吗?可以。您可以在 PyCaret 中自动调优任意模型的超参数。它与 sklearn、optuna、tune-sklearn 和 ray 集成,可进行不同的调优(如随机网格搜索或贝叶斯网格搜索)。
PyCaret 是否免费?PyCaret 完全免费且开源,使用 MIT 许可协议。