¿Qué es PyCaret?
Nota: este tutorial se creó en 2021 y PyCaret ya no se mantiene activamente; es posible que algunos pasos no funcionen con las versiones actuales de DataLab u otras herramientas.
PyCaret es una biblioteca de machine learning de código abierto y bajo código en Python que automatiza los flujos de trabajo de aprendizaje automático. Es una herramienta de extremo a extremo para machine learning y gestión de modelos que acelera exponencialmente el ciclo de experimentación y te hace más productivo.
En comparación con otras bibliotecas open source de machine learning, PyCaret es una alternativa low-code capaz de sustituir cientos de líneas de código por solo unas pocas. Esto hace que los experimentos sean muchísimo más rápidos y eficientes. En esencia, PyCaret es un contenedor en Python que reúne varias bibliotecas y frameworks de machine learning como scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray, entre otras.
El diseño y la sencillez de PyCaret se inspiran en el papel emergente de los citizen data scientists, un término acuñado por Gartner. Los citizen data scientists son usuarios avanzados capaces de realizar tanto tareas analíticas sencillas como de complejidad media que antes requerían más experiencia técnica.
PyCaret es simple y fácil de usar. Todas las operaciones que se ejecutan en PyCaret se almacenan secuencialmente en un pipeline totalmente orquestado para su despliegue. Ya sea imputar valores faltantes, transformar datos categóricos, hacer ingeniería de características o incluso ajustar hiperparámetros, PyCaret lo automatiza todo. Para saber más sobre PyCaret, mira este vídeo de un minuto.
Módulos en PyCaret
La API de PyCaret está organizada en módulos. Cada módulo admite un tipo de aprendizaje supervisado (clasificación y regresión) o no supervisado (clustering, detección de anomalías, nlp, minería de reglas de asociación). Recientemente se lanzó en beta un nuevo módulo de predicción de series temporales como un paquete de pip independiente.
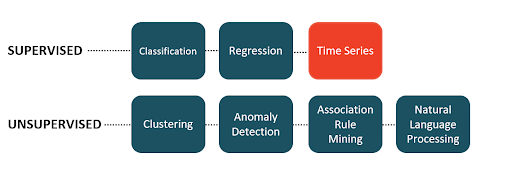 Fuente de la imagen: [Ali, Moez].
Instalar PyCaret
Instalar PyCaret con pip es muy sencillo y solo te llevará unos minutos. La instalación por defecto de PyCaret incluye únicamente las dependencias estrictamente necesarias tal como figuran en el archivo requirements.txt del repositorio.
Nota: este tutorial se creó en 2021 y PyCaret ya no se mantiene activamente; es posible que algunos pasos no funcionen con las versiones actuales de DataLab u otras herramientas.
pip install pycaret
Para instalar la versión completa:
pip install pycaret[full]
Funciones
La gran baza de PyCaret es su sencillez. Frente a otros softwares de AutoML, PyCaret es extremadamente flexible, ofrece una API unificada y prácticamente no tiene curva de aprendizaje.
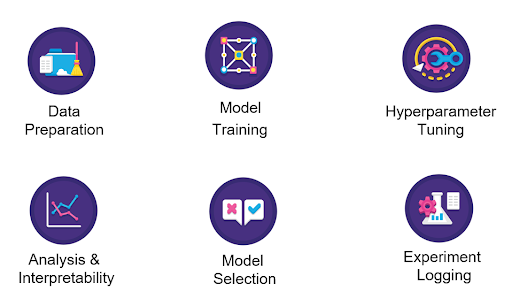
PyCaret viene cargado de funcionalidades. Puedes pasar del procesamiento de datos al entrenamiento de modelos y su despliegue en la nube con solo unas pocas líneas de código. Incluye numerosas transformaciones de preprocesado que se aplican automáticamente al iniciar el experimento. El zoo de modelos de PyCaret cuenta con más de 70 modelos sin entrenar para tareas supervisadas y no supervisadas.
También puedes usar PyCaret en GPU y acelerar tu flujo de trabajo hasta 10 veces. Para entrenar modelos en GPU, basta con pasar use_gpu = True en la función setup. No hay que cambiar nada más del código.
PyCaret es una solución de caja transparente. Incluye un montón de utilidades para interactuar con el modelo y analizar su rendimiento y resultados. Todos los gráficos estándar, como la matriz de confusión, el AUC, los residuales y la importancia de variables, están disponibles para todos los modelos. Además, se integra con la biblioteca SHAP, que se utiliza para explicar la salida de modelos complejos basados en árboles.
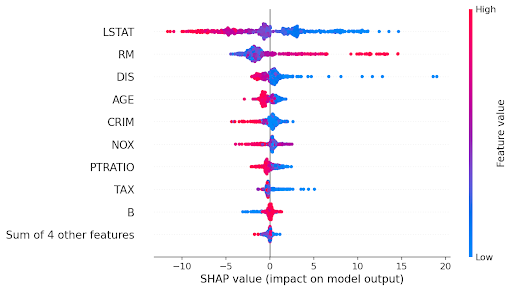 (Ejemplo de gráfico beeswarm)
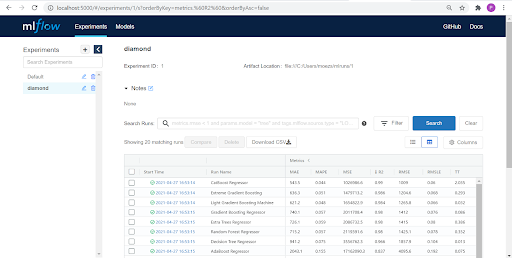
PyCaret también se integra con MLflow para capacidades de MLOps. Registra automáticamente métricas, parámetros y artefactos cuando pasas log_experiment = True en la función setup.
 (Imagen del autor)
Preprocesado en PyCaret
Todas las transformaciones de preprocesado se aplican dentro de la función setup. PyCaret ofrece más de 25 transformaciones de preprocesado distintas que se definen en la propia función setup. Haz clic aquí para saber más sobre las capacidades de preprocesado de PyCaret.
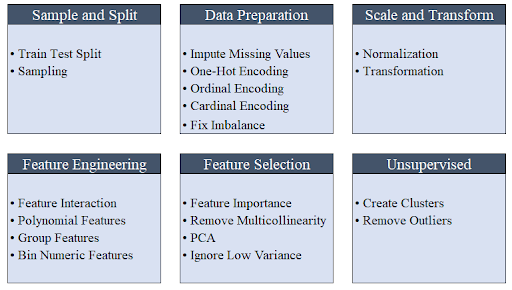 (Imagen del autor)
Módulos en PyCaret
| Módulo | Tarea |
|---|---|
| pycaret.classification | Supervisado: clasificación binaria o multiclase |
| pycaret.regression | Supervisado: regresión |
| pycaret.clustering | No supervisado: clustering |
| pycaret.anomaly | No supervisado: detección de anomalías |
| pycaret.nlp | No supervisado: procesamiento de lenguaje natural (modelado de temas) |
| pycaret.arules | No supervisado: minería de reglas de asociación |
| pycaret.datasets | Conjuntos de datos |
Ejemplo: un caso de uso de ML de extremo a extremo
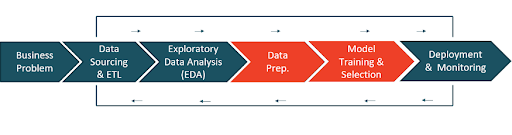
Este es un flujo de trabajo típico de machine learning. Plantear correctamente el problema de ML es el primer paso de cualquier proyecto y puede llevar desde unos días hasta semanas.
La obtención de datos y el ETL (Extract-Transform-Load) también varían en complejidad según la madurez tecnológica y el tamaño de la organización. Es normal ver a un equipo de ingenieros de datos trabajando conjuntamente en esta fase.
La fase de análisis exploratorio de datos (EDA) consiste en explorar los datos en bruto para evaluar su calidad (valores ausentes, outliers, etc.), la correlación entre variables y contrastar hipótesis de negocio.
Para la preparación de datos y el entrenamiento y selección de modelos, PyCaret se encarga del trabajo pesado por debajo. La preparación incluye transformaciones como imputación de valores faltantes, escalado (min-max, z-score, etc.), codificación categórica (one-hot encoding, codificación ordinal, etc.), ingeniería de características (polinomiales, interacción de variables, ratios, etc.) y selección de variables.
Tras preparar los datos, la fase de entrenamiento y selección implica ajustar múltiples algoritmos y evaluar su rendimiento con alguna estrategia de validación (normalmente validación cruzada).
Por último, el modelo elegido (el mejor) se despliega como un endpoint de API para inferencia. Una vez desplegado, el seguimiento de la API y del rendimiento del modelo en producción es continuo.
 (Imagen del autor)
Planteamiento del problema
Predecir el precio de un diamante a partir de atributos como corte, color, forma, etc.
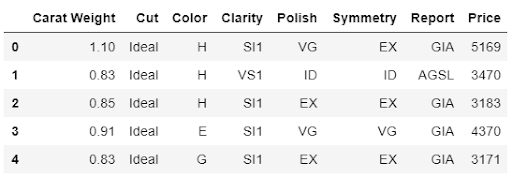
Obtención de datos
# cargar el conjunto de datos desde pycaret
from pycaret.datasets import get_data
data = get_data('diamond')
Análisis exploratorio de datos (EDA)
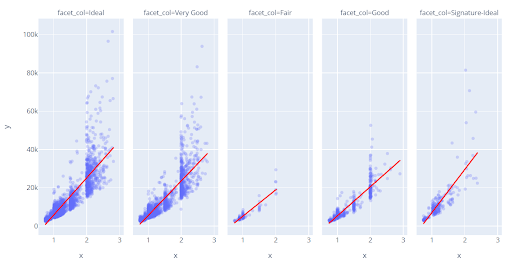
Hagamos unas visualizaciones rápidas para evaluar la relación de las variables independientes (peso, corte, color, claridad, etc.) con la variable objetivo, es decir, Price:
# diagrama de dispersión de carat_weight y Price
import plotly.express as px
fig = px.scatter(x=data['Carat Weight'], y=data['Price'], facet_col = data['Cut'], opacity = 0.25, trendline='ols', trendline_color_override = 'red')
fig.show()
Veamos el histograma de la variable objetivo Price.
# trazar histograma
fig = px.histogram(data, x=["Price"])
fig.show()
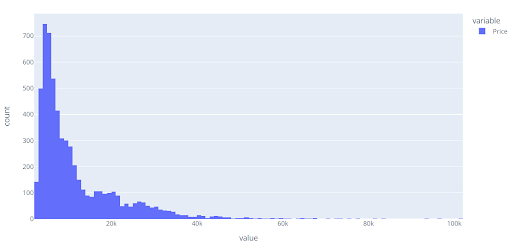
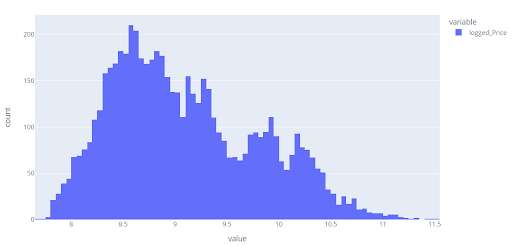
Observa que la distribución de Price está sesgada a la derecha; podemos comprobar rápidamente si una transformación logarítmica cambia la forma de la distribución de la variable objetivo.
# trazar histograma
data['logged_Price'] = np.log(data['Price'])
fig = px.histogram(data, x=["logged_Price"])
fig.show()
Limpieza y preparación de datos
Todos los experimentos en PyCaret deben inicializarse con la función setup. Es la responsable de todas las tareas de preparación de datos previas al entrenamiento. Además de realizar algunas tareas básicas por defecto, PyCaret ofrece una amplia gama de opciones de preprocesado. Haz clic aquí para conocer todas las funcionalidades de preprocesado de PyCaret.
# inicializar setup
from pycaret.regression import *
s = setup(data, target = 'Price', transform_target = True, log_experiment = True, experiment_name = 'diamond')
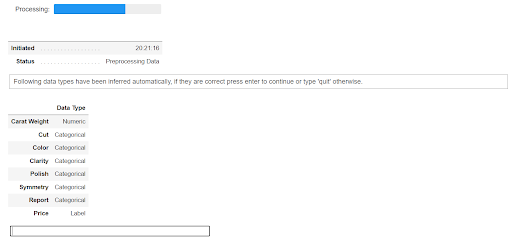
Al inicializar la función setup en PyCaret, este perfila el conjunto de datos e infiere los tipos de datos de todas las variables de entrada. Si todo es correcto, puedes pulsar Intro para continuar. También hay un parámetro para sobrescribir tipos de datos en PyCaret si lo necesitas. Además, si usas PyCaret en un script de Python, puedes omitir esta confirmación pasando silent = True en la función setup.
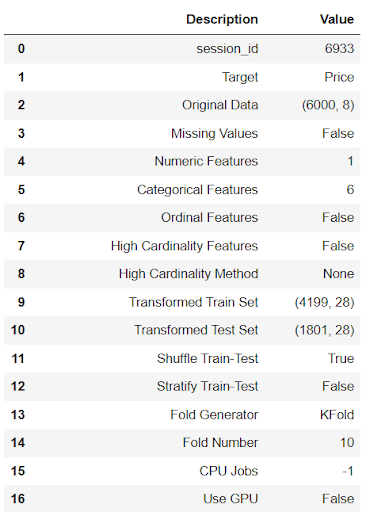 (Salida de setup — truncada para mostrar)
Entrenamiento y selección de modelos de ML
Tras el setup, los datos transformados quedan listos para entrenar modelos. Puedes iniciar el entrenamiento con la función compare_models. Entrenará todos los algoritmos disponibles en el zoo de modelos y evaluará múltiples métricas de rendimiento usando validación cruzada k-fold.
# comparar todos los modelos
best = compare_models()
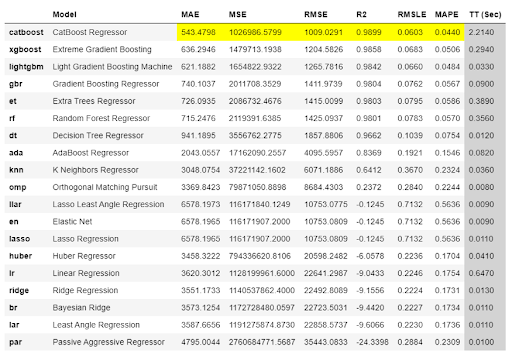 (Salida de compare_models)
La salida de compare_models muestra las métricas validadas cruzadamente y promediadas para todos los modelos. Por defecto, la tabla se ordena por "R2" (de mayor a menor), aunque puedes cambiarlo con el parámetro sort en compare_models.
El mejor modelo (en este caso, CatBoost Regressor) se devuelve al finalizar compare_models. Por defecto solo se devuelve el mejor, pero puedes modificarlo con el parámetro n_select. Por ejemplo, si pasas n_select = 3 en compare_models, obtendrás una lista con los 3 mejores modelos.
# consultar los parámetros finales del mejor modelo
best.get_params()
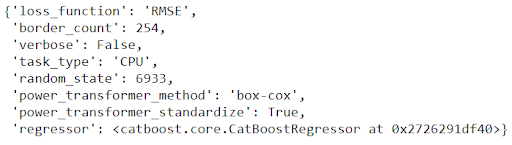
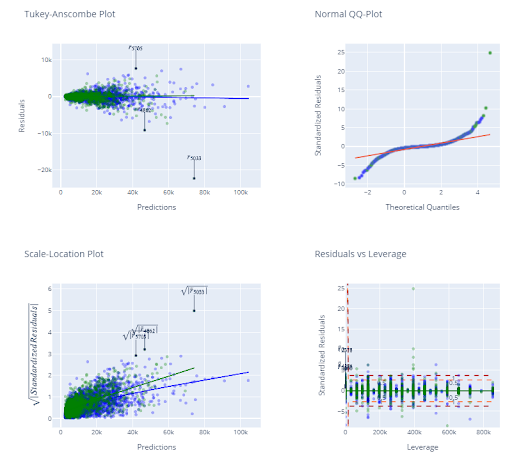
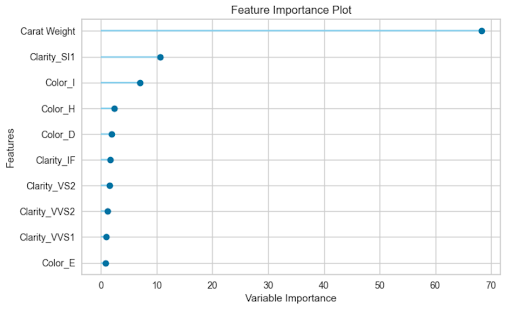
También podemos revisar diagnósticos y otros gráficos de análisis con la función plot_model.
# revisar los residuales del modelo entrenado
plot_model(best, plot = 'residuals_interactive')
plot_model(best, plot = ‘feature’)
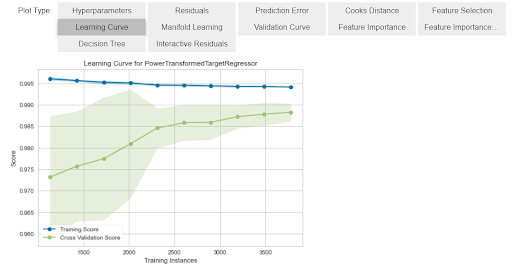
Hay otra función llamada evaluate_model, muy práctica para navegar por todos los gráficos de análisis disponibles en Jupyter Notebook.
evaluate_model(best)
Despliegue y monitorización del modelo de ML
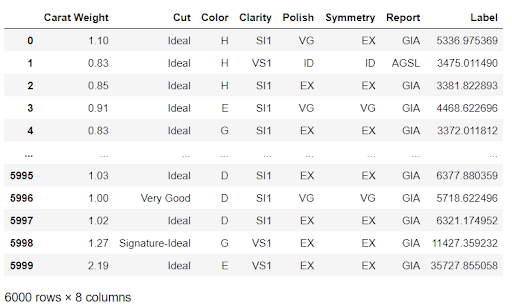
Ahora podemos usar el modelo final para generar predicciones sobre datos no vistos con la función predict_model:
# copiar datos y eliminar la variable objetivo
data_unseen = data.copy()
data_unseen.drop(‘Price’, axis = 1, inplace = True)
predictions = predict_model(best, data = data_unseen)
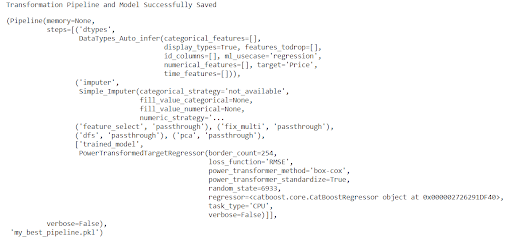
Para uso futuro, puedes guardar todo el pipeline con la función save_model.
save_model(best, ‘my_best_pipeline’)
Registro de experimentos
Recuerda que pasamos log_experiment = True en la función setup junto con experiment_name = 'diamond'. Veamos qué ha hecho PyCaret entre bambalinas. Para ver la magia, iniciemos el servidor de MLflow:
# dentro del notebook
!mlflow ui

# desde la línea de comandos
mlflow ui
Ahora abre tu navegador y escribe "localhost:5000". Se abrirá una interfaz como esta:
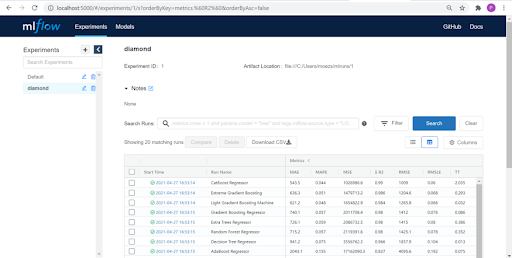
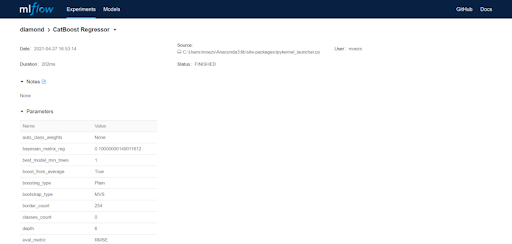
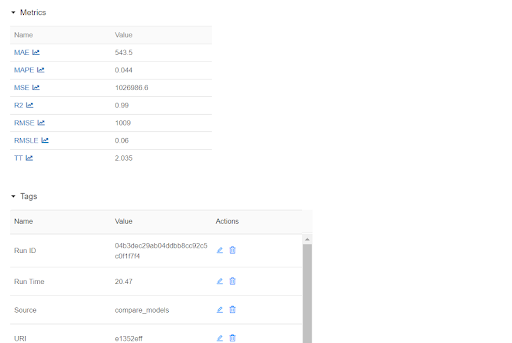
Cada entrada de la tabla representa una ejecución de entrenamiento que genera un pipeline entrenado y metadatos como la fecha y hora de la ejecución, métricas de rendimiento, hiperparámetros del modelo, etiquetas, etc. Haz clic en uno de los modelos:
Predicción de series temporales con PyCaret
El nuevo módulo de series temporales de PyCaret ya está disponible en beta. Fiel a la simplicidad de PyCaret, es coherente con la API existente y viene cargado de funcionalidades: pruebas estadísticas, entrenamiento y selección de modelos (30+ algoritmos), análisis de modelos, ajuste automático de hiperparámetros, registro de experimentos, despliegue en la nube y más. Todo esto con solo unas pocas líneas de código (igual que el resto de módulos de PyCaret). Si quieres usar este nuevo módulo en beta, debes instalarlo en un entorno conda separado para evitar conflictos de dependencias.
pip install pycaret-ts-alphaLos datos de series temporales son uno de los tipos más comunes y saber trabajar con ellos es una habilidad clave en ciencia de datos si quieres hacer predicciones e informar sobre tendencias. Si te interesa aprender más sobre análisis y predicción de series temporales en Python, DataCamp tiene una excelente colección de cursos. Puedes empezar con el itinerario de aprendizaje Time Series with Python o elegir cualquiera de estos cursos:
- Introduction to Time Series Analysis in Python
- Machine Learning for Time Series Data in Python
- Time Series Analysis Tutorial
Integraciones de PyCaret
| Área | Integraciones |
|---|---|
| Modelos | scikit-learn, XGBoost, LightGBM, CatBoost |
| Entrenamiento en GPU | RAPIDS.AI |
| Computación distribuida | RAY |
| Ajuste de hiperparámetros | tune-sklearn, optuna |
| Gráficos y análisis | plotly, yellowbrick, seaborn, matplotlib |
| NLP | gensim, spacy, nltk |
| MLOps | MLflow |
Preguntas frecuentes sobre PyCaret
-
¿PyCaret solo está disponible en Python? Sí, por ahora PyCaret solo está disponible en Python.
-
¿En qué se diferencia PyCaret de otras bibliotecas open source como scikit-learn, XGBoost o LightGBM? Frente a otras bibliotecas de código abierto, PyCaret es una alternativa low-code que puede sustituir cientos de líneas de código por unas pocas. En esencia, PyCaret es un contenedor en Python que integra varias bibliotecas y frameworks de machine learning como scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray, entre otras.
-
¿Qué casos de uso admite PyCaret? Desde la versión 2.3.4, PyCaret admite clasificación binaria/multiclase, regresión, clustering, detección de anomalías, procesamiento de lenguaje natural (modelado de temas) y minería de reglas de asociación. PyCaret también ha lanzado recientemente su nuevo módulo de series temporales en beta como un instalador de pip independiente.
-
¿Podemos usar PyCaret en la GPU? Sí. Puedes entrenar modelos en GPU con PyCaret y acelerar tu flujo de trabajo hasta 10 veces. Para entrenar en GPU, simplemente pasa use_gpu = True en la función setup. No cambia el uso de la API; sin embargo, en algunos casos tendrás que instalar bibliotecas adicionales que no vienen con la versión por defecto ni con la completa.
-
¿Se pueden ajustar los hiperparámetros de los modelos en PyCaret? Sí. Puedes ajustar automáticamente los hiperparámetros de cualquier modelo en PyCaret. Se integra con sklearn, optuna, tune-sklearn y ray para distintos métodos de ajuste como búsqueda aleatoria en rejilla o búsqueda bayesiana.
-
¿PyCaret es gratuito? PyCaret es completamente gratuito y de código abierto, con licencia MIT.
| Recursos de PyCaret | ---- |
|---|---|
| ⭐ Tutoriales | ¿Nuevo en PyCaret? Échale un vistazo a los notebooks oficiales. |
| 📋 Notebooks | Notebooks de ejemplo creados por la comunidad. |
| 📙 Blog | Tutoriales y artículos de colaboradores. |
| 📚 Documentación | La documentación detallada de la API de PyCaret. |
| 📺 Tutoriales en vídeo | Nuestros tutoriales en vídeo de distintos eventos. |
| 📢 Debates | ¿Tienes preguntas? Participa con la comunidad y los contribuidores. |
| 🛠️ <atarget="_blank" href="https://github.com/pycaret/pycaret/blob/master/CHANGELOG.md">Changelog | Cambios e historial de versiones. |
| 🌳 Hoja de ruta | El plan de desarrollo del software y la comunidad de PyCaret. |