Was ist PyCaret
Hinweis: Dieses Tutorial wurde 2021 erstellt und PyCaret wird nicht mehr aktiv gepflegt; einige Schritte funktionieren möglicherweise nicht mehr mit aktuellen Versionen von DataLab oder anderen Tools.
PyCaret ist eine Open-Source-ML-Bibliothek in Python mit Low-Code-Ansatz, die Machine-Learning-Workflows automatisiert. Es ist ein End-to-End-Tool für Machine Learning und Modellmanagement, das den Experimentzyklus exponentiell beschleunigt und dich produktiver macht.
Im Vergleich zu anderen Open-Source-ML-Bibliotheken ist PyCaret eine Low-Code-Alternative, die Hunderte Zeilen Code durch wenige Befehle ersetzt. Experimente werden damit um ein Vielfaches schneller und effizienter. PyCaret ist im Kern ein Python-Wrapper um mehrere ML-Bibliotheken und -Frameworks wie scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray und einige mehr.
Design und Einfachheit von PyCaret sind vom aufkommenden Rollenbild der Citizen Data Scientists inspiriert, ein Begriff, der erstmals von Gartner geprägt wurde. Citizen Data Scientists sind Power-User, die einfache bis mittelkomplexe Analysen durchführen können, für die früher deutlich mehr technisches Know-how nötig war.
PyCaret ist leicht zu erlernen und unkompliziert in der Anwendung. Alle Schritte werden in einer Pipeline gespeichert, die vollständig auf Deployment ausgerichtet ist. Ob fehlende Werte imputieren, kategoriale Daten transformieren, Feature Engineering oder Hyperparameter-Tuning – PyCaret automatisiert alles. Mehr über PyCaret erfährst du in diesem einminütigen Video.
Module in PyCaret
Die API von PyCaret ist modular aufgebaut. Jedes Modul unterstützt entweder überwachtes Lernen (Classification und Regression) oder unüberwachtes Lernen (Clustering, Anomalieerkennung, NLP, Association Rules Mining). Ein neues Modul für Zeitreihenprognosen wurde kürzlich als Beta in einem separaten pip-Paket veröffentlicht.
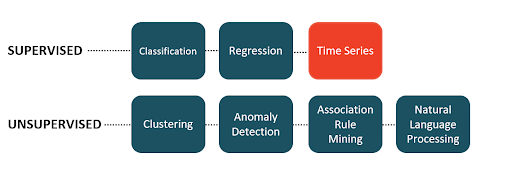 Image source: [Ali, Moez].
PyCaret installieren
Die Installation von PyCaret ist über pip einfach und dauert nur wenige Minuten. Die Standardinstallation von PyCaret installiert nur Hard-Dependencies, wie in der Datei requirements.txt im Repository aufgeführt.
Hinweis: Dieses Tutorial wurde 2021 erstellt und PyCaret wird nicht mehr aktiv gepflegt; einige Schritte funktionieren möglicherweise nicht mehr mit aktuellen Versionen von DataLab oder anderen Tools.
pip install pycaret
So installierst du die Vollversion:
pip install pycaret[full]
Funktionen
PyCarets großer Vorteil ist seine Einfachheit. Im Vergleich zu anderen AutoML-Tools ist PyCaret extrem flexibel, bietet eine einheitliche API und hat praktisch keine Lernkurve.
PyCaret bringt eine Fülle an Funktionen mit. Von der Datenaufbereitung über das Training bis zum Deployment in die Cloud – alles mit wenigen Zeilen Code. Viele Preprocessing-Transformationen werden automatisch angewendet, sobald das Experiment initialisiert wird. Der Model-Zoo von PyCaret umfasst über 70 untrainierte Modelle für überwachte und unüberwachte Aufgaben.
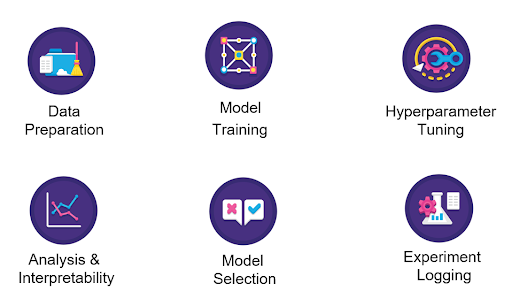
Du kannst PyCaret auch auf der GPU nutzen und deinen Workflow um den Faktor 10 beschleunigen. Um Modelle auf der GPU zu trainieren, übergib einfach use_gpu = True in der setup-Funktion. Am Code selbst musst du nichts ändern.
PyCaret ist eine Glass-Box-Lösung. Es enthält umfangreiche Möglichkeiten, mit dem Modell zu interagieren und Leistung sowie Ergebnisse zu analysieren. Alle Standardplots wie Confusion-Matrix, AUC, Residuen und Feature-Importance stehen für alle Modelle bereit. Außerdem gibt es eine Integration mit der SHAP-Bibliothek, um die Ergebnisse komplexer, baumbasierter ML-Modelle zu erklären.
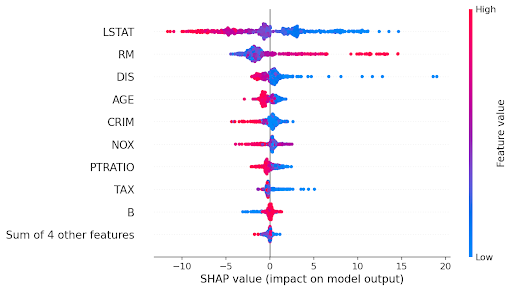 (Ein Beispiel für einen Beeswarm-Plot)
PyCaret integriert sich zudem mit MLflow für MLOps-Funktionalitäten. Sobald du log_experiment = True in der setup-Funktion setzt, werden Metriken, Parameter und Artefakte automatisch geloggt.
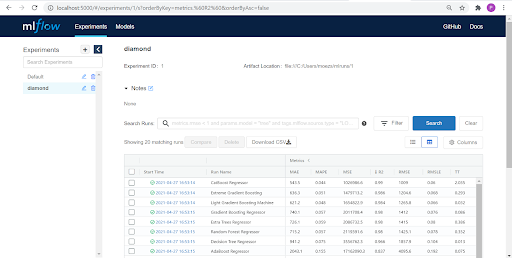 (Bild von Autor)
Preprocessing in PyCaret
Alle Preprocessing-Transformationen werden innerhalb der setup-Funktion angewendet. PyCaret stellt über 25 verschiedene Preprocessing-Transformationen bereit, die in der setup-Funktion definiert werden. Hier klicken, um mehr über PyCarets Preprocessing-Funktionen zu erfahren.
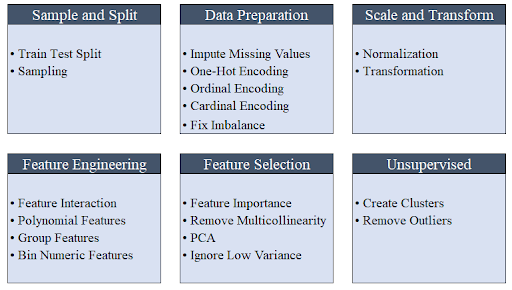 (Bild von Autor)
Module in PyCaret
| Modul | Aufgabe |
|---|---|
| pycaret.classification | Überwacht: Binäre oder Multiklassen-Klassifikation |
| pycaret.regression | Überwacht: Regression |
| pycaret.clustering | Unüberwacht: Clustering |
| pycaret.anomaly | Unüberwacht: Anomalieerkennung |
| pycaret.nlp | Unüberwacht: Natural Language Processing (Topic Modeling) |
| pycaret.arules | Unüberwacht: Association Rules Mining |
| pycaret.datasets | Datensätze |
Beispiel: Ein End-to-End-ML-Use-Case
So sieht ein typischer Machine-Learning-Workflow aus. Das Problem richtig zu formulieren, ist der erste Schritt in jedem ML-Projekt und kann von wenigen Tagen bis zu mehreren Wochen dauern.
Data Sourcing und ETL (Extract-Transform-Load) variieren in ihrer Komplexität je nach technologischem Reifegrad und Größe der Organisation. Häufig arbeitet hier ein Team aus Data Engineers zusammen.
Die Explorative Datenanalyse (EDA) umfasst das Untersuchen der Rohdaten, um Datenqualität (fehlende Werte, Ausreißer etc.), Korrelationen zwischen Features und geschäftliche Hypothesen zu prüfen.
Bei Datenaufbereitung, Modelltraining und -auswahl übernimmt PyCaret die Schwerarbeit unter der Haube. Zur Datenaufbereitung zählen Transformationen wie Imputation fehlender Werte, Skalierung (Min-Max, z-Score etc.), Kodierung kategorialer Variablen (One-Hot-Encoding, ordinale Kodierung etc.), Feature Engineering (Polynome, Feature-Interaktionen, Verhältnisse etc.) und Feature Selection.
Nach der Aufbereitung werden mehrere Algorithmen trainiert und ihre Leistung mithilfe einer Teststrategie (meist Cross-Validation) bewertet.
Abschließend wird das gewählte Modell als API-Endpunkt für Inferenz bereitgestellt. Nach dem Deployment laufen API-Monitoring und Performance-Überwachung des Modells in Produktion kontinuierlich weiter.
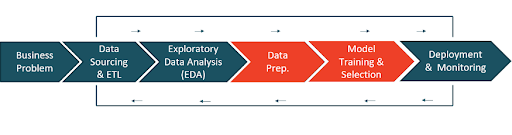 (Bild von Autor)
Problemstellung
Sage den Preis eines Diamanten basierend auf Attributen wie Schliff, Farbe, Form etc. voraus.
Data Sourcing
# Datensatz aus pycaret laden
from pycaret.datasets import get_data
data = get_data('diamond')
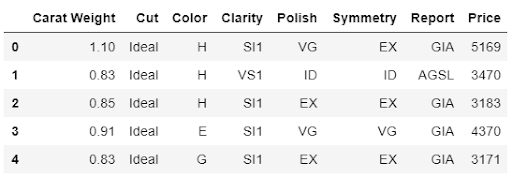
Explorative Datenanalyse (EDA)
Lass uns schnell visualisieren, wie unabhängige Features (Gewicht, Schliff, Farbe, Reinheit etc.) mit der Zielvariable Preis zusammenhängen:
# Streudiagramm für Carat Weight und Price
import plotly.express as px
fig = px.scatter(x=data['Carat Weight'], y=data['Price'], facet_col = data['Cut'], opacity = 0.25, trendline='ols', trendline_color_override = 'red')
fig.show()
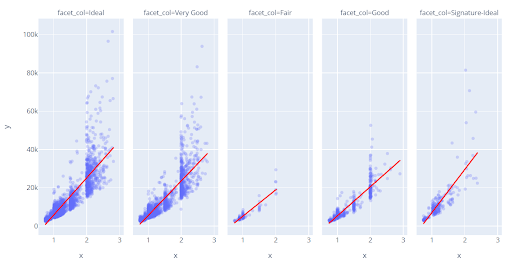
Schauen wir uns das Histogramm der Zielvariable Price an.
# Histogramm plotten
fig = px.histogram(data, x=["Price"])
fig.show()
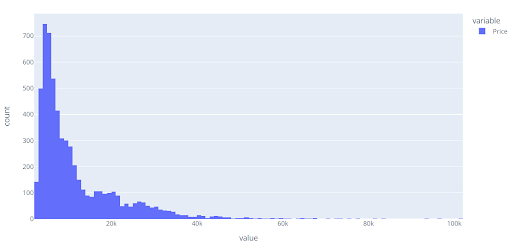
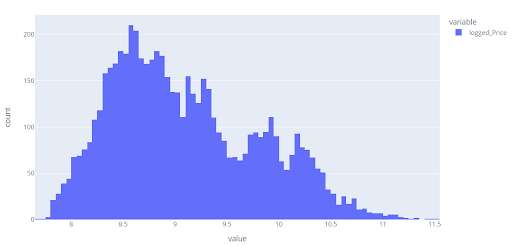
Die Verteilung von Price ist rechtsschief. Wir können schnell prüfen, ob eine Log-Transformation die Verteilung (Form) der Zielvariable verändert.
# Histogramm plotten
data['logged_Price'] = np.log(data['Price'])
fig = px.histogram(data, x=["logged_Price"])
fig.show()
Datenbereinigung und -aufbereitung
Alle Experimente in PyCaret müssen mit der setup-Funktion initialisiert werden. Sie übernimmt alle Schritte der Datenaufbereitung vor dem Modelltraining. Neben grundlegenden Standardprozessen bietet PyCaret eine breite Palette an Preprocessing-Funktionen. Klicke hier, um mehr über die Preprocessing-Funktionalitäten in PyCaret zu erfahren.
# setup initialisieren
from pycaret.regression import *
s = setup(data, target = 'Price', transform_target = True, log_experiment = True, experiment_name = 'diamond')
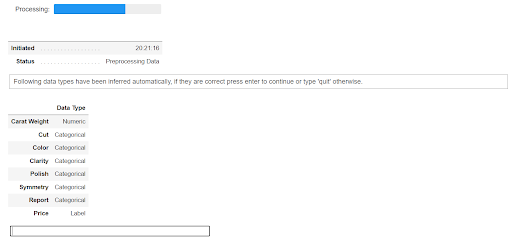
Wenn du die setup-Funktion in PyCaret initialisierst, profiliert sie den Datensatz und leitet die Datentypen aller Eingabefeatures ab. Sind alle Datentypen korrekt erkannt, kannst du mit Enter fortfahren. Es gibt außerdem einen Parameter, um Datentypen in PyCaret zu überschreiben. Wenn du PyCaret in einem Python-Skript nutzt, kannst du diese Bestätigung mit silent = True in der setup-Funktion unterdrücken.
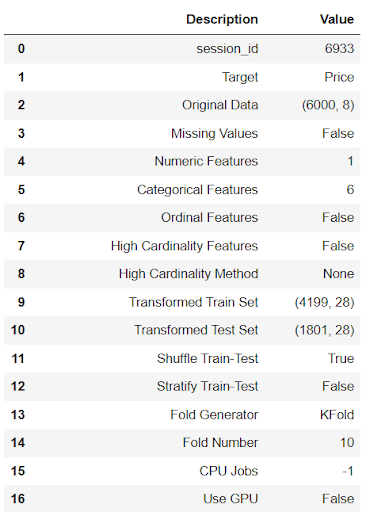 (Ausgabe von setup — für die Anzeige gekürzt)
Training und Auswahl des ML-Modells
Nach dem Setup stehen die transformierten Daten fürs Training bereit. Du startest mit der Funktion compare_models. Sie trainiert alle Algorithmen aus dem Model-Zoo und bewertet mehrere Metriken per k-fold-Cross-Validation.
# alle Modelle vergleichen
best = compare_models()
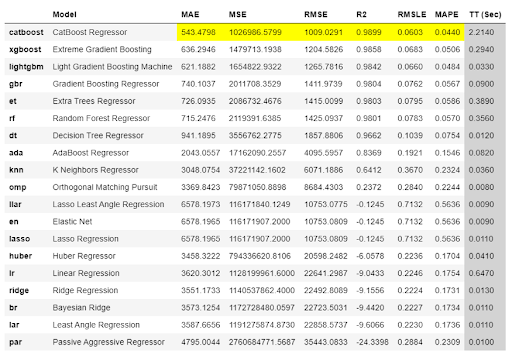 (Ausgabe von compare_models)
Die Ausgabe von compare_models zeigt die gemittelten, crossvalidierten Metriken für alle Modelle. Standardmäßig wird nach „R2“ (absteigend) sortiert; das lässt sich über den Parameter sort in compare_models ändern.
Das beste Modell (hier: CatBoost Regressor) wird nach Abschluss von compare_models zurückgegeben. Standardmäßig wird nur das beste Modell zurückgegeben, über den Parameter n_select kannst du das ändern. Mit n_select = 3 erhältst du z. B. die drei besten Modelle als Liste.
# finale Parameter des besten Modells prüfen
best.get_params()
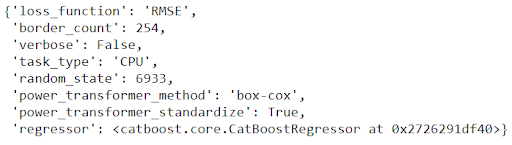
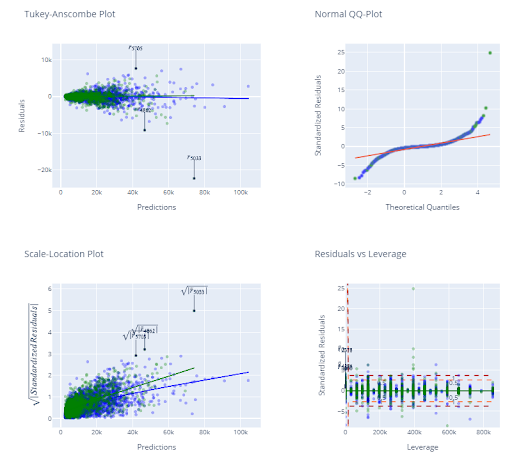
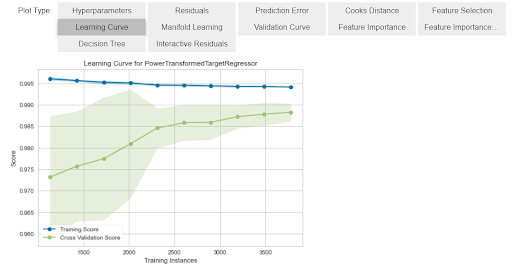
Mit plot_model kannst du Diagnosen und weitere Analyseplots aufrufen.
# Residuen des trainierten Modells prüfen
plot_model(best, plot = 'residuals_interactive')
plot_model(best, plot = ‘feature’)
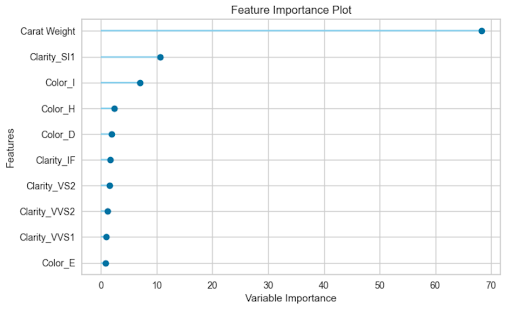
Außerdem gibt es evaluate_model – eine bequeme Möglichkeit, in Jupyter Notebook durch alle verfügbaren Analyseplots zu navigieren.
evaluate_model(best)
Deployment und Monitoring des ML-Modells
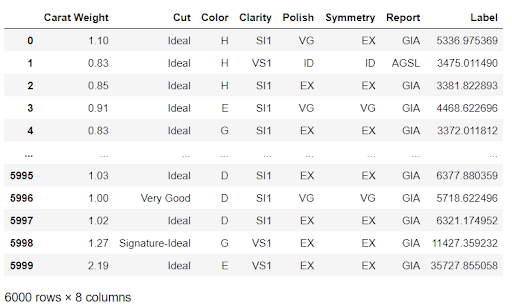
Mit der Funktion predict_model kannst du nun Vorhersagen auf unbekannten Daten erzeugen:
# Daten kopieren und Zielvariable entfernen
data_unseen = data.copy()
data_unseen.drop(‘Price’, axis = 1, inplace = True)
predictions = predict_model(best, data = data_unseen)
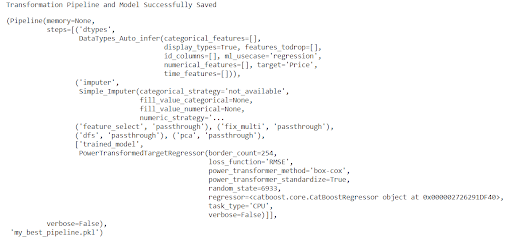
Für die spätere Verwendung kannst du die gesamte Pipeline mit save_model speichern.
save_model(best, ‘my_best_pipeline’)
Experiment-Logging
Erinnerst du dich an log_experiment = True und experiment_name = 'diamond' in der setup-Funktion? Schauen wir uns an, was PyCaret im Hintergrund erledigt hat. Starte dazu den MLflow-Server:
# im Notebook
!mlflow ui

# in der Kommandozeile
mlflow ui
Öffne jetzt deinen Browser und gib „localhost:5000“ ein. Es öffnet sich folgende Oberfläche:
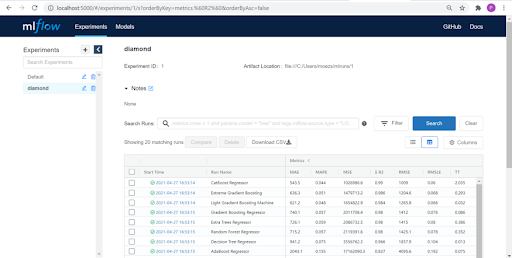
Jeder Eintrag in der Tabelle steht für einen Trainingslauf mit einer trainierten Pipeline und Metadaten wie Datum/Uhrzeit, Performance-Metriken, Modell-Hyperparametern, Tags etc. Klicken wir auf eines der Modelle:
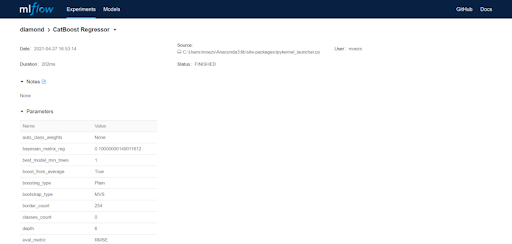
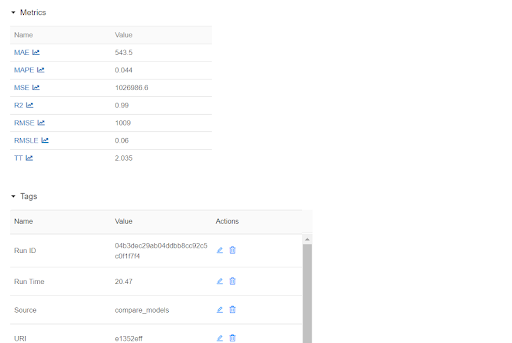
PyCaret Time-Series-Forecasting
PyCarets neues Zeitreihen-Modul ist jetzt als Beta verfügbar. Ganz im Sinne der PyCaret-Simplizität ist es konsistent mit der bestehenden API und randvoll mit Funktionen: Statistische Tests, Modelltraining und -auswahl (30+ Algorithmen), Modellanalyse, automatisches Hyperparameter-Tuning, Experiment-Logging, Deployment in die Cloud und mehr. All das mit wenigen Zeilen Code (wie bei den anderen PyCaret-Modulen). Wenn du dieses neue Beta-Modul nutzen willst, installiere es in einer separaten Conda-Umgebung, um Abhängigkeitskonflikte zu vermeiden.
pip install pycaret-ts-alphaZeitreihendaten sind einer der häufigsten Datentypen, und der Umgang damit ist eine zentrale Data-Science-Kompetenz, wenn du Prognosen erstellen und Trends berichten willst. Wenn du mehr über Zeitreihenanalyse und -prognosen in Python lernen möchtest, hat DataCamp eine starke Kursauswahl. Starte mit dem Learning Track „Time Series with Python“ oder wähle einen dieser Kurse:
- Introduction to Time Series Analysis in Python
- Machine Learning for Time Series Data in Python
- Time Series Analysis Tutorial
PyCaret-Integrationen
| Bereich | Integrationen |
|---|---|
| Modelle | scikit-learn, XGBoost, LightGBM, CatBoost |
| GPU-Training | RAPIDS.AI |
| Verteiltes Rechnen | RAY |
| Hyperparameter-Tuning | tune-sklearn, optuna |
| Plotting & Analyse | plotly, yellowbrick, seaborn, matplotlib |
| NLP | gensim, spacy, nltk |
| MLOps | MLflow |
PyCaret FAQs
-
Gibt es PyCaret nur für Python? Ja, PyCaret ist aktuell nur in Python verfügbar.
-
Worin unterscheidet sich PyCaret von anderen Open-Source-ML-Bibliotheken wie scikit-learn, XGBoost, LightGBM? Im Vergleich zu anderen Open-Source-ML-Bibliotheken ist PyCaret eine Low-Code-Alternative, die Hunderte Zeilen Code durch wenige Befehle ersetzt. PyCaret ist im Wesentlichen ein Python-Wrapper um verschiedene ML-Bibliotheken und -Frameworks wie scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray und weitere.
-
Welche Use-Cases unterstützt PyCaret? Mit Release 2.3.4 unterstützt PyCaret Binär-/Multiklassen-Klassifikation, Regression, Clustering, Anomalieerkennung, Natural Language Processing (Topic Modeling) und Association Rules Mining. Außerdem wurde kürzlich ein neues Zeitreihen-Modul als Beta in einem separaten pip-Installer veröffentlicht.
-
Können wir PyCaret auf der GPU nutzen? Ja, du kannst Modelle auf der GPU trainieren und deinen Workflow um den Faktor 10 beschleunigen. Übergebe dafür in der setup-Funktion einfach use_gpu = True. Die API-Nutzung bleibt unverändert, allerdings müssen in einigen Fällen zusätzliche Bibliotheken installiert werden, die nicht in der Standard- oder Vollversion enthalten sind.
-
Können wir Hyperparameter in PyCaret tunen? Ja, du kannst Hyperparameter jedes Modells automatisch tunen. PyCaret integriert sich mit sklearn, optuna, tune-sklearn und ray für verschiedene Tuner wie Random Grid Search oder Bayesian Grid Search.
-
Ist PyCaret kostenlos? PyCaret ist komplett kostenlos, Open Source und unter der MIT-Lizenz veröffentlicht.
| PyCaret-Ressourcen | ---- |
|---|---|
| ⭐ Tutorials | Neu bei PyCaret? Schau dir die offiziellen Notebooks an! |
| 📋 Notebooks | Beispiel-Notebooks aus der Community. |
| 📙 Blog | Tutorials und Artikel von Contributor:innen. |
| 📚 Dokumentation | Die detaillierte API-Dokumentation von PyCaret. |
| 📺 Video-Tutorials | Unsere Video-Tutorials von verschiedenen Events. |
| 📢 Discussions | Fragen? Tausche dich mit Community und Contributor:innen aus. |
| 🛠️ <atarget="_blank" href="https://github.com/pycaret/pycaret/blob/master/CHANGELOG.md">Changelog | Änderungen und Versionshistorie. |
| 🌳 Roadmap | Der Entwicklungsplan von PyCaret für Software und Community. |