PyCaret nedir
Not: Bu eğitim 2021 yılında oluşturulmuştur ve PyCaret artık aktif olarak bakım görmemektedir; bazı adımlar, DataLab veya diğer araçların güncel sürümleriyle çalışmayabilir.
PyCaret, makine öğrenimi iş akışlarını otomatikleştiren, Python’da açık kaynaklı, düşük kodlu bir makine öğrenimi kitaplığıdır. Deney döngüsünü katlayarak hızlandıran ve sizi daha üretken kılan uçtan uca bir makine öğrenimi ve model yönetimi aracıdır.
Diğer açık kaynak makine öğrenimi kitaplıklarıyla karşılaştırıldığında PyCaret, yüzlerce satır kodu yalnızca birkaç satırla değiştirebilen alternatif bir düşük kod kitaplığıdır. Bu da deneyleri katlanarak daha hızlı ve verimli hale getirir. PyCaret esasen scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray ve birkaç başka makine öğrenimi kitaplığı ile çerçevenin etrafında bir Python sarmalayıcısıdır.
PyCaret’in tasarımı ve sadeliği, ilk kez Gartner tarafından kullanılan bir terim olan vatandaş veri bilimcilerinin yükselen rolünden ilham almıştır. Vatandaş veri bilimcileri, önceden daha fazla teknik uzmanlık gerektiren basit ve orta düzeyde karmaşık analitik görevleri yerine getirebilen güçlü kullanıcılardır.
PyCaret basit ve kullanımı kolaydır. PyCaret’te gerçekleştirilen tüm işlemler, dağıtıma tamamen orkestre edilmiş bir ardışık düzende (pipeline) sıralı olarak saklanır. Eksik değerleri atama, kategorik veriyi dönüştürme, özellik mühendisliği veya hatta hiperparametre ayarı olsun, PyCaret bunların hepsini otomatikleştirir. PyCaret hakkında daha fazla bilgi edinmek için bu bir dakikalık videoyu izleyin.
PyCaret’teki modüller
PyCaret’in API’si modüller halinde düzenlenmiştir. Her modül, bir tür denetimli öğrenmeyi (sınıflandırma ve regresyon) veya denetimsiz öğrenmeyi (kümeleme, anomalilik tespiti, nlp, ilişkilendirme kuralları madenciliği) destekler. Zaman serisi tahmini için yeni bir modül, kısa süre önce ayrı bir pip paketi olarak beta sürümünde yayınlandı.
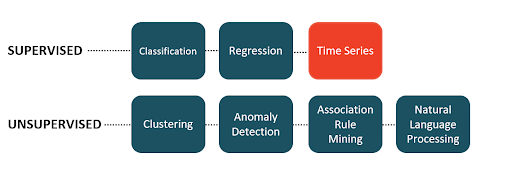 Görsel kaynağı: [Ali, Moez].
PyCaret’in kurulumu
PyCaret’i pip ile kurmak basittir ve yalnızca birkaç dakika sürer. PyCaret’in varsayılan kurulumu, yalnızca requirements.txt dosyasında repo üzerinde listelenen zorunlu bağımlılıkları kurar.
Not: Bu eğitim 2021 yılında oluşturulmuştur ve PyCaret artık aktif olarak bakım görmemektedir; bazı adımlar, DataLab veya diğer araçların güncel sürümleriyle çalışmayabilir.
pip install pycaret
Tam sürümü kurmak için:
pip install pycaret[full]
Özellikler
PyCaret’in ünü sadeliğinden gelir. Diğer otomatik makine öğrenimi yazılımlarıyla karşılaştırıldığında PyCaret son derece esnektir, birleşik bir API ile gelir ve öğrenme eğrisi yoktur.
PyCaret işlevsellik açısından zengindir. Verinizi işlemeye başlayıp modelleri eğitmeye ve ardından yalnızca birkaç satır kodla buluta dağıtmaya kadar gidebilirsiniz. Deney başlatıldığında otomatik olarak uygulanan çok sayıda önişleme dönüşümüyle birlikte gelir. PyCaret’in model havuzunda denetimli ve denetimsiz görevler için 70’ten fazla eğitilmemiş model bulunur.
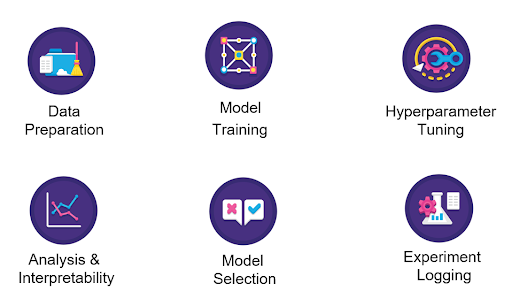
PyCaret’i GPU üzerinde de kullanabilir ve iş akışınızı 10 kat hızlandırabilirsiniz. Modelleri GPU’da eğitmek için setup işlevinde use_gpu = True parametresini geçirmeniz yeterlidir. Kodda hiçbir değişiklik yapmanız gerekmez.
PyCaret bir “glass-box” çözümüdür. Modelle etkileşime geçmek, performansı ve sonuçları analiz etmek için tonlarca işlevle birlikte gelir. Karmaşıklık matrisi, AUC, kalıntılar ve özellik önemi gibi tüm standart grafikler tüm modeller için mevcuttur. Ayrıca, herhangi bir karmaşık ağaç tabanlı makine öğrenimi modelinin çıktısını açıklamak için kullanılan SHAP kitaplığı ile entegrasyonu vardır.
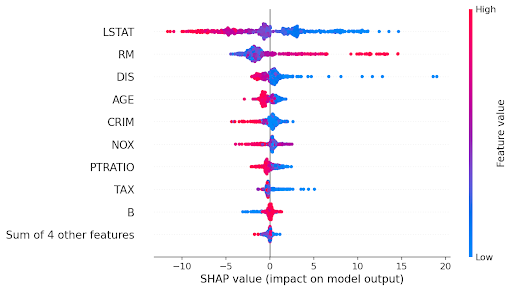 (Örnek bir beeswarm grafiği)
PyCaret ayrıca MLOps işlevleri için MLflow ile entegredir. setup işlevinde log_experiment = True parametresini geçirdiğinizde metrikleri, parametreleri ve yapıtları (artifact) otomatik olarak günlüğe kaydeder.
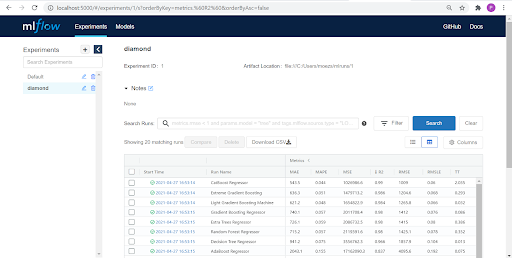 (Görsel: Yazar)
PyCaret’te önişleme
Tüm önişleme dönüşümleri setup işlevi içinde uygulanır. PyCaret, setup işlevinde tanımlanan 25’ten fazla farklı önişleme dönüşümü sağlar. PyCaret’in önişleme yetenekleri hakkında daha fazla bilgi edinmek için buraya tıklayın.
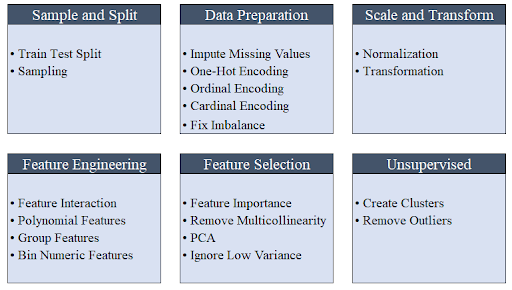 (Görsel: Yazar)
PyCaret’teki modüller
| Modül | Görev |
|---|---|
| pycaret.classification | Denetimli: İkili veya çok sınıflı sınıflandırma |
| pycaret.regression | Denetimli: Regresyon |
| pycaret.clustering | Denetimsiz: Kümeleme |
| pycaret.anomaly | Denetimsiz: Anomalilik Tespiti |
| pycaret.nlp | Denetimsiz: Doğal Dil İşleme (Konu Modellemesi) |
| pycaret.arules | Denetimsiz: İlişkilendirme Kuralları Madenciliği |
| pycaret.datasets | Veri Kümeleri |
Örnek: Uçtan uca bir ML kullanım senaryosu
Bu tipik bir makine öğrenimi iş akışıdır. Bir ML sorununu doğru şekilde çerçevelemek, herhangi bir makine öğrenimi projesindeki ilk adımdır ve bunu doğru kurgulamak birkaç günden haftalara kadar sürebilir.
Veri Kaynağı ve ETL (Extract-Transform-Load) karmaşıklığı da kuruluşun teknoloji olgunluğuna ve büyüklüğüne bağlı olarak değişebilir. Bu aşamada bir veri mühendisi ekibinin birlikte çalışması normaldir.
Keşifsel Veri Analizi (EDA) aşaması, ham verileri keşfederek veri kalitesini (eksik değerler, aykırı değerler vb.), özellikler arasındaki korelasyonu ve iş hipotezlerini test etmeyi kapsar.
Veri hazırlama ile model eğitimi ve seçimi için PyCaret kaputun altında ağır işi yapar. Veri hazırlama; eksik değer ataması, ölçekleme (min-maks, z-puanı vb.), kategorik kodlama (one-hot encoding, sıralı kodlama vb.), özellik mühendisliği (polinom, özellik etkileşimi, oranlar vb.) ve özellik seçimi gibi dönüşümleri içerir.
Veri hazırlığından sonra model eğitimi ve seçimi aşaması, birden çok algoritmanın uygunlanmasını ve bir tür test stratejisi (çoğunlukla çapraz doğrulama) kullanılarak performansın değerlendirilmesini içerir.
Son olarak seçilen (en iyi model), çıkarım için bir API uç noktası olarak dağıtılır. Dağıtım tamamlandıktan sonra API’nin izlenmesi ve üretimde model performansının takip edilmesi sürekli devam eder.
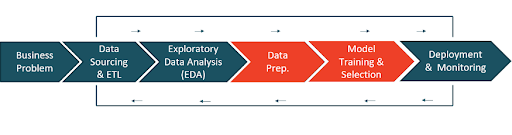 (Görsel: Yazar)
Problem tanımı
Kesim, renk, şekil vb. nitelikler verildiğinde elmasın fiyatını tahmin edin.
Veri kaynağı
# load the dataset from pycaret
from pycaret.datasets import get_data
data = get_data('diamond')
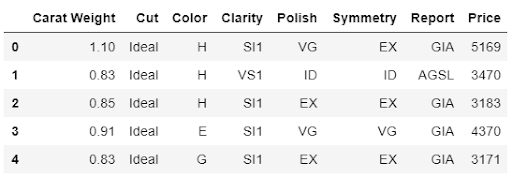
Keşifsel veri analizi (EDA)
Bağımsız özelliklerin (ağırlık, kesim, renk, berraklık vb.) hedef değişken (Fiyat) ile ilişkisini değerlendirmek için hızlı bir görselleştirme yapalım:
# plot scatter carat_weight and Price
import plotly.express as px
fig = px.scatter(x=data['Carat Weight'], y=data['Price'], facet_col = data['Cut'], opacity = 0.25, trendline='ols', trendline_color_override = 'red')
fig.show()
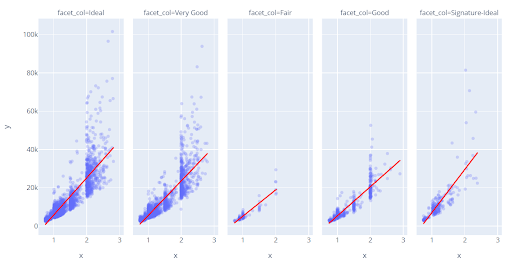
Hedef değişken Fiyat’ın histogramına bakalım.
# plot histogram
fig = px.histogram(data, x=["Price"])
fig.show()
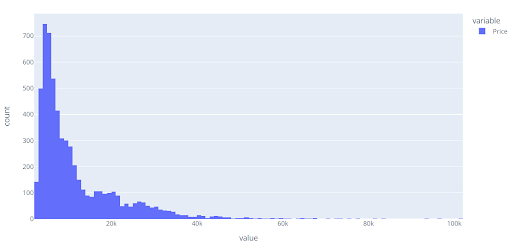
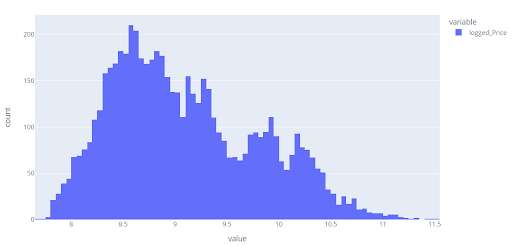
Fiyat dağılımının sağa çarpık olduğuna dikkat edin, hedef değişkenin dağılımını (biçimini) log dönüşümünün değiştirip değiştirmediğini hızlıca kontrol edebiliriz.
# plot histogram
data['logged_Price'] = np.log(data['Price'])
fig = px.histogram(data, x=["logged_Price"])
fig.show()
Veri temizleme ve hazırlama
PyCaret’te tüm deneyler setup işlevi kullanılarak başlatılmalıdır. Model eğitiminden önce gereken tüm veri hazırlama görevlerinden sorumludur. Bazı temel varsayılan işleme görevlerini gerçekleştirmesinin yanında PyCaret, geniş bir önişleme özelliği yelpazesi de sunar. PyCaret’teki tüm önişleme işlevleri hakkında daha fazla bilgi edinmek için buraya tıklayın.
# initialize setup
from pycaret.regression import *
s = setup(data, target = 'Price', transform_target = True, log_experiment = True, experiment_name = 'diamond')
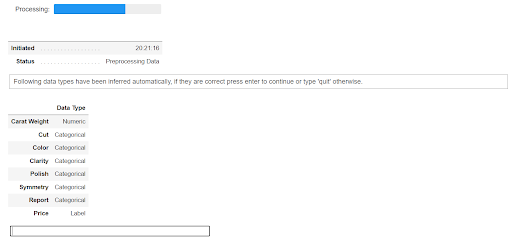
PyCaret’te setup işlevini başlattığınızda veri kümesini profiller ve tüm giriş özellikleri için veri türlerini çıkarır. Tüm veri türleri doğru çıkarıldıysa devam etmek için Enter’a basabilirsiniz. PyCaret’te veri türlerini geçersiz kılmak için kullanılabilecek bir parametre de vardır. Ayrıca PyCaret’i bir Python betiğinde kullanıyorsanız, setup işlevinde silent = True parametresini geçerek bu onayı susturabilirsiniz.
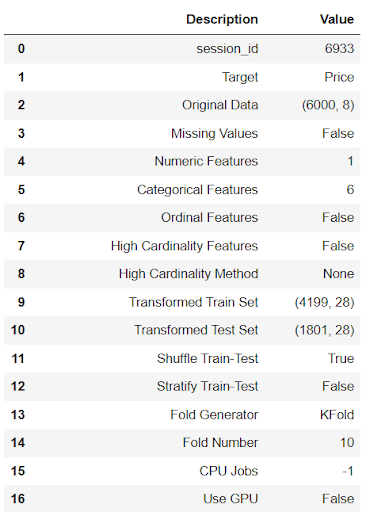 (setup çıktısı — görüntü için kısaltılmıştır)
ML model eğitimi ve seçimi
Kurulumdan sonra dönüştürülmüş veriler model eğitimi için hazırdır. Eğitimi compare_models işleviyle başlatabilirsiniz. Model havuzunda mevcut tüm algoritmaları eğitecek ve k-katlı çapraz doğrulama kullanarak birden çok performans metriğini değerlendirecektir.
# compare all models
best = compare_models()
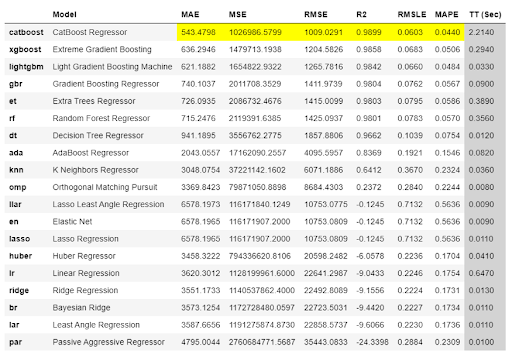 (compare_models çıktısı)
compare_models çıktısı, tüm modeller için ortalama alınmış çapraz doğrulanmış metrikleri gösterir. Çıktı varsayılan olarak ‘R2’ye göre (yüksekten düşüğe) sıralanır ancak compare_models işlevinde sort parametresi geçirilerek değiştirilebilir.
En iyi model (bu durumda CatBoost Regressor) compare_models tamamlandığında döndürülür. Varsayılan olarak yalnızca en iyi model döndürülür, ancak bu durum n_select parametresiyle değiştirilebilir. Örneğin compare_models işlevine n_select = 3 geçirilmesi, en iyi 3 modeli bir liste olarak döndürür.
# check the final params of best model
best.get_params()
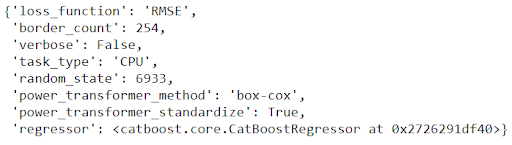
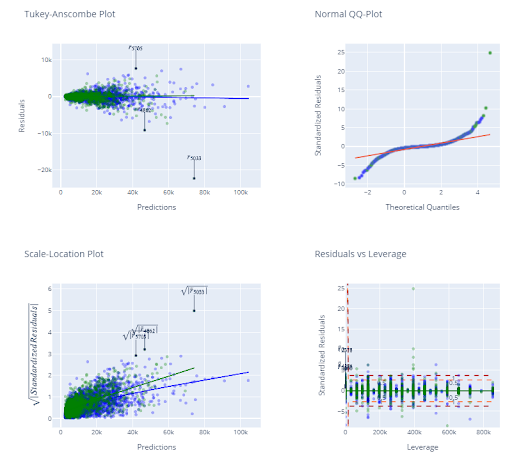
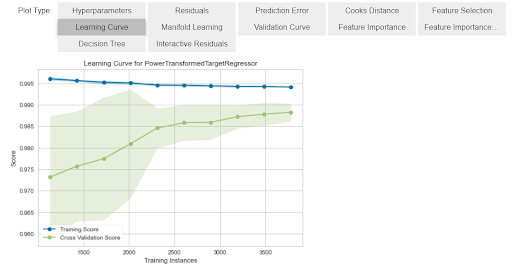
Ayrıca plot_model işlevini kullanarak tanılamaları ve birkaç başka analiz grafiğini de inceleyebiliriz.
# check the residuals of trained model
plot_model(best, plot = 'residuals_interactive')
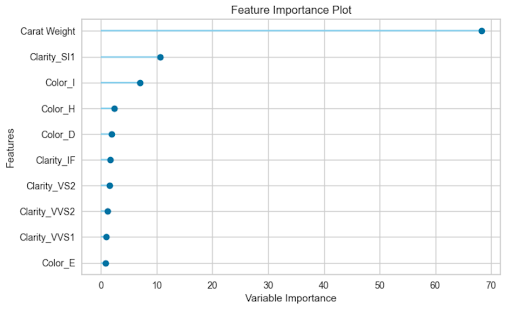
plot_model(best, plot = ‘feature’)
Jupyter Notebook’ta mevcut tüm analiz grafiklerinde gezinmenin kullanışlı bir yolu olan evaluate_model adlı bir işlev daha vardır.
evaluate_model(best)
ML modelinin dağıtımı ve izlenmesi
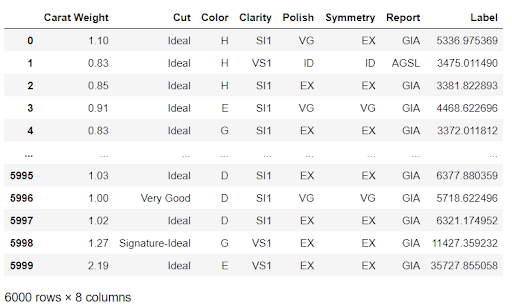
Artık predict_model işleviyle nihai modeli kullanarak görülmemiş veriler üzerinde tahminler üretebiliriz:
# copy data and remove target variable
data_unseen = data.copy()
data_unseen.drop(‘Price’, axis = 1, inplace = True)
predictions = predict_model(best, data = data_unseen)
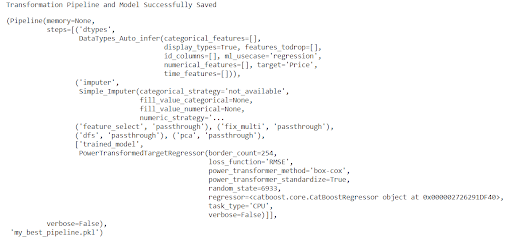
İleride kullanmak üzere tüm ardışık düzeni save_model işleviyle kaydedebilirsiniz.
save_model(best, ‘my_best_pipeline’)
Deney günlüğe kaydı
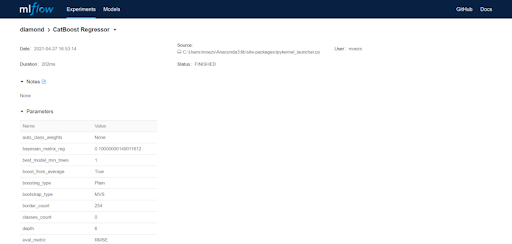
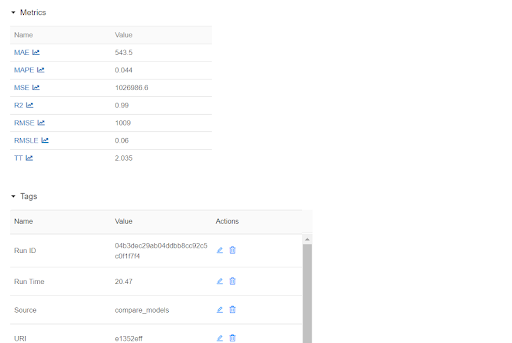
setup işlevinde log_experiment = True ve experiment_name = 'diamond' parametrelerini geçtiğimizi hatırlayın. PyCaret’in perde arkasında neler yaptığına bakalım. Sihri görmek için MLflow sunucusunu başlatalım:
# within notebook
!mlflow ui

# from the command line
mlflow ui
Şimdi tarayıcınızı açın ve “localhost:5000” yazın. Şu şekilde bir arayüz açılacaktır:
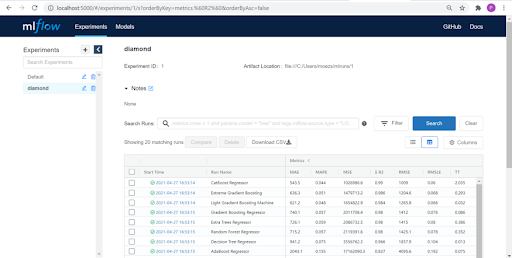
Yukarıdaki tablodaki her giriş, eğitilmiş bir ardışık düzen ve çalışmanın tarih-saat bilgisi, performans metrikleri, model hiperparametreleri, etiketler vb. bir dizi meta veri ile sonuçlanan bir eğitim çalışmasını temsil eder. Modellerden birine tıklayalım:
PyCaret zaman serisi tahmini
PyCaret’in yeni zaman serisi modülü artık beta sürümünde mevcut. PyCaret’in sadeliğine sadık kalarak mevcut API ile tutarlıdır ve işlevlerle doludur. İstatistiksel testler, model eğitimi ve seçimi (30+ algoritma), model analizi, otomatik hiperparametre ayarı, deney günlüğe kaydı, buluta dağıtım ve daha fazlası. Tüm bunlar yalnızca birkaç satır kodla (diğer modüllerinde olduğu gibi). Bu yeni modülü beta sürümünde kullanmak istiyorsanız, bağımlılık çakışmalarını önlemek için ayrı bir conda ortamına kurmanız gerekir.
pip install pycaret-ts-alphaZaman serisi verileri en yaygın veri türlerinden biridir ve onlarla nasıl çalışılacağını anlamak, tahmin yapmak ve eğilimler hakkında raporlamak istiyorsanız kritik bir veri bilimi becerisidir. Python’da zaman serisi analizi ve tahmini hakkında daha fazla bilgi edinmek isterseniz DataCamp’in harika bir ders koleksiyonu vardır. Python ile Zaman Serileri Öğrenme yoluna başlayabilir veya şu derslerden biri de harika bir seçenek olabilir:
- Python’da Zaman Serisi Analizine Giriş
- Python’da Zaman Serisi Verileri için Makine Öğrenimi
- Zaman Serisi Analizi Eğitimi
PyCaret Entegrasyonları
| Alan | Entegrasyonlar |
|---|---|
| Modeller | scikit-learn, XGBoost, LightGBM, CatBoost |
| GPU Eğitimi | RAPIDS.AI |
| Dağıtık Hesaplama | RAY |
| Hiperparametre Ayarı | tune-sklearn, optuna |
| Görselleştirme & Analiz | plotly, yellowbrick, seaborn, matplotlib |
| NLP | gensim, spacy, nltk |
| MLOps | MLflow |
PyCaret SSS
-
PyCaret yalnızca Python’da mı mevcut? Evet, PyCaret şu an için yalnızca Python’da mevcuttur.
-
PyCaret ile scikit-learn, XGBoost, LightGBM gibi diğer açık kaynak makine öğrenimi kitaplıkları arasındaki fark nedir? Diğer açık kaynak makine öğrenimi kitaplıklarıyla karşılaştırıldığında PyCaret, yüzlerce satır kodu yalnızca birkaç satırla değiştirebilen alternatif bir düşük kod kitaplığıdır. PyCaret esasen scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray ve birkaç başka makine öğrenimi kitaplığı ve çerçevenin etrafında bir Python sarmalayıcısıdır.
-
PyCaret’te hangi kullanım senaryoları destekleniyor? 2.3.4 sürümü itibarıyla PyCaret İkili/Çok Sınıflı Sınıflandırma, Regresyon, Kümeleme, Anomalilik Tespiti, Doğal Dil İşleme (Konu Modellemesi) ve İlişkilendirme Kuralları Madenciliğini destekler. PyCaret ayrıca kısa süre önce yeni zaman serisi modülünü beta olarak ayrı bir pip yükleyicisi şeklinde yayınladı.
-
PyCaret’i GPU’da kullanabilir miyiz? PyCaret’te modelleri GPU üzerinde eğitebilir ve iş akışınızı 10 kat hızlandırabilirsiniz. Modelleri GPU’da eğitmek için setup işlevinde use_gpu = True parametresini geçirmeniz yeterlidir. API kullanımında bir değişiklik yoktur, ancak bazı durumlarda varsayılan veya tam sürümle kurulmadıkları için ek kitaplıkların kurulması gerekebilir.
-
PyCaret’te modelin hiperparametrelerini ayarlayabilir miyiz? Evet, PyCaret’te herhangi bir modelin hiperparametrelerini otomatik olarak ayarlayabilirsiniz. Farklı ayarlayıcılar (Random Grid Search veya Bayesian Grid Search gibi) için sklearn, optuna, tune-sklearn ve ray ile entegredir.
-
PyCaret kullanımı ücretsiz mi? PyCaret tamamen ücretsiz ve açık kaynaklıdır ve MIT lisansı altında lisanslanmıştır.
| PyCaret Kaynakları | ---- |
|---|---|
| ⭐ Eğitimler | PyCaret’e yeni misiniz? Resmi not defterlerine göz atın! |
| 📋 Not Defterleri | Topluluk tarafından oluşturulan örnek not defterleri. |
| 📙 Blog | Katkıda bulunanların eğitimleri ve makaleleri. |
| 📚 Dokümantasyon | PyCaret’in ayrıntılı API dokümanları |
| 📺 Video Eğitimleri | Çeşitli etkinliklerden video eğitimlerimiz. |
| 📢 Tartışmalar | Sorularınız mı var? Topluluk ve katkıda bulunanlarla etkileşime geçin. |
| 🛠️ <atarget="_blank" href="https://github.com/pycaret/pycaret/blob/master/CHANGELOG.md">Sürüm Günlükleri | Değişiklikler ve sürüm geçmişi. |
| 🌳 Yol Haritası | PyCaret’in yazılım ve topluluk geliştirme planı. |




