Apa itu PyCaret
Catatan: Tutorial ini dibuat pada tahun 2021, dan PyCaret tidak lagi aktif dipelihara; beberapa langkah mungkin tidak berfungsi dengan versi DataLab atau alat lain saat ini.
PyCaret adalah pustaka pembelajaran mesin open-source berbasis low-code di Python yang mengotomatiskan alur kerja pembelajaran mesin. Ini adalah alat pembelajaran mesin end-to-end dan manajemen model yang mempercepat siklus eksperimen secara eksponensial dan membuat Anda lebih produktif.
Dibandingkan dengan pustaka pembelajaran mesin open-source lainnya, PyCaret adalah pustaka low-code alternatif yang dapat menggantikan ratusan baris kode hanya dengan beberapa baris. Hal ini membuat eksperimen jauh lebih cepat dan efisien. PyCaret pada dasarnya adalah pembungkus Python di atas sejumlah pustaka dan kerangka kerja pembelajaran mesin seperti scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray, dan beberapa lainnya.
Desain dan kesederhanaan PyCaret terinspirasi oleh peran yang muncul dari citizen data scientist, istilah yang pertama kali digunakan oleh Gartner. Citizen data scientist adalah pengguna andal yang dapat melakukan tugas analitis sederhana hingga cukup canggih yang sebelumnya memerlukan keahlian teknis lebih tinggi.
PyCaret sederhana dan mudah digunakan. Semua operasi yang dijalankan di PyCaret disimpan secara berurutan dalam pipeline yang sepenuhnya diorkestrasi untuk deployment. Baik itu imputasi nilai hilang, transformasi data kategorikal, rekayasa fitur, maupun penalaan hiperparameter, semuanya diotomatisasi oleh PyCaret. Untuk mempelajari lebih lanjut tentang PyCaret, tonton video berdurasi satu menit ini.
Modul di PyCaret
API PyCaret disusun dalam modul. Setiap modul mendukung satu jenis pembelajaran terawasi (klasifikasi dan regresi) atau pembelajaran tak terawasi (klasterisasi, deteksi anomali, nlp, penambangan aturan asosiasi). Modul baru untuk peramalan deret waktu telah dirilis baru-baru ini dalam versi beta sebagai paket pip terpisah.
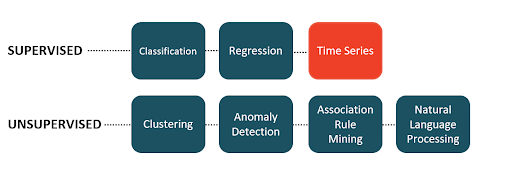 Sumber gambar: [Ali, Moez].
Menginstal PyCaret
Instalasi PyCaret mudah melalui pip dan hanya membutuhkan beberapa menit. Instalasi default PyCaret hanya memasang dependensi inti seperti yang tercantum dalam berkas requirements.txt di repo.
Catatan: Tutorial ini dibuat pada tahun 2021, dan PyCaret tidak lagi aktif dipelihara; beberapa langkah mungkin tidak berfungsi dengan versi DataLab atau alat lain saat ini.
pip install pycaret
Untuk memasang versi lengkap:
pip install pycaret[full]
Fitur
Klaim utama PyCaret adalah kesederhanaannya. Dibandingkan perangkat lunak AutoML lainnya, PyCaret sangat fleksibel, hadir dengan API terpadu, dan nyaris tanpa kurva belajar.
PyCaret sarat dengan fungsionalitas. Anda bisa memproses data, melatih model, lalu melakukan deployment ke cloud hanya dengan beberapa baris kode. PyCaret menyediakan banyak transformasi prapemrosesan yang diterapkan secara otomatis saat eksperimen diinisialisasi. Model zoo PyCaret memiliki lebih dari 70 model yang belum dilatih untuk tugas terawasi dan tak terawasi.
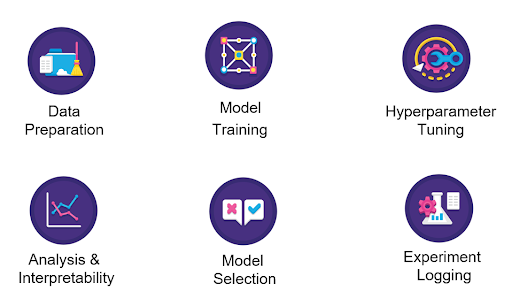
Anda juga dapat menggunakan PyCaret di GPU dan mempercepat alur kerja hingga 10x. Untuk melatih model di GPU, cukup berikan use_gpu = True pada fungsi setup. Tanpa perubahan kode sama sekali.
PyCaret adalah solusi glass-box. Ia hadir dengan banyak fungsi untuk berinteraksi dengan model serta menganalisis kinerja dan hasilnya. Semua plot standar seperti confusion matrix, AUC, residual, dan feature importance tersedia untuk semua model. PyCaret juga terintegrasi dengan pustaka SHAP yang digunakan untuk menjelaskan keluaran dari model pembelajaran mesin berbasis pohon yang kompleks.
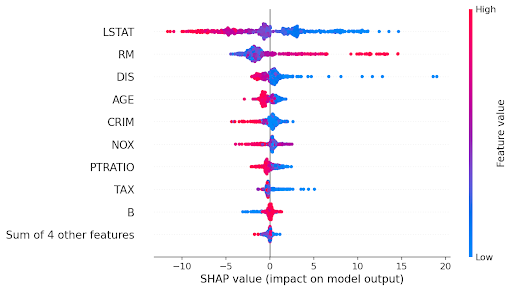 (Contoh plot beeswarm)
PyCaret juga terintegrasi dengan MLflow untuk fungsionalitas MLOps. Secara otomatis mencatat metrik, parameter, dan artefak saat Anda memberikan log_experiment = True pada fungsi setup.
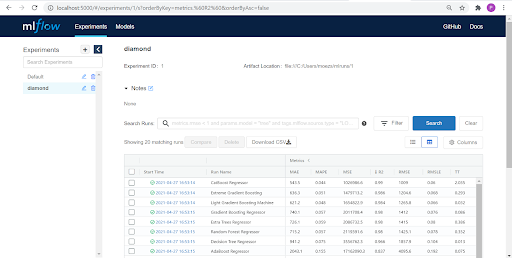 (Gambar oleh Penulis)
Prapemrosesan di PyCaret
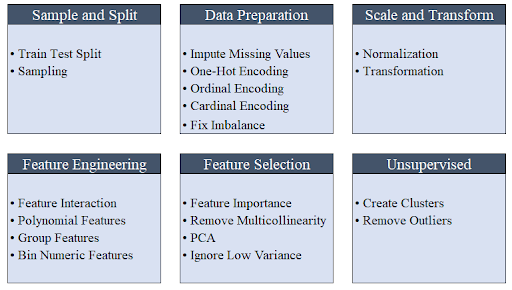
Semua transformasi prapemrosesan diterapkan dalam fungsi setup. PyCaret menyediakan lebih dari 25 transformasi prapemrosesan berbeda yang ditentukan dalam fungsi setup. Klik di sini untuk mempelajari lebih lanjut kemampuan prapemrosesan PyCaret.
 (Gambar oleh Penulis)
Modul di PyCaret
| Modul | Tugas |
|---|---|
| pycaret.classification | Terawasi: Klasifikasi biner atau multi-kelas |
| pycaret.regression | Terawasi: Regresi |
| pycaret.clustering | Tak terawasi: Klasterisasi |
| pycaret.anomaly | Tak terawasi: Deteksi anomali |
| pycaret.nlp | Tak terawasi: Pemrosesan Bahasa Alami (Pemodelan Topik) |
| pycaret.arules | Tak terawasi: Penambangan Aturan Asosiasi |
| pycaret.datasets | Dataset |
Contoh: Use case ML end-to-end
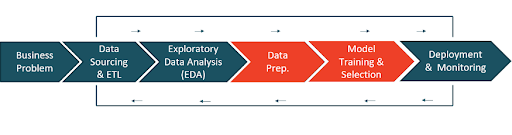
Ini adalah alur kerja pembelajaran mesin yang khas. Merumuskan masalah ML dengan benar adalah langkah pertama dalam proyek pembelajaran mesin mana pun dan bisa memakan waktu dari beberapa hari hingga berminggu-minggu untuk merumuskannya dengan tepat.
Pengumpulan Data dan ETL (Extract-Transform-Load) juga dapat bervariasi kompleksitasnya tergantung pada kematangan teknologi dan ukuran organisasi. Wajar melihat tim data engineer bekerja bersama pada fase ini.
Fase Exploratory Data Analysis (EDA) mencakup penelusuran data mentah untuk menilai kualitas data (nilai hilang, pencilan, dll.), korelasi antar fitur, dan menguji hipotesis bisnis.
Untuk penyiapan data serta pelatihan dan pemilihan model, PyCaret menangani pekerjaan berat di balik layar. Penyiapan data mencakup transformasi seperti imputasi nilai hilang, penskalaan (min-max, z-score, dll.), pengodean kategorikal (one-hot encoding, ordinal encoding, dll.), rekayasa fitur (polinomial, interaksi fitur, rasio, dll.), dan seleksi fitur.
Setelah penyiapan data, fase pelatihan dan pemilihan model melibatkan pemodelan dengan banyak algoritme dan evaluasi kinerja menggunakan strategi pengujian tertentu (umumnya cross-validation).
Pada akhirnya, model terpilih (terbaik) dideploy sebagai endpoint API untuk inferensi. Setelah deployment selesai, pemantauan API dan kinerja model di produksi berlangsung secara berkelanjutan.
 (Gambar oleh Penulis)
Pernyataan masalah
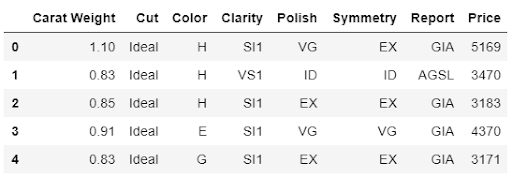
Memprediksi harga berlian berdasarkan atribut seperti potongan, warna, bentuk, dan lain-lain.
Sumber data
# muat dataset dari pycaret
from pycaret.datasets import get_data
data = get_data('diamond')
Exploratory data analysis (EDA)
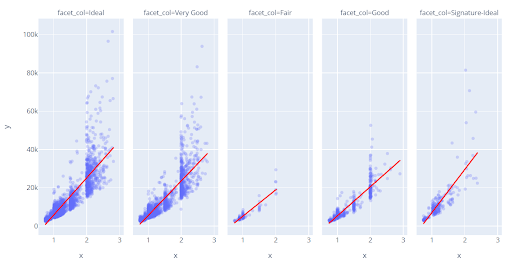
Mari lakukan visualisasi cepat untuk menilai hubungan fitur independen (berat, potongan, warna, kejernihan, dll.) dengan variabel target, yaitu Harga:
# plot sebar carat_weight dan Price
import plotly.express as px
fig = px.scatter(x=data['Carat Weight'], y=data['Price'], facet_col = data['Cut'], opacity = 0.25, trendline='ols', trendline_color_override = 'red')
fig.show()
Mari cek histogram variabel target Price.
# plot histogram
fig = px.histogram(data, x=["Price"])
fig.show()
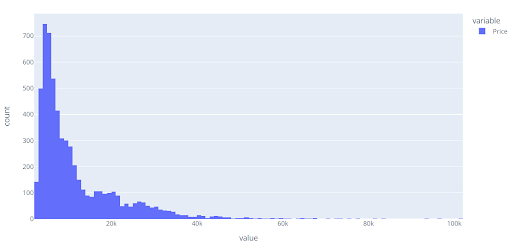
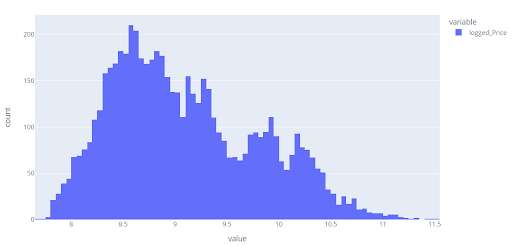
Perhatikan bahwa distribusi Price condong ke kanan; kita bisa cepat memeriksa apakah transformasi log dapat mengubah distribusi (bentuk) variabel target.
# plot histogram
data['logged_Price'] = np.log(data['Price'])
fig = px.histogram(data, x=["logged_Price"])
fig.show()
Pembersihan dan penyiapan data
Semua eksperimen di PyCaret harus diinisialisasi menggunakan fungsi setup. Fungsi ini bertanggung jawab atas semua tugas penyiapan data yang diperlukan sebelum pelatihan model. Selain melakukan beberapa pemrosesan dasar secara default, PyCaret juga menawarkan beragam fitur prapemrosesan. Klik di sini untuk mempelajari semua fungsionalitas prapemrosesan di PyCaret.
# inisialisasi setup
from pycaret.regression import *
s = setup(data, target = 'Price', transform_target = True, log_experiment = True, experiment_name = 'diamond')
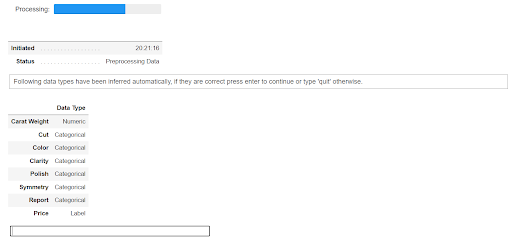
Saat Anda menginisialisasi fungsi setup di PyCaret, PyCaret melakukan profil terhadap dataset dan menyimpulkan tipe data untuk semua fitur masukan. Jika semua tipe data sudah disimpulkan dengan benar, Anda dapat menekan enter untuk melanjutkan. Ada juga parameter yang dapat digunakan untuk menimpa tipe data di PyCaret. Selain itu, jika Anda menggunakan PyCaret dalam skrip Python, Anda dapat menonaktifkan konfirmasi ini dengan memberikan silent = True pada fungsi setup.
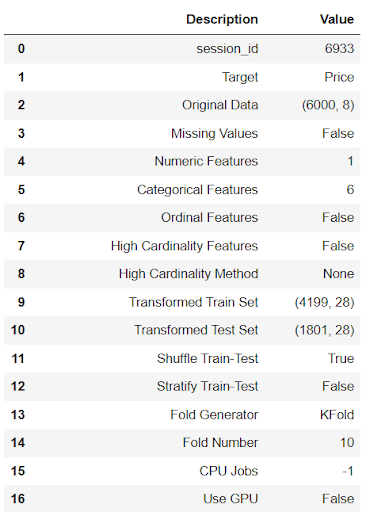 (Keluaran dari setup — dipangkas untuk tampilan)
Pelatihan dan pemilihan model ML
Setelah setup, data yang telah ditransformasi tersedia untuk pelatihan model. Anda dapat memulai proses pelatihan dengan fungsi compare_models. Fungsi ini akan melatih semua algoritme yang tersedia di model zoo dan mengevaluasi beberapa metrik kinerja menggunakan k-fold cross-validation.
# bandingkan semua model
best = compare_models()
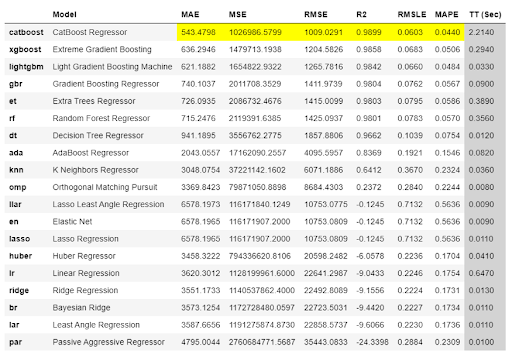 (Keluaran dari compare_models)
Keluaran dari compare_models menampilkan metrik cross-validation rerata untuk semua model. Secara default, keluaran diurutkan berdasarkan ‘R2’ (tertinggi ke terendah), namun dapat diubah dengan memberikan parameter sort pada fungsi compare_models.
Model terbaik (dalam kasus ini, CatBoost Regressor) dikembalikan setelah compare_models selesai. Secara default hanya model terbaik yang dikembalikan, namun ini dapat diubah dengan parameter n_select. Misalnya, memberikan n_select = 3 pada fungsi compare_models akan mengembalikan 3 model teratas sebagai sebuah list.
# periksa parameter final model terbaik
best.get_params()
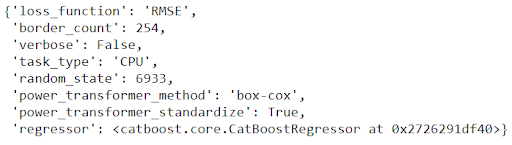
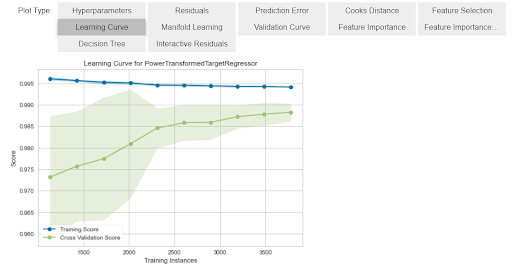
Kita juga dapat memeriksa diagnostik dan beberapa plot analisis lain menggunakan fungsi plot_model.
# periksa residual model terlatih
plot_model(best, plot = 'residuals_interactive')
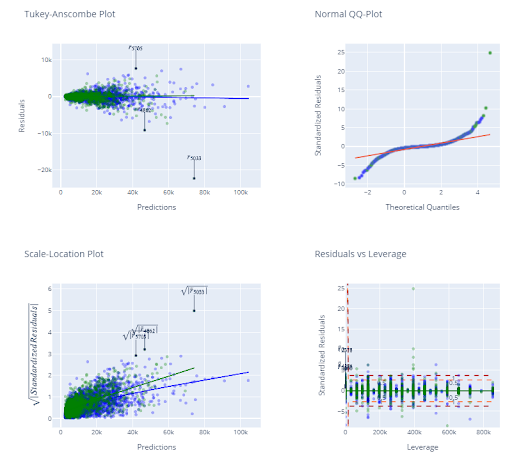
plot_model(best, plot = ‘feature’)
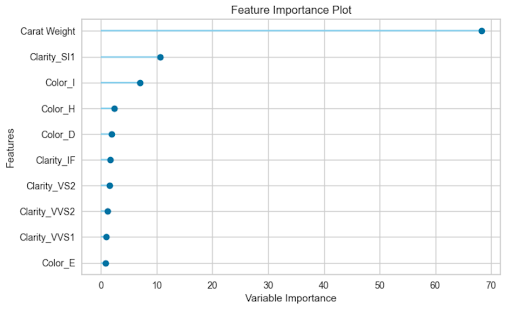
Ada satu fungsi lagi bernama evaluate_model yang memudahkan untuk menavigasi semua plot analisis yang tersedia di Jupyter Notebook.
evaluate_model(best)
Deployment dan pemantauan model ML
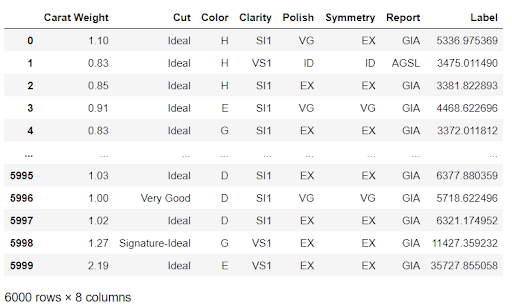
Sekarang kita dapat menggunakan model final untuk menghasilkan prediksi pada data yang belum terlihat dengan fungsi predict_model:
# salin data dan hapus variabel target
data_unseen = data.copy()
data_unseen.drop(‘Price’, axis = 1, inplace = True)
predictions = predict_model(best, data = data_unseen)
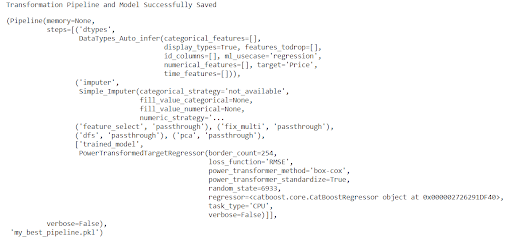
Untuk penggunaan di masa depan, Anda dapat menyimpan seluruh pipeline dengan fungsi save_model.
save_model(best, ‘my_best_pipeline’)
Pencatatan eksperimen
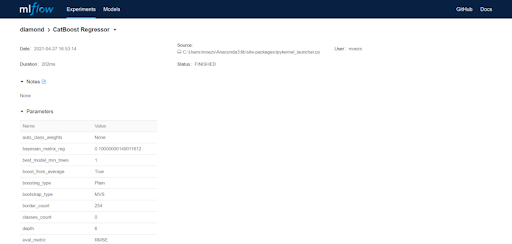
Ingat kita memberikan log_experiment = True pada fungsi setup bersama experiment_name = 'diamond'. Mari lihat apa yang dilakukan PyCaret di belakang layar. Untuk melihatnya, mari jalankan server MLflow:
# di dalam notebook
!mlflow ui

# dari command line
mlflow ui
Sekarang buka peramban Anda dan ketik “localhost:5000”. Akan terbuka UI seperti ini:
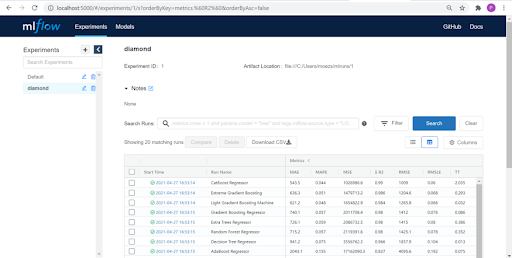
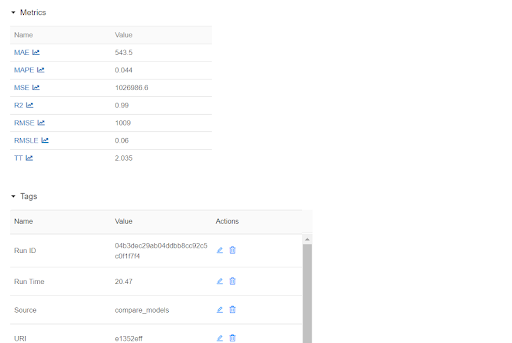
Setiap entri pada tabel di atas merepresentasikan satu training run yang menghasilkan pipeline terlatih dan sekumpulan metadata seperti DateTime run, metrik kinerja, hiperparameter model, tag, dan sebagainya. Mari klik salah satu model:
Peramalan deret waktu PyCaret
Modul deret waktu baru PyCaret kini tersedia dalam versi beta. Tetap setia pada kesederhanaan PyCaret, modul ini konsisten dengan API yang ada dan sarat dengan fungsionalitas. Pengujian statistik, pelatihan dan pemilihan model (30+ algoritme), analisis model, penalaan hiperparameter otomatis, pencatatan eksperimen, deployment ke cloud, dan lainnya. Semua ini hanya dengan beberapa baris kode (sama seperti modul PyCaret lainnya). Jika Anda ingin menggunakan modul beta baru ini, Anda harus memasangnya dalam lingkungan conda terpisah untuk menghindari konflik dependensi.
pip install pycaret-ts-alphaData deret waktu adalah salah satu tipe data paling umum dan memahami cara mengolahnya merupakan keterampilan sains data yang krusial jika Anda ingin membuat prediksi dan melaporkan tren. Jika Anda ingin mempelajari lebih jauh analisis dan peramalan deret waktu di Python, DataCamp memiliki koleksi kursus yang sangat baik. Anda dapat memulai dengan alur belajar Time Series with Python atau salah satu kursus berikut juga merupakan pilihan bagus:
- Introduction to Time Series Analysis in Python
- Machine Learning for Time Series Data in Python
- Time Series Analysis Tutorial
Integrasi PyCaret
| Area | Integrasi |
|---|---|
| Model | scikit-learn, XGBoost, LightGBM, CatBoost |
| Pelatihan GPU | RAPIDS.AI |
| Komputasi Terdistribusi | RAY |
| Penalaan Hiperparameter | tune-sklearn, optuna |
| Plotting & Analisis | plotly, yellowbrick, seaborn, matplotlib |
| NLP | gensim, spacy, nltk |
| MLOps | MLflow |
FAQ PyCaret
-
Apakah PyCaret hanya tersedia di Python? Ya, untuk saat ini PyCaret hanya tersedia di Python.
-
Apa perbedaan PyCaret dengan pustaka pembelajaran mesin open-source lain seperti scikit-learn, XGBoost, LightGBM? Dibandingkan pustaka open-source lainnya, PyCaret adalah pustaka low-code alternatif yang dapat menggantikan ratusan baris kode hanya dengan beberapa baris. PyCaret pada dasarnya adalah pembungkus Python di atas sejumlah pustaka dan kerangka kerja pembelajaran mesin seperti scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray, dan beberapa lainnya.
-
Use case apa saja yang didukung PyCaret? Per rilis 2.3.4, PyCaret mendukung Klasifikasi Biner/Multi-kelas, Regresi, Klasterisasi, Deteksi Anomali, Pemrosesan Bahasa Alami (Pemodelan Topik), dan Penambangan Aturan Asosiasi. PyCaret juga baru-baru ini merilis modul deret waktu baru dalam versi beta sebagai installer pip terpisah.
-
Dapatkah kita menggunakan PyCaret di GPU? Anda dapat melatih model di GPU dalam PyCaret dan mempercepat alur kerja hingga 10x. Untuk melatih model di GPU cukup berikan use_gpu = True pada fungsi setup. Tidak ada perubahan dalam penggunaan API, namun dalam beberapa kasus, pustaka tambahan perlu dipasang karena tidak termasuk dalam versi default atau versi penuh.
-
Dapatkah kita menala hiperparameter model di PyCaret? Ya, Anda dapat menala hiperparameter model apa pun secara otomatis di PyCaret. PyCaret terintegrasi dengan sklearn, optuna, tune-sklearn, dan ray untuk berbagai tuner seperti Random Grid Search atau Bayesian Grid Search.
-
Apakah PyCaret gratis digunakan? PyCaret sepenuhnya gratis dan open-source serta dilisensikan di bawah lisensi MIT.
| Sumber Daya PyCaret | ---- |
|---|---|
| ⭐ Tutorial | Baru di PyCaret? Lihat notebook resmi! |
| 📋 Notebook | Contoh notebook yang dibuat komunitas. |
| 📙 Blog | Tutorial dan artikel dari kontributor. |
| 📚 Dokumentasi | Dok API terperinci PyCaret |
| 📺 Tutorial Video | Video tutorial kami dari berbagai acara. |
| 📢 Diskusi | Punya pertanyaan? Bergabunglah dengan komunitas dan kontributor. |
| 🛠️ <atarget="_blank" href="https://github.com/pycaret/pycaret/blob/master/CHANGELOG.md">Changelog | Perubahan dan riwayat versi. |
| 🌳 Roadmap | Rencana pengembangan perangkat lunak dan komunitas PyCaret. |




