Che cos’è PyCaret
Nota: Questo tutorial è stato creato nel 2021 e PyCaret non è più mantenuto attivamente; alcuni passaggi potrebbero non funzionare con le versioni attuali di DataLab o di altri strumenti.
PyCaret è una libreria open source di machine learning a basso codice per Python che automatizza i workflow di machine learning. È uno strumento end-to-end per il machine learning e la gestione dei modelli che accelera esponenzialmente il ciclo di sperimentazione e ti rende più produttivo.
Rispetto ad altre librerie open source di machine learning, PyCaret è una libreria alternativa low-code che può sostituire centinaia di righe di codice con poche righe soltanto. Questo rende gli esperimenti esponenzialmente più veloci ed efficienti. In sostanza, PyCaret è un wrapper Python che integra diverse librerie e framework di machine learning come scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray e altri ancora.
Il design e la semplicità di PyCaret sono ispirati al ruolo emergente dei citizen data scientist, un termine coniato per la prima volta da Gartner. I citizen data scientist sono utenti esperti in grado di svolgere sia attività analitiche semplici sia di media complessità che in passato avrebbero richiesto maggiore competenza tecnica.
PyCaret è semplice e facile da usare. Tutte le operazioni eseguite in PyCaret vengono archiviate in sequenza in una pipeline completamente orchestrata per la messa in produzione. Che si tratti di imputare valori mancanti, trasformare dati categorici, fare feature engineering o persino il tuning degli iperparametri, PyCaret automatizza tutto. Per saperne di più su PyCaret, guarda questo video di un minuto.
Moduli in PyCaret
L’API di PyCaret è organizzata in moduli. Ogni modulo supporta un tipo di apprendimento supervisionato (classificazione e regressione) o non supervisionato (clustering, rilevamento anomalie, nlp, estrazione di regole associative). Di recente è stato rilasciato in beta un nuovo modulo per il forecasting di serie temporali come pacchetto pip separato.
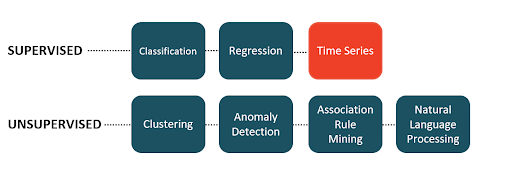 Fonte immagine: [Ali, Moez].
Installare PyCaret
Installare PyCaret con pip è semplice e richiede solo pochi minuti. L’installazione predefinita di PyCaret include solo le dipendenze strettamente necessarie elencate nel file requirements.txt sul repo.
Nota: Questo tutorial è stato creato nel 2021 e PyCaret non è più mantenuto attivamente; alcuni passaggi potrebbero non funzionare con le versioni attuali di DataLab o di altri strumenti.
pip install pycaret
Per installare la versione completa:
pip install pycaret[full]
Funzionalità
Il punto di forza di PyCaret è la sua semplicità. Rispetto ad altri software di AutoML, PyCaret è estremamente flessibile, offre un’API unificata e non ha curva di apprendimento.
PyCaret è ricco di funzionalità. Con poche righe di codice puoi passare dall’elaborazione dei dati all’addestramento dei modelli e quindi al deployment sul cloud. Include molte trasformazioni di preprocessing applicate automaticamente quando l’esperimento viene inizializzato. Il model zoo di PyCaret comprende oltre 70 modelli non addestrati per compiti supervisionati e non supervisionati.
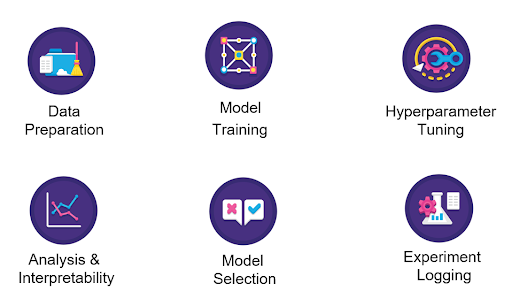
Puoi anche usare PyCaret su GPU e velocizzare il tuo workflow di 10 volte. Per addestrare i modelli su GPU basta passare use_gpu = True nella funzione setup. Nessuna modifica al codice.
PyCaret è una soluzione trasparente. Offre tantissime funzionalità per interagire con il modello e analizzarne prestazioni e risultati. Tutti i grafici standard come matrice di confusione, AUC, residui e importanza delle feature sono disponibili per tutti i modelli. Integra inoltre la libreria SHAP, usata per spiegare l’output di modelli di machine learning complessi basati su alberi.
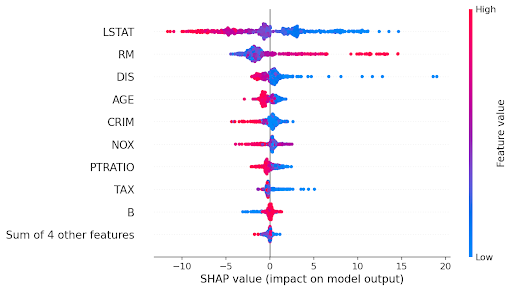 (Esempio di beeswarm plot)
PyCaret si integra anche con MLflow per le funzionalità di MLOps. Registra automaticamente metriche, parametri e artifact quando passi log_experiment = True nella funzione setup.
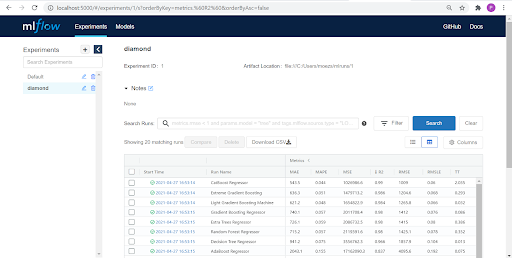 (Immagine dell’autore)
Preprocessing in PyCaret
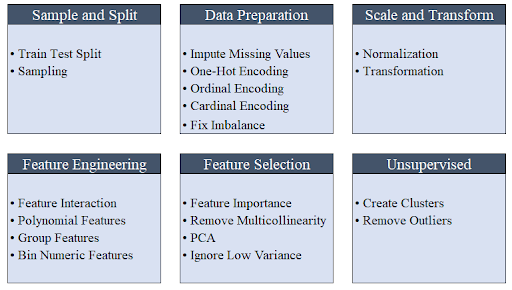
Tutte le trasformazioni di preprocessing vengono applicate all’interno della funzione setup. PyCaret offre oltre 25 diverse trasformazioni di preprocessing definite nella funzione setup. Clicca qui per saperne di più sulle capacità di preprocessing di PyCaret.
 (Immagine dell’autore)
Moduli in PyCaret
| Modulo | Attività |
|---|---|
| pycaret.classification | Supervisionato: Classificazione binaria o multiclasse |
| pycaret.regression | Supervisionato: Regressione |
| pycaret.clustering | Non supervisionato: Clustering |
| pycaret.anomaly | Non supervisionato: Rilevamento anomalie |
| pycaret.nlp | Non supervisionato: Elaborazione del linguaggio naturale (Topic Modeling) |
| pycaret.arules | Non supervisionato: Estrazione di regole associative |
| pycaret.datasets | Dataset |
Esempio: un caso d’uso ML end-to-end
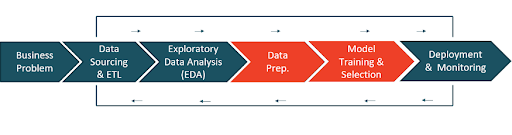
Questo è un tipico workflow di machine learning. Definire correttamente un problema di ML è il primo passo in qualsiasi progetto di machine learning e può richiedere da pochi giorni a settimane per essere inquadrato nel modo giusto.
Il reperimento dei dati e l’ETL (Extract-Transform-Load) possono variare in complessità a seconda della maturità tecnologica e delle dimensioni dell’organizzazione. È normale vedere un team di data engineer lavorare insieme in questa fase.
La fase di Exploratory Data Analysis (EDA) comprende l’esplorazione dei dati grezzi per valutare la qualità dei dati (valori mancanti, outlier, ecc.), la correlazione tra le feature e per testare ipotesi di business.
Per la preparazione dei dati e l’addestramento e la selezione del modello, PyCaret svolge tutto il lavoro pesante dietro le quinte. La preparazione dei dati include trasformazioni come l’imputazione dei valori mancanti, lo scaling (min-max, z-score, ecc.), la codifica categorica (one-hot encoding, ordinal encoding, ecc.), il feature engineering (polinomi, interazioni tra feature, rapporti, ecc.) e la selezione delle feature.
Dopo la preparazione dei dati, la fase di addestramento e selezione del modello prevede il fitting di più algoritmi e la valutazione delle prestazioni usando una qualche strategia di test (per lo più cross-validation).
Infine, il modello scelto (migliore) viene messo in produzione come endpoint API per l’inferenza. Una volta effettuato il deployment, il monitoraggio dell’API e delle prestazioni del modello in produzione prosegue nel tempo.
 (Immagine dell’autore)
Definizione del problema
Prevedere il prezzo di un diamante date le caratteristiche come taglio, colore, forma, ecc.
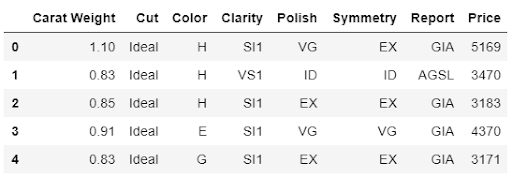
Reperimento dei dati
# load the dataset from pycaret
from pycaret.datasets import get_data
data = get_data('diamond')
Analisi esplorativa dei dati (EDA)
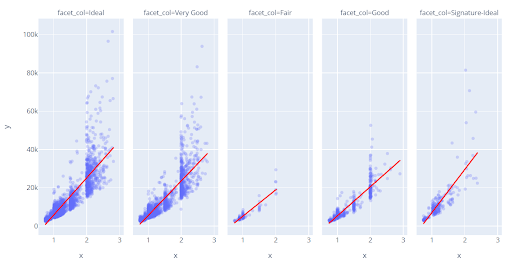
Facciamo qualche rapida visualizzazione per valutare la relazione tra le feature indipendenti (peso, taglio, colore, purezza, ecc.) e la variabile target, ossia il prezzo:
# plot scatter carat_weight and Price
import plotly.express as px
fig = px.scatter(x=data['Carat Weight'], y=data['Price'], facet_col = data['Cut'], opacity = 0.25, trendline='ols', trendline_color_override = 'red')
fig.show()
Verifichiamo l’istogramma della variabile target Price.
# plot histogram
fig = px.histogram(data, x=["Price"])
fig.show()
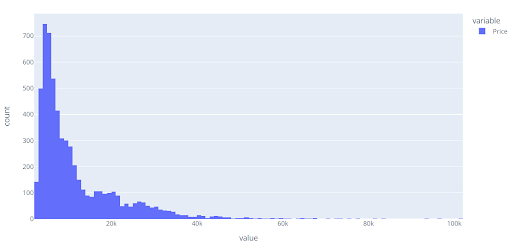
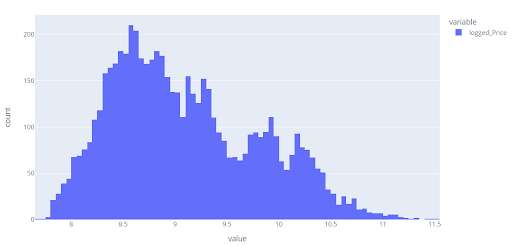
Nota che la distribuzione di Price è asimmetrica a destra; possiamo verificare rapidamente se una trasformazione logaritmica può modificare la distribuzione (forma) della variabile target.
# plot histogram
data['logged_Price'] = np.log(data['Price'])
fig = px.histogram(data, x=["logged_Price"])
fig.show()
Pulizia e preparazione dei dati
Tutti gli esperimenti in PyCaret devono essere inizializzati tramite la funzione setup. È responsabile di tutte le attività di preparazione dei dati necessarie prima dell’addestramento del modello. Oltre ad alcune operazioni di base predefinite, PyCaret offre un’ampia gamma di funzionalità di pre-processing. Clicca qui per saperne di più su tutte le funzionalità di preprocessing in PyCaret.
# initialize setup
from pycaret.regression import *
s = setup(data, target = 'Price', transform_target = True, log_experiment = True, experiment_name = 'diamond')
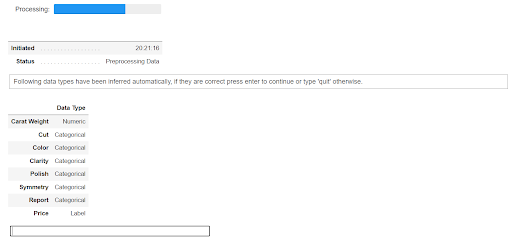
Quando inizializzi la funzione setup in PyCaret, il dataset viene profilato e i tipi di dato per tutte le feature in input vengono inferiti. Se tutti i tipi sono stati inferiti correttamente, puoi premere Invio per continuare. Esiste anche un parametro per sovrascrivere i tipi di dato in PyCaret. Inoltre, se usi PyCaret in uno script Python puoi disattivare questa conferma passando silent = True nella funzione setup.
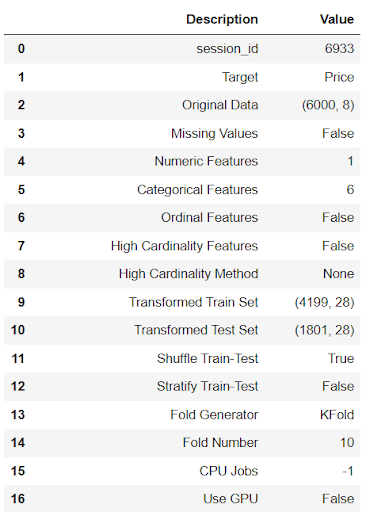 (Output di setup — troncato per la visualizzazione)
Addestramento e selezione del modello di ML
Dopo il setup, i dati trasformati sono disponibili per l’addestramento del modello. Puoi avviare l’addestramento con la funzione compare_models. Verranno addestrati tutti gli algoritmi disponibili nel model zoo e valutate più metriche di prestazione usando la k-fold cross-validation.
# compare all models
best = compare_models()
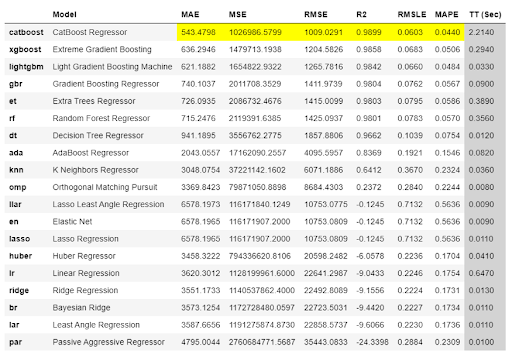 (Output di compare_models)
L’output di compare_models mostra le metriche medie convalidante incrociate per tutti i modelli. L’output è ordinato di default per “R2” (dal più alto al più basso), ma può essere modificato passando un parametro sort alla funzione compare_models.
Al termine di compare_models viene restituito il modello migliore (in questo caso, CatBoost Regressor). Per impostazione predefinita viene restituito solo il migliore, ma questo comportamento può essere cambiato con il parametro n_select. Ad esempio, passando n_select = 3 a compare_models verranno restituiti i 3 migliori modelli come lista.
# check the final params of best model
best.get_params()
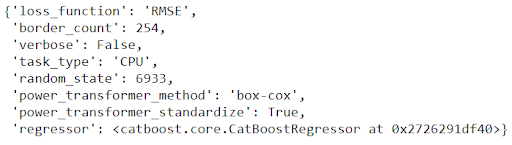
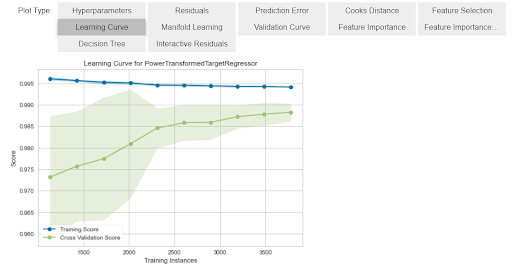
Possiamo anche controllare le diagnostiche e altri grafici di analisi con la funzione plot_model.
# check the residuals of trained model
plot_model(best, plot = 'residuals_interactive')
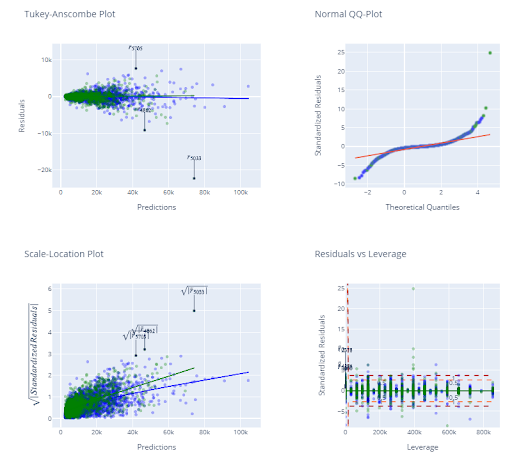
plot_model(best, plot = ‘feature’)
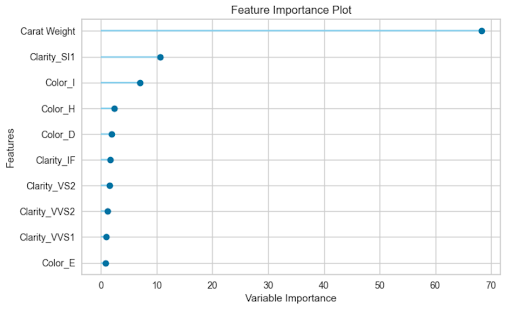
C’è anche una funzione chiamata evaluate_model che è un modo pratico per navigare tra tutti i grafici di analisi disponibili in Jupyter Notebook.
evaluate_model(best)
Deployment e monitoraggio del modello di ML
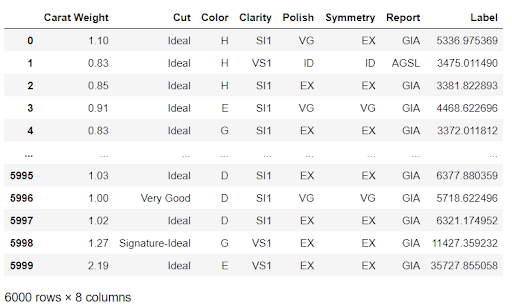
Ora possiamo usare il modello finale per generare previsioni su dati non visti con la funzione predict_model:
# copy data and remove target variable
data_unseen = data.copy()
data_unseen.drop(‘Price’, axis = 1, inplace = True)
predictions = predict_model(best, data = data_unseen)
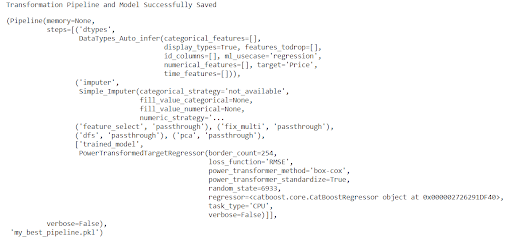
Per usi futuri, puoi salvare l’intera pipeline con la funzione save_model.
save_model(best, ‘my_best_pipeline’)
Registrazione dell’esperimento
Ricorda che abbiamo passato log_experiment = True nella funzione setup insieme a experiment_name = 'diamond'. Vediamo cosa ha fatto PyCaret dietro le quinte. Per vedere la magia, avviamo il server MLflow:
# within notebook
!mlflow ui

# from the command line
mlflow ui
Ora apri il browser e digita “localhost:5000”. Si aprirà un’interfaccia come questa:
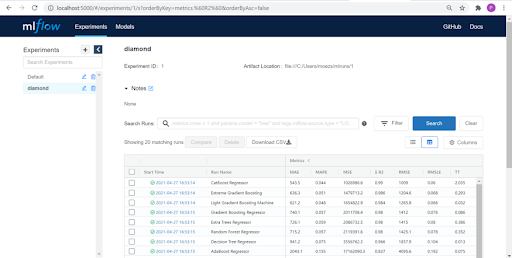
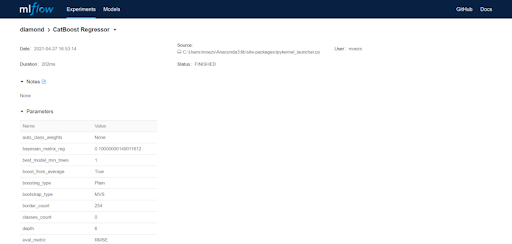
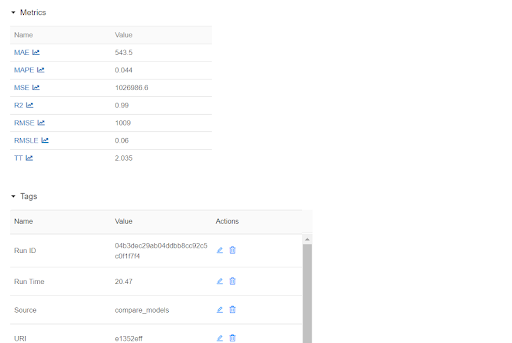
Ogni voce nella tabella sopra rappresenta un run di addestramento che produce una pipeline addestrata e una serie di metadati come data e ora del run, metriche di prestazione, iperparametri del modello, tag, ecc. Clicchiamo su uno dei modelli:
Forecasting con PyCaret per serie temporali
Il nuovo modulo per le serie temporali di PyCaret è ora disponibile in beta. Fedele alla semplicità di PyCaret, è coerente con l’API esistente ed è ricco di funzionalità. Test statistici, addestramento e selezione dei modelli (30+ algoritmi), analisi dei modelli, tuning automatico degli iperparametri, registrazione degli esperimenti, deployment su cloud e altro ancora. Tutto questo con poche righe di codice (proprio come gli altri moduli di PyCaret). Se vuoi usare questo nuovo modulo in beta, devi installarlo in un ambiente conda separato per evitare conflitti di dipendenze.
pip install pycaret-ts-alphaI dati di serie temporali sono tra i tipi di dati più comuni e saperci lavorare è una competenza fondamentale di data science se vuoi fare previsioni e riportare trend. Se vuoi approfondire l’analisi e il forecasting di serie temporali in Python, DataCamp ha un’ottima raccolta di corsi. Puoi iniziare con il percorso di apprendimento Time Series with Python o con uno di questi corsi, ottime scelte:
- Introduzione all’analisi delle serie temporali in Python
- Machine Learning per dati di serie temporali in Python
- Tutorial sull’analisi delle serie temporali
Integrazioni PyCaret
| Area | Integrazioni |
|---|---|
| Modelli | scikit-learn, XGBoost, LightGBM, CatBoost |
| Addestramento su GPU | RAPIDS.AI |
| Calcolo distribuito | RAY |
| Tuning iperparametri | tune-sklearn, optuna |
| Plot e analisi | plotly, yellowbrick, seaborn, matplotlib |
| NLP | gensim, spacy, nltk |
| MLOps | MLflow |
Domande frequenti su PyCaret
-
PyCaret è disponibile solo in Python? Sì, per ora PyCaret è disponibile solo in Python.
-
Qual è la differenza tra PyCaret e altre librerie open source di machine learning come scikit-learn, XGBoost, LightGBM? Rispetto ad altre librerie open source di machine learning, PyCaret è una libreria low-code alternativa che può sostituire centinaia di righe di codice con poche righe soltanto. In sostanza, PyCaret è un wrapper Python che integra diverse librerie e framework di machine learning come scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray e altri ancora.
-
Quali casi d’uso sono supportati in PyCaret? A partire dalla versione 2.3.4 PyCaret supporta classificazione binaria/multiclasse, regressione, clustering, rilevamento anomalie, elaborazione del linguaggio naturale (Topic Modeling) ed estrazione di regole associative. PyCaret ha inoltre rilasciato di recente in beta il nuovo modulo per serie temporali come installer pip separato.
-
Possiamo usare PyCaret su GPU? Puoi addestrare modelli su GPU in PyCaret e velocizzare il tuo workflow di 10 volte. Per addestrare i modelli su GPU basta passare use_gpu = True nella funzione setup. Non cambia l’uso dell’API; tuttavia, in alcuni casi è necessario installare librerie aggiuntive che non sono incluse nella versione predefinita o completa.
-
Possiamo effettuare il tuning degli iperparametri del modello in PyCaret? Sì, puoi eseguire automaticamente il tuning degli iperparametri di qualsiasi modello in PyCaret. Si integra con sklearn, optuna, tune-sklearn e ray per diversi tuner come Random Grid Search o Bayesian Grid Search.
-
PyCaret è gratuito? PyCaret è completamente gratuito e open source ed è distribuito con licenza MIT.
| Risorse PyCaret | ---- |
|---|---|
| ⭐ Tutorial | Nuovo su PyCaret? Dai un’occhiata ai notebook ufficiali! |
| 📋 Notebook | Notebook di esempio creati dalla community. |
| 📙 Blog | Tutorial e articoli dei contributor. |
| 📚 Documentazione | La documentazione dettagliata dell’API di PyCaret |
| 📺 Video Tutorial | I nostri video tutorial da vari eventi. |
| 📢 Discussioni | Domande? Confrontati con la community e i contributor. |
| 🛠️ <atarget="_blank" href="https://github.com/pycaret/pycaret/blob/master/CHANGELOG.md">Changelog | Modifiche e cronologia delle versioni. |
| 🌳 Roadmap | Piano di sviluppo del software e della community di PyCaret. |



