O que é PyCaret
Observação: este tutorial foi criado em 2021, e o PyCaret não é mais mantido ativamente; algumas etapas podem não funcionar nas versões atuais do DataLab ou de outras ferramentas.
PyCaret é uma biblioteca open source de machine learning em Python, de baixo código, que automatiza fluxos de trabalho de ML. É uma ferramenta completa de machine learning e gestão de modelos que acelera exponencialmente o ciclo de experimentos e torna você mais produtivo.
Em comparação com outras bibliotecas open source de machine learning, o PyCaret é uma alternativa low-code que substitui centenas de linhas de código por apenas algumas. Isso torna os experimentos muito mais rápidos e eficientes. Essencialmente, o PyCaret é um wrapper em Python sobre diversas bibliotecas e frameworks de machine learning, como scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray, entre outras.
O design e a simplicidade do PyCaret são inspirados no papel emergente do citizen data scientist, termo cunhado pela Gartner. Citizen data scientists são power users capazes de executar tarefas analíticas simples e de média complexidade que antes exigiam maior especialização técnica.
PyCaret é simples e fácil de usar. Todas as operações realizadas no PyCaret são armazenadas sequencialmente em um pipeline totalmente orquestrado para implantação. Seja para imputar valores ausentes, transformar dados categóricos, fazer engenharia de atributos ou até ajuste de hiperparâmetros, o PyCaret automatiza tudo isso. Para saber mais sobre o PyCaret, assista a este vídeo de um minuto.
Módulos do PyCaret
A API do PyCaret é organizada em módulos. Cada módulo oferece suporte a um tipo de aprendizado supervisionado (classificação e regressão) ou não supervisionado (clusterização, detecção de anomalias, nlp, mineração de regras de associação). Um novo módulo para previsão de séries temporais foi lançado recentemente em beta como um pacote pip separado.
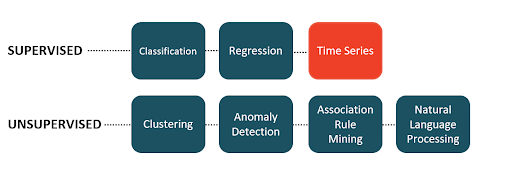 Fonte da imagem: [Ali, Moez].
Instalando o PyCaret
Instalar o PyCaret pelo pip é simples e leva apenas alguns minutos. A instalação padrão do PyCaret inclui apenas as dependências essenciais listadas no arquivo requirements.txt do repositório.
Observação: este tutorial foi criado em 2021, e o PyCaret não é mais mantido ativamente; algumas etapas podem não funcionar nas versões atuais do DataLab ou de outras ferramentas.
pip install pycaret
Para instalar a versão completa:
pip install pycaret[full]
Funcionalidades
O grande diferencial do PyCaret é sua simplicidade. Em comparação com outros softwares de AutoML, o PyCaret é extremamente flexível, tem uma API unificada e praticamente não exige curva de aprendizado.
O PyCaret vem repleto de recursos. Você pode ir do processamento de dados ao treinamento e implantação dos modelos na nuvem com poucas linhas de código. Ele oferece diversas transformações de pré-processamento aplicadas automaticamente quando o experimento é inicializado. O "zoológico de modelos" do PyCaret conta com mais de 70 modelos não treinados para tarefas supervisionadas e não supervisionadas.
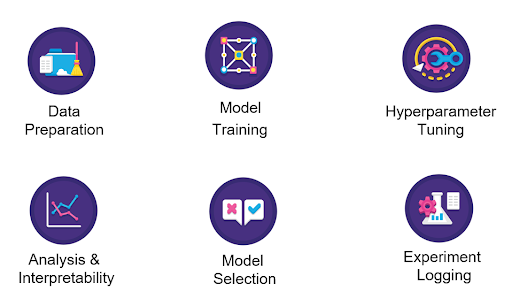
Você também pode usar o PyCaret com GPU e acelerar seu fluxo de trabalho em até 10x. Para treinar modelos na GPU, basta passar use_gpu = True na função setup. Não é preciso mudar mais nada no código.
O PyCaret é uma solução glass-box. Ele oferece várias funcionalidades para interagir com o modelo e analisar o desempenho e os resultados. Todos os gráficos padrão, como matriz de confusão, AUC, resíduos e importância de variáveis, estão disponíveis para todos os modelos. Ele também integra a biblioteca SHAP, usada para explicar a saída de modelos complexos baseados em árvores.
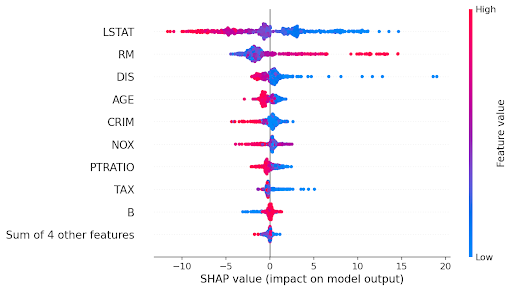 (Exemplo de gráfico beeswarm)
O PyCaret também integra com o MLflow para funcionalidades de MLOps. Ele registra automaticamente métricas, parâmetros e artefatos quando você define log_experiment = True na função setup.
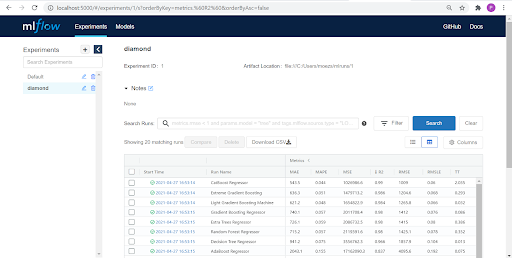 (Imagem do autor)
Pré-processamento no PyCaret
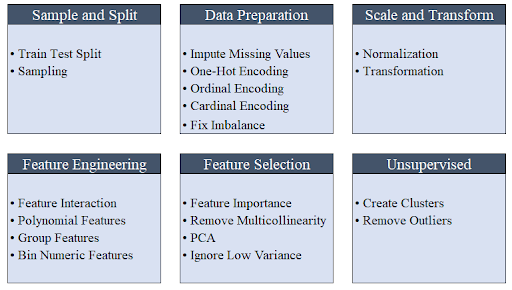
Todas as transformações de pré-processamento são aplicadas dentro da função setup. O PyCaret oferece mais de 25 transformações de pré-processamento definidas nessa função. Clique aqui para saber mais sobre os recursos de pré-processamento do PyCaret.
 (Imagem do autor)
Módulos do PyCaret
| Módulo | Tarefa |
|---|---|
| pycaret.classification | Supervisionado: classificação binária ou multiclasse |
| pycaret.regression | Supervisionado: regressão |
| pycaret.clustering | Não supervisionado: clusterização |
| pycaret.anomaly | Não supervisionado: detecção de anomalias |
| pycaret.nlp | Não supervisionado: processamento de linguagem natural (modelagem de tópicos) |
| pycaret.arules | Não supervisionado: mineração de regras de associação |
| pycaret.datasets | Conjuntos de dados |
Exemplo: um caso de uso de ML de ponta a ponta
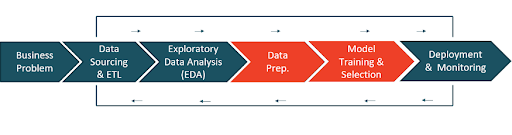
Este é um fluxo típico de machine learning. Formular corretamente o problema de ML é o primeiro passo de qualquer projeto e pode levar de alguns dias a semanas até acertar.
A aquisição de dados e o ETL (Extract-Transform-Load) também variam em complexidade conforme a maturidade tecnológica e o porte da organização. É comum ver um time de engenharia de dados atuando nessa fase.
A fase de análise exploratória de dados (EDA) envolve explorar os dados brutos para avaliar a qualidade (valores ausentes, outliers etc.), a correlação entre atributos e testar hipóteses de negócio.
Para preparação dos dados e treino/seleção de modelos, o PyCaret faz o trabalho pesado nos bastidores. A preparação inclui transformações como imputação de valores ausentes, escalonamento (min-max, z-score etc.), codificação categórica (one-hot encoding, ordinal encoding etc.), engenharia de atributos (polinomial, interação de variáveis, razões etc.) e seleção de atributos.
Após a preparação, a etapa de treinamento e seleção envolve ajustar múltiplos algoritmos e avaliar o desempenho usando alguma estratégia de teste (geralmente validação cruzada).
Por fim, o modelo escolhido (o melhor modelo) é implantado como um endpoint de API para inferência. Depois da implantação, o monitoramento da API e do desempenho do modelo em produção é contínuo.
 (Imagem do autor)
Definição do problema
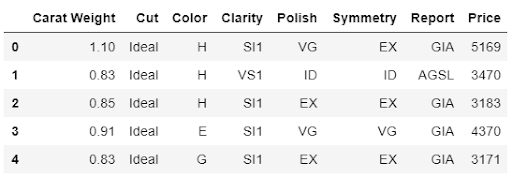
Prever o preço de um diamante a partir de atributos como lapidação, cor, formato etc.
Origem dos dados
# carregar o conjunto de dados do pycaret
from pycaret.datasets import get_data
data = get_data('diamond')
Análise exploratória de dados (EDA)
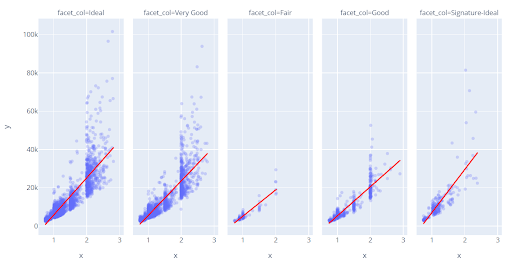
Vamos fazer uma visualização rápida para avaliar a relação dos atributos independentes (peso, lapidação, cor, claridade etc.) com a variável alvo, ou seja, Price:
# plotar dispersão entre carat_weight e Price
import plotly.express as px
fig = px.scatter(x=data['Carat Weight'], y=data['Price'], facet_col = data['Cut'], opacity = 0.25, trendline='ols', trendline_color_override = 'red')
fig.show()
Vamos conferir o histograma da variável alvo Price.
# plotar histograma
fig = px.histogram(data, x=["Price"])
fig.show()
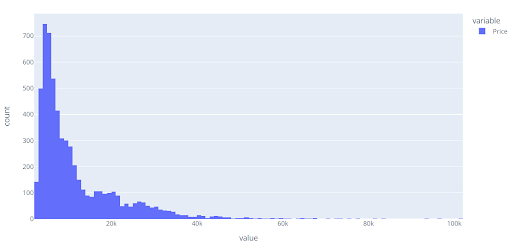
Repare que a distribuição de Price é enviesada à direita. Podemos verificar rapidamente se a transformação log muda a distribuição (o formato) da variável alvo.
# plotar histograma
data['logged_Price'] = np.log(data['Price'])
fig = px.histogram(data, x=["logged_Price"])
fig.show()
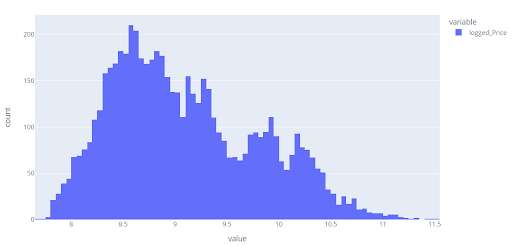
Limpeza e preparação dos dados
Todos os experimentos no PyCaret precisam ser inicializados usando a função setup. Ela é responsável por todas as tarefas de preparação antes do treinamento do modelo. Além de executar alguns processamentos padrão, o PyCaret também oferece uma ampla gama de recursos de pré-processamento. Clique aqui para saber mais sobre todas as funcionalidades de pré-processamento no PyCaret.
# inicializar o setup
from pycaret.regression import *
s = setup(data, target = 'Price', transform_target = True, log_experiment = True, experiment_name = 'diamond')
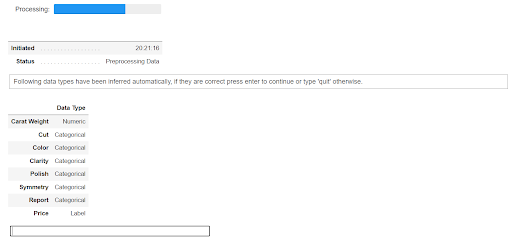
Quando você inicializa a função setup no PyCaret, ele faz o profiling do dataset e infere os tipos de dados de todos os atributos. Se os tipos estiverem corretos, basta pressionar Enter para continuar. Há também um parâmetro para sobrescrever tipos de dados no PyCaret. E, se você estiver usando o PyCaret em um script Python, pode silenciar essa confirmação passando silent = True na função setup.
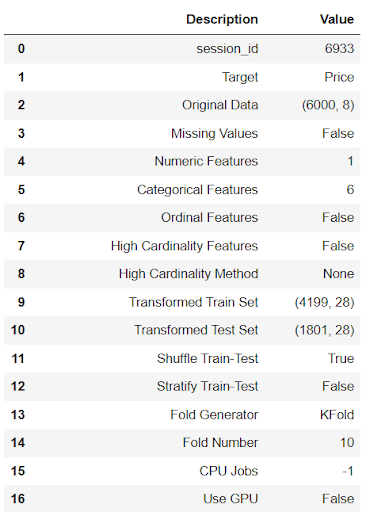 (Saída do setup — trecho para exibição)
Treinamento e seleção de modelos de ML
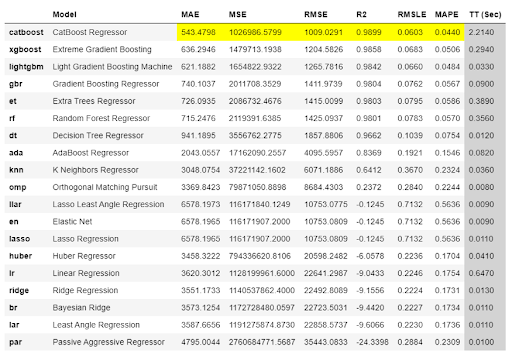
Após o setup, os dados transformados ficam disponíveis para o treinamento. Você pode iniciar o processo com a função compare_models. Ela treina todos os algoritmos disponíveis no zoológico de modelos e avalia várias métricas de desempenho usando validação cruzada k-fold.
# comparar todos os modelos
best = compare_models()
 (Saída do compare_models)
A saída do compare_models mostra as métricas médias da validação cruzada para todos os modelos. Por padrão, a ordenação é por "R2" (da maior para a menor), mas isso pode ser alterado passando o parâmetro sort na função compare_models.
O melhor modelo (neste caso, CatBoost Regressor) é retornado ao final do compare_models. Por padrão, apenas o melhor é retornado, mas isso pode ser alterado com o parâmetro n_select. Por exemplo, n_select = 3 retornará os 3 melhores modelos em uma lista.
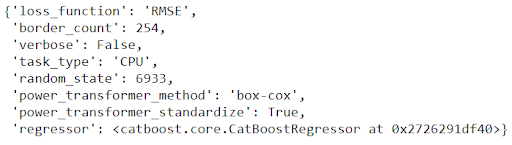
# verificar os parâmetros finais do melhor modelo
best.get_params()
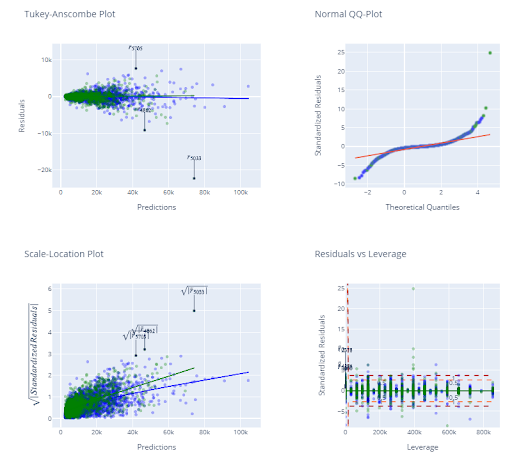
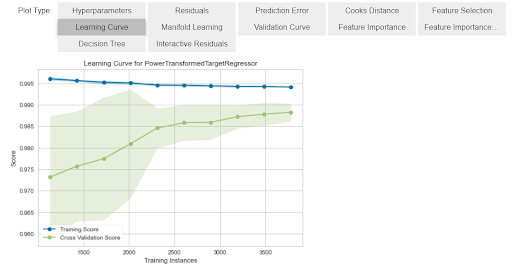
Também podemos checar diagnósticos e alguns gráficos de análise com a função plot_model.
# verificar os resíduos do modelo treinado
plot_model(best, plot = 'residuals_interactive')
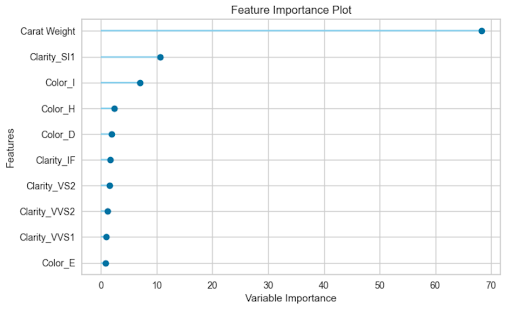
plot_model(best, plot = 'feature')
Há ainda a função evaluate_model, uma forma prática de navegar por todos os gráficos de análise disponíveis no Jupyter Notebook.
evaluate_model(best)
Implantação e monitoramento do modelo de ML
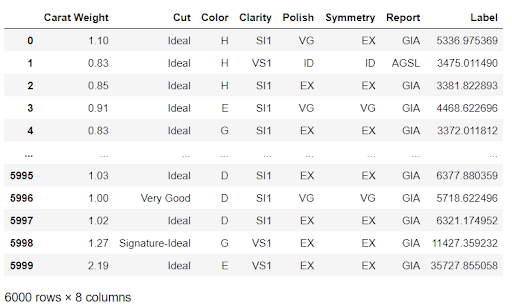
Agora podemos usar o modelo final para gerar previsões em dados não vistos com a função predict_model:
# copiar os dados e remover a variável alvo
data_unseen = data.copy()
data_unseen.drop('Price', axis = 1, inplace = True)
predictions = predict_model(best, data = data_unseen)
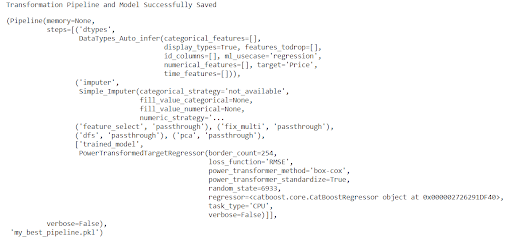
Para uso futuro, você pode salvar todo o pipeline com a função save_model.
save_model(best, 'my_best_pipeline')
Registro de experimentos
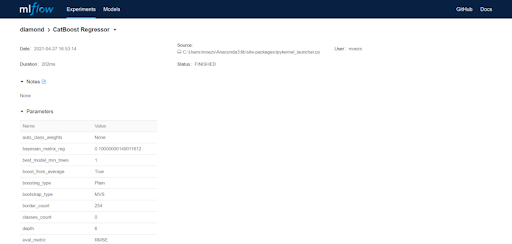
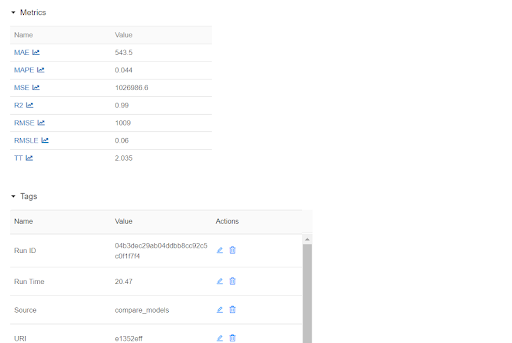
Lembra que passamos log_experiment = True na função setup junto com experiment_name = 'diamond'? Vamos ver o que o PyCaret fez nos bastidores. Para ver a mágica, vamos iniciar o servidor do MLflow:
# dentro do notebook
!mlflow ui

# no terminal
mlflow ui
Agora abra o navegador e digite "localhost:5000". Você verá uma interface como esta:
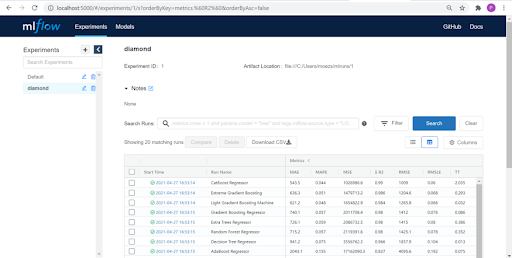
Cada entrada na tabela acima representa uma execução de treinamento que resulta em um pipeline treinado e vários metadados, como data/hora da execução, métricas de desempenho, hiperparâmetros do modelo, tags etc. Vamos clicar em um dos modelos:
Previsão de séries temporais com PyCaret
O novo módulo de séries temporais do PyCaret está disponível em beta. Mantendo a simplicidade do PyCaret, ele é consistente com a API existente e vem cheio de funcionalidades: testes estatísticos, treinamento e seleção de modelos (30+ algoritmos), análise de modelos, ajuste automático de hiperparâmetros, registro de experimentos, implantação na nuvem e mais. Tudo isso com poucas linhas de código (assim como nos outros módulos do PyCaret). Se quiser usar esse novo módulo em beta, instale-o em um ambiente conda separado para evitar conflitos de dependências.
pip install pycaret-ts-alphaDados de séries temporais são um dos tipos mais comuns, e entender como trabalhar com eles é uma habilidade essencial em ciência de dados para fazer previsões e reportar tendências. Se você quer aprender mais sobre análise e previsão de séries temporais em Python, a DataCamp tem uma ótima coleção de cursos. Você pode começar pela trilha de aprendizado Time Series with Python ou conferir um destes cursos:
- Introduction to Time Series Analysis in Python
- Machine Learning for Time Series Data in Python
- Time Series Analysis Tutorial
Integrações do PyCaret
| Área | Integrações |
|---|---|
| Modelos | scikit-learn, XGBoost, LightGBM, CatBoost |
| Treinamento em GPU | RAPIDS.AI |
| Computação distribuída | RAY |
| Ajuste de hiperparâmetros | tune-sklearn, optuna |
| Gráficos e análise | plotly, yellowbrick, seaborn, matplotlib |
| NLP | gensim, spacy, nltk |
| MLOps | MLflow |
Perguntas frequentes sobre PyCaret
-
O PyCaret está disponível apenas em Python? Sim, por enquanto o PyCaret está disponível apenas em Python.
-
Qual a diferença entre o PyCaret e outras bibliotecas open source como scikit-learn, XGBoost, LightGBM? Em comparação com outras bibliotecas open source de machine learning, o PyCaret é uma alternativa low-code que substitui centenas de linhas de código por poucas. Essencialmente, ele é um wrapper em Python sobre várias bibliotecas e frameworks como scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray, entre outras.
-
Quais casos de uso o PyCaret suporta? Na versão 2.3.4, o PyCaret oferece suporte a classificação binária/multiclasse, regressão, clusterização, detecção de anomalias, processamento de linguagem natural (modelagem de tópicos) e mineração de regras de associação. O PyCaret também lançou recentemente seu novo módulo de séries temporais em beta como um instalador pip separado.
-
Podemos usar o PyCaret na GPU? Você pode treinar modelos na GPU com o PyCaret e acelerar seu fluxo de trabalho em até 10x. Para treinar na GPU, basta passar use_gpu = True na função setup. A API não muda; porém, em alguns casos, pode ser necessário instalar bibliotecas adicionais que não vêm na versão padrão ou completa.
-
Podemos ajustar hiperparâmetros de modelos no PyCaret? Sim, é possível ajustar automaticamente os hiperparâmetros de qualquer modelo no PyCaret. Ele integra sklearn, optuna, tune-sklearn e ray para diferentes estratégias, como Random Grid Search ou Bayesian Search.
-
O PyCaret é gratuito? O PyCaret é totalmente gratuito e open source, licenciado sob a licença MIT.
| Recursos do PyCaret | ---- |
|---|---|
| ⭐ Tutoriais | Novo no PyCaret? Confira os notebooks oficiais! |
| 📋 Notebooks | Notebooks de exemplo criados pela comunidade. |
| 📙 Blog | Tutoriais e artigos de colaboradores. |
| 📚 Documentação | A documentação detalhada da API do PyCaret |
| 📺 Videoaulas | Nossas videoaulas de diversos eventos. |
| 📢 Discussões | Tem dúvidas? Converse com a comunidade e os colaboradores. |
| 🛠️ <atarget="_blank" href="https://github.com/pycaret/pycaret/blob/master/CHANGELOG.md">Changelog | Mudanças e histórico de versões. |
| 🌳 Roadmap | Plano de desenvolvimento do software e da comunidade do PyCaret. |



