
Last chance! 50% off DataCamp Premium
Sale ends in
नोट: यह ट्यूटोरियल 2021 में बनाया गया था, और PyCaret अब सक्रिय रूप से मेंटेन नहीं किया जा रहा है; कुछ चरण DataLab या अन्य टूल्स के वर्तमान संस्करणों के साथ काम न करें।
PyCaret Python में एक ओपन-सोर्स, लो-कोड मशीन लर्निंग लाइब्रेरी है जो मशीन लर्निंग वर्कफ़्लोज़ को ऑटोमेट करती है। यह एक एंड-टू-एंड मशीन लर्निंग और मॉडल मैनेजमेंट टूल है जो प्रयोग चक्र को कई गुना तेज़ कर देता है और आपको अधिक उत्पादक बनाता है।
अन्य ओपन-सोर्स मशीन लर्निंग लाइब्रेरियों की तुलना में, PyCaret एक वैकल्पिक लो-कोड लाइब्रेरी है जो सैकड़ों लाइनों के कोड को कुछ ही लाइनों से बदल सकती है। इससे प्रयोग अत्यधिक तेज़ और अधिक कुशल हो जाते हैं। मूल रूप से PyCaret कई मशीन लर्निंग लाइब्रेरियों और फ़्रेमवर्क जैसे scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray आदि के चारों ओर एक Python रैपर है।
PyCaret का डिज़ाइन और सरलता, Gartner द्वारा पहली बार उपयोग किए गए शब्द “सिटिजन डेटा साइंटिस्ट” की उभरती भूमिका से प्रेरित है। सिटिजन डेटा साइंटिस्ट वे पावर यूज़र होते हैं जो पहले अधिक तकनीकी विशेषज्ञता की आवश्यकता वाले सरल और मध्यम जटिल विश्लेषणात्मक कार्य कर सकते हैं।
PyCaret सरल और उपयोग में आसान है। PyCaret में किए गए सभी ऑपरेशंस एक पाइपलाइन में क्रमवार संग्रहीत होते हैं, जो डिप्लॉयमेंट के लिए पूरी तरह व्यवस्थित रहती है। चाहे वह मिसिंग वैल्यू इम्प्यूटेशन हो, केटेगोरिकल डेटा ट्रांसफॉर्मेशन, फीचर इंजीनियरिंग, या हाइपरपैरामीटर ट्यूनिंग—PyCaret यह सब ऑटोमेट कर देता है। PyCaret के बारे में अधिक जानने के लिए यह एक मिनट का वीडियो देखें।
PyCaret का API मॉड्यूल्स में व्यवस्थित है। प्रत्येक मॉड्यूल एक प्रकार का सुपरवाइज़्ड लर्निंग (classification और regression) या अनसुपरवाइज़्ड लर्निंग (clustering, anomaly detection, nlp, association rules mining) का समर्थन करता है। टाइम सीरीज़ फोरकास्टिंग के लिए एक नया मॉड्यूल हाल ही में बीटा में एक अलग pip पैकेज के रूप में जारी किया गया था।
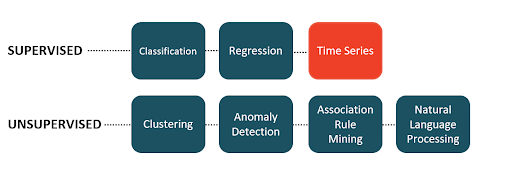 Image source: [Ali, Moez].
pip के ज़रिए PyCaret इंस्टॉल करना आसान है और इसमें केवल कुछ मिनट लगते हैं। PyCaret की डिफ़ॉल्ट इंस्टॉलेशन केवल हार्ड डिपेंडेंसीज़ इंस्टॉल करती है जैसा कि requirements.txt फ़ाइल में रेपो पर सूचीबद्ध है।
नोट: यह ट्यूटोरियल 2021 में बनाया गया था, और PyCaret अब सक्रिय रूप से मेंटेन नहीं किया जा रहा है; कुछ चरण DataLab या अन्य टूल्स के वर्तमान संस्करणों के साथ काम न करें।
pip install pycaret
फुल वर्ज़न इंस्टॉल करने के लिए:
pip install pycaret[full]
PyCaret की प्रसिद्धि का दावा इसकी सरलता है। अन्य ऑटोमेटेड मशीन लर्निंग सॉफ़्टवेयर की तुलना में, PyCaret अत्यंत लचीला है, एकीकृत API के साथ आता है, और इसका कोई लर्निंग कर्व नहीं है।
PyCaret ढेर सारी क्षमताओं से लैस है। आप कुछ ही लाइनों के कोड में अपने डेटा को प्रोसेस करने से लेकर मॉडल ट्रेनिंग और फिर उन्हें क्लाउड पर डिप्लॉय करने तक जा सकते हैं। इसमें कई प्रीप्रोसेसिंग ट्रांसफ़ॉर्मेशन आते हैं, जो प्रयोग के इनिशियलाइज़ होते ही स्वतः लागू हो जाते हैं। PyCaret के मॉडल ज़ू में सुपरवाइज़्ड और अनसुपरवाइज़्ड टास्क के लिए 70 से अधिक अनट्रेनड मॉडल हैं।
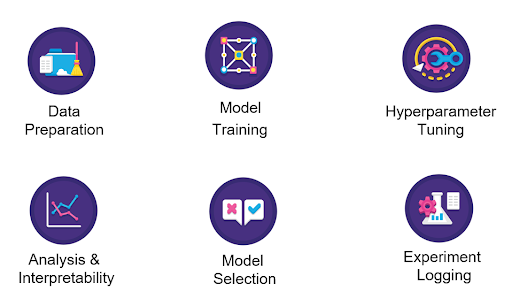
आप PyCaret को GPU पर भी चला सकते हैं और अपने वर्कफ़्लो को 10x तक तेज़ कर सकते हैं। GPU पर मॉडल ट्रेन करने के लिए बस setup फ़ंक्शन में use_gpu = True पास करें। कोड में और कोई बदलाव नहीं।
PyCaret एक ग्लास-बॉक्स समाधान है। यह मॉडल के साथ इंटरैक्ट करने और परफॉर्मेंस व परिणामों का विश्लेषण करने के लिए ढेर सारी सुविधाएँ देता है। सभी मानक प्लॉट जैसे कंफ्यूज़न मैट्रिक्स, AUC, रेजिडुअल्स, और फीचर इम्पॉर्टेंस सभी मॉडलों के लिए उपलब्ध हैं। इसका SHAP लाइब्रेरी के साथ भी इंटीग्रेशन है, जो जटिल ट्री-आधारित मशीन लर्निंग मॉडलों के आउटपुट को समझाने के लिए इस्तेमाल होती है।
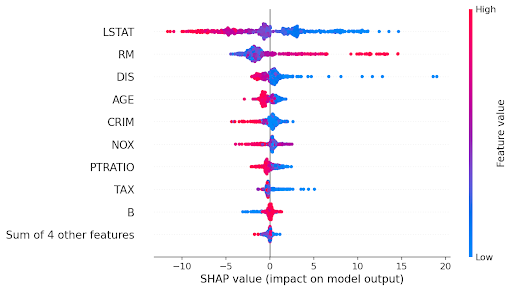 (बीस्वॉर्म प्लॉट का एक उदाहरण)
PyCaret अपने MLOps फ़ंक्शनैलिटी के लिए MLflow के साथ भी इंटीग्रेट होता है। setup फ़ंक्शन में log_experiment = True पास करने पर यह स्वतः मेट्रिक्स, पैरामीटर्स और आर्टिफैक्ट्स लॉग कर देता है।
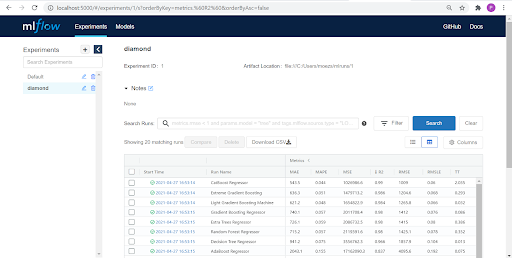 (Image by Author)
सभी प्रीप्रोसेसिंग ट्रांसफ़ॉर्मेशन setup फ़ंक्शन के भीतर लागू होते हैं। PyCaret setup फ़ंक्शन में परिभाषित 25 से अधिक अलग-अलग प्रीप्रोसेसिंग ट्रांसफ़ॉर्मेशन प्रदान करता है। PyCaret की प्रीप्रोसेसिंग क्षमताओं के बारे में अधिक जानने के लिए यहाँ क्लिक करें।
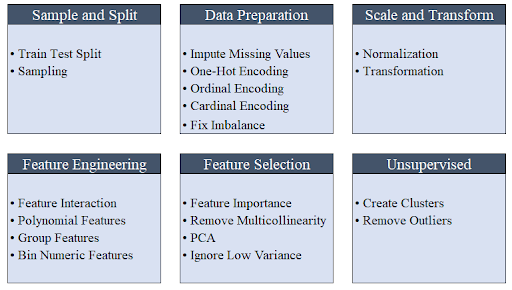 (Image by Author)
| मॉड्यूल | कार्य |
|---|---|
| pycaret.classification | सुपरवाइज़्ड: बाइनरी या मल्टी-क्लास क्लासिफिकेशन |
| pycaret.regression | सुपरवाइज़्ड: रिग्रेशन |
| pycaret.clustering | अनसुपरवाइज़्ड: क्लस्टरिंग |
| pycaret.anomaly | अनसुपरवाइज़्ड: एनोमली डिटेक्शन |
| pycaret.nlp | अनसुपरवाइज़्ड: नैचुरल लैंग्वेज प्रोसेसिंग (टॉपिक मॉडलिंग) |
| pycaret.arules | अनसुपरवाइज़्ड: असोसिएशन रूल्स माइनिंग |
| pycaret.datasets | डेटासेट्स |
यह एक सामान्य मशीन लर्निंग वर्कफ़्लो है। किसी भी मशीन लर्निंग प्रोजेक्ट में ML समस्या को सही ढंग से फ्रेम करना पहला कदम होता है और इसे सही तरह से फ्रेम करने में कुछ दिन से लेकर सप्ताह तक लग सकते हैं।
डेटा सोर्सिंग और ETL (Extract-Transform-Load) की जटिलता संगठन की तकनीकी परिपक्वता और आकार पर निर्भर करती है। इस चरण में डेटा इंजीनियरों की एक टीम का साथ मिलकर काम करना सामान्य है।
एक्सप्लोरेटरी डेटा एनालिसिस (EDA) चरण में कच्चे डेटा का अन्वेषण शामिल है ताकि डेटा की गुणवत्ता (मिसिंग वैल्यू, आउटलायर्स, आदि), फीचर्स के बीच सहसंबंध, और व्यावसायिक परिकल्पनाओं का परीक्षण किया जा सके।
डेटा प्रिपरेशन और मॉडल ट्रेनिंग व चयन के लिए, PyCaret पर्दे के पीछे भारी काम करता है। डेटा प्रिपरेशन में ट्रांसफ़ॉर्मेशन शामिल हैं जैसे मिसिंग वैल्यू इम्प्यूटेशन, स्केलिंग (मिन-मैक्स, z-स्कोर, आदि), केटेगोरिकल एनकोडिंग (वन-हॉट-एनकोडिंग, ऑर्डिनल एनकोडिंग, आदि), फीचर इंजीनियरिंग (पॉलीनॉमियल, फीचर इंटरैक्शन, रेशियो, आदि), और फीचर सेलेक्शन।
डेटा प्रिपरेशन के बाद, मॉडल ट्रेनिंग और चयन चरण में कई एल्गोरिद्म फिट करना और किसी परीक्षण रणनीति (अधिकतर क्रॉस-वैलिडेशन) का उपयोग करके परफॉर्मेंस का मूल्यांकन करना शामिल होता है।
अंत में, चुने गए (सर्वश्रेष्ठ मॉडल) को इन्फरेंस के लिए API एंड-पॉइंट के रूप में डिप्लॉय किया जाता है। डिप्लॉयमेंट के बाद, प्रोडक्शन में API की मॉनिटरिंग और मॉडल परफॉर्मेंस पर नज़र रखना लगातार चलता रहता है।
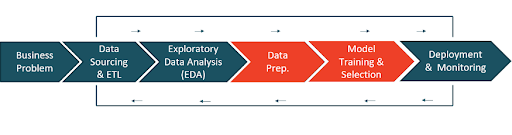 (An Image by Author)
कट, रंग, आकार आदि जैसे गुणों के आधार पर हीरे की कीमत का पूर्वानुमान लगाएँ।
# load the dataset from pycaret
from pycaret.datasets import get_data
data = get_data('diamond')
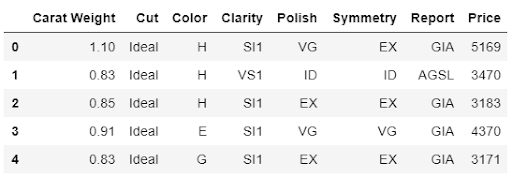
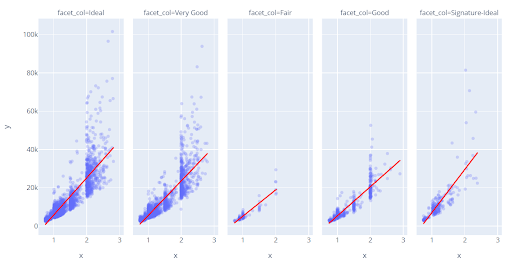
स्वतंत्र फीचर्स (वज़न, कट, रंग, क्लैरिटी आदि) और लक्ष्य चर यानी Price के बीच संबंध का आकलन करने के लिए कुछ त्वरित विज़ुअलाइज़ेशन करते हैं:
# plot scatter carat_weight and Price
import plotly.express as px
fig = px.scatter(x=data['Carat Weight'], y=data['Price'], facet_col = data['Cut'], opacity = 0.25, trendline='ols', trendline_color_override = 'red')
fig.show()
लक्ष्य चर Price का हिस्टोग्राम जाँचते हैं।
# plot histogram
fig = px.histogram(data, x=["Price"])
fig.show()
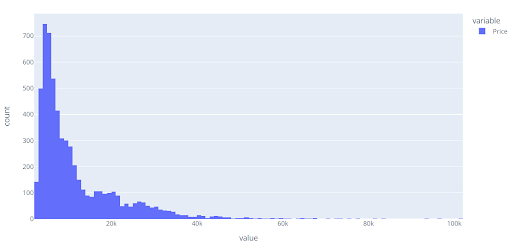
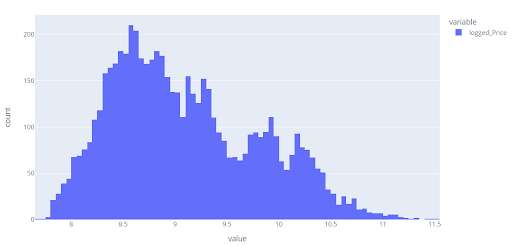
ध्यान दें कि Price का वितरण दाईं ओर झुका हुआ है; हम जल्दी से जाँच सकते हैं कि क्या लॉग ट्रांसफ़ॉर्मेशन लक्ष्य चर के वितरण (आकृति) को बदल सकता है।
# plot histogram
data['logged_Price'] = np.log(data['Price'])
fig = px.histogram(data, x=["logged_Price"])
fig.show()
PyCaret में सभी प्रयोगों को setup फ़ंक्शन का उपयोग करके इनिशियलाइज़ करना आवश्यक है। यह मॉडल ट्रेनिंग से पहले आवश्यक सभी डेटा प्रिपरेशन कार्यों के लिए ज़िम्मेदार होता है। कुछ डिफ़ॉल्ट प्रोसेसिंग कार्यों को करने के अलावा, PyCaret कई प्रकार की प्री-प्रोसेसिंग विशेषताएँ भी प्रदान करता है। PyCaret में सभी प्रीप्रोसेसिंग फ़ंक्शनैलिटीज़ के बारे में अधिक जानने के लिए यहाँ क्लिक करें।
# initialize setup
from pycaret.regression import *
s = setup(data, target = 'Price', transform_target = True, log_experiment = True, experiment_name = 'diamond')
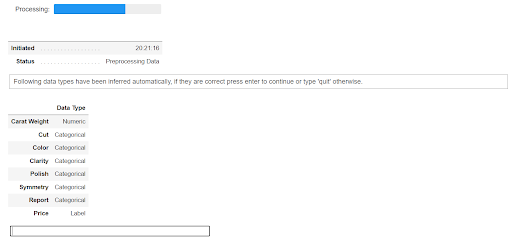
जब आप PyCaret में setup फ़ंक्शन इनिशियलाइज़ करते हैं, तो यह डेटासेट को प्रोफ़ाइल करता है और सभी इनपुट फीचर्स के लिए डेटा टाइप्स का अनुमान लगाता है। यदि सभी डेटा टाइप्स सही तरह से इन्फर हो गए हैं, तो आप जारी रखने के लिए एंटर दबा सकते हैं। PyCaret में डेटा टाइप्स को ओवरराइट करने के लिए एक पैरामीटर भी है। साथ ही, यदि आप PyCaret को Python स्क्रिप्ट में उपयोग कर रहे हैं, तो setup फ़ंक्शन में silent = True पास करके इस पुष्टि को साइलेंट किया जा सकता है।
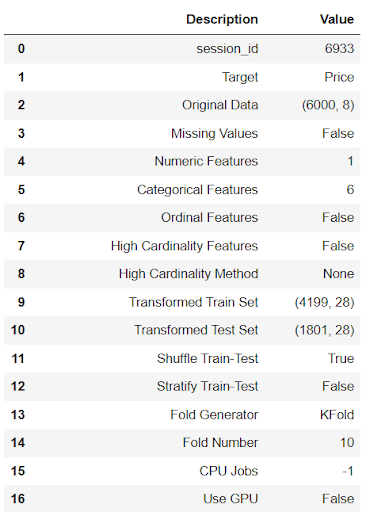 (setup से आउटपुट — प्रदर्शन हेतु संक्षिप्त)
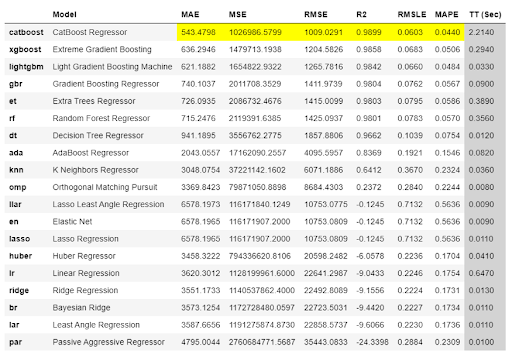
setup के बाद, ट्रांसफ़ॉर्म किया हुआ डेटा मॉडल ट्रेनिंग के लिए उपलब्ध हो जाता है। आप compare_models फ़ंक्शन से ट्रेनिंग प्रक्रिया शुरू कर सकते हैं। यह मॉडल ज़ू में उपलब्ध सभी एल्गोरिद्म को ट्रेन करेगा और k-fold क्रॉस-वैलिडेशन का उपयोग करके कई परफॉर्मेंस मैट्रिक्स का मूल्यांकन करेगा।
# compare all models
best = compare_models()
 (compare_models का आउटपुट)
compare_models का आउटपुट सभी मॉडलों के औसत क्रॉस-वैलिडेटेड मैट्रिक्स दिखाता है। आउटपुट डिफ़ॉल्ट रूप से ‘R2’ (उच्च से निम्न) के अनुसार सॉर्ट होता है, लेकिन compare_models फ़ंक्शन में sort पैरामीटर पास करके इसे बदला जा सकता है।
compare_models पूरा होने पर सर्वश्रेष्ठ मॉडल (इस मामले में, CatBoost Regressor) लौटाता है। डिफ़ॉल्ट रूप से केवल सर्वश्रेष्ठ मॉडल लौटाया जाता है, लेकिन इसे n_select पैरामीटर से बदला जा सकता है। उदाहरण के लिए, compare_models में n_select = 3 पास करने पर शीर्ष 3 मॉडल एक सूची के रूप में लौटेंगे।
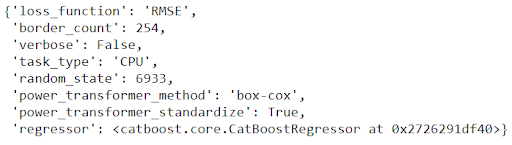
# check the final params of best model
best.get_params()
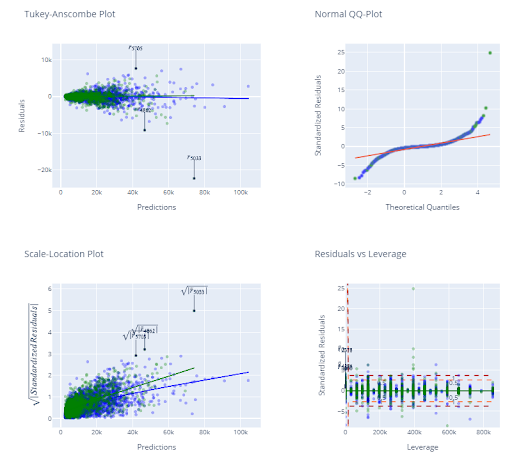
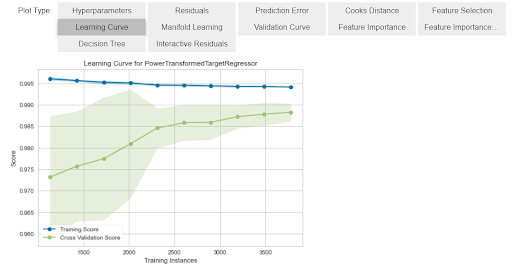
हम plot_model फ़ंक्शन का उपयोग करके डायग्नॉस्टिक्स और कुछ अन्य विश्लेषण प्लॉट भी देख सकते हैं।
# check the residuals of trained model
plot_model(best, plot = 'residuals_interactive')
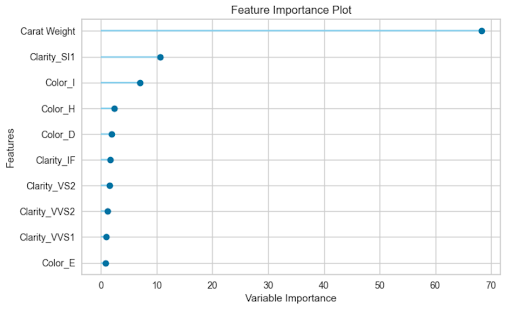
plot_model(best, plot = ‘feature’)
evaluate_model नामक एक और फ़ंक्शन है जो Jupyter Notebook में उपलब्ध सभी विश्लेषण प्लॉट्स पर नेविगेट करने का सुविधाजनक तरीका है।
evaluate_model(best)
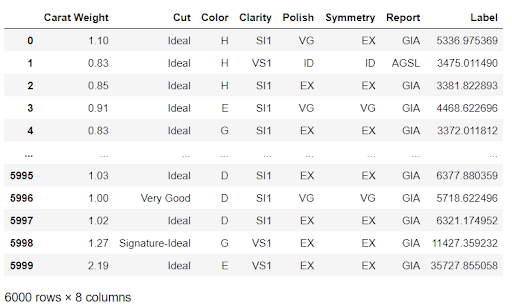
अब हम predict_model फ़ंक्शन का उपयोग करके अनदेखे डेटा पर प्रेडिक्शन जेनरेट कर सकते हैं:
# copy data and remove target variable
data_unseen = data.copy()
data_unseen.drop(‘Price’, axis = 1, inplace = True)
predictions = predict_model(best, data = data_unseen)
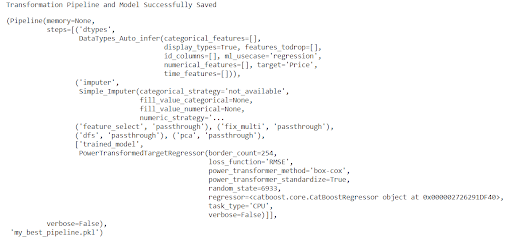
भविष्य में उपयोग के लिए, आप save_model फ़ंक्शन से पूरी पाइपलाइन सहेज सकते हैं।
save_model(best, ‘my_best_pipeline’)
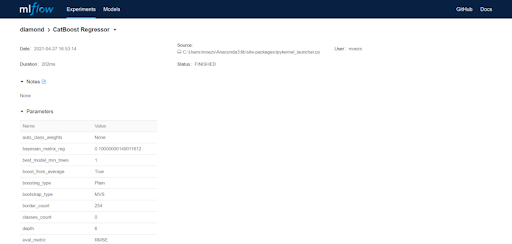
याद रखें कि हमने setup फ़ंक्शन में log_experiment = True के साथ experiment_name = 'diamond' पास किया था। देखें कि PyCaret ने पर्दे के पीछे क्या किया है। यह जादू देखने के लिए, MLflow सर्वर शुरू करते हैं:
# within notebook
!mlflow ui

# from the command line
mlflow ui
अब अपना ब्राउज़र खोलें और “localhost:5000” टाइप करें। एक ऐसा UI खुलेगा:
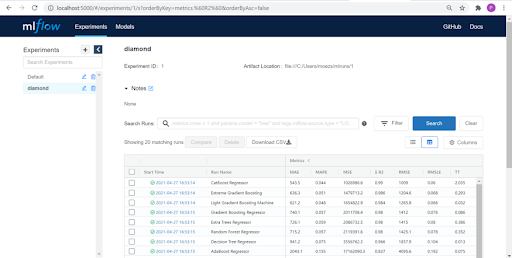
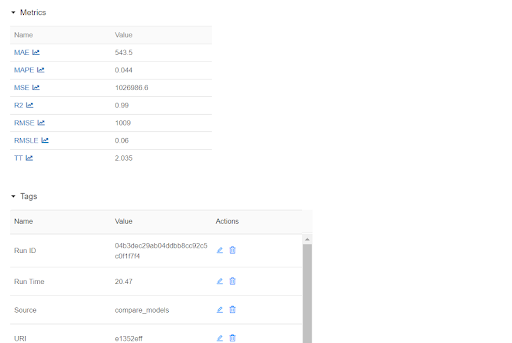
ऊपर की तालिका में प्रत्येक प्रविष्टि एक ट्रेनिंग रन का प्रतिनिधित्व करती है, जिसके परिणामस्वरूप एक प्रशिक्षित पाइपलाइन और मेटाडेटा का एक समूह बनता है, जैसे रन की दिनांक-समय, परफॉर्मेंस मैट्रिक्स, मॉडल हाइपरपैरामीटर्स, टैग्स, आदि। आइए मॉडलों में से किसी एक पर क्लिक करें:
PyCaret का नया टाइम सीरीज़ मॉड्यूल अब बीटा में उपलब्ध है। PyCaret की सरलता के अनुरूप, यह मौजूदा API के साथ संगत है और पूरी तरह फीचर-समृद्ध है। सांख्यिकीय परीक्षण, मॉडल ट्रेनिंग और चयन (30+ एल्गोरिद्म), मॉडल विश्लेषण, ऑटोमेटेड हाइपरपैरामीटर ट्यूनिंग, प्रयोग लॉगिंग, क्लाउड पर डिप्लॉयमेंट, और बहुत कुछ। यह सब कुछ केवल कुछ लाइनों के कोड से (ठीक अन्य मॉड्यूल्स की तरह)। यदि आप इस नए मॉड्यूल को बीटा में उपयोग करना चाहते हैं, तो डिपेंडेंसी कॉन्फ्लिक्ट से बचने के लिए आपको इसे एक अलग conda एन्वायरनमेंट में इंस्टॉल करना होगा।
pip install pycaret-ts-alphaटाइम सीरीज़ डेटा सबसे आम डेटा प्रकारों में से एक है, और इसके साथ काम करना समझना एक महत्वपूर्ण डेटा साइंस कौशल है यदि आप पूर्वानुमान लगाना और ट्रेंड्स पर रिपोर्ट करना चाहते हैं। यदि आप Python में टाइम-सीरीज़ विश्लेषण और फोरकास्टिंग के बारे में अधिक सीखना चाहते हैं, तो DataCamp के पास बेहतरीन कोर्स संग्रह है। आप Time Series with Python लर्निंग ट्रैक से शुरू कर सकते हैं, या इन कोर्सों में से कोई भी बढ़िया विकल्प होगा:
| क्षेत्र | इंटीग्रेशंस |
|---|---|
| मॉडल्स | scikit-learn, XGBoost, LightGBM, CatBoost |
| GPU ट्रेनिंग | RAPIDS.AI |
| डिस्ट्रिब्यूटेड कंप्यूटिंग | RAY |
| हाइपरपैरामीटर ट्यूनिंग | tune-sklearn, optuna |
| प्लॉटिंग और विश्लेषण | plotly, yellowbrick, seaborn, matplotlib |
| NLP | gensim, spacy, nltk |
| MLOps | MLflow |
क्या PyCaret केवल Python में उपलब्ध है? हाँ, फिलहाल PyCaret केवल Python में ही उपलब्ध है।
PyCaret और अन्य ओपन-सोर्स मशीन लर्निंग लाइब्रेरी जैसे scikit-learn, XGBoost, LightGBM में क्या अंतर है? अन्य ओपन-सोर्स मशीन लर्निंग लाइब्रेरियों की तुलना में, PyCaret एक वैकल्पिक लो-कोड लाइब्रेरी है जो सैकड़ों लाइनों के कोड को कुछ ही लाइनों से बदल सकती है। मूल रूप से PyCaret कई मशीन लर्निंग लाइब्रेरी और फ़्रेमवर्क जैसे scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray आदि के चारों ओर एक Python रैपर है।
PyCaret में कौन से उपयोग-परिदृश्य समर्थित हैं? रिलीज़ 2.3.4 के अनुसार PyCaret बाइनरी/मल्टी-क्लास क्लासिफिकेशन, रिग्रेशन, क्लस्टरिंग, एनोमली डिटेक्शन, नैचुरल लैंग्वेज प्रोसेसिंग (टॉपिक मॉडलिंग), और असोसिएशन रूल्स माइनिंग का समर्थन करता है। PyCaret ने हाल ही में अपना नया टाइम-सीरीज़ मॉड्यूल बीटा में एक अलग pip इंस्टॉलर के रूप में जारी किया है।
क्या हम PyCaret को GPU पर उपयोग कर सकते हैं? आप PyCaret में GPU पर मॉडल ट्रेन कर सकते हैं और अपने वर्कफ़्लो को 10x तक तेज़ कर सकते हैं। GPU पर मॉडल ट्रेन करने के लिए बस setup फ़ंक्शन में use_gpu = True पास करें। API के उपयोग में कोई बदलाव नहीं है, हालाँकि कुछ मामलों में अतिरिक्त लाइब्रेरियाँ इंस्टॉल करनी पड़ सकती हैं, क्योंकि वे डिफ़ॉल्ट या फुल वर्ज़न के साथ इंस्टॉल नहीं होतीं।
क्या हम PyCaret में मॉडल के हाइपरपैरामीटर्स ट्यून कर सकते हैं? हाँ, आप PyCaret में किसी भी मॉडल के हाइपरपैरामीटर्स को स्वतः ट्यून कर सकते हैं। यह sklearn, optuna, tune-sklearn, और ray के साथ इंटीग्रेट होता है, ताकि Random Grid Search या Bayesian Grid Search जैसे अलग-अलग ट्यूनर्स का उपयोग किया जा सके।
क्या PyCaret उपयोग के लिए मुफ़्त है? PyCaret पूरी तरह मुफ़्त और ओपन-सोर्स है और MIT लाइसेंस के अंतर्गत लाइसेंस प्राप्त है।
| PyCaret संसाधन | ---- |
|---|---|
| ⭐ ट्यूटोरियल्स | PyCaret में नए हैं? आधिकारिक नोटबुक्स देखें! |
| 📋 नोटबुक्स | समुदाय द्वारा बनाई गई उदाहरण नोटबुक्स। |
| 📙 ब्लॉग | योगदानकर्ताओं द्वारा ट्यूटोरियल्स और लेख। |
| 📚 प्रलेखन | PyCaret का विस्तृत API डॉक्यूमेंटेशन |
| 📺 वीडियो ट्यूटोरियल्स | विभिन्न इवेंट्स से हमारे वीडियो ट्यूटोरियल्स। |
| 📢 चर्चाएँ | सवाल हैं? समुदाय और योगदानकर्ताओं से जुड़ें। |
| 🛠️ <atarget="_blank" href="https://github.com/pycaret/pycaret/blob/master/CHANGELOG.md">Changelog | परिवर्तन और वर्ज़न इतिहास। |
| 🌳 रोडमैप | PyCaret का सॉफ़्टवेयर और समुदाय विकास प्लान। |