
Last chance! 50% off DataCamp Premium
Sale ends in
Let op: Deze tutorial is gemaakt in 2021 en PyCaret wordt niet langer actief onderhouden; sommige stappen werken mogelijk niet met de huidige versies van DataLab of andere tools.
PyCaret is een open-source, low-code machine learning-bibliotheek in Python die ML-workflows automatiseert. Het is een end-to-end tool voor machine learning en modelbeheer die de experimentcyclus exponentieel versnelt en je productiever maakt.
Vergeleken met andere open-source machine learning-bibliotheken is PyCaret een alternatieve low-code bibliotheek die honderden regels code kan vervangen door slechts een paar. Dit maakt experimenten exponentieel sneller en efficiënter. PyCaret is in essentie een Python-wrapper om verschillende machine learning-bibliotheken en -frameworks heen, zoals scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray en nog enkele anderen.
Het ontwerp en de eenvoud van PyCaret zijn geïnspireerd op de opkomende rol van de citizen data scientist, een term die voor het eerst door Gartner werd gebruikt. Citizen data scientists zijn power users die zowel eenvoudige als redelijk geavanceerde analytische taken kunnen uitvoeren die eerder meer technische expertise vereisten.
PyCaret is simpel en gebruiksvriendelijk. Alle bewerkingen die in PyCaret worden uitgevoerd, worden sequentieel opgeslagen in een pipeline die volledig is georkestreerd voor deployment. Of het nu gaat om het imputeren van missende waarden, het transformeren van categorische data, feature engineering of zelfs hyperparametertuning: PyCaret automatiseert het allemaal. Bekijk deze video van één minuut om meer over PyCaret te leren.
De API van PyCaret is opgedeeld in modules. Elke module ondersteunt een type supervised learning (classificatie en regressie) of unsupervised learning (clustering, anomaliedetectie, nlp, association rules mining). Een nieuwe module voor tijdreeksvoorspelling is onlangs als beta uitgebracht in een aparte pip-package.
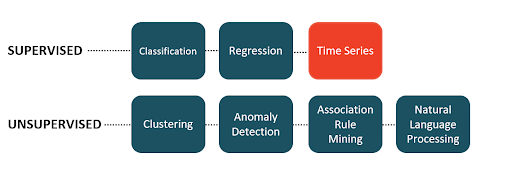 Beeldbron: [Ali, Moez].
PyCaret installeren is eenvoudig via pip en kost slechts enkele minuten. De standaardinstallatie van PyCaret installeert alleen harde afhankelijkheden zoals vermeld in het requirements.txt-bestand in de repo.
Let op: Deze tutorial is gemaakt in 2021 en PyCaret wordt niet langer actief onderhouden; sommige stappen werken mogelijk niet met de huidige versies van DataLab of andere tools.
pip install pycaret
Om de volledige versie te installeren:
pip install pycaret[full]
PyCaret’s grootste troef is de eenvoud. In vergelijking met andere geautomatiseerde machine learning-software is PyCaret uiterst flexibel, heeft het een uniforme API en kent het geen leercurve.
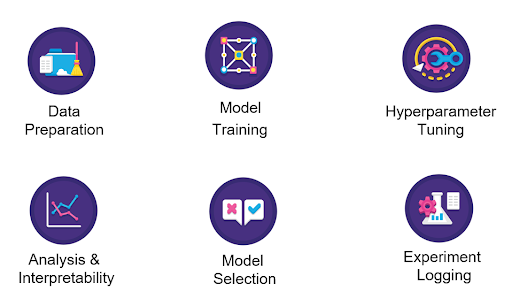
PyCaret zit boordevol functionaliteit. Je kunt in een paar regels code van dataverwerking naar modeltraining en vervolgens naar deployment in de cloud. Het bevat veel preprocessing-transformaties die automatisch worden toegepast wanneer het experiment wordt geïnitialiseerd. De modelzoo van PyCaret bevat meer dan 70 ongetrainde modellen voor supervised en unsupervised taken.
Je kunt PyCaret ook op de GPU gebruiken en je workflow tot 10x versnellen. Om modellen op de GPU te trainen, geef je simpelweg use_gpu = True mee in de setup-functie. Geen enkele codewijziging verder nodig.
PyCaret is een glass-box-oplossing. Het wordt geleverd met talloze functies om met het model te interacteren en de prestaties en resultaten te analyseren. Alle standaardplots zoals confusion matrix, AUC, residuals en feature importance zijn beschikbaar voor alle modellen. Het heeft ook integratie met de SHAP-bibliotheek, die wordt gebruikt om de uitkomst van complexe boomgebaseerde machine learning-modellen te verklaren.
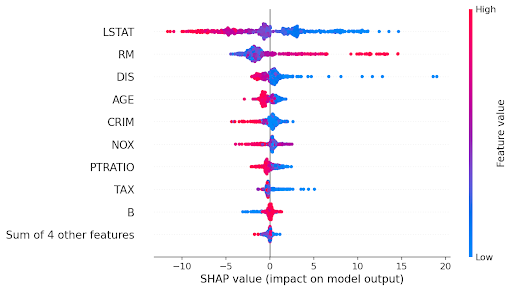 (Een voorbeeld van een beeswarm-plot)
PyCaret integreert ook met MLflow voor MLOps-functionaliteit. Het logt automatisch metrics, parameters en artifacts wanneer je log_experiment = True meegeeft in de setup-functie.
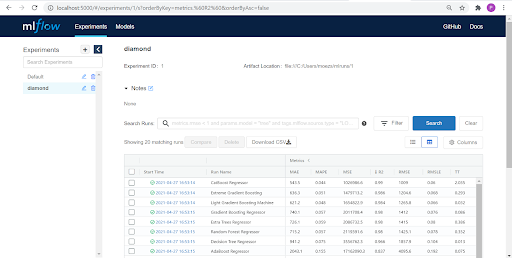 (Afbeelding door de auteur)
Alle preprocessing-transformaties worden toegepast binnen de setup-functie. PyCaret biedt meer dan 25 verschillende preprocessing-transformaties die in de setup-functie worden gedefinieerd. Klik hier om meer te leren over de preprocessing-mogelijkheden van PyCaret.
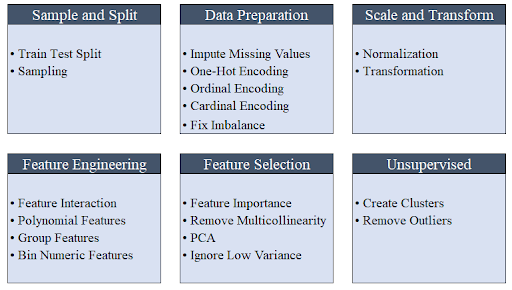 (Afbeelding door de auteur)
| Module | Taak |
|---|---|
| pycaret.classification | Supervised: Binaire of multi-class-classificatie |
| pycaret.regression | Supervised: Regressie |
| pycaret.clustering | Unsupervised: Clustering |
| pycaret.anomaly | Unsupervised: Anomaliedetectie |
| pycaret.nlp | Unsupervised: Natural Language Processing (topic modeling) |
| pycaret.arules | Unsupervised: Association Rules Mining |
| pycaret.datasets | Datasets |
Dit is een typische machine learning-workflow. Het correct formuleren van een ML-probleem is de eerste stap in elk ML-project en het kan enkele dagen tot weken duren om het goed te kadreren.
Data sourcing en ETL (Extract-Transform-Load) kunnen ook variëren in complexiteit, afhankelijk van de technologische volwassenheid en de grootte van de organisatie. Het is normaal dat in deze fase een team van data-engineers samenwerkt.
De fase van Exploratory Data Analysis (EDA) omvat het verkennen van de ruwe data om de datakwaliteit te beoordelen (missende waarden, uitschieters, enz.), correlaties tussen features te onderzoeken en businesshypothesen te testen.
Voor datapreparatie en modeltraining en -selectie doet PyCaret al het zware werk onder de motorkap. Datapreparatie omvat transformaties zoals imputatie van missende waarden, schalen (min-max, z-score, enz.), categorische encodering (one-hot-encoding, ordinale encodering, enz.), feature engineering (polynomen, feature-interactie, ratios, enz.) en featureselectie.
Na de datapreparatie omvat de fase van modeltraining en -selectie het fitten van meerdere algoritmen en het evalueren van de prestaties met een of andere teststrategie (meestal cross-validatie).
Tot slot wordt het gekozen (beste) model gedeployed als een API-endpoint voor inferentie. Na deployment ga je de API monitoren en houd je de modelprestaties in productie blijvend in de gaten.
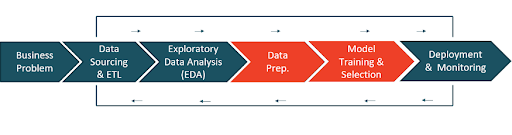 (Een afbeelding door de auteur)
Voorspel de prijs van een diamant op basis van kenmerken zoals slijpvorm, kleur, vorm, enz.
# laad de dataset uit pycaret
from pycaret.datasets import get_data
data = get_data('diamond')
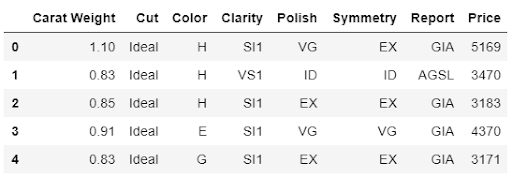
Laten we snel wat visualisaties maken om de relatie te beoordelen tussen onafhankelijke features (gewicht, slijpvorm, kleur, helderheid, enz.) en de targetvariabele, namelijk Price:
# plot scatter carat_weight en Price
import plotly.express as px
fig = px.scatter(x=data['Carat Weight'], y=data['Price'], facet_col = data['Cut'], opacity = 0.25, trendline='ols', trendline_color_override = 'red')
fig.show()
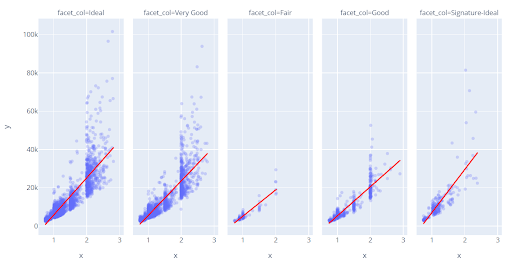
Laten we de histogram van de targetvariabele Price bekijken.
# plot histogram
fig = px.histogram(data, x=["Price"])
fig.show()
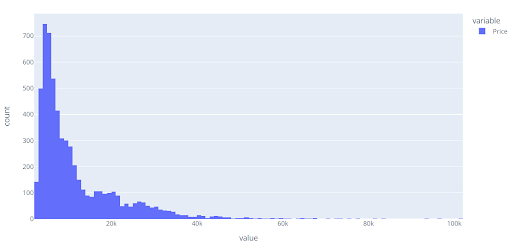
Merk op dat de verdeling van Price rechts-scheef is; we kunnen snel checken of een logtransformatie de verdeling (vorm) van de targetvariabele kan veranderen.
# plot histogram
data['logged_Price'] = np.log(data['Price'])
fig = px.histogram(data, x=["logged_Price"])
fig.show()
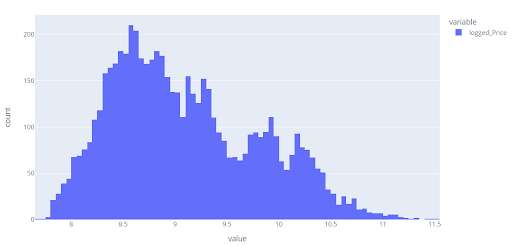
Alle experimenten in PyCaret moeten worden geïnitialiseerd met de setup-functie. Deze is verantwoordelijk voor alle datapreparatietaken die nodig zijn vóór modeltraining. Naast het uitvoeren van enkele basisverwerkingstaken biedt PyCaret ook een breed scala aan preprocessing-features. Klik hier om meer te leren over alle preprocessing-functionaliteiten in PyCaret.
# initialize setup
from pycaret.regression import *
s = setup(data, target = 'Price', transform_target = True, log_experiment = True, experiment_name = 'diamond')
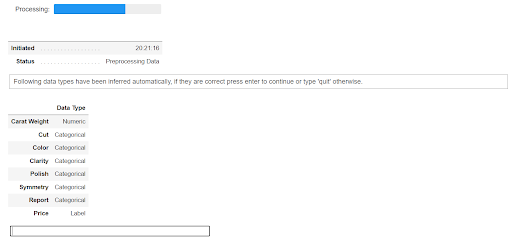
Wanneer je de setup-functie in PyCaret initialiseert, wordt de dataset geprofileerd en worden de datatypen voor alle inputfeatures afgeleid. Als alle datatypen correct zijn afgeleid, kun je op Enter drukken om door te gaan. Er is ook een parameter waarmee je datatypen in PyCaret kunt overschrijven. Als je PyCaret in een Python-script gebruikt, kun je deze bevestiging overslaan door silent = True mee te geven in de setup-functie.
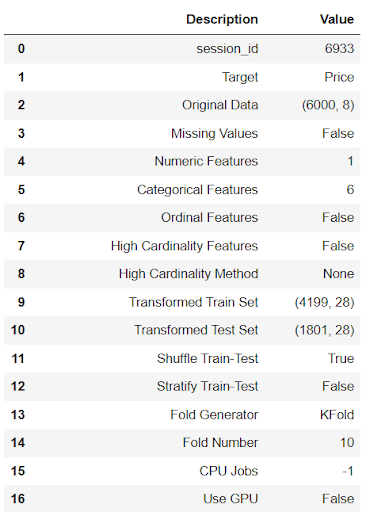 (Output van setup — ingekort voor weergave)
Na setup is de getransformeerde data beschikbaar voor modeltraining. Je kunt het trainingsproces starten met de compare_models-functie. Deze traint alle algoritmen die in de modelzoo beschikbaar zijn en evalueert meerdere prestatiemetrics met k-fold cross-validatie.
# vergelijk alle modellen
best = compare_models()
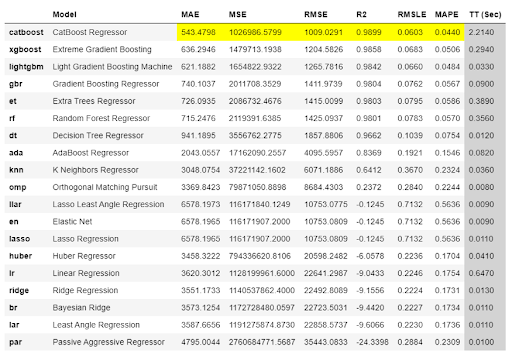 (Output van compare_models)
De output van compare_models toont de gemiddeld gecross-valideerde metrics voor alle modellen. De output is standaard gesorteerd op ‘R2’ (hoog-naar-laag), maar dit kan worden aangepast door een sort-parameter mee te geven aan de compare_models-functie.
Het beste model (in dit geval CatBoost Regressor) wordt geretourneerd zodra compare_models is voltooid. Standaard wordt alleen het beste model teruggegeven, maar dit kan worden aangepast met de parameter n_select. Als je bijvoorbeeld n_select = 3 meegeeft aan compare_models, worden de top 3 modellen als lijst teruggegeven.
# bekijk de uiteindelijke parameters van het beste model
best.get_params()
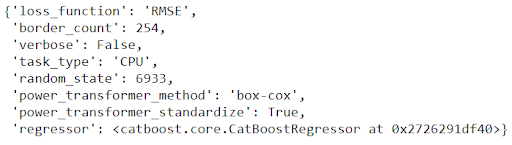
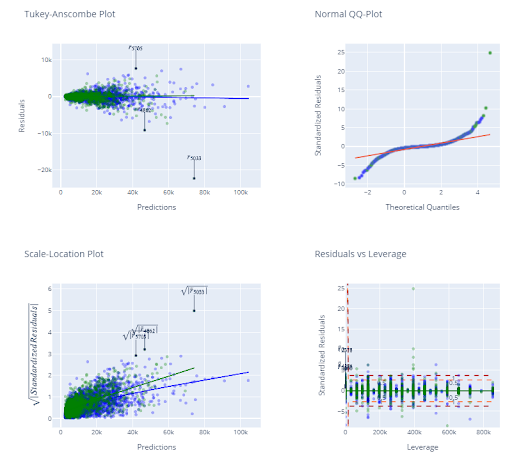
We kunnen ook de diagnostiek en enkele andere analyseplots bekijken met de plot_model-functie.
# bekijk de residuals van het getrainde model
plot_model(best, plot = 'residuals_interactive')
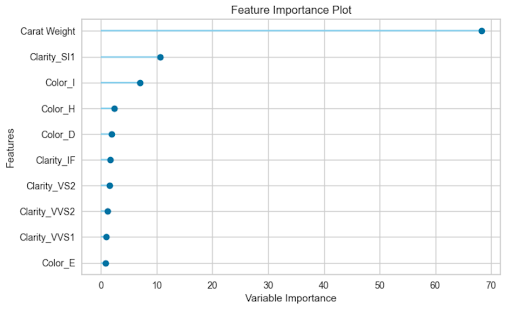
plot_model(best, plot = ‘feature’)
Er is nog een functie, evaluate_model, die een handige manier biedt om in de Jupyter Notebook langs alle beschikbare analyseplots te navigeren.
evaluate_model(best)
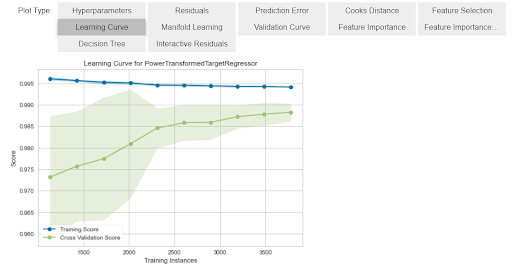
We kunnen nu het definitieve model gebruiken om voorspellingen te genereren op ongeziene data met de functie predict_model:
# kopieer data en verwijder de targetvariabele
data_unseen = data.copy()
data_unseen.drop(‘Price’, axis = 1, inplace = True)
predictions = predict_model(best, data = data_unseen)
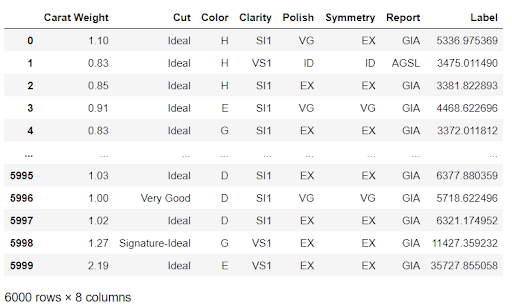
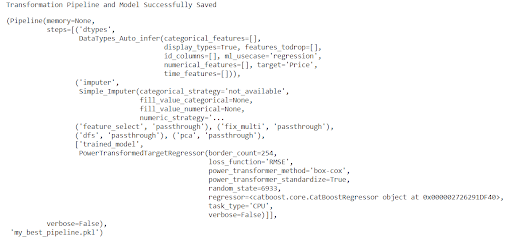
Voor later gebruik kun je de volledige pipeline opslaan met de functie save_model.
save_model(best, ‘my_best_pipeline’)
We hebben eerder log_experiment = True meegegeven in de setup-functie, samen met experiment_name = 'diamond'. Laten we kijken wat PyCaret achter de schermen heeft gedaan. Om de magie te zien, starten we de MLflow-server:
# binnen notebook
!mlflow ui

# vanaf de command line
mlflow ui
Open nu je browser en typ “localhost:5000”. Er verschijnt een UI zoals deze:
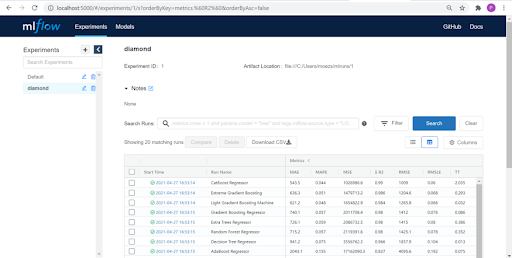
Elke rij in de tabel hierboven staat voor een trainingsrun die resulteert in een getrainde pipeline en een reeks metadata zoals datum/tijd van de run, prestatiemetrics, modelhyperparameters, tags, enz. Laten we op een van de modellen klikken:
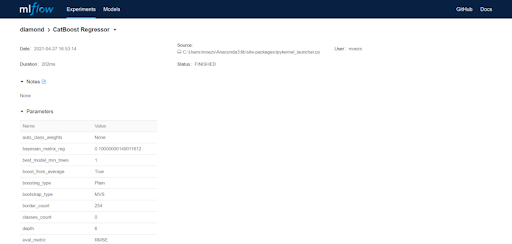
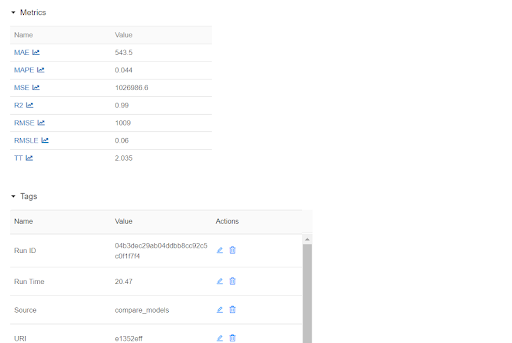
PyCaret's nieuwe time series-module is nu beschikbaar in beta. Helemaal in lijn met de eenvoud van PyCaret is deze consistent met de bestaande API en rijk aan functionaliteit. Statistische tests, modeltraining en -selectie (30+ algoritmen), modelanalyse, automatische hyperparametertuning, experimentlogging, deployment in de cloud en meer. Dit alles met slechts een paar regels code (net als de andere modules van PyCaret). Als je deze nieuwe module in beta wilt gebruiken, moet je die in een aparte conda-omgeving installeren om afhankelijkheidsconflicten te voorkomen.
pip install pycaret-ts-alphaTime series-data is een van de meest voorkomende datatypen en begrijpen hoe je ermee werkt is een cruciale datasciëncevaardigheid als je voorspellingen wilt doen en trends wilt rapporteren. Wil je meer leren over time series-analyse en -forecasting in Python, dan heeft DataCamp een mooie verzameling cursussen. Je kunt beginnen met de Time Series with Python-leerweg of een van deze cursussen is ook een goede keuze:
| Gebied | Integraties |
|---|---|
| Modellen | scikit-learn, XGBoost, LightGBM, CatBoost |
| GPU-training | RAPIDS.AI |
| Distributed computing | RAY |
| Hyperparametertuning | tune-sklearn, optuna |
| Plotten & analyse | plotly, yellowbrick, seaborn, matplotlib |
| NLP | gensim, spacy, nltk |
| MLOps | MLflow |
Is PyCaret alleen beschikbaar in Python? Ja, PyCaret is voorlopig alleen beschikbaar in Python.
Wat is het verschil tussen PyCaret en andere open-source ML-bibliotheken zoals scikit-learn, XGBoost, LightGBM? Vergeleken met andere open-source ML-bibliotheken is PyCaret een alternatieve low-code bibliotheek die honderden regels code kan vervangen door slechts enkele. PyCaret is in essentie een Python-wrapper om verschillende ML-bibliotheken en -frameworks heen, zoals scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray en nog enkele anderen.
Welke usecases worden ondersteund in PyCaret? Sinds release 2.3.4 ondersteunt PyCaret binaire/multi-class-classificatie, regressie, clustering, anomaliedetectie, natural language processing (topic modeling) en association rules mining. PyCaret heeft ook onlangs zijn nieuwe time series-module in beta uitgebracht als een aparte pip-installer.
Kunnen we PyCaret op de GPU gebruiken? Je kunt in PyCaret modellen op de GPU trainen en je workflow tot 10x versnellen. Om modellen op de GPU te trainen geef je simpelweg use_gpu = True mee in de setup-functie. Het gebruik van de API verandert niet, maar in sommige gevallen moeten extra libraries worden geïnstalleerd omdat deze niet worden meegeleverd met de standaard- of volledige versie.
Kunnen we de hyperparameters van het model in PyCaret tunen? Ja, je kunt de hyperparameters van elk model automatisch tunen in PyCaret. Het integreert met sklearn, optuna, tune-sklearn en ray voor verschillende tuners zoals Random Grid Search of Bayesian Grid Search.
Is PyCaret gratis te gebruiken? PyCaret is volledig gratis en open-source en gelicenseerd onder de MIT-licentie.
| PyCaret-bronnen | ---- |
|---|---|
| ⭐ Tutorials | Nieuw bij PyCaret? Bekijk de officiële notebooks! |
| 📋 Notebooks | Voorbeeldnotebooks gemaakt door de community. |
| 📙 Blog | Tutorials en artikelen door bijdragers. |
| 📚 Documentatie | De gedetailleerde API-docs van PyCaret |
| 📺 Videotutorials | Onze videotutorial van diverse events. |
| 📢 Discussies | Vragen? Ga in gesprek met de community en bijdragers. |
| 🛠️ <atarget="_blank" href="https://github.com/pycaret/pycaret/blob/master/CHANGELOG.md">Changelog | Wijzigingen en versiegeschiedenis. |
| 🌳 Roadmap | Het ontwikkelplan voor PyCaret's software en community. |
blog
Adel Nehme
15 min

