

k-Means Kümelemesine Genel Bakış
Kümeleme modelleri, verileri ayrı “kümelere” veya gruplara ayırmayı amaçlar. Bu, tek başına bir analiz olarak kullanılabilir ya da bir gözetimli öğrenme algoritmasında özellik olarak değerlendirilebilir.
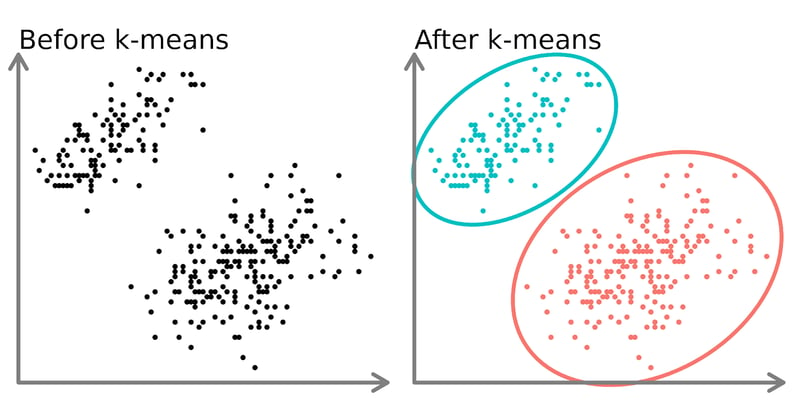
Yukarıdaki diyagramın sol tarafında, etiketlenmemiş ancak benzer veri noktaları olarak renklendirilmiş, birbirinden farklı 2 nokta kümesi görüyoruz. Bu veriye (sağ taraf) bir k-means modeli uydurmak, 2 ayrı grubu (hem farklı dairelerle hem de renklerle gösterilen) ortaya çıkarabilir.
İki boyutta insanlar için bu kümeleri ayırmak kolaydır, ancak boyut sayısı arttıkça bir modele ihtiyaç duyarsınız.
k-means algoritması
Benzer meyvelerden oluşan birkaç meyve salatası hazırlamak istediğinizi hayal edin.
- Kaç meyve salatası yapmak istediğinize (k) karar verirsiniz. Örneğin 3 meyve salatası yapmaya karar verirsiniz.
- Her salatanın başlangıçtaki "temsilcisi" olarak masadan rastgele 3 meyve seçersiniz.
- Şimdi masanın etrafında dolaşır ve her meyveyi en çok benzediği temsilciye sahip salataya atarsınız. Örneğin elmalar armutlarla, portakallar mandalinalarla, muzlar plantainlerle eşleşebilir.
- Tüm meyveler atandıktan sonra, her meyve salatasının yeni "merkezini" o gruptaki ortalama meyve özelliklerini (ör. boyut, renk, tat) hesaplayarak bulursunuz. Bu yeni merkezler güncellenmiş temsilciler olur.
- 3 ve 4. adımları birkaç kez tekrarlarsınız; meyveleri en benzer temsilciye atar ve gruplamalar artık değişmeyene kadar her seferinde temsilciyi güncellersiniz.
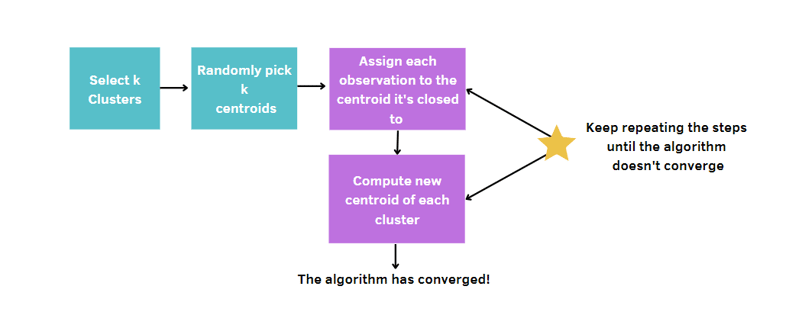
Daha genel olarak şunları yaparsınız:
- Küme sayısını, k’yı seçin.
- Rastgele k nokta (boyutu 1 olan kümeler) seçin.
- Her nokta ile merkez arasındaki mesafeyi hesaplayın ve her veri noktasını en yakın kümeye atayın.
- Her küme için merkezi (ortalama konumu) hesaplayın.
- Kümeler değişmeyene ya da maksimum yineleme sayısına ulaşılana kadar 3–4. adımları tekrarlayın.
k-means kümelerin merkezlerini rastgele seçtiği için, algoritmanın kullanıcı tarafından belirlenen sayıda kez çalıştırılması gerekir. Böylece, bir model kalite ölçütünü en aza indirerek en iyi çözüme ulaşılır. Bu ölçüt, her küme için veri noktaları ile ilgili merkezin arasındaki mesafelerin toplamı olan küme içi kareler toplamı (WCSS) olarak adlandırılır. Ölçütümüz ne kadar küçükse, kazanan modele o kadar çok yaklaşırız.
Airbnb İlanları Veri Seti
Bu eğitimin tüm içeriği, Cape Town’daki Airbnb kiralık ilanları etrafında dönecek olup DataLab’de mevcuttur. Veriler; ev sahipleri, fiyat, yorum sayısı, koordinatlar vb. gibi farklı türde bilgiler içerir.
Veri seti tatil kiralamaları hakkında derin bilgiler sağlıyor gibi görünse de, hâlâ yanıtlanabilecek net sorular var. Örneğin, Airbnb’in Cape Town’daki platform ilanlarının segmentasyonunu araştırması için veri bilimcilerinden talepte bulunduğunu hayal edelim.
Her şehir diğerinden farklıdır ve orada yaşayan insanların kültürüne bağlı olarak farklı gereksinimlere sahiptir. Bu şehirde kümelerin belirlenmesi, uygun Müşteri Sadakati Stratejileri ile mevcut müşterilerin memnuniyetini artırabilecek ve müşteri kaybını önleyebilecek yeni içgörüler çıkarmak için yararlı olabilir. Aynı zamanda, uygun kampanyalarla yeni insanları çekmek de kritik önemdedir.
Airbnb verilerini görselleştirin
k-means uygulamadan önce, korelasyon matrisine bakarak değişkenler arasındaki ilişkiyi daha fazla incelemek isteriz. Görsel kolaylık için, basamakları iki ondalığa yuvarlıyoruz.
library(dplyr)
airbnb |>
select(price, minimum_nights, number_of_reviews) |>
cor(use = "pairwise.complete.obs") |>
round(2)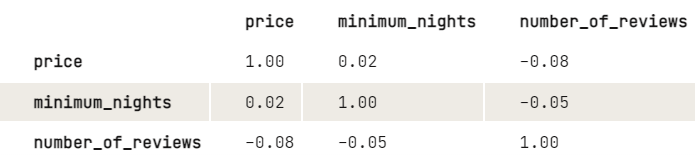
Çıktıdan, fiyat ile yorum sayısı arasında hafif bir negatif ilişki olduğu görülüyor: Fiyat yükseldikçe yorum sayısı düşüyor. Minimum gece sayısı ile yorum sayısı için de aynı durum var. Minimum gece sayısının fiyat üzerinde büyük bir etkisi olmadığından, fiyat ile yorum sayısının nasıl ilişkili olduğunu biraz daha araştırmak istiyoruz:
library(ggplot2)
ggplot(data, aes(number_of_reviews, price, color = room_type, shape = room_type)) +
geom_point(alpha = 0.25) +
xlab("Number of reviews") +
ylab("Price")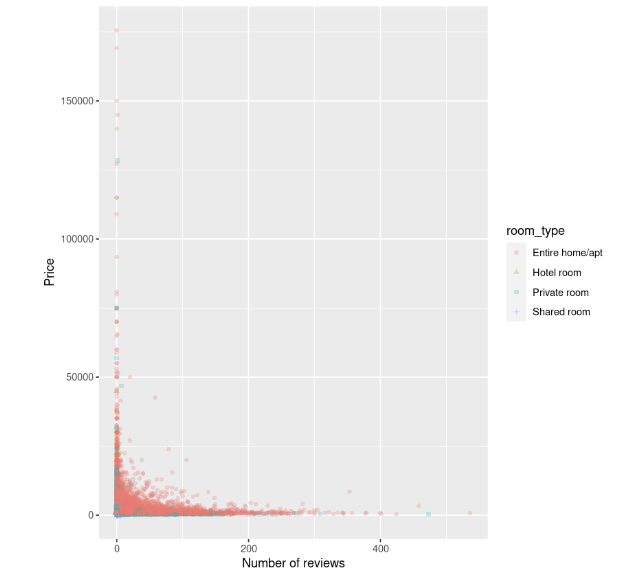
Saçılım grafiği, özellikle tüm evlerin konaklama maliyetinin, az sayıda yorum olduğunda daha yüksek olduğunu ve yorum sayısı arttıkça azalma eğilimi gösterdiğini ortaya koyuyor.
Normalizasyon
Modeli uydurmadan önce yapılması gereken bir adım daha var. k-means, birimleri karşılaştırılamayan değişkenlere duyarlıdır ve bu da yanıltıcı sonuçlara yol açabilir. Bu örnekte, yorum sayıları onlarca veya yüzlerce iken fiyat on binler mertebesindedir. Herhangi bir veri işleme olmadan, fiyatlardaki farklar yorumlardaki farklardan daha büyükmüş gibi görünecektir; oysa bu değişkenlerin eşit muamele görmesini isteriz.
Bu sorunu önlemek için, değişkenlerin benzer bir ölçeğe dönüştürülmesi gerekir. Böylece mesafe metriği kullanılarak doğru şekilde karşılaştırılabilirler.
Bu meseleyi ele almak için farklı yöntemler vardır. En bilinen ve en çok kullanılan yöntem standardizasyondur; özellik değerinden ortalama değerin çıkarılması ve ardından standart sapmasına bölünmesiyle yapılır. Bu teknik, ortalaması 0 ve sapması 1 olan özellikler elde etmeyi sağlar.
Değişkenleri scale() işleviyle ölçekleyebilirsiniz. Bu bir matris döndürdüğünden, kodun tidyverse yerine temel R tarzında yazılması daha temiz olur.
airbnb[, c("price", "number_of_reviews")] = scale(airbnb[, c("price", "number_of_reviews")])Modeli uydurma ve değerlendirme
Artık k-means ile ilanların kümelerini belirleyebiliriz. Başlangıç için, 3 küme ve nstart’ı 20 olacak şekilde k-means çalıştırmayı deneyelim. Bu son parametre, k-means’in 20 farklı rastgele başlangıç atamasıyla çalıştırılmasını sağlar ve ardından R, toplam küme içi kareler toplamı en iyi olan sonucu otomatik olarak seçecektir. Ayrıca, kodu her çalıştırdığımızda aynı sonuçları tekrarlamak için bir tohum (seed) belirliyoruz.
# Get the two columns of interest
airbnb_2cols <- data[, c("price", "number_of_reviews")]
set.seed(123)
km.out <- kmeans(airbnb_2cols, centers = 3, nstart = 20)
km.outÇıktı:
K-means clustering with 3 clusters of sizes 785, 37, 16069
Cluster means:
price number_of_reviews
1 14264.102 5.9401274
2 83051.541 0.6756757
3 1589.879 18.2649200
Clustering vector:
[1] 3 3 3 3 3 3 3 3 1 3 3 3 3 3 3 3 3 1 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3
[37] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3
[73] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3
[109] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 1 3 3 3 3 3 3 3 3 3 3 3 3 3
[145] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 1 1 3 3
...
[16777] 3 3 3 3 3 3 3 3 3 3 1 3 3 1 3 1 3 3 3 3 3 1 3 3 3 3 3 3 3 3 1 3 3 3 3 3
[16813] 3 1 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 1 3
[16849] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 1 3 3 3 3 3 3 3 3 3 3 3
[16885] 3 3 3 3 3 3 3
Within cluster sum of squares by cluster:
[1] 41529148852 49002793251 33286433394
(between_SS / total_SS = 74.5 %)
Available components:
[1] "cluster" "centers" "totss" "withinss" "tot.withinss"
[6] "betweenss" "size" "iter" "ifault"Çıktıdan, boyutları 785, 37 ve 16069 olan üç farklı küme bulunduğunu gözlemleyebiliriz. Her küme için, gözlemlerin merkezlere olan kareli mesafeleri hesaplanır. Böylece, her gözlem üç kümeden birine atanacaktır.
İyi bir sonuç gibi görünse de, en iyi modeli bulmanın yolu farklı sayıda kümeye sahip farklı modelleri denemektir. Bu nedenle, tek kümeli bir modelden başlayıp iki kümeli bir modelle devam etmeli ve böyle sürdürmeliyiz. Tüm bu süreç, x ekseninde küme sayısının, y ekseninde ise WCSS’in çizildiği, “scree plot” adı verilen bir grafikle izlenmelidir.
Bu vaka çalışmasında, her biri farklı sayıda kümeye sahip olacak şekilde 10 k-means modeli kuruyoruz ve maksimum 10 kümeye ulaşıyoruz. Ayrıca, veri setinin yalnızca bir kısmını kullanacağız; yani yalnızca fiyat ve yorum sayısını dahil edeceğiz. Scree grafiğini çizmek için, tüm modellerin toplam küme içi kareler toplamını wss değişkenine kaydetmemiz gerekir.
# Decide how many clusters to look at
n_clusters <- 10
# Initialize total within sum of squares error: wss
wss <- numeric(n_clusters)
set.seed(123)
# Look over 1 to n possible clusters
for (i in 1:n) {
# Fit the model: km.out
km.out <- kmeans(airbnb_2cols, centers = i, nstart = 20)
# Save the within cluster sum of squares
wss[i] <- km.out$tot.withinss
}
# Produce a scree plot
wss_df <- tibble(clusters = 1:n, wss = wss)
scree_plot <- ggplot(wss_df, aes(x = clusters, y = wss, group = 1)) +
geom_point(size = 4)+
geom_line() +
scale_x_continuous(breaks = c(2, 4, 6, 8, 10)) +
xlab('Number of clusters')
scree_plot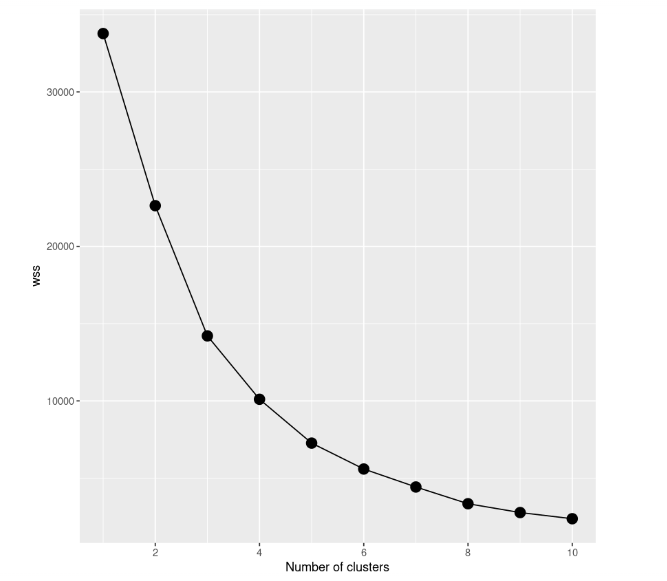
Scree grafiğine bakarak, küme sayısı arttıkça toplam küme içi kareler toplamının azaldığını fark edebiliriz. Kümelerin sayısını seçme ölçütü, bir dirsek (elbow) bulmaktır; yani yeni bir küme ekledikten sonra WCSS’in çok daha yavaş azaldığı noktayı tespit etmektir. Bu durumda çok net değil, bu yüzden daha iyi bir fikir edinmek için yatay çizgiler ekleyeceğiz:
scree_plot +
geom_hline(
yintercept = wss,
linetype = 'dashed',
col = c(rep('#000000',4),'#FF0000', rep('#000000', 5))
)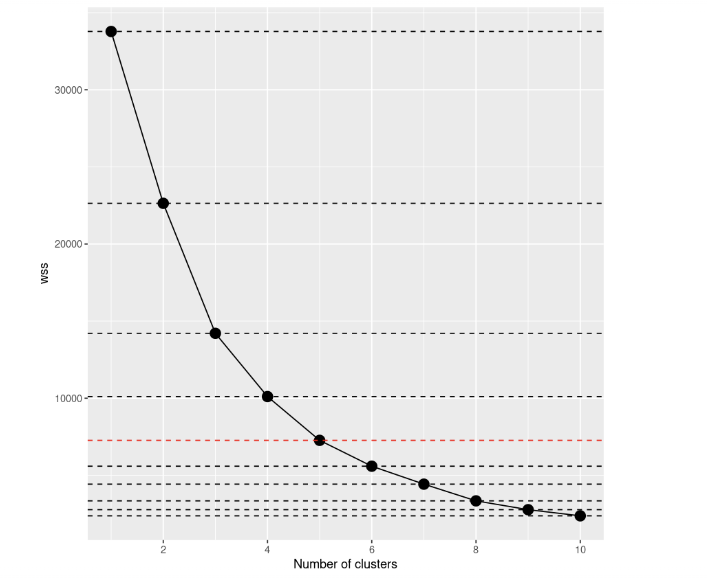
Tekrar bakarsanız, karar vermek önceye göre çok daha net, değil mi? Bu görselleştirmeden, en iyi seçimin küme sayısını 5 olarak belirlemek olduğunu söyleyebiliriz. k=5’ten sonra modellerdeki iyileşmeler keskin şekilde azalıyor gibi görünüyor.
# Select number of clusters
k <- 5
set.seed(123)
# Build model with k clusters: km.out
km.out <- kmeans(airbnb_2cols, centers = k, nstart = 20)Fiyat ile yorum sayısı arasındaki saçılım grafiğini yeniden görselleştirmeyi deneyebiliriz. Noktaları küme kimliğine göre de renklendiriyoruz:
data$cluster_id <- factor(km.out$cluster)
ggplot(data, aes(number_of_reviews, price, color = cluster_id)) +
geom_point(alpha = 0.25) +
xlab("Number of reviews") +
ylab("Price")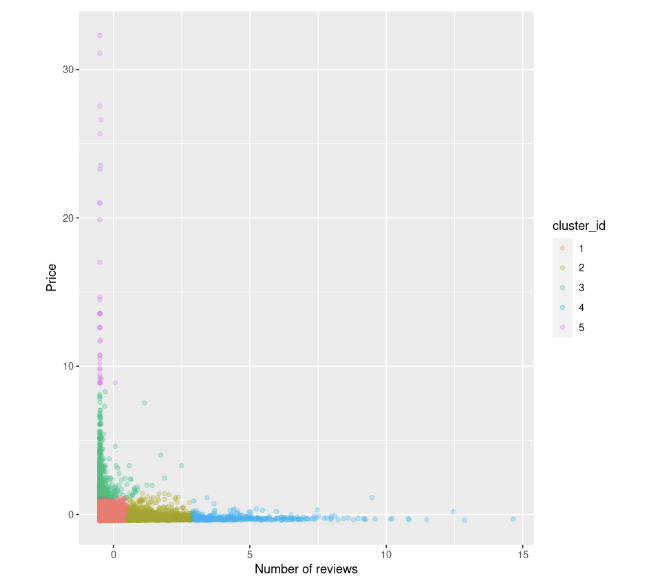
Şunları gözlemleyebiliriz:
- Yüksek fiyatlı ve düşük yorum sayısına sahip az sayıda ilan var; yeşil ve fuşya renkle gösteriliyorlar
- Ayrıca hem düşük fiyatlı hem de az yorumlu veri noktalarından oluşan bir grup var; kırmızıyla işaretlenmiş
- Bundan sonra, yorum sayısı arttıkça fiyatın dengeleniyor gibi göründüğünü söyleyebiliriz.
K-Means ne zaman başarısız olur?
Dikkat edin, k-means basit ve uygulaması kolaydır, ancak verileri gruplara ayırmak için her zaman en iyi seçim olmayabilir ve başarısız olabilir. Kümelerin küresel (spherical) olduğu varsayımı vardır ve bu durumlarda iyi iş çıkarır; ancak farklı boyut ve yoğunluktaki gruplar bu algoritma tarafından iyi yakalanma eğiliminde değildir.
Bu koşullar sağlanmadığında, DBSCAN ve BIRCH gibi alternatif yaklaşımlar tercih edilmelidir. Makine Öğrenmesinde Kümeleme: 5 Temel Kümeleme Algoritması, derinlemesine incelemek isterseniz kümeleme yaklaşımlarına harika bir genel bakış sunar.
Bir Sonraki Seviyeye Taşıyın
k-means, her ne kadar her durumda mükemmel olmasa da, farklı alt grupları belirlemek için en çok kullanılan kümeleme algoritmalarından biri olmaya devam ediyor. Artık bunu R ile diğer vaka çalışmalarında uygulayacak bilgiye sahipsiniz.
Bu yöntemi daha derinlemesine incelemek isterseniz, R’de Gözetimsiz Öğrenme kursuna göz atın. Ayrıca, kapsamlı bir kümeleme yaklaşımı genel görünümü için R’de Küme Analizi ve Python’da Hiyerarşik Kümelemeye Giriş de mevcut; k-means verilerinizden anlamlı içgörüler sunmakta yetersiz kaldığında yararlı olabilir. R ile gözetimli modellere de bakmak isterseniz, bu kurs önerilir!

Veri Bilimci - CRIF


K-means, veriler içinde kümeleri (benzer veri noktası gruplarını) belirlemeyi sağlayan, popüler bir gözetimsiz makine öğrenmesi tekniğidir. Bu eğitimde tidymodels, ggplot2 ve ggmap kullanarak R’de k-means kümelemeyi öğreneceksiniz. Şunları ele alacağız:
Daha derine inmeden önce, R Programlamanın temellerini (ör. vektörler ve veri çerçeveleri) tazelemenizi öneririz. Hazırsanız bunu atlayın ve başlayalım!