

k-Means क्लस्टरिंग का एक अवलोकन
क्लस्टरिंग मॉडल डेटा को अलग-अलग “क्लस्टरों” या समूहों में बाँटने का लक्ष्य रखते हैं। इसका उपयोग अपने आप में विश्लेषण के रूप में किया जा सकता है, या इसे किसी सुपरवाइज्ड लर्निंग एल्गोरिद्म में फीचर के रूप में भी इस्तेमाल किया जा सकता है।
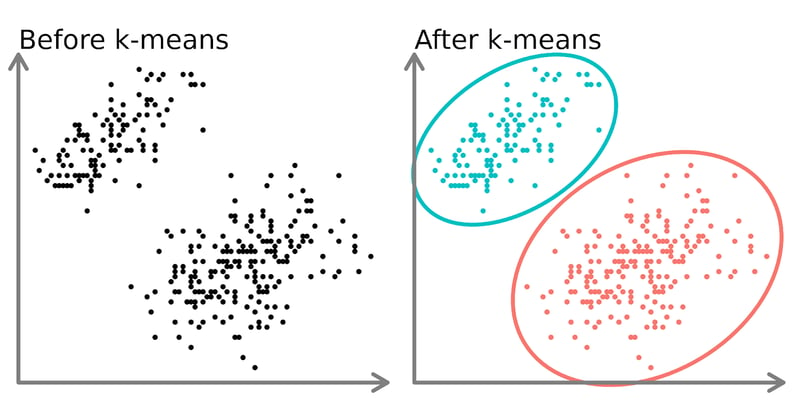
ऊपर के आरेख के बाएँ हिस्से में, हम बिना लेबल वाले और समान डेटा पॉइंट्स के रूप में रंगे 2 अलग-अलग बिंदु-समूह देखते हैं। इस डेटा पर k-means मॉडल फिट करना (दाएँ हिस्से में) 2 अलग समूह दिखा सकता है (अलग-अलग वृत्तों और रंगों में प्रदर्शित)।
दो आयामों में इंसानों के लिए इन क्लस्टरों को अलग करना आसान होता है, लेकिन अधिक आयामों में आपको मॉडल की ज़रूरत पड़ती है।
k-means एल्गोरिद्म
कल्पना करें कि आप कई फ्रूट सलाद बनाना चाहते हैं, जिनमें प्रत्येक में मिलते-जुलते फल हों।
- आप तय करते हैं कि कितने फ्रूट सलाद बनाने हैं (k)। उदाहरण के लिए, आप 3 फ्रूट सलाद बनाने का निर्णय लेते हैं।
- आप मेज़ से यादृच्छिक रूप से 3 फल चुनते हैं, जो हर सलाद के शुरुआती "प्रतिनिधि" होंगे।
- अब, आप मेज़ पर रखे हर फल को उस सलाद में असाइन करते हैं, जिसके प्रतिनिधि से वह सबसे ज़्यादा मिलता-जुलता हो। जैसे, सेब नाशपाती के साथ, संतरे किन्नू के साथ, और केले प्लांटेन के साथ जा सकते हैं।
- जब सभी फलों को असाइन कर दिया जाता है, तो आप प्रत्येक फ्रूट सलाद का नया "केंद्र" निकालते हैं, जो उस समूह में फलों की औसत विशेषताओं (जैसे आकार, रंग, स्वाद) से गणना होता है। ये नए केंद्र अपडेटेड प्रतिनिधि बन जाते हैं।
- आप चरण 3 और 4 कई बार दोहराते हैं—हर बार फलों को सबसे मिलते-जुलते प्रतिनिधि को असाइन करते हैं और प्रतिनिधि को अपडेट करते हैं—जब तक समूह बनना बदलना बंद न कर दे।
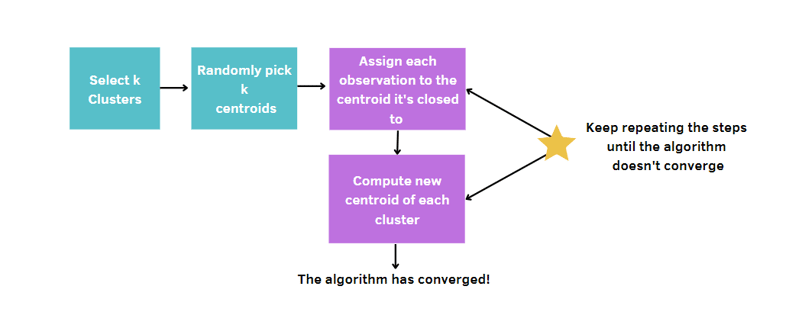
सामान्य रूप से, आप:
- क्लस्टरों की संख्या k चुनते हैं।
- यादृच्छिक रूप से k बिंदु (आकार 1 के क्लस्टर) चुनते हैं।
- हर बिंदु से सेंटरॉइड तक दूरी निकालते हैं और हर डेटा पॉइंट को सबसे नज़दीकी क्लस्टर में असाइन करते हैं।
- प्रत्येक क्लस्टर के लिए सेंटरॉइड (औसत स्थिति) की गणना करते हैं।
- चरण 3–4 को तब तक दोहराते हैं जब तक क्लस्टर बदलना बंद न कर दें या अधिकतम इटरेशंस पूरी न हो जाएँ।
क्योंकि k-means क्लस्टरों के केंद्र यादृच्छिक रूप से चुनता है, इसलिए इस एल्गोरिद्म को कुछ बार चलाने की ज़रूरत होती है, जिसकी संख्या उपयोगकर्ता तय करता है। इस तरह मॉडल क्वालिटी के एक माप को न्यूनतम करके सर्वश्रेष्ठ समाधान तक पहुँचा जा सकता है। इस माप को टोटल विदिन-क्लस्टर सम ऑफ स्क्वेयर्स (WCSS) कहते हैं, यानी हर क्लस्टर के लिए डेटा पॉइंट्स और उनके संबंधित सेंटरॉइड के बीच की दूरियों का योग। वास्तव में, जितना यह माप छोटा होगा, उतना ही हम बेहतर मॉडल तक पहुँचेंगे।
Airbnb लिस्टिंग्स डेटासेट
इस ट्यूटोरियल की सारी सामग्री केप टाउन की Airbnb रेंटल लिस्टिंग्स के इर्द-गिर्द है, जो DataLab पर उपलब्ध है। डेटा में होस्ट, कीमत, समीक्षाओं की संख्या, कॉर्डिनेट्स वगैरह जैसी अलग-अलग जानकारियाँ हैं।
भले ही डेटासेट छुट्टियों के रेंटल्स के बारे में विस्तृत जानकारी देता है, फिर भी कुछ स्पष्ट प्रश्न हैं जिनका उत्तर दिया जा सकता है। उदाहरण के लिए, मान लीजिए Airbnb अपने डेटा वैज्ञानिकों से केप टाउन में प्लेटफ़ॉर्म पर मौजूद लिस्टिंग्स का सेगमेंटेशन जाँचने के लिए कहता है।
हर शहर दूसरे से अलग होता है और वहाँ रहने वालों की संस्कृति के अनुसार अलग ज़रूरतें होती हैं। इस शहर में क्लस्टरों की पहचान नए इनसाइट्स निकालने में मदद कर सकती है, जिससे उपयुक्त कस्टमर लॉयल्टी रणनीतियों के जरिए मौजूदा ग्राहकों की संतुष्टि बढ़े और कस्टमर चर्न से बचा जा सके। साथ ही, उपयुक्त प्रमोशनों से नए लोगों को आकर्षित करना भी अहम है।
Airbnb डेटा का विज़ुअलाइज़ेशन
k-means लागू करने से पहले, हम वेरिएबल्स के बीच के संबंध को सहसंबंध मैट्रिक्स देखकर जाँचना चाहेंगे। डिस्प्ले की सुविधा के लिए, हम अंकों को दो दशमलव स्थान तक राउंड करते हैं।
library(dplyr)
airbnb |>
select(price, minimum_nights, number_of_reviews) |>
cor(use = "pairwise.complete.obs") |>
round(2)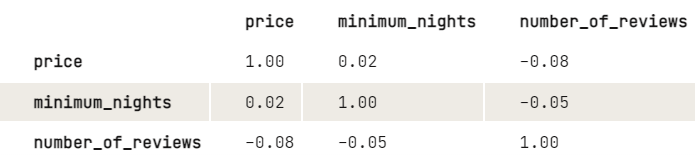
आउटपुट से लगता है कि कीमत और समीक्षाओं की संख्या के बीच थोड़ा नकारात्मक संबंध है: कीमत जितनी अधिक, समीक्षाएँ उतनी कम। यही बात न्यूनतम रातों और समीक्षाओं की संख्या पर भी लागू होती है। चूँकि न्यूनतम रातों का कीमत पर बड़ा प्रभाव नहीं दिखता, हम सिर्फ़ कीमत और समीक्षाओं की संख्या के संबंध को और जाँचना चाहेंगे:
library(ggplot2)
ggplot(data, aes(number_of_reviews, price, color = room_type, shape = room_type)) +
geom_point(alpha = 0.25) +
xlab("Number of reviews") +
ylab("Price")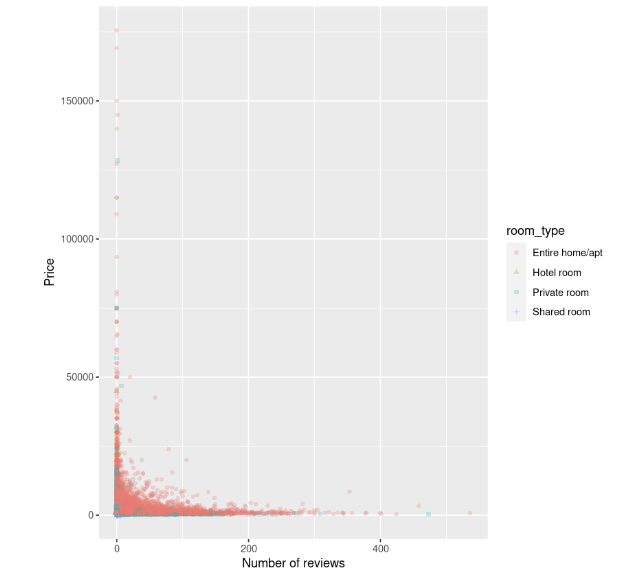
स्कैटरप्लॉट दिखाता है कि आवास की लागत, खासकर पूरे घरों की, तब ज़्यादा होती है जब समीक्षाओं की संख्या कम हो, और जैसे-जैसे समीक्षाएँ बढ़ती हैं, कीमत घटती हुई लगती है।
Normalization
मॉडल फिट करने से पहले एक और कदम ज़रूरी है। k-means उन वेरिएबल्स के प्रति संवेदनशील है जिनकी इकाइयाँ तुलनीय नहीं होतीं, जिससे भ्रामक परिणाम आ सकते हैं। इस उदाहरण में, समीक्षाओं की संख्या दर्जनों या सैकड़ों में है, लेकिन कीमत दसियों हज़ार में। बिना किसी प्री-प्रोसेसिंग के, कीमत में अंतर समीक्षाओं के अंतर से बड़ा दिखेगा, जबकि हम चाहते हैं कि इन वेरिएबल्स को बराबरी से ट्रीट किया जाए।
इस समस्या से बचने के लिए वेरिएबल्स को समान स्केल पर ट्रांसफ़ॉर्म करना होता है। इस तरह उन्हें दूरी मैट्रिक का उपयोग करके सही ढंग से तुलना किया जा सकता है।
इसे हल करने के कई तरीके हैं। सबसे जाना-माना तरीका स्टैंडर्डाइज़ेशन है, जिसमें फ़ीचर वैल्यू से औसत घटाया जाता है और फिर उसे उसके मानक विचलन से भाग दिया जाता है। इस तकनीक से औसत 0 और विचलन 1 वाले फ़ीचर मिलते हैं।
आप scale() फ़ंक्शन से वेरिएबल्स को स्केल कर सकते हैं। चूँकि यह एक मैट्रिक्स लौटाता है, इसलिए टाइडिवर्स की बजाय बेस-R स्टाइल में कोड लिखना ज़्यादा साफ़ रहता है।
airbnb[, c("price", "number_of_reviews")] = scale(airbnb[, c("price", "number_of_reviews")])मॉडल फिट करना और उसका मूल्यांकन
अब हम अंततः k-means से लिस्टिंग्स के क्लस्टर पहचान सकते हैं। शुरुआत के लिए, 3 क्लस्टर और nstart = 20 सेट करके k-means चलाते हैं। यह आखिरी पैरामीटर k-means को 20 अलग-अलग यादृच्छिक प्रारंभिक असाइनमेंट्स के साथ चलाने के लिए होता है और फिर R अपने-आप उस परिणाम को चुनता है जिसका टोटल विदिन-क्लस्टर सम ऑफ स्क्वेयर्स सबसे अच्छा हो। हम एक seed भी सेट करते हैं ताकि कोड हर बार चलाने पर वही परिणाम दोहर सके।
# Get the two columns of interest
airbnb_2cols <- data[, c("price", "number_of_reviews")]
set.seed(123)
km.out <- kmeans(airbnb_2cols, centers = 3, nstart = 20)
km.outआउटपुट:
K-means clustering with 3 clusters of sizes 785, 37, 16069
Cluster means:
price number_of_reviews
1 14264.102 5.9401274
2 83051.541 0.6756757
3 1589.879 18.2649200
Clustering vector:
[1] 3 3 3 3 3 3 3 3 1 3 3 3 3 3 3 3 3 1 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3
[37] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3
[73] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3
[109] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 1 3 3 3 3 3 3 3 3 3 3 3 3 3
[145] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 1 1 3 3
...
[16777] 3 3 3 3 3 3 3 3 3 3 1 3 3 1 3 1 3 3 3 3 3 1 3 3 3 3 3 3 3 3 1 3 3 3 3 3
[16813] 3 1 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 1 3
[16849] 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 3 1 3 3 3 3 3 3 3 3 3 3 3
[16885] 3 3 3 3 3 3 3
Within cluster sum of squares by cluster:
[1] 41529148852 49002793251 33286433394
(between_SS / total_SS = 74.5 %)
Available components:
[1] "cluster" "centers" "totss" "withinss" "tot.withinss"
[6] "betweenss" "size" "iter" "ifault"आउटपुट से देखते हैं कि 785, 37 और 16069 आकार वाले तीन अलग-अलग क्लस्टर मिले हैं। प्रत्येक क्लस्टर के लिए, ऑब्ज़र्वेशंस से सेंटरॉइड तक की वर्ग दूरी की गणना होती है। इस तरह, हर ऑब्ज़र्वेशन तीन में से किसी एक क्लस्टर में असाइन हो जाएगा।
भले ही यह अच्छा परिणाम लगे, सर्वोत्तम मॉडल ढूँढ़ने का बेहतरीन तरीका अलग-अलग क्लस्टर संख्याओं के साथ अलग-अलग मॉडल आज़माना है। तो, हमें एक क्लस्टर वाले मॉडल से शुरू करना होगा, फिर दो क्लस्टरों वाला मॉडल, और आगे बढ़ते जाना होगा। इस पूरी प्रक्रिया को एक ग्राफ़िकल रिप्रेज़ेंटेशन—स्क्री प्लॉट—से ट्रैक करना चाहिए, जिसमें x-अक्ष पर क्लस्टरों की संख्या और y-अक्ष पर WCSS प्लॉट होता है।
इस केस स्टडी में, हम 10 k-means मॉडल बनाते हैं, जिनमें क्लस्टरों की संख्या अलग-अलग होगी, अधिकतम 10 तक। साथ ही, हम डेटासेट का एक हिस्सा ही उपयोग करेंगे—सिर्फ कीमत और समीक्षाओं की संख्या। स्क्री प्लॉट बनाने के लिए, हमें सभी मॉडलों के टोटल विदिन-क्लस्टर सम ऑफ स्क्वेयर्स को wss वेरिएबल में सहेजना होगा।
# Decide how many clusters to look at
n_clusters <- 10
# Initialize total within sum of squares error: wss
wss <- numeric(n_clusters)
set.seed(123)
# Look over 1 to n possible clusters
for (i in 1:n) {
# Fit the model: km.out
km.out <- kmeans(airbnb_2cols, centers = i, nstart = 20)
# Save the within cluster sum of squares
wss[i] <- km.out$tot.withinss
}
# Produce a scree plot
wss_df <- tibble(clusters = 1:n, wss = wss)
scree_plot <- ggplot(wss_df, aes(x = clusters, y = wss, group = 1)) +
geom_point(size = 4)+
geom_line() +
scale_x_continuous(breaks = c(2, 4, 6, 8, 10)) +
xlab('Number of clusters')
scree_plot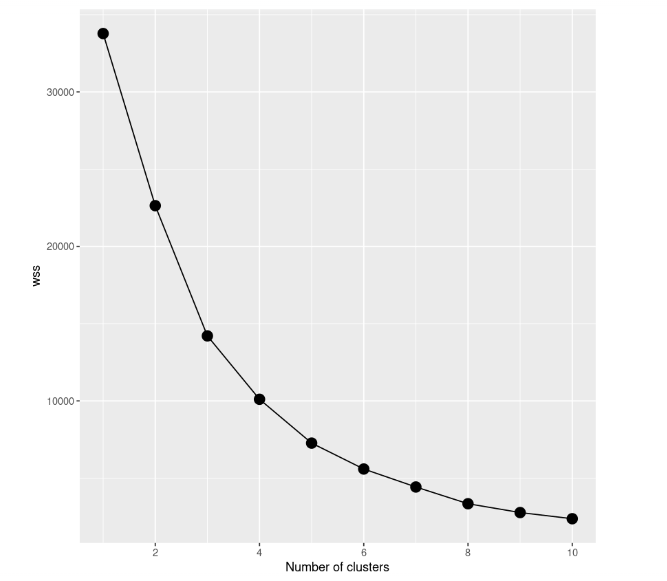
स्क्री प्लॉट देखकर हम नोटिस कर सकते हैं कि जैसे-जैसे क्लस्टरों की संख्या बढ़ती है, टोटल विदिन-क्लस्टर सम ऑफ स्क्वेयर्स घटता है। क्लस्टरों की संख्या चुनने का मानदंड “एल्बो” ढूँढ़ना है—वह बिंदु जहाँ एक और क्लस्टर जोड़ने के बाद WCSS बहुत धीमे घटता है। इस मामले में यह बहुत स्पष्ट नहीं, तो बेहतर समझ के लिए हम क्षैतिज रेखाएँ जोड़ेंगे:
scree_plot +
geom_hline(
yintercept = wss,
linetype = 'dashed',
col = c(rep('#000000',4),'#FF0000', rep('#000000', 5))
)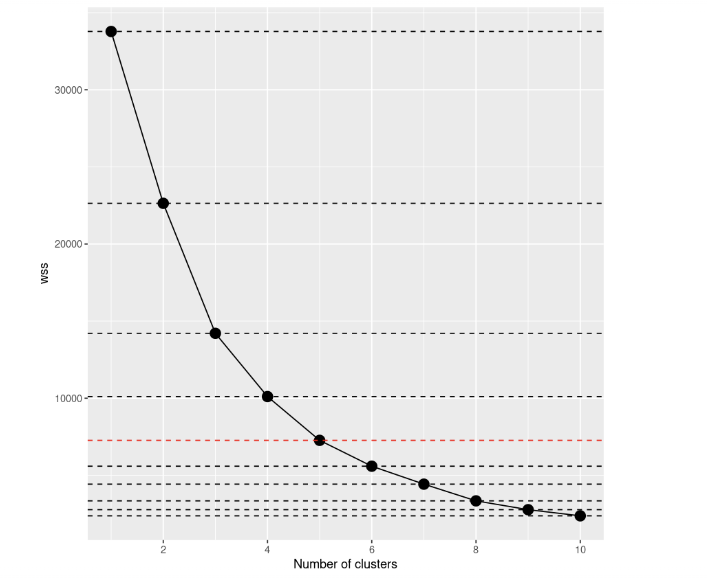
फिर से देखें तो फ़ैसला पहले से कहीं स्पष्ट लगता है, है ना? इस विज़ुअलाइज़ेशन से हम कह सकते हैं कि सबसे अच्छा विकल्प क्लस्टरों की संख्या 5 रखना है। k=5 के बाद मॉडलों में सुधार तेज़ी से घटता दिखता है।
# Select number of clusters
k <- 5
set.seed(123)
# Build model with k clusters: km.out
km.out <- kmeans(airbnb_2cols, centers = k, nstart = 20)हम कीमत और समीक्षाओं की संख्या के बीच स्कैटरप्लॉट फिर से विज़ुअलाइज़ कर सकते हैं। साथ ही, हम बिंदुओं को क्लस्टर आईडी के आधार पर रंग देंगे:
data$cluster_id <- factor(km.out$cluster)
ggplot(data, aes(number_of_reviews, price, color = cluster_id)) +
geom_point(alpha = 0.25) +
xlab("Number of reviews") +
ylab("Price")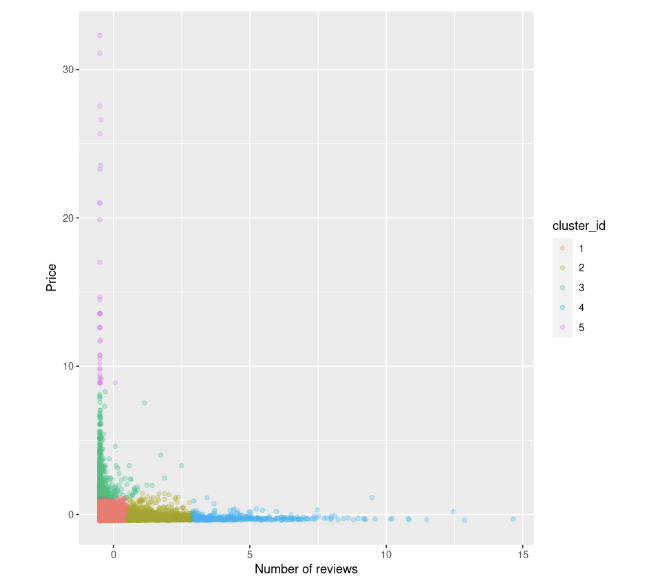
हम देख सकते हैं कि:
- कुछ लिस्टिंग्स ऐसी हैं जिनकी कीमतें ऊँची और समीक्षाएँ कम हैं—वे हरे और फ्यूशिया रंग में दिखती हैं
- एक समूह ऐसे डेटा पॉइंट्स का भी है जिनमें कीमतें और समीक्षाएँ दोनों कम हैं—यह लाल रंग में चिह्नित है
- इसके बाद, जैसे-जैसे समीक्षाओं की संख्या बढ़ती है, कीमत स्थिर होती दिखाई देती है।
k-means कब विफल होगा?
ध्यान रखें कि k-means सरल और लागू करने में आसान है, लेकिन डेटा को समूहों में बाँटने के लिए यह हमेशा सबसे अच्छा विकल्प नहीं होता क्योंकि यह विफल भी हो सकता है। यह मानकर चलता है कि क्लस्टर गोलाकार (spherical) हैं—ऐसे मामलों में यह अच्छा काम करता है—जबकि अलग आकार और घनत्व वाले समूहों को यह एल्गोरिद्म ठीक से कैप्चर नहीं कर पाता।
जब ये शर्तें पूरी न हों, तो DBSCAN और BIRCH जैसे वैकल्पिक तरीकों की तलाश करना बेहतर होता है। Clustering in Machine Learning: 5 Essential Clustering Algorithms क्लस्टरिंग अप्रोच का बेहतरीन ओवरव्यू देता है, अगर आप गहराई से पढ़ना चाहें।
अगले पायदान पर जाएँ
हम निष्कर्ष निकाल सकते हैं कि अलग-अलग उपसमूहों की पहचान के लिए k-means सबसे अधिक उपयोग किए जाने वाले क्लस्टरिंग एल्गोरिद्म में बना हुआ है, भले ही यह हर स्थिति में परफेक्ट न हो। अब आपके पास इसे R में अन्य केस स्टडीज़ पर लागू करने का ज्ञान है।
अगर आप इस पद्धति को और गहराई से पढ़ना चाहते हैं, तो कोर्स Unsupervised Learning in R देखें। साथ ही Cluster Analysis in R और An Introduction to Hierarchical Clustering in Python भी हैं, जो उपलब्ध क्लस्टरिंग अप्रोच का पूरा ओवरव्यू देते हैं—जो तब उपयोगी हैं जब k-means आपके डेटा से सार्थक इनसाइट्स निकालने के लिए पर्याप्त न हो। अगर आप R के साथ सुपरवाइज्ड मॉडल्स भी एक्सप्लोर करना चाहते हैं, तो यह कोर्स अनुशंसित है!

डेटा वैज्ञानिक - CRIF
K-means एक लोकप्रिय अनसुपरवाइज्ड मशीन लर्निंग तकनीक है जो डेटा के भीतर क्लस्टरों (एक जैसे डेटा पॉइंट्स के समूह) की पहचान करने देती है। इस ट्यूटोरियल में, आप tidymodels, ggplot2 और ggmap का उपयोग करके R में k-means क्लस्टरिंग के बारे में सीखेंगे। हम कवर करेंगे:
आगे बढ़ने से पहले, हम सुझाव देते हैं कि आप R प्रोग्रामिंग की बुनियादी बातें, जैसे वेक्टर और डेटा फ्रेम्स, दोहरा लें। अगर आप तैयार हैं, तो इसे छोड़ें और शुरू करते हैं!