from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
llm = ChatOpenAI(model="gpt-4o-mini")
prompt = ChatPromptTemplate.from_messages([("system","You are concise."),("human","{question}")])
chain = prompt | llm | StrOutputParser()# This is our chainprint(chain.invoke({"question":"Give me 3 focus tips."}))# making a single call
qs =[{"question": q}for q in["One tactic for RAG?","Explain LCEL in 1 line."]]print(chain.batch(qs))# many calls at once技术支持
在我看来,上面的代码展示了 LCEL 的最简用法。我们先创建一个提示模板,它总是包含一条系统消息(“you are concise”),并为人类问题留空。系统消息像是对 LLM 的指令,告诉它以特定方式回应/行动。然后我们将该模板连接到一个 OpenAI 模型——GPT-4o-mini。
from pydantic import BaseModel, Field
from typing import List
from langchain_openai import ChatOpenAI
classTaskPlan(BaseModel):
title:str
steps: List[str]= Field(..., min_items=3, description="actionable steps")
structured = ChatOpenAI(model="gpt-4o-mini").with_structured_output(TaskPlan)
plan = structured.invoke("Plan a 20-minute deep-work session for AI Agent notes.")print(plan.model_dump())技术支持
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
@tooldefmultiply(a:int, b:int)->int:"""This tool multiplies two numbers."""return a * b
llm = ChatOpenAI(model="gpt-4o-mini")
llm_tools = llm.bind_tools([multiply])# exposing the tools to the model
resp = llm_tools.invoke("What is 9*5? If needed, use a tool.")print(resp.tool_calls or resp.content)# model may emit a tool call with arguments技术支持
from typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage
# This is the backpack that moves through the graph.classState(TypedDict):# To add messages to the state
messages: Annotated[List, add_messages]
llm = ChatOpenAI(model="gpt-4o")# This is a node that asks the model and adds the reply to the backpack.defmodel_node(state: State):
reply = llm.invoke(state["messages"])return{"messages":[reply]}# Building the graph
graph = StateGraph(State)
graph.add_node("model", model_node)
graph.add_edge(START,"model")
graph.add_edge("model", END)# Building and running once
app = graph.compile()
result = app.invoke({"messages":[HumanMessage(content="Explain LangGraph in one sentence.")]})print(result["messages"][-1].content)技术支持
我们来走读一下代码。这里我们构建了最简 LangGraph 应用。状态就像一只背包,在图中携带消息。我们用 State 定义它,告诉 LangGraph 始终维护一份聊天消息的累积列表。
from typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, AIMessage
# Defining the stateclassState(TypedDict):
messages: Annotated[List, add_messages]
llm = ChatOpenAI(model="gpt-4o-mini")defanswer_node(state: State):# Normal answer using the whole chat history.return{"messages":[llm.invoke(state["messages"])]}defclarify_node(state: State):# LLm asking for a short follow-up to get enough detail (clarifying)return{"messages":[AIMessage(content="Could you share a bit more so I can be precise?")]}# Router functiondefroute(state: State):# Look for the latest human message and count words.
last_human =next((m for m inreversed(state["messages"])if m.type=="human"),None)ifnot last_human:return"clarify"
words =len(str(last_human.content).split())return"answer"if words >=3else"clarify"
graph = StateGraph(State)
graph.add_node("answer", answer_node)
graph.add_node("clarify", clarify_node)# Adding a conditional edge to connect the router function
graph.add_conditional_edges(START, route,{"answer":"answer","clarify":"clarify"})
graph.add_edge("answer", END)
graph.add_edge("clarify", END)
app = graph.compile()# Compiling the graph技术支持


本文对比介绍了 LangChain 与 LangGraph,并说明 LangSmith 与 LangFlow 在其中的位置。我们将基于其他 DataCamp 文章中涵盖的概念,讨论在交付可用于生产的代理型 AI 系统时如何选择各框架。如果您想快速上手 LangChain,推荐 Developing LLM Applications with LangChain 课程。
要点速览(TL;DR)
在深入细节前,先快速了解 LangChain、LangGraph、LangSmith 与 LangFlow 之间的关系,以及各自的适用场景。
简单决策规则: 先用 LangChain 起步;随着工作流复杂化迁移到 LangGraph;为可观测性加入 LangSmith;需要快速迭代或协作时使用 LangFlow。
LangChain 与 LangGraph 简介
大型语言模型(LLM)擅长处理单轮提示词。这已是常识,因为我们如今经常使用这些模型。
然而,真实应用需要工作流:拉取数据、推理、调用工具、追问澄清、失败重试,有时还需人工介入。因此,您会反复听到两个框架:LangChain 与 LangGraph。二者同属一个生态且常常配合使用,但侧重解决问题的不同部分:
说到生态,我们还将讨论 LangSmith(用于可观测性/评估)与 LangFlow(拖放式可视化构建器),它们同样是该生态的一部分。
LangChain 生态简史(2022–2025)
不妨从 LangChain 生态的简史说起;它已成为代理型 AI 的首选框架,了解其发展脉络有助于理解 LangGraph、LangSmith 与 LangFlow 的重要性。
LangChain 与 LangGraph 快速入门
下面我们深入生态的核心,从 LangChain 与 LangGraph 开始。
LangChain 是用于构建 LLM 应用的模块化框架。它提供构件——提示词、模型、记忆、工具、检索器——并通过 Runnable/LCEL API 将它们串成流水线(稍后讨论)。我更愿意把它看作是 LLM 常见模式的“乐高积木套件”,如 RAG、问答、聊天机器人与工具型智能体。
LangGraph 是基于 LangChain 组件构建的较新图式编排层。应用不是一条直线步骤,而是建模为节点(动作)与边(转移),并有一个显式状态对象在图中流动。稍后我们会更深入,但您先记住:这种设计让分支(走不同路径)、循环(反复追问直至有把握)、重试(工具/模型报错)与暂停人工审核变得自然,这正是长时运行、生产级智能体所需。
接下来您或许会问:
“为什么要比较它们?”
关键在于:尽管它们共享组件,但面向的复杂度层级不同:
实践中,许多开发者会先用 LangChain 起步做想法验证,随后在需要分支、错误处理、多智能体协作或持久化时升级到 LangGraph。
什么是 LangChain?
接下来我们深入 LangChain,理解其用法并在其中编写应用。再次强调,LangChain 是一个库,帮助我们为顺序型 LLM 工作流打好基础。
LCEL
首先解释什么是LCEL。LCEL(LangChain 表达式语言)是一种用管道符(|)将模块连接在一起的方式。每个模块可以是提示词、模型、检索器或解析器。把它们连接起来后,我们就得到一条可反复运行的链,大幅提升编码效率。
来看几个示例。
在我看来,上面的代码展示了 LCEL 的最简用法。我们先创建一个提示模板,它总是包含一条系统消息(“you are concise”),并为人类问题留空。系统消息像是对 LLM 的指令,告诉它以特定方式回应/行动。然后我们将该模板连接到一个 OpenAI 模型——GPT-4o-mini。
最后,我添加了一个输出解析器,将响应转换为纯文本。
最重要的一点是:管道符 | 将这些模块粘合为一条流水线。
我还想谈谈
invoke()与batch()。调用chain.invoke(...)时,流水线运行一次:模板填入问题、模型生成答案、解析器返回干净文本。而调用
chain.batch(...)时,同一条链会一次性处理多条输入,比逐条循环更快。实务中,这让我们几乎不加额外代码,就能从单次调用扩展到处理整批数据。再看一个示例:
这段代码与第一个示例很相似,但使用了流式输出。通过
.stream(...),模型不会等到完整答案就绪,而是在生成过程中分片发送文本,我们可以实时打印。本小节的核心要点是:LCEL 就是“管道与积木”的简洁系统,让我们把提示词、模型、工具与解析器拼接在一起,立刻得到一条可运行、可批量、可流式的链,无需额外代码。
用 Pydantic 获取结构化输出
结构化输出对 AI 智能体至关重要。其含义是:智能体不是给出冗长且凌乱的文本,而是以 JSON、表格或列表等清晰格式返回答案。这样更便于计算机与人类阅读、使用并与其他工具对接。
业界常用的一个框架是Pydantic。
在此示例中,
.with_structured_output()方法至关重要,它告诉 LLM 以我们定义的 Pydantic 模型格式返回结果。LangChain 在幕后确保智能体的回答是真正符合该格式的 JSON,然后将其转为可直接使用的 Python 对象。因此我们拿到的不是乱糟糟的文本,而是如
TaskPlan(title="...", steps=["...", "...", "..."])这样的对象。它在使用工具(Tools)时尤其有用。LangChain 中的工具调用
工具之所以重要,是因为它们可以扩展 LLM 的能力,让其完成原本无法完成的任务,比如联网搜索。
我最喜欢的是,LangChain(与许多代理型框架)提供了即用型工具,称为内置工具(Built-In Tools),使用非常简单。而且,我们也可以用装饰器
@tool自定义工具,告诉 LangChain 该函数是“特殊函数”。在上面的代码中,我创建了一个非常简单的工具,接收两个数字并返回其乘积。为了让内部模型(此处为 GPT-4o-mini)能访问这些工具,我们使用
llm.bind_tools()方法并传入工具列表,将工具暴露给模型。会话记忆
在构建 AI 智能体时,记忆同样至关重要。具备记忆的智能体能够记住过往对话中的内容,比如我们之前的提问、偏好,或哪些方法有效/无效。没有记忆,每次交互都像初次见面——我们不得不反复提供基本上下文,这很麻烦。
在 LangChain 中,记忆意味着把历史消息或事实存入某个存储(内存、数据库或向量库)。当智能体再次运行时,它可以取回这些记忆,让回答更连贯、更聪明。
主要有两类:短期记忆(同一会话中的近期消息)与长期记忆(跨多个会话记住的事实或偏好)。注意,会话是一段单独的对话或交互窗口,智能体会在结束前持续跟踪其中的对话内容。
短期记忆在单次对话中维持上下文,而长期记忆能让智能体随时间推移显得更个性化、更有帮助。
上述代码首先创建了一个能在会话中记住过往消息的聊天链。提示中包含 history 占位符,
RunnableWithMessageHistory会在每次运行时自动填入对应会话的对话记录。字典 store 用于保存不同会话的历史。需要注意的是,我们应谨慎使用记忆。需要决定与编码哪些内容值得保留、何时存储、向提示回填多少。记忆过多会拖慢系统或超出限制;但把握好平衡能显著提升智能体的实用性。
什么是 LangGraph?
现在转向另一个代理型框架——LangGraph。
为便于理解,我用一个类比来说明:背包式流程图(Backpack Flowchart)类比。
可以将 LangGraph 看作我们 AI 应用的一张小流程图。每个方框(节点)就是一个只做一件事的小 Python 函数。每个箭头(边)表示下一个要运行的方框。一只装着数据的小背包(“状态”)在流程图中传递,每个节点都能读取并往里添加内容。比如在聊天应用中,背包通常是不断累积的消息列表。
基础图
通过一个示例会更清楚:
我们来走读一下代码。这里我们构建了最简 LangGraph 应用。状态就像一只背包,在图中携带消息。我们用
State定义它,告诉 LangGraph 始终维护一份聊天消息的累积列表。接着是节点,此处就是一个函数
model_node,它查看背包,向 LLM 发送消息并返回回复。LangGraph 会把该回复自动加回背包。图本身就是一个小流程:
START → model → END。当我们编译它时,LangGraph 会将这张“图纸”变成可运行的应用。最后我们运行应用(运行的是编译后的图),传入一个已包含人类消息的背包。
为帮助建立直观认识,我们可运行以下代码查看图:
请注意:能生成可视化并不代表图一定能运行!仍可能存在需要先行修复的逻辑错误。
分支图
继续前进,来看分支机制——这是任何健壮代理型系统的重要(但不难)组件。它让智能体有更大的决策自由,把工作流升级为代理型系统。
来看代码:
大部分与第一个智能体相似,区别在于条件边。它允许我们根据 LLM 的判断提供不同的潜在路径。可视化如下:
借助条件边,我们已能构建相当健壮的代理型系统。如果您想要更系统的教程,推荐观看我的LangGraph 视频教程。
最近 LangGraph 也新增了 LangGraph Studio,强烈推荐这篇LangGraph Studio 指南。
什么是 LangFlow?
虽然LangChain 与 LangGraph 是 Lang 家族中开发者使用最广的两个库,但我认为也值得简要讨论一下 LangFlow。
可以把 LangFlow 视为 LLM 应用的拖放画布。每个节点 = 一个步骤(提示词、模型、工具、检索器、向量数据库、文件操作等)。我们将节点连成流程,然后运行、导出或部署。它非常适合快速迭代,尤其便于与非编程人员协作,并能迅速把想法变成可运行的智能体。
诚然,在构建智能体方面,它不如 LangGraph 与 LangChain 高级;但仍有一些使用理由:
我在这里假设您并非编程人员,因此当您探索架构方案(如 RAG 变体、工具使用等)并希望快速对比,或需要向相关方以可视化方式传达设计时,就很适合使用 LangFlow。
想进一步了解 LangFlow 并完成一个如“构建辅导助手”的项目,我强烈推荐这篇LangFlow 指南与演示项目。
什么是 LangSmith?
最后一个要介绍的库是 LangSmith。LangSmith 是面向 LLM 应用的可观测性 + 评估层。它提供追踪(让我们查看每一步、工具调用、Token、错误)、评估(数据集、自动化+人工评分)以及监控/告警(跟踪漂移与回归)。下图展示了 LangSmith 中一次追踪的示例: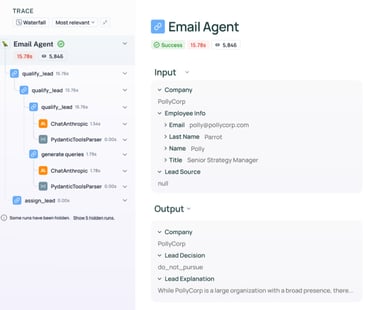
开发者选择 LangSmith 的理由很多:
关于 LangSmith 的更多信息,强烈推荐这篇详尽的LangSmith 入门介绍 和 LangSmith Agent Builder 教程。
LangChain vs LangGraph vs LangSmith vs LangFlow
本节我们来对比这四个库,帮助您彻底搞清楚它们是什么、何时使用。
它们是什么
核心组件
工作流结构
状态管理
控制流
易用性
最适合
何时用哪个
对比表
下表对比了 LangChain、LangGraph、LangSmith 与 LangFlow:
类别
LangChain
LangGraph
LangSmith
LangFlow
它们是什么
由模块化组件(提示词、模型、工具、记忆)构建 LLM 应用的框架。
基于 LangChain 的复杂有状态工作流编排器(分支、循环、持久化)。
与框架无关的 LLM 应用可观测性、评估与测试平台。
用于设计与原型流程的可视化拖放编辑器。
核心组件
Chains、Runnables、LCEL
节点、边、状态、路由、检查点、工具
追踪、运行、数据集、评估器、项目
带组件(加载器、LLM、检索器、工具)与连接的画布
工作流结构
线性或 DAG,大多为前向
完整图结构,支持环路、分支、循环、暂停
非执行框架;为日志与评估封装运行
可视化图形,可导出为 LangChain 代码
状态管理
隐式或组件本地
集中、显式状态贯穿节点;支持持久化与检查点(如聊天记忆)。
存储运行元数据、输入/输出、指标、反馈
组件配置保存在 JSON 流程中
控制流
分支/重试原语有限
对条件、重试、人机协同提供一等支持
无(专注评估而非执行)
可视化分支;语义取决于导出的后端
易用性
API 简洁
学习曲线较陡
非常易于启用(环境变量)
最易于以可视化方式起步;适合团队与非编程人员的工作坊
最适合
原型、线性逻辑、快速应用
健壮、复杂、长时运行或多智能体应用
可观测性、调试、回归测试、A/B 评估
可视化原型、干系人评审以及导出为 LangChain 代码
结语
我们已经较为深入地介绍并比较了这四个库,但要用它们成为高级 AI 工程师还有很多内容可学。因此,我强烈推荐 RAG Systems with LangChain 与 building Agentic Systems with LangChain 等课程。