
Cursus
Multi-agent systemen met LangGraph
2 uur 45 min
8.8K
Dit artikel geeft een formele vergelijking naast elkaar van LangChain vs LangGraph, en laat ook zien waar LangSmith en LangFlow in het geheel passen. We bouwen voort op concepten uit andere DataCamp‑artikelen en bespreken wanneer je welk framework kiest om productierijpe, agentische AI‑systemen te leveren. Als je op zoek bent naar een praktische start met LangChain, raad ik de cursus Developing LLM Applications with LangChain aan.
Voordat we de diepte ingaan, hier een kort overzicht van hoe LangChain, LangGraph, LangSmith en LangFlow samenhangen en wanneer je voor elk zou kiezen.
Snelle vuistregel: Begin met LangChain, stap over op LangGraph naarmate workflows groeien, voeg LangSmith toe voor observability, gebruik LangFlow wanneer je snel wilt itereren of samenwerken.
Grote taalmodellen (LLM’s) zijn sterk in enkele prompts. Dat is inmiddels algemeen bekend, aangezien we deze modellen tegenwoordig zo vaak gebruiken.
Echte applicaties hebben echter workflows nodig: data ophalen, redeneren, tools aanroepen, een vervolgvraag stellen, opnieuw proberen bij fouten en soms pauzeren voor een mens. Daarom hoor je steeds twee frameworks terugkomen: LangChain en LangGraph. Ze leven in hetzelfde ecosysteem en werken vaak samen, maar lossen verschillende delen van het probleem op:
Over het ecosysteem gesproken: we bespreken ook LangSmith (voor observability/evaluatie) en LangFlow (een drag‑en‑drop‑visuele bouwer), want die maken hier eveneens deel van uit.
Het is zinvol om te beginnen met wat geschiedenis over het LangChain‑ecosysteem; het is uitgegroeid tot het standaardframework voor agentische AI, en weten hoe het hier is gekomen maakt duidelijker waarom LangGraph, LangSmith en LangFlow ertoe doen.
Laten we nu dieper in het kernecosysteem duiken, te beginnen met LangChain en LangGraph.
LangChain is een modulair framework voor het bouwen van LLM‑gestuurde applicaties. Het geeft ons bouwstenen — prompts, modellen, geheugen, tools, retrievers — en een eenvoudige manier om ze aan elkaar te schakelen tot een pijplijn via de Runnable/LCEL‑API’s (daar komen we zo op). Ik zie het als een doos Lego‑steentjes voor gangbare LLM‑patronen zoals RAG, vraag‑antwoord, chatbots en tools‑gebruikende agents.
LangGraph is nieuwer, een grafengebaseerde orkestratielaag bovenop LangChain‑componenten. In plaats van één rechte lijn met stappen wordt de app gemodelleerd als nodes (de acties) en edges (de overgangen), met een expliciet state‑object dat door de graf stroomt. We gaan dit zo dieper bespreken, maar onthoud alvast dat dit ontwerp het natuurlijk maakt om te vertakken (verschillende paden nemen), te loopen (verduidelijkende vragen stellen tot er zekerheid is), te retryen (bij tool/model‑fouten) en te pauzeren voor menselijke review; precies wat we nodig hebben voor langlopende, productieklare agents.
Nu kun je je afvragen:
“Waarom ze überhaupt vergelijken?”
Het zit zo: hoewel ze componenten delen, mikken ze op verschillende complexiteitsniveaus:
In de praktijk beginnen veel ontwikkelaars met LangChain om een idee te valideren, en stappen daarna over op LangGraph wanneer ze vertakkingen, foutafhandeling, coördinatie tussen meerdere agents of duurzaamheid toevoegen.
Nu gaan we de diepte in met LangChain, het gebruik begrijpen en er applicaties in coderen. Nogmaals, onthoud dat LangChain een bibliotheek is waarmee we een basis voor sequentiële LLM‑workflows kunnen bouwen.
Om te beginnen wil ik uitleggen wat LCEL is. LCEL, of LangChain Expression Language, is simpelweg een manier om blokken met pipes (|) aan elkaar te koppelen. Elk blok kan een prompt, een model, een retriever of een parser zijn. Door ze te verbinden krijgen we een chain die we keer op keer kunnen draaien, wat het schrijven van code veel efficiënter maakt.
Laten we een paar voorbeelden doornemen.
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

llm    = ChatOpenAI(model="gpt-4o-mini")
prompt = ChatPromptTemplate.from_messages([
    ("system", "You are concise."),
    ("human", "{question}")
])
chain = prompt | llm | StrOutputParser() # This is our chain

print(chain.invoke({"question": "Give me 3 focus tips."}))     # making a single call

qs = [{"question": q} for q in ["One tactic for RAG?", "Explain LCEL in 1 line."]]
print(chain.batch(qs))                                         # many calls at once
Naar mijn mening laat de bovenstaande codecel de eenvoudigste manier zien om LCEL te gebruiken. We maakten eerst een prompttemplate die altijd een system message bevat (“you are concise”) en ruimte laat voor een menselijke vraag. De system message is als een instructie aan de LLM die aangeeft om op een bepaalde manier te reageren/handelen. Daarna koppelden we deze template aan een OpenAI‑model — GPT‑4o‑mini.
Als laatste voegde ik een outputparser toe, die de respons in gewone tekst omzet.
Hier komt het belangrijkste: De |‑operator is wat deze blokken aan elkaar lijmt tot één pijplijn.
Ik wil ook invoke() en batch() aanstippen. Wanneer we chain.invoke(...) aanroepen, draait de pijplijn één keer: de template vult de vraag in, het model genereert een antwoord en de parser geeft schone tekst terug.
Maar wanneer we chain.batch(...) aanroepen, draait dezelfde chain op veel invoeren tegelijk, wat veel sneller is dan één voor één loopen. In de praktijk maakt dit het makkelijk om van één simpele call naar het verwerken van hele datasets te gaan met vrijwel geen extra code.
Ik wil hier nog een voorbeeld laten zien:
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import StrOutputParser

stream_chain = (ChatPromptTemplate.from_template("{topic}")  | ChatOpenAI(model="gpt-4o-mini")  | StrOutputParser())

# Simple stream
for chunk in stream_chain.stream({"topic": "Explain PID in 2 lines"}):
    print(chunk, end="")
Deze code lijkt erg op de eerste, maar in plaats van één keer aan te roepen, gebruiken we streaming. Met .stream(...) wacht het model niet tot het hele antwoord klaar is. In plaats daarvan stuurt het tekst in stukjes zodra die worden gegenereerd, en wij printen die realtime.
De hoofdboodschap van deze subsectie is dat LCEL het simpele “pipes en blokken”‑systeem is waarmee we prompts, modellen, tools en parsers aan elkaar klikken en meteen een chain krijgen die we kunnen draaien, batchen of streamen zonder extra code.
Gestructureerde outputs zijn cruciaal voor AI‑agents. Het betekent dat onze agent in plaats van een lange rommelige tekst het antwoord geeft in een duidelijk format zoals JSON, tabellen of lijsten. Dit maakt het makkelijker voor computers en mensen om te lezen, te gebruiken en te koppelen aan andere tools.
Een van de belangrijkste frameworks die hiervoor in de industrie worden gebruikt is Pydantic.
from pydantic import BaseModel, Field
from typing import List
from langchain_openai import ChatOpenAI

class TaskPlan(BaseModel):
    title: str
    steps: List[str] = Field(..., min_items=3, description="actionable steps")

structured = ChatOpenAI(model="gpt-4o-mini").with_structured_output(TaskPlan)
plan = structured.invoke("Plan a 20-minute deep-work session for AI Agent notes.")
print(plan.model_dump())
In dit voorbeeld is de methode .with_structured_output() het belangrijkste deel, want die vertelt de LLM om de output te geven in het Pydantic‑modelformaat dat we hebben gemaakt. Achter de schermen zorgt LangChain ervoor dat het antwoord van onze agent echte JSON is die aan het format voldoet, en zet het dat vervolgens om in een Python‑object dat je direct kunt gebruiken.
In plaats van rommelige tekst krijgen we dus iets als TaskPlan(title="...", steps=["...", "...", "..."]). Dit is vooral handig wanneer we Tools gebruiken.
Tools zijn belangrijk omdat ze de mogelijkheden van onze LLM uitbreiden door taken uit te voeren die eerder niet mogelijk waren, zoals internetzoeken.
Wat ik het mooist vind aan tools is dat LangChain (en veel van deze agentische frameworks) kant‑en‑klare tools biedt, de Built‑In Tools, die erg makkelijk te gebruiken zijn. Bovendien kunnen we ook onze eigen tools maken met een decorator @tool, die LangChain vertelt dat dit een speciaal soort functie is.
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI

@tool
def multiply(a: int, b: int) -> int:
    """This tool multiplies two numbers."""
    return a * b

llm = ChatOpenAI(model="gpt-4o-mini")
llm_tools = llm.bind_tools([multiply])   # exposing the tools to the model

resp = llm_tools.invoke("What is 9*5? If needed, use a tool.")
print(resp.tool_calls or resp.content)   # model may emit a tool call with arguments
In de bovenstaande codecel zie je dat ik een heel eenvoudige tool heb gemaakt die twee getallen neemt en hun product teruggeeft. Om het interne model (in dit geval GPT‑4o‑mini) toegang te geven tot zulke tools, gebruiken we de methode llm.bind_tools() en geven we de lijst met tools door, waarmee we de tools aan het model blootstellen.
Geheugen is ook erg belangrijk bij het bouwen van AI‑agents. AI‑agents met geheugen kunnen dingen onthouden uit eerdere gesprekken, zoals wat we eerder vroegen, onze voorkeuren, of wat wel of niet werkte. Zonder geheugen voelt het elke keer alsof je iemand nieuw ontmoet — we zouden telkens weer basiscontext moeten herhalen, wat behoorlijk omslachtig is.
In LangChain betekent geheugen dat je eerdere berichten of feiten opslaat (in geheugen, database of vectorstore). Wanneer de agent daarna weer draait, kan hij dat geheugen ophalen zodat de antwoorden consistenter en slimmer aanvoelen.
Er zijn grofweg twee soorten: kortetermijngeheugen (recente berichten in dezelfde chat) en langetermijngeheugen (feiten of voorkeuren die over meerdere sessies heen worden onthouden). Let op: een sessie is één gesprek of interactievenster, waarin onze agent bijhoudt wat er is gezegd tot het eindigt.
Kortetermijn bewaart context tijdens één gesprek, terwijl langetermijn de agent over tijd persoonlijker en behulpzamer maakt.
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_core.chat_history import InMemoryChatMessageHistory

prompt = ChatPromptTemplate.from_messages([
    ("system", "Be brief"),
    MessagesPlaceholder(variable_name="history"),
    ("human", "{input}")
])
chain = prompt | ChatOpenAI(model="gpt-4o")

store = {}  # session_id -> history
def get_history(session_id: str):
    if session_id not in store:
        store[session_id] = InMemoryChatMessageHistory()
    return store[session_id]

with_history = RunnableWithMessageHistory(
    chain,
    lambda cfg: get_history(cfg["configurable"]["session_id"]),
    input_messages_key="input",
    history_messages_key="history",
)

cfg = {"configurable": {"session_id": "u1"}}
print(with_history.invoke({"input": "My name is Vaibhav."}, config=cfg))
print(with_history.invoke({"input": "What is my name?"}, config=cfg))
In de bovenstaande cel maakt de code eerst een chat‑chain die eerdere berichten binnen een sessie kan onthouden. De prompt heeft een history‑placeholder en RunnableWithMessageHistory vult die automatisch met het juiste gesprek elke keer. De store bewaart geschiedenissen voor verschillende sessies.
Belangrijk om te onthouden: gebruik geheugen doordacht. Bepaal en codeer wat de moeite waard is om te bewaren, wanneer je het opslaat en hoeveel je terug in de prompt stopt. Te veel geheugen kan dingen vertragen of limieten overschrijden, maar de juiste balans maakt onze agents veel nuttiger.
We gaan nu naar het andere agentische framework — LangGraph.
Om LangGraph eenvoudig uit te leggen, gebruik ik een analogie: de Rugzak‑flowchart‑analogie.
Zie LangGraph als een kleine stroomschema voor onze AI‑app. Elk blok (een node) is gewoon een kleine Python‑functie die één taak doet. De pijlen (edges) bepalen welk blok daarna draait. Een kleine rugzak met data (de “state”) beweegt door het stroomschema, zodat elke node het kan lezen en aanvullen. In een chat‑app is die rugzak bijvoorbeeld meestal de doorlopende lijst met berichten.
Dit wordt duidelijker als we samen een voorbeeld doornemen:
pip install langgraph langchain-openaifrom typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage
# This is the backpack that moves through the graph.
class State(TypedDict):
# To add messages to the state
messages: Annotated[List, add_messages]
llm = ChatOpenAI(model="gpt-4o")
# This is a node that asks the model and adds the reply to the backpack.
def model_node(state: State):
reply = llm.invoke(state["messages"])
return {"messages": [reply]}
# Building the graph
graph = StateGraph(State)
graph.add_node("model", model_node)
graph.add_edge(START, "model")
graph.add_edge("model", END)
# Building and running once
app = graph.compile()
result = app.invoke({"messages": [HumanMessage(content="Explain LangGraph in one sentence.")]} )
print(result["messages"][-1].content)Laten we de code doorlopen. We bouwen hier de simpelst mogelijke LangGraph‑app. De state is als een rugzak die berichten door de graf draagt. We definiëren die met State, wat LangGraph vertelt om altijd een doorlopende lijst met chatberichten bij te houden.
Dan komt de node, hier gewoon één functie, model_node, die in de rugzak kijkt, de berichten naar de LLM stuurt en het antwoord teruggeeft. LangGraph voegt dit antwoord vervolgens automatisch terug in de rugzak.
De graf zelf is een klein stroomschema: START → model → END. Wanneer we het compileren, zet LangGraph deze tekening om in een uitvoerbare app.
Tot slot draaien we de app (niet de graf zelf, maar de gecompileerde graf) met een rugzak die al een menselijk bericht bevat.
Om je visuele begrip te helpen, kunnen we deze code draaien om de graf te bekijken:
from IPython.display import Image, display
display(Image(app.get_graph().draw_mermaid_png()))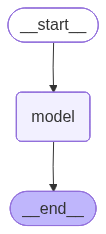
Let wel: het feit dat de visualisatie is gegenereerd betekent niet dat de graf zal draaien! Er kunnen logische fouten zijn die eerst opgelost moeten worden.
Laten we verdergaan met Branching, een belangrijk (maar eenvoudig) onderdeel van elk robuust agentisch systeem. Het geeft onze agents meer vrijheid om keuzes te maken en maakt er een agentisch systeem van in plaats van een workflow.
Laten we naar de code kijken:
from typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, AIMessage

# Defining the state
class State(TypedDict):
    messages: Annotated[List, add_messages]

llm = ChatOpenAI(model="gpt-4o-mini")

def answer_node(state: State):
    # Normal answer using the whole chat history.
    return {"messages": [llm.invoke(state["messages"])]}

def clarify_node(state: State):
    # LLm asking for a short follow-up to get enough detail (clarifying)
    return {"messages": [AIMessage(content="Could you share a bit more so I can be precise?")]}

# Router function
def route(state: State):
    # Look for the latest human message and count words.
    last_human = next((m for m in reversed(state["messages"]) if m.type == "human"), None)
    if not last_human:
        return "clarify"
    words = len(str(last_human.content).split())
    return "answer" if words >= 3 else "clarify"

graph = StateGraph(State)
graph.add_node("answer", answer_node)
graph.add_node("clarify", clarify_node)

# Adding a conditional edge to connect the router function
graph.add_conditional_edges(START, route, {"answer": "answer", "clarify": "clarify"})
graph.add_edge("answer", END)
graph.add_edge("clarify", END)
app = graph.compile() # Compiling the graph
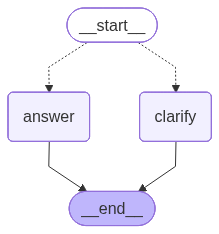
Het meeste lijkt op de eerste agent, behalve de conditionele edge. Daarmee kunnen we het systeem verschillende mogelijke routes geven op basis van het oordeel van de LLM. Visueel ziet het systeem er zo uit:
Met conditionele edges kunnen we al behoorlijk robuuste agentische systemen bouwen met onze huidige kennis. Wil je een uitgebreidere tutorial, bekijk dan mijn videotutorial over LangGraph.
Onlangs is er ook een nieuwe toevoeging aan LangGraph gekomen, LangGraph Studio, en ik beveel deze LangGraph Studio‑gids hierover van harte aan.
Hoewel LangChain en LangGraph de twee bibliotheken zijn waar de meeste ontwikkelaars in de Lang‑familie naar grijpen, vind ik het de moeite waard om ook kort LangFlow te bespreken.
Zie LangFlow als een drag‑en‑drop‑canvas voor LLM‑apps. Elke node = één stap (prompt, model, tool, retriever, vector‑DB, bestandsbewerking, enz.). We verbinden nodes tot een flow, en draaien die vervolgens, exporteren of deployen hem. Het is geweldig voor snelle iteratie en bijzonder geschikt om samen te werken met niet‑programmeurs en om ideeën snel om te zetten in werkende agents.
Het is inderdaad niet zo geavanceerd als LangGraph en LangChain voor het bouwen van agents; toch zijn er redenen om het te gebruiken:
Ik ga er even van uit dat jij een niet‑programmeur bent; gebruik LangFlow dan wanneer je architectuuropties (RAG‑varianten, toolgebruik, enz.) wilt verkennen en snel vergelijken, of wanneer je ontwerpen visueel aan stakeholders wilt communiceren.
Wil je meer leren over LangFlow en een project afronden zoals het bouwen van een Tutor, dan raad ik deze LangFlow‑gids met demoproject van harte aan.
De laatste bibliotheek die ik wil behandelen is LangSmith. LangSmith is de observability‑ plus evals‑laag voor LLM‑apps. Het biedt tracing (waarmee je elke stap, toolcall, token, fout kunt zien), evaluatie (datasets, geautomatiseerde & human‑in‑the‑loop‑scoring) en monitoring/alerts (drift, regressies volgen). Een voorbeeld van een trace in LangSmith zie je hieronder: 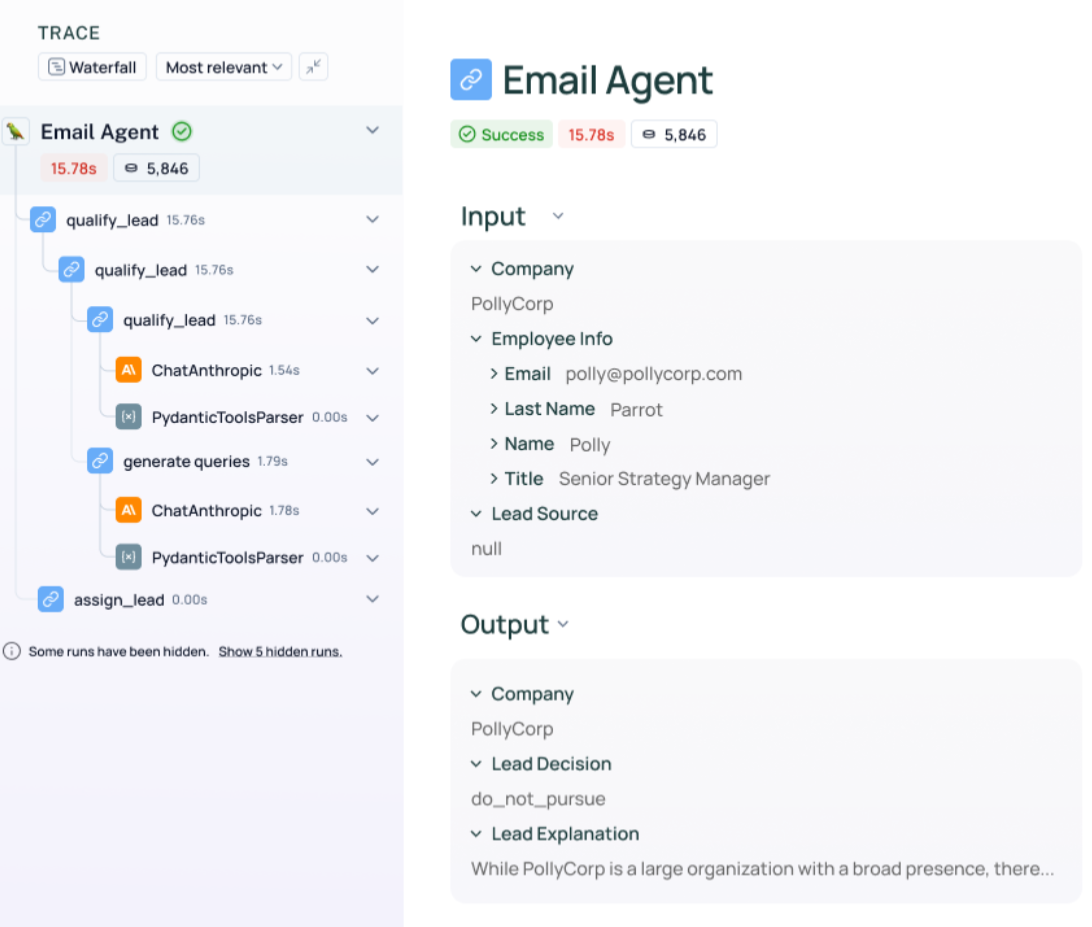
Er zijn veel redenen waarom ontwikkelaars LangSmith zouden gebruiken:
Voor meer informatie over LangSmith raad ik deze uitgebreide introductie tot LangSmith en de LangSmith Agent Builder‑tutorial aan.
In deze sectie vergelijk ik alle vier bibliotheken, zodat je precies weet wat ze zijn en wanneer je ze gebruikt.
In de tabel hieronder vind je de vergelijking van LangChain vs LangGraph vs LangSmith vs LangFlow:
|
Categorie |
LangChain |
LangGraph |
LangSmith |
LangFlow |
|
Wat ze zijn |
Framework voor het bouwen van LLM‑apps uit modulaire onderdelen (prompts, modellen, tools, geheugen). |
Orkestrator voor complexe, stateful workflows (vertakkingen, lussen, persistentie) bovenop LangChain. |
Framework‑agnostisch platform voor observability, evaluatie en testen van LLM‑apps. |
Visuele drag‑en‑drop‑editor om flows te ontwerpen en te prototypen. |
|
Primaire componenten |
Chains, Runnables, LCEL |
Nodes, edges, state, routers, checkpointers, tools |
Traces, runs, datasets, evaluators, projecten |
Canvas met componenten (loaders, LLM’s, retrievers, tools) + verbindingen |
|
Workflowstructuur |
Lineair of DAG, meestal alleen voorwaarts |
Volledige graf met cycli, vertakkingen, lussen, pauzes |
Geen uitvoeringsframework; omwikkelt runs voor logging & evaluatie |
Visuele graf, exporteerbaar naar LangChain‑code |
|
State‑beheer |
Impliciet of component‑lokaal |
Centrale, expliciete state door nodes heen; ondersteunt persistentie & checkpointing (bijv. chatgeheugen). |
Slaat run‑metadata, inputs/outputs, metrieken en feedback op |
Componentconfiguraties opgeslagen in JSON‑flow |
|
Controlflow |
Beperkte primitives voor vertakkingen/retries |
First‑class ondersteuning voor conditionals, retries, human‑in‑the‑loop |
Geen (focus ligt op evaluatie, niet op uitvoering) |
Visuele vertakkingen; semantiek hangt af van de geëxporteerde backend |
|
Gebruiksgemak |
Simpele API’s |
Steilere leercurve |
Zeer eenvoudig te activeren (env‑variabelen) |
Het makkelijkst om visueel te starten; teamvriendelijk voor workshops & niet‑programmeurs |
|
Het best voor |
Prototypen, lineaire logica, snelle apps |
Veerkrachtige, complexe, langlopende of multi‑agent‑apps |
Observability, debuggen, regressietests, A/B‑evaluaties |
Visueel prototypen, stakeholderreviews en export naar LangChain‑code |
We hebben deze 4 bibliotheken nu uitgebreid behandeld en vergeleken, maar er valt natuurlijk veel meer te leren om met deze bibliotheken een gevorderde AI‑engineer te worden. Daarom raad ik cursussen aan zoals RAG‑systemen met LangChain en Agentische systemen bouwen met LangChain.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

