

LangGraph 基础
先从 LangGraph 的基本构件讲起。这些要素让我们能够为高级 AI 代理搭建结构化、有状态、可扩展的工作流。
State(状态)
所谓状态(state),是贯穿整张图的共享内存对象。它存储所有相关信息,如消息、变量、中间结果与决策历史。LangGraph 会自动管理状态,从而提升开发效率。
除基本状态外,还有更高级的配套能力,如检查点(checkpointing)、线程本地内存与跨会话持久化。在执行过程中,状态会不断被更新,如下图所示: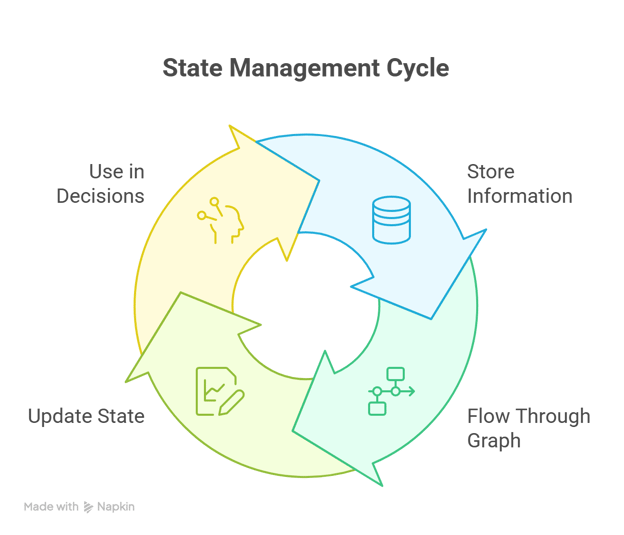
LangGraph 中的状态管理循环,展示了跨节点的持续更新
Node(节点)
每个节点(node)都是工作流中的一个功能单元。它可以执行多种操作,例如:
- 调用大语言模型(LLM)
- 调用工具或 API
- 运行自定义 Python 函数
- 路由逻辑或分支决策
每个节点接收当前状态并返回更新后的状态。
Edges 与条件边
边(Edges)定义了节点之间的转移,决定图的控制流,可以支持:
- 静态连接(用于线性推进)
- 循环路径(用于迭代行为)
- 动态分支(基于状态条件,通过条件边实现)
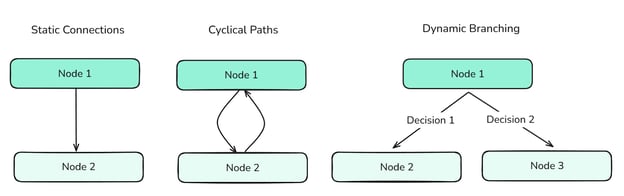
不同类型的边定义了节点间的流动,并在整张图中控制信息传递。
边对于编排复杂代理行为至关重要。
Graph 与 StateGraph
LangGraph 中的图(graph)定义了代理工作流的结构,由节点与边组成。
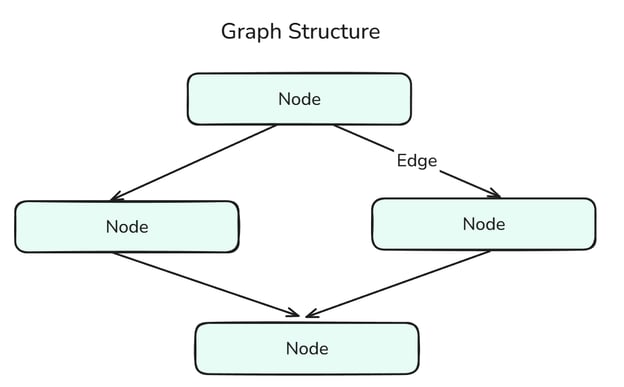
图结构由节点与边共同构成。
所谓StateGraph,是一种专门的图,在整个执行过程中维护并更新共享状态,使决策具备上下文感知,并在多步间保留记忆。可以将其视为 State 与 Graph 的融合。
Tool 与 ToolNode
所谓工具(tool),是代理可调用的任意外部或内部函数,如网页搜索、计算器或自定义工具。工具有两类:
- 内置工具:由 LangChain 预制并可直接使用的工具,可在文档中查看。
- 自定义工具:我们自行编写并在应用中使用的工具(通过装饰器与 DocString 的指定来实现——后续代码会演示)。
所谓ToolNode,是图中专用于执行工具的节点类型,便于开发者无需额外封装逻辑即可集成工具。可以将其视为 Tool 与 Node 的融合。
消息类型
消息(Messages)是贯穿整张图并存储于状态中的结构化数据元素(如用户输入、系统输出、中间响应等)。它们提供可追溯性、记忆与上下文,帮助代理做出更有依据的决策。
LangGraph 中有多种消息类型(MessageTypes):
- HumanMessage:表示来自用户的输入。它是与代理在图中开启或延续对话时最常见的消息类型。
- AIMessage:表示由底层语言模型生成的响应。这些消息会被存储以维持对话记忆,并为后续动作提供依据。
- SystemMessage:向 LLM 提供上下文或行为设定(例如:“You are my personal assistant.”)。该消息会影响模型的应答方式。
- ToolMessage:封装工具输出。当代理需要依赖外部操作(如计算或搜索)决定下一步时,这类消息尤为关键。
- RemoveMessage:用于以编程方式从状态中删除或撤销先前加入的消息,有助于纠错或裁剪无关上下文。
- BaseMessage:LangChain 与 LangGraph 中所有消息类型的父类。诸如
HumanMessage、AIMessage或SystemMessage等具体类型均继承自BaseMessage。
LangGraph 代理
接下来我们将用 LangGraph 编写这些代理,重点理解编码时涉及的不同方法与步骤,并对代理进行可视化。
单代理工作流
先创建一个不含工具与记忆的单一代理。先从导入开始:
from typing import TypedDict, List
from langchain_core.messages import HumanMessage
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, START, END
from dotenv import load_dotenv第一行提到 TypedDict,这是 Python 中的一种类型注解,定义方式如下:
from typing import TypedDict
class Student(TypedDict):
name: str
grade: float
s1: Student = {"name": "Sam", "grade": 92.5}本质上,TypedDict 是带有强类型安全的字典,对 AI 代理开发十分关键。
HumanMessage 您现在应该已很熟悉,因为我们刚刚讨论过。
ChatOpenAI 则是新的。我们稍作解释。
借助 LangChain,我们可以使用 Chat 家族,便可通过相应库(如 ChatOpenAI、ChatAnthropic、ChatOllama 等)调用来自 OpenAI、Anthropic、Ollama 等不同提供商的模型。
它们在参数与用法上大体一致,有利于我们代码的模块化。更多细节见LangChain 文档。
最后,StateGraph 我们已介绍过,而 Start 与 End 分别是图的起点与终点。
继续:
load_dotenv() # Obtaining over secret keys
# Creation of the state using a Typed Dictionary
class AgentState(TypedDict):
messages: List[HumanMessage] # We are going to be storing Human Messages (the user input) as a list of messages
llm = ChatOpenAI(model="gpt-4o") # Our model choice
# This is an action - the underlying function of our node
def process(state: AgentState) -> AgentState:
response = llm.invoke(state["messages"])
print(f"\nAI: {response.content}")
return state
graph = StateGraph(AgentState) # Initialization of a Graph
graph.add_node("process_node", process) # Adding nodes
graph.add_edge(START, "process_node") # Adding edges
graph.add_edge("process_node", END)
agent = graph.compile() # Compiling the graph我们详细聊聊 .add_node() 与 .add_edge() 方法。
add.node():主要关注两个参数;节点名称与底层动作。底层动作在此为process(),即到达该阶段时要完成的核心逻辑。节点名可任意,甚至与函数同名,但那样调试时可能更容易混淆!add_edge.():同样主要关注两个参数,即边的起点与终点节点。注意,这里传入的是节点名,而非底层动作。
看一个实际示例:
user_input = input("Enter: ")
while user_input != "exit":
agent.invoke({"messages": [HumanMessage(content=user_input)]})
user_input = input("Enter: ")这段代码允许我们多次调用代理。从可视角度看,我们构建的 AI 代理如下:
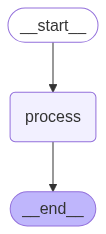
顺序代理(Sequential Agent)按预设顺序逐步完成任务,无分支与推理。
要获得这样的可视化,我们可以使用以下代码(注意:使用已编译的图):
from IPython.display import Image, display
display(Image(agent.get_graph().draw_mermaid_png()))ReAct 代理
ReAct 代理(推理-行动代理)在业界非常常见,因其易于创建且足够健壮。鉴于其普及,LangGraph 提供了可直接利用的内置方法来创建这类代理。
幸运的是,我们只需再导入两项:
from langgraph.prebuilt import create_react_agent
from langchain_google_community import GmailToolkitcreate_react_agent 方法会为我们创建 ReAct 代理。
tools = [GmailToolkit()] # We are using the Inbuilt Gmail tool
llm = ChatOllama(model="qwen2.5:latest") # Leveraging Ollama Models
agent = create_react_agent(
model = llm, # Choice of the LLM
tools = tools, # Tools we want our LLM to have
name = "email_agent", # Name of our agent
prompt = "You are my AI assistant that has access to certain tools. Use the tools to help me with my tasks.", # System Prompt
)使用此方式的最大好处是,我们可以创建多个代理并搭建更复杂的架构。
我们也可以创建自定义工具。
@tool
def send_email(email_address: str, email_content: str) -> str:
"""
Sends an email to a specified recipient with the given content.
Args:
email_address (str): The recipient's email address (e.g., '[email protected]')
email_content (str): The body of the email message to be sent
Returns:
str: A confirmation message indicating success or failure
Example:
>>> send_email('[email protected]', 'Hello John, just checking in!')
'Email successfully sent to [email protected]'
"""
# Tool Logic goes here
return "Done!"如上所述,创建自定义工具时有两点尤为重要:
- 装饰器(Decorator):告知 LangGraph 该函数是特殊函数——工具。
- 文档字符串(Docstring):用于向 LLM 说明工具的作用。提供参数说明与示例会让工具调用更可靠。
ReAct 代理的结构大致如下:
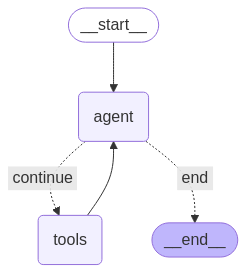
ReAct 代理在“思考(推理)”与“行动”之间交替,以分步解决任务。
用于状态增长的 Reducer 函数
当为更复杂、健壮的代理系统定义 State 时,建议使用 Reducer 函数,或简称 reducers。reducers 是数据注解,确保每次节点返回消息时,都会将其追加到状态中的现有列表,而非覆盖旧值。这样我们的状态就能逐渐累积上下文。
# State with reducer function
class AgentState(TypedDict):
messages: Annotated[list[BaseMessage], operator.add]上述代码将 reducer 函数 operator.add 集成到状态中,确保所有消息都会被保留。
LangGraph 中的内存管理
本节聚焦每个代理的核心组件——记忆(Memory)。记忆为代理提供必需的上下文,使其更稳健可靠。我们来看看在代理中管理记忆的多种方式。
外部检查点存储
状态(State)是 LangGraph 中最重要的元素,因此有多种方式可将状态外部化存储。常见选项包括:
- SQLite
- PostgreSQL
- Amazon S3
- Azure Blob Storage
- Google Cloud Storage
- Mem0
以上库均可在文档中找到。
这里先看 SQLite:
from langgraph.checkpoint.sqlite import SqliteSaver
memory = SqliteSaver.from_conn_string(":memory:") # This is for connecting to the SQLite database
graph = graph_builder.compile(checkpointer=memory) # Compiling graph with checkpointer as SQLite backend使用SQLite 是为代理增加“持久化”的简易途径。持久化即在不同交互间保持上下文的能力。
以上都是关于状态的存储与更新。现在看看如何有效使用和管理该状态,尤其是会话进行中不断增大的 messages 列表。
LangGraph 原生支持短期与长期记忆。我们分别来看。
短期记忆
短期记忆让代理在会话期间记住消息历史,适用于多轮对话。
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph
checkpointer = InMemorySaver()
builder = StateGraph(...)
graph = builder.compile(checkpointer=checkpointer)
# Invoking the Graph with our message
agent_graph.invoke(
{"messages": [{"role": "user", "content": "What's the weather today?"}]},
{"configurable": {"thread_id": "session_42"}},
)在上述示例中,thread_id 用于唯一标识一次对话或会话。
长期记忆
长期记忆可跨多个会话保持有效,非常适合记住姓名、目标或设置等在会话之间同样重要的信息。
from langgraph.store.memory import InMemoryStore
from langgraph.graph import StateGraph
long_term_store = InMemoryStore()
builder = StateGraph(...)
agent = builder.compile(store=long_term_store)然而,随着对话变长,我们需要限制消息历史的长度。这时就需要“裁剪”。
裁剪(Trimming)
下例中,我们从消息历史的开头移除 token(因为 strategy="first"),以保证裁剪后最多保留 150 个 token。
from langchain_core.messages.utils import trim_messages, count_tokens_approximately
trimmed = trim_messages(
messages=state["messages"],
strategy="first", # remove the messages from beginning
token_counter=count_tokens_approximately,
max_tokens=150
)基于摘要的剪枝
另一种减少消息历史的方式是摘要。与简单从对话某处剪掉 token 不同,摘要能在消息历史中保留关键信息。
from langmem.short_term import SummarizationNode
from langchain_core.messages.utils import count_tokens_approximately
summary_node = SummarizationNode(
model=summary_llm, # Our summarization LLM
max_tokens=300, # Total token limit
max_tokens_before_summary=150, # when to start summarizing
max_summary_tokens=150, # summary size
token_counter=count_tokens_approximately
)需注意,摘要由底层 LLM 执行,此处的 summary_llm 可为任意 LLM。
选择性删除
内存管理的最后一项关键操作是删除。要删除选定消息,可使用:
from langchain_core.messages import RemoveMessage
def clean_state(state):
# Remove all tool-related messages
to_remove = [RemoveMessage(id=msg.id) for msg in state["messages"] if msg.role == "tool"]
return {"messages": to_remove}在上例中,我们删除了所有与工具相关的消息,它们可能是冗余的(因为在实践中,Tool-Message 是供LLM 在使用工具后生成答案时参考的)。
若要删除整个消息历史,可这样:
from langgraph.graph.message import REMOVE_ALL_MESSAGES
from langchain_core.messages import RemoveMessage
def reset_history(state):
# Remove entire conversation history
return {"messages": [RemoveMessage(id=REMOVE_ALL_MESSAGES)]}结语
总体而言,LangGraph 是一个强大的库,提供了构建代理式系统的结构化与可扩展方法。将逻辑建模为由节点与边组成的图,并辅以共享状态与持久化记忆,使我们能开发出能够推理、交互并随时间适应的健壮代理。
随着系统复杂度上升,该框架提供了管理记忆、协调工具使用与维持长期上下文所需的工具——同时保持模块化与可扩展性。
现在您已掌握核心组件,足以设计并部署能处理真实世界工作流的健壮 AI 代理。
继续学习,欢迎查看我们的课程《使用 LangGraph 构建多代理系统》。您还可以查看我们的《用 LangChain 设计代理式系统》课程以及代理式 RAG 教程。
LangGraph 代理常见问答
LangGraph 到底是什么?
一个 Python 框架,将 AI 代理的逻辑建模为由节点与边构成的图,从而支持推理、工具调用与记忆。
为什么我应选择 LangGraph 而非其他代理库?
LangGraph 使用图结构来定义逻辑,这是其他流行代理框架所不具备的关键差异点。LangGraph 还原生支持循环、分支、记忆、持久化与多代理工作流——非常适合面向实际生产、可扩展的代理系统。
LangGraph 如何管理与持久化记忆?
它使用可短期(内存中)或长期(SQLite、S3 等)存储的共享状态,使代理能够记住过往交互。
我可以改用本地模型吗?
当然可以!LangGraph 原生支持 Ollama 模型、HuggingFace 模型、LlamaCpp 等。
如何缩减冗长的消息历史?
使用trim_messages 丢弃旧 token,或使用 SummarizationNode 在保留关键信息的同时压缩历史消息。

LangGraph 是一个基于图的框架,用于构建能够通过相互衔接的步骤进行推理、规划与执行的 AI 代理。它的独特之处在于,能轻松创建循环与分支的工作流,每个节点都可以运行一个 LLM、工具或函数——并在此过程中自动管理状态。
这使得 LangGraph 特别适合构建复杂、健壮的多代理系统,具备记忆、错误处理与实时决策能力。
在本教程中,我将带您了解 LangGraph 的基础与高级功能:从核心组件入门,到构建带有状态与工具增强的 AI 代理。如果您对使用 LangGraph 构建多代理系统感兴趣,务必查看我们的动手课程。您也可以观看我们在下方关于构建 LangGraph 代理的视频教程。