LangChain vs. LangGraph vs. LangSmith vs. LangFlow: Die wichtigsten Unterschiede erklärt
Vergleiche LangChain, LangGraph, LangSmith und LangFlow. Erfahre Rollen, Stärken und wann du welches Framework für produktionsreife KI-Anwendungen einsetzt.
Dieser Artikel liefert einen formalen Direktvergleich von LangChain vs. LangGraph sowie die Einordnung von LangSmith und LangFlow. Wir knüpfen an Konzepte aus anderen DataCamp-Artikeln an und besprechen, wann du welches Framework wählst, um produktionsreife, agentische KI-Systeme auszuliefern. Wenn du einen praxisnahen Einstieg in LangChain suchst, empfehle ich den Kurs Developing LLM Applications with LangChain.
TL;DR
Vorab eine kurze Übersicht, wie LangChain, LangGraph, LangSmith und LangFlow zusammenspielen und wann du welches Tool einsetzt.
LangChain: Die Basis. Baue modulare LLM-Workflows (Prompts, Tools, Memory, Retriever) über einfache APIs wie LCEL. Ideal für Prototyping und lineare Apps.
LangGraph: Der Orchestrator. Steuert komplexe, zustandsbehaftete, verzweigende Workflows mit Retries, Schleifen und Persistenz. Am besten für robuste, produktionsreife Multi-Agent-Systeme.
LangSmith: Der Beobachter. Framework-unabhängiges Tracing, Evaluation und Monitoring von LLM-Apps. Optimal für Debugging, Regressionstests und Qualitäts-Tracking.
LangFlow: Der visuelle Builder. Drag-and-drop für schnelles Prototyping und Export in Code. Ideal für Teams, Workshops und Nicht-Coder.
Schnelle Heuristik: Starte mit LangChain, wechsle zu LangGraph, wenn Workflows wachsen, füge LangSmith für Beobachtbarkeit hinzu, nutze LangFlow für schnelle Iteration oder Kollaboration.
Einführung in LangChain und LangGraph
Große Sprachmodelle (LLMs) sind stark bei einzelnen Prompts. Das ist inzwischen Allgemeinwissen, weil wir sie heute so oft einsetzen.
Echte Anwendungen brauchen jedoch Workflows: Daten holen, schlussfolgern, Tools aufrufen, Rückfragen stellen, bei Fehlern erneut versuchen und manchmal für menschliches Feedback pausieren. Deshalb hörst du immer wieder von zwei Frameworks: LangChain und LangGraph. Beide leben im selben Ökosystem und arbeiten oft zusammen, lösen aber unterschiedliche Teile des Problems:
LangChain hilft uns, die Schritte zu bauen.
LangGraph hilft uns, diese Schritte zu orchestrieren, wenn es komplex wird.
Apropos Ökosystem: Wir sprechen auch über LangSmith (Beobachtbarkeit/Evaluation) und LangFlow (visueller Drag-and-drop-Builder), da sie ebenfalls dazugehören.
Ein wenig Historie hilft beim Verständnis: LangChain ist zum Standard für agentische KI geworden. Zu wissen, wie es dazu kam, zeigt, warum LangGraph, LangSmith und LangFlow wichtig sind.
2022 — Geburt von LangChain: LangChain startete im Oktober 2022 als Open-Source-Projekt von Harrison Chase und Team. Es wurde schnell das Framework für LLM-Apps und zog eine wachsende Community samt Integrationen an.
2023 — Von Popularität zur Plattform: LangChain formalisierte Kernabstraktionen und führte die LCEL (LangChain Expression Language) für Pipe-Komposition ein. Zudem kam mit LangServe eine Möglichkeit, Chains per API in Produktion zu bringen. Das Unternehmen hinter LangChain sammelte Kapital für das Ökosystem.
2023–2024 — Beobachtbarkeit mit LangSmith: Mitte 2023 eingeführt und Anfang 2024 breit verfügbar, bot LangSmith einheitliches Tracing, Evaluation und Monitoring, damit Teams Chains/Agenten debuggen, testen und Qualität tracken können.
2024 — Orchestrierung mit LangGraph: Für lang laufende, mehrstufige/Multi-Agent-Apps brachte LangGraph eine Graph-Laufzeit mit explizitem State, Routern/Verzweigungen, Schleifen, Retries und Checkpointern für Persistenz. Damit entstand die Grundlage für langlebige, produktionsreife Agenten. Updates erweiterten die Anpassung und Integrationen mit LLM-Providern, inkl. Ollama (Open-Source-Modelle).
2024–2025 — Visuelles Bauen mit LangFlow. Der LangFlow-Editor entwickelte sich rasant (große Releases bis Ende 2024, Launch Week 2025): Teams können LLM-Komponenten per Drag-and-drop verbinden, schnell iterieren und Flows in Code exportieren — auch für Nicht-Coder ein wichtiger Schritt.
2025 — Auf dem Weg zu Managed-Agent-Plattformen. LangChain kündigte große Meilensteine an: eine Functional API für LangGraph, vorgefertigte Agent-Templates und eine LangGraph Platform für Bereitstellung und Management zustandsbehafteter Agenten in der Breite. Das ermöglicht es Developer:innen, zuverlässige Agenten in Produktion zu betreiben.
Kurzvorstellung von LangChain und LangGraph
Tauchen wir ins Kernökosystem ein und starten mit LangChain und LangGraph.
LangChain ist ein modulares Framework für LLM-Apps. Es liefert Bausteine – Prompts, Modelle, Memory, Tools, Retriever – und eine einfache Möglichkeit, sie via Runnable/LCEL-APIs zu einer Pipeline zu verbinden (gleich mehr dazu). Ich sehe es als Lego-Baukasten für gängige LLM-Muster wie RAG, Q&A, Chatbots und Tool-using-Agenten.
LangGraph ist eine neuere graphbasierte Orchestrierungsschicht auf Basis von LangChain-Komponenten. Anstelle einer geraden Schrittfolge wird die App als Knoten (Aktionen) und Kanten (Übergänge) modelliert, mit einem expliziten State-Objekt, das durch den Graph fließt. Das erleichtert Verzweigungen (verschiedene Pfade), Schleifen (Rückfragen bis zur Sicherheit), Retries (bei Tool/Modell-Fehlern) und Pausen für menschliche Prüfung — genau das, was langlebige, produktionsreife Agenten brauchen.
Vielleicht fragst du dich jetzt:
„Warum überhaupt vergleichen?“
Obwohl sie Komponenten teilen, zielen sie auf unterschiedliche Komplexitätsstufen ab:
LangChain ist stark bei schnellen, linearen Workflows. Beispiel: PDF laden → chunken → einbetten → abrufen → antworten. In Minuten prototypisierbar.
LangGraph punktet, wenn sich Logik anpassen muss. Beispiel: Wenn Confidence < 0,7 → Rückfrage stellen (Schleife); wenn Zahlung fehlschlägt → Retry mit Backoff; wenn Anfrage riskant wirkt → Pause für Mensch. Solche Verhaltensweisen sind im Graphen erstklassig abbildbar.
In der Praxis starten viele mit LangChain zur Ideennvalidierung und steigen auf LangGraph um, sobald Verzweigungen, Fehlertoleranz, Multi-Agent-Koordination oder Haltbarkeit gefragt sind.
Was ist LangChain?
Jetzt gehen wir tiefer in LangChain, verstehen die Nutzung und schreiben Code damit. Merke: LangChain ist eine Bibliothek, mit der wir eine Basis für sequentielle LLM-Workflows schaffen.
LCEL
Zuerst möchte ich erklären, was LCEL ist. LCEL (LangChain Expression Language) ist eine Möglichkeit, Blöcke per Pipe (|) zu verbinden. Jeder Block kann ein Prompt, ein Modell, ein Retriever oder ein Parser sein. Verbinden wir sie, entsteht eine Chain, die wir immer wieder ausführen können — das macht das Coden deutlich effizienter.
Schauen wir uns Beispiele an.
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
llm = ChatOpenAI(model="gpt-4o-mini")
prompt = ChatPromptTemplate.from_messages([("system","You are concise."),("human","{question}")])
chain = prompt | llm | StrOutputParser()# This is our chainprint(chain.invoke({"question":"Give me 3 focus tips."}))# making a single call
qs =[{"question": q}for q in["One tactic for RAG?","Explain LCEL in 1 line."]]print(chain.batch(qs))# many calls at onceBereitgestellt von
Meiner Meinung nach zeigt der obige Code die einfachste Nutzung von LCEL: Wir definieren eine Prompt-Vorlage mit Systemnachricht („you are concise“) und Platz für die Nutzerfrage, verbinden sie mit einem OpenAI-Modell (GPT-4o-mini) und fügen einen Output-Parser hinzu, der die Antwort als Klartext ausgibt.
Der wichtigste Teil: Der Operator | klebt diese Blöcke zu einer Pipeline zusammen.
Außerdem sind invoke() und batch() relevant: chain.invoke(...) führt die Pipeline einmal aus. chain.batch(...) verarbeitet viele Eingaben auf einmal — schneller als eine Schleife über einzelne Elemente. So skalierst du mit minimalem Zusatzcode von einer Einzelanfrage zu ganzen Datensätzen.
Noch ein Beispiel:
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import StrOutputParser
stream_chain =(ChatPromptTemplate.from_template("{topic}")| ChatOpenAI(model="gpt-4o-mini")| StrOutputParser())# Simple streamfor chunk in stream_chain.stream({"topic":"Explain PID in 2 lines"}):print(chunk, end="")Bereitgestellt von
Das ist ähnlich, aber statt eines einzelnen Calls nutzen wir Streaming. Mit .stream(...) wartet das Modell nicht auf die volle Antwort, sondern liefert Text stückweise, den wir in Echtzeit ausgeben.
Merke dir: LCEL ist das einfache „Pipes-und-Blöcke“-System, mit dem wir Prompts, Modelle, Tools und Parser zusammenstecken und sofort eine Chain erhalten, die wir ohne Zusatzcode ausführen, stapeln oder streamen können.
Strukturierte Outputs mit Pydantic
Strukturierte Ausgaben sind für KI-Agenten essenziell: Statt langem Freitext liefert der Agent klare Formate wie JSON, Tabellen oder Listen. Das erleichtert Lesen, Weiterverarbeitung und Tool-Integration.
In der Industrie wird dafür häufig Pydantic genutzt.
from pydantic import BaseModel, Field
from typing import List
from langchain_openai import ChatOpenAI
classTaskPlan(BaseModel):
title:str
steps: List[str]= Field(..., min_items=3, description="actionable steps")
structured = ChatOpenAI(model="gpt-4o-mini").with_structured_output(TaskPlan)
plan = structured.invoke("Plan a 20-minute deep-work session for AI Agent notes.")print(plan.model_dump())Bereitgestellt von
Wichtig ist hier .with_structured_output(): Es weist das LLM an, die Ausgabe im Pydantic-Modell zu liefern. LangChain stellt sicher, dass die Antwort echtes, zum Schema passendes JSON ist und konvertiert sie in ein direkt nutzbares Python-Objekt.
Statt unstrukturiertem Text erhalten wir z. B. TaskPlan(title="...", steps=["...", "...", "..."]). Das ist besonders nützlich beim Einsatz von Tools.
Tool-Aufrufe in LangChain
Tools sind wichtig, weil sie die Fähigkeiten eines LLM erweitern — etwa für Websuche.
Das Schöne: LangChain (und ähnliche Frameworks) liefert vorgefertigte Tools, die sich leicht nutzen lassen, siehe Built-In Tools. Eigene Tools erstellen wir z. B. mit dem Decorator @tool.
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
@tooldefmultiply(a:int, b:int)->int:"""This tool multiplies two numbers."""return a * b
llm = ChatOpenAI(model="gpt-4o-mini")
llm_tools = llm.bind_tools([multiply])# exposing the tools to the model
resp = llm_tools.invoke("What is 9*5? If needed, use a tool.")print(resp.tool_calls or resp.content)# model may emit a tool call with argumentsBereitgestellt von
Hier definieren wir ein einfaches Tool, das zwei Zahlen multipliziert. Mit llm.bind_tools() geben wir dem Modell (hier GPT-4o-mini) Zugriff darauf — wir exponieren also die Tools für das Modell.
Konversationsgedächtnis
Memory ist für KI-Agenten entscheidend. Agenten mit Gedächtnis können sich Dinge merken: frühere Fragen, Vorlieben oder was funktioniert hat. Ohne Memory wirkt jede Interaktion wie ein Neustart — wir müssten Kontext ständig wiederholen.
In LangChain bedeutet Memory, vergangene Nachrichten/Fakten in einem Store (RAM, Datenbank, Vector Store) zu sichern. Beim nächsten Lauf zieht der Agent diese Infos wieder heran — Antworten werden konsistenter und smarter.
Es gibt vor allem: Kurzzeitgedächtnis (jüngste Nachrichten derselben Unterhaltung) und Langzeitgedächtnis (Fakten/Präferenzen über viele Sessions hinweg). Eine Session ist eine einzelne Unterhaltung, in der der Agent den Verlauf bis zum Ende der Session nachhält.
Kurzzeit liefert Kontext innerhalb einer Unterhaltung, Langzeit macht den Agenten über die Zeit persönlicher und hilfreicher.
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_core.chat_history import InMemoryChatMessageHistory
prompt = ChatPromptTemplate.from_messages([("system","Be brief"),
MessagesPlaceholder(variable_name="history"),("human","{input}")])
chain = prompt | ChatOpenAI(model="gpt-4o")
store ={}# session_id -> historydefget_history(session_id:str):if session_id notin store:
store[session_id]= InMemoryChatMessageHistory()return store[session_id]
with_history = RunnableWithMessageHistory(
chain,lambda cfg: get_history(cfg["configurable"]["session_id"]),
input_messages_key="input",
history_messages_key="history",)
cfg ={"configurable":{"session_id":"u1"}}print(with_history.invoke({"input":"My name is Vaibhav."}, config=cfg))print(with_history.invoke({"input":"What is my name?"}, config=cfg))Bereitgestellt von
Hier bauen wir eine Chat-Chain, die sich Verläufe je Session merkt. Der Prompt enthält einen History-Platzhalter, und RunnableWithMessageHistory füllt automatisch die passende Unterhaltung ein. Der Store hält die Verläufe pro Session.
Nutze Memory mit Bedacht: Entscheide, was du speicherst, wann und wie viel davon in den Prompt zurückfließt. Zu viel Memory kann verlangsamen oder Limits sprengen, die richtige Dosis macht Agenten hingegen deutlich nützlicher.
Was ist LangGraph?
Kommen wir zum zweiten agentischen Framework: LangGraph.
Zur einfachen Erklärung nutze ich die Rucksack-Flowchart-Analogie.
Du kannst dir LangGraph als kleines Ablaufdiagramm für deine KI-App vorstellen. Jede Box (Knoten) ist eine kleine Python-Funktion für genau eine Aufgabe. Die Pfeile (Kanten) bestimmen, was als Nächstes läuft. Ein kleiner Rucksack mit Daten (der „State“) wandert durch das Diagramm; jeder Knoten kann daraus lesen und etwas hinzufügen. In einer Chat-App ist das meist die Nachrichtenliste.
from typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage
# This is the backpack that moves through the graph.classState(TypedDict):# To add messages to the state
messages: Annotated[List, add_messages]
llm = ChatOpenAI(model="gpt-4o")# This is a node that asks the model and adds the reply to the backpack.defmodel_node(state: State):
reply = llm.invoke(state["messages"])return{"messages":[reply]}# Building the graph
graph = StateGraph(State)
graph.add_node("model", model_node)
graph.add_edge(START,"model")
graph.add_edge("model", END)# Building and running once
app = graph.compile()
result = app.invoke({"messages":[HumanMessage(content="Explain LangGraph in one sentence.")]})print(result["messages"][-1].content)Bereitgestellt von
Hier bauen wir die einfachste LangGraph-App. Der State ist der Rucksack, der Nachrichten durch den Graph trägt. State teilt LangGraph mit, dass eine fortlaufende Chatliste gepflegt wird.
Der Knoten ist hier die Funktion model_node: Sie liest aus dem Rucksack, schickt die Nachrichten ans LLM und gibt die Antwort zurück. LangGraph fügt sie automatisch wieder in den Rucksack ein.
Der Graph selbst ist ein kleines Flowchart: START → model → END. Beim Kompilieren macht LangGraph daraus eine lauffähige App.
Anschließend starten wir die App mit einem Rucksack, der bereits eine Human-Nachricht enthält.
Zur Visualisierung kannst du Folgendes ausführen:
from IPython.display import Image, display
display(Image(app.get_graph().draw_mermaid_png()))Bereitgestellt von
Wichtig: Nur weil eine Visualisierung erzeugt wird, heißt das nicht, dass der Graph läuft! Logische Fehler können die Ausführung verhindern.
Verzweigender Graph
Weiter geht’s mit Verzweigungen — ein wichtiges (und einfaches) Element robuster agentischer Systeme. Dadurch treffen Agenten Entscheidungen, aus einem Workflow wird ein agentisches System.
Der Code dazu:
from typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, AIMessage
# Defining the stateclassState(TypedDict):
messages: Annotated[List, add_messages]
llm = ChatOpenAI(model="gpt-4o-mini")defanswer_node(state: State):# Normal answer using the whole chat history.return{"messages":[llm.invoke(state["messages"])]}defclarify_node(state: State):# LLm asking for a short follow-up to get enough detail (clarifying)return{"messages":[AIMessage(content="Could you share a bit more so I can be precise?")]}# Router functiondefroute(state: State):# Look for the latest human message and count words.
last_human =next((m for m inreversed(state["messages"])if m.type=="human"),None)ifnot last_human:return"clarify"
words =len(str(last_human.content).split())return"answer"if words >=3else"clarify"
graph = StateGraph(State)
graph.add_node("answer", answer_node)
graph.add_node("clarify", clarify_node)# Adding a conditional edge to connect the router function
graph.add_conditional_edges(START, route,{"answer":"answer","clarify":"clarify"})
graph.add_edge("answer", END)
graph.add_edge("clarify", END)
app = graph.compile()# Compiling the graphBereitgestellt von
Fast alles entspricht dem ersten Agenten, neu ist die konditionale Kante. Damit geben wir unterschiedliche Routen vor, je nach Einschätzung des LLM. So sieht das visuell aus:
Mit konditionalen Kanten kannst du bereits sehr robuste agentische Systeme bauen. Eine umfassendere Anleitung findest du in meinem LangGraph-Video-Tutorial.
Neu hinzugekommen ist außerdem LangGraph Studio — sehr empfehlenswert ist diese LangGraph-Studio-Anleitung.
Was ist LangFlow?
Auch wenn die meisten Developer zu LangChain und LangGraph greifen, lohnt ein Blick auf LangFlow.
Denk an LangFlow als Drag-and-drop-Leinwand für LLM-Apps. Jeder Knoten = ein Schritt (Prompt, Modell, Tool, Retriever, Vektor-DB, Datei-Op usw.). Wir verbinden Knoten zu einem Flow, führen ihn aus, exportieren oder deployen. Perfekt für schnelle Iterationen, Zusammenarbeit mit Nicht-Codern und für die schnelle Umsetzung von Ideen in funktionierende Agenten.
Es ist nicht so mächtig wie LangGraph/LangChain beim Agentenbau, hat aber klare Einsatzgründe:
Visueller Builder für schnelle Skizzen von Flows
Ermöglicht Nicht-Codern den Aufbau agentischer Systeme
Läuft überall: Web und als LangFlow Desktop für lokale Entwicklung
Export/Import von Flows als JSON und Bereitstellung als APIs
Ideal für Lehre, Workshops und schnelle Prototypen ohne viel Code
Export in Code: Übergabe an Engineers, sobald stabil.
Bist du (noch) Nicht-Coder, nutze LangFlow für Architektur-Exploration (RAG-Varianten, Tooling etc.), für schnellen Vergleich von Optionen oder für die visuelle Abstimmung mit Stakeholdern.
Zum Schluss LangSmith. LangSmith ist die Beobachtbarkeits- und Evals-Schicht für LLM-Apps. Es bietet Tracing (alle Schritte, Tool-Calls, Tokens, Fehler sichtbar), Evaluation (Datensätze, automatisierte und Human-in-the-loop-Bewertung) sowie Monitoring/Alerts (Drift/Regressionen tracken). Ein Beispiel-Trace in LangSmith siehst du unten:
What’s the main difference between LangChain and LangGraph?⌄
LangChain eignet sich für einfache, lineare Workflows, während LangGraph als graphbasierte Schicht komplexe, zustandsbehaftete Flüsse mit Verzweigungen/Schleifen und robuster Steuerung abbildet.
Do I need LangChain to use LangGraph?⌄
LangGraph baut auf dem LangChain-Ökosystem auf (Modelle, Tools, Speicher). In der Praxis nutzen wir beides zusammen, wobei LangGraph die Orchestrierung übernimmt.
When should I add LangSmith?⌄
Sobald es über schnelle Experimente hinausgeht. LangSmith bietet Tracing, Debugging, Evaluation und Analytics für Chains und Graphen.
Is LangFlow required?⌄
Nein, es ist optional, aber hilfreich fürs visuelle Prototyping, für Schulungen oder für Nicht-Coder.
Which is better for multi‑agent systems?⌄
LangGraph. Dank State- und Control-Flow-Fähigkeiten wird die Koordination mehrerer Agenten und das Wiederherstellen nach Fehlern deutlich einfacher, auch wenn die Lernkurve steiler ist.
Lerne die wichtigsten Arten von KI-Agenten kennen, wie sie mit ihrer Umgebung interagieren und wie sie in verschiedenen Branchen eingesetzt werden. Verstehe einfache reflexive, modellbasierte, zielbasierte, nutzenbasierte, lernende Agenten und mehr.
Bist du gerade auf der Suche nach einem Job, der Snowflake nutzt? Bereite dich mit diesen 20 besten Snowflake-Interview-Fragen vor, damit du den Job bekommst!
Gewinne Vertrauen in die OLS-Regression, indem du ihre theoretischen Grundlagen beherrschst. Erforsche, wie du einfache Implementierungen in Excel, R und Python durchführst.
Erforsche Pythons match-case: eine Anleitung zu seiner Syntax, Anwendungen in Data Science und ML sowie eine vergleichende Analyse mit dem traditionellen switch-case.







Dieser Artikel liefert einen formalen Direktvergleich von LangChain vs. LangGraph sowie die Einordnung von LangSmith und LangFlow. Wir knüpfen an Konzepte aus anderen DataCamp-Artikeln an und besprechen, wann du welches Framework wählst, um produktionsreife, agentische KI-Systeme auszuliefern. Wenn du einen praxisnahen Einstieg in LangChain suchst, empfehle ich den Kurs Developing LLM Applications with LangChain.
TL;DR
Vorab eine kurze Übersicht, wie LangChain, LangGraph, LangSmith und LangFlow zusammenspielen und wann du welches Tool einsetzt.
Schnelle Heuristik: Starte mit LangChain, wechsle zu LangGraph, wenn Workflows wachsen, füge LangSmith für Beobachtbarkeit hinzu, nutze LangFlow für schnelle Iteration oder Kollaboration.
Einführung in LangChain und LangGraph
Große Sprachmodelle (LLMs) sind stark bei einzelnen Prompts. Das ist inzwischen Allgemeinwissen, weil wir sie heute so oft einsetzen.
Echte Anwendungen brauchen jedoch Workflows: Daten holen, schlussfolgern, Tools aufrufen, Rückfragen stellen, bei Fehlern erneut versuchen und manchmal für menschliches Feedback pausieren. Deshalb hörst du immer wieder von zwei Frameworks: LangChain und LangGraph. Beide leben im selben Ökosystem und arbeiten oft zusammen, lösen aber unterschiedliche Teile des Problems:
Apropos Ökosystem: Wir sprechen auch über LangSmith (Beobachtbarkeit/Evaluation) und LangFlow (visueller Drag-and-drop-Builder), da sie ebenfalls dazugehören.
Kurzer Rückblick aufs LangChain-Ökosystem (2022–2025)
Ein wenig Historie hilft beim Verständnis: LangChain ist zum Standard für agentische KI geworden. Zu wissen, wie es dazu kam, zeigt, warum LangGraph, LangSmith und LangFlow wichtig sind.
Kurzvorstellung von LangChain und LangGraph
Tauchen wir ins Kernökosystem ein und starten mit LangChain und LangGraph.
LangChain ist ein modulares Framework für LLM-Apps. Es liefert Bausteine – Prompts, Modelle, Memory, Tools, Retriever – und eine einfache Möglichkeit, sie via Runnable/LCEL-APIs zu einer Pipeline zu verbinden (gleich mehr dazu). Ich sehe es als Lego-Baukasten für gängige LLM-Muster wie RAG, Q&A, Chatbots und Tool-using-Agenten.
LangGraph ist eine neuere graphbasierte Orchestrierungsschicht auf Basis von LangChain-Komponenten. Anstelle einer geraden Schrittfolge wird die App als Knoten (Aktionen) und Kanten (Übergänge) modelliert, mit einem expliziten State-Objekt, das durch den Graph fließt. Das erleichtert Verzweigungen (verschiedene Pfade), Schleifen (Rückfragen bis zur Sicherheit), Retries (bei Tool/Modell-Fehlern) und Pausen für menschliche Prüfung — genau das, was langlebige, produktionsreife Agenten brauchen.
Vielleicht fragst du dich jetzt:
„Warum überhaupt vergleichen?“
Obwohl sie Komponenten teilen, zielen sie auf unterschiedliche Komplexitätsstufen ab:
In der Praxis starten viele mit LangChain zur Ideennvalidierung und steigen auf LangGraph um, sobald Verzweigungen, Fehlertoleranz, Multi-Agent-Koordination oder Haltbarkeit gefragt sind.
Was ist LangChain?
Jetzt gehen wir tiefer in LangChain, verstehen die Nutzung und schreiben Code damit. Merke: LangChain ist eine Bibliothek, mit der wir eine Basis für sequentielle LLM-Workflows schaffen.
LCEL
Zuerst möchte ich erklären, was LCEL ist. LCEL (LangChain Expression Language) ist eine Möglichkeit, Blöcke per Pipe (|) zu verbinden. Jeder Block kann ein Prompt, ein Modell, ein Retriever oder ein Parser sein. Verbinden wir sie, entsteht eine Chain, die wir immer wieder ausführen können — das macht das Coden deutlich effizienter.
Schauen wir uns Beispiele an.
Meiner Meinung nach zeigt der obige Code die einfachste Nutzung von LCEL: Wir definieren eine Prompt-Vorlage mit Systemnachricht („you are concise“) und Platz für die Nutzerfrage, verbinden sie mit einem OpenAI-Modell (GPT-4o-mini) und fügen einen Output-Parser hinzu, der die Antwort als Klartext ausgibt.
Der wichtigste Teil: Der Operator | klebt diese Blöcke zu einer Pipeline zusammen.
Außerdem sind
invoke()undbatch()relevant:chain.invoke(...)führt die Pipeline einmal aus.chain.batch(...)verarbeitet viele Eingaben auf einmal — schneller als eine Schleife über einzelne Elemente. So skalierst du mit minimalem Zusatzcode von einer Einzelanfrage zu ganzen Datensätzen.Noch ein Beispiel:
Das ist ähnlich, aber statt eines einzelnen Calls nutzen wir Streaming. Mit
.stream(...)wartet das Modell nicht auf die volle Antwort, sondern liefert Text stückweise, den wir in Echtzeit ausgeben.Merke dir: LCEL ist das einfache „Pipes-und-Blöcke“-System, mit dem wir Prompts, Modelle, Tools und Parser zusammenstecken und sofort eine Chain erhalten, die wir ohne Zusatzcode ausführen, stapeln oder streamen können.
Strukturierte Outputs mit Pydantic
Strukturierte Ausgaben sind für KI-Agenten essenziell: Statt langem Freitext liefert der Agent klare Formate wie JSON, Tabellen oder Listen. Das erleichtert Lesen, Weiterverarbeitung und Tool-Integration.
In der Industrie wird dafür häufig Pydantic genutzt.
Wichtig ist hier
.with_structured_output(): Es weist das LLM an, die Ausgabe im Pydantic-Modell zu liefern. LangChain stellt sicher, dass die Antwort echtes, zum Schema passendes JSON ist und konvertiert sie in ein direkt nutzbares Python-Objekt.Statt unstrukturiertem Text erhalten wir z. B.
TaskPlan(title="...", steps=["...", "...", "..."]). Das ist besonders nützlich beim Einsatz von Tools.Tool-Aufrufe in LangChain
Tools sind wichtig, weil sie die Fähigkeiten eines LLM erweitern — etwa für Websuche.
Das Schöne: LangChain (und ähnliche Frameworks) liefert vorgefertigte Tools, die sich leicht nutzen lassen, siehe Built-In Tools. Eigene Tools erstellen wir z. B. mit dem Decorator
@tool.Hier definieren wir ein einfaches Tool, das zwei Zahlen multipliziert. Mit
llm.bind_tools()geben wir dem Modell (hier GPT-4o-mini) Zugriff darauf — wir exponieren also die Tools für das Modell.Konversationsgedächtnis
Memory ist für KI-Agenten entscheidend. Agenten mit Gedächtnis können sich Dinge merken: frühere Fragen, Vorlieben oder was funktioniert hat. Ohne Memory wirkt jede Interaktion wie ein Neustart — wir müssten Kontext ständig wiederholen.
In LangChain bedeutet Memory, vergangene Nachrichten/Fakten in einem Store (RAM, Datenbank, Vector Store) zu sichern. Beim nächsten Lauf zieht der Agent diese Infos wieder heran — Antworten werden konsistenter und smarter.
Es gibt vor allem: Kurzzeitgedächtnis (jüngste Nachrichten derselben Unterhaltung) und Langzeitgedächtnis (Fakten/Präferenzen über viele Sessions hinweg). Eine Session ist eine einzelne Unterhaltung, in der der Agent den Verlauf bis zum Ende der Session nachhält.
Kurzzeit liefert Kontext innerhalb einer Unterhaltung, Langzeit macht den Agenten über die Zeit persönlicher und hilfreicher.
Hier bauen wir eine Chat-Chain, die sich Verläufe je Session merkt. Der Prompt enthält einen History-Platzhalter, und
RunnableWithMessageHistoryfüllt automatisch die passende Unterhaltung ein. Der Store hält die Verläufe pro Session.Nutze Memory mit Bedacht: Entscheide, was du speicherst, wann und wie viel davon in den Prompt zurückfließt. Zu viel Memory kann verlangsamen oder Limits sprengen, die richtige Dosis macht Agenten hingegen deutlich nützlicher.
Was ist LangGraph?
Kommen wir zum zweiten agentischen Framework: LangGraph.
Zur einfachen Erklärung nutze ich die Rucksack-Flowchart-Analogie.
Du kannst dir LangGraph als kleines Ablaufdiagramm für deine KI-App vorstellen. Jede Box (Knoten) ist eine kleine Python-Funktion für genau eine Aufgabe. Die Pfeile (Kanten) bestimmen, was als Nächstes läuft. Ein kleiner Rucksack mit Daten (der „State“) wandert durch das Diagramm; jeder Knoten kann daraus lesen und etwas hinzufügen. In einer Chat-App ist das meist die Nachrichtenliste.
Ein einfacher Graph
Das wird mit einem Beispiel am besten greifbar:
Hier bauen wir die einfachste LangGraph-App. Der State ist der Rucksack, der Nachrichten durch den Graph trägt.
Stateteilt LangGraph mit, dass eine fortlaufende Chatliste gepflegt wird.Der Knoten ist hier die Funktion
model_node: Sie liest aus dem Rucksack, schickt die Nachrichten ans LLM und gibt die Antwort zurück. LangGraph fügt sie automatisch wieder in den Rucksack ein.Der Graph selbst ist ein kleines Flowchart:
START → model → END. Beim Kompilieren macht LangGraph daraus eine lauffähige App.Anschließend starten wir die App mit einem Rucksack, der bereits eine Human-Nachricht enthält.
Zur Visualisierung kannst du Folgendes ausführen:
Wichtig: Nur weil eine Visualisierung erzeugt wird, heißt das nicht, dass der Graph läuft! Logische Fehler können die Ausführung verhindern.
Verzweigender Graph
Weiter geht’s mit Verzweigungen — ein wichtiges (und einfaches) Element robuster agentischer Systeme. Dadurch treffen Agenten Entscheidungen, aus einem Workflow wird ein agentisches System.
Der Code dazu:
Fast alles entspricht dem ersten Agenten, neu ist die konditionale Kante. Damit geben wir unterschiedliche Routen vor, je nach Einschätzung des LLM. So sieht das visuell aus:
Mit konditionalen Kanten kannst du bereits sehr robuste agentische Systeme bauen. Eine umfassendere Anleitung findest du in meinem LangGraph-Video-Tutorial.
Neu hinzugekommen ist außerdem LangGraph Studio — sehr empfehlenswert ist diese LangGraph-Studio-Anleitung.
Was ist LangFlow?
Auch wenn die meisten Developer zu LangChain und LangGraph greifen, lohnt ein Blick auf LangFlow.
Denk an LangFlow als Drag-and-drop-Leinwand für LLM-Apps. Jeder Knoten = ein Schritt (Prompt, Modell, Tool, Retriever, Vektor-DB, Datei-Op usw.). Wir verbinden Knoten zu einem Flow, führen ihn aus, exportieren oder deployen. Perfekt für schnelle Iterationen, Zusammenarbeit mit Nicht-Codern und für die schnelle Umsetzung von Ideen in funktionierende Agenten.
Es ist nicht so mächtig wie LangGraph/LangChain beim Agentenbau, hat aber klare Einsatzgründe:
Bist du (noch) Nicht-Coder, nutze LangFlow für Architektur-Exploration (RAG-Varianten, Tooling etc.), für schnellen Vergleich von Optionen oder für die visuelle Abstimmung mit Stakeholdern.
Zum Einstieg in LangFlow und für ein Projekt wie einen Tutor empfehle ich dieses LangFlow-Tutorial mit Demoprojekt.
Was ist LangSmith?
Zum Schluss LangSmith. LangSmith ist die Beobachtbarkeits- und Evals-Schicht für LLM-Apps. Es bietet Tracing (alle Schritte, Tool-Calls, Tokens, Fehler sichtbar), Evaluation (Datensätze, automatisierte und Human-in-the-loop-Bewertung) sowie Monitoring/Alerts (Drift/Regressionen tracken). Ein Beispiel-Trace in LangSmith siehst du unten: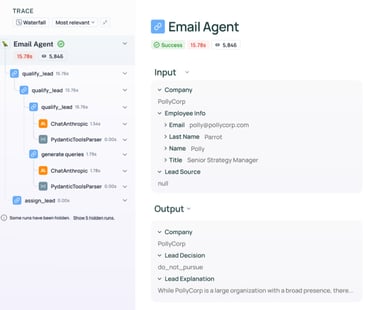
Gründe für LangSmith:
Mehr zu LangSmith findest du in dieser ausführlichen Einführung in LangSmith und im LangSmith Agent Builder Tutorial.
LangChain vs. LangGraph vs. LangSmith vs. LangFlow
Hier der direkte Vergleich aller vier Libraries, damit klar ist, was sie leisten und wann du sie nutzt.
Was sie sind
Zentrale Komponenten
Workflow-Struktur
State-Management
Control-Flow
Bedienbarkeit
Am besten geeignet für
Wann du was einsetzt
Vergleichstabelle
In der folgenden Tabelle findest du den Vergleich von LangChain vs. LangGraph vs. LangSmith vs. LangFlow:
Kategorie
LangChain
LangGraph
LangSmith
LangFlow
Was sie sind
Framework zum Bauen von LLM-Apps aus modularen Bausteinen (Prompts, Modelle, Tools, Memory).
Orchestrator für komplexe, zustandsbehaftete Workflows (Verzweigungen, Schleifen, Persistenz) auf Basis von LangChain.
Framework-agnostische Plattform für Beobachtbarkeit, Evaluation und Tests von LLM-Apps.
Visueller Drag-and-drop-Editor zum Entwerfen und Prototypen von Flows.
Zentrale Komponenten
Chains, Runnables, LCEL
Knoten, Kanten, State, Router, Checkpointer, Tools
Traces, Runs, Datasets, Evaluators, Projects
Canvas mit Komponenten (Loader, LLMs, Retriever, Tools) + Verbindungen
Workflow-Struktur
Linear oder DAG, meist vorwärtsgerichtet
Voller Graph mit Zyklen, Verzweigungen, Schleifen, Pausen
Kein Ausführungsframework; umhüllt Runs für Logging & Evaluation
Visueller Graph, exportierbar in LangChain-Code
State-Management
Implizit oder komponentenlokal
Zentraler, expliziter State durch alle Knoten; unterstützt Persistenz & Checkpointing (z. B. Chat-Memory).
Speichert Run-Metadaten, Inputs/Outputs, Metriken, Feedback
Komponentenkonfigurationen im JSON-Flow gespeichert
Control-Flow
Begrenzte Verzweigungs-/Retry-Primitiven
Erstklassige Unterstützung für Conditionals, Retries, Human-in-the-loop
Keine (Fokus auf Evaluation, nicht Ausführung)
Visuelle Verzweigung; Semantik hängt vom Export-Backend ab
Bedienbarkeit
Einfache APIs
Steilere Lernkurve
Sehr leicht aktivierbar (Env-Variablen)
Am einfachsten für den visuellen Start; teamfreundlich für Workshops & Nicht-Coder
Am besten geeignet für
Prototyping, lineare Logik, schnelle Apps
Robuste, komplexe, lang laufende oder Multi-Agent-Apps
Beobachtbarkeit, Debugging, Regressionstests, A/B-Evaluationen
Visuelles Prototyping, Stakeholder-Reviews und Export in LangChain-Code
Fazit
Wir haben die vier Libraries ausführlich behandelt und verglichen — dennoch gibt es viel mehr zu lernen, um als AI Engineer wirklich durchzustarten. Sehr empfehlen kann ich die Kurse RAG Systems with LangChain und building Agentic Systems with LangChain.