LangChain बनाम LangGraph बनाम LangSmith बनाम LangFlow: मुख्य अंतर समझाए गए
LangChain, LangGraph, LangSmith, और LangFlow की तुलना करें। उनकी भूमिकाएँ, खूबियाँ, और प्रोडक्शन-रेडी AI एप्लीकेशंस बनाने में किसे कब उपयोग करें, जानें।
यह लेख LangChain बनाम LangGraph की औपचारिक, साथ-साथ तुलना देता है, और साथ ही बताता है कि LangSmith और LangFlow इसमें कहाँ फिट होते हैं। हम अन्य DataCamp लेखों में कवर की गई अवधारणाओं पर आगे निर्माण करेंगे और चर्चा करेंगे कि प्रोडक्शन-रेडी, एजेंटिक AI सिस्टम्स शिप करने के लिए किस फ्रेमवर्क को कब चुनना चाहिए। यदि आप LangChain की व्यावहारिक शुरुआत खोज रहे हैं, तो मैं यह Developing LLM Applications with LangChain कोर्स सुझाता हूँ।
संक्षेप में (TL;DR)
विवरण में जाने से पहले, यहाँ एक त्वरित ओवरव्यू है कि LangChain, LangGraph, LangSmith, और LangFlow एक-दूसरे के साथ कैसे फिट होते हैं और आप किसे कब चुन सकते हैं।
LangChain: नींव, सरल APIs जैसे LCEL के साथ मॉड्यूलर LLM वर्कफ़्लोज़ (प्रॉम्प्ट्स, टूल्स, मेमोरी, रिट्रीवर्स) बनाएं। प्रोटोटाइपिंग और रैखिक ऐप्स के लिए सर्वोत्तम।
LangGraph: ऑर्केस्ट्रेटर, रिट्राइज़, लूप्स और परसिस्टेंस के साथ जटिल, स्टेटफुल, ब्रांचिंग वर्कफ़्लोज़ मैनेज करें। मज़बूत, प्रोडक्शन-रेडी, मल्टी-एजेंट सिस्टम्स के लिए सर्वोत्तम।
LangSmith: ऑब्ज़र्वर, LLM ऐप्स की फ्रेमवर्क-अज्ञेय ट्रेसिंग, मूल्यांकन, और मॉनिटरिंग। डिबगिंग, रिग्रेशन टेस्टिंग और क्वॉलिटी ट्रैकिंग के लिए सर्वोत्तम।
LangFlow: विज़ुअल बिल्डर, फ़्लोज़ को जल्दी प्रोटोटाइप करने और उन्हें कोड में एक्सपोर्ट करने के लिए ड्रैग-एंड-ड्रॉप इंटरफ़ेस। टीमों, वर्कशॉप्स और गैर-कोडर्स के लिए सर्वोत्तम।
त्वरित हीयूरिस्टिक: LangChain से शुरू करें, वर्कफ़्लो बढ़ने पर LangGraph पर जाएँ, ऑब्ज़र्वेबिलिटी के लिए LangSmith जोड़ें, तेज़ इटरेशन या सहयोग की ज़रूरत हो तो LangFlow का उपयोग करें।
LangChain और LangGraph का परिचय
लार्ज लैंग्वेज मॉडल्स (LLMs) एकल प्रॉम्प्ट्स पर बेहतरीन हैं। आजकल हम इन मॉडलों का इतना उपयोग करते हैं कि यह बात अब लगभग सर्वमान्य है।
हालाँकि, वास्तविक एप्लीकेशंस को वर्कफ़्लोज़ चाहिए: डेटा लाना, तर्क करना, टूल्स कॉल करना, फ़ॉलो‑अप पूछना, विफलता पर फिर से कोशिश करना, और कभी‑कभी इंसान के लिए रुकना। इसलिए, आप बार‑बार दो फ्रेमवर्क्स के बारे में सुनेंगे: LangChain और LangGraph। वे एक ही इकोसिस्टम में रहते हैं और अक्सर साथ काम करते हैं, लेकिन वे समस्या के अलग-अलग हिस्से हल करते हैं:
LangChain हमें कदमों को बनाने में मदद करता है
LangGraph चीज़ें जटिल होने पर इन कदमों को ऑर्केस्ट्रेट करने में मदद करता है।
इकोसिस्टम की बात करें, तो हम LangSmith (जो ऑब्ज़र्वेबिलिटी/इवैलुएशन कार्यों के लिए है) और LangFlow (जो एक ड्रैग‑एंड‑ड्रॉप विज़ुअल बिल्डर है) पर भी चर्चा करेंगे, क्योंकि ये भी इसी इकोसिस्टम का हिस्सा हैं।
LangChain इकोसिस्टम का संक्षिप्त इतिहास (2022–2025)
मेरा मानना है कि LangChain इकोसिस्टम का थोड़ा इतिहास बताना उचित है; यह एजेंटिक AI के लिए पसंदीदा फ्रेमवर्क बन चुका है, और यह जानना कि यह यहाँ तक कैसे पहुँचा, आपको समझने में मदद करेगा कि LangGraph, LangSmith, और LangFlow क्यों मायने रखते हैं।
2022 — LangChain का जन्म: LangChain अक्टूबर 2022 में Harrison Chase और टीम द्वारा एक ओपन‑सोर्स प्रोजेक्ट के रूप में लॉन्च हुआ। यह LLM ऐप्स की रचना के लिए तेज़ी से पसंदीदा फ्रेमवर्क बना और इस तरह तेज़ी से बढ़ते समुदाय और इंटीग्रेशंस को आकर्षित किया।
2023 — लोकप्रियता से प्लेटफ़ॉर्म तक: LangChain ने मूल अमूर्तताओं को औपचारिक किया और LCEL (LangChain Expression Language) जोड़ा, पाइप‑स्टाइल कम्पोज़िशन के लिए। API के ज़रिए चेन्स को प्रोडक्शन में डिप्लॉय करने का एक नया तरीका भी बनाया गया, जिसे LangServe कहा गया। LangChain के पीछे की कंपनी ने इकोसिस्टम कार्य को तेज़ करने के लिए फंडिंग जुटाई।
2023–2024 — LangSmith के साथ ऑब्ज़र्वेबिलिटी आई: 2023 के मध्य में, और 2024 की शुरुआत तक सामान्य रूप से उपलब्ध, LangSmith ने एकीकृत ट्रेसिंग, मूल्यांकन, और मॉनिटरिंग पेश किए ताकि टीमें चेन्स/एजेंट्स को डिबग और टेस्ट कर सकें और समय के साथ क्वॉलिटी ट्रैक कर सकें।
2024 — LangGraph के साथ ऑर्केस्ट्रेशन: लंबे समय तक चलने वाले, मल्टी‑स्टेप/एजेंट ऐप्स के समर्थन के लिए, LangGraph ने एक ग्राफ़ रनटाइम पेश किया जिसमें स्पष्ट स्टेट, राउटर्स/ब्रांचेज़, लूप्स, रिट्राइज़ और चेकपॉइंटर्स के साथ परसिस्टेंस जोड़ी गई। यह एक महत्वपूर्ण फ्रेमवर्क था क्योंकि इसने टिकाऊ, प्रोडक्शन‑रेडी एजेंट्स की नींव रखी। बाद के अपडेट्स ने कस्टमाइज़ेशन और विभिन्न LLM प्रदाताओं, जिनमें Ollama (ओपन-सोर्स मॉडल्स) शामिल हैं, के साथ इंटीग्रेशंस को बढ़ाया।
2024–2025 — LangFlow के साथ विज़ुअल बिल्डिंग।LangFlow विज़ुअल एडिटर ने तेज़ी से प्रगति की (2024 के अंत तक बड़े रिलीज़ और 2025 में एक Launch Week), जिससे टीमें ड्रैग‑एंड‑ड्रॉप के ज़रिए LLM कॉम्पोनेन्ट्स जोड़ सकें, जल्दी‑जल्दी इटरेट कर सकें, और फ़्लोज़ को कोड में एक्सपोर्ट कर सकें। यह एक महत्वपूर्ण कदम था क्योंकि इसने गैर‑कोडर्स को भी मज़बूत AI एजेंट्स बनाने की क्षमता देनी शुरू की।
2025 — मैनेज्ड एजेंट प्लेटफ़ॉर्म्स की ओर। LangChain ने बड़े माइलस्टोन्स की घोषणा की: LangGraph के लिए Functional API, प्रीबिल्ट एजेंट टेम्पलेट्स, और LangGraph Platform ताकि स्टेटफुल एजेंट्स को बड़े पैमाने पर डिप्लॉय और मैनेज किया जा सके। यह भी काफ़ी निर्णायक था, क्योंकि इसने हमें डेवलपर्स को प्रोडक्शन में भरोसेमंद एजेंट्स ऑपरेट करने की सुविधा दी।
LangChain और LangGraph का संक्षिप्त परिचय
अब हम कोर इकोसिस्टम में गहराई से जाएँगे, शुरुआत करते हैं LangChain और LangGraph से।
LangChain LLM‑संचालित एप्लीकेशंस बनाने का एक मॉड्यूलर फ्रेमवर्क है। यह हमें बिल्डिंग ब्लॉक्स देता है — प्रॉम्प्ट्स, मॉडल्स, मेमोरी, टूल्स, रिट्रीवर्स — और इन्हें अपनी Runnable/LCEL APIs से पाइपलाइन में जोड़ने का सरल तरीका देता है (इस पर थोड़ी देर में चर्चा करेंगे)। मैं इसे आम LLM पैटर्न्स — RAG, प्रश्न‑उत्तर, चैटबॉट्स, और टूल‑उपयोगी एजेंट्स — के लिए एक Lego ब्रिक्स किट की तरह मानता हूँ।
LangGraph एक नया, ग्राफ़‑आधारित ऑर्केस्ट्रेशन लेयर है जो LangChain कॉम्पोनेन्ट्स पर बना है। एक सीधी रेखा की बजाय, ऐप को नोड्स (यानी क्रियाएँ) और एजेज़ (यानी ट्राँज़िशन्स) के रूप में मॉडल किया जाता है, जिसमें एक स्पष्ट स्टेट ऑब्जेक्ट ग्राफ़ के माध्यम से बहता है। हम इसे विस्तार से चर्चा करेंगे, लेकिन फिलहाल याद रखें कि यह डिज़ाइन स्वाभाविक रूप से ब्रांच (विभिन्न पथ लेना), लूप (स्पष्टता के प्रश्न तब तक पूछना जब तक भरोसा न हो), रिट्राइ (टूल/मॉडल त्रुटियों पर), और रुकना (मानव समीक्षा के लिए) सहज बनाता है; ठीक वही जो लंबे समय तक चलने वाले, प्रोडक्शन‑ग्रेड एजेंट्स के लिए चाहिए।
अब आपके मन में एक प्रश्न हो सकता है:
“इनकी तुलना करनी ही क्यों?”
बात ये है: यद्यपि वे कॉम्पोनेन्ट्स साझा करते हैं, वे अलग‑अलग जटिलता स्तरों को लक्ष्य करते हैं:
LangChain त्वरित, रैखिक वर्कफ़्लोज़ में उत्कृष्ट है। उदाहरण: PDF लोड करें → चंक करें → एम्बेड करें → रिट्रीव करें → उत्तर दें। आप इसे मिनटों में प्रोटोटाइप कर सकते हैं।
LangGraph तब उत्कृष्ट है जब लॉजिक को अनुकूलित होना हो। उदाहरण: यदि confidence < 0.7 → स्पष्टता का प्रश्न पूछें (लूप); यदि भुगतान विफल → बैकऑफ के साथ फिर से प्रयास; यदि अनुरोध जोखिमपूर्ण लगे → इंसान के लिए पॉज़। ये व्यवहार ग्राफ़ में फ़र्स्ट‑क्लास हैं।
व्यवहार में, कई डेवलपर्स LangChain से शुरुआत करके आइडिया वैलिडेट करते हैं, फिर LangGraph पर अपग्रेड करते हैं जैसे‑जैसे वे ब्रांचिंग, एरर हैंडलिंग, मल्टी‑एजेंट समन्वयन या ड्यूरेबिलिटी जोड़ते हैं।
LangChain क्या है?
अब हम LangChain को विस्तार से समझेंगे, उसका उपयोग जानेंगे, और इसमें एप्लीकेशंस कोड करेंगे। फिर से ध्यान दें कि LangChain एक लाइब्रेरी है जो हमें सीक्वेंशियल LLM वर्कफ़्लोज़ की नींव बनाने देती है।
LCEL
शुरू करने के लिए, मैं बताना चाहता हूँ कि LCEL क्या है। LCEL यानी LangChain Expression Language, ब्लॉक्स को पाइप्स (|) से आपस में जोड़ने का तरीका है। हर ब्लॉक एक प्रॉम्प्ट, एक मॉडल, एक रिट्रीवर या एक पार्सर हो सकता है। जब हम इन्हें जोड़ते हैं, हमें एक चेन मिलती है जिसे बार‑बार चलाया जा सकता है, जिससे कोड लिखना काफ़ी कुशल हो जाता है।
कुछ उदाहरण देखते हैं।
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
llm = ChatOpenAI(model="gpt-4o-mini")
prompt = ChatPromptTemplate.from_messages([("system","You are concise."),("human","{question}")])
chain = prompt | llm | StrOutputParser()# This is our chainprint(chain.invoke({"question":"Give me 3 focus tips."}))# making a single call
qs =[{"question": q}for q in["One tactic for RAG?","Explain LCEL in 1 line."]]print(chain.batch(qs))# many calls at onceसंचालित द्वारा
मेरे विचार में, ऊपर का कोड सेल LCEL का सबसे सरल उपयोग दिखाता है। हमने पहले एक प्रॉम्प्ट टेम्पलेट बनाया जो हमेशा एक सिस्टम संदेश (“you are concise”) शामिल करता है और मानव प्रश्न के लिए जगह छोड़ता है। सिस्टम संदेश LLM के लिए एक निर्देश जैसा है जो बताता है कि उसे किसी विशिष्ट तरीके से जवाब/कार्य करना है। फिर हमने इस टेम्पलेट को एक OpenAI मॉडल — GPT-4o-mini — से जोड़ा।
अंत में, मैंने एक आउटपुट पार्सर जोड़ा, जो मूलतः प्रतिक्रिया को सादे टेक्स्ट में बदल देता है।
अब आती है सबसे महत्वपूर्ण बात: | ऑपरेटर ही इन ब्लॉक्स को एक पाइपलाइन में जोड़ता है।
मैं invoke() और batch() के बारे में भी बात करना चाहता हूँ। जब हम chain.invoke(...) कॉल करते हैं, तो पाइपलाइन एक बार चलती है, यानी टेम्पलेट में प्रश्न भरता है, मॉडल उत्तर जनरेट करता है, और पार्सर साफ़ टेक्स्ट लौटाता है।
लेकिन जब हम chain.batch(...) कॉल करते हैं, तो वही चेन एक साथ कई इनपुट्स पर चलती है, जो एक‑एक करके लूप करने से कहीं तेज़ है। व्यवहार में, इससे सरल, एकल कॉल से पूरे डेटासेट संभालने तक जाना लगभग बिना अतिरिक्त कोड के आसान हो जाता है।
मैं यहाँ एक और उदाहरण दिखाना चाहता हूँ:
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import StrOutputParser
stream_chain =(ChatPromptTemplate.from_template("{topic}")| ChatOpenAI(model="gpt-4o-mini")| StrOutputParser())# Simple streamfor chunk in stream_chain.stream({"topic":"Explain PID in 2 lines"}):print(chunk, end="")संचालित द्वारा
यह कोड पहले वाले जैसा ही है लेकिन इसे एक बार कॉल करने के बजाय हम स्ट्रीमिंग का उपयोग करते हैं। .stream(...) के साथ, मॉडल पूरे उत्तर के तैयार होने का इंतज़ार नहीं करता। इसके बजाय, यह टेक्स्ट के टुकड़े जैसे‑जैसे बनते हैं वैसे‑वैसे भेजता है, और हम उन्हें रीयल‑टाइम में प्रिंट करते हैं।
इस उपखंड से मुख्य सीख यह है कि LCEL एक सरल “पाइप्स और ब्लॉक्स” सिस्टम है जो हमें प्रॉम्प्ट्स, मॉडल्स, टूल्स और पार्सर्स को जोड़ने देता है और तुरंत एक चेन देता है जिसे हम रन, बैच, या स्ट्रीम कर सकते हैं—वो भी बिना अतिरिक्त कोड के।
Pydantic के साथ स्ट्रक्चर्ड आउटपुट्स
स्ट्रक्चर्ड आउटपुट्स AI एजेंट्स का एक महत्वपूर्ण घटक है। इसका अर्थ है कि हमारा एजेंट लंबा बिखरा हुआ टेक्स्ट देने की बजाय, स्पष्ट फ़ॉर्मैट—जैसे JSON, टेबल्स या लिस्ट्स—में उत्तर दे। इससे कंप्यूटर और लोग दोनों उसे पढ़, उपयोग, और अन्य टूल्स से जोड़ने में आसानी महसूस करते हैं।
उद्योग में इसके लिए उपयोग होने वाले प्रमुख फ्रेमवर्क्स में से एक है Pydantic।
from pydantic import BaseModel, Field
from typing import List
from langchain_openai import ChatOpenAI
classTaskPlan(BaseModel):
title:str
steps: List[str]= Field(..., min_items=3, description="actionable steps")
structured = ChatOpenAI(model="gpt-4o-mini").with_structured_output(TaskPlan)
plan = structured.invoke("Plan a 20-minute deep-work session for AI Agent notes.")print(plan.model_dump())संचालित द्वारा
इस उदाहरण में, .with_structured_output() मेथड महत्वपूर्ण है, क्योंकि यह LLM को बताता है कि आउटपुट हमारे बनाए Pydantic मॉडल के रूप में दे। परदे के पीछे, LangChain सुनिश्चित करता है कि हमारे एजेंट का जवाब वास्तविक JSON हो जो फ़ॉर्म से मेल खाता हो, और फिर उसे एक Python ऑब्जेक्ट में बदल देता है जिसे आप तुरंत उपयोग कर सकते हैं।
तो बिखरे हुए टेक्स्ट के बजाय, हमें कुछ ऐसा मिलता है: TaskPlan(title="...", steps=["...", "...", "..."])। यह विशेष रूप से तब उपयोगी है जब हम टूल्स उपयोग करते हैं।
LangChain में टूल कॉलिंग
टूल्स महत्वपूर्ण हैं क्योंकि वे हमारे LLM की क्षमता बढ़ाते हैं—ऐसे कार्य पूरे करके जो वह पहले करने में असमर्थ था, जैसे इंटरनेट सर्च करना।
मुझे टूल्स की सबसे अच्छी बात यह लगती है कि LangChain (और कई एजेंटिक फ्रेमवर्क) रेडी‑मेड टूल्स प्रदान करते हैं जिन्हें Built-In Tools कहा जाता है और जिनका उपयोग काफ़ी आसान है। इसके अलावा, हम अपने टूल्स स्वयं भी बना सकते हैं एक डेकोरेटर @tool का उपयोग कर, जो LangChain को बताता है कि यह फ़ंक्शन एक विशेष प्रकार का फ़ंक्शन है।
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
@tooldefmultiply(a:int, b:int)->int:"""This tool multiplies two numbers."""return a * b
llm = ChatOpenAI(model="gpt-4o-mini")
llm_tools = llm.bind_tools([multiply])# exposing the tools to the model
resp = llm_tools.invoke("What is 9*5? If needed, use a tool.")print(resp.tool_calls or resp.content)# model may emit a tool call with argumentsसंचालित द्वारा
ऊपर के कोड सेल में, आप देख सकते हैं कि मैंने एक बहुत सरल टूल बनाया है, जो दो संख्याएँ लेकर उनका गुणनफल लौटाता है। आंतरिक मॉडल (यहाँ GPT-4o-mini) को ऐसे टूल्स की पहुँच देने के लिए, हम llm.bind_tools() मेथड का उपयोग करते हैं और टूल्स की सूची पास करते हैं, यानी टूल्स को मॉडल के सामने उजागर करते हैं।
संवादी मेमोरी
AI एजेंट्स बनाते समय मेमोरी भी काफ़ी महत्वपूर्ण है। मेमोरी वाले AI एजेंट्स चीज़ें याद रख सकते हैं—पिछली बातचीत से, जैसे हमने पहले क्या पूछा, हमारी प्राथमिकताएँ, या क्या काम किया/नहीं किया। बिना मेमोरी के, हर बार किसी नए व्यक्ति से मिलने जैसा लगेगा—हमें बार‑बार बुनियादी संदर्भ दोहराना पड़ेगा, जो काफ़ी दुष्कर है।
LangChain में, मेमोरी का मतलब है पिछले संदेश या तथ्य किसी स्टोर (मेमोरी, डेटाबेस, या वेक्टर स्टोर) में सहेजना। फिर जब एजेंट दोबारा चलता है, वह उस मेमोरी को खींच सकता है ताकि प्रतिक्रियाएँ सुसंगत और स्मार्ट लगें।
दो मुख्य प्रकार हैं: शॉर्ट‑टर्म मेमोरी (उसी चैट के हाल के संदेश) और लॉन्ग‑टर्म मेमोरी (कई सेशन्स में याद रखे गए तथ्य या प्राथमिकताएँ)। ध्यान दें कि सेशन एक एकल बातचीत या इंटरेक्शन विंडो है, जहाँ हमारा एजेंट उसके समाप्त होने तक कही गई बातों का हिसाब रखता है।
शॉर्ट‑टर्म एकल बातचीत के दौरान संदर्भ बनाए रखती है, जबकि लॉन्ग‑टर्म समय के साथ एजेंट को अधिक व्यक्तिगत और सहायक बनाती है।
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_core.chat_history import InMemoryChatMessageHistory
prompt = ChatPromptTemplate.from_messages([("system","Be brief"),
MessagesPlaceholder(variable_name="history"),("human","{input}")])
chain = prompt | ChatOpenAI(model="gpt-4o")
store ={}# session_id -> historydefget_history(session_id:str):if session_id notin store:
store[session_id]= InMemoryChatMessageHistory()return store[session_id]
with_history = RunnableWithMessageHistory(
chain,lambda cfg: get_history(cfg["configurable"]["session_id"]),
input_messages_key="input",
history_messages_key="history",)
cfg ={"configurable":{"session_id":"u1"}}print(with_history.invoke({"input":"My name is Vaibhav."}, config=cfg))print(with_history.invoke({"input":"What is my name?"}, config=cfg))संचालित द्वारा
ऊपर के सेल में, कोड एक चैट चेन बनाता है जो किसी सेशन में पिछले संदेश याद रख सकता है। प्रॉम्प्ट में एक हिस्ट्री प्लेसहोल्डर है, और RunnableWithMessageHistory हर बार सही बातचीत से उसे स्वचालित रूप से भर देता है। स्टोर अलग‑अलग सेशन्स की हिस्ट्री रखता है।
ध्यान देने की बात यह है कि मेमोरी का उपयोग सोच‑समझकर करना चाहिए। हमें तय करना और कोड लिखना पड़ता है कि क्या रखना सार्थक है, कब स्टोर करना है, और प्रॉम्प्ट में कितना वापस पास करना है। बात यह है कि, बहुत ज़्यादा मेमोरी चीज़ों को धीमा कर सकती है या लिमिट्स पार कर सकती है, लेकिन सही संतुलन हमारे एजेंट्स को कहीं अधिक उपयोगी बनाता है।
LangGraph क्या है?
अब हम दूसरे एजेंटिक फ्रेमवर्क—LangGraph—पर आते हैं।
LangGraph को सरलता से समझाने के लिए, मैं एक उपमा का उपयोग करूँगा: बैकपैक फ्लोचार्ट उपमा।
हम LangGraph को अपने AI ऐप के एक छोटे से फ्लोचार्ट के रूप में सोच सकते हैं। हर बॉक्स (जिसे नोड कहते हैं) एक छोटा‑सा Python फ़ंक्शन है जो एक काम करता है। तीर (एजेज़) बताते हैं कि अगला कौन‑सा बॉक्स चलेगा। डेटा का एक छोटा बैकपैक (“स्टेट”) फ्लोचार्ट में घूमता है, ताकि हर नोड उसे पढ़ सके और उसमें जोड़ सके। उदाहरण के लिए, चैट ऐप में यह बैकपैक आम तौर पर संदेशों की चलती सूची होता है।
from typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage
# This is the backpack that moves through the graph.classState(TypedDict):# To add messages to the state
messages: Annotated[List, add_messages]
llm = ChatOpenAI(model="gpt-4o")# This is a node that asks the model and adds the reply to the backpack.defmodel_node(state: State):
reply = llm.invoke(state["messages"])return{"messages":[reply]}# Building the graph
graph = StateGraph(State)
graph.add_node("model", model_node)
graph.add_edge(START,"model")
graph.add_edge("model", END)# Building and running once
app = graph.compile()
result = app.invoke({"messages":[HumanMessage(content="Explain LangGraph in one sentence.")]})print(result["messages"][-1].content)संचालित द्वारा
आइए अब कोड को समझते हैं। यहाँ हम सबसे सरल संभव LangGraph ऐप बना रहे हैं। स्टेट बैकपैक जैसा है, जो संदेशों को ग्राफ़ में ले जाता है। हम इसे State से परिभाषित करते हैं, जो LangGraph को बताता है कि चैट संदेशों की चलती सूची हमेशा रखनी है।
फिर आता है नोड, जो यहाँ एक ही फ़ंक्शन है—model_node—जो बैकपैक के भीतर देखता है, संदेशों को LLM को भेजता है, और जवाब लौटाता है। LangGraph फिर स्वचालित रूप से इस जवाब को बैकपैक में जोड़ देता है।
स्वयं ग्राफ़ एक छोटा फ्लोचार्ट है: START → model → END। जब हम इसे कंपाइल करते हैं, LangGraph इस ड्रॉइंग को रन करने योग्य ऐप में बदल देता है।
अंततः, हम ऐप (ग्राफ़ नहीं—बल्कि कंपाइल्ड ग्राफ़) को चलाते हैं, जिसमें बैकपैक पहले से एक मानव संदेश लिए होता है।
दृश्य समझ बनाने में मदद के लिए, हम यह कोड चलाकर ग्राफ़ देख सकते हैं:
from IPython.display import Image, display
display(Image(app.get_graph().draw_mermaid_png()))संचालित द्वारा
फिर भी ध्यान दें, केवल इसलिए कि विज़ुअलाइज़ेशन बन गया है, इसका मतलब यह नहीं कि ग्राफ़ चलेगा! कुछ तार्किक त्रुटियाँ हो सकती हैं जिन्हें पहले ठीक करना आवश्यक है।
ब्रांचिंग ग्राफ़
अब आगे बढ़ते हैं ब्रांचिंग की ओर, जो किसी भी मज़बूत एजेंटिक सिस्टम का महत्वपूर्ण (और आसान) घटक है। यह हमारे एजेंट्स को विकल्प चुनने की अधिक स्वतंत्रता देता है, उसे वर्कफ़्लो से एजेंटिक सिस्टम में बदल देता है।
अब कोड देखें:
from typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, AIMessage
# Defining the stateclassState(TypedDict):
messages: Annotated[List, add_messages]
llm = ChatOpenAI(model="gpt-4o-mini")defanswer_node(state: State):# Normal answer using the whole chat history.return{"messages":[llm.invoke(state["messages")]]}defclarify_node(state: State):# LLm asking for a short follow-up to get enough detail (clarifying)return{"messages":[AIMessage(content="Could you share a bit more so I can be precise?")]}# Router functiondefroute(state: State):# Look for the latest human message and count words.
last_human =next((m for m inreversed(state["messages"])if m.type=="human"),None)ifnot last_human:return"clarify"
words =len(str(last_human.content).split())return"answer"if words >=3else"clarify"
graph = StateGraph(State)
graph.add_node("answer", answer_node)
graph.add_node("clarify", clarify_node)# Adding a conditional edge to connect the router function
graph.add_conditional_edges(START, route,{"answer":"answer","clarify":"clarify"})
graph.add_edge("answer", END)
graph.add_edge("clarify", END)
app = graph.compile()# Compiling the graphसंचालित द्वारा
अधिकांश भाग पहले एजेंट जैसा ही है, सिवाय कंडीशनल एज के। यह हमें LLM के आकलन के आधार पर सिस्टम को अलग‑अलग संभावित रूट्स देने देता है। दृश्य रूप में, सिस्टम कुछ ऐसा दिखता है:
कंडीशनल एजेज़ की ताकत से, हम अपनी वर्तमान जानकारी के साथ काफ़ी मज़बूत एजेंटिक सिस्टम्स बना सकते हैं। यदि आप अधिक व्यापक ट्यूटोरियल चाहते हैं, तो मैं अपना LangGraph वीडियो ट्यूटोरियल देखने की सलाह देता हूँ।
हाल ही में, LangGraph में LangGraph Studio नामक एक नया जोड़ भी हुआ है, और मैं इस पर यह LangGraph Studio गाइड अवश्य देखने की सिफारिश करता हूँ।
LangFlow क्या है?
यद्यपि LangChain और LangGraph Lang परिवार में अधिकांश डेवलपर्स की पहली पसंद हैं, मेरा मानना है कि LangFlow पर संक्षेप में चर्चा करना उचित होगा।
LangFlow को LLM ऐप्स के लिए ड्रैग‑एंड‑ड्रॉप कैनवस समझें। हर नोड = एक स्टेप (प्रॉम्प्ट, मॉडल, टूल, रिट्रीवर, वेक्टर DB, फ़ाइल ऑप, आदि)। हम नोड्स को जोड़कर एक फ्लो बनाते हैं, फिर उसे चलाते हैं, एक्सपोर्ट करते हैं, या डिप्लॉय करते हैं। यह तेज़ इटरेशन के लिए बढ़िया है और विशेषकर गैर‑कोडर्स के साथ सहयोग करने तथा विचारों को जल्दी काम करने वाले एजेंट्स में बदलने के लिए उपयुक्त है।
अब, हाँ, एजेंट्स बनाने में यह LangGraph और LangChain जितना उन्नत नहीं है; फिर भी, इसे उपयोग करने के कुछ कारण हैं:
विज़ुअल बिल्डर जिससे फ़्लोज़ को जल्दी स्केच किया जा सके
गैर‑कोडर्स को एजेंटिक सिस्टम बनाने की क्षमता देना
हर जगह चलता है: वेब, और अब स्थानीय विकास के लिए LangFlow Desktop
फ़्लोज़ को JSON के रूप में एक्सपोर्ट/इम्पोर्ट करें और APIs के रूप में सर्व करें
शिक्षण, वर्कशॉप्स, और बिना भारी कोडिंग के त्वरित प्रोटोटाइप के लिए बढ़िया
कोड में एक्सपोर्ट: स्थिर होने पर इंजीनियरों को सौंप दें।
मैं मान लेता हूँ कि आप वास्तव में गैर‑कोडर हैं, तो आपको LangFlow का उपयोग तब करना चाहिए जब आप आर्किटेक्चर विकल्पों (RAG वेरिएंट्स, टूल उपयोग आदि) का अन्वेषण कर रहे हों और जल्दी तुलना करना चाहते हों या आपको स्टेकहोल्डर्स के सामने डिज़ाइन्स को विज़ुअली संप्रेषित करना हो।
LangFlow के बारे में और सीखने तथा एक ट्यूटर बनाने जैसे प्रोजेक्ट पूरे करने के लिए, मैं यह LangFlow गाइड विद डेमो प्रोजेक्ट अवश्य सुझाऊँगा।
LangSmith क्या है?
अंतिम लाइब्रेरी जिस पर मैं बात करना चाहता हूँ, वह है LangSmith। LangSmith LLM ऐप्स के लिए ऑब्ज़र्वेबिलिटी + इवैल का लेयर है। यह हमें ट्रेसिंग देता है (यानी हर स्टेप, टूल कॉल, टोकन, त्रुटि देखना), मूल्यांकन (डेटासेट्स, स्वचालित एवं मानव‑इन‑द‑लूप स्कोरिंग) और मॉनिटरिंग/अलर्ट्स (ड्रिफ्ट, रिग्रेशन ट्रैक करना)। LangSmith में एक ट्रेस कैसा दिखता है, इसका उदाहरण नीचे देखा जा सकता है:
डेवलपर्स LangSmith का उपयोग कई कारणों से कर सकते हैं:
ट्रेस करें जटिल चेन्स/एजेंट्स को एंड‑टू‑एंड (इनपुट्स, आउटपुट्स, लेटेंसीज़, त्रुटियाँ)
मूल्यांकन करें बदलावों का सुरक्षित रूप से—डेटासेट्स + स्वचालित/मानव ग्रेडर्स के साथ
मॉनिटर करें लाइव ट्रैफ़िक; रिग्रेशंस पकड़ें; वर्ज़न्स की तुलना करें
प्लग‑एंड‑प्ले LangChain/LangGraph के साथ
फ्रेम‑अज्ञेय, यानी LangSmith को LangChain, LangGraph, या पूरी तरह अलग स्टैक्स के साथ भी उपयोग कर सकते हैं।
किसी भी लैंग्वेज स्टैक—JavaScript, TypeScript, Python—में उपयोग किया जा सकता है
LangFlow: कॉम्पोनेन्ट्स (लोडर्स, LLMs, रिट्रीवर्स, टूल्स) और कनेक्शन्स वाला कैनवस।
वर्कफ़्लो संरचना
LangChain: लिनियर या DAG, अधिकतर आगे‑की‑ओर।
LangGraph: पूर्ण ग्राफ़ जिसमें सायकिल्स, ब्रांचिंग, लूपिंग, पॉज़ेस हों।
LangSmith: यह एक एक्ज़ीक्यूशन फ्रेमवर्क नहीं—यह लॉगिंग/इवैल के लिए आपके रन्स को रैप करता है।
LangFlow: विज़ुअल ग्राफ़, जिसे आम तौर पर LangChain कोड में एक्सपोर्ट किया जाता है।
स्टेट प्रबंधन
LangChain: अक्सर इम्प्लिसिट या कॉम्पोनेन्ट‑लोकल।
LangGraph: केंद्रीय, स्पष्ट स्टेट जो नोड्स के बीच थ्रेडेड है। इससे परसिस्टेंस/चेकपॉइंटिंग संभव होती है—अर्थात हम चैट्स को मेमोरी में स्टोर कर सकते हैं।
LangSmith: रन मेटाडेटा, इनपुट्स/आउटपुट्स, मेट्रिक्स और फीडबैक स्टोर करता है।
LangFlow: कॉम्पोनेन्ट कॉन्फ़िगरेशन JSON फ़्लो में सेव होते हैं।
कंट्रोल फ्लो
LangChain: सीमित ब्रांचिंग/रिट्राइ प्रिमिटिव्स।
LangGraph: कंडीशनल्स, रिट्राइज़, ह्यूमन‑इन‑द‑लूप के लिए फ़र्स्ट‑क्लास सपोर्ट।
LangSmith: कंट्रोल फ्लो के लिए कुछ नहीं, केवल मूल्यांकन/अलर्ट्स ऑफ़र करता है।
LangFlow: विज़ुअल ब्रांचिंग; सटीक सेमांटिक्स एक्सपोर्टेड बैकएंड पर निर्भर।
उपयोग में सरलता
LangChain: सरल APIs।
LangGraph: सीखने का कर्व अधिक खड़ा।
LangSmith: वातावरण वेरिएबल्स से सक्षम करना आसान।
LangFlow: विज़ुअली शुरू करना सबसे आसान और टीमों/वर्कशॉप्स—विशेषकर गैर‑कोडर्स—के लिए बढ़िया।
विज़ुअल प्रोटोटाइपिंग, स्टेकहोल्डर रिव्यूज़, और LangChain कोड में एक्सपोर्ट
अंतिम विचार
अब हमने इन 4 लाइब्रेरीज़ को काफ़ी विस्तार से कवर और तुलना कर ली है, पर स्पष्ट है कि इन लाइब्रेरीज़ के साथ एक एडवांस्ड AI इंजीनियर बनने के लिए सीखने को और बहुत कुछ है। इसलिए, मैं RAG Systems with LangChain और building Agentic Systems with LangChain जैसे कोर्सेज़ की अत्यधिक सिफारिश करता हूँ।
LangChain बनाम LangGraph FAQs
LangChain और LangGraph में मुख्य अंतर क्या है?⌄
सरल रैखिक वर्कफ़्लोज़ के लिए LangChain बढ़िया है, जबकि LangGraph जटिल, स्टेटफुल, ब्रांचिंग/लूपिंग फ्लोज़ के लिए मज़बूत नियंत्रण वाला ग्राफ़-आधारित लेयर है।
क्या LangGraph का उपयोग करने के लिए मुझे LangChain चाहिए?⌄
LangGraph, LangChain इकोसिस्टम (मॉडल, टूल्स, मेमोरी) पर बना है। आमतौर पर, इन्हें साथ में उपयोग किया जाता है जहाँ ऑर्केस्ट्रेशन LangGraph संभालता है।
मुझे LangSmith कब जोड़ना चाहिए?⌄
जैसे ही आप त्वरित प्रयोगों से आगे बढ़ते हैं। LangSmith चेन और ग्राफ़—दोनों के लिए ट्रेसिंग, डिबगिंग, मूल्यांकन, और एनालिटिक्स देता है।
क्या LangFlow अनिवार्य है?⌄
नहीं, यह अनिवार्य नहीं है, लेकिन विज़ुअल प्रोटोटाइपिंग और सिखाने में, या गैर-कोडर्स के लिए यह उपयोगी है।
मल्टी‑एजेंट सिस्टम्स के लिए कौन बेहतर है?⌄
LangGraph। इसकी स्टेट और कंट्रोल-फ्लो क्षमता मल्टी‑एजेंट समन्वयन और रिकवरी रणनीतियों को प्रबंधित करना काफी आसान बना देती है, यद्यपि सीखने का कर्व अधिक खड़ा है।


यह लेख LangChain बनाम LangGraph की औपचारिक, साथ-साथ तुलना देता है, और साथ ही बताता है कि LangSmith और LangFlow इसमें कहाँ फिट होते हैं। हम अन्य DataCamp लेखों में कवर की गई अवधारणाओं पर आगे निर्माण करेंगे और चर्चा करेंगे कि प्रोडक्शन-रेडी, एजेंटिक AI सिस्टम्स शिप करने के लिए किस फ्रेमवर्क को कब चुनना चाहिए। यदि आप LangChain की व्यावहारिक शुरुआत खोज रहे हैं, तो मैं यह Developing LLM Applications with LangChain कोर्स सुझाता हूँ।
संक्षेप में (TL;DR)
विवरण में जाने से पहले, यहाँ एक त्वरित ओवरव्यू है कि LangChain, LangGraph, LangSmith, और LangFlow एक-दूसरे के साथ कैसे फिट होते हैं और आप किसे कब चुन सकते हैं।
त्वरित हीयूरिस्टिक: LangChain से शुरू करें, वर्कफ़्लो बढ़ने पर LangGraph पर जाएँ, ऑब्ज़र्वेबिलिटी के लिए LangSmith जोड़ें, तेज़ इटरेशन या सहयोग की ज़रूरत हो तो LangFlow का उपयोग करें।
LangChain और LangGraph का परिचय
लार्ज लैंग्वेज मॉडल्स (LLMs) एकल प्रॉम्प्ट्स पर बेहतरीन हैं। आजकल हम इन मॉडलों का इतना उपयोग करते हैं कि यह बात अब लगभग सर्वमान्य है।
हालाँकि, वास्तविक एप्लीकेशंस को वर्कफ़्लोज़ चाहिए: डेटा लाना, तर्क करना, टूल्स कॉल करना, फ़ॉलो‑अप पूछना, विफलता पर फिर से कोशिश करना, और कभी‑कभी इंसान के लिए रुकना। इसलिए, आप बार‑बार दो फ्रेमवर्क्स के बारे में सुनेंगे: LangChain और LangGraph। वे एक ही इकोसिस्टम में रहते हैं और अक्सर साथ काम करते हैं, लेकिन वे समस्या के अलग-अलग हिस्से हल करते हैं:
इकोसिस्टम की बात करें, तो हम LangSmith (जो ऑब्ज़र्वेबिलिटी/इवैलुएशन कार्यों के लिए है) और LangFlow (जो एक ड्रैग‑एंड‑ड्रॉप विज़ुअल बिल्डर है) पर भी चर्चा करेंगे, क्योंकि ये भी इसी इकोसिस्टम का हिस्सा हैं।
LangChain इकोसिस्टम का संक्षिप्त इतिहास (2022–2025)
मेरा मानना है कि LangChain इकोसिस्टम का थोड़ा इतिहास बताना उचित है; यह एजेंटिक AI के लिए पसंदीदा फ्रेमवर्क बन चुका है, और यह जानना कि यह यहाँ तक कैसे पहुँचा, आपको समझने में मदद करेगा कि LangGraph, LangSmith, और LangFlow क्यों मायने रखते हैं।
LangChain और LangGraph का संक्षिप्त परिचय
अब हम कोर इकोसिस्टम में गहराई से जाएँगे, शुरुआत करते हैं LangChain और LangGraph से।
LangChain LLM‑संचालित एप्लीकेशंस बनाने का एक मॉड्यूलर फ्रेमवर्क है। यह हमें बिल्डिंग ब्लॉक्स देता है — प्रॉम्प्ट्स, मॉडल्स, मेमोरी, टूल्स, रिट्रीवर्स — और इन्हें अपनी Runnable/LCEL APIs से पाइपलाइन में जोड़ने का सरल तरीका देता है (इस पर थोड़ी देर में चर्चा करेंगे)। मैं इसे आम LLM पैटर्न्स — RAG, प्रश्न‑उत्तर, चैटबॉट्स, और टूल‑उपयोगी एजेंट्स — के लिए एक Lego ब्रिक्स किट की तरह मानता हूँ।
LangGraph एक नया, ग्राफ़‑आधारित ऑर्केस्ट्रेशन लेयर है जो LangChain कॉम्पोनेन्ट्स पर बना है। एक सीधी रेखा की बजाय, ऐप को नोड्स (यानी क्रियाएँ) और एजेज़ (यानी ट्राँज़िशन्स) के रूप में मॉडल किया जाता है, जिसमें एक स्पष्ट स्टेट ऑब्जेक्ट ग्राफ़ के माध्यम से बहता है। हम इसे विस्तार से चर्चा करेंगे, लेकिन फिलहाल याद रखें कि यह डिज़ाइन स्वाभाविक रूप से ब्रांच (विभिन्न पथ लेना), लूप (स्पष्टता के प्रश्न तब तक पूछना जब तक भरोसा न हो), रिट्राइ (टूल/मॉडल त्रुटियों पर), और रुकना (मानव समीक्षा के लिए) सहज बनाता है; ठीक वही जो लंबे समय तक चलने वाले, प्रोडक्शन‑ग्रेड एजेंट्स के लिए चाहिए।
अब आपके मन में एक प्रश्न हो सकता है:
“इनकी तुलना करनी ही क्यों?”
बात ये है: यद्यपि वे कॉम्पोनेन्ट्स साझा करते हैं, वे अलग‑अलग जटिलता स्तरों को लक्ष्य करते हैं:
व्यवहार में, कई डेवलपर्स LangChain से शुरुआत करके आइडिया वैलिडेट करते हैं, फिर LangGraph पर अपग्रेड करते हैं जैसे‑जैसे वे ब्रांचिंग, एरर हैंडलिंग, मल्टी‑एजेंट समन्वयन या ड्यूरेबिलिटी जोड़ते हैं।
LangChain क्या है?
अब हम LangChain को विस्तार से समझेंगे, उसका उपयोग जानेंगे, और इसमें एप्लीकेशंस कोड करेंगे। फिर से ध्यान दें कि LangChain एक लाइब्रेरी है जो हमें सीक्वेंशियल LLM वर्कफ़्लोज़ की नींव बनाने देती है।
LCEL
शुरू करने के लिए, मैं बताना चाहता हूँ कि LCEL क्या है। LCEL यानी LangChain Expression Language, ब्लॉक्स को पाइप्स (|) से आपस में जोड़ने का तरीका है। हर ब्लॉक एक प्रॉम्प्ट, एक मॉडल, एक रिट्रीवर या एक पार्सर हो सकता है। जब हम इन्हें जोड़ते हैं, हमें एक चेन मिलती है जिसे बार‑बार चलाया जा सकता है, जिससे कोड लिखना काफ़ी कुशल हो जाता है।
कुछ उदाहरण देखते हैं।
मेरे विचार में, ऊपर का कोड सेल LCEL का सबसे सरल उपयोग दिखाता है। हमने पहले एक प्रॉम्प्ट टेम्पलेट बनाया जो हमेशा एक सिस्टम संदेश (“you are concise”) शामिल करता है और मानव प्रश्न के लिए जगह छोड़ता है। सिस्टम संदेश LLM के लिए एक निर्देश जैसा है जो बताता है कि उसे किसी विशिष्ट तरीके से जवाब/कार्य करना है। फिर हमने इस टेम्पलेट को एक OpenAI मॉडल — GPT-4o-mini — से जोड़ा।
अंत में, मैंने एक आउटपुट पार्सर जोड़ा, जो मूलतः प्रतिक्रिया को सादे टेक्स्ट में बदल देता है।
अब आती है सबसे महत्वपूर्ण बात: | ऑपरेटर ही इन ब्लॉक्स को एक पाइपलाइन में जोड़ता है।
मैं
invoke()औरbatch()के बारे में भी बात करना चाहता हूँ। जब हमchain.invoke(...)कॉल करते हैं, तो पाइपलाइन एक बार चलती है, यानी टेम्पलेट में प्रश्न भरता है, मॉडल उत्तर जनरेट करता है, और पार्सर साफ़ टेक्स्ट लौटाता है।लेकिन जब हम
chain.batch(...)कॉल करते हैं, तो वही चेन एक साथ कई इनपुट्स पर चलती है, जो एक‑एक करके लूप करने से कहीं तेज़ है। व्यवहार में, इससे सरल, एकल कॉल से पूरे डेटासेट संभालने तक जाना लगभग बिना अतिरिक्त कोड के आसान हो जाता है।मैं यहाँ एक और उदाहरण दिखाना चाहता हूँ:
यह कोड पहले वाले जैसा ही है लेकिन इसे एक बार कॉल करने के बजाय हम स्ट्रीमिंग का उपयोग करते हैं।
.stream(...)के साथ, मॉडल पूरे उत्तर के तैयार होने का इंतज़ार नहीं करता। इसके बजाय, यह टेक्स्ट के टुकड़े जैसे‑जैसे बनते हैं वैसे‑वैसे भेजता है, और हम उन्हें रीयल‑टाइम में प्रिंट करते हैं।इस उपखंड से मुख्य सीख यह है कि LCEL एक सरल “पाइप्स और ब्लॉक्स” सिस्टम है जो हमें प्रॉम्प्ट्स, मॉडल्स, टूल्स और पार्सर्स को जोड़ने देता है और तुरंत एक चेन देता है जिसे हम रन, बैच, या स्ट्रीम कर सकते हैं—वो भी बिना अतिरिक्त कोड के।
Pydantic के साथ स्ट्रक्चर्ड आउटपुट्स
स्ट्रक्चर्ड आउटपुट्स AI एजेंट्स का एक महत्वपूर्ण घटक है। इसका अर्थ है कि हमारा एजेंट लंबा बिखरा हुआ टेक्स्ट देने की बजाय, स्पष्ट फ़ॉर्मैट—जैसे JSON, टेबल्स या लिस्ट्स—में उत्तर दे। इससे कंप्यूटर और लोग दोनों उसे पढ़, उपयोग, और अन्य टूल्स से जोड़ने में आसानी महसूस करते हैं।
उद्योग में इसके लिए उपयोग होने वाले प्रमुख फ्रेमवर्क्स में से एक है Pydantic।
इस उदाहरण में,
.with_structured_output()मेथड महत्वपूर्ण है, क्योंकि यह LLM को बताता है कि आउटपुट हमारे बनाए Pydantic मॉडल के रूप में दे। परदे के पीछे, LangChain सुनिश्चित करता है कि हमारे एजेंट का जवाब वास्तविक JSON हो जो फ़ॉर्म से मेल खाता हो, और फिर उसे एक Python ऑब्जेक्ट में बदल देता है जिसे आप तुरंत उपयोग कर सकते हैं।तो बिखरे हुए टेक्स्ट के बजाय, हमें कुछ ऐसा मिलता है:
TaskPlan(title="...", steps=["...", "...", "..."])। यह विशेष रूप से तब उपयोगी है जब हम टूल्स उपयोग करते हैं।LangChain में टूल कॉलिंग
टूल्स महत्वपूर्ण हैं क्योंकि वे हमारे LLM की क्षमता बढ़ाते हैं—ऐसे कार्य पूरे करके जो वह पहले करने में असमर्थ था, जैसे इंटरनेट सर्च करना।
मुझे टूल्स की सबसे अच्छी बात यह लगती है कि LangChain (और कई एजेंटिक फ्रेमवर्क) रेडी‑मेड टूल्स प्रदान करते हैं जिन्हें Built-In Tools कहा जाता है और जिनका उपयोग काफ़ी आसान है। इसके अलावा, हम अपने टूल्स स्वयं भी बना सकते हैं एक डेकोरेटर
@toolका उपयोग कर, जो LangChain को बताता है कि यह फ़ंक्शन एक विशेष प्रकार का फ़ंक्शन है।ऊपर के कोड सेल में, आप देख सकते हैं कि मैंने एक बहुत सरल टूल बनाया है, जो दो संख्याएँ लेकर उनका गुणनफल लौटाता है। आंतरिक मॉडल (यहाँ GPT-4o-mini) को ऐसे टूल्स की पहुँच देने के लिए, हम
llm.bind_tools()मेथड का उपयोग करते हैं और टूल्स की सूची पास करते हैं, यानी टूल्स को मॉडल के सामने उजागर करते हैं।संवादी मेमोरी
AI एजेंट्स बनाते समय मेमोरी भी काफ़ी महत्वपूर्ण है। मेमोरी वाले AI एजेंट्स चीज़ें याद रख सकते हैं—पिछली बातचीत से, जैसे हमने पहले क्या पूछा, हमारी प्राथमिकताएँ, या क्या काम किया/नहीं किया। बिना मेमोरी के, हर बार किसी नए व्यक्ति से मिलने जैसा लगेगा—हमें बार‑बार बुनियादी संदर्भ दोहराना पड़ेगा, जो काफ़ी दुष्कर है।
LangChain में, मेमोरी का मतलब है पिछले संदेश या तथ्य किसी स्टोर (मेमोरी, डेटाबेस, या वेक्टर स्टोर) में सहेजना। फिर जब एजेंट दोबारा चलता है, वह उस मेमोरी को खींच सकता है ताकि प्रतिक्रियाएँ सुसंगत और स्मार्ट लगें।
दो मुख्य प्रकार हैं: शॉर्ट‑टर्म मेमोरी (उसी चैट के हाल के संदेश) और लॉन्ग‑टर्म मेमोरी (कई सेशन्स में याद रखे गए तथ्य या प्राथमिकताएँ)। ध्यान दें कि सेशन एक एकल बातचीत या इंटरेक्शन विंडो है, जहाँ हमारा एजेंट उसके समाप्त होने तक कही गई बातों का हिसाब रखता है।
शॉर्ट‑टर्म एकल बातचीत के दौरान संदर्भ बनाए रखती है, जबकि लॉन्ग‑टर्म समय के साथ एजेंट को अधिक व्यक्तिगत और सहायक बनाती है।
ऊपर के सेल में, कोड एक चैट चेन बनाता है जो किसी सेशन में पिछले संदेश याद रख सकता है। प्रॉम्प्ट में एक हिस्ट्री प्लेसहोल्डर है, और
RunnableWithMessageHistoryहर बार सही बातचीत से उसे स्वचालित रूप से भर देता है। स्टोर अलग‑अलग सेशन्स की हिस्ट्री रखता है।ध्यान देने की बात यह है कि मेमोरी का उपयोग सोच‑समझकर करना चाहिए। हमें तय करना और कोड लिखना पड़ता है कि क्या रखना सार्थक है, कब स्टोर करना है, और प्रॉम्प्ट में कितना वापस पास करना है। बात यह है कि, बहुत ज़्यादा मेमोरी चीज़ों को धीमा कर सकती है या लिमिट्स पार कर सकती है, लेकिन सही संतुलन हमारे एजेंट्स को कहीं अधिक उपयोगी बनाता है।
LangGraph क्या है?
अब हम दूसरे एजेंटिक फ्रेमवर्क—LangGraph—पर आते हैं।
LangGraph को सरलता से समझाने के लिए, मैं एक उपमा का उपयोग करूँगा: बैकपैक फ्लोचार्ट उपमा।
हम LangGraph को अपने AI ऐप के एक छोटे से फ्लोचार्ट के रूप में सोच सकते हैं। हर बॉक्स (जिसे नोड कहते हैं) एक छोटा‑सा Python फ़ंक्शन है जो एक काम करता है। तीर (एजेज़) बताते हैं कि अगला कौन‑सा बॉक्स चलेगा। डेटा का एक छोटा बैकपैक (“स्टेट”) फ्लोचार्ट में घूमता है, ताकि हर नोड उसे पढ़ सके और उसमें जोड़ सके। उदाहरण के लिए, चैट ऐप में यह बैकपैक आम तौर पर संदेशों की चलती सूची होता है।
मूलभूत ग्राफ़
यह एक साथ उदाहरण देखकर और स्पष्ट होगा:
आइए अब कोड को समझते हैं। यहाँ हम सबसे सरल संभव LangGraph ऐप बना रहे हैं। स्टेट बैकपैक जैसा है, जो संदेशों को ग्राफ़ में ले जाता है। हम इसे
Stateसे परिभाषित करते हैं, जो LangGraph को बताता है कि चैट संदेशों की चलती सूची हमेशा रखनी है।फिर आता है नोड, जो यहाँ एक ही फ़ंक्शन है—
model_node—जो बैकपैक के भीतर देखता है, संदेशों को LLM को भेजता है, और जवाब लौटाता है। LangGraph फिर स्वचालित रूप से इस जवाब को बैकपैक में जोड़ देता है।स्वयं ग्राफ़ एक छोटा फ्लोचार्ट है:
START → model → END। जब हम इसे कंपाइल करते हैं, LangGraph इस ड्रॉइंग को रन करने योग्य ऐप में बदल देता है।अंततः, हम ऐप (ग्राफ़ नहीं—बल्कि कंपाइल्ड ग्राफ़) को चलाते हैं, जिसमें बैकपैक पहले से एक मानव संदेश लिए होता है।
दृश्य समझ बनाने में मदद के लिए, हम यह कोड चलाकर ग्राफ़ देख सकते हैं:
फिर भी ध्यान दें, केवल इसलिए कि विज़ुअलाइज़ेशन बन गया है, इसका मतलब यह नहीं कि ग्राफ़ चलेगा! कुछ तार्किक त्रुटियाँ हो सकती हैं जिन्हें पहले ठीक करना आवश्यक है।
ब्रांचिंग ग्राफ़
अब आगे बढ़ते हैं ब्रांचिंग की ओर, जो किसी भी मज़बूत एजेंटिक सिस्टम का महत्वपूर्ण (और आसान) घटक है। यह हमारे एजेंट्स को विकल्प चुनने की अधिक स्वतंत्रता देता है, उसे वर्कफ़्लो से एजेंटिक सिस्टम में बदल देता है।
अब कोड देखें:
अधिकांश भाग पहले एजेंट जैसा ही है, सिवाय कंडीशनल एज के। यह हमें LLM के आकलन के आधार पर सिस्टम को अलग‑अलग संभावित रूट्स देने देता है। दृश्य रूप में, सिस्टम कुछ ऐसा दिखता है:
कंडीशनल एजेज़ की ताकत से, हम अपनी वर्तमान जानकारी के साथ काफ़ी मज़बूत एजेंटिक सिस्टम्स बना सकते हैं। यदि आप अधिक व्यापक ट्यूटोरियल चाहते हैं, तो मैं अपना LangGraph वीडियो ट्यूटोरियल देखने की सलाह देता हूँ।
हाल ही में, LangGraph में LangGraph Studio नामक एक नया जोड़ भी हुआ है, और मैं इस पर यह LangGraph Studio गाइड अवश्य देखने की सिफारिश करता हूँ।
LangFlow क्या है?
यद्यपि LangChain और LangGraph Lang परिवार में अधिकांश डेवलपर्स की पहली पसंद हैं, मेरा मानना है कि LangFlow पर संक्षेप में चर्चा करना उचित होगा।
LangFlow को LLM ऐप्स के लिए ड्रैग‑एंड‑ड्रॉप कैनवस समझें। हर नोड = एक स्टेप (प्रॉम्प्ट, मॉडल, टूल, रिट्रीवर, वेक्टर DB, फ़ाइल ऑप, आदि)। हम नोड्स को जोड़कर एक फ्लो बनाते हैं, फिर उसे चलाते हैं, एक्सपोर्ट करते हैं, या डिप्लॉय करते हैं। यह तेज़ इटरेशन के लिए बढ़िया है और विशेषकर गैर‑कोडर्स के साथ सहयोग करने तथा विचारों को जल्दी काम करने वाले एजेंट्स में बदलने के लिए उपयुक्त है।
अब, हाँ, एजेंट्स बनाने में यह LangGraph और LangChain जितना उन्नत नहीं है; फिर भी, इसे उपयोग करने के कुछ कारण हैं:
मैं मान लेता हूँ कि आप वास्तव में गैर‑कोडर हैं, तो आपको LangFlow का उपयोग तब करना चाहिए जब आप आर्किटेक्चर विकल्पों (RAG वेरिएंट्स, टूल उपयोग आदि) का अन्वेषण कर रहे हों और जल्दी तुलना करना चाहते हों या आपको स्टेकहोल्डर्स के सामने डिज़ाइन्स को विज़ुअली संप्रेषित करना हो।
LangFlow के बारे में और सीखने तथा एक ट्यूटर बनाने जैसे प्रोजेक्ट पूरे करने के लिए, मैं यह LangFlow गाइड विद डेमो प्रोजेक्ट अवश्य सुझाऊँगा।
LangSmith क्या है?
अंतिम लाइब्रेरी जिस पर मैं बात करना चाहता हूँ, वह है LangSmith। LangSmith LLM ऐप्स के लिए ऑब्ज़र्वेबिलिटी + इवैल का लेयर है। यह हमें ट्रेसिंग देता है (यानी हर स्टेप, टूल कॉल, टोकन, त्रुटि देखना), मूल्यांकन (डेटासेट्स, स्वचालित एवं मानव‑इन‑द‑लूप स्कोरिंग) और मॉनिटरिंग/अलर्ट्स (ड्रिफ्ट, रिग्रेशन ट्रैक करना)। LangSmith में एक ट्रेस कैसा दिखता है, इसका उदाहरण नीचे देखा जा सकता है: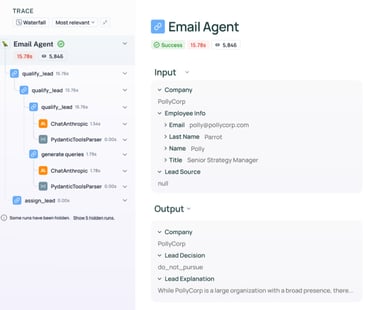
डेवलपर्स LangSmith का उपयोग कई कारणों से कर सकते हैं:
LangSmith के बारे में अधिक जानकारी के लिए, मैं यह विस्तृत introduction to LangSmith और LangSmith Agent Builder ट्यूटोरियल की सिफारिश करता हूँ।
LangChain बनाम LangGraph बनाम LangSmith बनाम LangFlow
इस खंड में मैं इन चारों लाइब्रेरीज़ की तुलना करना चाहता हूँ ताकि आप पूरी तरह स्पष्ट हों कि ये क्या हैं और इन्हें कब उपयोग करना है।
ये क्या हैं
प्रमुख कॉम्पोनेन्ट्स
वर्कफ़्लो संरचना
स्टेट प्रबंधन
कंट्रोल फ्लो
उपयोग में सरलता
किसके लिए सर्वोत्तम
कब किसका उपयोग करें
तुलनात्मक सारणी
नीचे की सारणी में आप LangChain बनाम LangGraph बनाम LangSmith बनाम LangFlow की तुलना देख सकते हैं:
श्रेणी
LangChain
LangGraph
LangSmith
LangFlow
ये क्या हैं
मॉड्यूलर हिस्सों (प्रॉम्प्ट्स, मॉडल्स, टूल्स, मेमोरी) से LLM ऐप्स बनाने का फ्रेमवर्क।
LangChain के ऊपर जटिल, स्टेटफुल वर्कफ़्लोज़ (ब्रांचिंग, लूपिंग, परसिस्टेंस) का ऑर्केस्ट्रेटर।
फ्रेमवर्क‑अज्ञेय ऑब्ज़र्वेबिलिटी, मूल्यांकन, और परीक्षण प्लेटफ़ॉर्म LLM ऐप्स के लिए।
फ़्लोज़ डिज़ाइन और प्रोटोटाइप करने के लिए विज़ुअल ड्रैग‑एंड‑ड्रॉप एडिटर।
प्रमुख कॉम्पोनेन्ट्स
चेन्स, Runnables, LCEL
नोड्स, एजेज़, स्टेट, राउटर्स, चेकपॉइंटर्स, टूल्स
ट्रेसेज़, रन्स, डेटासेट्स, इवैलुएटर्स, प्रोजेक्ट्स
कम्पोनेन्ट्स (लोडर्स, LLMs, रिट्रीवर्स, टूल्स) + कनेक्शन्स वाला कैनवस
वर्कफ़्लो संरचना
लिनियर या DAG, अधिकतर आगे‑की‑ओर
पूर्ण ग्राफ़ जिसमें सायकिल्स, ब्रांचिंग, लूपिंग, पॉज़ेस
एक्ज़ीक्यूशन फ्रेमवर्क नहीं; लॉगिंग और मूल्यांकन के लिए रन्स को रैप करता है
विज़ुअल ग्राफ़, LangChain कोड में एक्सपोर्टेबल
स्टेट प्रबंधन
इम्प्लिसिट या कॉम्पोनेन्ट‑लोकल
केंद्रीय, स्पष्ट स्टेट जो नोड्स में थ्रेडेड है; परसिस्टेंस और चेकपॉइंटिंग (जैसे चैट मेमोरी) को सपोर्ट करता है।
रन मेटाडेटा, इनपुट्स/आउटपुट्स, मेट्रिक्स, फीडबैक स्टोर करता है
कॉम्पोनेन्ट कॉन्फ़िगरेशन JSON फ़्लो में सेव
कंट्रोल फ्लो
सीमित ब्रांचिंग/रिट्राइ प्रिमिटिव्स
कंडीशनल्स, रिट्राइज़, ह्यूमन‑इन‑द‑लूप के लिए फ़र्स्ट‑क्लास सपोर्ट
कोई नहीं (फोकस एक्ज़ीक्यूशन पर नहीं, मूल्यांकन पर है)
विज़ुअल ब्रांचिंग; सेमांटिक्स एक्सपोर्टेड बैकएंड पर निर्भर
उपयोग में सरलता
सरल APIs
सीखने का कर्व अधिक खड़ा
सक्षम करना बहुत आसान (env variables)
विज़ुअली शुरू करने में सबसे आसान; वर्कशॉप्स और गैर‑कोडर्स के लिए टीम‑अनुकूल
किसके लिए सर्वोत्तम
प्रोटोटाइपिंग, रैखिक लॉजिक, त्वरित ऐप्स
मज़बूत, जटिल, लंबे समय तक चलने वाले या मल्टी‑एजेंट ऐप्स
ऑब्ज़र्वेबिलिटी, डिबगिंग, रिग्रेशन टेस्ट्स, A/B इवैल्यूएशंस
विज़ुअल प्रोटोटाइपिंग, स्टेकहोल्डर रिव्यूज़, और LangChain कोड में एक्सपोर्ट
अंतिम विचार
अब हमने इन 4 लाइब्रेरीज़ को काफ़ी विस्तार से कवर और तुलना कर ली है, पर स्पष्ट है कि इन लाइब्रेरीज़ के साथ एक एडवांस्ड AI इंजीनियर बनने के लिए सीखने को और बहुत कुछ है। इसलिए, मैं RAG Systems with LangChain और building Agentic Systems with LangChain जैसे कोर्सेज़ की अत्यधिक सिफारिश करता हूँ।