
{count, plural, one {Corso} other {Corsi}}
Sistemi Multi-Agente con LangGraph
{hours} ore {minutes} min
8.9K
Questo articolo offre un confronto formale, affiancato, tra LangChain e LangGraph, e chiarisce anche dove si inseriscono LangSmith e LangFlow. Riprenderemo concetti trattati in altri articoli DataCamp e discuteremo quando scegliere ciascun framework per consegnare sistemi AI agentici pronti per la produzione. Se cerchi un avvio pratico con LangChain, ti consiglio il corso Developing LLM Applications with LangChain.
Prima di entrare nei dettagli, ecco una rapida panoramica di come LangChain, LangGraph, LangSmith e LangFlow si incastrano e quando potresti scegliere ciascuno.
Euristica veloce: parti da LangChain, passa a LangGraph quando i workflow crescono, aggiungi LangSmith per l’osservabilità, usa LangFlow quando servono iterazioni rapide o collaborazione.
I large language model (LLM) sono ottimi con singoli prompt. Ormai è quasi scontato, visto quanto li utilizziamo.
Tuttavia, le applicazioni reali hanno bisogno di workflow: recuperare dati, ragionare, chiamare strumenti, fare una domanda di follow‑up, riprovare in caso di errore e a volte mettere in pausa per un intervento umano. Per questo sentirai spesso parlare di due framework: LangChain e LangGraph. Vivono nello stesso ecosistema e spesso lavorano insieme, ma risolvono parti diverse del problema:
Parlando di ecosistema, discuteremo anche di LangSmith (per osservabilità/valutazione) e di LangFlow (builder visuale drag‑and‑drop), poiché fanno parte dello stesso ecosistema.
Ha senso iniziare con un po’ di storia dell’ecosistema LangChain; è diventato il framework di riferimento per l’AI agentica, e capire come ci è arrivato aiuta a vedere perché LangGraph, LangSmith e LangFlow sono importanti.
Entriamo ora nel cuore dell’ecosistema, partendo da LangChain e LangGraph.
LangChain è un framework modulare per creare applicazioni basate su LLM. Fornisce i mattoncini — prompt, modelli, memoria, strumenti, retriever — e un modo semplice per concatenarli in una pipeline usando le API Runnable/LCEL (ne parleremo a breve). Mi piace pensarla come un kit di mattoncini Lego per pattern LLM comuni come RAG, question answering, chatbot e agenti tool‑using.
LangGraph è uno strato di orchestrazione basato su grafi più recente, costruito sui componenti LangChain. Invece di una linea retta di passaggi, l’app è modellata come nodi (le azioni) e archi (le transizioni), con un oggetto di stato esplicito che fluisce nel grafo. Ne parleremo in dettaglio, ma per ora ricorda che questo design rende naturale ramificare (seguire percorsi diversi), ciclare (porre domande chiarificatrici finché si è sicuri), riprovare (su errori di tool/modello) e mettere in pausa per una revisione umana; esattamente ciò che serve per agenti di lunga durata e di livello produttivo.
A questo punto potresti avere una domanda:
“Perché confrontarli?”
Il punto è questo: pur condividendo componenti, puntano a livelli di complessità diversi:
In pratica, molti sviluppatori partono da LangChain per validare un’idea, poi passano a LangGraph man mano che aggiungono ramificazioni, gestione errori, coordinamento multi‑agente o durabilità.
Ora entreremo in profondità su LangChain, per capirne l’utilizzo e scrivere applicazioni. Ricorda: LangChain è una libreria che ci permette di costruire le basi per workflow LLM sequenziali.
Per iniziare, voglio spiegare cos’è LCEL. LCEL, o LangChain Expression Language, è semplicemente un modo per collegare i blocchi con pipe (|). Ogni blocco può essere un prompt, un modello, un retriever o un parser. Unendoli, otteniamo una chain che possiamo eseguire più volte, rendendo la scrittura del codice molto più efficiente.
Vediamo alcuni esempi.
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

llm    = ChatOpenAI(model="gpt-4o-mini")
prompt = ChatPromptTemplate.from_messages([
    ("system", "You are concise."),
    ("human", "{question}")
])
chain = prompt | llm | StrOutputParser() # This is our chain

print(chain.invoke({"question": "Give me 3 focus tips."}))     # making a single call

qs = [{"question": q} for q in ["One tactic for RAG?", "Explain LCEL in 1 line."]]
print(chain.batch(qs))                                         # many calls at once
Secondo me, la cella di codice sopra mostra il modo più semplice per usare LCEL. Prima abbiamo creato un template di prompt che include sempre un messaggio di sistema (“you are concise”) e lascia spazio a una domanda dell’utente. Il messaggio di sistema è come un’istruzione per l’LLM che gli dice di rispondere/agire in un certo modo. Abbiamo poi collegato questo template a un modello OpenAI — GPT-4o-mini.
Infine, ho aggiunto un parser di output, che in pratica converte la risposta in testo semplice.
Ed ecco la parte più importante: l’operatore | è ciò che incolla questi blocchi in un’unica pipeline.
Voglio anche parlare di invoke() e batch(). Quando chiamiamo chain.invoke(...), la pipeline gira una volta: il template inserisce la domanda, il modello genera una risposta e il parser restituisce testo pulito.
Quando invece chiamiamo chain.batch(...), la stessa chain gira su molti input in una volta, molto più veloce che ciclare uno per uno. In pratica, passare da una singola chiamata semplice a gestire interi dataset diventa facile, quasi senza codice aggiuntivo.
Voglio mostrare un altro esempio:
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import StrOutputParser

stream_chain = (ChatPromptTemplate.from_template("{topic}")  | ChatOpenAI(model="gpt-4o-mini")  | StrOutputParser())

# Simple stream
for chunk in stream_chain.stream({"topic": "Explain PID in 2 lines"}):
    print(chunk, end="")
Questo codice è simile al primo, ma invece di chiamarlo una volta usiamo lo streaming. Con .stream(...), il modello non aspetta che l’intera risposta sia pronta. Invece invia chunk di testo man mano che vengono generati, e noi li stampiamo in tempo reale.
La cosa principale da portare a casa è che LCEL è il semplice sistema “tubi e blocchi” che ci consente di agganciare prompt, modelli, strumenti e parser e ottenere subito una chain che possiamo eseguire, batchare o streammare senza codice extra.
Gli output strutturati sono un componente vitale degli agenti AI. Significa che invece di fornire un testo lungo e disordinato, l’agente restituisce la risposta in un formato chiaro come JSON, tabelle o liste. Questo rende più facile per computer e persone leggere, usare e collegare ad altri strumenti.
Uno dei principali framework usati nell’industria per questo è Pydantic.
from pydantic import BaseModel, Field
from typing import List
from langchain_openai import ChatOpenAI

class TaskPlan(BaseModel):
    title: str
    steps: List[str] = Field(..., min_items=3, description="actionable steps")

structured = ChatOpenAI(model="gpt-4o-mini").with_structured_output(TaskPlan)
plan = structured.invoke("Plan a 20-minute deep-work session for AI Agent notes.")
print(plan.model_dump())
In questo esempio, il metodo .with_structured_output() è la parte importante, perché dice all’LLM di fornire l’output nella forma del modello Pydantic che abbiamo creato. Dietro le quinte, LangChain si assicura che la risposta del nostro agente sia un JSON reale che rispetta la struttura, e poi la converte in un oggetto Python utilizzabile subito.
Quindi, invece di testo disordinato, otteniamo qualcosa come TaskPlan(title="...", steps=["...", "...", "..."]). Questo è particolarmente utile quando usiamo Tool.
Gli strumenti sono importanti perché estendono le capacità dell’LLM per svolgere compiti che da solo non potrebbe fare, come cercare su Internet.
La cosa che preferisco degli strumenti è che LangChain (e molti framework agentici) fornisce tool già pronti chiamati Built-In Tools che sono piuttosto semplici da usare. Inoltre, possiamo anche creare i nostri tool usando il decorator @tool, che dice a LangChain che questa funzione è di un tipo speciale.
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI

@tool
def multiply(a: int, b: int) -> int:
    """This tool multiplies two numbers."""
    return a * b

llm = ChatOpenAI(model="gpt-4o-mini")
llm_tools = llm.bind_tools([multiply])   # exposing the tools to the model

resp = llm_tools.invoke("What is 9*5? If needed, use a tool.")
print(resp.tool_calls or resp.content)   # model may emit a tool call with arguments
Nel codice sopra, ho creato un tool molto semplice, che prende due numeri e restituisce il loro prodotto. Per dare al modello interno (in questo caso GPT-4o-mini) accesso a tali tool, usiamo il metodo llm.bind_tools() e passiamo la lista di strumenti, esponendo i tool al modello.
La memoria è cruciale nella costruzione di agenti AI. Gli agenti con memoria possono ricordare cose delle conversazioni passate, come ciò che abbiamo chiesto, le nostre preferenze o cosa ha funzionato e cosa no. Senza memoria, ogni volta sembra di incontrare qualcuno per la prima volta — dovremmo ripetere il contesto di base ogni volta, il che è scomodo.
In LangChain, la memoria significa salvare messaggi o fatti passati in un archivio (in memoria, database o vector store). Poi, quando l’agente gira di nuovo, può recuperare quella memoria così le risposte risultano coerenti e più intelligenti.
Ci sono due tipologie principali: memoria a breve termine (messaggi recenti nella stessa chat) e memoria a lungo termine (fatti o preferenze ricordati su molte sessioni). Nota che una sessione è una singola conversazione o finestra di interazione, in cui il nostro agente tiene traccia di ciò che è stato detto fino alla fine.
La breve termine mantiene il contesto durante una singola conversazione, mentre la lunga termine fa sì che l’agente, nel tempo, appaia più personale e utile.
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_core.chat_history import InMemoryChatMessageHistory

prompt = ChatPromptTemplate.from_messages([
    ("system", "Be brief"),
    MessagesPlaceholder(variable_name="history"),
    ("human", "{input}")
])
chain = prompt | ChatOpenAI(model="gpt-4o")

store = {}  # session_id -> history
def get_history(session_id: str):
    if session_id not in store:
        store[session_id] = InMemoryChatMessageHistory()
    return store[session_id]

with_history = RunnableWithMessageHistory(
    chain,
    lambda cfg: get_history(cfg["configurable"]["session_id"]),
    input_messages_key="input",
    history_messages_key="history",
)

cfg = {"configurable": {"session_id": "u1"}}
print(with_history.invoke({"input": "My name is Vaibhav."}, config=cfg))
print(with_history.invoke({"input": "What is my name?"}, config=cfg))
Nella cella sopra, il codice crea una chat chain che può ricordare i messaggi passati in una sessione. Il prompt ha un placeholder per la history e RunnableWithMessageHistory la riempie automaticamente con la conversazione corretta ogni volta. Lo store conserva le history per sessioni diverse.
È importante usare la memoria con criterio. Dobbiamo decidere e codificare cosa vale la pena tenere, quando salvarlo e quanto reinserire nel prompt. Il punto è: troppa memoria può rallentare o superare i limiti, ma il giusto equilibrio rende gli agenti molto più utili.
Passiamo ora all’altro framework agentico: LangGraph.
Per spiegare LangGraph in modo semplice, userò un’analogia: l’analogia del diagramma di flusso con lo zainetto.
Possiamo pensare a LangGraph come a un piccolo diagramma di flusso per la nostra app AI. Ogni scatola (chiamata nodo) è una piccola funzione Python che fa un compito. Le frecce (archi) dicono quale scatola gira dopo. Un piccolo zainetto di dati (lo “stato”) si muove nel diagramma, così ogni nodo può leggerlo e aggiungervi dati. In una chat, ad esempio, lo zainetto è di solito l’elenco dei messaggi in corso.
Tutto sarà più chiaro con un esempio:
pip install langgraph langchain-openaifrom typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage
# This is the backpack that moves through the graph.
class State(TypedDict):
# To add messages to the state
messages: Annotated[List, add_messages]
llm = ChatOpenAI(model="gpt-4o")
# This is a node that asks the model and adds the reply to the backpack.
def model_node(state: State):
reply = llm.invoke(state["messages"])
return {"messages": [reply]}
# Building the graph
graph = StateGraph(State)
graph.add_node("model", model_node)
graph.add_edge(START, "model")
graph.add_edge("model", END)
# Building and running once
app = graph.compile()
result = app.invoke({"messages": [HumanMessage(content="Explain LangGraph in one sentence.")]} )
print(result["messages"][-1].content)Vediamo il codice. Qui costruiamo l’app LangGraph più semplice possibile. Lo stato è come uno zainetto che trasporta i messaggi nel grafo. Lo definiamo con State, che dice a LangGraph di mantenere sempre un elenco aggiornato dei messaggi della chat.
Poi arriva il nodo, in questo caso una singola funzione, model_node, che guarda nello zainetto, invia i messaggi all’LLM e restituisce la risposta. LangGraph aggiunge automaticamente la risposta nello zainetto.
Il grafo è un mini diagramma: START → model → END. Quando lo compiliamo, LangGraph trasforma questo schema in un’app eseguibile.
Infine, eseguiamo l’app (non il grafo, bensì il grafo compilato) con uno zainetto che contiene già un messaggio umano.
Per aiutare la comprensione visiva, possiamo eseguire questo codice per vedere il grafo:
from IPython.display import Image, display
display(Image(app.get_graph().draw_mermaid_png()))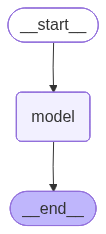
Nota bene: il fatto che venga generata la visualizzazione non significa che il grafo girerà! Potrebbero esserci errori logici da risolvere prima.
Facciamo un passo avanti verso le Ramificazioni, un componente importante (ma semplice) di qualsiasi sistema agentico robusto. Concedono più libertà decisionale agli agenti, trasformandolo da workflow a sistema agentico.
Ecco il codice:
from typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, AIMessage

# Defining the state
class State(TypedDict):
    messages: Annotated[List, add_messages]

llm = ChatOpenAI(model="gpt-4o-mini")

def answer_node(state: State):
    # Normal answer using the whole chat history.
    return {"messages": [llm.invoke(state["messages"])]}

def clarify_node(state: State):
    # LLm asking for a short follow-up to get enough detail (clarifying)
    return {"messages": [AIMessage(content="Could you share a bit more so I can be precise?")]}

# Router function
def route(state: State):
    # Look for the latest human message and count words.
    last_human = next((m for m in reversed(state["messages"]) if m.type == "human"), None)
    if not last_human:
        return "clarify"
    words = len(str(last_human.content).split())
    return "answer" if words >= 3 else "clarify"

graph = StateGraph(State)
graph.add_node("answer", answer_node)
graph.add_node("clarify", clarify_node)

# Adding a conditional edge to connect the router function
graph.add_conditional_edges(START, route, {"answer": "answer", "clarify": "clarify"})
graph.add_edge("answer", END)
graph.add_edge("clarify", END)
app = graph.compile() # Compiling the graph
Quasi tutto è simile al primo agente, tranne il bordo condizionale. Questo ci consente di fornire al sistema diversi percorsi potenziali in base al giudizio dell’LLM. Visivamente, il sistema appare così:
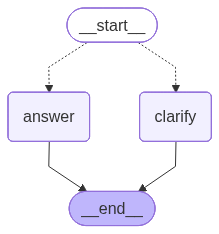
Con la potenza degli edge condizionali, possiamo costruire sistemi agentici piuttosto robusti con le conoscenze attuali. Se vuoi un tutorial più completo, ti consiglio di dare un’occhiata al mio video tutorial su LangGraph.
Di recente, è stato aggiunto anche LangGraph Studio, e ti consiglio vivamente questa guida a LangGraph Studio.
Anche se LangChain e LangGraph sono le due librerie più usate nella famiglia Lang, vale la pena parlare brevemente anche di LangFlow.
Pensa a LangFlow come a una tela drag‑and‑drop per app LLM. Ogni nodo = un passaggio (prompt, modello, tool, retriever, DB vettoriale, operazioni su file, ecc.). Connettiamo i nodi in un flusso, poi lo eseguiamo, esportiamo o distribuiamo. È ottimo per iterare velocemente e, in particolare, per collaborare con non programmatori e trasformare idee in agenti funzionanti in poco tempo.
Certo, non è avanzato come LangGraph e LangChain nella costruzione di agenti; tuttavia, ci sono buoni motivi per usarlo:
Immagino che tu non sia un programmatore, quindi dovresti usare LangFlow quando stai esplorando opzioni architetturali (varianti RAG, uso di tool, ecc.) e vuoi confrontarle rapidamente, o quando devi comunicare i design in modo visivo agli stakeholder.
Per saperne di più su LangFlow e realizzare un progetto come la costruzione di un Tutor, ti consiglio vivamente questa guida a LangFlow con progetto demo.
L’ultima libreria di cui voglio parlare è LangSmith. LangSmith è lo strato di osservabilità + valutazioni per le app LLM. Offre tracing (in pratica permette di vedere ogni passaggio, tool call, token, errore), valutazione (dataset, punteggi automatici e con l’uomo nel loop) e monitoraggio/alert (tracciare drift, regressioni). Un esempio di trace in LangSmith è mostrato sotto: 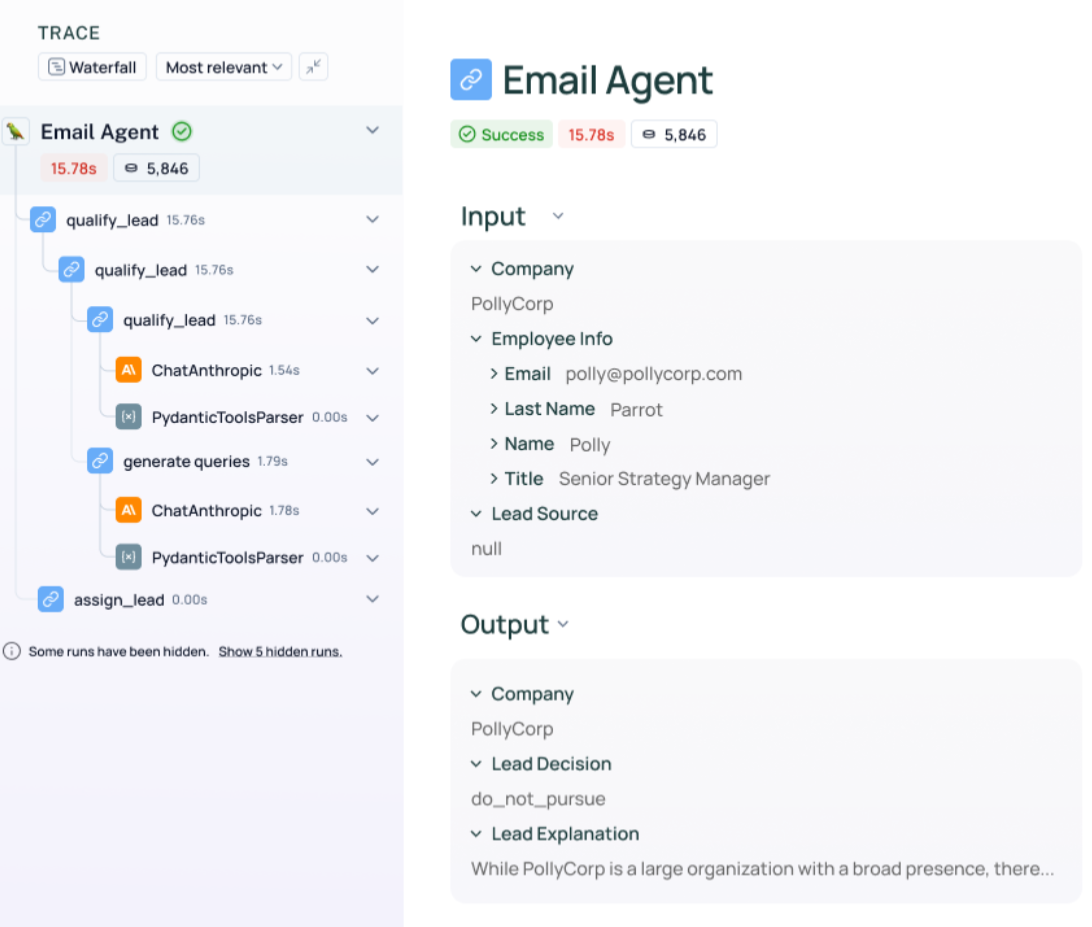
Ci sono molti motivi per cui gli sviluppatori usano LangSmith:
Per ulteriori informazioni su LangSmith, ti consiglio vivamente questa introduzione a LangSmith e il tutorial LangSmith Agent Builder.
In questa sezione voglio confrontare tutte e quattro le librerie, così ti sarà chiaro cosa sono e quando usarle.
Nella tabella seguente trovi il confronto tra LangChain, LangGraph, LangSmith e LangFlow:
|
Categoria |
LangChain |
LangGraph |
LangSmith |
LangFlow |
|
Cosa sono |
Framework per creare app LLM da pezzi modulari (prompt, modelli, strumenti, memoria). |
Orchestratore per workflow complessi e con stato (ramificazioni, loop, persistenza) basato su LangChain. |
Piattaforma di osservabilità, valutazione e test agnostica rispetto al framework per app LLM. |
Editor visuale drag‑and‑drop per progettare e prototipare flussi. |
|
Componenti principali |
Chain, Runnable, LCEL |
Nodi, archi, stato, router, checkpoint, tool |
Trace, run, dataset, evaluator, progetti |
Canvas con componenti (loader, LLM, retriever, tool) + connessioni |
|
Struttura del workflow |
Lineare o DAG, per lo più forward‑only |
Grafo completo con cicli, ramificazioni, loop, pause |
Non è un framework di esecuzione; avvolge le run per logging & valutazione |
Grafo visuale, esportabile in codice LangChain |
|
Gestione dello stato |
Implicita o locale al componente |
Stato centrale ed esplicito che attraversa i nodi; supporta persistenza & checkpoint (es. memoria chat). |
Memorizza metadati delle run, input/output, metriche, feedback |
Configurazioni dei componenti salvate nel flow JSON |
|
Control flow |
Primitive limitate per ramificazioni/retry |
Supporto di prima classe per condizionali, retry, human‑in‑the‑loop |
Nessuno (focus su valutazione, non esecuzione) |
Ramificazione visuale; le semantiche dipendono dal backend esportato |
|
Facilità d’uso |
API semplici |
Curva di apprendimento più ripida |
Molto facile da abilitare (variabili d’ambiente) |
Il più semplice per iniziare visivamente; adatto a team & non programmatori |
|
Ideale per |
Prototipazione, logica lineare, app rapide |
App resilienti, complesse, di lunga durata o multi‑agente |
Osservabilità, debugging, test di regressione, valutazioni A/B |
Prototipazione visuale, review con stakeholder ed export in codice LangChain |
Ora abbiamo trattato e confrontato queste 4 librerie in buona profondità, ma ovviamente c’è molto altro da imparare per diventare un AI Engineer avanzato con queste librerie. Perciò consiglio vivamente corsi come RAG Systems with LangChain e building Agentic Systems with LangChain.
I migliori corsi DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



