LangChain vs LangGraph vs LangSmith vs LangFlow : les principales différences expliquées
Comparez LangChain, LangGraph, LangSmith et LangFlow. Découvrez leurs rôles, leurs atouts et quand utiliser chacun pour créer des applications d’IA prêtes pour la production.
Cet article propose une comparaison formelle, point par point, de LangChain et LangGraph, ainsi que la place de LangSmith et LangFlow. Nous nous appuierons sur des notions abordées dans d’autres articles DataCamp et verrons quand choisir chaque framework pour déployer des systèmes agentiques d’IA prêts pour la production. Si vous cherchez une prise en main pratique de LangChain, je vous recommande le cours Developing LLM Applications with LangChain.
TL;DR
Avant d’entrer dans le détail, voici un aperçu rapide de la complémentarité entre LangChain, LangGraph, LangSmith et LangFlow, et dans quels cas privilégier chacun.
LangChain : la base pour créer des workflows LLM modulaires (prompts, outils, mémoire, retrievers) via des API simples comme LCEL. Idéal pour le prototypage et les applications linéaires.
LangGraph : l’orchestrateur pour gérer des workflows complexes, avec état, branches, boucles, relances et persistance. Parfait pour des systèmes multi‑agents résilients, prêts pour la production.
LangSmith : l’observateur, pour le traçage, l’évaluation et le monitoring des apps LLM, indépendant du framework. Idéal pour le débogage, les tests de régression et le suivi qualité.
LangFlow : l’éditeur visuel, avec interface glisser‑déposer pour prototyper rapidement et exporter en code. Idéal pour les équipes, ateliers et non‑codeurs.
Heuristique rapide : commencez avec LangChain, passez à LangGraph à mesure que les workflows se complexifient, ajoutez LangSmith pour l’observabilité, utilisez LangFlow quand vous avez besoin d’itérer vite ou de collaborer.
Introduction à LangChain et LangGraph
Les grands modèles de langage (LLM) excellent sur un prompt unique. C’est largement admis, tant nous utilisons ces modèles au quotidien.
Mais des applications réelles ont besoin de workflows : récupérer des données, raisonner, appeler des outils, poser une relance, retenter en cas d’échec, et parfois se mettre en pause pour un humain. Deux frameworks reviennent donc sans cesse : LangChain et LangGraph. Ils cohabitent dans le même écosystème et travaillent souvent ensemble, mais ils résolvent des parties différentes du problème :
LangChain nous aide à construire les étapes
LangGraph nous aide à les orchestrer quand les choses se compliquent.
Côté écosystème, nous parlerons aussi de LangSmith (observabilité/évaluation) et de LangFlow (éditeur visuel en glisser‑déposer), puisqu’ils en font également partie.
Brève histoire de l’écosystème LangChain (2022–2025)
Commençons par un peu d’histoire : LangChain est devenu le framework de référence pour l’IA agentique. Comprendre son évolution aide à voir pourquoi LangGraph, LangSmith et LangFlow comptent.
2022 — naissance de LangChain : lancé en open source en octobre 2022 par Harrison Chase et son équipe, LangChain s’impose vite pour composer des apps LLM, fédérant une communauté et de nombreuses intégrations.
2023 — de la popularité à la plateforme : formalisation des abstractions clés et ajout de LCEL (LangChain Expression Language) pour des compositions en « pipeline ». Déploiement des chains en production via API avec LangServe. Levée de fonds pour accélérer l’écosystème.
2023–2024 — l’observabilité arrive avec LangSmith : mi‑2023 puis en disponibilité générale début 2024, LangSmith introduit un traçage, une évaluation et un monitoring unifiés pour que les équipes puissent déboguer et tester chains/agents et suivre la qualité dans le temps.
2024 — orchestration avec LangGraph : pour des apps longues et multi‑étapes/agents, LangGraph apporte un runtime en graphe avec état explicite, routeurs/branches, boucles, retries et checkpointers pour la persistance. Une brique clé qui pose les bases d’agents pérennes et prêts pour la production. Les mises à jour suivantes élargissent la personnalisation et les intégrations avec divers fournisseurs de LLM, dont Ollama (modèles open source).
2024–2025 — conception visuelle avec LangFlow. L’éditeur visuel LangFlow évolue rapidement (versions majeures fin 2024 et Launch Week en 2025), permettant de glisser‑déposer des composants LLM, d’itérer vite et d’exporter les flows en code. Un cap important, car il ouvre aussi la porte aux non‑codeurs pour créer des agents d’IA robustes.
2025 — vers des plateformes d’agents managées. LangChain annonce des jalons majeurs : une Functional API pour LangGraph, des modèles d’agents prêts à l’emploi et une LangGraph Platform pour déployer et gérer des agents avec état à l’échelle. Un tournant qui permet aux développeurs d’exploiter des agents fiables en production.
Introduction rapide à LangChain et LangGraph
Plongeons maintenant au cœur de l’écosystème, avec LangChain et LangGraph.
LangChain est un framework modulaire pour construire des applications alimentées par des LLM. Il fournit des briques — prompts, modèles, mémoire, outils, retrievers — et une manière simple de les chaîner en pipeline via ses API Runnable/LCEL (nous y revenons). Je le vois comme un kit de briques Lego pour les motifs LLM courants : RAG, questions‑réponses, chatbots et agents utilisant des outils.
LangGraph est une couche d’orchestration orientée graphe plus récente, bâtie sur des composants LangChain. Au lieu d’une suite d’étapes en ligne droite, l’app est modélisée en nœuds (actions) et arêtes (transitions), avec un objet d’état explicite qui circule dans le graphe. Nous détaillerons cela, mais retenez que ce design facilite les branches (chemins alternatifs), les boucles (poser des questions de clarification jusqu’à confiance), les retries (sur erreurs d’outil/modèle) et les pauses pour revue humaine : exactement ce qu’il faut pour des agents endurants, de niveau production.
Vous pouvez vous demander :
« Pourquoi les comparer ? »
Parce que, bien qu’ils partagent des composants, ils ciblent des niveaux de complexité différents :
LangChain excelle sur des workflows rapides et linéaires. Exemple : Charger un PDF → découper → embarquer → retrouver → répondre. Prototypable en quelques minutes.
LangGraph brille quand la logique doit s’adapter. Exemple : si confiance < 0,7 → poser une clarification (boucle) ; si le paiement échoue → retenter avec backoff ; si la requête paraît risquée → pause pour validation humaine. Ces comportements sont natifs dans un graphe.
En pratique, de nombreux développeurs démarrent avec LangChain pour valider une idée, puis passent à LangGraph en ajoutant branches, gestion d’erreurs, coordination multi‑agents ou durabilité.
Qu’est‑ce que LangChain ?
Passons maintenant en détail sur LangChain, son usage et la création d’applications. Rappel : LangChain est une bibliothèque qui permet de bâtir une base pour des workflows LLM séquentiels.
LCEL
Commençons par expliquer ce qu’est LCEL. LCEL, pour LangChain Expression Language, est simplement une façon de relier des blocs avec des « tubes » (|). Chaque bloc peut être un prompt, un modèle, un retriever ou un parser. En les assemblant, on obtient une chain exécutable à l’infini, ce qui rend l’écriture de code bien plus efficace.
Voyons quelques exemples.
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
llm = ChatOpenAI(model="gpt-4o-mini")
prompt = ChatPromptTemplate.from_messages([("system","You are concise."),("human","{question}")])
chain = prompt | llm | StrOutputParser()# This is our chainprint(chain.invoke({"question":"Give me 3 focus tips."}))# making a single call
qs =[{"question": q}for q in["One tactic for RAG?","Explain LCEL in 1 line."]]print(chain.batch(qs))# many calls at oncePropulsé par
Selon moi, ce bloc montre la façon la plus simple d’utiliser LCEL. Nous créons une trame de prompt avec un message système (« you are concise ») et un emplacement pour la question humaine. Le message système sert d’instruction au LLM pour qu’il réponde/agisse d’une certaine manière. Nous relions ensuite ce template à un modèle OpenAI — GPT‑4o‑mini.
Enfin, j’ajoute un parser de sortie, qui convertit la réponse en texte brut.
Point clé : l’opérateur | assemble ces blocs en un pipeline unique.
Je souhaite aussi évoquer invoke() et batch(). Quand on appelle chain.invoke(...), le pipeline s’exécute une fois : le template insère la question, le modèle génère une réponse, le parser renvoie un texte propre.
À l’inverse, avec chain.batch(...), la même chain traite plusieurs entrées d’un coup, bien plus rapide qu’une boucle unitaire. En pratique, cela permet de passer d’un simple appel à la gestion de jeux de données complets presque sans code additionnel.
Un autre exemple :
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import StrOutputParser
stream_chain =(ChatPromptTemplate.from_template("{topic}")| ChatOpenAI(model="gpt-4o-mini")| StrOutputParser())# Simple streamfor chunk in stream_chain.stream({"topic":"Explain PID in 2 lines"}):print(chunk, end="")Propulsé par
Ce code ressemble au précédent, mais au lieu d’un appel unique, on utilise le streaming. Avec .stream(...), le modèle n’attend pas la réponse complète : il envoie des segments de texte au fil de la génération, que l’on affiche en temps réel.
À retenir : LCEL est le système « blocs et tuyaux » qui nous permet d’assembler prompts, modèles, outils et parsers et de disposer instantanément d’une chain que l’on peut exécuter, batcher ou streamer sans code supplémentaire.
Sorties structurées avec Pydantic
Les sorties structurées sont essentielles pour les agents d’IA. Plutôt qu’un long texte brouillon, l’agent renvoie des réponses dans un format clair (JSON, tableaux, listes). C’est plus simple à lire, exploiter et relier à d’autres outils.
L’un des principaux frameworks utilisés en industrie pour cela est Pydantic.
from pydantic import BaseModel, Field
from typing import List
from langchain_openai import ChatOpenAI
classTaskPlan(BaseModel):
title:str
steps: List[str]= Field(..., min_items=3, description="actionable steps")
structured = ChatOpenAI(model="gpt-4o-mini").with_structured_output(TaskPlan)
plan = structured.invoke("Plan a 20-minute deep-work session for AI Agent notes.")print(plan.model_dump())Propulsé par
Ici, la méthode .with_structured_output() est déterminante : elle indique au LLM de produire une sortie conforme au modèle Pydantic défini. En coulisses, LangChain s’assure que la réponse de l’agent est un JSON réel respectant le schéma, puis la convertit en objet Python immédiatement exploitable.
On obtient donc quelque chose comme TaskPlan(title="...", steps=["...", "...", "..."]). C’est particulièrement utile lorsque nous utilisons des outils.
Appels d’outils dans LangChain
Les outils sont importants car ils étendent les capacités du LLM à des tâches auparavant impossibles, comme chercher sur Internet.
Ce que j’apprécie le plus, c’est que LangChain (et d’autres frameworks agentiques) fournit des outils prêts à l’emploi appelés Built‑In Tools, très simples à utiliser. De plus, nous pouvons créer nos propres outils à l’aide d’un décorateur @tool, qui indique à LangChain qu’il s’agit d’une fonction spéciale.
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
@tooldefmultiply(a:int, b:int)->int:"""This tool multiplies two numbers."""return a * b
llm = ChatOpenAI(model="gpt-4o-mini")
llm_tools = llm.bind_tools([multiply])# exposing the tools to the model
resp = llm_tools.invoke("What is 9*5? If needed, use a tool.")print(resp.tool_calls or resp.content)# model may emit a tool call with argumentsPropulsé par
Dans cet exemple, je crée un outil très simple, qui prend deux nombres et renvoie leur produit. Pour donner au modèle (ici GPT‑4o‑mini) l’accès à ces outils, on utilise llm.bind_tools() en lui passant la liste des outils, ce qui expose les outils au modèle.
Mémoire conversationnelle
La mémoire est également cruciale pour construire des agents d’IA. Des agents avec mémoire peuvent se souvenir d’échanges passés : ce qui a été demandé, des préférences, ce qui a fonctionné ou non. Sans mémoire, chaque interaction ressemble à une première rencontre — il faut répéter le contexte à l’infini, ce qui est pénible.
Dans LangChain, la mémoire consiste à stocker des messages ou faits passés (mémoire, base de données, ou vector store). Lorsqu’un agent tourne à nouveau, il peut réinjecter cette mémoire pour des réponses plus cohérentes et pertinentes.
Deux grands types existent : mémoire court terme (messages récents dans la même conversation) et mémoire long terme (faits/préférences retenus sur plusieurs sessions). Une session est une conversation ou fenêtre d’interaction unique, durant laquelle l’agent suit ce qui a été dit jusqu’à sa fin.
La court terme préserve le contexte pendant l’échange, la long terme rend l’agent plus personnel et utile au fil du temps.
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_core.chat_history import InMemoryChatMessageHistory
prompt = ChatPromptTemplate.from_messages([("system","Be brief"),
MessagesPlaceholder(variable_name="history"),("human","{input}")])
chain = prompt | ChatOpenAI(model="gpt-4o")
store ={}# session_id -> historydefget_history(session_id:str):if session_id notin store:
store[session_id]= InMemoryChatMessageHistory()return store[session_id]
with_history = RunnableWithMessageHistory(
chain,lambda cfg: get_history(cfg["configurable"]["session_id"]),
input_messages_key="input",
history_messages_key="history",)
cfg ={"configurable":{"session_id":"u1"}}print(with_history.invoke({"input":"My name is Vaibhav."}, config=cfg))print(with_history.invoke({"input":"What is my name?"}, config=cfg))Propulsé par
Ici, la chain de chat peut se souvenir des messages d’une session. Le prompt contient un placeholder d’historique, et RunnableWithMessageHistory l’alimente automatiquement avec la bonne conversation. Le store conserve les historiques pour différentes sessions.
Attention : la mémoire doit être utilisée avec discernement. Il faut décider ce qui mérite d’être gardé, quand le stocker, et combien en réinjecter dans le prompt. Trop de mémoire peut ralentir ou dépasser des limites, mais le bon équilibre rend nos agents bien plus utiles.
Qu’est‑ce que LangGraph ?
Passons maintenant à l’autre framework agentique : LangGraph.
Pour l’expliquer simplement, utilisons une analogie : le schéma‑bloc avec sac à dos.
Imaginez LangGraph comme un petit schéma de flux pour votre app d’IA. Chaque boîte (nœud) est une petite fonction Python qui fait une tâche. Les flèches (arêtes) indiquent la suite. Un petit sac à dos de données (l’« état ») circule dans le schéma, chaque nœud peut le lire et l’enrichir. Par exemple, dans un chat, le sac à dos est souvent la liste des messages.
Graphe fondamental
Cela sera plus parlant avec un exemple :
pip install langgraph langchain-openaiPropulsé par
from typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage
# This is the backpack that moves through the graph.classState(TypedDict):# To add messages to the state
messages: Annotated[List, add_messages]
llm = ChatOpenAI(model="gpt-4o")# This is a node that asks the model and adds the reply to the backpack.defmodel_node(state: State):
reply = llm.invoke(state["messages"])return{"messages":[reply]}# Building the graph
graph = StateGraph(State)
graph.add_node("model", model_node)
graph.add_edge(START,"model")
graph.add_edge("model", END)# Building and running once
app = graph.compile()
result = app.invoke({"messages":[HumanMessage(content="Explain LangGraph in one sentence.")]})print(result["messages"][-1].content)Propulsé par
Parcourons ce code. Nous bâtissons l’app LangGraph la plus simple possible. L’état est comme un sac à dos qui transporte les messages. Nous le définissons avec State, pour indiquer à LangGraph de maintenir une liste de messages de chat.
Vient ensuite le nœud, ici une fonction unique model_node, qui regarde dans le sac à dos, envoie les messages au LLM et renvoie la réponse. LangGraph ajoute ensuite automatiquement cette réponse au sac à dos.
Le graphe est un mini schéma : START → model → END. En le compilant, LangGraph transforme ce « dessin » en app exécutable.
Enfin, nous lançons l’app (le graphe compilé) avec un sac à dos contenant déjà un message humain.
Pour visualiser, on peut exécuter :
from IPython.display import Image, display
display(Image(app.get_graph().draw_mermaid_png()))Propulsé par
Attention : ce n’est pas parce qu’une visualisation est produite que le graphe s’exécutera ! Des erreurs logiques peuvent subsister et doivent être corrigées.
Graphe avec branchement
Passons au branchement, un composant important (et simple) de tout système agentique robuste. Il donne à nos agents la liberté de choisir, en le faisant évoluer d’un workflow à un système agentique.
Regardons le code :
from typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, AIMessage
# Defining the stateclassState(TypedDict):
messages: Annotated[List, add_messages]
llm = ChatOpenAI(model="gpt-4o-mini")defanswer_node(state: State):# Normal answer using the whole chat history.return{"messages":[llm.invoke(state["messages"])]}defclarify_node(state: State):# LLm asking for a short follow-up to get enough detail (clarifying)return{"messages":[AIMessage(content="Could you share a bit more so I can be precise?")]}# Router functiondefroute(state: State):# Look for the latest human message and count words.
last_human =next((m for m inreversed(state["messages"])if m.type=="human"),None)ifnot last_human:return"clarify"
words =len(str(last_human.content).split())return"answer"if words >=3else"clarify"
graph = StateGraph(State)
graph.add_node("answer", answer_node)
graph.add_node("clarify", clarify_node)# Adding a conditional edge to connect the router function
graph.add_conditional_edges(START, route,{"answer":"answer","clarify":"clarify"})
graph.add_edge("answer", END)
graph.add_edge("clarify", END)
app = graph.compile()# Compiling the graphPropulsé par
L’essentiel est similaire au premier agent, sauf l’arête conditionnelle. Elle permet de définir des routes potentielles selon la décision du LLM. Visuellement, le système ressemble à ceci :
Avec la puissance des arêtes conditionnelles, on peut déjà construire des systèmes agentiques solides. Pour un tutoriel plus complet, je vous conseille ma vidéo sur LangGraph.
Récemment, une nouveauté est arrivée : LangGraph Studio, et je vous recommande vivement ce guide LangGraph Studio.
Qu’est‑ce que LangFlow ?
Même si LangChain et LangGraph sont les deux bibliothèques les plus utilisées de la « famille Lang », il vaut la peine d’évoquer LangFlow.
Pensez à LangFlow comme une toile en glisser‑déposer pour apps LLM. Chaque nœud = une étape (prompt, modèle, outil, retriever, base vectorielle, opération fichier, etc.). On relie les nœuds en un flow, puis on l’exécute, l’exporte ou le déploie. Idéal pour itérer vite et collaborer avec des non‑codeurs, ou transformer une idée en agent opérationnel rapidement.
Certes, ce n’est pas aussi avancé que LangGraph et LangChain pour la construction d’agents, mais il existe de bonnes raisons de l’utiliser :
Éditeur visuel pour esquisser des flows rapidement
Permettre aux non‑codeurs de créer des systèmes agentiques
Fonctionne partout : web, et désormais LangFlow Desktop pour le local
Export/import des flows en JSON et exposition en API
Parfait pour l’enseignement, les ateliers et les prototypes rapides sans code lourd
Export en code : passage de relais aux ingénieurs une fois stabilisé.
Si vous êtes non‑codeur, utilisez LangFlow pour explorer des architectures (variantes de RAG, usage d’outils, etc.), comparer rapidement et communiquer visuellement des designs aux parties prenantes.
Pour en savoir plus et réaliser un projet (par exemple un tuteur), je vous recommande vivement ce guide LangFlow avec projet démo.
Qu’est‑ce que LangSmith ?
Dernière bibliothèque : LangSmith. LangSmith est la couche d’observabilité + évaluation des apps LLM. Elle apporte le traçage (voir chaque étape, appel d’outil, token, erreur), l’évaluation (datasets, scoring automatisé et humain) et le monitoring/alertes (suivre la dérive, les régressions). Un exemple de trace LangSmith est visible ci‑dessous :
Pourquoi utiliser LangSmith :
Tracer de bout en bout des chains/agents complexes (entrées, sorties, latences, erreurs)
Évaluer les changements en sécurité via datasets + évaluateurs automatiques/humains
Surveiller le trafic live, détecter les régressions, comparer des versions
Plug‑and‑play avec LangChain/LangGraph
Indépendant du framework, LangSmith s’emploie avec LangChain, LangGraph ou d’autres piles.
Utilisable dans tout stack de langage : JavaScript, TypeScript, Python
Canvas avec composants (loaders, LLM, retrievers, outils) + connexions
Structure de workflow
Linéaire ou DAG, majoritairement en avant
Graphe complet avec cycles, branches, boucles, pauses
Pas un framework d’exécution ; encapsule les runs pour logs & évaluation
Graphe visuel, exportable en code LangChain
Gestion de l’état
Implicite ou locale au composant
État central et explicite entre nœuds ; supporte persistance & checkpointing (p.ex. mémoire de chat).
Stocke métadonnées de run, entrées/sorties, métriques, feedback
Configurations de composants sauvegardées dans un flow JSON
Contrôle de flux
Branchement/retry limités
Prise en charge native des conditionnels, retries, humain‑dans‑la‑boucle
Aucun (focus sur l’évaluation, pas l’exécution)
Branchement visuel ; sémantique selon le backend exporté
Prise en main
APIs simples
Courbe d’apprentissage plus raide
Très facile à activer (variables d’env.)
La plus facile visuellement ; adapté aux équipes & non‑codeurs
Idéal pour
Prototypage, logique linéaire, apps rapides
Apps résilientes, complexes, longues ou multi‑agents
Observabilité, débogage, tests de régression, évaluations A/B
Prototypage visuel, revues avec parties prenantes, export vers code LangChain
Conclusion
Nous avons couvert et comparé ces 4 bibliothèques en profondeur, mais il reste beaucoup à apprendre pour devenir un(e) ingénieur(e) IA avancé(e) avec ces outils. Je recommande vivement des cours comme RAG Systems with LangChain et building Agentic Systems with LangChain.
FAQ : LangChain vs LangGraph
Quelle est la principale différence entre LangChain et LangGraph ?⌄
LangChain est idéal pour des workflows linéaires simples, tandis que LangGraph est une couche orientée graphe pour des flux complexes, avec état, ramification/boucles et un contrôle robuste.
Ai-je besoin de LangChain pour utiliser LangGraph ?⌄
LangGraph s’appuie sur l’écosystème LangChain (modèles, outils, mémoire). En pratique, on les utilise souvent ensemble, LangGraph prenant en charge l’orchestration.
Quand devrais-je ajouter LangSmith ?⌄
Dès que l’on dépasse les expériences rapides. LangSmith offre traçage, débogage, évaluation et analytics, pour les chains comme pour les graphs.
LangFlow est-il obligatoire ?⌄
Non, c’est optionnel, mais utile pour le prototypage visuel et la formation, ou pour les non-codeurs.
Lequel est le plus adapté aux systèmes multi‑agents ?⌄
LangGraph. Sa gestion de l’état et du contrôle de flux facilite grandement la coordination multi‑agents et les stratégies de reprise, même si la courbe d’apprentissage est plus marquée.
Découvrez les principaux types d'agents d'intelligence artificielle, comment ils interagissent avec les environnements et comment ils sont utilisés dans les différents secteurs d'activité. Comprendre les agents réflexes simples, les agents basés sur un modèle, les agents basés sur un but, les agents basés sur l'utilité, les agents d'apprentissage, etc.
Apprenez l'essentiel de l'architecture d'un entrepôt de données, des composants clés aux meilleures pratiques, pour construire un système de données évolutif et efficace !
L'essor du développement de l'intelligence artificielle (IA) a entraîné une augmentation notable de la demande en matière de calcul, d'où la nécessité de disposer de solutions matérielles robustes. Les unités de traitement graphique (GPU) et les unités de traitement tensoriel (TPU) sont devenues des technologies essentielles pour répondre à ces demandes.
Découvrez les principales différences, les applications et la mise en œuvre de la normalisation et de la standardisation dans le prétraitement des données pour l’apprentissage automatique.
Découvrez le match-case de Python : un guide sur sa syntaxe, ses applications en data science, ML, et une analyse comparative avec le switch-case traditionnel.










Cet article propose une comparaison formelle, point par point, de LangChain et LangGraph, ainsi que la place de LangSmith et LangFlow. Nous nous appuierons sur des notions abordées dans d’autres articles DataCamp et verrons quand choisir chaque framework pour déployer des systèmes agentiques d’IA prêts pour la production. Si vous cherchez une prise en main pratique de LangChain, je vous recommande le cours Developing LLM Applications with LangChain.
TL;DR
Avant d’entrer dans le détail, voici un aperçu rapide de la complémentarité entre LangChain, LangGraph, LangSmith et LangFlow, et dans quels cas privilégier chacun.
Heuristique rapide : commencez avec LangChain, passez à LangGraph à mesure que les workflows se complexifient, ajoutez LangSmith pour l’observabilité, utilisez LangFlow quand vous avez besoin d’itérer vite ou de collaborer.
Introduction à LangChain et LangGraph
Les grands modèles de langage (LLM) excellent sur un prompt unique. C’est largement admis, tant nous utilisons ces modèles au quotidien.
Mais des applications réelles ont besoin de workflows : récupérer des données, raisonner, appeler des outils, poser une relance, retenter en cas d’échec, et parfois se mettre en pause pour un humain. Deux frameworks reviennent donc sans cesse : LangChain et LangGraph. Ils cohabitent dans le même écosystème et travaillent souvent ensemble, mais ils résolvent des parties différentes du problème :
Côté écosystème, nous parlerons aussi de LangSmith (observabilité/évaluation) et de LangFlow (éditeur visuel en glisser‑déposer), puisqu’ils en font également partie.
Brève histoire de l’écosystème LangChain (2022–2025)
Commençons par un peu d’histoire : LangChain est devenu le framework de référence pour l’IA agentique. Comprendre son évolution aide à voir pourquoi LangGraph, LangSmith et LangFlow comptent.
Introduction rapide à LangChain et LangGraph
Plongeons maintenant au cœur de l’écosystème, avec LangChain et LangGraph.
LangChain est un framework modulaire pour construire des applications alimentées par des LLM. Il fournit des briques — prompts, modèles, mémoire, outils, retrievers — et une manière simple de les chaîner en pipeline via ses API Runnable/LCEL (nous y revenons). Je le vois comme un kit de briques Lego pour les motifs LLM courants : RAG, questions‑réponses, chatbots et agents utilisant des outils.
LangGraph est une couche d’orchestration orientée graphe plus récente, bâtie sur des composants LangChain. Au lieu d’une suite d’étapes en ligne droite, l’app est modélisée en nœuds (actions) et arêtes (transitions), avec un objet d’état explicite qui circule dans le graphe. Nous détaillerons cela, mais retenez que ce design facilite les branches (chemins alternatifs), les boucles (poser des questions de clarification jusqu’à confiance), les retries (sur erreurs d’outil/modèle) et les pauses pour revue humaine : exactement ce qu’il faut pour des agents endurants, de niveau production.
Vous pouvez vous demander :
« Pourquoi les comparer ? »
Parce que, bien qu’ils partagent des composants, ils ciblent des niveaux de complexité différents :
En pratique, de nombreux développeurs démarrent avec LangChain pour valider une idée, puis passent à LangGraph en ajoutant branches, gestion d’erreurs, coordination multi‑agents ou durabilité.
Qu’est‑ce que LangChain ?
Passons maintenant en détail sur LangChain, son usage et la création d’applications. Rappel : LangChain est une bibliothèque qui permet de bâtir une base pour des workflows LLM séquentiels.
LCEL
Commençons par expliquer ce qu’est LCEL. LCEL, pour LangChain Expression Language, est simplement une façon de relier des blocs avec des « tubes » (|). Chaque bloc peut être un prompt, un modèle, un retriever ou un parser. En les assemblant, on obtient une chain exécutable à l’infini, ce qui rend l’écriture de code bien plus efficace.
Voyons quelques exemples.
Selon moi, ce bloc montre la façon la plus simple d’utiliser LCEL. Nous créons une trame de prompt avec un message système (« you are concise ») et un emplacement pour la question humaine. Le message système sert d’instruction au LLM pour qu’il réponde/agisse d’une certaine manière. Nous relions ensuite ce template à un modèle OpenAI — GPT‑4o‑mini.
Enfin, j’ajoute un parser de sortie, qui convertit la réponse en texte brut.
Point clé : l’opérateur | assemble ces blocs en un pipeline unique.
Je souhaite aussi évoquer
invoke()etbatch(). Quand on appellechain.invoke(...), le pipeline s’exécute une fois : le template insère la question, le modèle génère une réponse, le parser renvoie un texte propre.À l’inverse, avec
chain.batch(...), la même chain traite plusieurs entrées d’un coup, bien plus rapide qu’une boucle unitaire. En pratique, cela permet de passer d’un simple appel à la gestion de jeux de données complets presque sans code additionnel.Un autre exemple :
Ce code ressemble au précédent, mais au lieu d’un appel unique, on utilise le streaming. Avec
.stream(...), le modèle n’attend pas la réponse complète : il envoie des segments de texte au fil de la génération, que l’on affiche en temps réel.À retenir : LCEL est le système « blocs et tuyaux » qui nous permet d’assembler prompts, modèles, outils et parsers et de disposer instantanément d’une chain que l’on peut exécuter, batcher ou streamer sans code supplémentaire.
Sorties structurées avec Pydantic
Les sorties structurées sont essentielles pour les agents d’IA. Plutôt qu’un long texte brouillon, l’agent renvoie des réponses dans un format clair (JSON, tableaux, listes). C’est plus simple à lire, exploiter et relier à d’autres outils.
L’un des principaux frameworks utilisés en industrie pour cela est Pydantic.
Ici, la méthode
.with_structured_output()est déterminante : elle indique au LLM de produire une sortie conforme au modèle Pydantic défini. En coulisses, LangChain s’assure que la réponse de l’agent est un JSON réel respectant le schéma, puis la convertit en objet Python immédiatement exploitable.On obtient donc quelque chose comme
TaskPlan(title="...", steps=["...", "...", "..."]). C’est particulièrement utile lorsque nous utilisons des outils.Appels d’outils dans LangChain
Les outils sont importants car ils étendent les capacités du LLM à des tâches auparavant impossibles, comme chercher sur Internet.
Ce que j’apprécie le plus, c’est que LangChain (et d’autres frameworks agentiques) fournit des outils prêts à l’emploi appelés Built‑In Tools, très simples à utiliser. De plus, nous pouvons créer nos propres outils à l’aide d’un décorateur
@tool, qui indique à LangChain qu’il s’agit d’une fonction spéciale.Dans cet exemple, je crée un outil très simple, qui prend deux nombres et renvoie leur produit. Pour donner au modèle (ici GPT‑4o‑mini) l’accès à ces outils, on utilise
llm.bind_tools()en lui passant la liste des outils, ce qui expose les outils au modèle.Mémoire conversationnelle
La mémoire est également cruciale pour construire des agents d’IA. Des agents avec mémoire peuvent se souvenir d’échanges passés : ce qui a été demandé, des préférences, ce qui a fonctionné ou non. Sans mémoire, chaque interaction ressemble à une première rencontre — il faut répéter le contexte à l’infini, ce qui est pénible.
Dans LangChain, la mémoire consiste à stocker des messages ou faits passés (mémoire, base de données, ou vector store). Lorsqu’un agent tourne à nouveau, il peut réinjecter cette mémoire pour des réponses plus cohérentes et pertinentes.
Deux grands types existent : mémoire court terme (messages récents dans la même conversation) et mémoire long terme (faits/préférences retenus sur plusieurs sessions). Une session est une conversation ou fenêtre d’interaction unique, durant laquelle l’agent suit ce qui a été dit jusqu’à sa fin.
La court terme préserve le contexte pendant l’échange, la long terme rend l’agent plus personnel et utile au fil du temps.
Ici, la chain de chat peut se souvenir des messages d’une session. Le prompt contient un placeholder d’historique, et
RunnableWithMessageHistoryl’alimente automatiquement avec la bonne conversation. Le store conserve les historiques pour différentes sessions.Attention : la mémoire doit être utilisée avec discernement. Il faut décider ce qui mérite d’être gardé, quand le stocker, et combien en réinjecter dans le prompt. Trop de mémoire peut ralentir ou dépasser des limites, mais le bon équilibre rend nos agents bien plus utiles.
Qu’est‑ce que LangGraph ?
Passons maintenant à l’autre framework agentique : LangGraph.
Pour l’expliquer simplement, utilisons une analogie : le schéma‑bloc avec sac à dos.
Imaginez LangGraph comme un petit schéma de flux pour votre app d’IA. Chaque boîte (nœud) est une petite fonction Python qui fait une tâche. Les flèches (arêtes) indiquent la suite. Un petit sac à dos de données (l’« état ») circule dans le schéma, chaque nœud peut le lire et l’enrichir. Par exemple, dans un chat, le sac à dos est souvent la liste des messages.
Graphe fondamental
Cela sera plus parlant avec un exemple :
Parcourons ce code. Nous bâtissons l’app LangGraph la plus simple possible. L’état est comme un sac à dos qui transporte les messages. Nous le définissons avec
State, pour indiquer à LangGraph de maintenir une liste de messages de chat.Vient ensuite le nœud, ici une fonction unique
model_node, qui regarde dans le sac à dos, envoie les messages au LLM et renvoie la réponse. LangGraph ajoute ensuite automatiquement cette réponse au sac à dos.Le graphe est un mini schéma :
START → model → END. En le compilant, LangGraph transforme ce « dessin » en app exécutable.Enfin, nous lançons l’app (le graphe compilé) avec un sac à dos contenant déjà un message humain.
Pour visualiser, on peut exécuter :
Attention : ce n’est pas parce qu’une visualisation est produite que le graphe s’exécutera ! Des erreurs logiques peuvent subsister et doivent être corrigées.
Graphe avec branchement
Passons au branchement, un composant important (et simple) de tout système agentique robuste. Il donne à nos agents la liberté de choisir, en le faisant évoluer d’un workflow à un système agentique.
Regardons le code :
L’essentiel est similaire au premier agent, sauf l’arête conditionnelle. Elle permet de définir des routes potentielles selon la décision du LLM. Visuellement, le système ressemble à ceci :
Avec la puissance des arêtes conditionnelles, on peut déjà construire des systèmes agentiques solides. Pour un tutoriel plus complet, je vous conseille ma vidéo sur LangGraph.
Récemment, une nouveauté est arrivée : LangGraph Studio, et je vous recommande vivement ce guide LangGraph Studio.
Qu’est‑ce que LangFlow ?
Même si LangChain et LangGraph sont les deux bibliothèques les plus utilisées de la « famille Lang », il vaut la peine d’évoquer LangFlow.
Pensez à LangFlow comme une toile en glisser‑déposer pour apps LLM. Chaque nœud = une étape (prompt, modèle, outil, retriever, base vectorielle, opération fichier, etc.). On relie les nœuds en un flow, puis on l’exécute, l’exporte ou le déploie. Idéal pour itérer vite et collaborer avec des non‑codeurs, ou transformer une idée en agent opérationnel rapidement.
Certes, ce n’est pas aussi avancé que LangGraph et LangChain pour la construction d’agents, mais il existe de bonnes raisons de l’utiliser :
Si vous êtes non‑codeur, utilisez LangFlow pour explorer des architectures (variantes de RAG, usage d’outils, etc.), comparer rapidement et communiquer visuellement des designs aux parties prenantes.
Pour en savoir plus et réaliser un projet (par exemple un tuteur), je vous recommande vivement ce guide LangFlow avec projet démo.
Qu’est‑ce que LangSmith ?
Dernière bibliothèque : LangSmith. LangSmith est la couche d’observabilité + évaluation des apps LLM. Elle apporte le traçage (voir chaque étape, appel d’outil, token, erreur), l’évaluation (datasets, scoring automatisé et humain) et le monitoring/alertes (suivre la dérive, les régressions). Un exemple de trace LangSmith est visible ci‑dessous :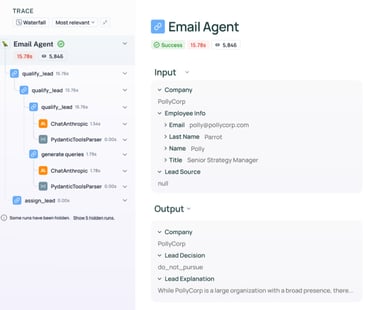
Pourquoi utiliser LangSmith :
Pour en savoir plus, lisez cette introduction à LangSmith et le tutoriel LangSmith Agent Builder.
LangChain vs LangGraph vs LangSmith vs LangFlow
Dans cette section, je compare ces quatre bibliothèques pour clarifier ce qu’elles sont et quand les utiliser.
Ce qu’elles sont
Composants principaux
Structure de workflow
Gestion de l’état
Contrôle de flux
Prise en main
Idéal pour
Quand utiliser quoi
Tableau comparatif
Le tableau ci‑dessous compare LangChain, LangGraph, LangSmith et LangFlow :
Catégorie
LangChain
LangGraph
LangSmith
LangFlow
Ce qu’ils sont
Framework pour créer des apps LLM à partir de briques modulaires (prompts, modèles, outils, mémoire).
Orchestrateur de workflows complexes et stateful (branches, boucles, persistance) au‑dessus de LangChain.
Plateforme d’observabilité, d’évaluation et de test, indépendante du framework, pour apps LLM.
Éditeur visuel en glisser‑déposer pour concevoir et prototyper des flows.
Composants principaux
Chains, Runnables, LCEL
Nœuds, arêtes, état, routeurs, checkpointers, outils
Traces, runs, datasets, évaluateurs, projets
Canvas avec composants (loaders, LLM, retrievers, outils) + connexions
Structure de workflow
Linéaire ou DAG, majoritairement en avant
Graphe complet avec cycles, branches, boucles, pauses
Pas un framework d’exécution ; encapsule les runs pour logs & évaluation
Graphe visuel, exportable en code LangChain
Gestion de l’état
Implicite ou locale au composant
État central et explicite entre nœuds ; supporte persistance & checkpointing (p.ex. mémoire de chat).
Stocke métadonnées de run, entrées/sorties, métriques, feedback
Configurations de composants sauvegardées dans un flow JSON
Contrôle de flux
Branchement/retry limités
Prise en charge native des conditionnels, retries, humain‑dans‑la‑boucle
Aucun (focus sur l’évaluation, pas l’exécution)
Branchement visuel ; sémantique selon le backend exporté
Prise en main
APIs simples
Courbe d’apprentissage plus raide
Très facile à activer (variables d’env.)
La plus facile visuellement ; adapté aux équipes & non‑codeurs
Idéal pour
Prototypage, logique linéaire, apps rapides
Apps résilientes, complexes, longues ou multi‑agents
Observabilité, débogage, tests de régression, évaluations A/B
Prototypage visuel, revues avec parties prenantes, export vers code LangChain
Conclusion
Nous avons couvert et comparé ces 4 bibliothèques en profondeur, mais il reste beaucoup à apprendre pour devenir un(e) ingénieur(e) IA avancé(e) avec ces outils. Je recommande vivement des cours comme RAG Systems with LangChain et building Agentic Systems with LangChain.