
Kurs
LangGraph ile Çoklu Aracılı Sistemler
2 sa 45 dk
8.8K
Bu makale, LangChain ve LangGraph’ın resmi, yan yana bir karşılaştırmasını ve LangSmith ile LangFlow’un bu resimde nereye oturduğunu sunar. Diğer DataCamp makalelerinde ele alınan kavramların üzerine inşa edeceğiz ve üretime hazır, ajansal yapay zeka sistemleri teslim etmek için her bir çerçeveyi ne zaman seçmeniz gerektiğini tartışacağız. LangChain’e pratik bir başlangıç arıyorsanız, Developing LLM Applications with LangChain kursunu öneririm.
Ayrıntılara girmeden önce, LangChain, LangGraph, LangSmith ve LangFlow’un nasıl bir araya geldiğine ve hangisini ne zaman seçeceğinize dair hızlı bir genel bakış.
Hızlı sezgisel kural: LangChain ile başlayın, iş akışları büyüdükçe LangGraph’a geçin, gözlemlenebilirlik için LangSmith’i ekleyin, hızlı yineleme veya işbirliği gerektiğinde LangFlow’u kullanın.
Büyük dil modelleri (LLM’ler) tekli istemlerde çok iyidir. Bunu artık sık kullandığımız için, bu neredeyse herkesin bildiği bir gerçek.
Ancak gerçek uygulamalar iş akışları gerektirir: veri çek, mantık yürüt, araç çağır, takip sorusu sor, hata durumunda yeniden dene ve bazen insan için duraklat. Bu nedenle iki çerçeveyi tekrar tekrar duyacaksınız: LangChain ve LangGraph. Aynı ekosistemde yer alırlar ve sıklıkla birlikte çalışırlar; ancak sorunun farklı kısımlarını çözerler:
Ekosistem demişken, LangSmith’i (gözlemlenebilirlik/değerlendirme görevleri için) ve LangFlow’u (sürükle-bırak görsel oluşturucu) da ele alacağız; çünkü bunlar da bu ekosistemin parçasıdır.
LangChain ekosistemiyle ilgili biraz tarihçe ile başlamak mantıklı olacaktır; ajansal yapay zeka için başvurulan çerçeve haline geldi ve buraya nasıl geldiğini bilmek, LangGraph, LangSmith ve LangFlow’un neden önemli olduğunu görmeyi kolaylaştıracaktır.
Şimdi çekirdek ekosisteme derinlemesine dalmaya, LangChain ve LangGraph ile başlayalım.
LangChain, LLM destekli uygulamalar geliştirmek için modüler bir çerçevedir. Bize yapı taşları — istemler, modeller, bellek, araçlar, alıcılar — ve bunları Runnable/LCEL API’leriyle bir boru hattında zincirlemenin basit bir yolunu sunar (bunu birazdan tartışacağız). Ben bunu, RAG, soru-cevap, sohbet botları ve araç kullanan ajanlar gibi yaygın LLM kalıpları için bir Lego parçaları kiti olarak düşünmeyi seviyorum.
LangGraph ise LangChain bileşenleri üzerine inşa edilmiş daha yeni bir grafik tabanlı orkestrasyon katmanıdır. Tek bir düz adım dizisi yerine, uygulama düğümler (yani eylemler) ve kenarlar (yani geçişler) olarak modellenir ve grafik boyunca akan açık bir durum nesnesi bulunur. Bunu daha derinlemesine tartışacağız; ancak şimdilik, bu tasarımın doğal olarak dallanmayı (farklı yollar izlemek), döngü kurmayı (emin olana dek açıklayıcı sorular sormak), yeniden denemeyi (araç/model hatalarında) ve duraklatmayı (insan incelemesi için) sağladığını unutmayın; tam da uzun süre çalışan, üretim düzeyindeki ajanlar için ihtiyaç duyduğumuz şeyler.
Burada şu soru akla gelebilir:
“Neden onları karşılaştıralım ki?”
Şöyle ki: Bileşenleri paylaşıyor olsalar da, farklı karmaşıklık seviyelerini hedeflerler:
Uygulamada, birçok geliştirici önce bir fikri doğrulamak için LangChain ile başlar, ardından dallanma, hata yönetimi, çoklu ajan koordinasyonu veya kalıcılık ekledikçe LangGraph’a yükseltir.
Şimdi LangChain’i derinlemesine ele alacak, kullanımını anlayacak ve içinde uygulamalar kodlayacağız. Tekrar belirtmek gerekirse, LangChain bize ardışık LLM iş akışları için bir temel kurma olanağı tanıyan bir kütüphanedir.
Öncelikle LCEL’in ne olduğunu açıklamak istiyorum. LCEL ya da LangChain Expression Language, blokları borular (|) ile birbirine bağlamanın bir yoludur. Her blok bir istem, bir model, bir alıcı (retriever) veya bir ayrıştırıcı olabilir. Bunları birleştirdiğimizde, tekrar tekrar çalıştırabileceğimiz bir zincir elde ederiz; bu da kod yazmayı çok daha verimli kılar.
Bazı örnekler üzerinden gidelim.
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

llm    = ChatOpenAI(model="gpt-4o-mini")
prompt = ChatPromptTemplate.from_messages([
    ("system", "You are concise."),
    ("human", "{question}")
])
chain = prompt | llm | StrOutputParser() # This is our chain

print(chain.invoke({"question": "Give me 3 focus tips."}))     # making a single call

qs = [{"question": q} for q in ["One tactic for RAG?", "Explain LCEL in 1 line."]]
print(chain.batch(qs))                                         # many calls at once
Bana göre, yukarıdaki kod hücresi LCEL’i kullanmanın en basit yolunu gösteriyor. Önce her zaman bir sistem mesajı (“you are concise”) içeren ve insan sorusu için yer bırakan bir istem şablonu oluşturduk. Sistem mesajı, LLM’e belirli bir şekilde yanıt vermesini/eylemde bulunmasını söyleyen bir talimat gibidir. Sonra bu şablonu bir OpenAI modeline — GPT-4o-mini — bağladık.
Son olarak, yanıtı düz metne dönüştüren bir çıktı ayrıştırıcı ekledim.
Şimdi en önemli kısım geliyor: | operatörü bu blokları tek bir boru hattına yapıştıran şeydir.
invoke() ve batch() hakkında da konuşmak istiyorum. chain.invoke(...) çağrısı yaptığımızda, boru hattı bir kez çalışır; yani şablon soruyu doldurur, model bir yanıt üretir ve ayrıştırıcı temiz metin döndürür.
Ancak chain.batch(...) çağrısı yaptığımızda, aynı zincir birden çok girdide aynı anda çalışır; bu da teker teker döngülemekten çok daha hızlıdır. Pratikte bu, basit bir tekli çağrıdan, neredeyse hiç ek kod yazmadan tüm veri kümelerini işleyecek bir yapıya geçmeyi kolaylaştırır.
Burada başka bir örnek daha göstermek istiyorum:
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import StrOutputParser

stream_chain = (ChatPromptTemplate.from_template("{topic}")  | ChatOpenAI(model="gpt-4o-mini")  | StrOutputParser())

# Simple stream
for chunk in stream_chain.stream({"topic": "Explain PID in 2 lines"}):
    print(chunk, end="")
Bu kod, ilkine oldukça benzer; ancak tek bir çağrı yapmak yerine akış (streaming) kullanıyoruz. .stream(...) ile model tüm yanıt hazır olana kadar beklemez. Bunun yerine,
oluşturuldukça metin parçalarını gönderir ve biz de bunları gerçek zamanlı yazdırırız.
Bu alt bölümden çıkarmanızı istediğim ana nokta, LCEL’in istemleri, modelleri, araçları ve ayrıştırıcıları birbirine geçirip bize anında zincir veren basit “borular ve bloklar” sistemi olduğu ve bu zinciri ekstra koda gerek kalmadan çalıştırabileceğimiz, toplu işleyebileceğimiz veya akışa alabileceğimiz.
Yapılandırılmış çıktılar, yapay zeka ajanlarının hayati bir bileşenidir. Ajanımızın uzun ve dağınık bir metin yerine, yanıtı JSON, tablolar veya listeler gibi net bir formatta vermesi anlamına gelir. Bu, bilgisayarların ve insanların okumasını, kullanmasını ve diğer araçlarla bağlamasını kolaylaştırır.
Sektörde bunun için kullanılan temel çerçevelerden biri Pydantic’tir.
from pydantic import BaseModel, Field
from typing import List
from langchain_openai import ChatOpenAI

class TaskPlan(BaseModel):
    title: str
    steps: List[str] = Field(..., min_items=3, description="actionable steps")

structured = ChatOpenAI(model="gpt-4o-mini").with_structured_output(TaskPlan)
plan = structured.invoke("Plan a 20-minute deep-work session for AI Agent notes.")
print(plan.model_dump())
Bu örnekte önemli kısım .with_structured_output() yöntemidir; çünkü LLM’e çıktıyı oluşturduğumuz Pydantic model biçiminde vermesini söyler. Perde arkasında, LangChain ajanımızın yanıtının biçime uyan gerçek bir JSON olmasını sağlar ve ardından bunu doğrudan kullanabileceğiniz bir Python nesnesine dönüştürür.
Yani dağınık metin yerine TaskPlan(title="...", steps=["...", "...", "..."]) gibi bir şey alırız. Bu, özellikle Araçlar kullandığımızda faydalıdır.
Araçlar önemlidir; çünkü LLM’in yetkinliğini genişleterek daha önce yapamadığı görevleri, örneğin internette arama yapmayı, gerçekleştirmesini sağlar.
Araçlar hakkında en sevdiğim şey ise LangChain’in (ve pek çok ajansal çerçevenin) kullanımı oldukça kolay Yerleşik Araçlar sağlamasıdır. Dahası, kendi araçlarımızı da oluşturabiliriz; bunu da bir dekoratör @tool kullanarak yaparız; bu, LangChain’e bu fonksiyonun özel bir tür fonksiyon olduğunu söyler.
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI

@tool
def multiply(a: int, b: int) -> int:
    """This tool multiplies two numbers."""
    return a * b

llm = ChatOpenAI(model="gpt-4o-mini")
llm_tools = llm.bind_tools([multiply])   # exposing the tools to the model

resp = llm_tools.invoke("What is 9*5? If needed, use a tool.")
print(resp.tool_calls or resp.content)   # model may emit a tool call with arguments
Yukarıdaki kod hücresinde, iki sayıyı alıp çarpımlarını döndüren çok basit bir araç oluşturduğumu görebilirsiniz. Dahili modele (bu örnekte GPT-4o-mini) bu tür araçlara erişim vermek için llm.bind_tools() yöntemini kullanır ve araç listesini geçiririz; böylece
araçları modele açmış oluruz.
Bellek, yapay zeka ajanları geliştirirken oldukça kritiktir. Belleğe sahip yapay zeka ajanları, geçmiş konuşmalardan bazı şeyleri hatırlayabilir; örneğin daha önce ne sorduğumuzu, tercihleri veya neyin işe yarayıp yaramadığını. Bellek olmadan her seferinde yepyeni biriyle tanışmak gibi olur — temel bağlamı tekrar tekrar belirtmemiz gerekir; bu da oldukça zahmetlidir.
LangChain’de bellek, geçmiş mesajların veya olguların bir depoda (bellekte, veritabanında veya vektör deposunda) saklanması anlamına gelir. Ajan yeniden çalıştığında, bu belleği çekebilir; böylece yanıtlar daha tutarlı ve akıllı olur.
İki ana tür vardır: kısa vadeli bellek (aynı sohbetteki son mesajlar) ve uzun vadeli bellek (birçok oturum boyunca hatırlanan olgular veya tercihler). Bir oturumun tek bir konuşma veya etkileşim penceresi olduğunu; ajanın kapanana kadar söylenenleri takip ettiğini unutmayın.
Kısa vadeli bellek tek bir konuşma sırasında bağlamı korurken, uzun vadeli bellek ajanı zamanla daha kişisel ve faydalı hissettirir.
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_core.chat_history import InMemoryChatMessageHistory

prompt = ChatPromptTemplate.from_messages([
    ("system", "Be brief"),
    MessagesPlaceholder(variable_name="history"),
    ("human", "{input}")
])
chain = prompt | ChatOpenAI(model="gpt-4o")

store = {}  # session_id -> history
def get_history(session_id: str):
    if session_id not in store:
        store[session_id] = InMemoryChatMessageHistory()
    return store[session_id]

with_history = RunnableWithMessageHistory(
    chain,
    lambda cfg: get_history(cfg["configurable"]["session_id"]),
    input_messages_key="input",
    history_messages_key="history",
)

cfg = {"configurable": {"session_id": "u1"}}
print(with_history.invoke({"input": "My name is Vaibhav."}, config=cfg))
print(with_history.invoke({"input": "What is my name?"}, config=cfg))
Yukarıdaki hücrede, kod önce bir oturumda geçmiş mesajları hatırlayabilen bir sohbet zinciri oluşturuyor. İstemde bir geçmiş yer tutucu var ve RunnableWithMessageHistory her seferinde doğru konuşmayı otomatik olarak dolduruyor. store ise farklı oturumların geçmişlerini tutar.
Not etmek gerekir ki belleği dikkatli kullanmalıyız. Nelerin saklanmaya değer olduğuna, ne zaman kaydedileceğine ve isteme ne kadarının geri verileceğine karar verip kodlamalıyız. Şöyle ki, fazla bellek işleri yavaşlatabilir veya limitleri aşabilir; ancak doğru denge, ajanlarımızı çok daha kullanışlı kılar.
Şimdi diğer ajansal çerçeve olan LangGraph’a geçiyoruz.
LangGraph’ı basitçe açıklamak için bir benzetme kullanacağım: Sırt Çantası Akış Şeması Benzetmesi.
LangGraph’ı, yapay zeka uygulamamız için küçük bir akış şeması olarak düşünebiliriz. Her kutu (düğüm olarak adlandırılır) tek bir işi yapan küçük bir Python fonksiyonudur. Oklar (kenarlar) sırada hangi kutunun çalışacağını söyler. Küçük bir sırt çantası veri (“durum”) akış şemasında hareket eder; böylece her düğüm onu okuyup üzerine ekleme yapabilir. Örneğin bir sohbet uygulamasında, sırt çantası genellikle mesajların devam eden listesidir.
Birlikte bir örnek üzerinden gidersek daha anlamlı olacaktır:
pip install langgraph langchain-openaifrom typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage
# This is the backpack that moves through the graph.
class State(TypedDict):
# To add messages to the state
messages: Annotated[List, add_messages]
llm = ChatOpenAI(model="gpt-4o")
# This is a node that asks the model and adds the reply to the backpack.
def model_node(state: State):
reply = llm.invoke(state["messages"])
return {"messages": [reply]}
# Building the graph
graph = StateGraph(State)
graph.add_node("model", model_node)
graph.add_edge(START, "model")
graph.add_edge("model", END)
# Building and running once
app = graph.compile()
result = app.invoke({"messages": [HumanMessage(content="Explain LangGraph in one sentence.")]} )
print(result["messages"][-1].content)Şimdi kodu adım adım inceleyelim. Burada mümkün olan en basit LangGraph uygulamasını oluşturuyoruz. Durum, grafikte mesajları taşıyan bir sırt çantası gibidir. LangGraph’a sohbet mesajlarının her zaman devam eden bir listesini tutmasını söyleyen State ile tanımlarız.
Sonra düğüm gelir; burada tek bir fonksiyondur, model_node; sırt çantasının içine bakar, mesajları LLM’e gönderir ve yanıtı döndürür. LangGraph daha sonra bu yanıtı otomatik olarak sırt çantasına ekler.
Grafiğin kendisi küçük bir akış şemasıdır: START → model → END. Derlediğimizde, LangGraph bu çizimi çalıştırılabilir bir uygulamaya dönüştürür.
Son olarak, halihazırda bir insan mesajı içeren bir sırt çantasıyla uygulamayı çalıştırırız (grafiği değil — derlenmiş grafiği).
Görsel anlayışınızı pekiştirmek için grafiği görüntülemek üzere şu kodu çalıştırabiliriz:
from IPython.display import Image, display
display(Image(app.get_graph().draw_mermaid_png()))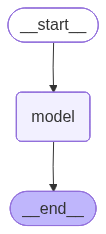
Ancak lütfen şunu unutmayın: görselleştirme üretildi diye grafik çalışacak anlamına gelmez! Önce ele alınması gereken bazı mantıksal hatalar olabilir.
Şimdi, sağlam bir Ajansal sistemin önemli (ama kolay) bir bileşeni olan dallanmaya doğru ilerleyelim. Bu, ajanlarımıza daha fazla seçim özgürlüğü verir, onu bir iş akışından ajansal bir sisteme dönüştürür.
Koda bakalım:
from typing import TypedDict, Annotated, List
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, AIMessage

# Defining the state
class State(TypedDict):
    messages: Annotated[List, add_messages]

llm = ChatOpenAI(model="gpt-4o-mini")

def answer_node(state: State):
    # Normal answer using the whole chat history.
    return {"messages": [llm.invoke(state["messages"])]}

def clarify_node(state: State):
    # LLm asking for a short follow-up to get enough detail (clarifying)
    return {"messages": [AIMessage(content="Could you share a bit more so I can be precise?")]}

# Router function
def route(state: State):
    # Look for the latest human message and count words.
    last_human = next((m for m in reversed(state["messages"]) if m.type == "human"), None)
    if not last_human:
        return "clarify"
    words = len(str(last_human.content).split())
    return "answer" if words >= 3 else "clarify"

graph = StateGraph(State)
graph.add_node("answer", answer_node)
graph.add_node("clarify", clarify_node)

# Adding a conditional edge to connect the router function
graph.add_conditional_edges(START, route, {"answer": "answer", "clarify": "clarify"})
graph.add_edge("answer", END)
graph.add_edge("clarify", END)
app = graph.compile() # Compiling the graph
Bunun büyük kısmı ilk ajana benzerdir; koşullu kenar dışında. Bu, LLM’in yargısına bağlı olarak sisteme farklı olası yollar sağlama imkânı tanır. Görsel olarak, sistem şöyle görünür:
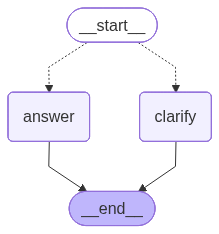
Koşullu kenarların gücüyle, mevcut bilgilerimizle oldukça sağlam ajansal sistemler kurabiliriz. Daha kapsamlı bir eğitim istiyorsanız, LangGraph video eğitimime göz atmanızı öneririm.
Yakın zamanda LangGraph’a LangGraph Studio adlı yeni bir ekleme yapıldı ve bu konuda şu LangGraph Studio rehberini şiddetle tavsiye ederim.
Her ne kadar geliştiricilerin Lang ailesinde en çok başvurduğu iki kütüphane LangChain ve LangGraph olsa da, LangFlow’dan da kısaca bahsetmeye değer olduğunu düşünüyorum.
LangFlow’u LLM uygulamaları için bir sürükle-bırak tuvali olarak düşünün. Her bir düğüm = bir adım (istem, model, araç, alıcı, vektör veritabanı, dosya işlemi vb.). Düğümleri bir akışa bağlarız; ardından çalıştırır, dışa aktarır veya dağıtırız. Hızlı yineleme için harikadır ve özellikle kod yazmayanlarla işbirliği yapmak ve fikirleri hızla çalışan ajanlara dönüştürmek için iyidir.
Evet, ajan oluşturmada LangGraph ve LangChain kadar gelişmiş değildir; ancak onu kullanmak için bazı nedenler vardır:
Kod yazmayan biri olduğunuzu varsayacağım; bu nedenle, mimari seçenekleri (RAG varyantları, araç kullanımı vb.) keşfederken hızlıca karşılaştırmak istediğinizde veya tasarımları paydaşlara görsel olarak aktarmanız gerektiğinde LangFlow kullanmalısınız.
LangFlow hakkında daha fazla bilgi edinmek ve bir Öğretmen uygulaması gibi bir proje tamamlamak için, bu demo projeli LangFlow rehberini şiddetle tavsiye ederim.
Ele almak istediğim son kütüphane LangSmith. LangSmith, LLM uygulamaları için gözlemlenebilirlik + değerlendirme katmanıdır. Bize izleme (temelde her adımı, araç çağrısını, token’ı, hatayı görmemizi sağlar), değerlendirme (veri kümeleri, otomatik ve insan döngülü puanlama) ve izleme/uyarılar (sapmaları, gerilemeleri takip) sunar. LangSmith’te bir izlemenin nasıl göründüğüne aşağıda bir örnek görebilirsiniz: 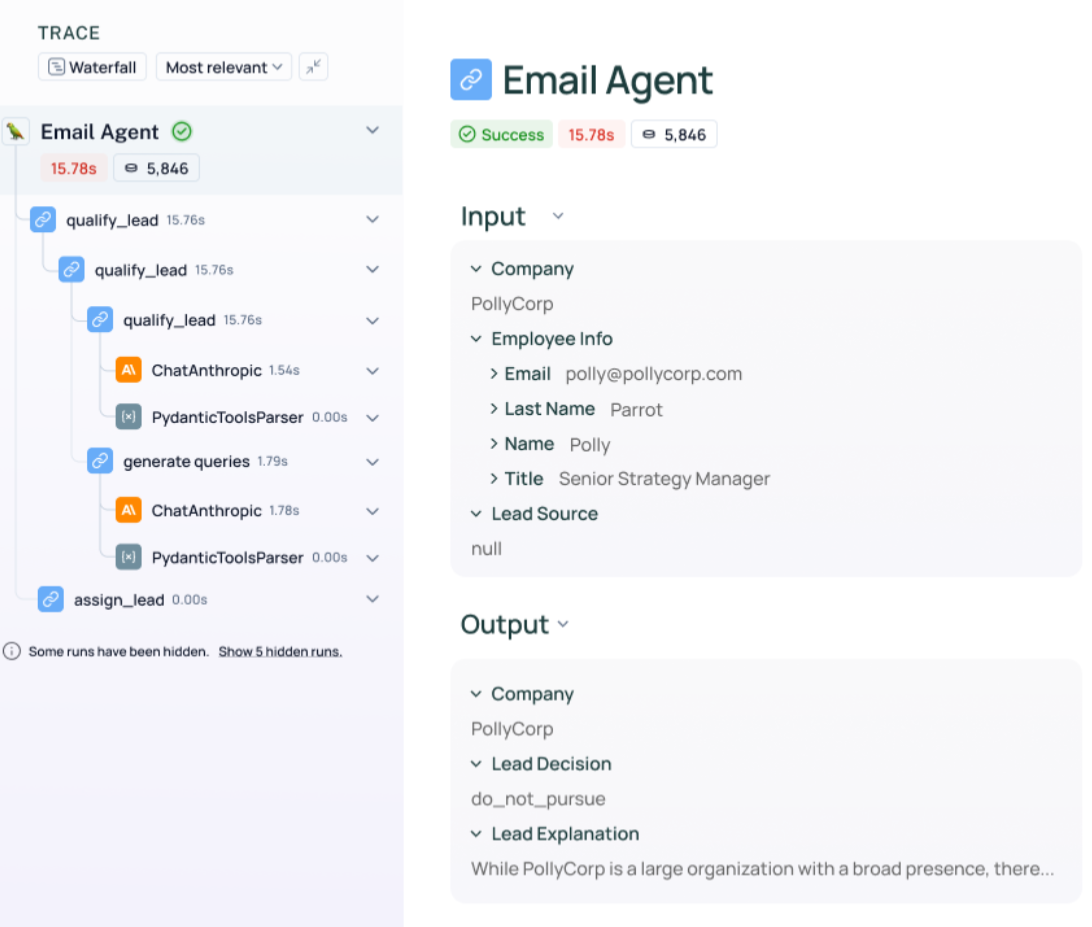
Geliştiricilerin LangSmith’i kullanması için pek çok neden vardır:
LangSmith hakkında daha fazla bilgi için, bu detaylı LangSmith’e giriş ve LangSmith Agent Builder eğitimini şiddetle tavsiye ederim.
Bu bölümde, bu dört kütüphaneyi karşılaştırarak ne oldukları ve ne zaman kullanılacakları konusunda tamamen net olmanızı istiyorum.
Aşağıdaki tabloda LangChain, LangGraph, LangSmith ve LangFlow karşılaştırmasını bulabilirsiniz:
|
Kategori |
LangChain |
LangGraph |
LangSmith |
LangFlow |
|
Nedirler |
Modüler parçalardan (istemler, modeller, araçlar, bellek) LLM uygulamaları geliştirme çerçevesi. |
LangChain üzerinde karmaşık, durumsal iş akışları (dallanma, döngü, kalıcılık) için orkestratör. |
Çerçeveden bağımsız gözlemlenebilirlik, değerlendirme ve test platformu. |
Akış tasarlamak ve prototiplemek için görsel sürükle-bırak düzenleyici. |
|
Birincil bileşenler |
Zincirler, Runnables, LCEL |
Düğümler, kenarlar, durum, yönlendiriciler, denetleyiciler, araçlar |
İzler, çalıştırmalar, veri kümeleri, değerlendiriciler, projeler |
Bileşenli tuval (yükleyiciler, LLM’ler, alıcılar, araçlar) + bağlantılar |
|
İş akışı yapısı |
Doğrusal veya DAG, çoğunlukla ileri yönlü |
Döngüler, dallanma, yineleme, duraklamalarla tam grafik |
Bir yürütme çerçevesi değil; günlükleme ve değerlendirme için çalıştırmaları sarar |
Görsel grafik, LangChain koduna aktarılabilir |
|
Durum yönetimi |
Örtük veya bileşene özgü |
Düğümler boyunca işlenen merkezi, açık durum; kalıcılık ve denetim noktası alma (örn. sohbet belleği) desteği. |
Çalıştırma meta verilerini, girdileri/çıktıları, metrikleri, geri bildirimleri saklar |
Bileşen yapılandırmaları JSON akışında saklanır |
|
Kontrol akışı |
Sınırlı dallanma/yeniden deneme ilkeleri |
Koşullar, yeniden denemeler ve insan döngüsü için birinci sınıf destek |
Yok (odak değerlendirmede, yürütmede değil) |
Görsel dallanma; anlambilim dışa aktarılan arka uca bağlı |
|
Kullanım kolaylığı |
Basit API’ler |
Daha dik öğrenme eğrisi |
Etkinleştirmesi çok kolay (ortam değişkenleri) |
Görsel olarak başlaması en kolay; atölyeler ve kod yazmayanlar için ekip dostu |
|
En uygun |
Prototipleme, doğrusal mantık, hızlı uygulamalar |
Dayanıklı, karmaşık, uzun soluklu veya çoklu ajan uygulamaları |
Gözlemlenebilirlik, hata ayıklama, regresyon testleri, A/B değerlendirmeleri |
Görsel prototipleme, paydaş incelemeleri ve LangChain koduna aktarma |
Şimdi bu 4 kütüphaneyi oldukça derinlemesine ele alıp karşılaştırdık; ancak bu kütüphanelerle ileri düzey bir Yapay Zeka Mühendisi olmak için öğrenecek çok şey var. Bu nedenle, LangChain ile RAG Sistemleri ve LangChain ile Ajansal Sistemler Kurma gibi kursları şiddetle tavsiye ederim.
En Popüler DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




