

LangGraph Temelleri
LangGraph’ın temel yapı taşlarını ele alarak başlayalım. Bu öğeler, gelişmiş yapay zeka ajanları için yapılandırılmış, durumlu ve ölçeklenebilir iş akışları kurmamıza olanak tanır.
Durum (State)
Durum, grafik boyunca akan paylaşılan bir bellek nesnesidir. Mesajlar, değişkenler, ara sonuçlar ve karar geçmişi gibi tüm ilgili bilgileri saklar. LangGraph, durumu otomatik olarak yönetir ve geliştirmeyi daha verimli hale getirir.
Durumu tamamlamak için kontrol noktası alma (checkpointing), iş parçacığına özgü bellek ve oturumlar arası kalıcılık gibi daha gelişmiş destekleyici özellikler vardır. Çalıştırma boyunca durum sürekli olarak güncellenir; aşağıdaki diyagramda gösterildiği gibi: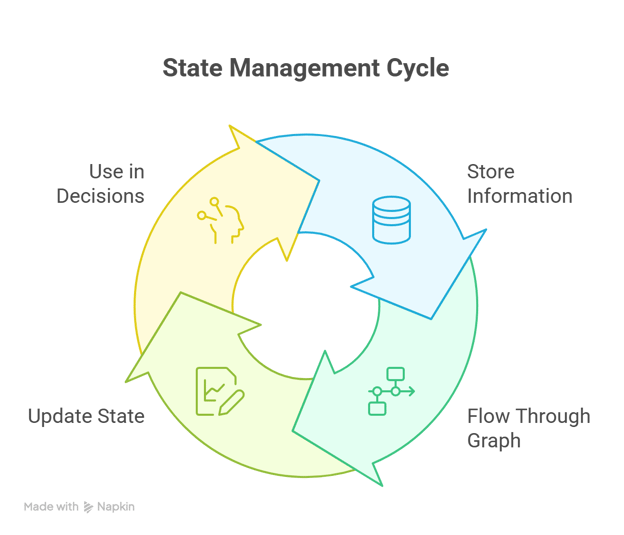
LangGraph’ta düğümler arasında sürekli güncellemeleri gösteren durum yönetimi döngüsü
Düğüm (Node)
Bir düğüm, iş akışındaki tek bir işlevsel birimdir. Şu tür eylemleri gerçekleştirebilir:
- Büyük dil modelini (LLM) çağırma
- Bir aracı veya API’yi çağırma
- Özel bir Python fonksiyonu çalıştırma
- Yönlendirme mantığı veya dallanma kararları
Her düğüm, mevcut durumu alır ve güncellenmiş bir durum döndürür.
Kenarlar ve koşullu kenarlar
Kenarlar, düğümler arasındaki geçişleri tanımlar. Grafiğin kontrol akışını belirler ve şunları destekleyebilir:
- Statik bağlantılar (doğrusal ilerleme için)
- Döngüsel yollar (yinelemeli davranışlar için)
- Dinamik dallanma (durum koşullarına göre - Koşullu Kenarlar ile oluşturulur)
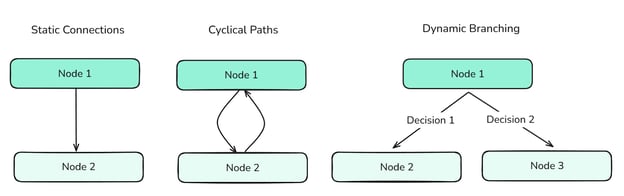
Farklı Kenar türleri, düğümler arasındaki akışı tanımlar ve grafikteki bilgi akışını kontrol eder.
Karmaşık ajan davranışlarını düzenlemek için kenarlar kritik öneme sahiptir.
Graf ve stategraph
LangGraph’taki bir grafik, ajansal iş akışının yapısını tanımlar ve kenarlarla birbirine bağlanan düğümlerden oluşur.
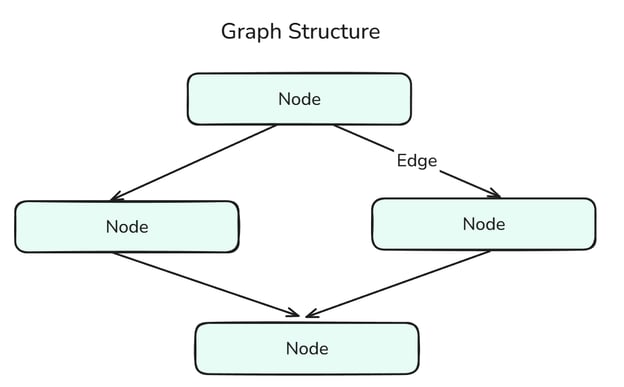
Graf Yapısı, Düğümler ve Kenarların birleşimidir.
StateGraph, yürütme boyunca paylaşılan bir durumu koruyan ve güncelleyen özel bir grafiktir. Adımlar arasında bağlama duyarlı karar verme ve kalıcı bellek sağlar. Bunu State ve Graph’ın birleşimi olarak düşünebiliriz.
Araç ve toolnode
Bir araç, bir ajanın çağırabileceği harici veya dahili herhangi bir fonksiyondur; örneğin web araması, hesap makinesi veya özel yardımcı program. İki tür Araç vardır:
- Yerleşik Araçlar: Langchain tarafından önceden hazırlanmış ve kullanıma hazır araçlardır; Dokümantasyon üzerinden erişilebilir.
- Özel Araçlar: Uygulamamızda kendimizin oluşturup kullanabileceği araçlardır (bir dekoratör ve DocString ataması yoluyla yapılır — kodda az sonra gösterilecektir).
Bir ToolNode, grafik içinde araçları çalıştırmaya ayrılmış bir düğüm türüdür. Geliştiricilerin ek sarmalayıcı mantık yazmadan araçları entegre etmesine olanak tanır. Bunu Tool ve Node’un birleşimi olarak düşünebiliriz.
Mesaj türleri
Mesajlar, kullanıcı girdisi, sistem çıktısı, ara yanıtlar vb. gibi grafikte dolaşan ve durumda saklanan yapılandırılmış veri öğeleridir. İzlenebilirlik, bellek ve bağlam sağlar; bu da ajanın daha isabetli kararlar vermesine yardımcı olur.
LangGraph’ta birden fazla Mesaj Türü vardır:
- HumanMessage: Kullanıcıdan gelen girdiyi temsil eder. Bu, grafikte ajanla bir konuşmayı başlatmak veya sürdürmek için en sık kullanılan mesaj türüdür.
- AIMessage: Altta yatan dil modelleri tarafından üretilen yanıtları temsil eder. Diyalog belleğini korumak ve gelecekteki eylemleri bilgilendirmek için saklanırlar.
- SystemMessage: LLM’e bağlam veya davranış kurulum talimatları sağlar (ör. “Kişisel asistanımsın.”). Bu mesaj, modelin nasıl yanıt verdiğini etkiler.
- ToolMessage: Bir aracın çıktısını kapsüller. Ajanınız bir sonraki adımlarına karar vermek için harici işlemlere (ör. hesaplamalar veya aramalar) dayandığında kritik önemdedir.
- RemoveMessage: Daha önce eklenmiş mesajları durumdan programatik olarak silmek veya geri almak için kullanılır. Hata düzeltme veya ilgisiz bağlamı budama için yararlıdır.
- BaseMessage: LangChain ve LangGraph’taki tüm mesaj türlerinin ana üst sınıfıdır.
HumanMessage,AIMessageveyaSystemMessagegibi her özel mesaj türüBaseMessage’dan türetilir.
LangGraph Ajanları
Şimdi bu Ajanları LangGraph’ta kodlayacağız; kodlarken kullanılan farklı yöntemleri ve adımları anlamaya ve bu ajanları görselleştirmeye odaklanacağız.
Tek ajanlı iş akışı
Araçsız ve belleksiz tek bir ajan oluşturarak başlayalım. İçe aktarmalarla başlayalım:
from typing import TypedDict, List
from langchain_core.messages import HumanMessage
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, START, END
from dotenv import load_dotenvİlk satırda TypedDict belirtilir; bu, Python’da şu şekilde tanımlanan bir Tip Açıklamasıdır:
from typing import TypedDict
class Student(TypedDict):
name: str
grade: float
s1: Student = {"name": "Sam", "grade": 92.5}Özetle, bir TypedDict, güçlü Tip Güvenliği önlemlerine sahip bir sözlüktür; yapay zeka ajanı geliştirme için kritik önemdedir.
HumanMessage’i artık biliyor olmalısınız; bunu daha önce tartıştık.
ChatOpenAI ise yeni. Bunu kısaca açıklayalım.
Langchain aracılığıyla, Chat ailesini kullanabiliriz; bu da OpenAI, Anthropic, Ollama vb. gibi birçok farklı LLM sağlayıcısının modellerini kendi kütüphaneleri (ChatOpenAI, ChatAnthropic, ChatOllama vb.) üzerinden kullanmamıza olanak tanır.
Temelde, parametreleri ve kullanımları benzerdir; bu da kodumuzda modülerliği sağlar. Daha ayrıntılı adımlar LangChain Dokümantasyonu’nda bulunabilir.
Son olarak, StateGraph’ı daha önce ele aldık; Start ve End ise grafiğimizin başlangıç ve bitiş noktalarıdır.
Devam edelim:
load_dotenv() # Obtaining over secret keys
# Creation of the state using a Typed Dictionary
class AgentState(TypedDict):
messages: List[HumanMessage] # We are going to be storing Human Messages (the user input) as a list of messages
llm = ChatOpenAI(model="gpt-4o") # Our model choice
# This is an action - the underlying function of our node
def process(state: AgentState) -> AgentState:
response = llm.invoke(state["messages"])
print(f"\nAI: {response.content}")
return state
graph = StateGraph(AgentState) # Initialization of a Graph
graph.add_node("process_node", process) # Adding nodes
graph.add_edge(START, "process_node") # Adding edges
graph.add_edge("process_node", END)
agent = graph.compile() # Compiling the graph.add_node() ve .add_edge() yöntemlerini biraz daha ayrıntılı tartışalım.
add.node(): Odaklanmanız gereken iki ana parametre vardır; düğümün adı ve alttaki eylem. Bizim durumumuzda alttaki eylem —process()— düğümün arkasındaki ana mantıktır; yani bu aşamaya geldiğimizde hangi eylemler tamamlanır. Düğümün adı herhangi bir şey olabilir; hatta fonksiyonla aynı isimde dahi olabilir; ancak bu, hata ayıklarken oldukça kafa karıştırıcı olabilir!add_edge.(): Yine odaklanmanız gereken iki ana parametre vardır; bunlar Kenarın başlangıç ve bitiş düğümleridir. Girdi olarak alınanın alttaki eylem değil, düğümün adı olduğuna dikkat edin.
Pratik bir örneğe bakalım:
user_input = input("Enter: ")
while user_input != "exit":
agent.invoke({"messages": [HumanMessage(content=user_input)]})
user_input = input("Enter: ")Yukarıdaki kod parçası, Ajana birden çok kez çağrı yapmamızı sağlar. Görsel olarak, oluşturduğumuz Yapay Zeka Ajanı şöyle görünür:
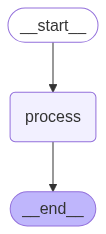
Ardışık bir Ajan, dallanma veya akıl yürütme olmadan görevleri önceden tanımlanmış sırayla adım adım tamamlar.
Bu tür bir görselleştirmeyi elde etmek için şu kodu kullanabiliriz (Not: derlenmiş grafiği kullanıyoruz):
from IPython.display import Image, display
display(Image(agent.get_graph().draw_mermaid_png()))React ajanları
ReAct Ajanları (Reasoning and Acting), oluşturma kolaylığına rağmen sağlamlıkları nedeniyle sektörde son derece yaygındır. Bu kadar yaygın olduklarından, LangGraph bu tür Ajanları oluşturmamız için kullanabileceğimiz yerleşik bir yöntem sunar.
Neyse ki yalnızca iki ek içe aktarmaya ihtiyacımız var:
from langgraph.prebuilt import create_react_agent
from langchain_google_community import GmailToolkitcreate_react_agent yöntemi, ReAct ajanlarını bizim için oluşturacak olan yöntemdir.
tools = [GmailToolkit()] # We are using the Inbuilt Gmail tool
llm = ChatOllama(model="qwen2.5:latest") # Leveraging Ollama Models
agent = create_react_agent(
model = llm, # Choice of the LLM
tools = tools, # Tools we want our LLM to have
name = "email_agent", # Name of our agent
prompt = "You are my AI assistant that has access to certain tools. Use the tools to help me with my tasks.", # System Prompt
)Bunun en iyi yanı, birden fazla ajan oluşturup daha karmaşık mimariler kurabilmemizdir.
Kendi özel araçlarımızı da oluşturabiliriz.
@tool
def send_email(email_address: str, email_content: str) -> str:
"""
Sends an email to a specified recipient with the given content.
Args:
email_address (str): The recipient's email address (e.g., '[email protected]')
email_content (str): The body of the email message to be sent
Returns:
str: A confirmation message indicating success or failure
Example:
>>> send_email('[email protected]', 'Hello John, just checking in!')
'Email successfully sent to [email protected]'
"""
# Tool Logic goes here
return "Done!"Yukarıda belirtildiği gibi, özel araçlar oluştururken önemli olan iki temel unsur vardır:
- Dekoratör: Bu, LangGraph’a bu özel fonksiyonun uzmanlaşmış bir fonksiyon — bir araç — olduğunu bildirir.
- Docstring: Bu, aracın ne yaptığını LLM’e anlatmak için gereklidir. Her parametrenin açıklamalarını ve örneklerini sağlamak, araç çağrımını daha sağlam kıldığı için faydalıdır.
ReAct Ajanları şu şekilde görünür:
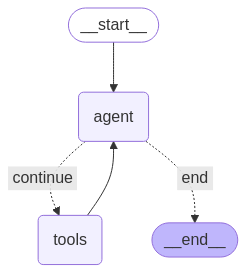
Bir ReAct Ajanı, görevleri adım adım çözmek için akıl yürütme (düşünceler) ile eylem arasında gidip gelir.
Durum büyümesi için indirgeme (reducer) fonksiyonları
Daha karmaşık ve sağlam ajansal sistemler için State tanımlarken, İndirgeme Fonksiyonlarını veya kısaca reducers kullanmak iyi bir fikirdir. reducers, her seferinde bir düğüm bir mesaj döndürdüğünde, önceki değerin üzerine yazmak yerine durumdaki mevcut listeye eklenmesini sağlayan veri açıklamalarıdır. Bu, bağlamın durum içinde birikmesini sağlar.
# State with reducer function
class AgentState(TypedDict):
messages: Annotated[list[BaseMessage], operator.add]Bu kod, operator.add indirgeme fonksiyonunu durumla bütünleştirerek tüm mesajların korunmasını sağlar.
LangGraph’ta Bellek Yönetimi
Bu bölümde her ajanın temel bir bileşenine — Belleğe — odaklanacağız. Bellek, ajana gerekli bağlamı sağladığı için son derece önemlidir; bu da onu daha sağlam ve güvenilir kılar. Ajanlarımızda belleği yönetmenin farklı yollarını inceleyelim.
Harici kontrol noktası depoları
Durum, LangGraph’taki en önemli öğedir ve doğal olarak durumu haricen depolamanın birden fazla yolu vardır. Popüler harici depolardan bazıları şunlardır:
- SQLite
- PostgreSQL
- Amazon S3
- Azure Blob Storage
- Google Cloud Storage
- Mem0
Bu kütüphanelerin tümü dokümantasyonda bulunabilir.
Şimdilik SQLite’a bakalım:
from langgraph.checkpoint.sqlite import SqliteSaver
memory = SqliteSaver.from_conn_string(":memory:") # This is for connecting to the SQLite database
graph = graph_builder.compile(checkpointer=memory) # Compiling graph with checkpointer as SQLite backendSQLite kullanmak, Ajanlarımıza Kalıcılık eklemenin kolay bir yoludur. Kalıcılık, farklı etkileşimler arasında bağlamı koruma yeteneğidir.
Bunların tümü, durumu depolamak ve güncellemek içindir. Şimdi, özellikle konuşma ilerledikçe oldukça büyüyen messages listesini, bu durumu nasıl etkili şekilde kullanıp yöneteceğimize bakalım.
LangGraph, kısa vadeli ve uzun vadeli bellek için yerel destek sağlar. Bunları inceleyelim.
Kısa vadeli bellek
Kısa vadeli bellek, ajanlarımızın bir oturum sırasında mesaj geçmişini hatırlamasını sağlar; çok turlu konuşmalar için kullanışlıdır.
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph
checkpointer = InMemorySaver()
builder = StateGraph(...)
graph = builder.compile(checkpointer=checkpointer)
# Invoking the Graph with our message
agent_graph.invoke(
{"messages": [{"role": "user", "content": "What's the weather today?"}]},
{"configurable": {"thread_id": "session_42"}},
)Yukarıdaki örnekte thread_id, bir konuşmayı veya oturumu benzersiz şekilde tanımlamak için kullanılır.
Uzun vadeli bellek
Uzun vadeli bellek, birden fazla oturum boyunca kalıcıdır ve adlar, hedefler veya ayarlar gibi — oturumlar arasında gerekli — önemli şeyleri hatırlamak için idealdir.
from langgraph.store.memory import InMemoryStore
from langgraph.graph import StateGraph
long_term_store = InMemoryStore()
builder = StateGraph(...)
agent = builder.compile(store=long_term_store)Ancak konuşmamız büyüyebileceğinden, mesaj geçmişimizi sınırlamanın bir yoluna ihtiyacımız var. İşte burada kırpma (trimming) devreye girer.
Kırpma (Trimming)
Aşağıdaki örnekte, mesaj geçmişinin başından belirteçleri kaldırıyoruz (strategy="first" satırı nedeniyle); böylece kırpma sonrasında en fazla 150 belirteç kalıyor.
from langchain_core.messages.utils import trim_messages, count_tokens_approximately
trimmed = trim_messages(
messages=state["messages"],
strategy="first", # remove the messages from beginning
token_counter=count_tokens_approximately,
max_tokens=150
)Özetlemeye dayalı budama
Mesaj geçmişini azaltmanın bir başka yolu da özetlemedir. Bu, konuşmanın sadece bir kısmından belirteçleri kesmek yerine, mesaj geçmişi boyunca önemli bilgilerin korunmasına olanak tanır.
from langmem.short_term import SummarizationNode
from langchain_core.messages.utils import count_tokens_approximately
summary_node = SummarizationNode(
model=summary_llm, # Our summarization LLM
max_tokens=300, # Total token limit
max_tokens_before_summary=150, # when to start summarizing
max_summary_tokens=150, # summary size
token_counter=count_tokens_approximately
)Özetlemenin, bu durumda herhangi bir LLM olabilen summary_llm adlı alttaki bir LLM tarafından gerçekleştirildiğine dikkat etmek önemlidir.
Seçici silme
Bellek Yönetiminde gereken son ana işlem Silme’dir. Seçili mesajları silmek için şu kodu kullanabiliriz:
from langchain_core.messages import RemoveMessage
def clean_state(state):
# Remove all tool-related messages
to_remove = [RemoveMessage(id=msg.id) for msg in state["messages"] if msg.role == "tool"]
return {"messages": to_remove}Yukarıdaki kodda, gerçekçi olarak Tool-Message’ın, LLM’in aracı kullandıktan sonra yanıtını oluşturmasına yönelik olması nedeniyle gereksiz olabileceğinden tüm araçla ilgili mesajları sildik.
Ancak, tüm mesaj geçmişini silmek istersek şunu yapabiliriz:
from langgraph.graph.message import REMOVE_ALL_MESSAGES
from langchain_core.messages import RemoveMessage
def reset_history(state):
# Remove entire conversation history
return {"messages": [RemoveMessage(id=REMOVE_ALL_MESSAGES)]}Sonuç
Genel olarak LangGraph, ajansal sistemler geliştirmek için yapılandırılmış ve ölçeklenebilir bir yaklaşım sunan güçlü bir kütüphanedir. Düğümler ve kenarlardan oluşan bir grafikte mantığı modellemek; paylaşılan durum ve kalıcı bellekle birlikte, zaman içinde akıl yürütebilen, etkileşime girebilen ve uyum sağlayabilen sağlam ajanlar geliştirmemizi sağlar.
Sistemler karmaşıklıkça büyüdükçe, bu çerçeve; bellek yönetimi, araç kullanımını koordine etme ve uzun vadeli bağlamı sürdürme için gereken araçları sunar — tüm bunları modüler ve genişletilebilir kalırken yapar.
Artık temel bileşenler yerli yerinde olduğuna göre, gerçek dünya iş akışlarını yönetebilen sağlam yapay zeka ajanları tasarlayıp devreye almaya hazırsınız.
Öğrenmeye devam etmek için LangGraph ile Çoklu Ajan Sistemleri Oluşturma kursumuzu mutlaka inceleyin. Ayrıca LangChain ile Ajansal Sistemler Tasarlama kursumuzu ve Ajansal RAG eğitimimizi görüntüleyebilirsiniz.
LangGraph Ajanları SSS
LangGraph tam olarak nedir?
Bir yapay zeka ajanın mantığını düğüm ve kenarlardan oluşan bir grafik olarak modelleyen, akıl yürütme, araç çağrıları ve belleğe imkân veren bir Python çerçevesi.
Diğer ajan kütüphaneleri yerine neden LangGraph’ı seçmeliyim?
LangGraph, mantığı tanımlamak için Grafik yapısını kullanır; bu, diğer popüler ajansal çerçevelerin kullanmadığı ayırt edici bir özelliktir. LangGraph ayrıca döngüler, dallanma, bellek, kalıcılık ve çoklu ajan iş akışları için yerel destek sunar — bu da onu gerçek dünyada ölçeklenebilir ajan sistemleri için ideal kılar.
LangGraph belleği nasıl yönetir ve kalıcı hale getirir?
Geçmiş etkileşimleri hatırlamaya imkân veren, kısa vadeli (bellekte) veya uzun vadeli (SQLite, S3 vb.) olarak saklanabilen paylaşılan bir durum kullanır.
Yerel modelleri kullanabilir miyim?
Elbette! LangGraph, Ollama Modelleri, HuggingFace Modelleri, LlamaCpp vb. için yerel destek sunar.
Uzun mesaj geçmişlerinin boyutunu nasıl küçültürüm?
Eski belirteçleri atmak için trim_messages kullanın veya önemli bağlamı korurken geçmiş mesajları sıkıştırmak için SummarizationNode kullanın.




LangGraph, birbirine bağlı adımlar aracılığıyla akıl yürütebilen, plan yapabilen ve eyleme geçebilen yapay zeka ajanları oluşturmak için grafik tabanlı bir çerçevedir. Öne çıkan farkı, her bir düğümün bir LLM, araç veya fonksiyon çalıştırabildiği; aynı zamanda durumu otomatik yöneten döngüsel ve dallanan iş akışlarını kolayca oluşturmamıza izin vermesidir.
Bu, LangGraph’ı bellek, hata yönetimi ve gerçek zamanlı karar alma gerektiren karmaşık, sağlam, çoklu ajan sistemleri kurmak için ideal kılar.
Bu eğitimde, LangGraph’ın temel bileşenlerini anlamaktan duruma duyarlı, araç destekli yapay zeka ajanları geliştirmeye kadar temel ve ileri özelliklerini adım adım göstereceğim. LangGraph ile çoklu ajan sistemleri oluşturmakla ilgileniyorsanız, uygulamalı kursumuzu mutlaka inceleyin. Ayrıca aşağıda LangGraph ajanları oluşturma video eğitimimizi izleyebilirsiniz.