

LangGraph की बुनियादी बातें
चलिए LangGraph के मौलिक बिल्डिंग ब्लॉक्स पर चर्चा से शुरू करते हैं। ये तत्व हमें उन्नत AI एजेंट्स के लिए संरचित, स्टेटफुल और स्केलेबल वर्कफ़्लो बनाने की सुविधा देते हैं।
State
यहाँ state एक साझा मेमोरी ऑब्जेक्ट है जो पूरे ग्राफ में बहता है। यह सभी प्रासंगिक जानकारी जैसे संदेश, वेरिएबल्स, मध्यवर्ती परिणाम और निर्णयों का इतिहास संग्रहीत करता है। LangGraph स्टेट को ऑटोमैटिक रूप से मैनेज करता है, जिससे डेवलपमेंट अधिक कुशल बनता है।
State के पूरक के रूप में, चेकपॉइंटिंग, थ्रेड-लोकल मेमोरी और क्रॉस-सेशन परसिस्टेंस जैसी उन्नत सुविधाएँ मौजूद हैं। निष्पादन के दौरान स्टेट लगातार अपडेट होता रहता है, जैसा कि नीचे दिए गए डायग्राम में दिखाया गया है: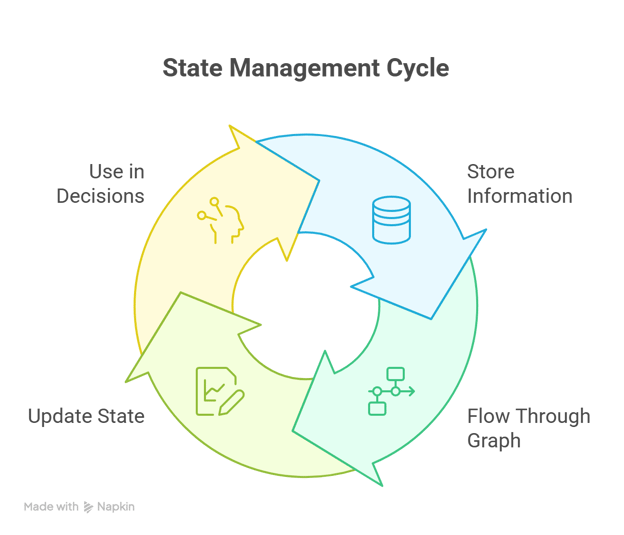
LangGraph में स्टेट मैनेजमेंट चक्र, जो नोड्स के बीच लगातार अपडेट दर्शाता है
Node
एक node वर्कफ़्लो की एकल क्रियात्मक इकाई है। यह कई तरह की क्रियाएँ कर सकता है, जैसे:
- किसी बड़े भाषा मॉडल (LLM) को इनवोक करना
- किसी टूल या API को कॉल करना
- कस्टम Python फ़ंक्शन चलाना
- रूटिंग लॉजिक या ब्रांचिंग निर्णय
हर नोड वर्तमान स्टेट लेता है और अपडेटेड स्टेट लौटाता है।
Edges और conditional edges
Edges नोड्स के बीच संक्रमण परिभाषित करते हैं। वे ग्राफ के कंट्रोल फ़्लो को निर्धारित करते हैं और इनमें यह सपोर्ट हो सकता है:
- स्टैटिक कनेक्शन (रेखीय प्रगति के लिए)
- चक्रीय पथ (इटरेटिव व्यवहार के लिए)
- डायनामिक ब्रांचिंग (स्टेट कंडीशन्स के आधार पर—Conditional Edges के जरिए)
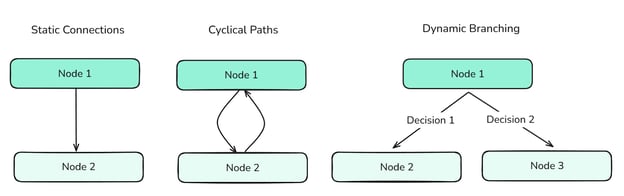
विभिन्न प्रकार के Edges नोड्स के बीच फ्लो को परिभाषित करते हैं और ग्राफ के भीतर सूचना के प्रवाह को नियंत्रित करते हैं।
जटिल एजेंट व्यवहार को ऑर्केस्ट्रेट करने के लिए Edges आवश्यक हैं।
Graph और stategraph
LangGraph में ग्राफ एजेंटिक वर्कफ़्लो की संरचना तय करता है, और यह एजेस से जुड़े नोड्स से मिलकर बनता है।
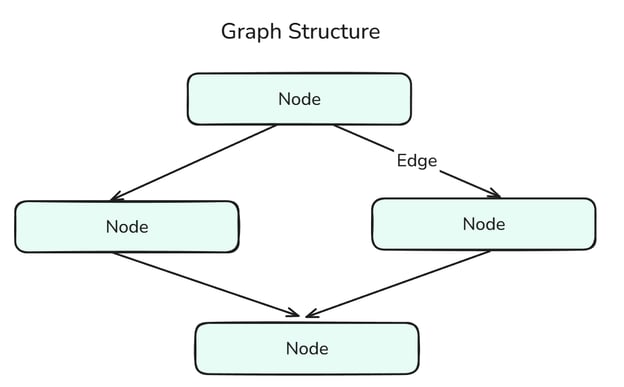
ग्राफ संरचना नोड्स और एजेस का संयोजन है।
StateGraph एक विशेष प्रकार का ग्राफ है जो निष्पादन के दौरान साझा स्टेट को बनाए रखता और अपडेट करता है। यह संदर्भ-सचेत निर्णय लेने और चरणों के बीच पर्सिस्टेंट मेमोरी सक्षम करता है। इसे आप State और Graph के मेल के रूप में समझ सकते हैं।
Tool और toolnode
एक tool कोई भी बाहरी या आंतरिक फ़ंक्शन होता है जिसे एजेंट कॉल कर सकता है, जैसे वेब सर्च, कैलकुलेटर, या कस्टम यूटिलिटी। टूल्स के दो प्रकार हैं:
- इन-बिल्ट टूल्स: वे टूल्स जो LangChain द्वारा पहले से बने और उपयोग के लिए तैयार हैं, और दस्तावेज़ीकरण में उपलब्ध हैं।
- कस्टम टूल्स: वे टूल्स जो हम स्वयं बना सकते हैं और अपनी एप्लिकेशन में उपयोग कर सकते हैं (डेकोरेटर और DocString असाइन करके—यह आगे कोड में दिखेगा)।
एक ToolNode ग्राफ के भीतर टूल्स निष्पादित करने के लिए समर्पित नोड प्रकार है। यह हमें अतिरिक्त रैपर लॉजिक लिखे बिना टूल्स इंटीग्रेट करने देता है। इसे आप Tool और Node के मेल के रूप में समझ सकते हैं।
Message types
Messages संरचित डेटा तत्व होते हैं (जैसे यूज़र इनपुट, सिस्टम आउटपुट, मध्यवर्ती प्रतिक्रियाएँ आदि) जो ग्राफ के माध्यम से चलते हैं और स्टेट में संग्रहीत होते हैं। ये एजेंट के निर्णयों के लिए ट्रेसेबिलिटी, मेमोरी और संदर्भ प्रदान करते हैं, जिससे अधिक सूचित निर्णय संभव होते हैं।
LangGraph में कई MessageTypes होते हैं:
- HumanMessage: यूज़र से आया इनपुट दर्शाता है। यह ग्राफ में एजेंट के साथ बातचीत शुरू या जारी रखने के लिए सबसे आम संदेश प्रकार है।
- AIMessage: अंतर्निहित भाषा मॉडल द्वारा उत्पन्न प्रतिक्रियाएँ दर्शाता है। इन्हें वार्तालाप मेमोरी बनाए रखने और भविष्य की कार्रवाइयों को सूचित करने के लिए संग्रहीत किया जाता है।
- SystemMessage: LLM को संदर्भ या व्यवहार सेटअप निर्देश प्रदान करता है (उदाहरण: “You are my personal assistant.”)। यह संदेश मॉडल की प्रतिक्रिया को प्रभावित करता है।
- ToolMessage: किसी टूल से प्राप्त आउटपुट को समाहित करता है। जब आपका एजेंट बाहरी कार्रवाइयों (जैसे गणना या खोज) पर निर्भर करता है, तो ये उसके अगले कदम तय करने में अहम होते हैं।
- RemoveMessage: स्टेट से पहले जोड़े गए संदेशों को प्रोग्रामेटिक रूप से हटाने या वापस लेने के लिए उपयोग होता है। यह त्रुटि सुधार या अप्रासंगिक संदर्भ हटाने में सहायक है।
- BaseMessage: LangChain और LangGraph में सभी संदेश प्रकारों का मूल पैरेंट है। हर विशिष्ट संदेश प्रकार—जैसे
HumanMessage,AIMessage, याSystemMessage—BaseMessageसे इनहेरिट करता है।
LangGraph एजेंट्स
अब हम LangGraph में इन एजेंट्स को कोड करेंगे, कोडिंग के दौरान शामिल विभिन्न तरीकों और चरणों को समझने पर ध्यान देते हुए, साथ ही इन एजेंट्स का विज़ुअलाइज़ेशन भी करेंगे।
सिंगल-एजेंट वर्कफ़्लो
आइए बिना किसी टूल या मेमोरी के एक सिंगल एजेंट बनाकर शुरू करें। सबसे पहले इम्पोर्ट्स देखते हैं:
from typing import TypedDict, List
from langchain_core.messages import HumanMessage
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, START, END
from dotenv import load_dotenvपहली पंक्ति में TypedDict है, जो Python में इस प्रकार परिभाषित टाइप-एनोटेशन है:
from typing import TypedDict
class Student(TypedDict):
name: str
grade: float
s1: Student = {"name": "Sam", "grade": 92.5}मूल रूप से, TypedDict ऐसा डिक्शनरी टाइप है जिसमें सख्त टाइप-सेफ़्टी होती है—AI एजेंट डेवलपमेंट के लिए महत्वपूर्ण।
HumanMessage अब तक आपको परिचित होना चाहिए, क्योंकि हम इसे पहले चर्चा कर चुके हैं।
ChatOpenAI हालांकि नया है। आइए इसे संक्षेप में समझते हैं।
LangChain के माध्यम से, हम Chat परिवार का उपयोग कर सकते हैं, जो हमें OpenAI, Anthropic, Ollama आदि जैसे विभिन्न LLM प्रदाताओं के मॉडल उनकी संबंधित लाइब्रेरीज़—ChatOpenAI, ChatAnthropic, ChatOllama आदि—के जरिए उपयोग करने देता है।
मूल रूप से, इनके पैरामीटर और उपयोग समान होते हैं, जिससे हमारे कोड में मॉड्युलैरिटी आती है। अधिक विस्तृत चरण LangChain दस्तावेज़ में मिल सकते हैं।
अंत में, StateGraph पर हम पहले बात कर चुके हैं, और Start तथा End हमारे ग्राफ के आरंभ और अंत बिंदु हैं।
आगे बढ़ते हैं:
load_dotenv() # Obtaining over secret keys
# Creation of the state using a Typed Dictionary
class AgentState(TypedDict):
messages: List[HumanMessage] # We are going to be storing Human Messages (the user input) as a list of messages
llm = ChatOpenAI(model="gpt-4o") # Our model choice
# This is an action - the underlying function of our node
def process(state: AgentState) -> AgentState:
response = llm.invoke(state["messages"])
print(f"\nAI: {response.content}")
return state
graph = StateGraph(AgentState) # Initialization of a Graph
graph.add_node("process_node", process) # Adding nodes
graph.add_edge(START, "process_node") # Adding edges
graph.add_edge("process_node", END)
agent = graph.compile() # Compiling the graph.add_node() और .add_edge() मेथड्स को थोड़ा विस्तार से समझते हैं।
add.node(): इसमें दो मुख्य पैरामीटर होते हैं—नोड का नाम और अंतर्निहित एक्शन। हमारे मामले में—process()—यह नोड के पीछे का मुख्य लॉजिक है, यानी इस चरण पर पहुँचने पर क्या कार्रवाइयाँ पूरी होती हैं। नोड का नाम कुछ भी हो सकता है, यहाँ तक कि फ़ंक्शन के समान भी, हालांकि डिबगिंग में इससे भ्रम हो सकता है!add_edge.(): इसमें भी दो मुख्य पैरामीटर होते हैं—एज के स्टार्ट और एंड नोड्स। ध्यान दें कि यहाँ नोड का नाम दिया जाता है, न कि अंतर्निहित एक्शन।
एक व्यावहारिक उदाहरण देखते हैं:
user_input = input("Enter: ")
while user_input != "exit":
agent.invoke({"messages": [HumanMessage(content=user_input)]})
user_input = input("Enter: ")ऊपर का कोड हमें एजेंट को कई बार कॉल करने देता है। दृश्य रूप से, बनाया गया AI एजेंट इस प्रकार दिखता है:
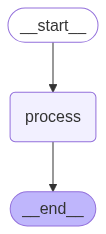
एक क्रमिक (Sequential) एजेंट पूर्व-निर्धारित क्रम में चरण-दर-चरण कार्य पूरा करता है, बिना ब्रांचिंग या तर्क के।
ऐसा विज़ुअलाइज़ेशन प्राप्त करने के लिए, हम निम्न कोड का उपयोग कर सकते हैं (ध्यान दें: हम कम्पाइल्ड ग्राफ का उपयोग करते हैं):
from IPython.display import Image, display
display(Image(agent.get_graph().draw_mermaid_png()))React एजेंट्स
ReAct एजेंट्स—Reasoning and Acting एजेंट्स—उद्योग में बेहद आम हैं, क्योंकि इन्हें बनाना आसान होते हुए भी ये मज़बूत होते हैं। इतनी लोकप्रियता के कारण, LangGraph में ऐसे एजेंट्स बनाने के लिए एक इनबिल्ट मेथड उपलब्ध है।
सौभाग्य से, हमें केवल दो अतिरिक्त इम्पोर्ट्स की ज़रूरत है:
from langgraph.prebuilt import create_react_agent
from langchain_google_community import GmailToolkitcreate_react_agent वही मेथड है जो हमारे लिए ReAct एजेंट्स बनाएगा।
tools = [GmailToolkit()] # We are using the Inbuilt Gmail tool
llm = ChatOllama(model="qwen2.5:latest") # Leveraging Ollama Models
agent = create_react_agent(
model = llm, # Choice of the LLM
tools = tools, # Tools we want our LLM to have
name = "email_agent", # Name of our agent
prompt = "You are my AI assistant that has access to certain tools. Use the tools to help me with my tasks.", # System Prompt
)इसका सबसे अच्छा भाग यह है कि हम कई एजेंट्स बनाकर अधिक जटिल आर्किटेक्चर तैयार कर सकते हैं।
हम अपने स्वयं के कस्टम टूल्स भी बना सकते हैं।
@tool
def send_email(email_address: str, email_content: str) -> str:
"""
Sends an email to a specified recipient with the given content.
Args:
email_address (str): The recipient's email address (e.g., '[email protected]')
email_content (str): The body of the email message to be sent
Returns:
str: A confirmation message indicating success or failure
Example:
>>> send_email('[email protected]', 'Hello John, just checking in!')
'Email successfully sent to [email protected]'
"""
# Tool Logic goes here
return "Done!"जैसा ऊपर कहा गया, कस्टम टूल्स बनाते समय दो चीज़ें प्रमुख हैं:
- डेकोरेटर: यह LangGraph को बताता है कि यह विशेष फ़ंक्शन एक विशेषीकृत फ़ंक्शन—एक टूल—है।
- डॉकस्ट्रिंग: यह LLM को बताने के लिए आवश्यक है कि टूल क्या करता है। हर पैरामीटर के विवरण और उदाहरण देना उपयोगी होता है, क्योंकि इससे टूल-कॉलिंग अधिक मज़बूत होती है।
ReAct एजेंट्स इस प्रकार दिखते हैं:
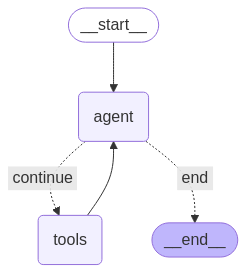
एक ReAct एजेंट विचार (reasoning) और क्रियाओं के बीच बारी-बारी से काम करते हुए चरण-दर-चरण कार्य हल करता है।
स्टेट ग्रोथ के लिए Reducer फ़ंक्शन्स
अधिक जटिल, मज़बूत एजेंटिक सिस्टम्स के लिए State परिभाषित करते समय Reducer फ़ंक्शन्स या संक्षेप में reducers का उपयोग करना अच्छा विचार है। reducers ऐसी डेटा एनोटेशन्स हैं जो सुनिश्चित करती हैं कि हर बार कोई नोड संदेश लौटाए, तो वह स्टेट में मौजूद सूची में जुड़ जाए, न कि पिछले मान को ओवरराइट कर दे। इससे हमारा स्टेट संदर्भ बनाता और बढ़ाता रहता है।
# State with reducer function
class AgentState(TypedDict):
messages: Annotated[list[BaseMessage], operator.add]यह कोड स्टेट के साथ operator.add रिड्यूसर फ़ंक्शन को एकीकृत करता है, जिससे सभी संदेश संरक्षित रहते हैं।
LangGraph में मेमोरी मैनेजमेंट
इस खंड में हम हर एजेंट के एक मुख्य घटक—मेमोरी—पर ध्यान देंगे। मेमोरी एजेंट के लिए बेहद आवश्यक है क्योंकि यह आवश्यक संदर्भ प्रदान करती है, जिससे वह अधिक मज़बूत और विश्वसनीय बनता है। आइए देखते हैं कि हम अपने एजेंट्स में मेमोरी को विभिन्न तरीकों से कैसे मैनेज कर सकते हैं।
बाहरी चेकपॉइंट स्टोर्स
State LangGraph का सबसे महत्वपूर्ण तत्व है, और स्वाभाविक रूप से, स्टेट को बाहरी रूप से संग्रहीत करने के कई तरीके हैं। लोकप्रिय बाहरी स्टोरेज में शामिल हैं:
- SQLite
- PostgreSQL
- Amazon S3
- Azure Blob Storage
- Google Cloud Storage
- Mem0
इन सभी लाइब्रेरीज़ को आप दस्तावेज़ीकरण में पा सकते हैं।
फ़िलहाल हम SQLite देखते हैं:
from langgraph.checkpoint.sqlite import SqliteSaver
memory = SqliteSaver.from_conn_string(":memory:") # This is for connecting to the SQLite database
graph = graph_builder.compile(checkpointer=memory) # Compiling graph with checkpointer as SQLite backendSQLite का उपयोग हमारे एजेंट्स में पर्सिस्टेंस जोड़ने का आसान तरीका है। पर्सिस्टेंस का मतलब है विभिन्न इंटरैक्शन के बीच संदर्भ को बनाए रखने की क्षमता।
यह सब स्टेट को स्टोर और अपडेट करने के लिए है। अब देखते हैं कि उस स्टेट—खासकर messages सूची, जो बातचीत बढ़ने के साथ बड़ी हो जाती है—का प्रभावी उपयोग और प्रबंधन कैसे करें।
LangGraph में शॉर्ट-टर्म और लॉन्ग-टर्म मेमोरी का नैटिव सपोर्ट है। आइए इन्हें समझते हैं।
शॉर्ट-टर्म मेमोरी
शॉर्ट-टर्म मेमोरी हमारे एजेंट्स को एक सेशन के दौरान संदेश इतिहास याद रखने देती है, जो मल्टी-टर्न बातचीत में उपयोगी है।
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph
checkpointer = InMemorySaver()
builder = StateGraph(...)
graph = builder.compile(checkpointer=checkpointer)
# Invoking the Graph with our message
agent_graph.invoke(
{"messages": [{"role": "user", "content": "What's the weather today?"}]},
{"configurable": {"thread_id": "session_42"}},
)ऊपर के उदाहरण में, thread_id किसी बातचीत या सेशन को विशिष्ट रूप से पहचानने के लिए उपयोग होता है।
लॉन्ग-टर्म मेमोरी
लॉन्ग-टर्म मेमोरी कई सेशन्स में बनी रहती है और नाम, लक्ष्य या सेटिंग्स जैसी चीज़ों को याद रखने के लिए उपयुक्त है—ऐसी अहम बातें जो सेशन्स के बीच भी ज़रूरी होती हैं।
from langgraph.store.memory import InMemoryStore
from langgraph.graph import StateGraph
long_term_store = InMemoryStore()
builder = StateGraph(...)
agent = builder.compile(store=long_term_store)हालाँकि, बातचीत बड़ी हो सकती है, इसलिए हमें संदेश इतिहास सीमित करने का तरीका चाहिए। यहीं पर ट्रिमिंग काम आती है।
Trimming
नीचे के उदाहरण में, हम संदेश इतिहास की शुरुआत से टोकन हटा रहे हैं (strategy="first" होने के कारण) ताकि ट्रिमिंग के बाद अधिकतम 150 टोकन ही शेष रहें।
from langchain_core.messages.utils import trim_messages, count_tokens_approximately
trimmed = trim_messages(
messages=state["messages"],
strategy="first", # remove the messages from beginning
token_counter=count_tokens_approximately,
max_tokens=150
)सार-संक्षेप पर आधारित प्रूनिंग
संदेश इतिहास घटाने का एक और तरीका है सार-संक्षेप (summarization)। इससे वार्तालाप के किसी हिस्से से केवल टोकन काटने के बजाय पूरे इतिहास की महत्वपूर्ण जानकारी संरक्षित रहती है।
from langmem.short_term import SummarizationNode
from langchain_core.messages.utils import count_tokens_approximately
summary_node = SummarizationNode(
model=summary_llm, # Our summarization LLM
max_tokens=300, # Total token limit
max_tokens_before_summary=150, # when to start summarizing
max_summary_tokens=150, # summary size
token_counter=count_tokens_approximately
)ध्यान देने योग्य है कि सार-संक्षेप किसी अंतर्निहित LLM द्वारा किया जाता है—यहाँ summary_llm—जो कोई भी LLM हो सकता है।
चयनात्मक deletion
मेमोरी मैनेजमेंट में अंतिम प्रमुख ऑपरेशन है Delete। चयनित संदेशों को हटाने के लिए, हम यह कोड उपयोग कर सकते हैं:
from langchain_core.messages import RemoveMessage
def clean_state(state):
# Remove all tool-related messages
to_remove = [RemoveMessage(id=msg.id) for msg in state["messages"] if msg.role == "tool"]
return {"messages": to_remove}ऊपर के कोड में हमने सभी टूल-संबंधित संदेश हटा दिए हैं, जो अनावश्यक हो सकते हैं (क्योंकि व्यावहारिक रूप से Tool-Message LLM के लिए होता है ताकि वह टूल का उपयोग करने के बाद अपना उत्तर बना सके)।
हालाँकि, यदि हम पूरा संदेश इतिहास हटाना चाहें, तो ऐसा कर सकते हैं:
from langgraph.graph.message import REMOVE_ALL_MESSAGES
from langchain_core.messages import RemoveMessage
def reset_history(state):
# Remove entire conversation history
return {"messages": [RemoveMessage(id=REMOVE_ALL_MESSAGES)]}निष्कर्ष
कुल मिलाकर, LangGraph एक शक्तिशाली लाइब्रेरी है जो एजेंटिक सिस्टम बनाने के लिए संरचित और स्केलेबल दृष्टिकोण प्रदान करती है। नोड्स और एजेस के ग्राफ के रूप में लॉजिक को मॉडल करना, साझा स्टेट और पर्सिस्टेंट मेमोरी के साथ, हमें ऐसे मज़बूत एजेंट्स विकसित करने देता है जो समय के साथ तर्क कर सकें, इंटरेक्ट कर सकें और अनुकूलित हो सकें।
जैसे-जैसे प्रणालियाँ जटिल होती जाती हैं, यह फ़्रेमवर्क मेमोरी मैनेज करने, टूल्स के समन्वय और दीर्घकालिक संदर्भ बनाए रखने के लिए आवश्यक टूल्स प्रदान करता है—वह भी मॉड्युलर और एक्स्टेंसिबल बना रहते हुए।
अब जब मुख्य घटक आपके पास हैं, तो आप वास्तविक दुनिया के वर्कफ़्लो संभालने में सक्षम मज़बूत AI एजेंट्स को डिज़ाइन और तैनात करने के लिए तैयार हैं।
सीखते रहने के लिए हमारा कोर्स Building Multi-Agent Systems With LangGraph ज़रूर देखें। आप हमारा Designing Agentic Systems with LangChain कोर्स और हमारा Agentic RAG पर ट्यूटोरियल भी देख सकते हैं।
LangGraph एजेंट्स FAQs
LangGraph वास्तव में है क्या?
एक Python फ़्रेमवर्क जो AI एजेंट की लॉजिक को नोड्स और एजेस के ग्राफ़ के रूप में मॉडल करता है, जिससे तर्क, टूल कॉल्स और मेमोरी संभव होती है।
मुझे अन्य एजेंट लाइब्रेरीज़ के बजाय LangGraph क्यों चुनना चाहिए?
LangGraph लॉजिक परिभाषित करने के लिए ग्राफ संरचना का उपयोग करता है—यह एक प्रमुख विशेषता है जिसे अन्य लोकप्रिय एजेंटिक फ़्रेमवर्क सामान्यतः नहीं अपनाते। LangGraph में लूप्स, ब्रांचिंग, मेमोरी, पर्सिस्टेंस और मल्टी-एजेंट वर्कफ़्लो का नैटिव सपोर्ट भी है—जिससे यह वास्तविक, स्केलेबल एजेंट सिस्टम्स के लिए आदर्श बनता है।
LangGraph मेमोरी को कैसे मैनेज और पर्सिस्ट करता है?
यह साझा स्टेट का उपयोग करता है जिसे शॉर्ट-टर्म (इन-मेमोरी) या लॉन्ग-टर्म (SQLite, S3, आदि) में स्टोर किया जा सकता है, जिससे एजेंट्स पिछली इंटरैक्शन्स को याद रख पाते हैं।
क्या मैं लोकल मॉडल्स का उपयोग कर सकता/सकती हूँ?
बिल्कुल! LangGraph में Ollama मॉडल्स, HuggingFace मॉडल्स, LlamaCpp आदि के लिए नैटिव सपोर्ट मौजूद है।
लंबे संदेश इतिहास का आकार कैसे घटाएँ?
पुराने टोकन्स हटाने के लिए trim_messages का उपयोग करें, या महत्वपूर्ण संदर्भ को सुरक्षित रखते हुए पिछले संदेश संक्षेपित करने के लिए SummarizationNode का।

LangGraph AI एजेंट्स बनाने के लिए एक ग्राफ-आधारित फ़्रेमवर्क है जो आपस में जुड़े चरणों के माध्यम से तर्क कर सकता है, योजना बना सकता है और कार्रवाई कर सकता है। इसकी खासियत यह है कि यह हमें आसानी से चक्रीय और शाखित वर्कफ़्लो बनाने देता है, जहाँ हर नोड एक LLM, टूल, या फ़ंक्शन चला सकता है—और साथ ही स्टेट को ऑटोमैटिक रूप से मैनेज करता है।
इससे LangGraph जटिल, मज़बूत, मल्टी-एजेंट प्रणालियाँ बनाने के लिए आदर्श बनता है, जिन्हें मेमोरी, एरर हैंडलिंग और रियल-टाइम निर्णय लेने की ज़रूरत होती है।
इस ट्यूटोरियल में, मैं आपको LangGraph की बुनियादी बातों और उन्नत सुविधाओं के माध्यम से ले जाऊँगा—इसके मुख्य घटकों को समझने से लेकर स्टेटफुल, टूल-संवर्धित AI एजेंट्स बनाने तक। यदि आप LangGraph के साथ मल्टी-एजेंट सिस्टम बनाने में रुचि रखते हैं, तो हमारा हैंड्स-ऑन कोर्स ज़रूर देखें। आप नीचे LangGraph एजेंट्स बनाने पर हमारा वीडियो ट्यूटोरियल भी देख सकते हैं।