
Corso
Sistemi Multi-Agente con LangGraph
2 ore 45 min
8.8K
Partiamo dai mattoni fondamentali di LangGraph. Questi elementi ci permettono di costruire workflow strutturati, con stato e scalabili per agenti IA avanzati.
Lo state è un oggetto di memoria condivisa che scorre attraverso il grafo. Memorizza tutte le informazioni rilevanti come messaggi, variabili, risultati intermedi e cronologia delle decisioni. LangGraph gestisce lo stato automaticamente, rendendo lo sviluppo più efficiente.
A complemento dello State, ci sono funzionalità avanzate come checkpointing, memoria locale al thread e persistenza cross-session. Durante l'esecuzione, lo stato viene aggiornato continuamente, come mostrato nel diagramma seguente: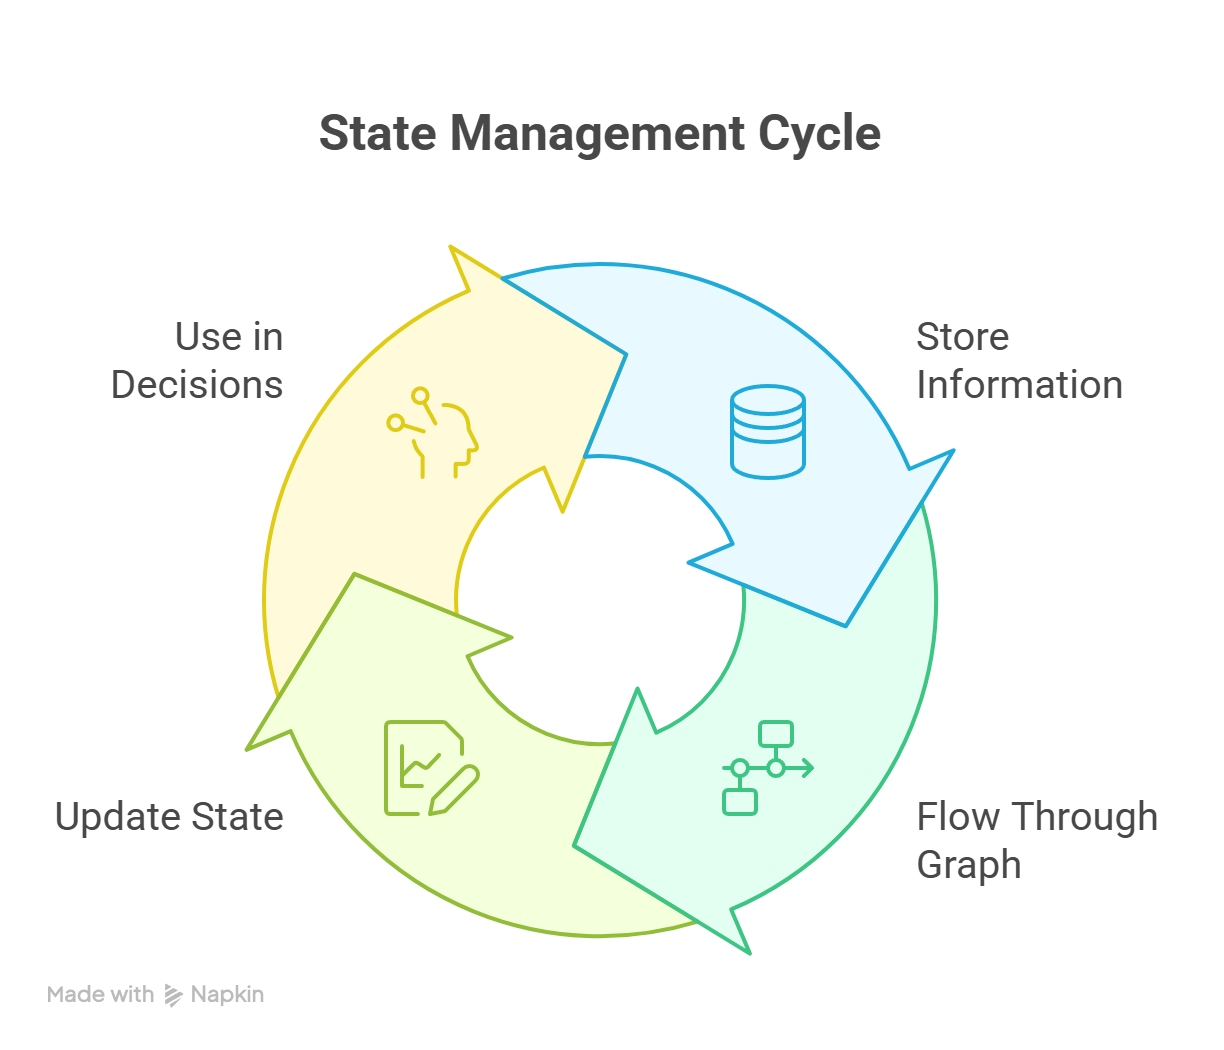
Ciclo di gestione dello stato in LangGraph con aggiornamenti continui tra i nodi
Un nodo è un'unità funzionale singola nel workflow. Può eseguire diverse azioni, come:
Ogni nodo riceve lo stato corrente e restituisce uno stato aggiornato.
Gli archi definiscono le transizioni tra i nodi. Determinano il flusso di controllo del grafo e possono supportare:
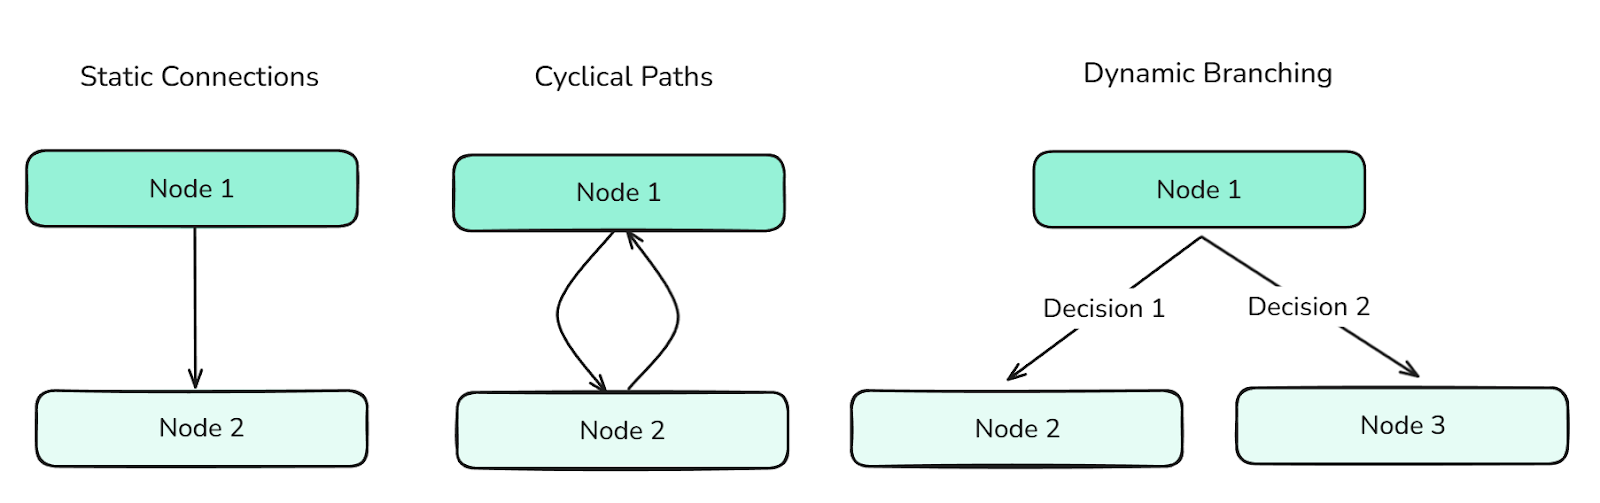
Tipi diversi di archi definiscono il flusso tra i nodi e controllano le informazioni nel grafo.
Gli archi sono essenziali per orchestrare comportamenti complessi degli agenti.
Un grafo in LangGraph definisce la struttura del workflow agentico ed è composto da nodi collegati da archi.
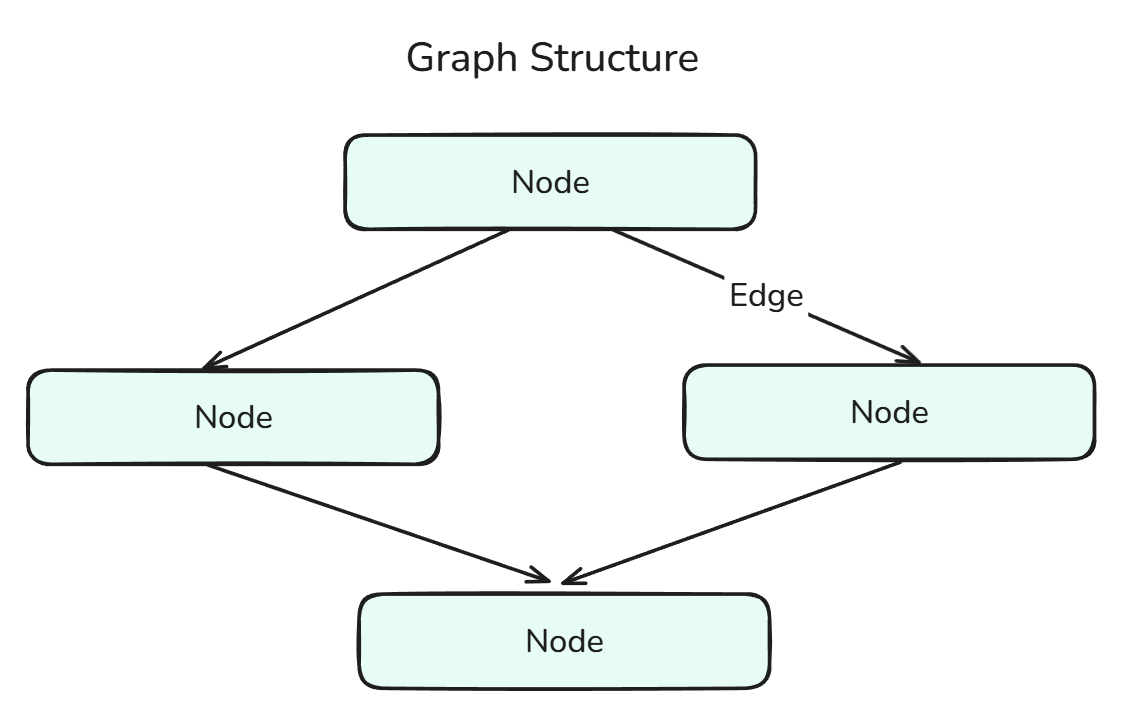
La struttura del grafo è una combinazione di nodi e archi.
Lo StateGraph è un grafo specializzato che mantiene e aggiorna uno stato condiviso durante l'esecuzione. Abilita decisioni sensibili al contesto e memoria persistente tra i passaggi. Possiamo vederlo come la fusione di State e Graph.
Un tool è qualsiasi funzione esterna o interna che un agente può chiamare, come una ricerca web, una calcolatrice o un'utility personalizzata. Esistono due tipi di strumenti:
Un ToolNode è un tipo di nodo dedicato all'esecuzione di strumenti all'interno del grafo. Permette a noi sviluppatori di integrare strumenti senza scrivere ulteriore logica di wrapper. Possiamo vederlo come la fusione di Tool e Node.
I messaggi sono elementi di dati strutturati (come input dell'utente, output del sistema, risposte intermedie, ecc.) che si muovono nel grafo e vengono memorizzati nello stato. Consentono tracciabilità, memoria e contesto per le decisioni dell'agente, aiutando a prendere decisioni più informate.
In LangGraph esistono diversi tipi di messaggi:
HumanMessage, AIMessage o SystemMessage — eredita da BaseMessage.Ora programmeremo questi agenti in LangGraph, concentrandoci sui vari metodi e passaggi necessari, oltre che sulla visualizzazione degli agenti.
Iniziamo creando un singolo agente senza strumenti o memoria. Partiamo dagli import:
from typing import TypedDict, List
from langchain_core.messages import HumanMessage
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, START, END
from dotenv import load_dotenv
La prima riga cita TypedDict, una annotazione di tipo definita così in Python:
from typing import TypedDict
class Student(TypedDict):
name: str
grade: float
s1: Student = {"name": "Sam", "grade": 92.5}
In sostanza, un TypedDict è un dizionario con solide garanzie di type-safety, fondamentali per lo sviluppo di agenti IA.
HumanMessage dovrebbe esserti ormai familiare, visto che ne abbiamo parlato prima.
ChatOpenAI, invece, è nuovo. Facciamo una breve digressione per spiegarlo.
Attraverso LangChain possiamo usare la famiglia Chat, che consente di utilizzare modelli di molti provider di LLM, come OpenAI, Anthropic, Ollama, ecc., tramite le rispettive librerie come ChatOpenAI, ChatAnthropic, ChatOllama, ecc.
In sostanza, parametri e uso sono simili, garantendo modularità al nostro codice. Passaggi più dettagliati sono nella documentazione di LangChain.
Infine, lo StateGraph lo abbiamo già visto, mentre Start ed End sono i punti di inizio e fine del nostro grafo.
Andiamo avanti:
load_dotenv() # Obtaining over secret keys
# Creation of the state using a Typed Dictionary
class AgentState(TypedDict):
messages: List[HumanMessage] # We are going to be storing Human Messages (the user input) as a list of messages
llm = ChatOpenAI(model="gpt-4o") # Our model choice
# This is an action - the underlying function of our node
def process(state: AgentState) -> AgentState:
response = llm.invoke(state["messages"])
    print(f"\nAI: {response.content}")
    return state
graph = StateGraph(AgentState) # Initialization of a Graph
graph.add_node("process_node", process) # Adding nodes
graph.add_edge(START, "process_node") # Adding edges
graph.add_edge("process_node", END)
agent = graph.compile() # Compiling the graph
Vediamo più in dettaglio i metodi .add_node() e .add_edge().
add.node(): ci sono due parametri principali su cui concentrarti: il nome del nodo e l'azione sottostante. L'azione sottostante, nel nostro caso process(), è la logica principale del nodo, cioè cosa accade quando arriviamo a questo passaggio. Il nome del nodo può essere qualsiasi cosa, anche uguale alla funzione, anche se potrebbe creare confusione in fase di debug!add_edge.(): anche qui i due parametri principali sono il nodo di partenza e quello di arrivo dell'arco. Nota che viene passato il nome del nodo, non l'azione sottostante.Guardiamo un esempio pratico:
user_input = input("Enter: ")
while user_input != "exit":
agent.invoke({"messages": [HumanMessage(content=user_input)]})
user_input = input("Enter: ")
Il codice sopra ci permette di chiamare l'agente più volte. Visivamente, l'agente IA che abbiamo costruito è così:
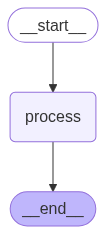
Un agente sequenziale completa i compiti passo dopo passo in un ordine predefinito, senza ramificazioni o ragionamento.
Per ottenere una tale visualizzazione, possiamo usare il seguente codice (Nota: usiamo il grafo compilato):
from IPython.display import Image, display
display(Image(agent.get_graph().draw_mermaid_png()))Gli agenti ReAct, Reasoning and Acting, sono molto comuni in ambito industriale per la facilità di creazione unita alla robustezza. Proprio perché sono così diffusi, LangGraph offre un metodo integrato che possiamo sfruttare per crearli.
Fortunatamente, ci servono solo due import aggiuntivi:
from langgraph.prebuilt import create_react_agent
from langchain_google_community import GmailToolkit
Il metodo create_react_agent è ciò che creerà per noi gli agenti ReAct.
tools = [GmailToolkit()] # We are using the Inbuilt Gmail tool
llm = ChatOllama(model="qwen2.5:latest") # Leveraging Ollama Models
agent = create_react_agent(
    model = llm, # Choice of the LLM
    tools = tools, # Tools we want our LLM to have
    name = "email_agent", # Name of our agent
    prompt = "You are my AI assistant that has access to certain tools. Use the tools to help me with my tasks.", # System Prompt
)
La parte migliore è che possiamo creare più agenti e architetture più complesse.
Possiamo anche creare strumenti personalizzati.
@tool
def send_email(email_address: str, email_content: str) -> str:
    """
Sends an email to a specified recipient with the given content.
Args:
email_address (str): The recipient's email address (e.g., 'example@example.com')
email_content (str): The body of the email message to be sent
Returns:
str: A confirmation message indicating success or failure
Example:
        >>> send_email('john.doe@example.com', 'Hello John, just checking in!')
'Email successfully sent to john.doe@example.com'
"""
    # Tool Logic goes here
    return "Done!"
Come detto sopra, ci sono due aspetti principali importanti quando si creano strumenti personalizzati:
Gli agenti ReAct appaiono così:
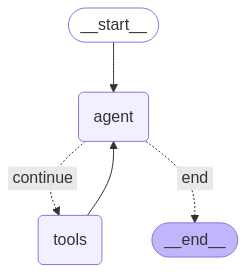
Un agente ReAct alterna ragionamento (pensieri) e azioni per risolvere i compiti passo dopo passo.
Quando si definisce lo State per sistemi agentici più complessi e robusti, è una buona idea usare le funzioni Reducer, o semplicemente i reducers. I reducers sono annotazioni dei dati che garantiscono che ogni volta che un nodo restituisce un messaggio, questo venga aggiunto all'elenco esistente nello stato, invece di sovrascrivere il valore precedente. In questo modo il nostro stato accumula contesto.
# State with reducer function
class AgentState(TypedDict):
messages: Annotated[list[BaseMessage], operator.add]
Questo codice integra la funzione reducer operator.add con lo stato, assicurando che tutti i messaggi vengano preservati.
In questa sezione ci concentriamo su un componente chiave di ogni agente: la memoria. La memoria è fondamentale perché fornisce il contesto necessario a rendere l'agente più robusto e affidabile. Esploriamo i diversi modi per gestirla nei nostri agenti.
Lo State è l'elemento più importante in LangGraph e, naturalmente, esistono vari modi per memorizzarlo esternamente. Alcuni degli storage più diffusi sono:
Tutte queste librerie sono elencate nella documentazione.
Per ora, vediamo SQLite:
from langgraph.checkpoint.sqlite import SqliteSaver
memory = SqliteSaver.from_conn_string(":memory:") # This is for connecting to the SQLite database
graph = graph_builder.compile(checkpointer=memory) # Compiling graph with checkpointer as SQLite backend
Usare SQLite è un modo semplice per aggiungere persistenza ai nostri agenti. La persistenza è la capacità di mantenere il contesto tra interazioni diverse.
Tutto questo serve a memorizzare e aggiornare lo stato. Ora vediamo come usare e gestire efficacemente quello stato, soprattutto la lista messages, che cresce molto con il proseguire della conversazione.
LangGraph offre supporto nativo per memoria a breve termine e a lungo termine. Vediamole.
La memoria a breve termine permette agli agenti di ricordare la cronologia dei messaggi durante una sessione, risultando utile per conversazioni multi-turno.
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph

checkpointer = InMemorySaver()

builder = StateGraph(...)
graph = builder.compile(checkpointer=checkpointer)


# Invoking the Graph with our message
agent_graph.invoke(
    {"messages": [{"role": "user", "content": "What's the weather today?"}]},
    {"configurable": {"thread_id": "session_42"}},
)
Nell'esempio sopra, il thread_id viene usato per identificare in modo univoco una conversazione o sessione.
La memoria a lungo termine persiste tra più sessioni ed è perfetta per ricordare elementi come nomi, obiettivi o impostazioni — informazioni importanti richieste tra sessioni.
from langgraph.store.memory import InMemoryStore
from langgraph.graph import StateGraph

long_term_store = InMemoryStore()
builder = StateGraph(...)
agent = builder.compile(store=long_term_store)
Tuttavia, dato che la conversazione può diventare lunga, serve un modo per limitare la cronologia dei messaggi. Qui entra in gioco il trimming.
Nell'esempio seguente, rimuoviamo i token dall'inizio della cronologia dei messaggi (grazie a strategy="first") in modo che, dopo il trimming, restino al massimo 150 token.
from langchain_core.messages.utils import trim_messages, count_tokens_approximately

trimmed = trim_messages(
        messages=state["messages"],
        strategy="first",  # remove the messages from beginning
        token_counter=count_tokens_approximately,
        max_tokens=150
)Un altro modo per ridurre la cronologia è tramite riassunto. Questo permette di preservare le informazioni importanti lungo tutta la cronologia, invece di tagliare semplicemente token da una parte della conversazione.
from langmem.short_term import SummarizationNode
from langchain_core.messages.utils import count_tokens_approximately

summary_node = SummarizationNode(
    model=summary_llm,                       # Our summarization LLM
    max_tokens=300,                          # Total token limit
    max_tokens_before_summary=150,           # when to start summarizing
    max_summary_tokens=150,                  # summary size
    token_counter=count_tokens_approximately
)
È importante notare che il riassunto è eseguito da un LLM sottostante, in questo caso summary_llm, che può essere qualsiasi LLM.
L'ultima operazione principale nella gestione della memoria è l'eliminazione. Per cancellare messaggi selezionati, possiamo usare questo codice:
from langchain_core.messages import RemoveMessage

def clean_state(state):
    # Remove all tool-related messages
    to_remove = [RemoveMessage(id=msg.id) for msg in state["messages"] if msg.role == "tool"]
    return {"messages": to_remove}
Nel codice sopra abbiamo eliminato tutti i messaggi relativi agli strumenti, che potrebbero essere ridondanti (dato che, realisticamente, il Tool-Message serve all'LLM per elaborare la risposta dopo l'uso dello strumento).
Se però vogliamo cancellare l'intera cronologia, possiamo fare così:
from langgraph.graph.message import REMOVE_ALL_MESSAGES
from langchain_core.messages import RemoveMessage

def reset_history(state):
    # Remove entire conversation history
return {"messages": [RemoveMessage(id=REMOVE_ALL_MESSAGES)]}In sintesi, LangGraph è una libreria potente che offre un approccio strutturato e scalabile alla creazione di sistemi agentici. Modellare la logica come un grafo di nodi e archi, con stato condiviso e memoria persistente, ci permette di sviluppare agenti robusti in grado di ragionare, interagire e adattarsi nel tempo.
Con l'aumentare della complessità, questo framework fornisce gli strumenti per gestire la memoria, coordinare l'uso degli strumenti e mantenere il contesto a lungo termine — restando al contempo modulare ed estensibile.
Con i componenti principali ormai chiari, sei pronto a progettare e distribuire agenti IA robusti, capaci di gestire workflow reali.
Per continuare a imparare, dai un'occhiata al nostro corso Building Multi-Agent Systems With LangGraph. Puoi anche consultare il nostro corso Designing Agentic Systems with LangChain e il nostro tutorial su Agentic RAG.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



