

De basis van LangGraph
Laten we beginnen met de fundamentele bouwstenen van LangGraph. Met deze elementen bouw je gestructureerde, stateful en schaalbare workflows voor geavanceerde AI‑agents.
State
De state is een gedeeld geheugenobject dat door de grafiek stroomt. Het slaat alle relevante informatie op, zoals berichten, variabelen, tussentijdse resultaten en beslissingsgeschiedenis. LangGraph beheert de state automatisch, wat de ontwikkeling efficiënter maakt.
Ter aanvulling op de State zijn er geavanceerde features zoals checkpointing, thread‑local memory en sessieoverstijgende persistentie. Tijdens de uitvoering wordt de state continu bijgewerkt, zoals in het onderstaande diagram: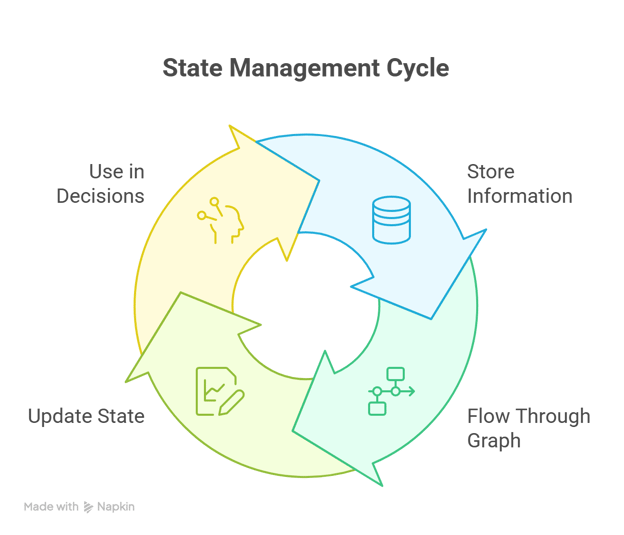
Cyclus voor state‑management in LangGraph met continue updates over nodes heen
Node
Een node is een enkele functionele eenheid in de workflow. Een node kan verschillende acties uitvoeren, zoals:
- Een large language model (LLM) aanroepen
- Een tool of API aanroepen
- Een aangepaste Python‑functie draaien
- Routeringslogica of vertakkingsbeslissingen
Elke node neemt de huidige state en geeft een bijgewerkte state terug.
Edges en conditionele edges
Edges definiëren de overgangen tussen nodes. Ze bepalen de control‑flow van de grafiek en kunnen het volgende ondersteunen:
- Statische verbindingen (voor lineaire voortgang)
- Cyclische paden (voor iteratief gedrag)
- Dynamische vertakkingen (op basis van state‑condities — gemaakt via Conditional Edges)
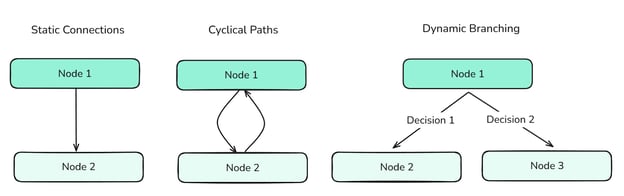
Verschillende typen Edges bepalen de flow tussen nodes en sturen de informatie door de grafiek.
Edges zijn cruciaal voor het orkestreren van complex agentgedrag.
Graph en stategraph
Een graph in LangGraph definieert de structuur van de agentische workflow en bestaat uit nodes die met edges zijn verbonden.
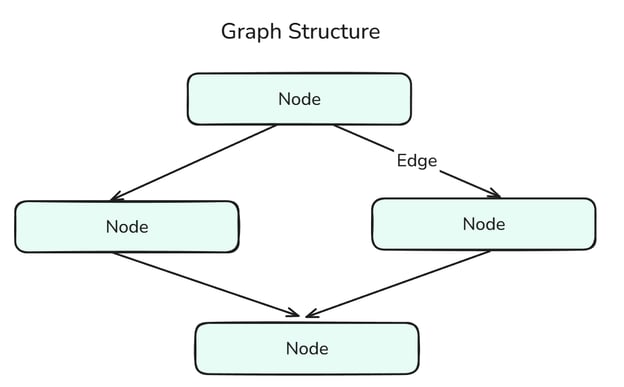
Graph‑structuur is een combinatie van Nodes en Edges.
De StateGraph is een gespecialiseerde graph die tijdens de uitvoering een gedeelde state bijhoudt en bijwerkt. Dit maakt contextbewuste besluitvorming en persistente geheugen over stappen mogelijk. Je kunt dit zien als de fusie van State en Graph.
Tool en toolnode
Een tool is elke externe of interne functie die een agent kan aanroepen, zoals een webzoekopdracht, rekenmachine of aangepaste utility. Er zijn twee typen Tools:
- Ingebouwde tools: tools die vooraf zijn gemaakt en klaar voor gebruik door LangChain, en beschikbaar zijn in de documentatie.
- Aangepaste tools: tools die we zelf kunnen maken en in onze applicatie gebruiken (door een decorator en DocString toe te voegen — dit laten we later in code zien).
Een ToolNode is een speciaal node‑type om tools binnen de graph uit te voeren. Hiermee kunnen ontwikkelaars tools integreren zonder extra wrapper‑logica te schrijven. Je kunt dit zien als de fusie van Tool en Node.
Berichttypen
Berichten zijn gestructureerde data‑elementen (zoals gebruikersinput, systeemoutput, tussentijdse reacties, enz.) die door de graph bewegen en in de state worden opgeslagen. Ze zorgen voor traceerbaarheid, geheugen en context voor agentbeslissingen, wat helpt om beter onderbouwde keuzes te maken.
Er zijn meerdere MessageTypes in LangGraph:
- HumanMessage: vertegenwoordigt input van een gebruiker. Dit is het meest gebruikte berichttype om een gesprek met de agent binnen de graph te starten of voort te zetten.
- AIMessage: vertegenwoordigt de reacties die door de onderliggende taalmodellen worden gegenereerd. Deze worden opgeslagen om gespreksgeheugen te behouden en toekomstige acties te informeren.
- SystemMessage: biedt context of instructies voor het gedrag van de LLM (bijv. “Je bent mijn persoonlijke assistent.”). Dit bericht beïnvloedt hoe het model reageert.
- ToolMessage: bevat de output van een tool. Deze zijn cruciaal wanneer je agent voor zijn volgende stappen afhankelijk is van externe operaties (zoals berekeningen of zoekopdrachten).
- RemoveMessage: wordt gebruikt om eerder toegevoegde berichten in de state programmatisch te verwijderen of ongedaan te maken. Handig voor foutcorrectie of het snoeien van irrelevante context.
- BaseMessage: de hoofdbasis voor alle berichttypen in LangChain en LangGraph. Elk specifiek berichttype — zoals
HumanMessage,AIMessageofSystemMessage— erft vanBaseMessage.
LangGraph‑agents
Nu gaan we deze agents in LangGraph coderen, met focus op de verschillende methoden en stappen tijdens het coderen én het visualiseren van deze agents.
Single‑agent workflow
Laten we beginnen met een enkele agent zonder tools of geheugen. We starten met de imports:
from typing import TypedDict, List
from langchain_core.messages import HumanMessage
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, START, END
from dotenv import load_dotenvDe eerste regel noemt TypedDict, een type‑annotatie die in Python zo wordt gedefinieerd:
from typing import TypedDict
class Student(TypedDict):
name: str
grade: float
s1: Student = {"name": "Sam", "grade": 92.5}Kort gezegd is een TypedDict een dictionary met sterke type‑veiligheid, cruciaal voor AI‑agentontwikkeling.
HumanMessage is je inmiddels bekend, want dat hebben we hierboven besproken.
ChatOpenAI is nieuw. Laten we dit kort toelichten.
Via LangChain kunnen we de Chat‑familie gebruiken, waarmee we modellen van verschillende LLM‑providers kunnen inzetten, zoals OpenAI, Anthropic, Ollama, enz., via hun respectieve libraries zoals ChatOpenAI, ChatAnthropic, ChatOllama, enz.
In de kern lijken hun parameters en gebruik op elkaar, wat modulariteit in onze code mogelijk maakt. Meer details staan in de LangChain‑documentatie.
Tot slot hebben we de StateGraph al besproken, en Start en End zijn de begin‑ en eindpunten van onze graph.
Laten we verdergaan:
load_dotenv() # Obtaining over secret keys
# Creation of the state using a Typed Dictionary
class AgentState(TypedDict):
messages: List[HumanMessage] # We are going to be storing Human Messages (the user input) as a list of messages
llm = ChatOpenAI(model="gpt-4o") # Our model choice
# This is an action - the underlying function of our node
def process(state: AgentState) -> AgentState:
response = llm.invoke(state["messages"])
print(f"\nAI: {response.content}")
return state
graph = StateGraph(AgentState) # Initialization of a Graph
graph.add_node("process_node", process) # Adding nodes
graph.add_edge(START, "process_node") # Adding edges
graph.add_edge("process_node", END)
agent = graph.compile() # Compiling the graphLaten we de methoden .add_node() en .add_edge() iets uitgebreider bespreken.
add.node(): er zijn twee hoofdparameters om op te letten: de naam van de node en de onderliggende actie. De onderliggende actie, in ons gevalprocess(), is de hoofdlogica achter de node, dus wat er gebeurt wanneer we deze fase bereiken. De naam van de node kan van alles zijn, zelfs dezelfde als de functie, al kan dat verwarrend zijn bij het debuggen!add_edge.(): ook hier zijn twee hoofdparameters belangrijk: de begin‑ en eindnode van de Edge. Let erop dat je de naam van de node opgeeft, niet de onderliggende actie.
Kijken we naar een praktisch voorbeeld:
user_input = input("Enter: ")
while user_input != "exit":
agent.invoke({"messages": [HumanMessage(content=user_input)]})
user_input = input("Enter: ")Met bovenstaande code kunnen we de agent meerdere keren aanroepen. Visueel ziet de AI‑agent die we hebben gebouwd er zo uit:
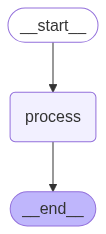
Een sequentiële agent voert taken stap voor stap uit in een vooraf bepaalde volgorde, zonder vertakkingen of redeneren.
Om zo’n visualisatie te maken, kun je de volgende code gebruiken (let op: we gebruiken de gecompileerde graph):
from IPython.display import Image, display
display(Image(agent.get_graph().draw_mermaid_png()))ReAct‑agents
ReAct‑agents, Reasoning and Acting Agents, zijn in de industrie enorm gangbaar vanwege hun eenvoudige creatie maar robuustheid. Omdat ze zo veel voorkomen, heeft LangGraph een ingebouwde methode die we kunnen gebruiken om zulke agents te maken.
Gelukkig hebben we maar twee extra imports nodig:
from langgraph.prebuilt import create_react_agent
from langchain_google_community import GmailToolkitDe methode create_react_agent maakt de ReAct‑agents voor ons aan.
tools = [GmailToolkit()] # We are using the Inbuilt Gmail tool
llm = ChatOllama(model="qwen2.5:latest") # Leveraging Ollama Models
agent = create_react_agent(
model = llm, # Choice of the LLM
tools = tools, # Tools we want our LLM to have
name = "email_agent", # Name of our agent
prompt = "You are my AI assistant that has access to certain tools. Use the tools to help me with my tasks.", # System Prompt
)Het mooie hiervan is dat we meerdere agents kunnen maken en complexere architecturen kunnen opzetten.
We kunnen ook onze eigen aangepaste tools maken.
@tool
def send_email(email_address: str, email_content: str) -> str:
"""
Sends an email to a specified recipient with the given content.
Args:
email_address (str): The recipient's email address (e.g., '[email protected]')
email_content (str): The body of the email message to be sent
Returns:
str: A confirmation message indicating success or failure
Example:
>>> send_email('[email protected]', 'Hello John, just checking in!')
'Email successfully sent to [email protected]'
"""
# Tool Logic goes here
return "Done!"Zoals hierboven vermeld, zijn er twee hoofdpunten belangrijk bij het maken van aangepaste tools:
- Decorator: dit vertelt LangGraph dat deze functie een speciale functie is — een tool.
- Docstring: deze is nodig om de LLM context te geven over wat de tool doet. Het is nuttig om voorbeelden en beschrijvingen van elke parameter te geven, omdat dit tool‑aanroepen robuuster maakt.
ReAct‑agents zien er zo uit:
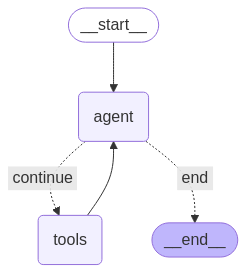
Een ReAct‑agent wisselt af tussen redeneren (gedachten) en acties om taken stap voor stap op te lossen.
Reducer‑functies voor groei van de state
Bij het definiëren van de State voor meer complexe, robuuste agentische systemen is het verstandig om Reducer‑functies of simpelweg reducers te gebruiken. reducers zijn data‑annotaties die ervoor zorgen dat elke keer dat een node een bericht teruggeeft, dit wordt toegevoegd aan de bestaande lijst in de state, in plaats van de vorige waarde te overschrijven. Zo kan onze state de context opbouwen.
# State with reducer function
class AgentState(TypedDict):
messages: Annotated[list[BaseMessage], operator.add]Deze code integreert de reducer‑functie operator.add met de state, zodat alle berichten bewaard blijven.
Geheugenbeheer in LangGraph
In deze sectie focussen we op een kernonderdeel van elke agent: geheugen. Geheugen is cruciaal voor een agent omdat het de context biedt die nodig is om robuuster en betrouwbaarder te zijn. Laten we de verschillende manieren verkennen om geheugen in onze agents te beheren.
Externe checkpoint‑stores
De State is het belangrijkste element in LangGraph, en er zijn dan ook meerdere manieren om de state extern op te slaan. Enkele populaire externe opslagopties zijn:
- SQLite
- PostgreSQL
- Amazon S3
- Azure Blob Storage
- Google Cloud Storage
- Mem0
Al deze libraries vind je in de documentatie.
Voor nu kijken we naar SQLite:
from langgraph.checkpoint.sqlite import SqliteSaver
memory = SqliteSaver.from_conn_string(":memory:") # This is for connecting to the SQLite database
graph = graph_builder.compile(checkpointer=memory) # Compiling graph with checkpointer as SQLite backendHet gebruik van SQLite is een eenvoudige manier om persistentie toe te voegen aan onze agents. Persistentie is het vermogen om context te behouden over verschillende interacties heen.
Dit alles is bedoeld om de state op te slaan en bij te werken. Laten we nu kijken hoe we die state effectief gebruiken en beheren, met name de lijst messages, die flink kan groeien naarmate het gesprek doorgaat.
LangGraph biedt native ondersteuning voor kortetermijngeheugen en langetermijngeheugen. Laten we die verkennen.
Kortetermijngeheugen
Kortetermijngeheugen laat onze agents het berichtverloop tijdens een sessie onthouden, wat handig is voor gesprekken met meerdere beurten.
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph
checkpointer = InMemorySaver()
builder = StateGraph(...)
graph = builder.compile(checkpointer=checkpointer)
# Invoking the Graph with our message
agent_graph.invoke(
{"messages": [{"role": "user", "content": "What's the weather today?"}]},
{"configurable": {"thread_id": "session_42"}},
)In het bovenstaande voorbeeld wordt thread_id gebruikt om een gesprek of sessie uniek te identificeren.
Langetermijngeheugen
Langetermijngeheugen blijft overeind over meerdere sessies en is perfect om zaken te onthouden als namen, doelen of instellingen — belangrijke zaken die sessieoverstijgend nodig zijn.
from langgraph.store.memory import InMemoryStore
from langgraph.graph import StateGraph
long_term_store = InMemoryStore()
builder = StateGraph(...)
agent = builder.compile(store=long_term_store)Omdat ons gesprek echter groot kan worden, hebben we een manier nodig om onze berichtenhistorie te beperken. Daarvoor gebruiken we trimming.
Trimming
In het onderstaande voorbeeld verwijderen we tokens vanaf het begin van de berichtenhistorie (door de regel: strategy="first"), zodat we na het trimmen maximaal 150 tokens overhouden.
from langchain_core.messages.utils import trim_messages, count_tokens_approximately
trimmed = trim_messages(
messages=state["messages"],
strategy="first", # remove the messages from beginning
token_counter=count_tokens_approximately,
max_tokens=150
)Samenvattingsgebaseerd snoeien
Een andere manier om de berichtenhistorie te verkleinen is door samen te vatten. Zo blijft belangrijke informatie door de berichtenhistorie heen bewaard, in plaats van simpelweg tokens uit een deel van het gesprek te knippen.
from langmem.short_term import SummarizationNode
from langchain_core.messages.utils import count_tokens_approximately
summary_node = SummarizationNode(
model=summary_llm, # Our summarization LLM
max_tokens=300, # Total token limit
max_tokens_before_summary=150, # when to start summarizing
max_summary_tokens=150, # summary size
token_counter=count_tokens_approximately
)Belangrijk om te weten: het samenvatten gebeurt door een onderliggende LLM, in dit geval summary_llm, en dat kan elk LLM zijn.
Selectief verwijderen
De laatste hoofdoperatie voor geheugenbeheer is verwijderen. Om geselecteerde berichten te verwijderen, kun je deze code gebruiken:
from langchain_core.messages import RemoveMessage
def clean_state(state):
# Remove all tool-related messages
to_remove = [RemoveMessage(id=msg.id) for msg in state["messages"] if msg.role == "tool"]
return {"messages": to_remove}In de bovenstaande code hebben we alle tool‑gerelateerde berichten verwijderd, die overbodig kunnen zijn (want realistisch gezien is de Tool‑Message bedoeld voor de LLM om zijn antwoord te formuleren na gebruik van de tool).
Wil je echter de volledige berichtenhistorie verwijderen, dan kan dat zo:
from langgraph.graph.message import REMOVE_ALL_MESSAGES
from langchain_core.messages import RemoveMessage
def reset_history(state):
# Remove entire conversation history
return {"messages": [RemoveMessage(id=REMOVE_ALL_MESSAGES)]}Conclusie
Kortom, LangGraph is een krachtige bibliotheek die een gestructureerde en schaalbare aanpak biedt voor het bouwen van agentische systemen. Door logica te modelleren als een graph van nodes en edges, met gedeelde state en persistent geheugen, kunnen we robuuste agents ontwikkelen die in de tijd kunnen redeneren, interacteren en zich aanpassen.
Naarmate systemen complexer worden, biedt dit framework de tools om geheugen te beheren, toolgebruik te coördineren en langetermijncontext te behouden — en dat alles modulair en uitbreidbaar.
Met de kerncomponenten nu op hun plek kun je robuuste AI‑agents ontwerpen en uitrollen die echte workflows aankunnen.
Blijf leren en bekijk onze cursus Building Multi‑Agent Systems With LangGraph. Je kunt ook onze cursus Designing Agentic Systems with LangChain en onze tutorial over Agentic RAG bekijken.
LangGraph‑agents: veelgestelde vragen
Wat is LangGraph precies?
Een Python‑framework dat de logica van een AI‑agent modelleert als een graph van nodes en edges, met ondersteuning voor redeneren, tool‑calls en geheugen.
Waarom zou ik LangGraph kiezen boven andere agent‑libraries?
LangGraph gebruikt een graph‑structuur om logica te definiëren, een belangrijk onderscheid dat andere populaire agentische frameworks niet gebruiken. LangGraph biedt ook native ondersteuning voor lussen, vertakkingen, geheugen, persistentie en multi‑agent workflows — ideaal voor schaalbare agents in de echte wereld.
Hoe beheert en bewaart LangGraph geheugen?
Het gebruikt een gedeelde state die kortetermijn (in‑memory) of langetermijn (SQLite, S3, enz.) kan worden opgeslagen, zodat agents eerdere interacties kunnen onthouden.
Kan ik in plaats daarvan lokale modellen gebruiken?
Zeker! LangGraph biedt native ondersteuning voor Ollama‑modellen, HuggingFace‑modellen, LlamaCpp, enz.
Hoe verklein ik lange berichtenhistorie?
Gebruik trim_messages om oude tokens te verwijderen of SummarizationNode om eerdere berichten te comprimeren met behoud van belangrijke context.


LangGraph is een grafiekgebaseerd framework voor het bouwen van AI-agents die via onderling verbonden stappen kunnen redeneren, plannen en handelen. Het onderscheidende kenmerk is dat je hiermee moeiteloos cyclische, vertakkende workflows maakt, waarbij elke node een LLM, tool of functie kan draaien — terwijl de state automatisch wordt beheerd.
Daardoor is LangGraph ideaal voor het bouwen van complexe, robuuste multi-agent systemen die geheugen, foutafhandeling en realtime besluitvorming nodig hebben.
In deze tutorial neem ik je mee door de basis en geavanceerde features van LangGraph, van de kernonderdelen tot het bouwen van stateful, tool‑verrijkte AI‑agents. Ben je geïnteresseerd in het bouwen van multi-agent systemen met LangGraph, bekijk dan zeker onze hands-on cursus. Je kunt ook onze videotutorial over LangGraph‑agents bouwen hieronder bekijken.